
Jeśli oceniasz narzędzia do web scrapingu w 2026 roku, zwykle nie szukasz wykładu z filozofii. Potrzebujesz krótkiej, godnej zaufania listy, szybkiego sposobu na odróżnienie narzędzi dla użytkowników biznesowych od cięższych technologicznie stosów oraz wystarczającej ilości konkretnych dowodów, by nie kupić niewłaściwego rozwiązania. Właśnie temu służy ta strona.
Krótka odpowiedź
Jeśli interesuje Cię tylko logika wyboru, kieruj się tym:
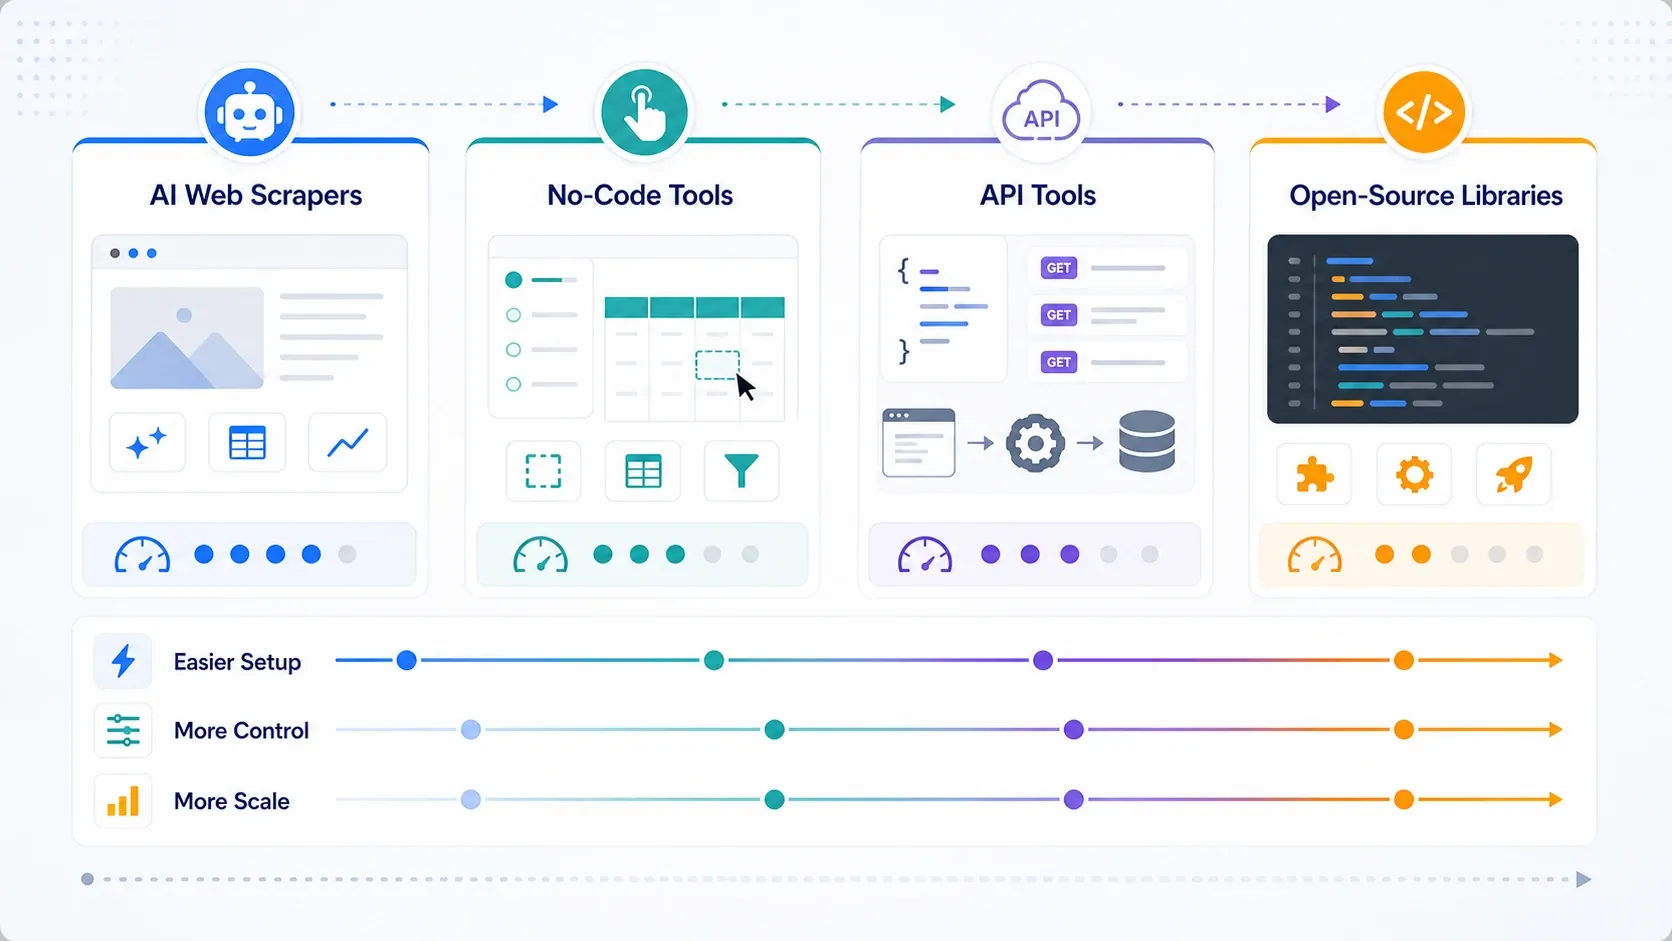
- Wybierz AI web scraper, jeśli chcesz najszybciej przejść od strony internetowej do arkusza kalkulacyjnego przy minimalnej konfiguracji.
- Wybierz no-code scraper, jeśli potrzebujesz większej kontroli nad zadaniami, harmonogramowania lub uruchomień w chmurze bez pisania kodu.
- Wybierz platformę API, jeśli Twój zespół potrzebuje renderowania, rotacji proxy, obsługi anty-botów lub integracji z produktem wewnętrznym.
- Wybierz bibliotekę open source, jeśli zależy Ci na pełnej kontroli i jesteś gotów sam odpowiadać za utrzymanie, selektory, infrastrukturę i błędy.
W tym artykule znajdziesz wszystkie 20 narzędzi, ale logika rekomendacji jest celowo prosta: zacznij od najlżejszego narzędzia, które realnie poradzi sobie z Twoim procesem, a schodź niżej w stosie tylko wtedy, gdy zmuszają Cię do tego utrzymanie, blokady albo skala.
Szybka tabela porównawcza: najlepsze narzędzia do web scrapingu w 2026 roku
Ceny i modele planów zostały sprawdzone na oficjalnych stronach produktów lub cenników w sierpniu 2026 roku. Tam, gdzie dostawcy stosują rozliczanie za użycie lub wyceny dla klientów enterprise, opisuję model cenowy zamiast udawać, że istnieje jedna uniwersalna i zawsze aktualna cena katalogowa.
| Narzędzie | Typ | Najlepsze zastosowanie | Dlaczego trafiło na listę 2026 | Model cenowy (sprawdzone w maju 2026) |
|---|---|---|---|---|
| Thunderbit | AI Web Scraper | Sprzedaż, operacje, e-commerce, nieruchomości | Najszybsza droga dla osób bez kodowania; sugestie pól AI, podstrony, eksporty, przepływ przeglądarka + chmura | Darmowy plan, płatne plany, wycena dla firm |
| Browse AI | AI Web Scraper | Użytkownicy biznesowi monitorujący strony | Mocne roboty no-code, monitoring i wyniki w formie arkusza/API | Darmowy plan, płatne plany, wyższy plan managed premium |
| Bardeen | AI Automation + Scraping | Revenue ops i przepływy przeglądarkowe | Najlepszy, gdy scraping jest tylko jednym krokiem w szerszej automatyzacji | Darmowy plan i płatne plany |
| Diffbot | AI Extraction Platform | Enterprise i zespoły data | Najmocniejszy wybór, gdy potrzebujesz ekstrakcji AI i dużych, ustrukturyzowanych przepływów danych | Cennik w modelu enterprise |
| Instant Data Scraper | Lekki scraper do przeglądarki | Użytkownicy okazjonalni i szybkie pobieranie tabel | Nadal jeden z najprostszych sposobów na szybkie wyciągnięcie widocznej listy lub tabeli do CSV | Bezpłatny |
| Octoparse | No-Code Scraper | Analitycy i zespoły operacyjne z większą liczbą cyklicznych zadań | Dojrzały wizualny builder z ekstrakcją w chmurze, zabezpieczeniami antyblokującymi i szablonami | Darmowy plan, płatne od 69 USD/mies., enterprise custom |
| ParseHub | Low-Code Scraper | Analitycy, którzy potrzebują logiki i kontroli desktopowej | Elastyczna logika projektów i zagnieżdżona nawigacja, ale z większą krzywą uczenia niż nowsze narzędzia AI-first | Darmowy plan i płatne plany |
| Web Scraper | No-Code Scraper | Początkujący i lekkie zadania w chmurze | Dobry punkt startu, jeśli lubisz scrapowanie oparte na sitemapach i konfigurację zaczynającą się w przeglądarce | Darmowe rozszerzenie, płatne plany chmurowe |
| Data Miner | Scraper do przeglądarki | Badacze i specjaliści growth | Nadal przydatny do szybkiej ekstrakcji opartej na gotowych przepisach bezpośrednio w przeglądarce | Darmowy plan i płatne plany |
| Apify | Platforma API + Actor | Zespoły techniczne i hybrydowe | Świetny ekosystem Actorów plus własne środowisko uruchomieniowe, gdy rozszerzasz się poza rozszerzenia do przeglądarki | Darmowy plan, start od 29 USD/mies. + zużycie, większe płatne poziomy |
| ScrapingBee | Scraping API | Deweloperzy scrapujący strony mocno oparte na JS | Dobry wybór, gdy chcesz renderowania i obsługi proxy bez budowania własnej warstwy przeglądarki | Darmowy trial i płatne plany |
| ScraperAPI | Scraping API | Deweloperzy szybko skalujący liczbę żądań | Proste API, kredyty testowe, uporządkowane produkty i łatwiejsze odciążenie infrastruktury | Trial 7 dni z 5000 kredytów, płatne od 49 USD/mies. |
| Bright Data | Enterprise API + platforma proxy | Programy o dużym wolumenie i wysokich wymaganiach zgodności | Najszerszy stack do pozyskiwania danych, gdy ważniejsze są odblokowanie, proxy i zarządzane pobieranie niż prostota | Cennik oparty na użyciu i produktach |
| Oxylabs | Enterprise API + platforma proxy | Zespoły kupujące scraping jako infrastrukturę | Mocny przy dużej skali, szczególnie w cenach, SEO i badaniach rynku | Web Scraper API od 49 USD/mies.; szerszy cennik proxy zależny od produktu |
| Zyte | API + stos anty-bot | Deweloperzy i zespoły data | Dobry wybór, jeśli chcesz ekstrakcji API-first z silnymi mechanizmami przeglądarki, rotacji i antydetekcji | Trial z 5 USD darmowego kredytu, zobowiązania oparte na użyciu |
| Selenium | Open-Source Browser Automation | Automatyzacja w stylu QA i trudne przepływy interakcji | Nadal przydatny, gdy ważniejsza jest wierna interakcja niż przepustowość scrapera | Bezpłatny i open source |
| BeautifulSoup4 | Open-Source Parser | Początkujący i lekkie parsowanie | Najlepszy jako parser w prostym stosie, nie jako pełna platforma do scrapingu | Bezpłatny i open source |
| Scrapy | Open-Source Crawling Framework | Produkcyjne, niestandardowe crawlery | Najlepszy kompromis między mocą a dojrzałością, jeśli chcesz samodzielnie zarządzać pipeline’em | Bezpłatny i open source |
| Puppeteer | Open-Source Browser Automation | Scrapowanie i skrypty przeglądarkowe w środowisku Node | Świetny, jeśli zespół dobrze czuje się w ekosystemie Chrome/Node | Bezpłatny i open source |
| Playwright | Open-Source Browser Automation | Nowoczesna automatyzacja wieloprzeglądarkowa | Często najczystszy wybór do nowoczesnej automatyzacji przeglądarki z dobrym komfortem pracy dewelopera | Bezpłatny i open source |
Jak oceniłem te narzędzia
Korzystałem z czterech filtrów:
- Czas do pierwszego udanego scrapingu
Jeśli osoba nietechniczna nie może szybko uzyskać użytecznych danych, to ma znaczenie. - Koszt utrzymania
Szybka konfiguracja nie ma wartości, jeśli workflow psuje się przy każdej zmianie strony. - Limit skali
Niektóre narzędzia są idealne dla 50 stron tygodniowo, a fatalne przy 5 milionach żądań miesięcznie. - Dopasowanie do procesu
Najlepsze narzędzie dla zespołu revenue ops rzadko jest najlepsze dla zespołu data platform.
Wynik nie jest uniwersalnym rankingiem. To strona decyzyjna, która pomaga najpierw wybrać właściwą klasę narzędzia, a dopiero potem konkretny produkt z tej klasy.
Jakiego typu narzędzia do web scrapingu naprawdę potrzebujesz?
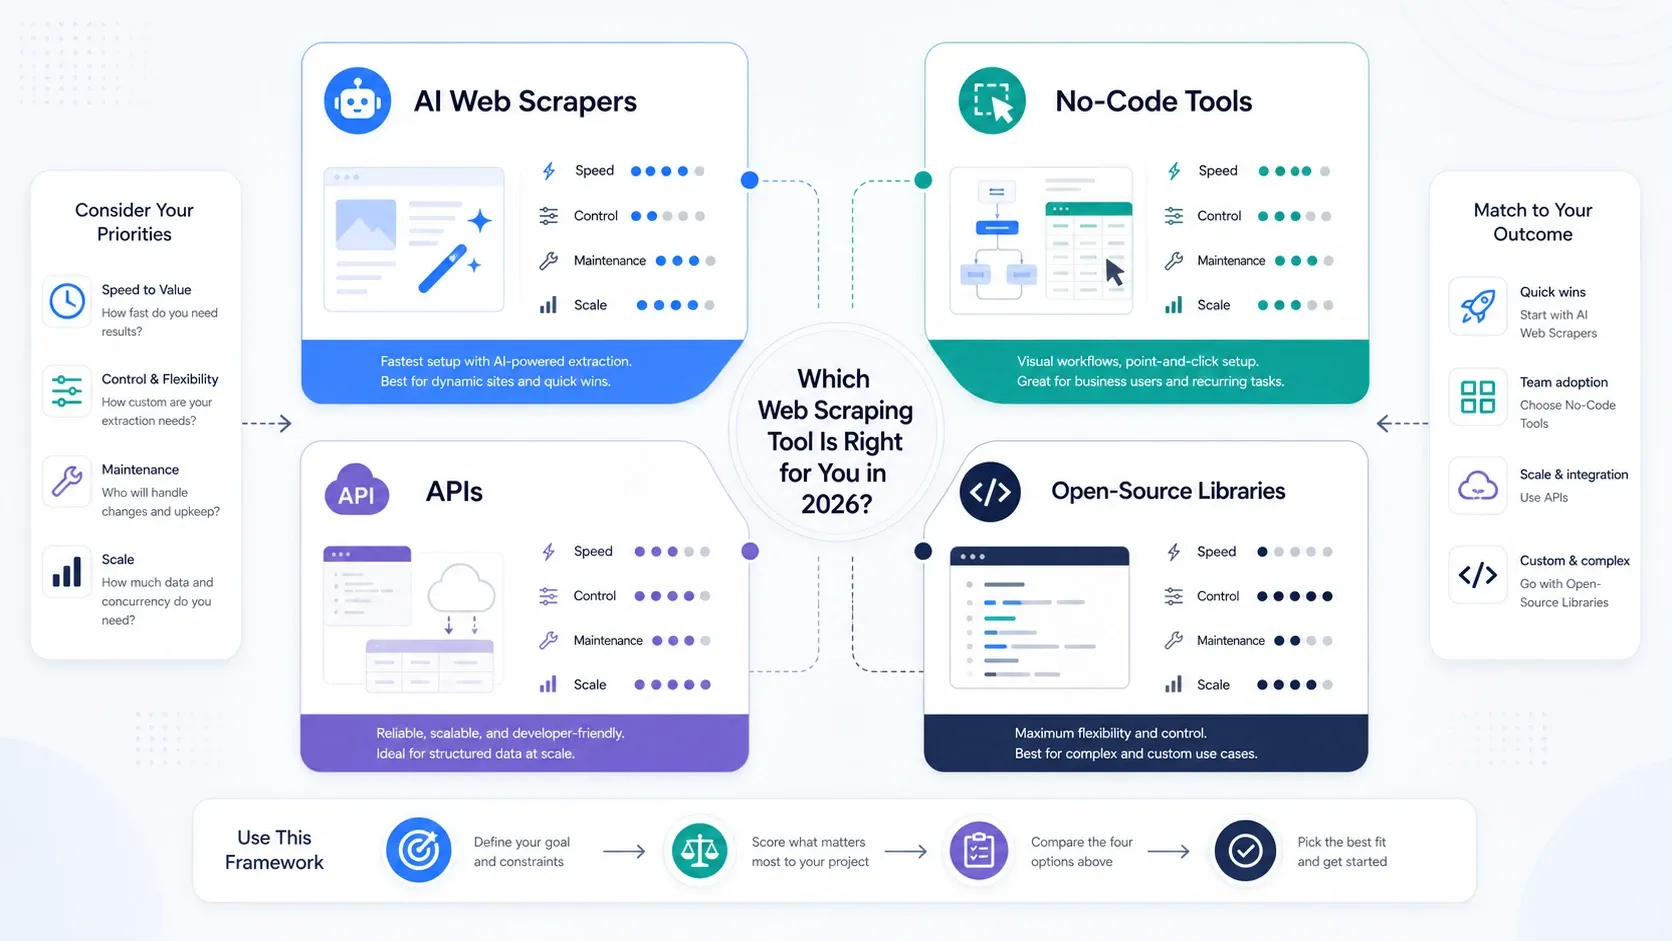
- Wybierz AI web scrapery, jeśli Twoim głównym celem jest szybkość działania.
- Wybierz narzędzia no-code, jeśli potrzebujesz większej kontroli nad paginacją, harmonogramami i powtarzalnymi zadaniami.
- Wybierz API i platformy scrapingowe, jeśli renderowanie, rotacja i możliwość odblokowania dostępu są dziś Twoim wąskim gardłem.
- Wybierz biblioteki open source, jeśli zespół ceni kontrolę bardziej niż wygodę i może utrzymywać cały stos wewnętrznie.
Jeśli Twój zespół nadal zastanawia się, czy scraping powinien należeć do operacji czy do inżynierii, zacznij najpierw od narzędzia AI lub no-code. O wiele szybciej zrozumiesz, co naprawdę ma znaczenie, uruchamiając rzeczywiste zadania, niż projektując cały stos z góry.
Najlepsze AI web scrapery dla zespołów biznesowych
To narzędzia, które sprawdziłbym najpierw, jeśli zależy Ci na danych gotowych do arkusza kalkulacyjnego przy możliwie najmniejszej konfiguracji.
1. Thunderbit
Thunderbit to tutaj najprostszy wybór, jeśli Twój zespół chce wyciągać uporządkowane dane bez uczenia się selektorów, skryptów przeglądarkowych ani infrastruktury scrapingowej. Proces opiera się na sugestiach pól AI, wzbogacaniu podstron i bezpośrednim eksporcie do narzędzi, z których użytkownicy biznesowi już korzystają.
- Najlepszy dla: sprzedaży, operacji, e-commerce, nieruchomości i innych zespołów intensywnie pracujących w przeglądarce.
- Dlaczego się wyróżnia: skraca czas konfiguracji lepiej niż cokolwiek innego na tej liście dla osób bez kodowania.
- Uwaga: jeśli potrzebujesz zaawansowanej logiki crawlera albo bardzo specyficznej kontroli inżynierskiej, z czasem przejdziesz niżej w stosie.
- Model cenowy: darmowy plan, samodzielnie obsługiwane płatne plany i wycena dla firm.
Jeśli chcesz zobaczyć najszybszy rzeczywisty workflow, zanim porównasz więcej narzędzi, ten przewodnik to najlepszy punkt startowy:
Wypróbuj Thunderbit na aktywnej stronie Otwórz dowolną stronę, pozwól AI ją odczytać i wyeksportuj uporządkowaną tabelę jednym kliknięciem. Get Started Free
2. Browse AI
Browse AI nadal jest mocnym wyborem dla użytkowników biznesowych, którzy chcą konfiguracji typu point-and-click oraz cyklicznego monitoringu. Model robotów jest szczególnie przydatny, gdy równie ważne są scraping i wykrywanie zmian.
- Najlepszy dla: monitorowania stron z cenami, stron konkurencji i powtarzalnej ekstrakcji list.
- Dlaczego się wyróżnia: dopracowany onboarding, gotowe roboty i jasna ścieżka od strony do arkusza lub wyjścia w stylu API.
- Uwaga: złożone, wielkoskalowe zadania mogą szybciej stać się kosztowne lub operacyjnie niewygodne niż w stackach API-first.
- Model cenowy: darmowy plan, płatne plany, plan premium/managed.
3. Bardeen
Bardeen jest najbardziej atrakcyjny wtedy, gdy scraping jest tylko jednym działaniem w szerszym przepływie automatyzacji w przeglądarce. Jeśli przenosisz dane do CRM-ów, arkuszy albo outbound workflows, jego automatyzacyjny charakter ma większe znaczenie niż sama głębokość scrapingu.
- Najlepszy dla: revenue ops, procesów leadowych i automatyzacji zadań w przeglądarce.
- Dlaczego się wyróżnia: mocniejsza historia automatyzacji workflow niż w czystych narzędziach do ekstrakcji.
- Uwaga: nie jest to najczystszy wybór, gdy samo scrapowanie jest złożone i krytyczne dla biznesu.
- Model cenowy: darmowy plan i płatne plany.
4. Diffbot
Diffbot jest dla zespołów, które potrzebują ekstrakcji AI na poziomie enterprise, a nie dla osób szukających najtańszej lub najprostszej drogi. Ma więcej sensu wtedy, gdy jakość danych strukturalnych i masowe zasilanie danych są ważniejsze niż ręczna kontrola.
- Najlepszy dla: zespołów data w enterprise, inteligencji treści i dużych programów ekstrakcji.
- Dlaczego się wyróżnia: ekstrakcja zbliżona do analizy komputerowej obrazu i mocne nastawienie na dane strukturalne.
- Uwaga: przesada dla małych zespołów i zbyt ciężki, jeśli użycie ma być lekkie.
- Model cenowy: plany enterprise i sprzedaż w modelu indywidualnym.
5. Instant Data Scraper
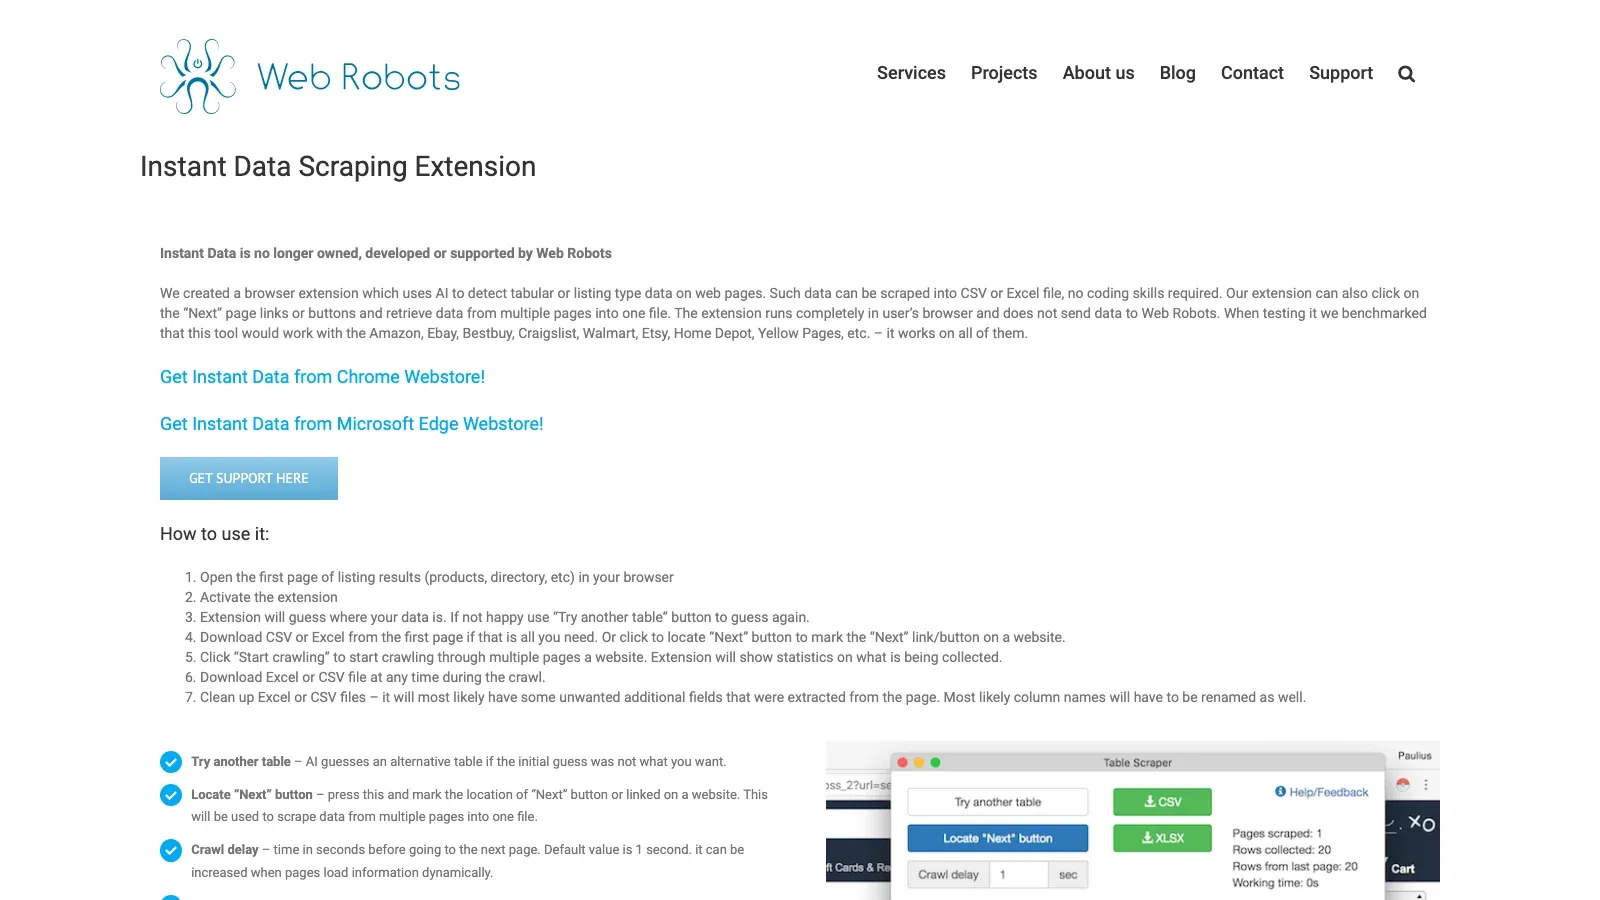
Instant Data Scraper nadal zasługuje na miejsce, bo istnieje wiele sytuacji, w których po prostu potrzebujesz teraz widocznej tabeli, katalogu albo listy. To nie jest platforma, ale często w zupełności wystarcza.
- Najlepszy dla: jednorazowej ekstrakcji, szybkich list leadów, prostych katalogów i widocznych tabel.
- Dlaczego się wyróżnia: niemal zerowy próg wejścia na odpowiednich stronach.
- Uwaga: ograniczona automatyzacja, mała głębokość i słabe dopasowanie do zaawansowanych procesów.
- Model cenowy: bezpłatny.
Najlepsze no-code narzędzia do web scrapingu dla zadań cyklicznych
Gdy zadanie to już coś więcej niż okazjonalny scraping, zaczynają się liczyć wizualne buildery i uruchamianie w chmurze.
6. Octoparse
Octoparse nadal pozostaje jedną z najmocniejszych platform no-code, jeśli potrzebujesz uruchomień w chmurze, szerokiej bazy szablonów i bardziej zaawansowanego zarządzania zadaniami, niż oferuje rozszerzenie przeglądarkowe.
- Najlepszy dla: analityków, zespołów cenowych i operatorów uruchamiających cykliczne zadania pobierania danych.
- Dlaczego się wyróżnia: dojrzały builder zadań, ekstrakcja w chmurze, funkcje antyblokujące i duży ekosystem szablonów.
- Uwaga: jest mocniejszy niż narzędzia przeglądarkowe AI-first, ale oznacza to też większy narzut konfiguracji.
- Model cenowy: darmowy plan, płatne od 69 USD/mies., enterprise custom.
7. ParseHub
ParseHub nadal ma sens dla użytkowników, którzy chcą większej kontroli niż daje AI scraper, ale nie chcą budować kodowej bazy projektu. Nagradza cierpliwość, nie szybkość.
- Najlepszy dla: analityków i technicznie ciekawych operatorów, którzy tolerują większą krzywą uczenia.
- Dlaczego się wyróżnia: elastyczna logika nawigacji i lepsza kontrola niż lekkie narzędzia przeglądarkowe.
- Uwaga: doświadczenie produktu wydaje się cięższe niż u nowszych konkurentów, zwłaszcza dla szybko działających zespołów biznesowych.
- Model cenowy: darmowy plan i płatne plany.
8. Web Scraper
Web Scraper nadal jest rozsądnym punktem wejścia, jeśli lubisz model sitemap i chcesz czegoś, co zaczyna się w przeglądarce, a później rozwija się w kierunku harmonogramów chmurowych.
- Najlepszy dla: początkujących, projektów hobbystycznych i mniejszych zadań cyklicznych.
- Dlaczego się wyróżnia: przystępny workflow oparty na sitemapach i łatwe wdrożenie zaczynające się w przeglądarce.
- Uwaga: zaczyna ograniczać, gdy potrzebujesz bardziej adaptacyjnej logiki ekstrakcji.
- Model cenowy: darmowe rozszerzenie do przeglądarki i płatne plany chmurowe.
9. Data Miner
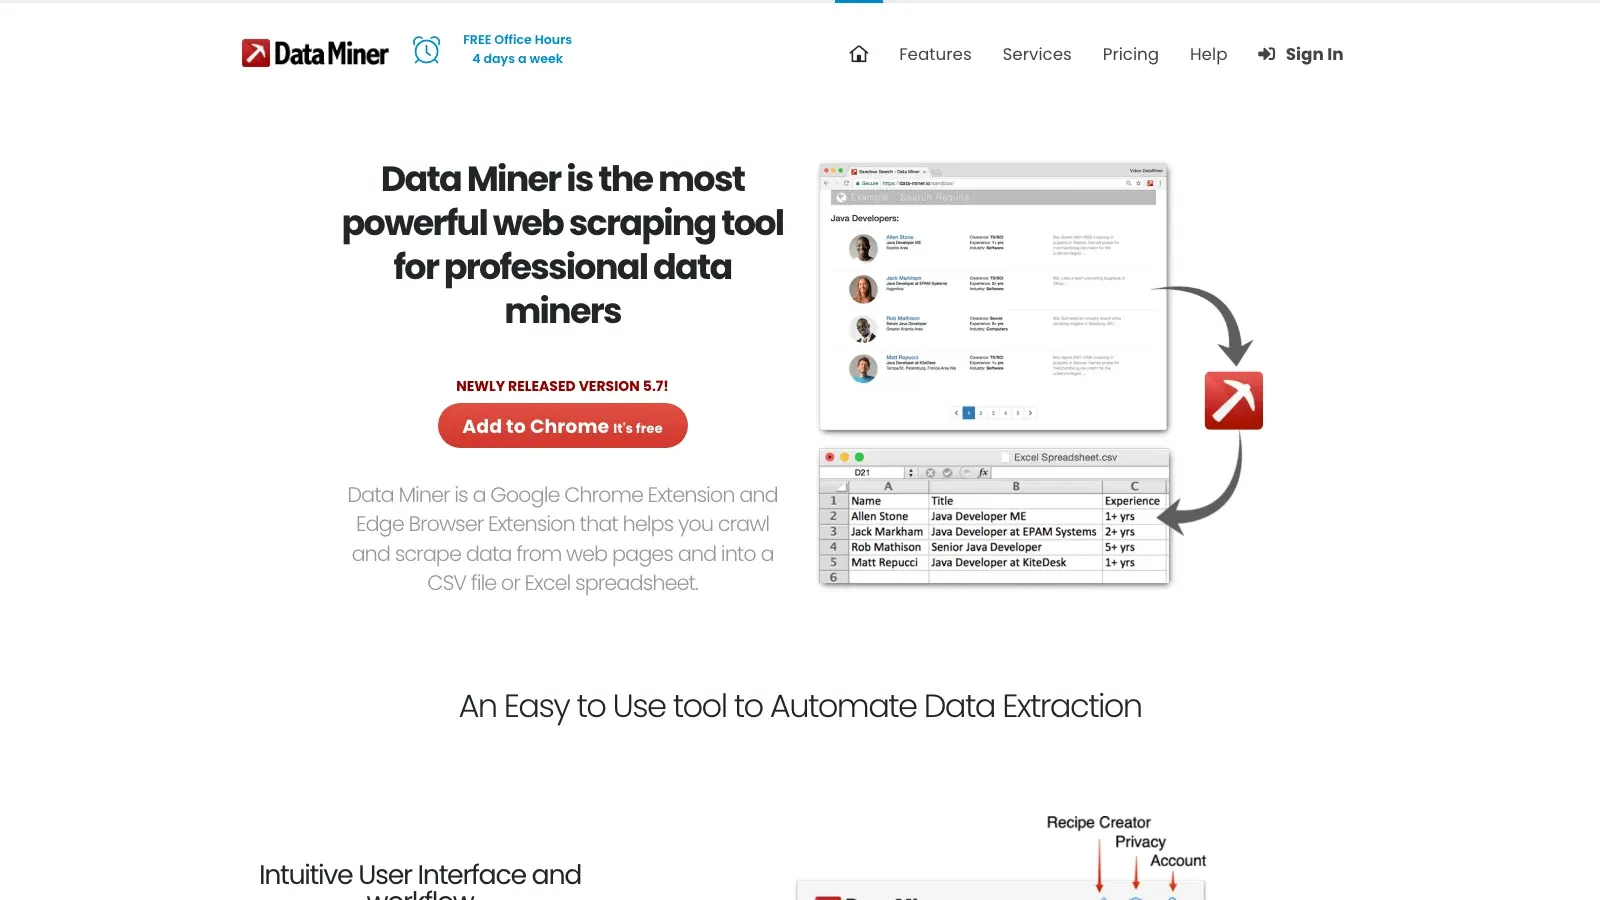
Data Miner najlepiej rozumieć jako szybkie narzędzie do ekstrakcji, a nie pełną platformę scrapingową. Nadal zasługuje na miejsce, bo praca oparta na gotowych przepisach jest bardzo użyteczna w wielu zadaniach badawczych i prospectingowych.
- Najlepszy dla: badaczy, zespołów growth i szybkiego eksportu z poziomu przeglądarki.
- Dlaczego się wyróżnia: model receptur, niski próg wejścia i prosty eksport z przeglądarki.
- Uwaga: to nie jest narzędzie do poważnego scrapingu na poziomie platformy.
- Model cenowy: darmowy plan i płatne plany.
Najlepsze platformy API, gdy skala i blokady stają się prawdziwym problemem
To warstwa, w której zespoły inżynierskie przestają pytać „jak zeskrobać tę stronę?”, a zaczynają pytać „jak zrobić to niezawodnie na dużą skalę?”.
10. Apify
Apify to najbardziej elastyczna platforma w tej grupie, jeśli chcesz mieć zarówno marketplace gotowych scraperów, jak i miejsce do uruchamiania własnego kodu. Lepiej niż większość konkurentów łączy odkrywanie no-code z wykonywaniem po stronie dewelopera.
- Najlepszy dla: zespołów hybrydowych, scrapingu prowadzonego przez deweloperów i powtarzalnych automatyzacji.
- Dlaczego się wyróżnia: ekosystem Actorów plus własne środowisko uruchomieniowe dają mu wyjątkowy zakres możliwości.
- Uwaga: gdy wejdziesz w custom, wracasz do świata inżynierii i przewaga prostoty znika.
- Model cenowy: darmowy plan, start od 29 USD/mies. + zużycie, większe pakiety i enterprise.
11. ScrapingBee
ScrapingBee to dobry wybór, gdy Twoja realna potrzeba brzmi: „dostarcz mi renderowaną stronę i odciągnij ode mnie całą brudną infrastrukturę”. Dobrze pasuje do celów mocno opartych na JS.
- Najlepszy dla: deweloperów scrapujących dynamiczne strony i niechcących zajmować się infrastrukturą.
- Dlaczego się wyróżnia: proste API do renderowania, proxy i automatyzacji przeglądarki.
- Uwaga: to usługa infrastrukturalna, więc nadal odpowiadasz za parsowanie, retry logic i jakość danych na dalszym etapie.
- Model cenowy: trial i płatne plany.
12. ScraperAPI
ScraperAPI nadal jest jednym z najprostszych sposobów na odciążenie zarządzania proxy i poprawy skuteczności żądań, gdy chcesz szybko skalować.
- Najlepszy dla: deweloperów, którzy muszą szybko przejść od prototypu do dużego wolumenu.
- Dlaczego się wyróżnia: proste API, kredyty testowe, uporządkowane produkty i łatwiejsze skalowanie.
- Uwaga: jak wszystkie produkty API-first, nie zwalnia z inżynierskiej oceny parsowania i walidacji danych.
- Model cenowy: 7-dniowy trial z 5000 kredytów, płatne od 49 USD/mies.
13. Bright Data
Bright Data to ciężka artyleria, gdy możliwość odblokowania, zasoby proxy i zarządzane pozyskiwanie danych są ważniejsze niż prostota narzędzia.
- Najlepszy dla: programów enterprise, dużych wdrożeń wrażliwych na zgodność i zarządzanego pozyskiwania danych.
- Dlaczego się wyróżnia: ogromna szerokość produktów proxy, scraperów, browserów i datasetów.
- Uwaga: drogie i łatwo przepłacić, jeśli główny workflow jest jeszcze stosunkowo prosty.
- Model cenowy: rozliczanie oparte na użyciu i produktach w obszarze API, proxy i usług zarządzanych.
14. Oxylabs
Oxylabs pozostaje mocnym wyborem dla zespołów kupujących scraping jako infrastrukturę, a nie jako narzędzie do przeglądarki. Jest szczególnie istotny, gdy liczą się niezawodność i dojrzałość zakupowa.
- Najlepszy dla: zbierania danych w enterprise, monitoringu cen, monitoringu SEO i badań rynku.
- Dlaczego się wyróżnia: solidna infrastruktura, głęboka oferta proxy i bardziej oczywisty model sprzedaży dla enterprise.
- Uwaga: nie jest idealny, jeśli zespół chce swobodnego workflow self-serve.
- Model cenowy: Web Scraper API od 49 USD/mies.; pozostałe produkty różnią się jednostką i użyciem.
15. Zyte
Zyte nadal zasługuje na poważne rozważenie przez zespoły deweloperskie i data, które chcą antydetekcji, akcji w przeglądarce, renderowania JS i rotujących IP w ramach jednej historii API-first.
- Najlepszy dla: zespołów technicznych budujących powtarzalne systemy ekstrakcji.
- Dlaczego się wyróżnia: akcje w przeglądarce, renderowanie JS, rotacja IP i podejście anty-bot w jednym stacku.
- Uwaga: lepszy dla zespołów z odpowiedzialnością inżynierską niż dla osób nietechnicznych.
- Model cenowy: trial z 5 USD darmowego kredytu i miesięczne zobowiązania oparte na użyciu.
Przetestuj prostszy workflow, zanim zbudujesz zbyt dużo Zanim zainwestujesz w proxy i kod, sprawdź, jak daleko zajdzie 1-klilkowy AI scraper. Get Started Free
Najlepsze biblioteki open source dla deweloperów, którzy chcą pełnej kontroli
Jeśli chcesz samodzielnie zarządzać całym stosem scrapingowym od początku do końca, to w 2026 roku są najbardziej użyteczne klocki.
16. Selenium
Selenium nadal jest przydatny, gdy potrzebujesz wiernej interakcji w stylu QA, starszych workflow automatyzacji przeglądarki albo bardzo precyzyjnej kontroli przepływu użytkownika.
- Najlepszy dla: automatyzacji wymagającej intensywnej interakcji, overlapu z QA i stron, gdzie zachowanie przeglądarki jest ważniejsze niż przepustowość.
- Dlaczego się wyróżnia: dojrzały ekosystem i szerokie wsparcie przeglądarek.
- Uwaga: dla wielu zadań scrapingowych jest cięższy i wolniejszy niż nowsze narzędzia do przeglądarki.
- Model cenowy: bezpłatny i open source.
17. BeautifulSoup4
BeautifulSoup nie jest pełną platformą scrapingową, ale nadal pozostaje jednym z najprostszych sposobów parsowania chaotycznego HTML w lekkich workflow.
- Najlepszy dla: początkujących, szybkich skryptów i zadań nastawionych przede wszystkim na parsowanie.
- Dlaczego się wyróżnia: prosty interfejs i niski koszt poznawczy.
- Uwaga: łącz go z narzędziami do requestów, przeglądarki lub crawlingu; sam w sobie jest tylko parserem.
- Model cenowy: bezpłatny i open source.
18. Scrapy
Scrapy nadal jest najlepszą odpowiedzią, gdy potrzebujesz prawdziwego frameworka crawlera, a nie kilku skryptów.
- Najlepszy dla: produkcyjnych crawlerów tworzonych na zamówienie i wewnętrznych pipeline’ów danych.
- Dlaczego się wyróżnia: wysoka wydajność, pipeline’y, middleware i duża rozszerzalność długoterminowa.
- Uwaga: wiąże się z realnym narzutem inżynierskim, a strony mocno oparte na JS często wymagają narzędzi towarzyszących.
- Model cenowy: bezpłatny i open source.
19. Puppeteer
Puppeteer nadal jest mocnym wyborem dla zespołów pracujących w Node, które chcą bezpośredniej kontroli nad Chromium i skryptami przeglądarkowymi.
- Najlepszy dla: scrapingu w Node, zrzutów ekranu i automatyzacji przeglądarki.
- Dlaczego się wyróżnia: bezpośrednia, bardzo mocna kontrola nad zachowaniem Chromium.
- Uwaga: ma węższy zakres przeglądarek niż Playwright i nadal jest zasobożerny przy dużej skali.
- Model cenowy: bezpłatny i open source.
20. Playwright
Playwright to mój domyślny wybór do nowoczesnej automatyzacji przeglądarki, jeśli zespół pisze kod i chce nowszej abstrakcji niż Selenium.
- Najlepszy dla: nowoczesnej automatyzacji przeglądarki, stron mocno opartych na JS i zespołów, którym zależy na wygodzie pracy dewelopera.
- Dlaczego się wyróżnia: mocny model wieloprzeglądarkowy, niezawodne oczekiwanie na elementy i czyste API.
- Uwaga: nadal odpowiadasz za infrastrukturę przeglądarki, współbieżność, drift selektorów i walidację danych.
- Model cenowy: bezpłatny i open source.
Moja krótka lista według typu zespołu
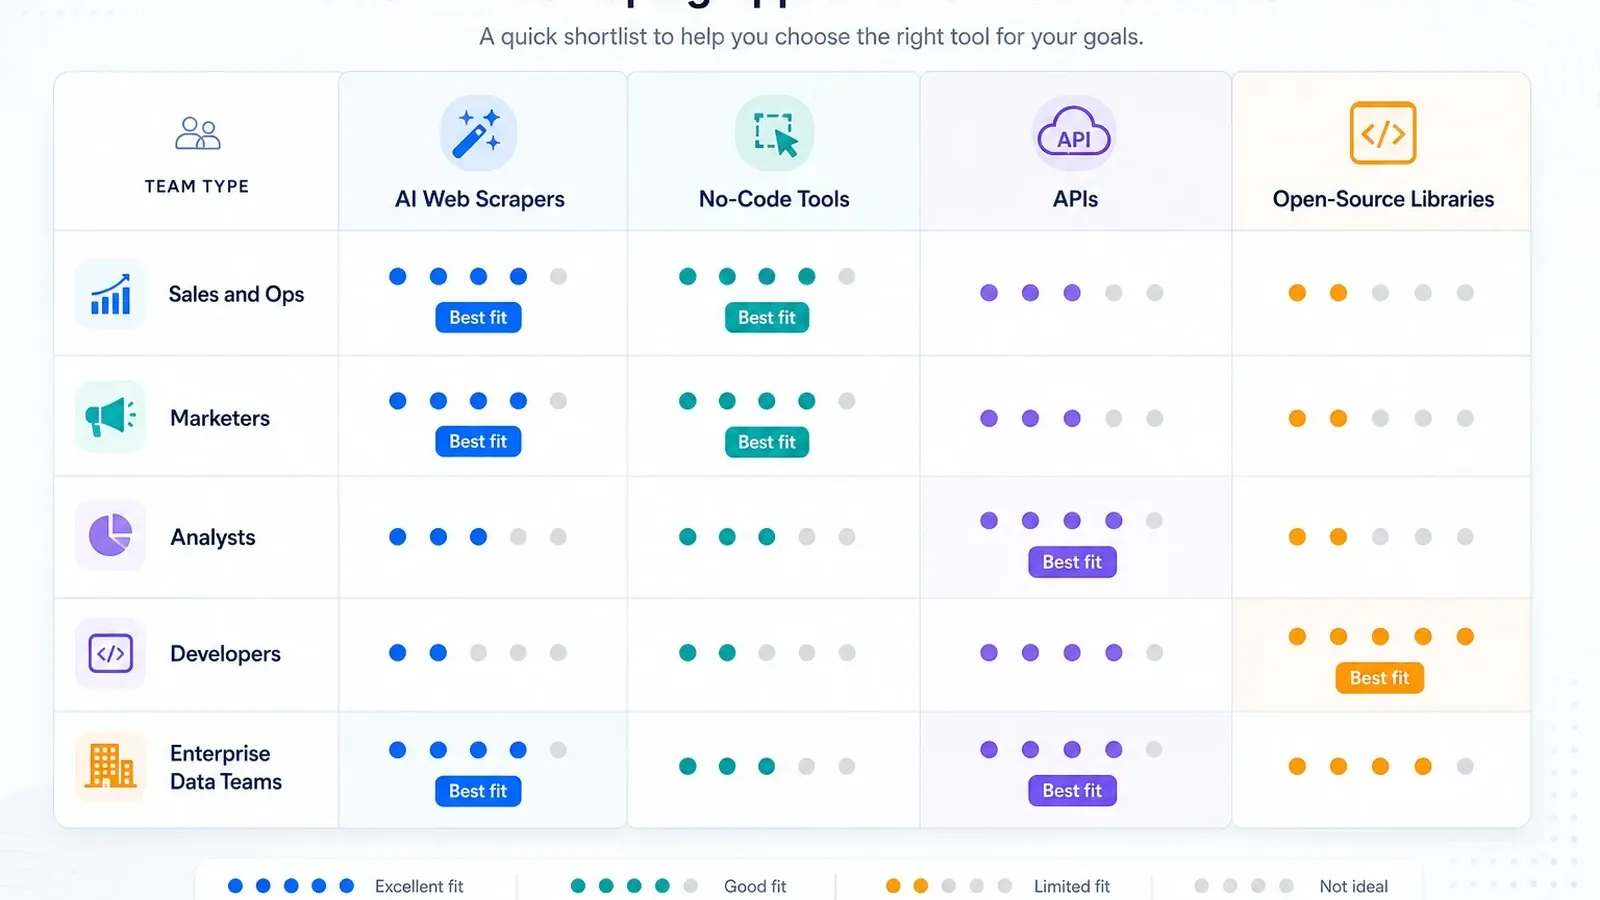
- Zespoły sprzedaży i operacji: zacznij od Thunderbit, a następnie sprawdź Browse AI, jeśli monitoring jest ważniejszy niż wzbogacanie podstron.
- Analitycy i zespoły badawcze: najpierw Octoparse, jeśli cykliczne zadania są większe, niż wygodnie obsłużą narzędzia wtyczkowe.
- Zespoły GTM nastawione na automatyzację: Bardeen, jeśli scraping to tylko jeden krok w szerszym workflow.
- Zespoły deweloperskie budujące wewnętrzne narzędzia: Apify, Zyte, ScraperAPI lub Playwright, zależnie od tego, jak dużą część stosu chcesz utrzymywać samodzielnie.
- Programy danych w enterprise: Bright Data, Oxylabs, Diffbot i Zyte to poważne rozmowy infrastrukturalne.
Kiedy zejść niżej w stosie
Kieruj się tą zasadą:
- Zostań przy narzędziach AI, dopóki nie dojdziesz do ograniczeń powtarzalności lub przypadków brzegowych.
- Przejdź do narzędzi no-code, gdy harmonogramowanie, paginacja, antyblokowanie lub uruchomienia w chmurze stają się ważniejsze niż prostota 1 kliknięcia.
- Przejdź do API, gdy skuteczność odblokowania, renderowanie JS i współbieżność stają się prawdziwym wąskim gardłem.
- Przejdź do bibliotek open source, gdy koszt abstrakcji dostawcy staje się wyższy niż koszt samodzielnego posiadania całego stosu.
Większość zespołów schodzi niżej w stosie zbyt wcześnie. To jeden z najczęstszych błędów, jakie widzę.
Ostateczny wniosek
Dla większości zespołów nietechnicznych właściwa odpowiedź w 2026 roku nie brzmi „najmocniejszy scraper”. To narzędzie, które dostarcza dokładne dane do następnego etapu procesu przy najmniejszym koszcie utrzymania. Dlatego narzędzia AI-first nadal wygrywają wśród operatorów, a API i stosy open source pozostają lepszym wyborem dla zespołów technicznych z jasno określonymi wymaganiami skali.
Jeśli chcesz najkrótszej drogi od strony do ustrukturyzowanego wyniku, zacznij od Thunderbit. Jeśli już wiesz, że Twoje zadanie wymaga ciężkiej infrastruktury, przejdź od razu do warstwy API i deweloperskiej. Tylko nie myl złożoności z zaawansowaniem.
Zacznij od najlżejszego narzędzia, które naprawdę potrafi wykonać zadanie Get Started Free
FAQ
1. Jakie jest najlepsze narzędzie do web scrapingu dla użytkowników nietechnicznych w 2026 roku?
Dla większości użytkowników nietechnicznych najlepszym wyborem są narzędzia AI-first, takie jak Thunderbit i Browse AI, ponieważ najszybciej prowadzą do użytecznych danych i ograniczają pracę nad selektorami, konfigurację oraz koszty utrzymania.
2. Co wybrać, jeśli moje strony są mocno oparte na JavaScript albo agresywnie blokują żądania?
Warto rozważyć ScrapingBee, ScraperAPI, Zyte, Bright Data, Oxylabs, Playwright lub Selenium — zależnie od tego, czy potrzebujesz usługi zarządzanej, czy bezpośredniej kontroli inżynierskiej.
3. Czy narzędzia no-code są nadal potrzebne, skoro AI web scrapery są lepsze?
Tak. Narzędzia no-code, takie jak Octoparse i ParseHub, nadal mają sens, gdy potrzebujesz bardziej precyzyjnej kontroli nad logiką zadania, uruchamianiem w chmurze i powtarzalnym zarządzaniem pracą.
4. Które narzędzia najlepiej pasują do zespołów inżynierskich?
Apify, Zyte, ScraperAPI, Scrapy, Playwright, Puppeteer i Selenium to najbardziej naturalne wybory, gdy workflow jest prowadzony przez deweloperów.
5. Jak szybko zawęzić wybór, zamiast robić zbyt szeroki research?
Najpierw wybierz typ narzędzia, a nie dostawcę. Zdecyduj, czy potrzebujesz prostoty AI, kontroli no-code, infrastruktury API czy własności open source. Dopiero potem porównuj konkretne produkty w tej warstwie.
Powiązane lektury




