
Trustpilot gromadzi 361 milionów aktywnych opinii w 1,27 miliona firm — a większość narzędzi stworzonych do pobierania tych danych przestała działać już kilka miesięcy temu. Jeśli próbowałeś ostatnio pobierać recenzje, prawdopodobnie natknąłeś się na słynny blok logowania po 10. stronie i zobaczyłeś, jak Twoje narzędzie zwraca wyłącznie błąd.
Przez ostatnie kilka tygodni testowałem, analizowałem i porównywałem narzędzia, które nadal potrafią niezawodnie wyciągać dane z recenzji Trustpilot w 2026 roku. Krajobraz mocno się zmienił: zabezpieczenia anty-bot Trustpilot są dziś bardziej agresywne, frontend Next.js generuje nazwy klas zmieniające się przy każdym wdrożeniu, a co najważniejsze — dostęp bez logowania kończy się już po 10 stronach opinii. Wątek na Reddicie z końca 2025 roku świetnie oddał frustrację: „żaden z actorów w sklepie nie działa”.
Które narzędzia faktycznie dają radę? Oceniałem pięć rozwiązań pod kątem tego, jak radzą sobie z blokadą logowania, zabezpieczeniami anty-bot, kosztami utrzymania oraz praktycznymi potrzebami marketerów i developerów.
Dlaczego scrapowanie opinii z Trustpilot jest trudniejsze, niż się wydaje w 2026 roku
Trustpilot nie jest prostą, statyczną stroną, którą da się pobrać zwykłym żądaniem HTTP i sparsować za pomocą BeautifulSoup. To nowoczesna, dynamicznie renderowana platforma oparta na Next.js, a jej zabezpieczenia w ciągu ostatniego roku wyraźnie się zaostrzyły.
Z czym tak naprawdę trzeba się mierzyć:
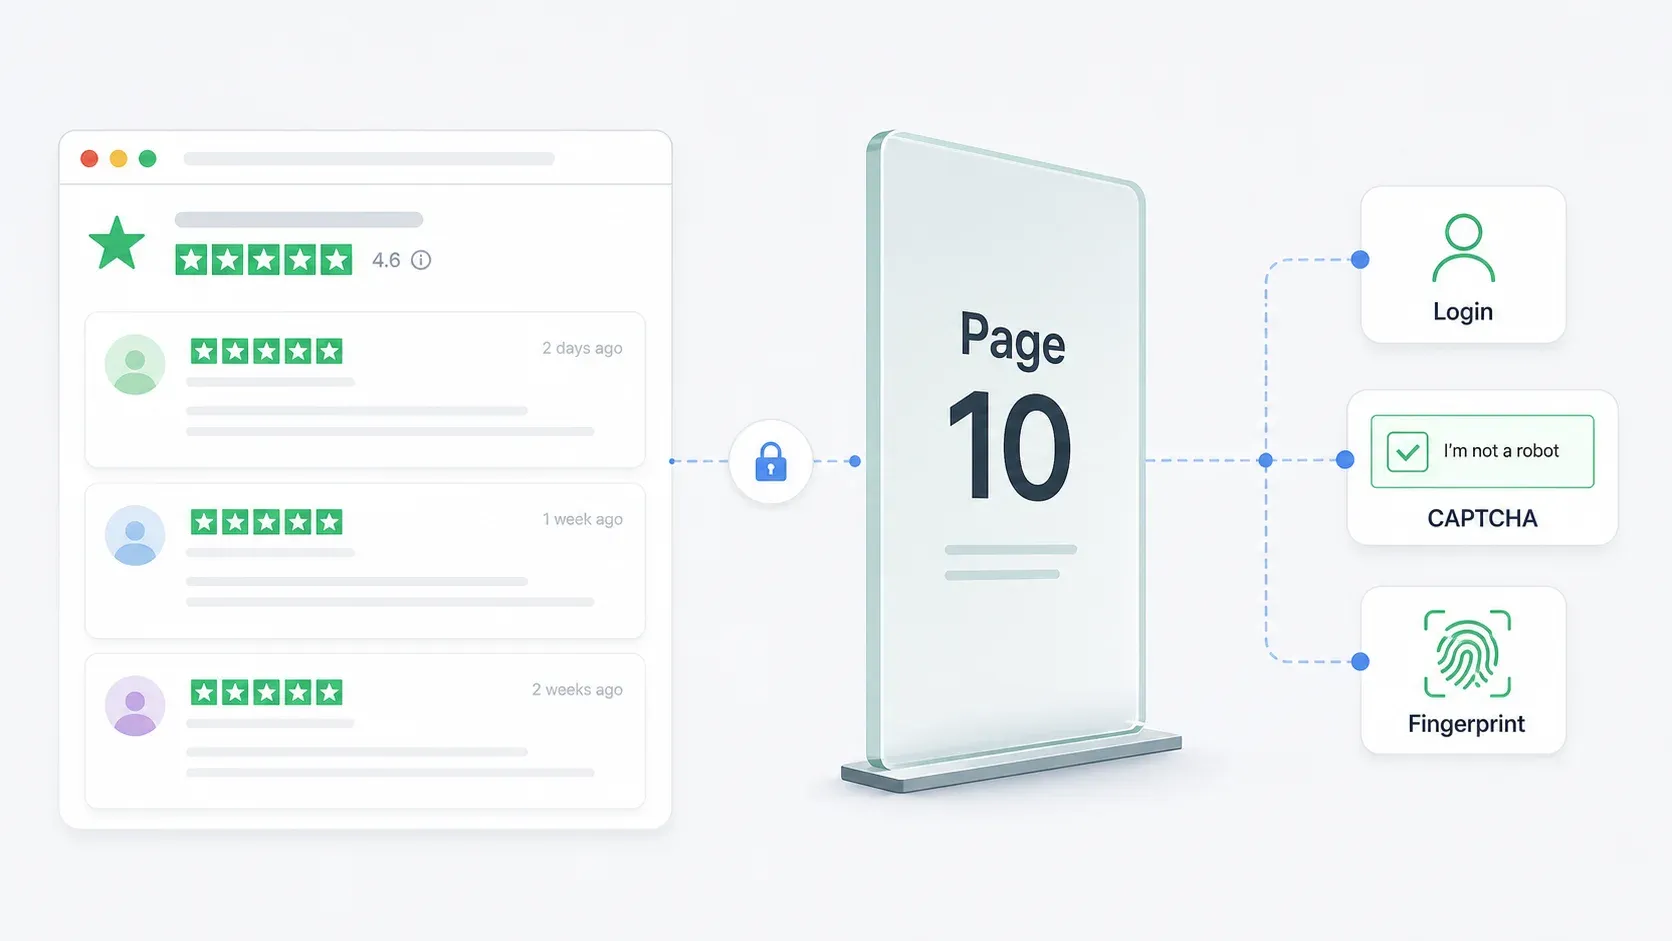
Blokada logowania po 10. stronie. To największy problem. Własny przewodnik Web Scraper z marca 2026 r. o Trustpilot potwierdza, że Trustpilot pozwala przejrzeć tylko pierwsze 10 stron opinii, po czym wyświetla monit o zalogowanie. Dla firmy z 2 000 opinii (czyli około 100 stron przy 20 recenzjach na stronę) oznacza to brak dostępu do 90% danych, jeśli nie masz uwierzytelnionej sesji.
Zabezpieczenia anty-bot. Trustpilot korzysta z reCAPTCHA, blokowania opartego na sesji, filtrowania zapytań na poziomie CDN oraz fingerprintingu przeglądarki. Na stronie About wprost podaje, że serwis jest „protected by reCAPTCHA” i zbiera sygnały dotyczące urządzenia oraz interakcji.
Dynamiczne nazwy klas CSS. Ponieważ Trustpilot korzysta z Next.js i CSS modules, nazwy takie jak styles_reviewCardInner__EwDq2 są generowane podczas builda i zmieniają się przy każdym wdrożeniu aktualizacji. Własny poradnik ScraperAPI opiera się właśnie na tych selektorach — co oznacza, że każdy kod korzystający z tego tutoriala przestanie działać przy następnej zmianie frontendu.
Zmiany struktury DOM. Poza nazwami klas może zmieniać się także sama hierarchia HTML. Elementy bywają inaczej zagnieżdżone, pojawiają się nowe wrappery, a komponenty paginacji są przebudowywane.
Scrapery oparte na selektorach CSS — niezależnie od tego, czy są to Apify Actors, workflowy Octoparse, czy własne skrypty w Pythonie — są na Trustpilot strukturalnie kruche. Działają, dopóki przestają działać. A „dopóki przestają” często oznacza tygodnie, a nie miesiące.
Czego szukaliśmy w najlepszych scraperach opinii Trustpilot
Nie oceniałem tych narzędzi według ogólnego kryterium „czy potrafi pobrać stronę internetową”. Każde narzędzie z tej listy umie wyciągnąć dane z prostej strony HTML.
Pytanie brzmi: czy poradzi sobie konkretnie z Trustpilot, ze wszystkimi jego niuansami, w 2026 roku?
Najważniejsze kryteria:
| Kryterium | Dlaczego ma znaczenie w Trustpilot |
|---|---|
| Obsługa blokady logowania (strona 10+) | Większość firm ma znacznie więcej niż 200 opinii. Limit 10 stron oznacza utratę większości danych historycznych. |
| Podejście do obejścia anty-bot | reCAPTCHA, blokowanie sesji i filtrowanie CDN zatrzymają naiwne scrapery w miejscu. |
| Odporność selektorów / utrzymanie | Generowane klasy CSS regularnie psują narzędzia oparte na selektorach. Czy narzędzie potrafi się samonaprawić? |
| Obsługa paginacji | Opinie mogą zajmować setki stron. Ręczne pobieranie strona po stronie nie wchodzi w grę. |
| No-code vs. wymagany kod | Marketerzy potrzebują prostego kliknięcia, developerzy chcą pełnej kontroli. |
| Cena / darmowy plan | Zespoły z ograniczonym budżetem potrzebują jasności przed zakupem. |
| Opcje eksportu | Użytkownicy biznesowi potrzebują Google Sheets, Airtable, Notion — nie tylko surowego JSON-a. |
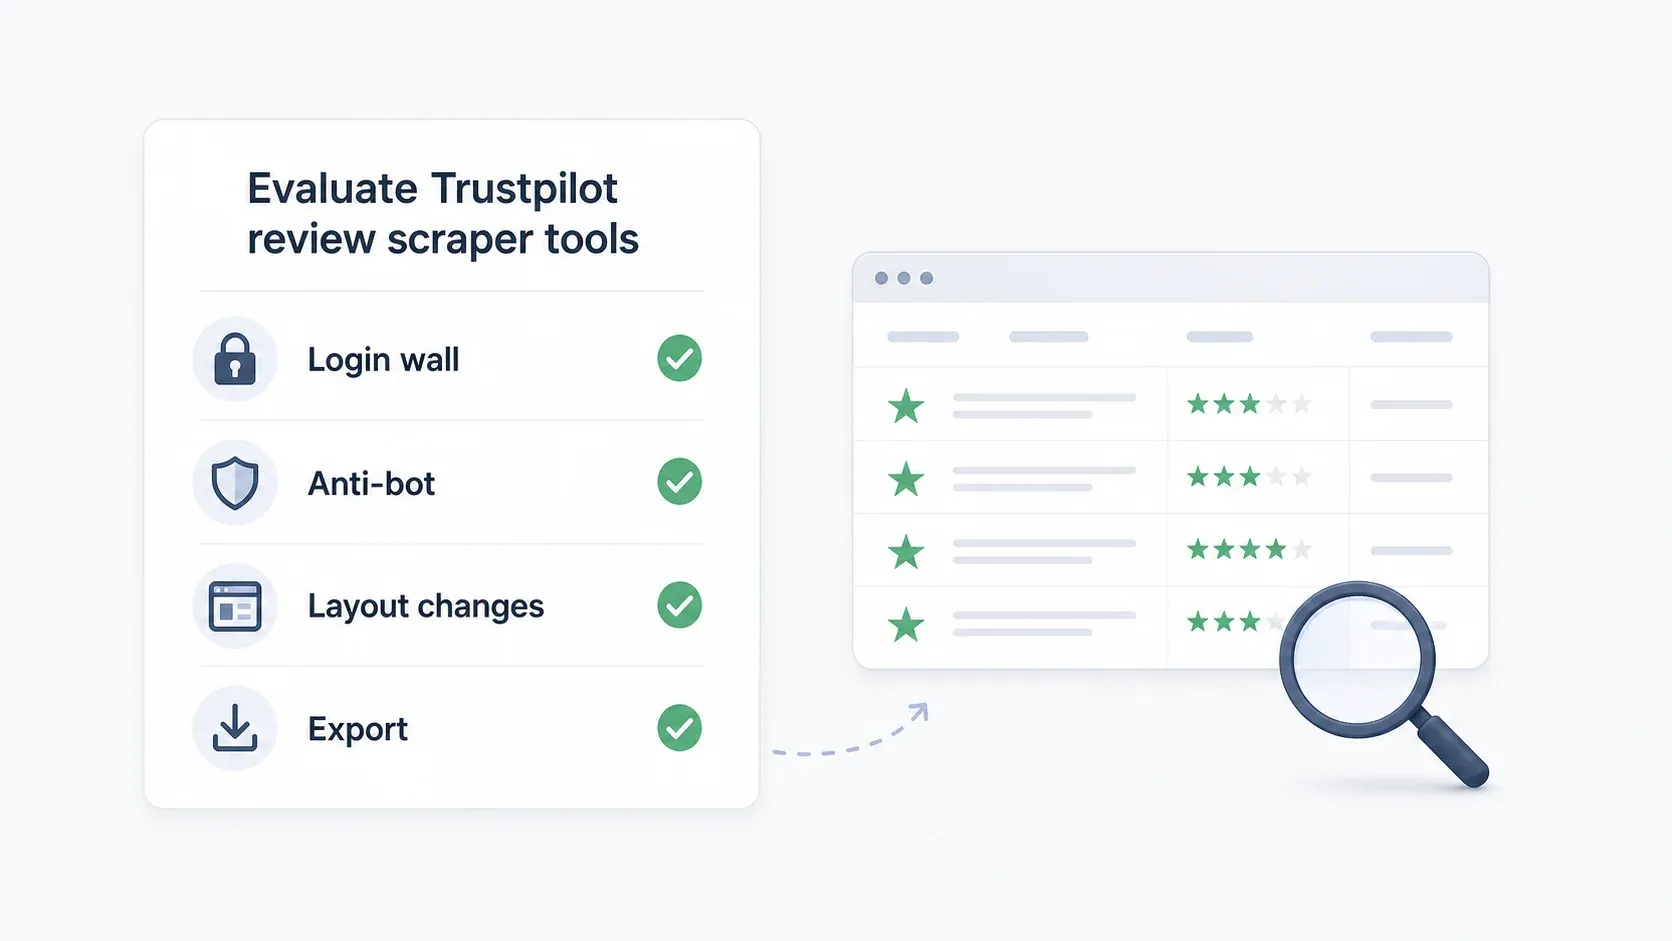
Blokada logowania to czynnik decydujący.
Jeśli narzędzie nie potrafi przejść dalej niż 10. strona — albo przynajmniej nie daje jasnej ścieżki dostępu uwierzytelnionego — w 2026 roku nie jest realnym scraperem Trustpilot.
Najlepsze scrapery Trustpilot Reviews w skrócie
Pełne porównanie:
| Narzędzie | Poziom techniczny | Obsługa blokady logowania | Podejście anty-bot | Paginacja | Darmowy plan | Opcje eksportu |
|---|---|---|---|---|---|---|
| Thunderbit | No-code | Tryb przeglądarkowy (korzysta z Twojej zalogowanej sesji Chrome) | Semantyczna ekstrakcja AI dopasowuje się do zmian układu | Automatyczne wykrywanie, wiele stron | 6 stron za darmo / miesiąc | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Zależne od Actora; część wymaga cookies dla stron >10 | Wbudowana rotacja proxy, zależna od Actora | Konfigurowalna dla każdego Actora | $5/mies. w darmowych kredytach platformy | JSON, CSV, Excel, XML, RSS |
| Octoparse | No-code (wizualne) | Ręczna konfiguracja cookie/sesji | Rotacja IP, proxy residential, rozwiązywanie CAPTCHA (płatne) | Workflow oparty na klikaniu/przewijaniu | Darmowy plan + 14-dniowy trial premium | CSV, Excel, JSON, HTML, XML, bazy danych |
| Web Scraper | No-code (sitemap) | Ograniczona — własna dokumentacja opisuje limit 10 stron opinii | Chmura + proxy w płatnych planach | Konfigurowalna; zalecane klikanie JS | Darmowe rozszerzenie Chrome | CSV, XLSX |
| ScraperAPI | Developer (Python) | Zarządzanie sesją/cookies na poziomie kodu | Ponad 40 mln proxy residential, renderowanie JS, obsługa CAPTCHA | Oparte na kodzie | 7-dniowy trial, 5 000 kredytów API | Określane przez developera (CSV, JSON itd.) |
1. Thunderbit

Thunderbit to rozszerzenie Chrome oparte na AI, stworzone dla zespołów biznesowych, które potrzebują danych ustrukturyzowanych ze stron internetowych bez pisania kodu. Dla Trustpilot oferuje dedykowany szablon do scrapowania opinii, który jednym kliknięciem pobiera imię recenzenta, ocenę, tytuł opinii, treść recenzji, datę oraz odpowiedź firmy.
Jestem stronniczy — pracuję tutaj — ale powód, dla którego zbudowaliśmy Thunderbit właśnie w ten sposób, bezpośrednio wynika z tego, jak trudne jest scrapowanie Trustpilot. Nasza AI czyta strony semantycznie, zamiast polegać na selektorach CSS. Gdy Trustpilot zmienia nazwy klas albo przebudowuje DOM, Thunderbit nadal działa, bo szuka znaczenia elementów strony, a nie ich konkretnych adresów HTML.
Wypróbuj Thunderbit do scrapowania Trustpilot
Jak Thunderbit radzi sobie z blokadą logowania po 10. stronie
Tutaj kluczowy jest tryb przeglądarkowy. Thunderbit działa w Twojej przeglądarce Chrome — tej samej, w której jesteś już zalogowany do Trustpilot. Gdy przełączysz się na tryb scrapowania w przeglądarce, rozszerzenie odczytuje strony widoczne w Twojej uwierzytelnionej sesji. Bez kombinowania z proxy. Bez wstrzykiwania cookies. Bez puli sesji Playwright.
Praktyczny proces wygląda tak: zaloguj się do Trustpilot w Chrome, przejdź do interesującej Cię strony opinii i otwórz rozszerzenie. Jedno kliknięcie i AI samo rozpoznaje pola recenzji na stronie oraz wykonuje ekstrakcję. Chcesz inny zakres danych? Opisz go, a AI dostosuje się do Twojej prośby. Od tego momentu paginacja odbywa się automatycznie — Thunderbit przechodzi przez wszystkie strony dostępne w Twojej sesji przeglądarki.
Dlaczego Thunderbit nie psuje się, gdy Trustpilot coś zmienia
Nasza strona szablonu Trustpilot pokazuje to wprost: tradycyjne scrapery przestają działać, gdy zmienia się układ strony i trzeba aktualizować selektory CSS. Thunderbit używa semantycznej AI, która rozumie treść bez polegania na konkretnym CSS, obsługuje dynamiczną zawartość i automatyczną paginację.
Porównaj to z kodem z tutoriala ScraperAPI, który parsuje dane po nazwach klas, takich jak styles_reviewCardInner__EwDq2. Ten selektor przestanie działać przy następnej aktualizacji Trustpilot. AI Thunderbit pyta: „gdzie na tej stronie jest tekst opinii?”, zamiast: „co znajduje się w tym konkretnym divie?”
Najważniejsze funkcje do scrapowania Trustpilot
- Pola wykrywane przez AI: rozszerzenie samo znajduje pola recenzji (imię, ocena, data, tytuł, treść, odpowiedź firmy) bez ręcznej konfiguracji — albo, jeśli masz konkretny zestaw na myśli, wystarczy go opisać
- Workflow jednym kliknięciem: jedno kliknięcie → gotowa tabela. To wszystko.
- Tryb przeglądarkowy dla stron wymagających logowania: działa w Twojej uwierzytelnionej sesji Chrome, dzięki czemu masz dostęp do stron 10+
- Automatyczna paginacja: obsługuje wielostronicowe zestawy opinii bez ręcznej ingerencji
- Scraping podstron: może odwiedzać indywidualne profile recenzentów w celu wzbogacenia danych
- Zaplanowane scrapowanie: ustaw tygodniowe lub miesięczne monitorowanie opinii do śledzenia reputacji
- Eksporty: Google Sheets, Airtable, Notion, CSV, JSON — wszystko w cenie darmowego planu
Cennik
- Darmowy plan: 6 stron/miesiąc, bez karty kredytowej
- System kredytowy: 1 kredyt = 1 wiersz wyniku
- Płatne plany: $15/miesiąc lub około $9/miesiąc przy rozliczeniu rocznym (strona cennika)
Dla kogo: zespoły marketingowe, operacyjne i użytkownicy biznesowi, którzy potrzebują opinii z Trustpilot bez dotykania kodu — i którzy nie chcą utrzymywać scrapera psującego się co kilka tygodni.
2. Apify
Apify to platforma do scrapowania w chmurze z marketplace’em gotowych „Actorów” — szablonów scrapingowych tworzonych przez innych użytkowników i zespół Apify. W przypadku Trustpilot sklep zawiera wiele Actorów utrzymywanych przez społeczność, ale ich niezawodność bywa różna.
Z Apify jest tak, że może być potężne, ale też rozdrobnione. Niektóre Actorzy działają. Niektóre są przestarzałe. Niektóre wymagają cookies dla stron 10+. A skargi z Reddita, że „żaden z actorów w sklepie nie działa”, są realne — pokazują, jak szybko zmiany w Trustpilot potrafią rozbić logikę zależną od konkretnego Actora.
Actorzy Trustpilot i znane ograniczenia
Apify Store zawiera kilka Actorów do Trustpilot. Co najmniej jeden z nich (autorstwa dewelopera „burbn”) wyraźnie informuje, że dla stron powyżej 10 wymagane jest podanie cookie. Inne mają ocenę 0.0, bardzo mało użytkowników albo bardzo świeże daty modyfikacji — sygnały, że utrzymanie trwa, ale niezawodność jest zmienna.
Warto też zwrócić uwagę na przestarzałe Actorzy. Jeden starszy Actor odczytywał bezpośrednio JSON __NEXT_DATA__ osadzony przez Trustpilot — sprytne i szybsze niż parsowanie DOM, ale nadal podatne na awarie, gdy Trustpilot zmienia strukturę danych.
Obsługa blokady logowania i anty-bot
- Blokada logowania: wszystko zależy od wybranego Actora. Niektóre wspierają wstrzykiwanie cookies dla stron 10+; inne nie.
- Anty-bot: platforma Apify obejmuje rotację proxy i infrastrukturę opartą o compute units. Proxy residential są dostępne w cenie $8/GB w planach Free/Starter.
- Utrzymanie: gdy Actor przestaje działać, czekasz aż opiekun go naprawi, przełączasz się na innego Actora albo zamawiasz własnego prywatnego Actora.
Cennik
- Darmowy plan: $5/miesiąc w przedpłaconych zasobach, bez karty kredytowej
- Starter: $9/miesiąc + model pay-as-you-go
- Scale: $99/miesiąc + pay-as-you-go
- Eksporty: JSON, CSV, Excel, XML, RSS (zależnie od Actora)
Dla kogo: użytkownicy techniczni, którzy potrafią oceniać różne Actorzy, konfigurować cookies i rozwiązywać problemy, gdy coś przestaje działać. Nie jest to idealne rozwiązanie dla zespołów szukających opcji „ustaw i zapomnij”.
3. Octoparse
Octoparse to desktopowy scraper no-code z wizualnym kreatorem workflow typu point-and-click. Sytuuje się pomiędzy prostotą jednego kliknięcia w Thunderbit a pełną kontrolą developera w ScraperAPI — dostajesz konfigurację wizualną bez kodu, ale nadal budujesz i utrzymujesz workflow.
Jak skonfigurować scrapowanie Trustpilot w Octoparse
Proces jest prosty, ale ręczny:
- Wklej URL opinii firmy z Trustpilot
- Wizualnie zaznacz elementy recenzji (tytuł, treść, ocena, data, imię recenzenta)
- Zdefiniuj pętlę paginacji za pomocą przycisku następnej strony
- Ustaw czasy oczekiwania (zalecane 2–5 sekund, by uniknąć reCAPTCHA)
- Uruchom lokalnie dla małych próbek albo w chmurze dla większych zadań
Konfiguracja zajmuje 10–15 minut osobie, która zna narzędzie. Problem polega na tym, że ponieważ Octoparse korzysta z wizualnych selektorów powiązanych z elementami DOM, przy każdej zmianie struktury strony Trustpilot trzeba zaktualizować workflow.
Obsługa blokady logowania i anty-bot
- Blokada logowania: wymaga ręcznego logowania / konfiguracji cookie / sesji. Nie jest obsługiwana automatycznie.
- Anty-bot: płatne plany obejmują rotację IP, proxy residential ($3/GB) oraz automatyczne rozwiązywanie CAPTCHA ($1–1,5 za tysiąc).
- Utrzymanie: umiarkowane. Trzeba liczyć się z przebudową lub korektą workflow po aktualizacji frontendu przez Trustpilot.
Cennik
- Darmowy plan: bezterminowo, 10 zadań, 1 urządzenie, ekstrakcja lokalna, do 50 000 wierszy/miesiąc
- Standard: $69/miesiąc (rozliczenie roczne)
- Professional: $149/miesiąc
- 14-dniowy trial premium: obejmuje ekstrakcję w chmurze, harmonogram, API i szablony
- Eksporty: Excel, CSV, JSON, HTML, XML; bazy danych i Google Sheets w wyższych planach
Dla kogo: użytkownicy, którzy chcą wizualnej kontroli nad workflow, nie przeszkadza im początkowa konfiguracja i są gotowi utrzymywać procesy, gdy strony się zmieniają. Dobre dla zespołów potrzebujących więcej personalizacji niż daje narzędzie jednym kliknięciem, ale mniejszej złożoności niż pisanie w Pythonie.
4. Web Scraper
Web Scraper to rozszerzenie Chrome i platforma chmurowa oparta na sitemapach. Najmocniejszą ofertą dla Trustpilot jest gotowy szablon do stron firmowych, który pobiera dane na poziomie firmy: nazwę, kategorię, adres, ocenę, liczbę opinii, TrustScore i URL strony.
W przypadku scrapowania samych recenzji Web Scraper ma jednak udokumentowane ograniczenie, które warto podkreślić.
Gotowy szablon vs. konfiguracja własna
Szablon z marketplace działa dobrze do wyszukiwania firm — czyli scrapowania profili biznesowych w kategoriach Trustpilot. Do niestandardowego pobierania recenzji kreator Sitemap Wizard pozwala zbudować scraper wizualnie wewnątrz rozszerzenia Chrome.
Własny przewodnik Web Scraper z marca 2026 r. zaleca paginację opartą na kliknięciu JavaScript, zamiast opierania się wyłącznie na URL-ach, ponieważ Trustpilot może dynamicznie przestawiać treść pomiędzy stronami, co powoduje przesuwanie wyników.
Obsługa blokady logowania i anty-bot
Tu liczy się szczerość: oficjalny przewodnik Web Scraper wprost mówi, że Trustpilot pozwala zobaczyć tylko pierwsze 10 stron opinii, po czym pojawia się monit o zalogowanie. Dokumentują to jako znane ograniczenie, bez oferowania obejścia.
- Blokada logowania: ograniczona obsługa. Limit 10 stron opinii jest opisany w ich własnym przewodniku.
- Anty-bot: plany chmurowe obejmują obsługę proxy; przewodnik zaleca opóźnienia 2–5 sekund i zmniejszenie współbieżności.
- Paginacja: konfigurowalna, ale w praktyce ograniczona do pierwszych 10 stron opinii przy dostępie bez logowania.
Cennik
- Darmowe rozszerzenie Chrome: lokalne scrapowanie, ograniczona funkcjonalność
- Project: $50/miesiąc (5 000 kredytów URL)
- Professional: $100/miesiąc (20 000 kredytów URL)
- Scale: od $200/miesiąc (nieograniczone kredyty URL pod pewnymi warunkami)
- 7-dniowy darmowy trial w płatnych planach chmurowych
- Eksporty: CSV, XLSX
Dla kogo: użytkownicy, którzy chcą gotowego szablonu do scrapowania profili firm Trustpilot albo potrzebują wyłącznie opinii z pierwszych 10 stron. To nie jest najlepszy wybór, jeśli potrzebujesz pełnej historii opinii dla firm z dużą liczbą recenzji.
5. ScraperAPI
ScraperAPI to infrastruktura scrapingowa dla developerów — nie narzędzie typu point-and-click, lecz warstwa proxy/renderingu, która obsługuje zabezpieczenia anty-bot, podczas gdy Ty piszesz logikę parsowania. Ich strona rozwiązania dla Trustpilot promuje renderowanie JS, obsługę CAPTCHA i ponad 40 milionów proxy.
Jeśli jesteś Python developerem i chcesz pełnej kontroli nad logiką ekstrakcji, ScraperAPI daje Ci fundament.
Ale za utrzymanie odpowiadasz już sam.
Budowanie własnego scrapera Trustpilot z ScraperAPI
Poradnik ScraperAPI ze stycznia 2026 r. pokazuje workflow w Pythonie i BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
Gotowy kod w tym tutorialu ustawia pages_to_scrape = 10 — co pośrednio potwierdza publiczny limit stron. Dla stron 10+ developerzy muszą samodzielnie zarządzać sesjami uwierzytelnionymi, cookies i tokenami.
Obsługa blokady logowania i anty-bot
- Blokada logowania: wymagane zarządzanie sesją/cookies na poziomie kodu. ScraperAPI obsługuje proxy i renderowanie; logikę uwierzytelnienia obsługujesz Ty.
- Anty-bot: pula proxy residential z automatyczną rotacją IP, renderowanie JS przez
render=true, obsługa CAPTCHA poprzez inteligentną rotację proxy. Dostępne w każdym planie. - Utrzymanie: gdy Trustpilot zmienia nazwy klas (co robi regularnie), musisz zaktualizować kod parsowania. Selektor
styles_reviewCardInner__EwDq2z tutoriala to tykająca bomba.
Cennik
- 7-dniowy trial: 5 000 darmowych kredytów API, bez karty kredytowej
- Hobby: $49/miesiąc (100 000 kredytów API)
- Startup: $149/miesiąc (1 000 000 kredytów)
- Business: $299/miesiąc (3 000 000 kredytów)
- Eksporty: wszystko, co wygeneruje Twój kod (zwykle CSV, JSON, zapisy do bazy danych)
Dla kogo: developerzy, którzy chcą pełnej personalizacji, potrafią utrzymywać własne skrypty parsujące i potrzebują programowalnej kontroli nad sesjami, logiką paginacji i strukturą danych. Nie dla użytkowników nietechnicznych.
Dlaczego scrapery Trustpilot ciągle się psują (i jak wybrać taki, który nie będzie)
To najbardziej niedoceniany czynnik przy wyborze scrapera Trustpilot. Pytanie nie brzmi: „czy to narzędzie działa dziś?” Pytanie brzmi: „czy będzie działać za trzy tygodnie?”
Scrapery psują się na Trustpilot z czterech powtarzalnych powodów:
-
Zmiany generowanych klas CSS. Moduły CSS w Next.js tworzą nazwy takie jak
styles_reviewCardInner__EwDq2. Zmieniają się one przy każdym wdrożeniu frontendu. Każdy scraper, który celuje w te klasy, przestaje działać. -
Zmiany struktury DOM. Trustpilot może przebudować hierarchię HTML — inaczej zagnieżdżać karty opinii, zmieniać elementy opakowujące, przenosić metadane w inne miejsca.
-
Zmiany wyzwalaczy anty-bot. Progi reCAPTCHA się przesuwają. Rotacja tokenów sesyjnych staje się bardziej agresywna. Reguły filtrowania CDN są aktualizowane.
-
Zmiany uwierzytelniania/sesji. Blokada logowania po 10. stronie została wprowadzona (lub zaczęła być egzekwowana dużo surowiej) pod koniec 2025 roku. Kolejne ograniczenia dostępu mogą pojawić się w dowolnym momencie.
Fundamentalna różnica architektoniczna polega na tym, że mamy ekstrakcję opartą na selektorach i ekstrakcję semantyczną:
-
Narzędzia selektorowe (Apify Actors, workflowy Octoparse, skrypty ScraperAPI, sitemapy Web Scraper) pytają: „Znajdź element dokładnie pod tą ścieżką CSS”. Gdy ścieżka się zmienia, narzędzie zawodzi po cichu albo zwraca puste dane.
-
Narzędzia semantyczne / AI (Thunderbit) pytają: „Znajdź tekst opinii, ocenę i datę na tej stronie”. AI interpretuje zawartość przez znaczenie, a nie przez adres. Zmiany układu nie psują działania, bo znaczenie pozostaje to samo.
Moja rekomendacja:
- Nie chcesz żadnego utrzymania? → narzędzie oparte na AI (Thunderbit)
- Dopuszczasz trochę utrzymania i chcesz automatyzacji w chmurze? → Apify (z doborem Actora i monitoringiem)
- Chcesz wizualnej kontroli i umiarkowanego utrzymania? → Octoparse
- Potrzebujesz rozwiązania opartego na szablonach, o ograniczonym zakresie? → Web Scraper
- Chcesz pełnej kontroli i brać odpowiedzialność za wszystko? → ScraperAPI
Co zrobić ze scrapowanymi opiniami Trustpilot
Samo pobranie recenzji to dopiero pierwszy krok. W forach wciąż widzę to samo pytanie: „Mam dane — i co dalej?”
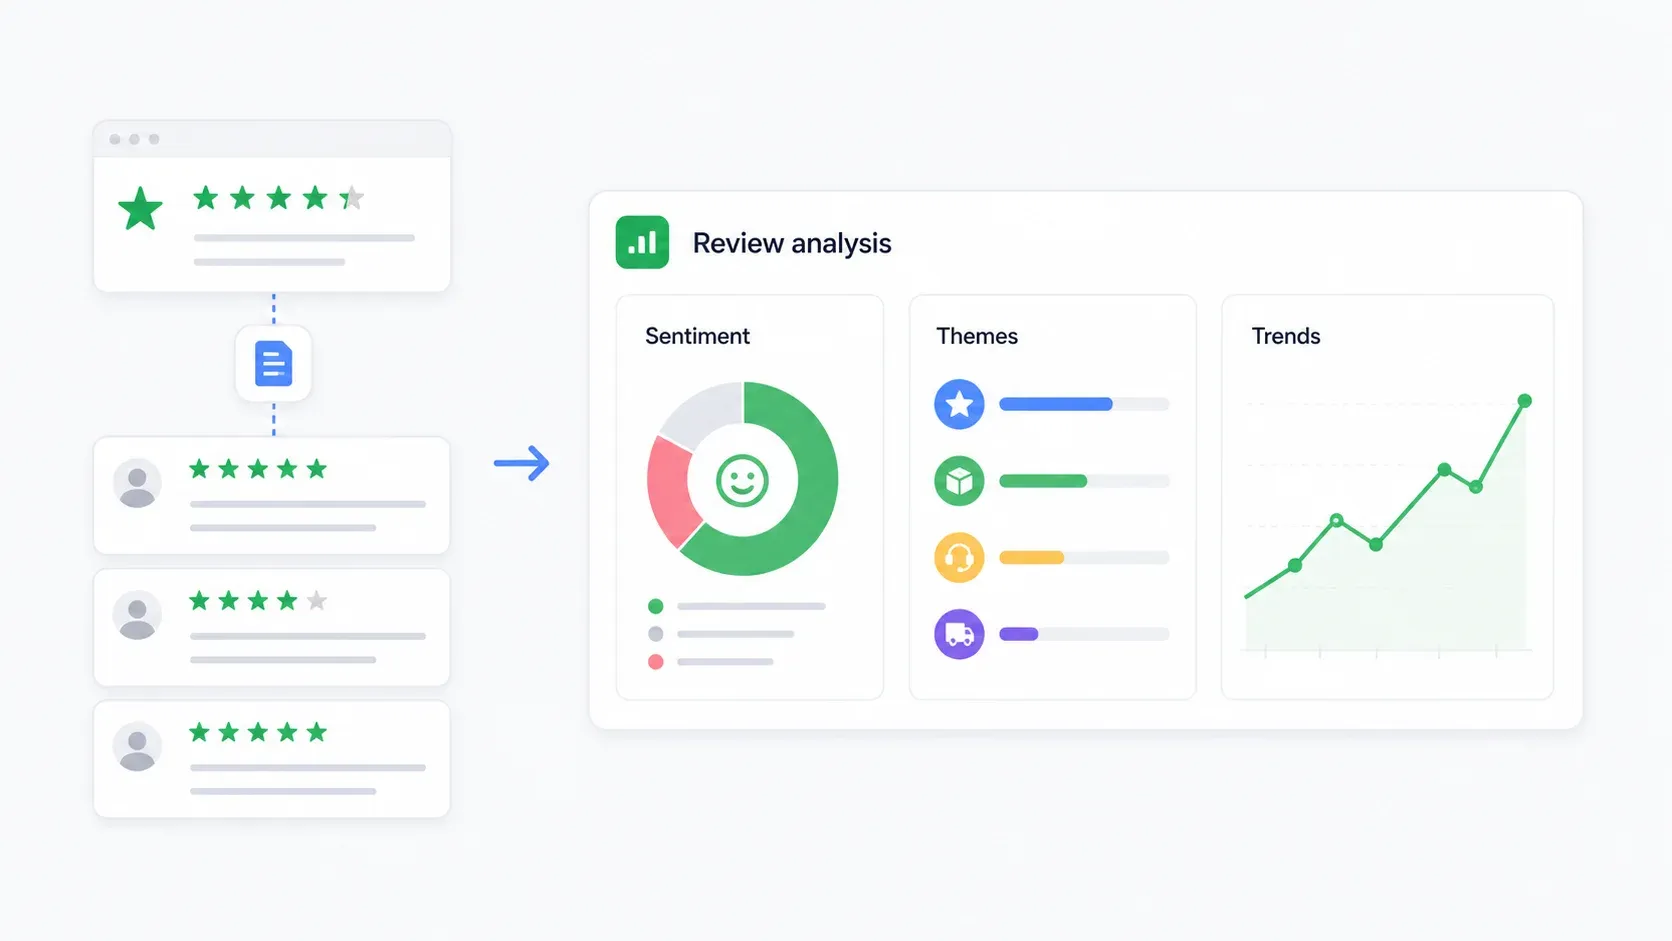
Analiza sentymentu
Najprostszy workflow: wyeksportuj opinie do Google Sheets, a następnie użyj narzędzia AI (ChatGPT, Claude albo funkcji AI w arkuszu), aby sklasyfikować każdą opinię jako pozytywną, neutralną lub negatywną. Dodaj kolumny dla kategorii skargi, pilności i sugerowanego priorytetu działania.
Dla większych zbiorów danych możesz wgrać plik CSV do ChatGPT i poprosić o podsumowanie: „Skategoryzuj te opinie według sentymentu i wskaż 5 głównych tematów skarg z reprezentatywnymi cytatami”.
Monitoring konkurencji
Użyj zaplanowanego scrapowania w Thunderbit, aby pobierać opinie konkurencji co tydzień lub co miesiąc. Śledź:
- Trend średniej oceny w czasie
- Udział opinii 1-gwiazdkowych i 2-gwiazdkowych
- Zmiany wolumenu opinii (czy pojawia się ich więcej, czy mniej?)
- Najczęstsze tematy skarg
- Wskaźnik i szybkość odpowiedzi firmy
Prosty dashboard w Google Sheets z tabelami przestawnymi według oceny i daty daje Ci automatycznie aktualizowany feed intelligence konkurencyjnej.
Ekstrakcja tematów
Grupuj opinie według wspólnych kategorii: wysyłka/dostawa, obsługa klienta, zwroty, jakość produktu, rozliczenia, użyteczność aplikacji, cena/wartość oraz obawy związane z oszustwem. Wynik powinien być tabelą pokazującą: temat, liczbę wystąpień, średnią ocenę, reprezentatywne cytaty i sugerowane działanie biznesowe.
To jest bardziej użyteczne niż chmura słów. Pokazuje, co naprawdę napędza zadowolenie albo niezadowolenie.
Hurtowa analiza wielu firm
Do badań na poziomie kategorii scrapuj opinie z wielu firm w tej samej kategorii Trustpilot. Porównuj wolumen opinii, oceny, rozkład gwiazdek i częstość występowania tematów w całym segmencie rynku. Szablon list firm w Web Scraper nadaje się do wykrywania spółek; Thunderbit lub ScraperAPI mogą obsłużyć próbki opinii dla każdej z nich.
Aspekty prawne i etyczne scrapowania Trustpilot
Nie jestem prawnikiem i to nie jest porada prawna. Ale kwestie zgodności mają tu znaczenie.
Warunki korzystania z Trustpilot są jednoznaczne. Zabraniają użytkownikom dostępu do treści lub ich gromadzenia „w jakikolwiek inny sposób niż przewidziany lub wyraźnie zatwierdzony przez Trustpilot” i wprost wskazują na text mining, data mining oraz web scraping bez wyraźnej zgody.
Spektrum ryzyka wygląda tak:
- Niższe ryzyko: eksport własnych opinii firmy do analizy wewnętrznej, zwłaszcza przy użyciu oficjalnych narzędzi biznesowych lub API Trustpilot.
- Umiarkowane ryzyko: scrapowanie publicznych stron konkurencji w niskim wolumenie do badań rynkowych. Nadal podlega ToS i obowiązkom związanym z prywatnością.
- Wyższe ryzyko: scrapowanie treści za blokadą logowania po 10. stronie, omijanie zabezpieczeń technicznych, redystrybucja danych recenzentów albo wykorzystywanie zebranych opinii do trenowania modeli AI.
Kwestie GDPR: imię recenzenta, link do profilu, treść opinii i lokalizacja mogą stanowić dane osobowe w świetle prawa UE. Praktyczne zabezpieczenia obejmują zbieranie wyłącznie potrzebnych pól, haszowanie nazw recenzentów na potrzeby analityki wewnętrznej, ustalanie okresów retencji danych oraz niepublikowanie surowych treści opinii na dużą skalę.
Dane publiczne vs. uwierzytelnione: istnieje istotna różnica prawna i etyczna między scrapowaniem stron dostępnych dla każdego (pierwsze 10 stron opinii) a scrapowaniem danych za barierą logowania. Narzędzia korzystające wyłącznie z danych publicznych niosą niższe ryzyko zgodności niż te wymagające poświadczeń logowania.
To powinno mieć wpływ na wybór narzędzia. Tryb przeglądarkowy Thunderbit działa na stronach widocznych w Twojej własnej sesji — nie omija uwierzytelnienia samodzielnie. ScraperAPI daje developerom pełną kontrolę, ale także pełną odpowiedzialność za legalność zarządzania sesją.
Jak wybrać odpowiedni scraper opinii Trustpilot
Framework decyzyjny według profilu użytkownika:
- Nietechniczny marketer, który potrzebuje opinii bez kodu? → Thunderbit. Jedno kliknięcie, AI robi resztę, eksport do Sheets/Notion/Airtable.
- Użytkownik low-code, który czuje się dobrze z konfiguracją i debugowaniem? → Apify. Wybierz Actora, skonfiguruj cookies dla strony 10+, monitoruj awarie.
- Budujesz wizualnie i chcesz kontroli nad workflow? → Octoparse. Konfiguracja point-and-click, ale licz się z utrzymaniem, gdy Trustpilot coś zmieni.
- Potrzebujesz danych na poziomie firm albo tylko opinii z pierwszych 10 stron? → Web Scraper. Mocne gotowe szablony dla profili biznesowych.
- Developer, który chce pełnej personalizacji? → ScraperAPI. Sam zarządzasz logiką parsowania, sesjami i pipeline’em danych.
Jeśli najważniejsza jest dla Ciebie niska potrzeba utrzymania, skala wygląda od Thunderbit (praktycznie zero utrzymania) do ScraperAPI (utrzymujesz wszystko sam). Pod względem budżetu każde narzędzie z tej listy ma darmowy punkt startowy — warto zacząć tam, zanim cokolwiek kupisz.
Podsumowanie
Dane z recenzji Trustpilot są naprawdę cenne dla monitorowania konkurencji, reputacji marki i wniosków o klientach.
Ale w 2026 roku ich niezawodne pobieranie wymaga narzędzia, które poradzi sobie z blokadą logowania po 10. stronie, dostosuje się do zmian DOM i obejdzie zabezpieczenia anty-bot bez ciągłej ręcznej interwencji.
Dla większości użytkowników biznesowych Thunderbit jest najprostszą drogą — jedno kliknięcie, wykrywanie pól oparte na AI, tryb przeglądarkowy dla stron uwierzytelnionych i brak konieczności utrzymania, gdy Trustpilot zmienia frontend. Możesz wypróbować go za darmo z limitem 6 stron miesięcznie i bez karty kredytowej.
Dla developerów, którzy chcą pełnej kontroli, ScraperAPI zapewnia infrastrukturę. Dla wszystkich pomiędzy Apify, Octoparse i Web Scraper odpowiadają na konkretne potrzeby. Najważniejsze jest dopasowanie narzędzia do Twojego poziomu technicznego, tolerancji na utrzymanie i wymogów zgodności.
Jeśli chcesz zobaczyć, jak Thunderbit radzi sobie konkretnie z Trustpilot, mamy przewodnik na naszym kanale YouTube. A jeśli szukasz szerszego kontekstu na temat web scrapingu bez kodu albo czym właściwie jest web scraping, te poradniki wyjaśniają podstawy.
FAQ
1. Czy da się scrapować opinie Trustpilot poza 10. stronę?
Tak, ale tylko z uwierzytelnioną ścieżką dostępu. Trustpilot blokuje dostęp bez logowania po pierwszych 10 stronach opinii. Tryb przeglądarkowy Thunderbit działa w Twojej zalogowanej sesji Chrome, więc może odczytywać strony, które widzisz. ScraperAPI wymaga zarządzania sesją/cookies na poziomie kodu. Actorzy Apify potrzebują konfiguracji cookie. Octoparse wymaga ręcznego logowania i ustawienia cookies. Dokumentacja Web Scraper sama przyznaje istnienie limitu 10 stron i nie oferuje wbudowanego obejścia.
2. Czy scrapowanie opinii Trustpilot jest legalne?
Warunki korzystania z Trustpilot zabraniają automatycznego gromadzenia danych bez wyraźnej zgody. Ryzyko prawne zależy od metody i zastosowania: pobieranie własnych publicznych opinii wiąże się z mniejszym ryzykiem niż obchodzenie blokad uwierzytelnienia w celu scrapowania konkurencji. Do danych recenzentów z UE zastosowanie ma GDPR. To nie jest porada prawna — przy projektach na dużą skalę lub komercyjnych skonsultuj się z prawnikiem.
3. Jakie dane można wyciągnąć z Trustpilot?
Typowe pola to: imię recenzenta, ocena gwiazdkowa, tytuł opinii, treść recenzji, data publikacji, data doświadczenia, status zweryfikowanego zakupu, lokalizacja recenzenta, treść odpowiedzi firmy, nazwa firmy, TrustScore, łączna liczba opinii, rozkład gwiazdek i URL opinii.
4. Jak często psują się scrapery Trustpilot?
Narzędzia oparte na selektorach (Actorzy Apify, workflowy Octoparse, własne skrypty Python) mogą przestać działać za każdym razem, gdy Trustpilot zmieni klasy CSS albo strukturę DOM — a to może zdarzać się nawet kilka razy w miesiącu. Narzędzia AI-semantyczne, takie jak Thunderbit, dostosowują się automatycznie, bo interpretują znaczenie strony zamiast celować w konkretne selektory. Jednak żadne narzędzie nie jest odporne na duże zmiany w kontroli dostępu, takie jak blokada logowania po 10. stronie.
5. Czy mogę scrapować opinie Trustpilot za darmo?
Każde narzędzie z tej listy ma darmowy punkt startowy: Thunderbit oferuje 6 darmowych stron miesięcznie, ScraperAPI daje 5 000 kredytów próbnych na 7 dni, Web Scraper ma darmowe rozszerzenie Chrome do lokalnego użytku, Octoparse ma plan darmowy na zawsze (10 zadań, 50 000 wierszy/miesiąc), a Apify zapewnia $5 miesięcznie w darmowych kredytach platformy. Do małych próbek lub testów każde z tych rozwiązań sprawdzi się bez płacenia.
Wypróbuj Thunderbit do scrapowania opinii Trustpilot Get Started Free
Dowiedz się więcej



