
Google dziś obsługuje grubo ponad 8,5 miliarda wyszukiwań dziennie — według niektórych szacunków bliżej 14 miliardów — i ta liczba wciąż rośnie. Ten ocean danych z wyszukiwarki to prawdziwa kopalnia złota dla zespołów SEO, sales ops, analityków ecommerce, a coraz częściej także dla agentów AI, którzy potrzebują świeżych dowodów z sieci. Problem w tym, że wybór SERP API w 2026 roku przypomina mniej dobór narzędzia, a bardziej rozplątywanie labiryntu cenników, systemów kredytowych i mętnych obietnic o „ustrukturyzowanym JSON-ie”.
Przez ostatnich kilka tygodni sprawdzałem osiem dostawców SERP API — testowałem czasy odpowiedzi, porównywałem ceny w różnych, często mylących modelach rozliczeń i sprawdzałem, które elementy SERP faktycznie trafiają do pól strukturalnych. Cel był prosty: dać Ci uczciwe porównanie „jabłko do jabłka”, jakiego nie znajdziesz nigdzie indziej. Omawiamy szybkość, realny koszt przy większej skali, zakres parsowania, gotowość pod agentów AI i niezawodność produkcyjną. Jeśli drażni Cię stwierdzenie „porównujesz strony z cennikami, a nie rzeczywiste wydatki” (to prawdziwy cytat z wątku na Reddicie, który znalazłem), ten tekst jest dla Ciebie.
Dlaczego w 2026 roku potrzebujesz SERP API — i dlaczego wybór jest tak trudny
SERP API to usługa hostowana, która wysyła zapytanie do wyszukiwarki i zwraca stronę wyników w formacie możliwym do odczytu maszynowego — zwykle jako JSON. Zamiast samemu budować rotację proxy, obsługę CAPTCHA, renderowanie przeglądarki i parsery, po prostu wywołujesz endpoint i dostajesz z powrotem dane strukturalne. Koncepcja jest prosta, ale sam rynek — już nie.
Zastosowania dawno wykroczyły poza zwykły monitoring pozycji:
- Zespoły SEO potrzebują pozycji, widoczności snippetów, sekcji People Also Ask i analizy konkurencji.
- Zespoły sprzedaży i GTM wykorzystują SERP-y do wyszukiwania firm, stron z recenzjami, katalogów i sygnałów zakupowych.
- Zespoły ecommerce monitorują Google Shopping, reklamy płatne i ceny konkurencji.
- Deweloperzy AI przekazują dane SERP do agentów LLM, pipeline’ów RAG i narzędzi workflow, takich jak n8n czy LangChain.
Rynek web scrapingu ma osiągnąć 2,23 mld USD do 2031 roku, rosnąc w tempie około 13,78% CAGR. SERP API stanowią z tego sporą część.
Największa frustracja jest taka: każdy dostawca obiecuje „ustrukturyzowany JSON”, ale realny zakres parsowanych elementów SERP — PAA, panele wiedzy, lokalne pakiety wyników, reklamy shoppingowe, featured snippets — mocno się różni. Cenniki też nie są przejrzyste. Jedni liczą za wyszukiwanie, inni za kredyty, jeszcze inni za wynik, a część stosuje różne stawki zależnie od poziomu szybkości albo lokalizacji. Jeden użytkownik Reddita ujął to świetnie: „SerpApi rozlicza się za udane wyszukiwanie, ScraperAPI opakowuje wszystko w kredyty, a Serperdev wygląda tanio, dopóki nie przeliczysz kredytów na realne obciążenie”.
Ten artykuł wypełnia luki, których nie udało mi się znaleźć nigdzie indziej: macierz parsowania pokazującą, co każde API faktycznie zwraca, znormalizowane ceny przy 1K/10K/100K zapytań, dopasowanie do agentów AI oraz dane o gotowości produkcyjnej.
Jak testowaliśmy: kryteria wyboru najlepszego SERP API
Oceniłem każdego dostawcę w ośmiu wymiarach, które bezpośrednio odpowiadają na potrzeby użytkowników produkcyjnych. Większość artykułów porównawczych omawia dwa albo trzy z nich bardzo pobieżnie. Ja chciałem wszystkich ośmiu — i to z konkretnymi dowodami.
Szybkość i czas odpowiedzi. Korzystałem z benchmarków stron trzecich — zwłaszcza z porównania HasData — oraz dokumentacji dostawców. Szybkość ma znaczenie, gdy budujesz dashboardy działające w czasie rzeczywistym albo agentów AI korzystających z wywołań narzędzi, którzy nie mogą czekać 30 sekund na odpowiedź.
Cena w skali (1K, 10K, 100K zapytań). Przeliczyłem ceny każdego dostawcy na koszt 1 000 udanych zapytań. Tylko w ten sposób da się uczciwie porównać modele oparte na kredytach, subskrypcjach i pay-as-you-go.
Parsowane elementy SERP (nie tylko organiczne wyniki). Sprawdzałem dokumentację i przykładowe odpowiedzi, żeby potwierdzić, które elementy SERP każde API zwraca jako pola strukturalne — a nie tylko surowy HTML.
Dostępność darmowego planu i pay-as-you-go. Niski próg wejścia ma znaczenie. Jeśli nie możesz przetestować usługi na własnym realnym obciążeniu, zanim wydasz setki dolarów, to jest to czerwona flaga.
Integracja z AI i automatyzacją. W 2026 roku więcej zespołów potrzebuje zasilać SERP API agentów AI niż same dashboardy. Stabilność schematu, czyste wyjście i konwersja do Markdown mają znaczenie dla dalszego użycia przez LLM.
Obsługa wielu wyszukiwarek. Większość artykułów skupia się wyłącznie na Google. Sprawdzałem, które usługi wspierają Bing, Yandex, DuckDuckGo, Baidu i inne.
Limity i gotowość produkcyjna. Żaden z konkurencyjnych artykułów nie porównuje systematycznie rate limitów, polityki retry ani SLA. A przecież zespoły skalujące się do tysięcy zapytań dziennie tego potrzebują.
Przyjazność dla deweloperów. Jakość dokumentacji, dostępność SDK i czas do pierwszego wyniku.
1. Thunderbit
Thunderbit podchodzi do tego zupełnie inaczej niż tradycyjne SERP API. Zamiast oferować sztywne endpointy parsujące z góry określone elementy SERP, Extract API w Thunderbit pozwala zdefiniować własny JSON Schema — a AI wyciąga dokładnie te pola, które wskażesz, z dowolnej strony wyników wyszukiwania. Distill API zamienia dowolny URL w czysty Markdown gotowy dla LLM.
To oznacza, że Thunderbit działa na Google, Bing, Yandex, DuckDuckGo i każdej innej wyszukiwarce — AI odczytuje stronę od nowa za każdym razem, zamiast opierać się na twardo zakodowanych selektorach. Układ SERP zmienia się cały czas. Nie musisz czekać, aż dostawca zaktualizuje parser.
Najważniejsze funkcje
- Extract API: Definiujesz własny JSON Schema (wyniki organiczne, pytania PAA, lokalne firmy, produkty shoppingowe — cokolwiek potrzebujesz) i dostajesz dokładnie te pola jako dane strukturalne.
- Distill API: Zamienia dowolną stronę SERP w czysty Markdown — idealny do pipeline’ów RAG i podsumowań LLM.
- Wielowyszukiwarkowość z założenia: Działa na każdej dostępnej stronie wyszukiwania, nie tylko na Google.
- Przetwarzanie wsadowe: Obsługuje wiele URL-i równolegle.
- Wbudowana obsługa anty-bot: Rozwiązywanie CAPTCHA, renderowanie JS i rotacja proxy są w zestawie.
- Limity zależne od planu: Free (600 jednostek jednorazowo, 2 równoległe), Starter (60 000 jednostek/mies., 30 równoległych), Pro (600 000 jednostek/mies., 50 równoległych).
Cennik
Model oparty na kredytach. Distill kosztuje 1 kredyt za stronę; Extract kosztuje 20 kredytów za stronę. Dostępne są darmowe kredyty do testów. Przy przeliczeniu dla planu rocznego marginalny koszt Distill może wynosić nawet ok. 0,80 USD za 1K stron, a Extract około 16 USD za 1K stron przy pełnym wykorzystaniu. Wartość Extract polega na tym, że dostajesz dokładnie taki schemat, jakiego potrzebuje Twój system downstream — bez dodatkowego przetwarzania.
Aktualne pakiety znajdziesz na Thunderbit Pricing.
Wypróbuj Thunderbit do AI SERP Extraction
Najlepsze zastosowania
Workflowy agentów AI, pipeline’y RAG, scrapowanie wielowyszukiwarkowe, zespoły potrzebujące elastycznego schematu zamiast sztywnego formatu wyjściowego oraz każdy, kto ma dość czekania, aż dostawca doda obsługę nowego elementu SERP.
2. SerpApi
SerpApi to weteran w tej przestrzeni — działa od 2016 roku i oferuje najszerszy zestaw endpointów specyficznych dla Google. Obejmuje Google Search, Maps, Shopping, Scholar, News, Jobs, Trends, Images, Videos i wiele więcej.
Najważniejsze funkcje
- Dedykowane endpointy dla różnych produktów Google z dojrzałym geo-targetingiem (aż do poziomu miasta).
- Parsuje PAA, panele wiedzy, lokalne pakiety, reklamy, wyniki shoppingowe, featured snippets, answer boxes i podobne wyszukiwania jako pola strukturalne.
- Dobrze utrzymywana dokumentacja i biblioteki klienckie w wielu językach.
Cennik
250 darmowych wyszukiwań miesięcznie. Plan Starter: 25 USD/mies. za 1 000 wyszukiwań (czyli efektywnie 25 USD za 1K). Plan Developer (oznaczony jako „Most popular”): 75 USD/mies. za 5 000 wyszukiwań (~15 USD za 1K). Big Data: 275 USD/mies. za 30 000 wyszukiwań (~9,17 USD za 1K). Brak prostego pay-as-you-go — to model subskrypcyjny.
Szybkość i niezawodność
Benchmark HasData podaje ok. 5,49 s średniego czasu odpowiedzi — nie najszybciej, ale stabilnie. SerpApi deklaruje SLA dostępności na poziomie 99,95% dla planów płatnych, a limity równoległych zapytań zależą od planu.
Najlepsze zastosowania
Zespoły potrzebujące najszerszego pokrycia produktów Google (Maps, Scholar, Shopping, Jobs) z wysoką dokładnością i stabilnymi schematami. Projekty enterprise z budżetem na wyższy poziom cenowy.
3. Serper
Serper to opcja stawiająca na szybkość i koszt. To nowszy gracz, skupiony na szybkim scrapowaniu Google SERP przy bardzo konkurencyjnych cenach, który zdobył popularność w społecznościach n8n i LangChain dzięki integracjom z agentami AI.
Najważniejsze funkcje
- Czyste wyjście JSON dla Google Search, News, Scholar, Images, Shopping, Videos, Places, Patents i Autocomplete.
- Minimalna konfiguracja — wyniki możesz pobierać w mniej niż minutę.
- Na tyle prosty, że frameworki agentów AI integrują go natywnie.
Cennik
2 500 darmowych zapytań przy rejestracji. Ceny startowe ok. 0,001 USD za wyszukiwanie, spadając do ok. 0,00075 USD przy dużym wolumenie. Przyjazny model pay-as-you-go. Jedno zastrzeżenie: żądanie więcej niż 10 wyników na zapytanie może kosztować 2 kredyty (warto sprawdzić aktualne zachowanie w panelu).
Szybkość i niezawodność
Jeden z najszybszych w benchmarkach — HasData podaje ok. 2,87 s średnio. Wsparcie działa wyłącznie przez e-mail, a zespół utrzymuje dość niski profil publiczny, co niektórych użytkowników może powstrzymywać. Przy bardzo wysokiej współbieżności kilku recenzentów zgłasza obawy o niezawodność. W większości zastosowań jest jednak solidny.
Najlepsze zastosowania
Projekty z ograniczonym budżetem, startupy i integracje agentów AI potrzebujące szybkich i tanich danych Google SERP. Monitoring pozycji na dużą skalę, gdy koszt zapytania jest kluczowym ograniczeniem.
4. Scrapingdog
Scrapingdog jest na rynku od ponad 5 lat i regularnie pojawia się jako najszybszy w benchmarkach zewnętrznych. HasData zmierzyło go na ~1,25 s średniego czasu odpowiedzi przy 100% skuteczności.
Najważniejsze funkcje
- Google SERP API zwraca wyniki organiczne, PAA, featured snippets, reklamy i wyniki lokalne jako strukturalny JSON.
- Dostępne są zarówno surowy HTML, jak i parsowany JSON.
- Dokumentacja w wielu językach z fragmentami kodu dla większości języków programowania — start zajmuje minuty, nie godziny.
- Wsparcie 24/7.
Cennik
200 darmowych kredytów miesięcznie. Płatne plany zaczynają się około 40 USD/mies. Cena za wywołanie startuje od ok. 0,001 USD i spada mocno przy dużym wolumenie — niektóre porównania wskazują stawki nawet 0,000058 USD na najwyższych progach.
Szybkość i niezawodność
Wyniki szybkości są naprawdę imponujące. Jeśli Twój workflow jest wrażliwy na opóźnienia i wykonujesz duże wolumeny ekstrakcji Google SERP o stałym schemacie, trudno go przebić pod względem samego czasu odpowiedzi.
Najlepsze zastosowania
Narzędzia SEO i rank trackery pracujące na dużej skali, które potrzebują niskich opóźnień i niskiego kosztu. Zespoły budujące systemy produkcyjne, w których liczy się każda milisekunda odpowiedzi API.
5. DataForSEO
DataForSEO to nie tylko SERP API — to cała platforma API zaprojektowana dla firm tworzących produkty SEO. Obejmuje SERP, słowa kluczowe, backlinki, dane biznesowe, Google Ads, Trends i wiele więcej.
Najważniejsze funkcje
- Bardzo rozbudowane parsowanie elementów SERP — organiczne, płatne, lokalny pakiet, knowledge graph, PAA, featured snippets, shopping, obrazy, wideo, top stories i inne.
- Dwa tryby: Live (synchroniczny) dla dashboardów czasu rzeczywistego oraz Standard (asynchroniczny) dla workflow wsadowych, w których kolejkujesz zadania i pobierasz wyniki później.
- Wiele wyszukiwarek: Google, Bing, Yahoo, Baidu, Naver, Seznam i inne.
Cennik
Model pay-as-you-go, ale koszt zależy od endpointu, wyszukiwarki, urządzenia, priorytetu i trybu. Ceny SERP zwykle mieszczą się w zakresie ok. 0,0006–0,002 USD za zadanie dla organicznych wyników Google, zależnie od trybu standard/live i ustawień priorytetu. Dokumentacja jest rozbudowana — warto przygotować się na korzystanie z kalkulatora cen. DataForSEO Pricing.
Szybkość i niezawodność
Asynchroniczny tryb Standard może działać wolniej (ok. 10 sekund), ponieważ zadania są kolejkowane. Tryby Live / high-speed kosztują więcej, ale świetnie nadają się do dashboardów czasu rzeczywistego. Długa historia na rynku, sprawdzona stabilność i dostępne wsparcie enterprise.
Najlepsze zastosowania
Firmy SaaS budujące platformy SEO, dashboardy do monitoringu pozycji i narzędzia do researchu słów kluczowych. Zespoły komfortowo czujące się z bardziej złożoną dokumentacją i infrastrukturą klasy enterprise.
6. Bright Data
Bright Data to ciężka artyleria klasy enterprise. Jej SERP API to tylko jeden z wielu produktów — obok proxy, datasetów, Web Unlocker i narzędzi do scrapingu. Wartość tej platformy to skala, niezawodność i infrastruktura.
Najważniejsze funkcje
- Dedykowane endpointy dla Google Maps, Shopping i general search — a także wsparcie dla wielu wyszukiwarek przez infrastrukturę proxy obejmującą Bing, Yahoo, Yandex i DuckDuckGo.
- Deklarowany 100% success rate dzięki wbudowanej technologii odblokowywania.
- Tam, gdzie Bright Data naprawdę błyszczy: geo-targeting, współbieżność i odblokowywanie na poziomie enterprise.
Cennik
Oferta ukierunkowana na enterprise. Publiczne ceny pokazują opcje pay-as-you-go i subskrypcje, a wiele porównań wskazuje na próg wejścia około 499 USD/mies. Koszt za wywołanie zaczyna się od ok. 0,005 USD, ale spada wraz z wolumenem. Bright Data Pricing. Dostępny jest darmowy plan (5 000 kredytów/mies., bez karty kredytowej).
Szybkość i niezawodność
Benchmarki często pokazują od 2 do 5,58 s. Powód, dla którego kupuje się Bright Data, to nie sama średnia latencja — to SLA enterprise, dedykowane wsparcie i infrastruktura obsługująca miliony równoległych zapytań bez spadku jakości. Dokumentacja limitów zaleca stopniowe zwiększanie obciążenia.
Najlepsze zastosowania
Zespoły enterprise zbierające miliony SERP-ów miesięcznie. Organizacje potrzebujące danych Google Maps / lokalnych firm na dużą skalę. Zespoły już korzystające z produktów proxy Bright Data.
7. ScraperAPI
ScraperAPI to ogólnego przeznaczenia API do web scrapingu, które oferuje także ustrukturyzowane endpointy Google SERP. To opcja „jedno narzędzie do wszystkiego” — łatwa do integracji, z pulą proxy ponad 40M IP.
Najważniejsze funkcje
- Ustrukturyzowane endpointy danych dla Google Search, Shopping, News i Jobs.
- Oparte na machine learning odblokowywanie i rozwiązywanie CAPTCHA, a renderowanie JavaScript bez dodatkowych kosztów.
- Obsługa geo-targetingu dla zlokalizowanych wyników.
Cennik
7-dniowy darmowy okres próbny z 5 000 kredytów. Płatne plany zaczynają się od ok. 49 USD/mies. Uwaga: wywołania SERP mogą zużywać inne kredyty niż zwykłe żądania scrapingu, więc zawsze przeliczaj koszt względem rzeczywiście dostarczonych, udanych zapytań SERP. ScraperAPI Pricing.
Szybkość i niezawodność
A teraz uczciwie: benchmark HasData podaje ok. 33,66 s średniego czasu odpowiedzi dla zapytań SERP. To dużo wolniej niż wyspecjalizowane SERP API. Wysoka skuteczność (99,9%), ale latencja sprawia, że rozwiązanie gorzej nadaje się do zastosowań czasu rzeczywistego. Lepiej sprawdza się przy przetwarzaniu wsadowym.
Najlepsze zastosowania
Zespoły potrzebujące ogólnego rozwiązania do scrapingu, w którym SERP jest dodatkiem. Projekty, gdzie szybkość jest mniej istotna niż niezawodność i łatwość konfiguracji. Deweloperzy już używający ScraperAPI do innych zadań scrapingu, którzy chcą skonsolidować dostawców.
8. Apify
Apify nie jest czystym SERP API. To platforma do scrapingu i automatyzacji zbudowana wokół „Actors” — wielokrotnego użytku skryptów do zadań takich jak scrapowanie Google Search, ekstrakcja Maps czy automatyzacja workflow. Traktuj to jak marketplace, w którym wybierasz (albo tworzysz) scraper dokładnie pod swoje potrzeby.
Najważniejsze funkcje
- Marketplace gotowych Google SERP actors o różnym zakresie funkcji.
- Wysoka konfigurowalność — budowanie własnych workflow scrapingu, łączenie actorów, planowanie uruchomień.
- Wyjście w JSON; możliwość wyciągania konkretnych elementów SERP przez konfigurację actorów.
- Mocna opcja do łączenia ekstrakcji SERP z innymi zadaniami scrapingu i automatyzacji.
Cennik
Darmowy plan z miesięcznymi kredytami platformy (wartość ok. 5 USD, czyli mniej więcej 1 400 wyników). Płatne plany zaczynają się od ok. 29 USD/mies. Koszt na poziomie actorów jest zmienny — niektóre rozliczają się za wynik, inne za jednostkę obliczeniową. Porównania zewnętrzne często szacują Apify na około 0,003 USD za wyszukiwanie przy małej skali. Apify Pricing.
Szybkość i niezawodność
HasData podaje ok. 8,2 s średnio. Architektura oparta na actorach dodaje narzut w porównaniu z dedykowanymi endpointami SERP. Lepiej nadaje się do workflow wsadowych i planowanych niż do zapytań w czasie rzeczywistym.
Najlepsze zastosowania
Zespoły potrzebujące niestandardowego scrapingu i automatyzacji wykraczającej poza same dane SERP. Projekty łączące ekstrakcję SERP z innymi zadaniami web scrapingu. Deweloperzy, którzy chcą maksymalnej elastyczności zamiast gotowych endpointów.
Macierz parsowania elementów SERP: co każde API naprawdę zwraca
To porównanie, którego nie udało mi się znaleźć nigdzie indziej. Każdy dostawca mówi o „ustrukturyzowanym JSON-ie”, ale rzeczywisty zakres parsowanych elementów SERP jako pierwszorzędnych pól bardzo się różni. Sprawdziłem dokumentację i przykładowe odpowiedzi dla każdego z nich.
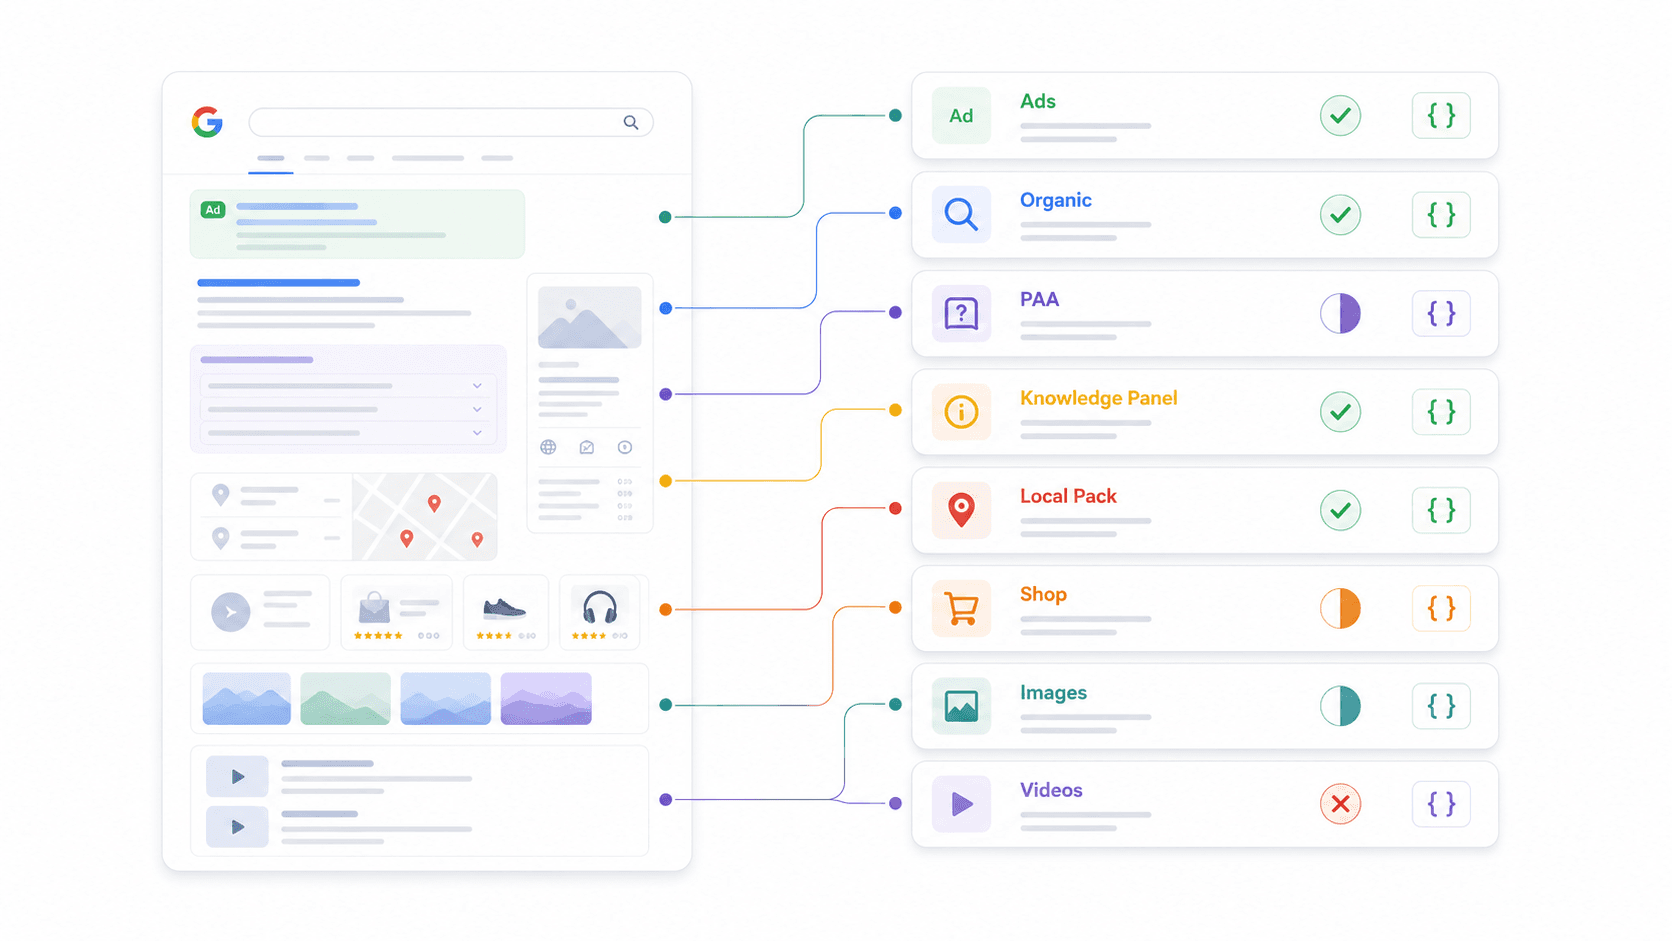
| Element SERP | Thunderbit | SerpApi | Serper | Scrapingdog | DataForSEO | Bright Data | ScraperAPI | Apify |
|---|---|---|---|---|---|---|---|---|
| Wyniki organiczne | Własny schemat | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | Zależne od actora |
| People Also Ask | Własny schemat | ✅ | ✅ | ✅ | ✅ | Częściowo | Częściowo | Zależne od actora |
| Panel wiedzy | Własny schemat | ✅ | Częściowo | Częściowo | ✅ | Częściowo | Częściowo | Zależne od actora |
| Local Pack / Maps | Własny schemat | ✅ | ✅ | Częściowo | ✅ | ✅ | Częściowo | Zależne od actora |
| Wyniki shoppingowe | Własny schemat | ✅ | ✅ | Częściowo | ✅ | ✅ | ✅ | Zależne od actora |
| Featured Snippets | Własny schemat | ✅ | Częściowo | ✅ | ✅ | Częściowo | Częściowo | Zależne od actora |
| Reklamy (góra/dół) | Własny schemat | ✅ | Częściowo | ✅ | ✅ | Częściowo | Częściowo | Zależne od actora |
| Pakiet obrazów | Własny schemat | ✅ | ✅ | ✅ | ✅ | Częściowo | Częściowo | Zależne od actora |
| Wyniki wideo | Własny schemat | ✅ | ✅ | Częściowo | ✅ | Częściowo | Częściowo | Zależne od actora |
Co oznacza „Własny schemat” w Thunderbit: Zamiast z góry definiować, które elementy SERP są parsowane, sam tworzysz JSON Schema, żeby wyciągnąć dokładnie te pola, których potrzebujesz. Chcesz pytania PAA wraz z podsumowaniami odpowiedzi i sygnałami intencji komercyjnej? Definiujesz taki schemat, a AI zwraca wynik. Ta elastyczność sprawia, że Thunderbit działa w każdej wyszukiwarce — nie tylko w Google.
Dlaczego to ma znaczenie w Twoim workflow: Jeśli potrzebujesz danych PAA do strategii contentowej, sprawdź, czy dostawca rzeczywiście je parsuje. Jeśli monitorujesz reklamy shoppingowe w ecommerce, potwierdź, że istnieją strukturalne pola dla shoppingu. Nie zakładaj, że „ustrukturyzowany JSON” oznacza pełne pokrycie.
Realny koszt w skali: porównanie ceny za zapytanie
Ceny widoczne na stronach nie pokazują pełnego obrazu. Przeliczyłem wszystko na koszt 1 000 udanych zapytań w trzech progach wolumenowych.
| Dostawca | Koszt 1K zapytań | Koszt 10K zapytań | Koszt 100K zapytań | Pay-as-you-go? | Darmowy plan |
|---|---|---|---|---|---|
| Thunderbit (Distill) | ~0,80–3,20 USD | ~8–32 USD | ~80–320 USD | Pakiety kredytów | Darmowe kredyty |
| Thunderbit (Extract) | ~16–64 USD | ~160–640 USD | ~1 600–6 400 USD | Pakiety kredytów | Darmowe kredyty |
| SerpApi | 25 USD (Starter) | ~150 USD (Developer) | ~917 USD (Big Data) | Nie (subskrypcja) | 250/mies. |
| Serper | ~1 USD | ~10 USD | ~75–100 USD | Tak | 2 500 zapytań |
| Scrapingdog | ~1 USD | ~10 USD lub mniej | Może spaść znacznie poniżej 10 USD | Plan/kredyty | 200 kredytów/mies. |
| DataForSEO | ~0,60–2 USD | ~6–20 USD | ~60–200 USD | Tak | Kredyty testowe |
| Bright Data | ~0,50–5+ USD | Zależnie od wyceny | Najlepszy przy skali enterprise | Tak/plan | Darmowy plan (5 000 kredytów/mies.) |
| ScraperAPI | Zależne od kredytów | Zależne od kredytów | Zależne od kredytów | Plan/kredyty | 5 000 kredytów próbnych |
| Apify | ~3 USD (mała skala) | Zależne od actorów | Zależne od actorów | Kredyty platformy | Miesięczne darmowe kredyty |
Ukryte koszty, na które warto uważać:
- Możliwa opłata 2 kredytów w Serper za >10 wyników na zapytanie.
- Różnice cenowe w DataForSEO między trybem standard a live / high-priority.
- Mnożniki kredytowe w ScraperAPI dla SERP vs. zwykłego scrapingu.
- Minimalne zobowiązania enterprise w Bright Data.
Wartość na każdym poziomie:
- Poboczne projekty (50 USD/mies.): Serper lub Scrapingdog dla sztywnego JSON-a z Google SERP.
- Rosnące zespoły (10K–50K zapytań/mies.): Serper, Scrapingdog lub DataForSEO — zależnie od głębokości parsowania.
- Enterprise (100K+ zapytań/mies.): DataForSEO, Bright Data albo SerpApi Big Data.
- Ekstrakcja AI-first: Thunderbit, bo schemat odpowiada oczekiwaniom Twojego downstream agenta bez dodatkowego przetwarzania.
Najlepsze SERP API dla agentów AI i workflow LLM w 2026 roku
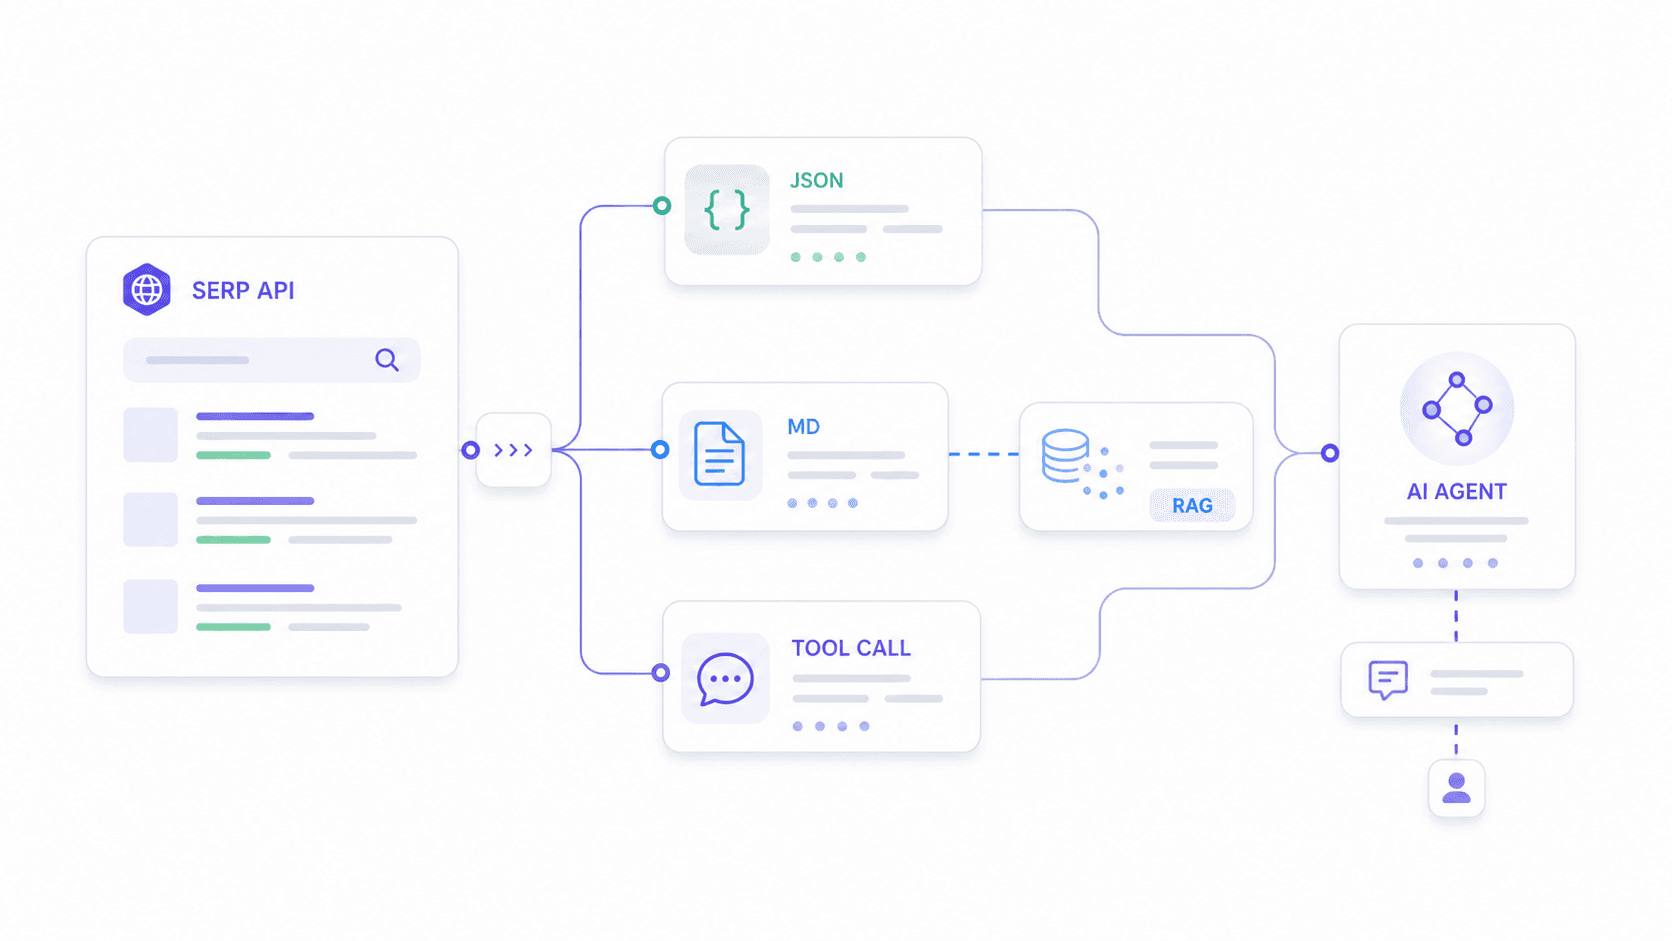
To przypadek użycia, który wszyscy inni opisują słabo. Znalazłem co najmniej trzy wątki na Reddicie, w których użytkownicy opisują próby integracji SERP API z workflow n8n i agentami AI, a jeden z nich wprost napisał, że „nie udało mu się sprawić, by to działało poprawnie z agentem AI”.
Agenci AI potrzebują od danych SERP czegoś innego niż dashboardy do monitoringu pozycji. Potrzebują:
- Stabilnego schematu JSON, który nie rozsypie logiki parsowania po zmianie formatu wyjściowego przez dostawcę.
- Własnych pól wyjściowych, pasujących do tego, czego oczekuje model downstream — a nie generycznego zrzutu wszystkiego.
- Czystego Markdown lub tekstu dla pipeline’ów embeddingowych RAG.
- Wystarczająco niskiej latencji do wywołań narzędzi w czasie rzeczywistym.
Jak każdy dostawca pasuje do stacku agenta AI
| Dostawca | Dopasowanie do agenta AI | Dlaczego |
|---|---|---|
| Thunderbit | Doskonałe | Własny JSON Schema (Extract API) + Markdown dla RAG (Distill API). Najbardziej elastyczne rozwiązanie do ekstrakcji pod konkretnego agenta. |
| Serper | Bardzo dobre | Szybki, czysty JSON, popularny w społecznościach n8n/LangChain. Prosty i tani dla podstawowych wywołań search-tool. |
| SerpApi | Dobre | Stabilny schemat, świetna dokumentacja. Dobrze działa, gdy agenty potrzebują vertykali Google (Maps, Scholar, Shopping). |
| DataForSEO | Dobre | Najlepszy wybór, gdy agent jest częścią większego pipeline’u danych SEO. |
| Scrapingdog | Dobre | Szybki i tani; schemat stabilny dla Google SERP. |
| Bright Data | Dobre | Dane świeże na skalę enterprise, wiele wyszukiwarek i regionów. |
| ScraperAPI | Umiarkowane | Lepsze, gdy agent potrzebuje też ogólnego web crawl. |
| Apify | Umiarkowane do dobrego | Elastyczne, ale wolniejsze; lepsze do workflow wsadowych i planowanych. |
Praktyczny przykład z Thunderbit: Wyobraź sobie, że Twój agent AI ma przeanalizować intencję wyszukiwania dla frazy „najlepszy CRM dla nieruchomości”. Definiujesz schemat, który pobiera wyniki organiczne (tytuł, URL, snippet, pozycja), pytania People Also Ask wraz z podsumowaniami odpowiedzi oraz klasyfikację intencji komercyjnej. Extract API w Thunderbit zwraca dokładnie taką strukturę — ani więcej, ani mniej. Agent nie traci tokenów na parsowanie zbędnych pól ani czyszczenie artefaktów HTML.
W pipeline’ach RAG Distill API Thunderbit zamienia stronę SERP na czysty Markdown gotowy do embeddingu. Większość wyspecjalizowanych SERP API zwraca sztywne schematy JSON; podejście Thunderbit pozwala dopasować wynik do tego, czego oczekuje model downstream.
Macierz decyzji według zastosowania: jeśli potrzebujesz X, wybierz Y
Użytkownicy forów ciągle pytają o konkretne rekomendacje dopasowane do ich workflow — a nie ogólne porady w stylu „to zależy”. Więc stworzyłem taką matrycę.
| Twój przypadek użycia | Najlepszy wybór | Drugi wybór | Dlaczego |
|---|---|---|---|
| Monitoring pozycji SEO (duża skala) | DataForSEO | Scrapingdog | SEO-native endpointy, cenowanie hurtowe, rozbudowane parsowanie |
| Google Maps / dane o lokalnych firmach | SerpApi | Bright Data | Dojrzały endpoint Maps; Bright Data dobrze skaluje się do enterprise local scraping |
| Agent AI / automatyzacja n8n | Thunderbit | Serper | Własny schemat + Markdown do RAG; Serper jest szybki i tani dla prostych wywołań |
| Budżetowe MVP / projekt poboczny (<50 USD/mies.) | Serper | Scrapingdog | Hojne darmowe plany, pay-as-you-go, minimalna konfiguracja |
| Wiele wyszukiwarek (Bing, Yandex, DuckDuckGo) | Thunderbit | DataForSEO | Thunderbit działa na dowolnej wyszukiwarce dzięki ekstrakcji AI; DataForSEO ma endpointy multi-engine |
| Agregacja Google Reviews | SerpApi | DataForSEO | Dedykowane endpointy do parsowania opinii |
| Monitoring ecommerce / shopping | SerpApi | DataForSEO | Silne pokrycie Google Shopping i pola strukturalne |
| Niestandardowe workflow scrapingu | Apify | ScraperAPI | Elastyczność actorów; ScraperAPI jest prosty do ogólnego scrapingu + SERP |
Szybki przewodnik po personach:
- Zespół SEO: zacznij od DataForSEO, jeśli budujesz dashboardy; wybierz SerpApi, jeśli ważniejsze są pokrycie vertykali Google i dokumentacja niż cena.
- Zespół sprzedaży: użyj Thunderbit, gdy workflow obejmuje SERP-y, strony katalogowe i enrichment; użyj Serper do prostych zapytań lead discovery.
- Deweloper narzędzi AI: Thunderbit do własnych schematów/RAG, Serper do tanich i szybkich wyszukiwań, SerpApi do solidnych danych z vertykali Google.
- Solo przedsiębiorca: zacznij od darmowych planów Serper, Scrapingdog, SerpApi i Thunderbit. Uruchom te same 20 zapytań zbliżonych do produkcyjnych, zanim się zdecydujesz.
Limity, niezawodność i gotowość produkcyjna — porównanie
Szkoda, że ta sekcja nie istniała, kiedy pierwszy raz oceniałem dostawców pod kątem produkcji. Zespoły skalujące się do tysięcy zapytań dziennie potrzebują przewidywalnych limitów, automatycznych retry i gwarancji dostępności — a żaden inny artykuł porównawczy nie omawia tego systematycznie.
| Dostawca | Rate limit | Zapytania równoległe | Retry po błędzie | SLA / uptime |
|---|---|---|---|---|
| Thunderbit Free | 600 jednostek, jednorazowo | 2 | Wbudowane (anty-bot, CAPTCHA) | — |
| Thunderbit Starter | 60 000 jednostek/mies. | 30 | Wbudowane | — |
| Thunderbit Pro | 600 000 jednostek/mies. | 50 | Wbudowane | — |
| SerpApi | Zależne od planu (wyszukiwania/godz.) | Zależne od planu | Dostawca obsługuje proxy/CAPTCHA | SLA 99,95% |
| Serper | Zależne od konta/planu | Niepubliczne w szerokim zakresie | Zalecane ręczne retry po stronie klienta | Brak publicznego SLA |
| Scrapingdog | Zależne od planu | Sprawdź warunki planu | Obsługa anty-blocking | Nie zawsze publiczne |
| DataForSEO | Udokumentowane dla endpointu/trybu | Zależne od trybu | Async wspiera polling/retry | Wsparcie enterprise |
| Bright Data | Udokumentowane, zwiększaj stopniowo | Skala enterprise | Wbudowane odblokowywanie | SLA enterprise |
| ScraperAPI | Współbieżność zależna od planu | Zależne od kredytów | Obsługuje retry/proxy | Opcje płatnego wsparcia |
| Apify | Zależne od actorów/pamięci/mocy obliczeniowej | Limity platformy | Konfiguracja na poziomie actorów | Niezawodność platformy |
Checklist przed wdrożeniem produkcyjnym:
- Zapytaj, czy dostawca nalicza opłaty za nieudane lub zablokowane żądania.
- Potwierdź dokładną współbieżność, liczbę żądań na minutę i zachowanie przy skokach ruchu.
- Sprawdź, czy geo-targeting, mobile vs desktop i renderowanie JS wpływają na zużycie kredytów.
- Zapisz przykładowe odpowiedzi JSON dla 20–50 realnych zapytań i porównuj nazwy pól w kolejnych dniach, aby sprawdzić stabilność schematu.
- Dodaj retry po stronie klienta i budżet timeoutów, jeśli dane SERP są krytyczne dla działania systemu.
Podsumowanie w pigułce: porównanie wszystkich 8 SERP API
| Dostawca | Średnia szybkość | Koszt za 1K | Darmowy plan | Zakres parsowania | Dopasowanie do AI | Wiele wyszukiwarek | Werdykt |
|---|---|---|---|---|---|---|---|
| Thunderbit | Średnia (ekstrakcja AI) | Niski (Distill) do premium (Extract) | Tak | Własny (dowolny element) | Doskonałe | Doskonałe | Najlepszy do natywnej AI-ekstrakcji SERP i RAG |
| SerpApi | ~5,5 s | Premium | 250/mies. | Doskonały (stały) | Dobre | Szerokie vertykale Google | Najlepsze dojrzałe pokrycie Google |
| Serper | ~2–3 s | Bardzo niski | 2 500 zapytań | Dobre | Bardzo dobre | Głównie Google | Najlepsze tanie i szybkie API dla AI/MVP |
| Scrapingdog | ~1,25 s | Bardzo niski przy skali | 200 kredytów/mies. | Dobre | Dobre | Sprawdź obsługiwane wyszukiwarki | Najlepszy stosunek szybkości do ceny |
| DataForSEO | Średnio-wolne (standard) | Niski–umiarkowany | Kredyty testowe | Doskonały | Dobre | Doskonałe | Najlepsza infrastruktura dla platform SEO |
| Bright Data | ~2–5,5 s | Enterprise | Darmowy plan (5 000/mies.) | Dobre (zależne od produktu) | Dobre | Doskonałe | Najlepsze zbieranie danych w skali enterprise |
| ScraperAPI | ~33 s | Zależne od kredytów | 5 000 trial | Umiarkowany | Umiarkowane | Endpointy Google | Najlepsze, jeśli SERP to tylko część szerszego scrapingu |
| Apify | ~8 s | Zależne od actorów | Miesięczne kredyty | Zależne od actorów | Umiarkowane–dobre | Zależne od actorów | Najlepsze do niestandardowych workflow automatyzacji |
Jak Thunderbit wpisuje się w Twój workflow SERP
Trochę więcej kontekstu, dlaczego nasz zespół zbudował API Thunderbit właśnie w ten sposób. Tradycyjny model SERP API — sztywne endpointy, z góry ustalone pola wyjściowe, tylko Google — sprawdza się przy prostym monitoringu pozycji. Ale gdy tylko potrzebujesz czegoś choć odrobinę innego (odpowiedzi PAA z sentymentem, lokalnych wyników z liczbą recenzji albo danych shoppingowych dopasowanych do konkretnego schematu bazy), zostajesz z post-processingiem albo musisz zmienić dostawcę.
Extract API w Thunderbit odwraca ten model. Mówisz mu, czego potrzebujesz, poprzez JSON Schema, a AI sama ustala, jak to wydobyć z dowolnej wskazanej strony wyszukiwania. Dziś Google, jutro Bing, w przyszłym tygodniu niszowa wyszukiwarka wertykalna — to samo API, to samo podejście.
Distill API rozwiązuje inny problem: zamienia chaotyczne strony SERP w czysty Markdown, który LLM mogą faktycznie przetworzyć bez zacinania się na artefaktach HTML, elementach nawigacji i skryptach śledzących. Jeśli budujesz pipeline RAG, który potrzebuje świeżych dowodów z wyszukiwania, to najszybsza droga od „żywego SERP” do „treści gotowej do embeddingu”.
Oba endpointy mają wbudowaną obsługę anty-bot, rozwiązywanie CAPTCHA i renderowanie JS. Nie płacisz za to dodatkowo — jest to wliczone w koszt kredytów.
Wypróbuj rozszerzenie Thunderbit Chrome
Sprawdź sam: Thunderbit Chrome Extension do ekstrakcji w przeglądarce albo korzystaj bezpośrednio z API w workflow programistycznych. Nasz kanał YouTube zawiera instrukcje, jeśli chcesz zobaczyć to w praktyce, zanim napiszesz kod.
Uwaga o legalności
Pojawia się to w prawie każdym FAQ, więc krótka wersja brzmi: legalność scrapowania SERP jest zależna od konkretnego przypadku i jurysdykcji. Sprawa hiQ v. LinkedIn pokazała, że scrapowanie publicznie dostępnych danych nie musi być przestępstwem komputerowym, ale nie daje ono bezwarunkowej zgody. Google pozwał SerpApi za scrapowanie SERP, co pokazuje, że wokół dostępu do danych istnieje realna presja komercyjna.
Praktyczna rada: korzystaj z API dostawców zgodnie z ich warunkami, unikaj zbierania danych osobowych, jeśli nie jest to konieczne, i pytaj dostawców, jak podchodzą do kwestii zgodności. Nie zakładaj, że scrapowanie SERP jest wolne od ryzyka.
Podsumowanie
Żaden pojedynczy dostawca nie wygrywa we wszystkich wymiarach — właściwy wybór zależy od zastosowania, budżetu i stacku technologicznego. Po znormalizowaniu cen, testach szybkości, mapowaniu zakresu parsowania i ocenie gotowości pod agentów AI, mój schemat decyzyjny wygląda tak:
- Potrzebujesz elastyczności i gotowości pod agentów AI? → Thunderbit
- Potrzebujesz szerokiego pokrycia produktów Google? → SerpApi
- Potrzebujesz szybkości i najniższej ceny? → Serper lub Scrapingdog
- Budujesz platformę SEO? → DataForSEO
- Enterprise scale z SLA? → Bright Data lub DataForSEO
- Ogólny scraping + okazjonalny SERP? → ScraperAPI lub Apify
Zacznij od darmowych planów. Uruchom 20–50 realnych zapytań odpowiadających Twojemu obciążeniu produkcyjnemu. Porównaj odpowiedzi JSON. Sprawdź rzeczywisty koszt po kredytach i mnożnikach. Dopiero potem podejmij decyzję.
Ceny na tym rynku zmieniają się często — to porównanie zostało znormalizowane na podstawie aktualnych publicznych stron w maju 2026. Jeśli czytasz to kilka miesięcy później, sprawdź ponownie przed zakupem.
Więcej o podejściach do AI web scraping i o tym, jak wypadają na tle tradycyjnych metod, opisaliśmy szczegółowo na naszym blogu. Jeśli rozważasz web scraping bez kodowania, rozszerzenie Chrome Thunderbit także załatwia tę część.
FAQ
1. Czym jest SERP API i kto go potrzebuje?
SERP API to usługa, która wysyła zapytania do wyszukiwarek takich jak Google, Bing czy Yandex i zwraca wyniki jako dane strukturalne (zwykle JSON). Specjaliści SEO używają ich do monitoringu pozycji, zespoły sprzedaży do wyszukiwania leadów, zespoły ecommerce do monitorowania cen, a deweloperzy AI do zasilania agentów i pipeline’ów RAG aktualnymi danymi z wyszukiwania.
2. Ile kosztuje pobranie 1 000 wyników Google przez API?
Koszty bardzo się różnią — od ok. 0,60 USD za 1K (DataForSEO w standardowym tierze) do ok. 25 USD za 1K (SerpApi Starter). Rabaty przy większym wolumenie też potrafią się diametralnie różnić między dostawcami. Zawsze porównuj koszt 1 000 udanych zapytań, a nie tylko nagłówkowe ceny.
3. Czy mogę używać SERP API z agentami AI, np. LangChain lub n8n?
Tak. Serper jest popularny w społeczności n8n do prostych wywołań search. Thunderbit sprawdza się najlepiej, gdy agent potrzebuje własnych schematów JSON albo Markdown do RAG. SerpApi dobrze działa w przypadku agentów potrzebujących stabilnych danych z vertykali Google (Maps, Scholar, Shopping).
4. Które SERP API ma najlepszy darmowy plan do testów?
Serper oferuje 2 500 darmowych zapytań przy rejestracji — to najhojniejszy plan pod względem samego wolumenu. SerpApi daje 250/mies., Scrapingdog 200 kredytów/mies., ScraperAPI 5 000 kredytów próbnych (7 dni), a Thunderbit zawiera darmowe kredyty do prototypowania. Apify oferuje miesięczne kredyty platformy o wartości ok. 5 USD.
5. Jakie elementy SERP powinienem sprawdzić u dostawcy przed zakupem?
Nie zakładaj, że „ustrukturyzowany JSON” oznacza pełne pokrycie. Sprawdź, czy API zwraca strukturalne pola dla: People Also Ask, Knowledge Panel, Local Pack/Maps, wyników Shopping, Featured Snippets, reklam (góra i dół), pakietu obrazów i wyników wideo. Skorzystaj z macierzy parsowania z tego artykułu jako listy startowej i przetestuj ją na prawdziwych zapytaniach, zanim podpiszesz plan.
Wypróbuj Thunderbit do AI Web Scraping Get Started Free
Dowiedz się więcej



