
Wpisujesz w Google hasło „scraper plugin”, spodziewając się przycisku na pasku narzędzi i arkusza kalkulacyjnego za pięć minut. Zamiast tego trafiasz na ścianę dokumentacji API dla developerów, fragmenty kodu i cenniki, które mówią o „rotacji proxy” oraz „współbieżnych workerach”. Gdzieś pomiędzy tymi skrajnościami większość użytkowników biznesowych po prostu rezygnuje i ręcznie kopiuje dane.
To zamieszanie nie bierze się znikąd — to problem samej kategorii. Większość zestawień „najlepszych scraperów” wrzuca do jednego worka rozszerzenia przeglądarki, aplikacje desktopowe i chmurowe API, jakby instalacja rozszerzenia do Chrome i integracja z REST API były tą samą decyzją. Nie są. Dlatego tę listę podzieliłem najpierw według typu instalacji, a dopiero potem według zastosowania, żebyś mógł w około trzydzieści sekund ustalić, czy potrzebujesz wtyczki, aplikacji, czy przekazania zadania developerowi.
Co naprawdę można uznać za scraper plugin? (rozszerzenia vs aplikacje desktopowe vs chmurowe API)
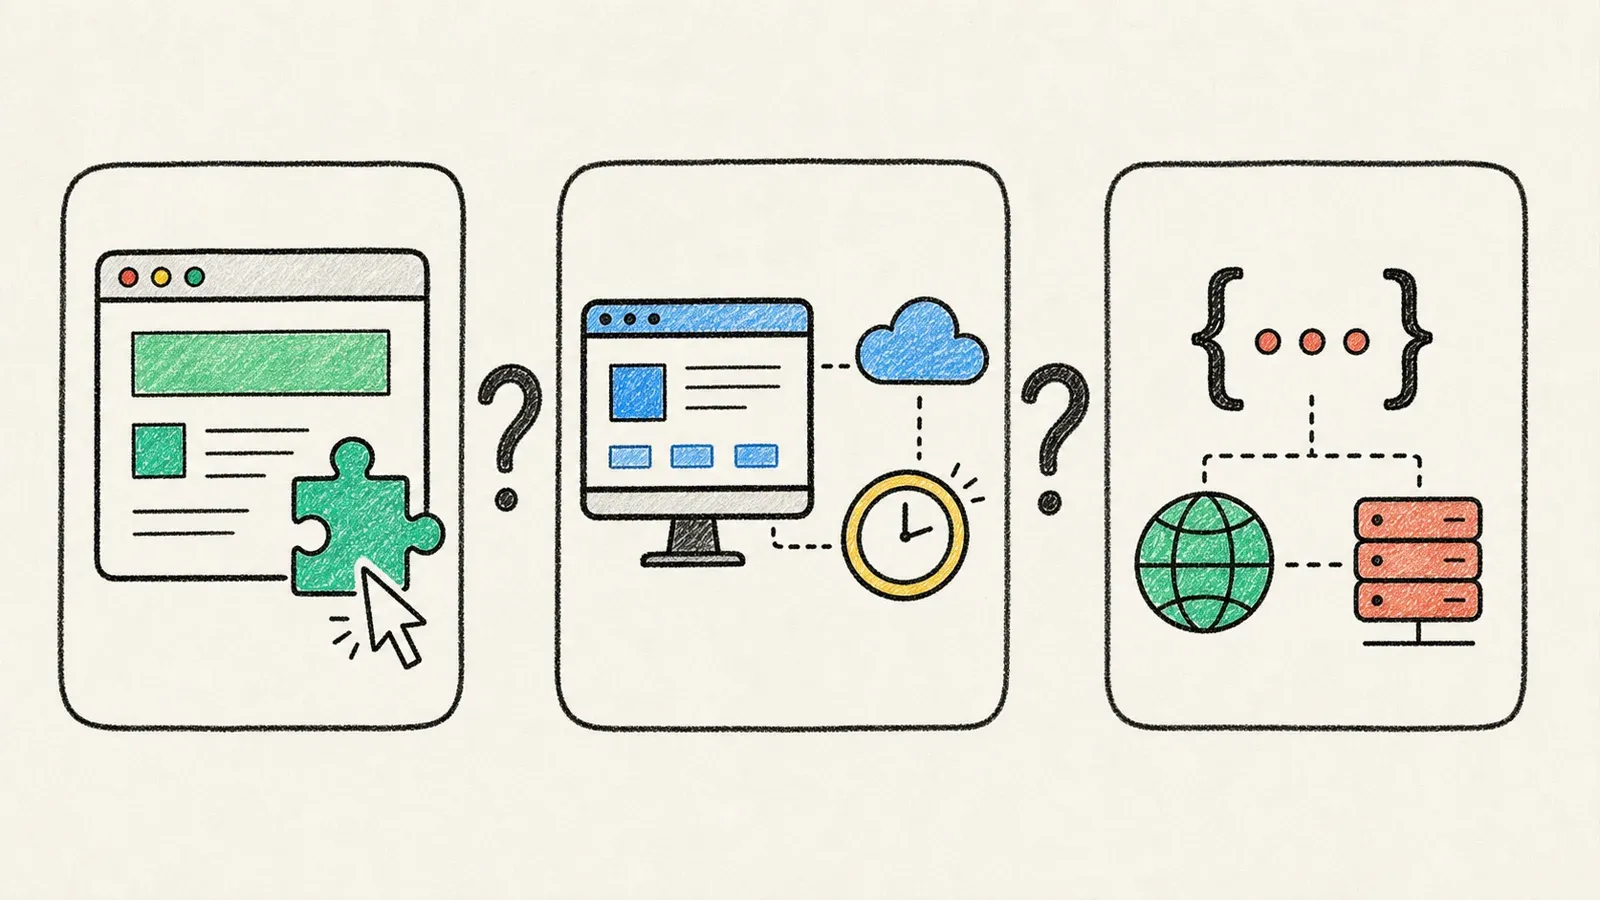
Jest prosty test, który naprawdę działa: czy narzędzie instaluje się w przeglądarce i działa na aktualnie otwartej stronie, bez konieczności wcześniejszej budowy integracji backendowej? Jeśli tak, to w praktycznym sensie jest to prawdziwa wtyczka do przeglądarki. Jeśli trzeba pobrać i uruchomić osobny program, to jest to aplikacja desktopowa. Jeśli piszesz kod i wysyłasz zapytania do endpointu, to jest to chmurowe API — przydatne, ale w żadnym rozsądnym ujęciu nie jest to plugin.
| Kategoria | Gdzie działa | Interfejs sterowania | Mocna strona | Ograniczenie |
|---|---|---|---|---|
| Prawdziwe rozszerzenie przeglądarki | W Chrome/Edge na aktualnie otwartej stronie/sesji | Pasek narzędzi, panel boczny, wskazywanie i klikanie | Najmniejszy próg wejścia, działa dokładnie na tym, co widzisz | Zależne od otwartej karty; słabsze planowanie i skala |
| Aplikacja desktopowa | Osobny zainstalowany program z własną przeglądarką | Wizualny kreator projektów | Większa kontrola nad nawigacją i projektami lokalnymi | Konieczność instalacji i konfiguracji projektu |
| Chmurowa platforma automatyzacji | Usługa hostowana, czasem z towarzyszącym rozszerzeniem | Szablony, roboty, harmonogram | Powtarzalność, działa bez otwartego laptopa | Złożoność konta i kredytów |
| Chmurowe API/platforma | Infrastruktura dostawcy wywoływana z kodu | Żądanie HTTP, SDK, CLI | Skalowalność i powtarzalność | Wymaga programisty |
To rozróżnienie ma znaczenie, bo narzędzia hybrydowe ciągle je rozmywają. Octoparse ma tryb szablonów przypominający rozszerzenie, ale w gruncie rzeczy jest aplikacją desktopową z warstwą chmurową. PhantomBuster ma rozszerzenie do przeglądarki, ale jego główny produkt to chmurowa automatyzacja social mediów. Nazywanie każdego narzędzia do scrapowania „pluginem” tylko dlatego, że ma jakiś komponent przeglądarkowy, to dokładnie ten rodzaj mieszania kategorii, który doprowadził Cię do tego bałaganu.
Jak wybraliśmy najlepsze narzędzia typu scraper plugin
Każde narzędzie oceniłem według sześciu kryteriów: łatwość instalacji (prawdziwe rozszerzenie vs. aplikacja desktopowa vs. API), obsługa no-code kontra konieczność kodowania, renderowanie JS i radzenie sobie z anti-botem, miejsca eksportu, przejrzystość cen oraz — i to jest element, który większość recenzji pomija — koszt utrzymania, gdy docelowa strona zmieni układ.
Ten ostatni punkt warto podkreślić. Każde narzędzie oparte na selektorach w tej liście ma w swojej oficjalnej dokumentacji opisane, co się dzieje po przebudowie strony: złe kolumny, puste wiersze, duplikaty albo ciche błędy. Na stronie pomocy Octoparse jako typowe błędy wymieniono pomijanie stron i nieskończone zapętlenie ostatniej strony. Kody błędów ParseHub obejmują komunikat „selected no elements”, gdy selektor przestaje pasować. To nie zarzut wobec tych narzędzi — to po prostu fizyka pracy na stałych elementach HTML. Narzędzie, które przy każdym uruchomieniu odczytuje strukturę strony od nowa, radzi sobie z tym inaczej niż takie, które pół roku temu zapamiętało ścieżkę CSS, a ta różnica bezpośrednio wpływa na bieżące utrzymanie.
Najlepsze narzędzia typu scraper plugin — zestawienie
| Narzędzie | Kategoria | Najlepsze do | Konfiguracja | Obsługa JS/anti-bot | Eksport | Model cenowy |
|---|---|---|---|---|---|---|
| Thunderbit | Rozszerzenie przeglądarki z AI | Ekstrakcja jednym kliknięciem bez selektorów | Kliknij i uruchom, bez konfiguracji schematu na obsługiwanych stronach | Agentowa analiza strony na zgodnych/autoryzowanych stronach | Excel, Google Sheets, Airtable, Notion, pobranie | Oparte na kredytach (sprawdź na żywo) |
| Instant Data Scraper | Starsze rozszerzenie heurystyczne | Darmowe, szybkie scrapowanie tabel i list | Wskazuj i klikaj, automatyczne wykrywanie tabel | Udokumentowana obsługa dynamicznego ładowania i nieskończonego scrolla; brak zarządzanego proxy/CAPTCHA | XLS/XLSX/CSV | Darmowe |
| Web Scraper | Rozszerzenie oparte na recepturach | Ustrukturyzowane, powtarzalne recepty scrapowania | Ręczna konfiguracja sitemap i selektorów | Lokalnie kontrola JS/paginacji; Cloud dodaje proxy i ponowienia | CSV, XLSX lokalnie; JSON/API w Cloud | Darmowa wersja lokalna + płatny Cloud |
| Octoparse | Aplikacja desktopowa + warstwa chmurowa | No-code dla bardziej złożonych stron dynamicznych | Szablon + desktopowy workflow point-and-click | Umiarkowanie dobra dzięki trybom Chrome/Phantom i ekstrakcji w chmurze | CSV, Excel, DB, API | Free + plany abonamentowe |
| ParseHub | Desktopowy point-and-click | Złożona, wielopoziomowa paginacja | Instalacja aplikacji desktopowej | Dobre wsparcie JS przez wbudowaną przeglądarkę; snapshot serwera do debugowania | CSV, JSON, Google Sheets (przez skrypt) | Free + płatne plany |
| Browse AI | Chmurowe roboty + monitoring | Harmonogramy i alerty | Szablony robotów (rozszerzenie zostało wycofane) | Dobrze działa na nagranych interakcjach; obowiązują minima dla stron premium | CSV, JSON, S3, API, Sheets, Airtable | Kredyty / zadania |
| PhantomBuster | Chmurowa automatyzacja + towarzyszące rozszerzenie | Obsługiwana automatyzacja social/lead-gen | Gotowe „Phantomy” | Działa przez Twoje własne zalogowane konto | HubSpot zweryfikowany; inne eksporty wymagają ponownej weryfikacji | Kredyty za czas wykonania (dokładne ceny niepubliczne) |
| Firecrawl | Chmurowe API kontekstowe | Crawlowanie na dużą skalę, mocno oparte na JS | API/SDK/CLI, wymagana wiedza developerska | Renderowanie w chmurze, inteligentne czekanie, respektowanie robots.txt przez FirecrawlAgent | Markdown, HTML, zrzuty ekranu, JSON | Oparte na kredytach (1 kredyt/strona dla Scrape/Crawl/Map/Monitor) |
| ScraperAPI | Chmurowe proxy/API do scrapowania | Unikanie blokad IP na dużą skalę | Wymagane API/kod | Rotacja proxy, CAPTCHA/browser handling, geotargetowanie | JSON (ustrukturyzowane endpointy); surowa odpowiedź dla głównego API | Oparte na użyciu (dokładne stawki niepubliczne) |
Jeśli już wiesz, że Twoje zadanie to „wrzuć tę jedną tabelę do Excela dziś”, przejdź od razu do Thunderbit albo Instant Data Scraper. Jeśli Twoim zadaniem jest „nasz developer potrzebuje niezawodnego sposobu na wejście w 10 000 URL-i bez blokad”, idź od razu do Firecrawl albo ScraperAPI. Wszyscy inni — czytaj dalej, bo środek tej listy to miejsce, w którym ląduje większość biznesowych zastosowań.
Najlepsze do ekstrakcji jednym kliknięciem bez selektorów: Thunderbit
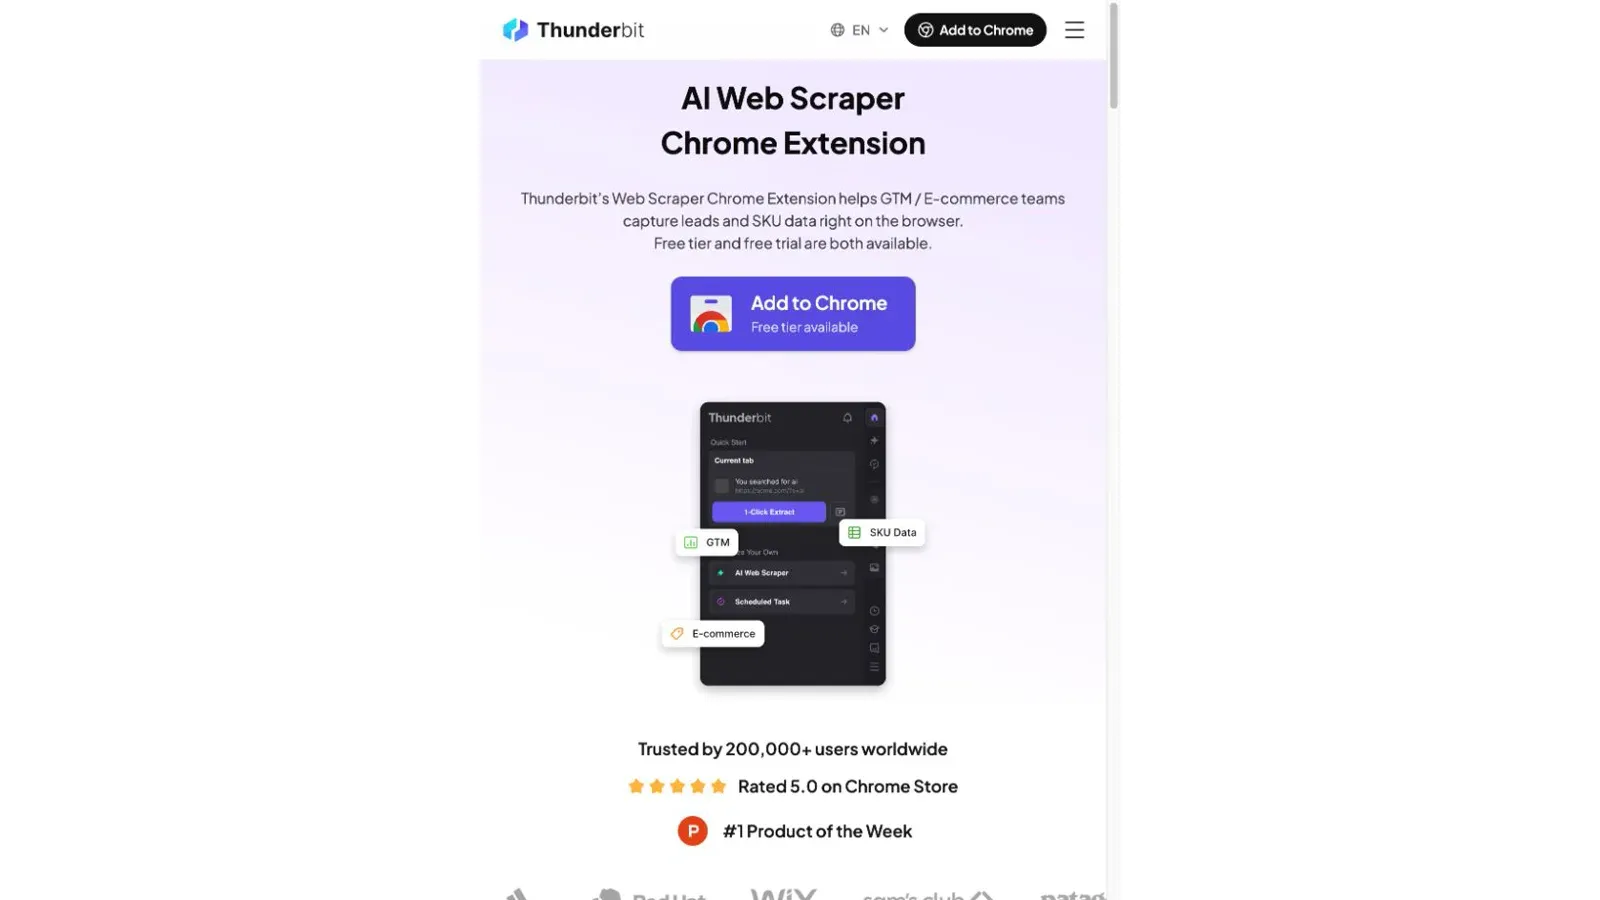
Thunderbit to natywne dla AI rozszerzenie do Chrome i Edge, stworzone tak, aby użytkownik nietechniczny nigdy nie musiał rysować selektora CSS. Otwierasz docelową stronę, klikasz One Click Extract, a Thunderbit odczytuje i analizuje stronę, żeby ustalić, co należy pobrać — po czym pokazuje przycisk Run Now, dzięki któremu możesz od razu uruchomić zadanie.
To naprawdę inny sposób pracy niż model „AI Suggest Fields → review → Scrape”, opisywany w starszych recenzjach Thunderbit. Obecny domyślny flow jest bliższy „jedno kliknięcie i gotowe”, a to ma znaczenie, jeśli szukałeś „scraper plugin” właśnie dlatego, że nie chcesz niczego konfigurować.
Najważniejsze funkcje:
- Kolumny podpowiadane przez AI bez ręcznego budowania selektorów CSS, z możliwością prostego dostosowania pól zwykłym językiem
- Enrichment na podstronach — podążanie za linkiem do strony szczegółów i automatyczne pobieranie dodatkowych pól
- Obsługa paginacji, masowego wprowadzania URL-i i nieskończonego scrolla na wspieranych stronach
- Tryb przeglądarkowy dla stron, na których jesteś zalogowany; tryb chmurowy dla stron publicznych
- Eksport do Excela, CSV, Google Sheets, Airtable, Notion lub JSON
Ceny (sprawdź aktualne wartości na oficjalnej stronie): darmowy plan obejmuje 6 stron miesięcznie; Starter kosztuje 15 USD/miesiąc za 500 kredytów; Pro kosztuje 38 USD/miesiąc za 3000 kredytów. Własne warunki Thunderbit mówią, że kredyty zużywane są na każdy wiersz wynikowy, co daje około 30 USD za 1000 wierszy w Starterze i około 12,67 USD za 1000 wierszy w Pro — to jednak wyliczenia z limitów, a nie faktury, więc przed planowaniem budżetu sprawdź ponownie stronę z cennikiem.
Najlepsze dla: zespołów sprzedaży, operacji lub marketingu, które chcą dziś dostać arkusz z dowolnej strony, bez nauki, czym jest selektor.
Jedno uczciwe ograniczenie: jak każde rozszerzenie z tej listy, Thunderbit działa tylko na zgodnych, autoryzowanych stronach. Nie obiecuje obchodzenia CAPTCHA ani innych systemów antybotowych, a jego warunki wprost zabraniają używania go do omijania kontroli dostępu. Żadne narzędzie nie robi tego niezawodnie — każdy, kto twierdzi inaczej, coś sprzedaje.
Najlepsza darmowa opcja do jednorazowego szybkiego scrapowania tabel: Instant Data Scraper
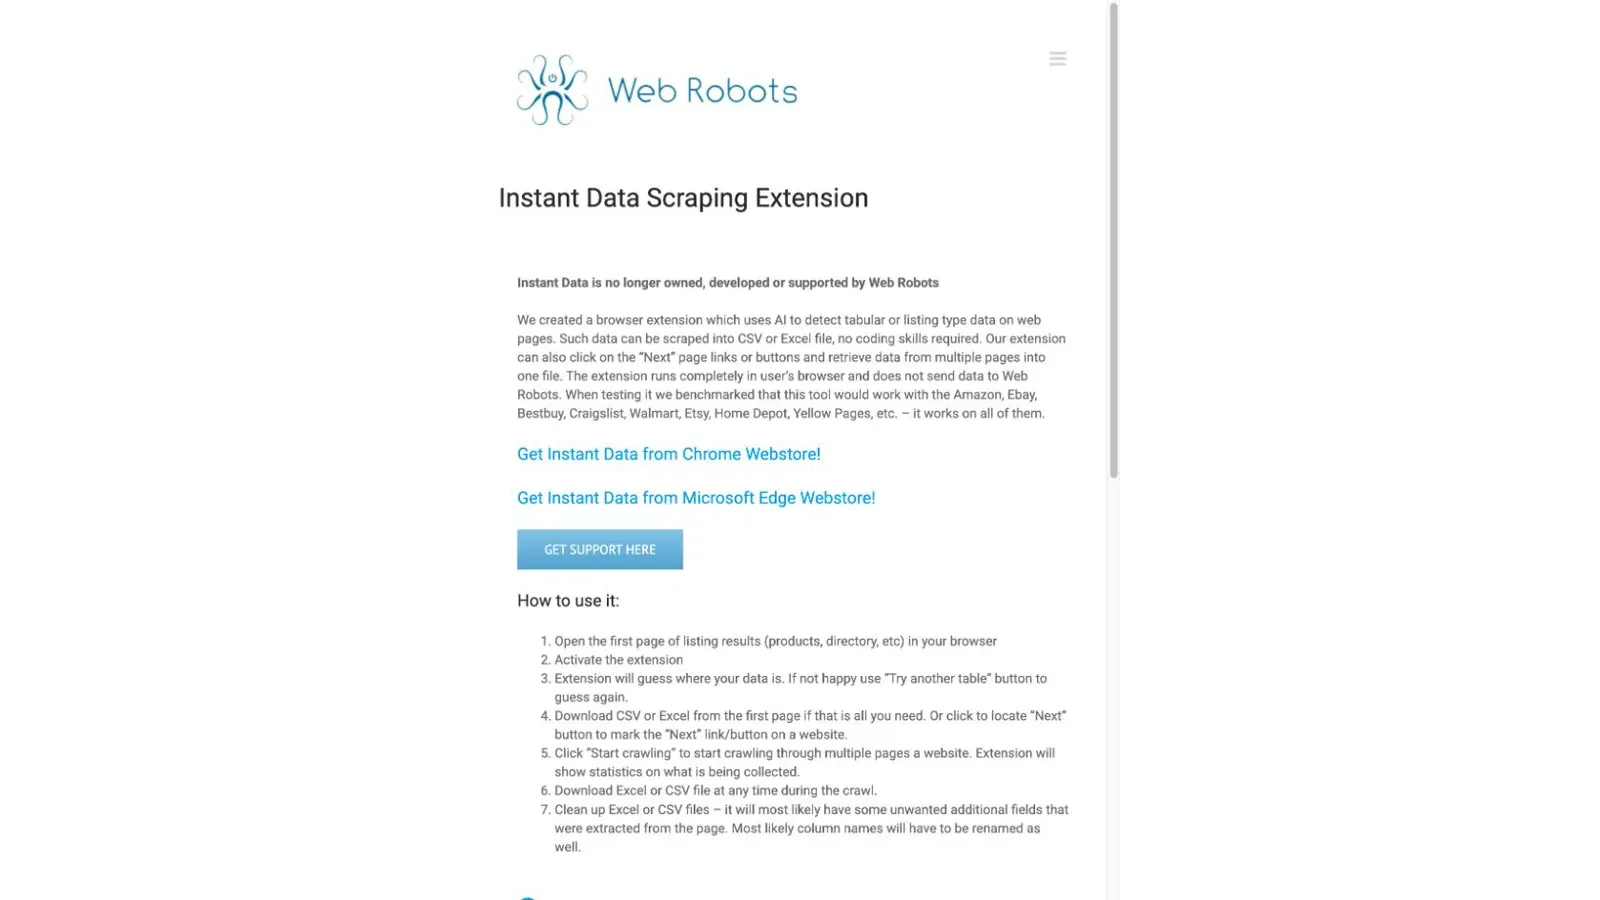
Instant Data Scraper to darmowe, heurystyczne rozszerzenie do Chrome, które automatycznie wykrywa najbardziej prawdopodobną tabelę lub listę na stronie i pozwala ją podejrzeć, dostroić oraz wyeksportować. Warto wiedzieć: obecnym wydawcą rozszerzenia w Chrome Web Store jest Flavr Technology, a nie Web Robots — Web Robots stworzyło to narzędzie, ale deklaruje, że już go nie posiada ani nie wspiera, więc starsze poradniki z tej domeny traktuj raczej jako historyczne odniesienia do procesu pracy niż aktualne zobowiązania dotyczące prywatności.
W czym jest dobre:
- Niemal natychmiastowy eksport do CSV/Excela z czystych, statycznych stron katalogowych
- Wykrywanie treści ładowanych dynamicznie i przez nieskończony scroll, z możliwością regulacji opóźnienia crawl
- Zero kosztów wdrożenia — naprawdę jest darmowe i nie wymaga konta
Do czego nie jest stworzone: nie ma udokumentowanego harmonogramu, API, eksportu JSON ani zarządzanej obsługi CAPTCHA. I tu jest rzecz, na którą naprawdę warto zwrócić uwagę — aktualna polityka prywatności wydawcy (ostatnia aktualizacja: lipiec 2026) ujawnia zbieranie szerszej aktywności przeglądania, wyszukiwania i zakupów online, niż sugerowałby slogan „Twoje dane zostają lokalnie”. To nie oznacza, że zeskrobane wiersze opuszczają przeglądarkę, ale oznacza, że nie jest to narzędzie, które z automatu poleciłbym do wrażliwej, zalogowanej sesji.
Najlepsze dla: jednorazowego pobrania danych z czystej, publicznej strony listingowej, gdy chcesz zerowego tarcia i zerowego kosztu.
Najlepsze do powtarzalnych receptur scrapowania: Web Scraper
Web Scraper dzieli się wyraźnie na dwa produkty: darmowe, nielimitowane lokalne rozszerzenie wykorzystujące punktowo-klikalną „sitemapę” selektorów oraz płatną wersję Web Scraper Cloud, która dodaje harmonogram, API, webhooki i zarządzanie blokadami.
Model sitemap wymaga więcej przygotowań niż Thunderbit czy Instant Data Scraper — ręcznie definiujesz nawigację i selektory danych — ale ten początkowy wysiłek daje coś, czego narzędzia heurystyczne nie oferują: udokumentowaną, wielokrotnego użytku recepturę, która za każdym razem działa tak samo (o ile strona się nie zmieni). Dokumentacja Web Scraper bardzo uczciwie opisuje ten kompromis, ostrzegając, że automatyczne zaznaczanie „point-and-click” „nie zawsze wystarcza” i że osobno oznaczone selektory „multiple” wymagają jawnego elementu opakowującego, inaczej wiersze się rozjadą.
- Lokalnie: darmowo, bez limitu, eksport CSV/XLSX, bez konieczności zakładania konta
- Cloud: harmonogramy (daily/interval/CRON), API, eksport JSON, proxy i funkcje obsługi CAPTCHA
- Ceny w chmurze zaczynają się od 50 USD/miesiąc (przy rozliczeniu rocznym) za 5000 kredytów URL — pamiętaj, że to kredyt za załadowaną stronę, a nie za wiersz, więc koszt na wiersz zależy od tego, ile rekordów zawiera dana strona
Najlepsze dla: zespołów, które chcą uruchamiać ten sam wielostronicowy scraping tydzień po tygodniu i są gotowe zainwestować czas w konfigurację na start.
Najlepszy no-code krok dalej dla stron dynamicznych: Octoparse
Octoparse najlepiej opisać jako aplikację desktopową z warstwą chmurowego wykonywania — nie ma wersji webowej i nie działa na Linuxie ani Chromebookach. To, co zyskujesz w porównaniu z rozszerzeniem przeglądarki, to tryb Chrome, który bezpośrednio steruje zainstalowanym Chrome’em na stronach z CAPTCHA i Cloudflare, tryb Phantom do lokalnych uruchomień headless oraz prawdziwą chmurową ekstrakcję dla zadań, które mają przetrwać zamknięcie laptopa.
- Wykrywanie AJAX z konfigurowalnymi timeoutami dla treści dynamicznych
- Jawna obsługa paginacji dla przycisków Next, Load More i nieskończonego scrolla
- Eksport do Excela, CSV, JSON, XML, Google Sheets, baz SQL lub chmury na płatnych planach
W kwestii cen trzeba uważać: aktualna strona cenowa (w momencie pisania) pokazuje Standard „od 69 USD/miesiąc” i Professional około 199 USD, ale własna strona porównawcza w centrum pomocy Octoparse podaje inne liczby niż karta cennika. Przed zakupem sprawdź przełącznik rozliczenia i aktualną promocję.
Najlepsze dla: użytkowników, którzy wyrośli z prostego rozszerzenia i potrzebują wizualnej kontroli nad naprawdę dynamicznymi stronami, ale nie chcą pisać kodu.
Najlepsze do złożonej, wielopoziomowej paginacji: ParseHub
ParseHub to aplikacja desktopowa — nie przeglądarkowy plugin — z interfejsem point-and-click opartym na osadzonej przeglądarce. To, co ją wyróżnia, to hierarchia komend: Select, Relative Select, Click oraz naprawdę sprytny Jump, który rekurencyjnie wraca do nadrzędnego wyboru, co dokumentacja ParseHub wprost rekomenduje dla głęboko zagnieżdżonych wątków komentarzy.
To jest realna odpowiedź na „złożoną, wielopoziomową paginację” — większość narzędzi z tej listy nie ma odpowiednika Jump. Kompromis to złożoność konfiguracji: przewodnik ParseHub ostrzega, że umieszczenie kliknięcia następnej strony pod złym elementem nadrzędnym może spowodować, że scraper będzie w kółko scrapował drugą stronę.
Warto zaznaczyć jedną cechę: testowe uruchomienia używają Twojego lokalnego IP, ale „normalne” uruchomienia produkcyjne przesyłają projekt i wykonują go na serwerach ParseHub z innymi adresami IP — co oznacza, że projekt działający idealnie w testach może dać inny wynik albo blokadę po uruchomieniu na żywo. ParseHub stworzył funkcję „Server Snapshot” właśnie po to, by debugować tę różnicę.
Najlepsze dla: wielopoziomowej, głęboko zagnieżdżonej paginacji (np. wątki komentarzy, drzewa kategorii), gdzie prostsze narzędzia point-and-click zawodzą.
Najlepsze do monitoringu i alertów według harmonogramu: Browse AI
Browse AI po cichu stało się platformą monitoringu najpierw w chmurze, a dopiero potem narzędziem przeglądarkowym — własne centrum pomocy z marca 2026 wprost wycofuje rozszerzenie Chrome na rzecz „Robot Studio”. (Na stronie FAQ o cenach wciąż mówi się nowym użytkownikom, żeby instalowali rozszerzenie, co jest typowym przykładem wewnętrznej niespójności, gdy produkt szybciej zmienia kierunek niż jego treści marketingowe.)
W czym radzi sobie dobrze: każdy nagrany „robot” można zaplanować godzinowo, dziennie, tygodniowo albo w niestandardowych odstępach, z historią zmian, alertami e-mail i integracjami webhook. System kredytów jest szczegółowy — 10 wierszy listy to 1 kredyt, z minimalnym kosztem 1 kredytu na zadanie, a „premium sites” (większe bezpieczeństwo, większa złożoność dynamiczna) kosztują minimum 2–10 kredytów za zadanie.
Najlepsze dla: powtarzalnego monitoringu cen, obserwowania konkurencji albo workflow „powiadom mnie, gdy coś się zmieni”, gdzie celem nie jest jednorazowy eksport, lecz ciągła obserwacja.
Najlepsze do automatyzacji sociali i lead generation: PhantomBuster
PhantomBuster to chmurowa platforma automatyzacji z towarzyszącym rozszerzeniem do przeglądarki, zbudowana wokół gotowych „Phantomów” do zadań takich jak pozyskiwanie leadów na LinkedIn, enrichment i outreach. Własne FAQ dostawcy podaje ważną rzecz, którą warto powtórzyć dosłownie: automatyzacja działa przez Twoje własne konto i nie korzysta z danych, których nie mógłbyś już zobaczyć.
To rozsądna zasada projektowa, ale nie odpowiada na trudniejsze pytanie — czy częstotliwość automatyzacji albo typ działań nie narusza regulaminu docelowej platformy? Samo odczytywanie danych i działania na koncie (wysyłanie zaproszeń, wiadomości, polubień) niosą bardzo różny poziom ryzyka, a strona główna PhantomBuster wprost reklamuje oba scenariusze. Traktuj hasło „działa przez Twoje konto” jako punkt wyjścia do analizy zgodności, a nie gwarancję bezpieczeństwa.
Najlepsze dla: zespołów sprzedaży realizujących obsługiwane workflow LinkedIn lub social lead-gen — nie jako zamiennik uniwersalnego scrapera stron.
Najlepszy chmurowy fallback do dużych crawlów mocno opartych na JS: Firecrawl
Firecrawl nazywa siebie „context API do wyszukiwania, scrapowania i interakcji z webem na dużą skalę” i to jest trafny opis — to nie jest plugin, tylko infrastruktura dla developerów z SDK dla Python, Node.js, Go, Rust, Java i Elixir oraz oficjalnym serwerem MCP dla agentów AI.
To narzędzie, po które sięgasz wtedy, gdy rozszerzenie przeglądarki fizycznie nie daje już rady: laptop nie może być otwarty przez crawl 10 000 stron albo potrzebujesz czystego wyjścia Markdown/JSON dla pipeline’u LLM zamiast CSV. Endpoint Crawl w Firecrawl respektuje reguły robots.txt zapisane dla dyrektywy FirecrawlAgent — to mały, ale konkretny sygnał odpowiedzialnego podejścia, którego większość konkurentów nie publikuje.
Rozliczenie jest oparte na kredytach: Scrape, Crawl, Map i Monitor kosztują 1 kredyt za stronę; Search kosztuje 2 kredyty za 10 wyników; Interact (wieloetapowe akcje przeglądarkowe) kosztuje 2 kredyty za minutę działania przeglądarki. Darmowy plan zawiera 1000 kredytów miesięcznie. Dokładnych kwot w dolarach nie udało się potwierdzić w czasie researchu — sprawdź aktualny cennik.
Najlepsze dla: developerów budujących cykliczny crawl albo karmiących ustrukturyzowaną treścią webową pipeline AI/RAG.
Najlepszy chmurowy fallback do unikania blokad IP na dużą skalę: ScraperAPI
ScraperAPI jest wprost opisywane jako „web scraping API do zbierania danych z publicznych stron” — bez przeglądarki, bez aplikacji desktopowej, tylko endpoint, który za Ciebie obsługuje rotację proxy, rozwiązywanie CAPTCHA i renderowanie przeglądarkowe, niezależnie od tego, co już zbudowałeś. Firma reklamuje pulę ponad 40 milionów proxy w ponad 50 krajach, a także ustrukturyzowane endpointy dla konkretnych celów, takich jak Amazon i Google Search, które zwracają od razu sparsowany JSON zamiast surowego HTML.
To właściwe narzędzie wtedy, gdy Twój problem nie brzmi „nie wiem, jak sparsować tę stronę”, tylko „dokładnie wiem, jak ją sparsować, ale ciągle dostaję blokadę IP albo CAPTCHA”. To węższe, bardziej uczciwe pozycjonowanie niż „dowolna strona”, i trzymałbym się właśnie tego węższego ujęcia: własna strona główna ScraperAPI ogranicza zakres do publicznych stron, a nie treści za logowaniem.
Dokładne, aktualne progi cenowe nie zostały publicznie potwierdzone w czasie researchu — dostawca nie publikuje szczegółowych stawek per request na głównych stronach marketingowych, więc przed decyzją poproś o ofertę lub sprawdź aktualny cennik.
Najlepsze dla: zespołu, który ma już własny scraper, a prawdziwym wąskim gardłem są blokady IP, nie logika ekstrakcji.
Dlaczego scraper pluginy zawodzą albo są blokowane
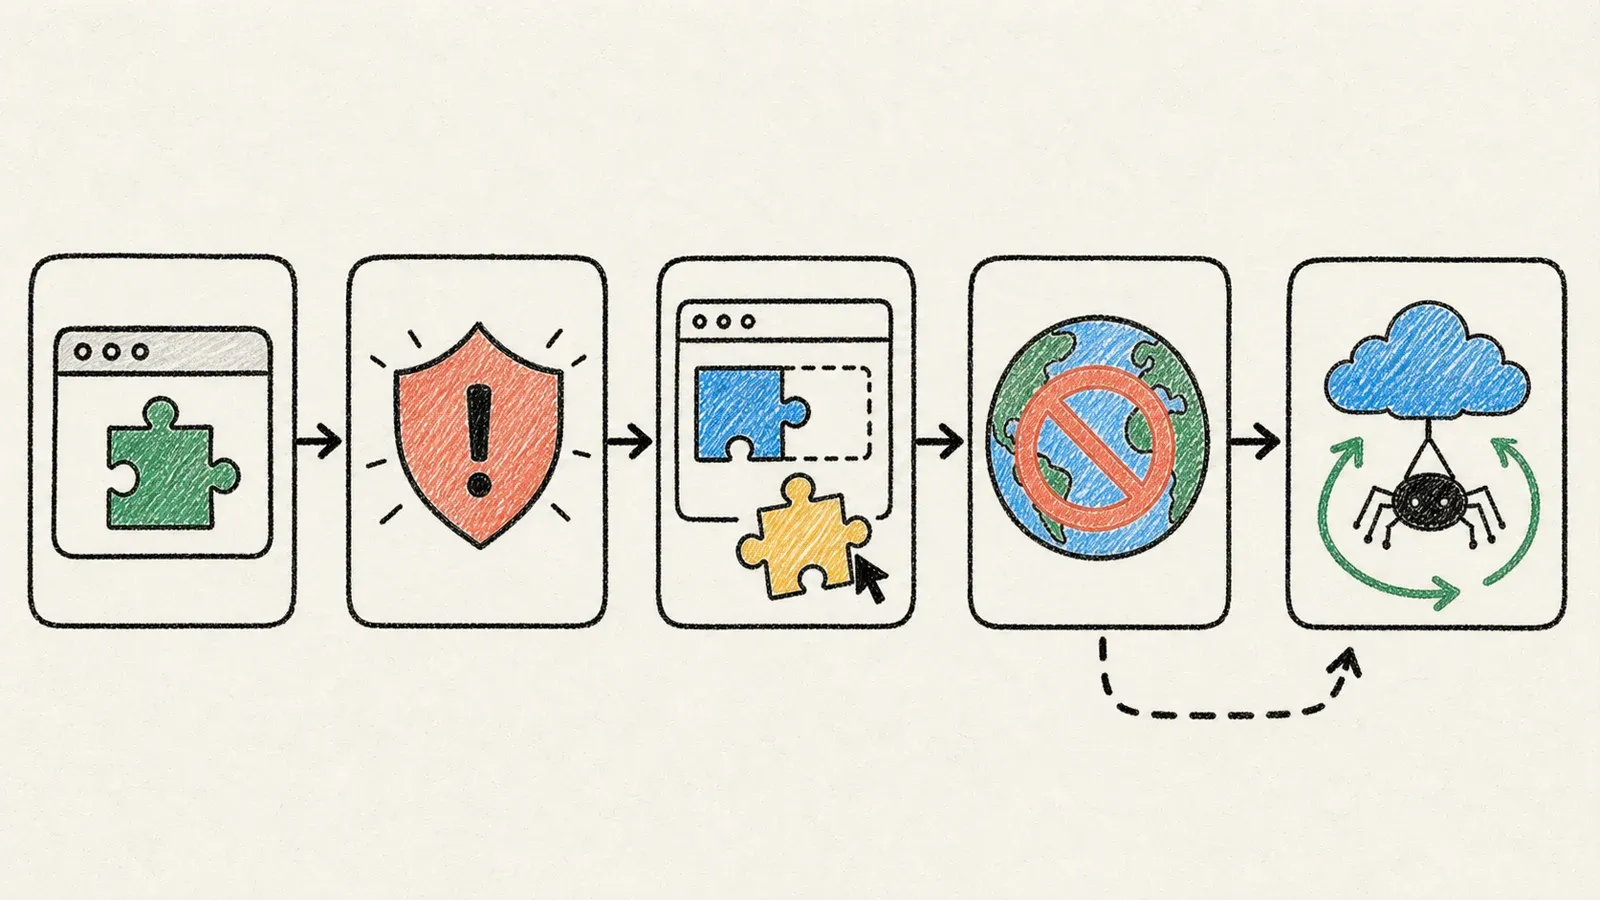
Pusty wynik i wynik z blokadą wyglądają dla użytkownika identycznie, ale to różne problemy, które wymagają różnych napraw.
| Rodzaj błędu | Co się dzieje | Co sprawdzić najpierw |
|---|---|---|
| Drift DOM/selektora | Przebudowa strony przesunęła pola | Ponownie uruchom wykrywanie, zaktualizuj recepturę |
| Timing JS | Treść ładuje się po wywołaniu API lub interakcji | Dodaj czekanie, sprawdź wyrenderowany stan |
| Nieskończony scroll / wirtualizowane listy | W DOM jednocześnie istnieją tylko widoczne wiersze | Przetestuj przewijanie, sprawdź deduplikację |
| Stan paginacji / nawigacji | Logika kolejnej strony nie jest poprawnie śledzona | Zweryfikuj zakres pętli i warunek stopu |
| Logowanie / gating sesji | Treść zależy od ciasteczek lub tokena | Potwierdź autoryzację i zakres sesji |
| Ograniczenia rate/IP | Wzorzec żądań uruchomił throttling lub CAPTCHA | Zwolnij tempo, sprawdź politykę celu |
Narzędzia oparte na selektorach (heurystyczne wykrywanie w Instant Data Scraper, stała sitemapa w Web Scraper) są najbardziej narażone na pierwszy rodzaj błędu, bo zapamiętują strukturę zamiast odczytywać ją ponownie. Narzędzia agentowe, takie jak Thunderbit, ponownie analizują stronę przy każdym uruchomieniu, co może ograniczyć — choć nie wyeliminować — ten konkretny problem. To nie pomoże przy limitach żądań, CAPTCHA ani ścianie logowania, i żaden dostawca na tej liście, w tym Thunderbit, nie twierdzi wiarygodnie inaczej. Gdy ograniczenia rate/IP albo ciężkie renderowanie JS stają się stałym wąskim gardłem, a nie tylko okazjonalną niedogodnością, to sygnał, że czas przejść na fallback chmurowy, taki jak Firecrawl lub ScraperAPI, albo na tryb chmurowej ekstrakcji, jak płatna warstwa Octoparse.
Porównanie realnych kosztów: ile kosztują te narzędzia na 1000 wierszy?
Problem z porównywaniem tych narzędzi wyłącznie po cenie jest taki, że nie rozliczają się w tej samej jednostce. Thunderbit pobiera opłatę za każdy wiersz wynikowy. Web Scraper Cloud nalicza opłatę za załadowany URL (z którego może wyjść zero albo tysiąc wierszy). Firecrawl liczy per strona w Scrape/Crawl/Map/Monitor. Browse AI pobiera opłatę za 10 wierszy z minimalnym kosztem 1 kredytu za zadanie, co może dominować przy małych jobach. PhantomBuster i ScraperAPI nie publikują wystarczająco szczegółowych cen, by dało się policzyć stawkę.
| Narzędzie | Zweryfikowana jednostka | Przybliżony koszt po normalizacji | Hak |
|---|---|---|---|
| Thunderbit | Kredyt za wiersz wynikowy | ~30 USD/1K wierszy (Starter), ~12,67 USD/1K (Pro) | Działania agenta mogą zużywać zmienną liczbę kredytów |
| Instant Data Scraper | Darmowe | 0 USD/1K wierszy | Nie obejmuje czasu czyszczenia, brak harmonogramu |
| Web Scraper (Cloud) | Kredyt za załadowany URL | 10 USD/1K URL-i (Project), 5 USD/1K URL-i (Professional) | Liczba wierszy na URL bardzo się różni |
| Browse AI | 10 wierszy = 1 kredyt, minimum 1 kredyt za zadanie | ~1,90–20,90 USD/1K w zależności od użycia stron szczegółów | Strony szczegółów i witryny premium zjadają budżet |
| Firecrawl | 1 kredyt za stronę | Darmowy plan obejmuje 1000 stron/miesiąc | Strony ≠ wiersze; ceny płatne nie były publicznie potwierdzone w czasie researchu |
| Octoparse, ParseHub, PhantomBuster, ScraperAPI | Zależy / nie w pełni publiczne | Nie da się wiarygodnie obliczyć | Przed budżetowaniem sprawdź aktualne dokumenty rozliczeniowe |
Nie ufaj żadnemu twierdzeniu w stylu „X USD za 1000 wierszy” — włącznie z moim powyżej — bez sprawdzenia aktualnej strony z cennikiem i przeliczenia tego na rzeczywistą gęstość danych w Twoim przypadku. Narzędzie liczone per strona wygląda tanio, dopóki z jednej strony nie wyjdzie 10 wierszy zamiast 100.
Dopasowanie każdego scraper pluginu do konkretnego zastosowania
| Potrzeba | Zacznij tutaj | Dlaczego |
|---|---|---|
| Jedna strona, minimalna konfiguracja, bez kodu | Thunderbit | Jedno kliknięcie, pola podpowiadane przez AI |
| Darmowy, jednorazowy, czysta statyczna tabela | Instant Data Scraper | Zero kosztu, zero konfiguracji |
| Powtarzalna receptura uruchamiana co tydzień | Web Scraper | Jawna, wersjonowalna kontrola selektorów |
| Strony dynamiczne, potrzebna kontrola desktopowa | Octoparse | Tryby Chrome/Phantom + warstwa chmurowa |
| Głęboko zagnieżdżona paginacja | ParseHub | Celowo zaprojektowana komenda Jump |
| Harmonogramy i alerty | Browse AI | Robot + harmonogram w chmurze, historia zmian |
| Obsługiwany workflow social / lead-gen | PhantomBuster | Gotowa automatyzacja oparta na koncie |
| Duży, cykliczny crawl JS-heavy do AI/RAG | Firecrawl | Markdown/JSON, SDK, MCP |
| Istniejący scraper ciągle dostaje blokadę IP | ScraperAPI | Zarządzana warstwa proxy/CAPTCHA |
Dopasuj narzędzie do najmniejszego modelu operacyjnego, który naprawdę rozwiązuje Twój problem. Nie przejmuj od razu API dla developerów tylko dlatego, że brzmi mocniej — i nie trzymaj karty w przeglądarce bez końca dla zadania, które powinno działać według harmonogramu gdzieś indziej.
Czy używanie scraper pluginu jest legalne? Krótka uwaga o regulaminach i prywatności
Nie jestem prawnikiem i nie jest to porada prawna — ale oto praktyczna wersja. Ogranicz się do danych publicznych lub wyraźnie autoryzowanych. Zanim rozpoczniesz regularne scrapowanie, sprawdź regulamin strony docelowej i plik robots.txt. I zachowaj szczególną ostrożność przy narzędziach działających w zalogowanej sesji — tryb przeglądarkowy Thunderbit, konfiguracja stanu logowania w Web Scraper oraz automatyzacja oparta na koncie w PhantomBuster mieszczą się w tej kategorii.
To, że da się obejść barierę techniczną (CAPTCHA, ściana logowania), nie znaczy, że masz na to zgodę. Własne FAQ PhantomBuster mówi, że narzędzie pobiera tylko dane, które i tak widziałbyś przez swoje konto — to rozsądna zasada projektowa, ale nie daje Ci automatycznie prawa do publikowania, odsprzedaży ani masowego kontaktowania się z ludźmi tylko dlatego, że technicznie możesz zobaczyć ich profil. Minimalizuj zakres zbieranych danych osobowych, miej jasno określony cel i nie trzymaj danych dłużej, niż naprawdę potrzebujesz.
Żadne z narzędzi z tej listy — nawet te, które na stronach cenowych używają słowa „compliant” — nie może automatycznie sprawić, że Twój konkretny przypadek użycia będzie legalny. To zależy od strony docelowej, rodzaju danych i tego, co zrobisz z nimi później.
Wniosek: którego scraper pluginu powinieneś użyć?
Jeśli potrzebujesz dziś jednego czystego arkusza i nie chcesz myśleć o selektorach, zainstaluj prawdziwe rozszerzenie przeglądarki — Thunderbit, jeśli chcesz pola podpowiadane przez AI i eksport do narzędzi biznesowych, albo Instant Data Scraper, jeśli strona jest czysta, a Ty chcesz zerowego kosztu. Jeśli co tydzień uruchamiasz to samo scrapowanie, model receptur Web Scraper albo desktopowy workflow Octoparse da Ci powtarzalność kosztem czasu konfiguracji. Jeśli Twoim problemem jest naprawdę złożona, zagnieżdżona paginacja, drzewo komend ParseHub zostało stworzone właśnie do tego. Jeśli zadanie brzmi „obserwuj to i wyślij alert”, wybierz Browse AI. A jeśli przerośnięte zostały już wszystkie te rozwiązania — tysiące URL-i, strony mocno oparte na JS albo stały problem z blokadą IP — przekaż to developerowi i wskaż mu odpowiednio Firecrawl albo ScraperAPI.
Plugin jest właściwym narzędziem do sprawdzonego, jednorazowego, samoobsługowego zadania. API jest właściwym narzędziem do działającego bez nadzoru, skalowalnego pipeline’u należącego do developera. Nie myl tych dwóch rzeczy tylko dlatego, że oba zawierają w nazwie słowo „scraper”.
FAQ
Czy scraper pluginy / rozszerzenia są bezpieczne na stronach z logowaniem? Tylko wtedy, gdy masz uprawnienie do dostępu do danych i sprawdziłeś, co narzędzie robi z Twoją sesją. Szerokie uprawnienia przeglądarki są częste, bo scraper musi czytać dowolne strony — to nie oznacza automatycznie, że Twoje dane opuszczają przeglądarkę, ale oznacza, że powinieneś sprawdzić politykę prywatności każdego narzędzia zamiast zakładać. W myśleniu o ryzyku oddziel działania modyfikujące konto (jak funkcje wiadomości w PhantomBuster) od zwykłej ekstrakcji tylko do odczytu.
Jaka jest różnica między scraper pluginem a scraper API? Plugin działa w Twojej przeglądarce na stronie, którą masz otwartą — bez kodu, z minimalną konfiguracją, powiązany z sesją. API działa na infrastrukturze (Twojej albo dostawcy) i zwraca dane programowo do pipeline’u. Aplikacje desktopowe, takie jak ParseHub i Octoparse, są pośrodku: więcej konfiguracji niż w pluginie, ale bardziej wizualna kontrola niż w surowym API.
Dlaczego mój scraper plugin nagle zwraca puste albo uszkodzone dane? Zwykle chodzi o jedną z kilku przyczyn: układ strony się zmienił i selektor już nie pasuje, treść ładuje się przez JavaScript po tym, jak narzędzie już sprawdziło stronę, logika paginacji nie poradziła sobie z nowym typem strony albo wygasło ciasteczko logowania. Narzędzia, które przy każdym uruchomieniu ponownie analizują strukturę strony (jak agentowe podejście Thunderbit), mogą szczególnie ograniczyć błędy driftu selektora, ale żadne z narzędzi z tej listy nie eliminuje limitów żądań ani ścian CAPTCHA.
Czy mogę używać darmowego scraper pluginu do cyklicznego, zaplanowanego scrapowania? Nie jest to rozwiązanie pewne. Darmowe narzędzia, takie jak Instant Data Scraper i lokalne rozszerzenie Web Scraper, nie mają udokumentowanego harmonogramu — działają wtedy, gdy przeglądarka jest otwarta i klikniesz przycisk. Jeśli potrzebujesz naprawdę bezobsługowych, cyklicznych uruchomień, potrzebujesz płatnej warstwy: schedulerów Thunderbit, Web Scraper Cloud, chmurowej ekstrakcji Octoparse albo produktu monitorującego Browse AI.
Dowiedz się więcej



