
Web terus menjadi makin kompleks setiap tahun, sementara jarak antara “saya butuh datanya” dan “saya tahu cara ngambilnya” tetap terasa lebar. Buat pemula, pertanyaan pertama biasanya simpel: Apa saya benar-benar harus belajar Python cuma untuk ambil harga produk dari sebuah situs web?
Untungnya, jawabannya tidak. Tapi pertanyaan berikutnya—tool mana yang sebenarnya harus saya pakai?—di situlah semuanya mulai ribet. Ada aplikasi desktop tanpa kode, ekstensi browser, framework Python, library Go, spider SEO, API terkelola, dan proyek open-source yang batasnya saling tumpang tindih. Sepuluh opsi yang paling menonjol di tahun 2026 ini layak dilihat dari hal-hal yang benar-benar penting buat pemula: seberapa banyak coding yang dibutuhkan, seberapa cepat data bisa dipakai, apakah tool sanggup menangani situs berat JavaScript, apa saja yang bisa didapat gratis, dan untuk kasus penggunaan apa tool itu paling cocok. Entah kamu belum pernah nulis satu baris kode pun, atau junior developer yang lagi cari framework crawler pertama, ada titik awal yang pas di sini.
Cara Kami Memilih Web Crawler Terbaik untuk Pemula
“Pemula” bukan berarti “tidak teknis.” Maksudnya adalah siapa pun yang belum pernah membangun workflow web crawling sebelumnya—termasuk orang yang cukup nyaman menulis Python atau JavaScript dasar, tapi belum pernah mengelola antrean URL atau berurusan dengan file robots.txt.
Setiap tool dinilai berdasarkan enam dimensi yang langsung menjawab pertanyaan yang biasanya ditanyakan pemula di forum:
- Perlu Coding atau Tidak — Tidak perlu, Python/JS dasar, atau level menengah ke atas
- Tingkat Kesulitan Setup — Waktu dari instalasi sampai data pertama yang bisa dipakai
- Rendering JavaScript — Bisa menangani SPA dan halaman yang memuat konten secara dinamis?
- Kedermawanan Free Tier — Apa yang bisa dipakai sebelum bayar apa pun?
- Format Output — CSV, JSON, Excel, Google Sheets, dan sebagainya
- Kasus Penggunaan Terbaik — Skenario spesifik tempat tool itu paling bersinar buat pemula
Daftar ini mencakup tiga tingkat kemampuan: no-code (tanpa programming), intermediate (Python atau JavaScript dasar), dan advanced beginner (Go atau pemahaman framework yang lebih dalam). Saya berusaha jujur soal kelebihan dan keterbatasan masing-masing tool—karena salah pilih crawler untuk level kemampuanmu adalah salah satu cara tercepat buat buang waktu seharian.
Pilih Web Crawler Pertama Anda: Flowchart Keputusan Singkat
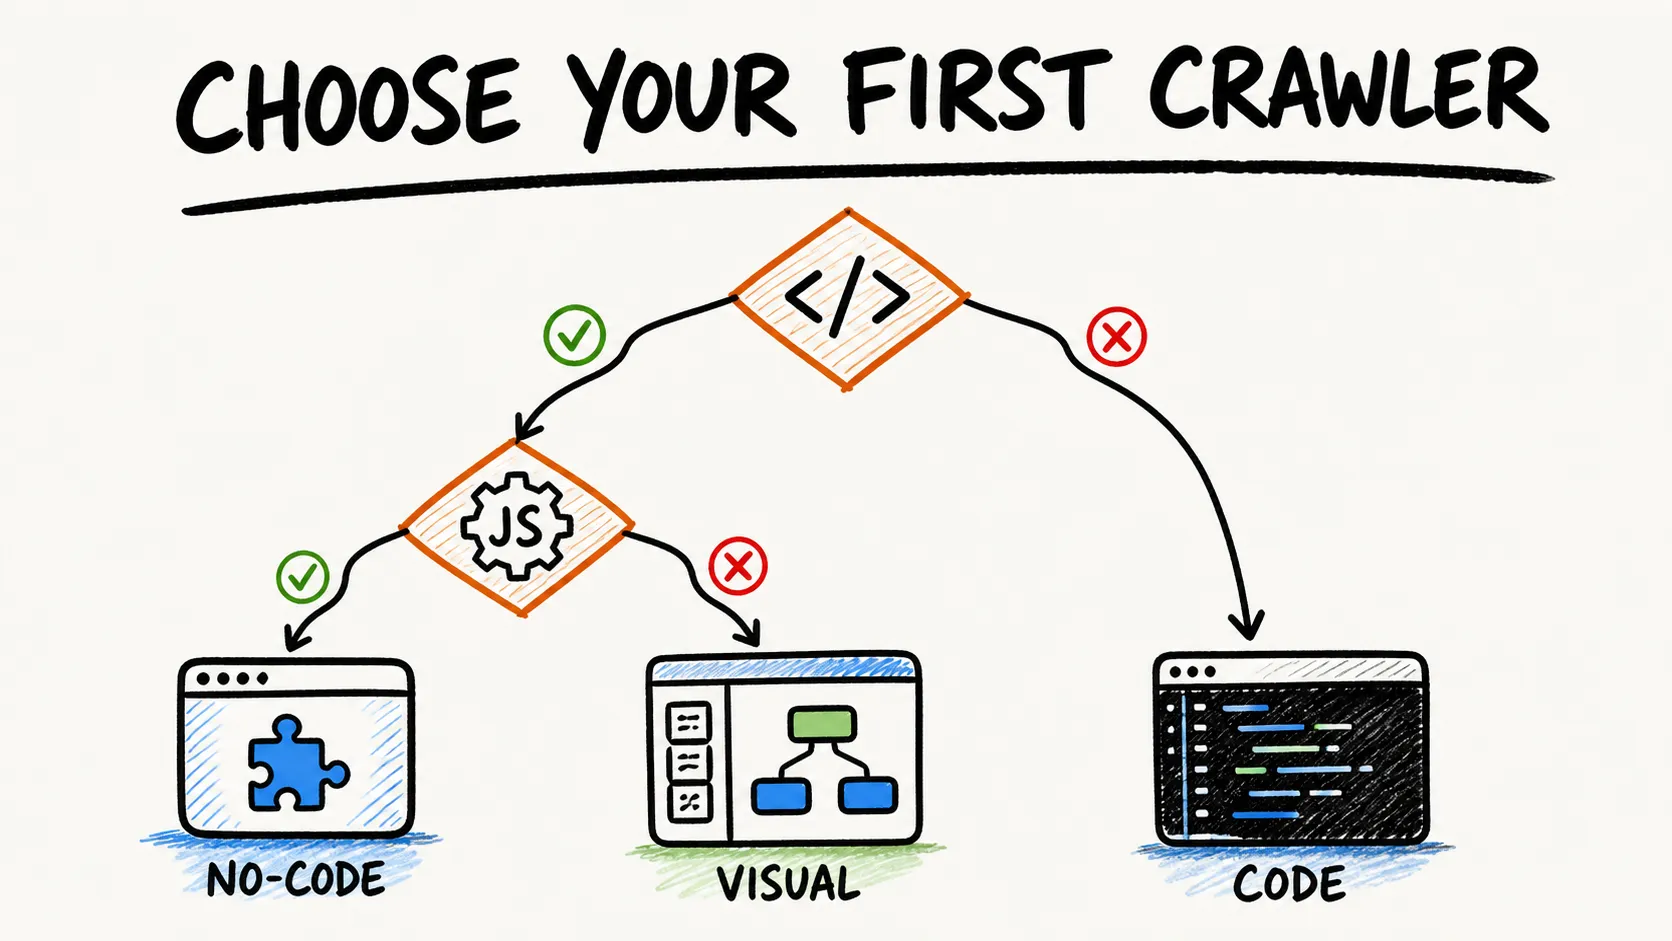
Sebelum baca sepuluh ulasan tool ini, jawab tiga pertanyaan berikut. Titik temu jawabannya akan mengarah ke satu atau dua tool yang paling pas.
Pertanyaan 1: Seberapa nyaman Anda dengan coding?
- Tidak ada → Lanjut ke Pertanyaan 2a
- Python dasar → Lanjut ke Pertanyaan 2b
- JavaScript/TypeScript → Lanjut ke Pertanyaan 2c
- Go → Colly
Pertanyaan 2a (Tanpa kode): Apa tujuan utama Anda?
- Ekstraksi data umum (info produk, daftar lead, riset) → Thunderbit atau Octoparse
- Alur multi-langkah yang rumit (login, dropdown, infinite scroll) → ParseHub atau Octoparse
- Audit SEO → Screaming Frog
Pertanyaan 2b (Python): Apa tujuan utama Anda?
- Pipeline AI/LLM (RAG, pelatihan chatbot) → Crawl4AI atau Firecrawl
- Crawling terstruktur skala besar untuk situs yang mostly statis → Scrapy
- Automasi browser untuk situs berat JS → Playwright (tapi siapkan logika crawling sendiri)
Pertanyaan 2c (JavaScript/TypeScript): Apa tujuan utama Anda?
- Crawling SPA modern dengan anti-blocking → Crawlee
- Interaksi browser yang kompleks (login, klik, screenshot) → Playwright
- Markdown bersih untuk input AI → Firecrawl (via API/SDK)
Filter anggaran: Kalau kamu butuh software $0 dan bisa self-host, tool open-source di sini (Scrapy, Crawlee, Crawl4AI, Playwright, dan Colly) tidak punya kuota halaman dari vendor, walaupun komputasi, bandwidth, penyimpanan, maintenance, dan batasan situs target tetap berlaku. Kalau kamu tidak bisa self-host, Octoparse, ParseHub, Thunderbit, Firecrawl, dan Screaming Frog masing-masing menawarkan jalur gratis dengan batas yang berbeda.
Flowchart ini saja bisa menghemat waktu kamu berjam-jam pindah tab. Simpan saja sebagai bookmark.
Sekilas Web Crawler Terbaik untuk Pemula
Berikut tabel perbandingan lengkapnya. “Coding Required” menunjukkan bahasa apa yang kamu perlukan, kalau ada. “JS Rendering” menunjukkan apakah tool bisa menangani halaman yang memuat konten lewat JavaScript. “Free Tier” merangkum apa yang bisa kamu dapatkan di harga $0. Ulasan detailnya ada di bawah.
| Tool | Skill Level | Coding Required | JS Rendering | Free Tier | Best For |
|---|---|---|---|---|---|
| Octoparse | Beginner | None | ✅ Built-in | Free plan: 10 tasks, local-only, 10K rows/export | Point-and-click scraping of structured sites |
| ParseHub | Beginner | None | ✅ Built-in | 5 public projects, 200 pages/run, 14-day retention | Complex multi-page flows without code |
| Thunderbit | Beginner | None | ✅ Via browser | Free tier (verify current limits) | AI-assisted extraction from the page you're on |
| Crawl4AI | Intermediate | Python | ✅ Chromium | Open source (self-hosted) | LLM-ready crawling for RAG pipelines |
| Firecrawl | Intermediate | API/SDK | ✅ Managed | 1,000 credits/month (cloud) | Clean markdown output for AI ingestion |
| Scrapy | Intermediate | Python | ⚠️ Needs plugin | Open source (BSD) | Large-scale, customizable HTTP crawl projects |
| Crawlee | Intermediate | JS/TS or Python | ✅ Via Playwright | Open source (Apache) | Modern JS crawling with anti-blocking |
| Playwright | Intermediate | Python/JS/Java/.NET | ✅ Native | Open source (Apache) | Browser automation + JS-heavy site interaction |
| Screaming Frog | Beginner | None | ✅ (paid only) | 500 URLs/crawl (free forever) | SEO auditing and technical site analysis |
| Colly | Advanced beginner | Go | ⚠️ None built in | Open source (Apache) | Fast, lightweight concurrent HTTP crawling |
Sekarang, mari masuk ke rincian tiap tool.
1. Octoparse

Octoparse adalah pembuat task desktop tanpa kode dengan opsi eksekusi cloud berbayar. Kamu tinggal tempel URL, lalu Auto-detect akan mengidentifikasi field data yang berulang dan pola navigasi, mengecek pratinjau, lalu menjalankan task secara lokal. Editor workflow visualnya mendukung loop, branch, pagination, infinite scroll, AJAX, form, dan dropdown—meski alur dinamis kadang tetap butuh penyesuaian waktu secara manual.
Fitur utama:
- Auto-detect untuk field data dan navigasi halaman
- Rendering JavaScript bawaan lewat browser internal
- Ratusan template siap pakai untuk situs umum
- Workflow yang bisa diedit dengan loop, branch, dan kontrol selector kustom
- Ekspor ke Excel, CSV, HTML, JSON, XML, Google Sheets, dan database (tergantung paket)
Harga: Tier gratis terbatas mendukung run lokal. Eksekusi cloud, penjadwalan, rotasi IP, dan akses API butuh paket berbayar. Cek harga terbaru sebelum berkomitmen karena batas paket bisa berubah.
Cocok untuk: Pemula yang ingin ekstraksi terstruktur berulang dari situs e-commerce, direktori, atau listing—tanpa nulis kode. Kurang ideal kalau kamu butuh kenyamanan ekstensi browser atau format output yang siap langsung untuk LLM.
2. ParseHub
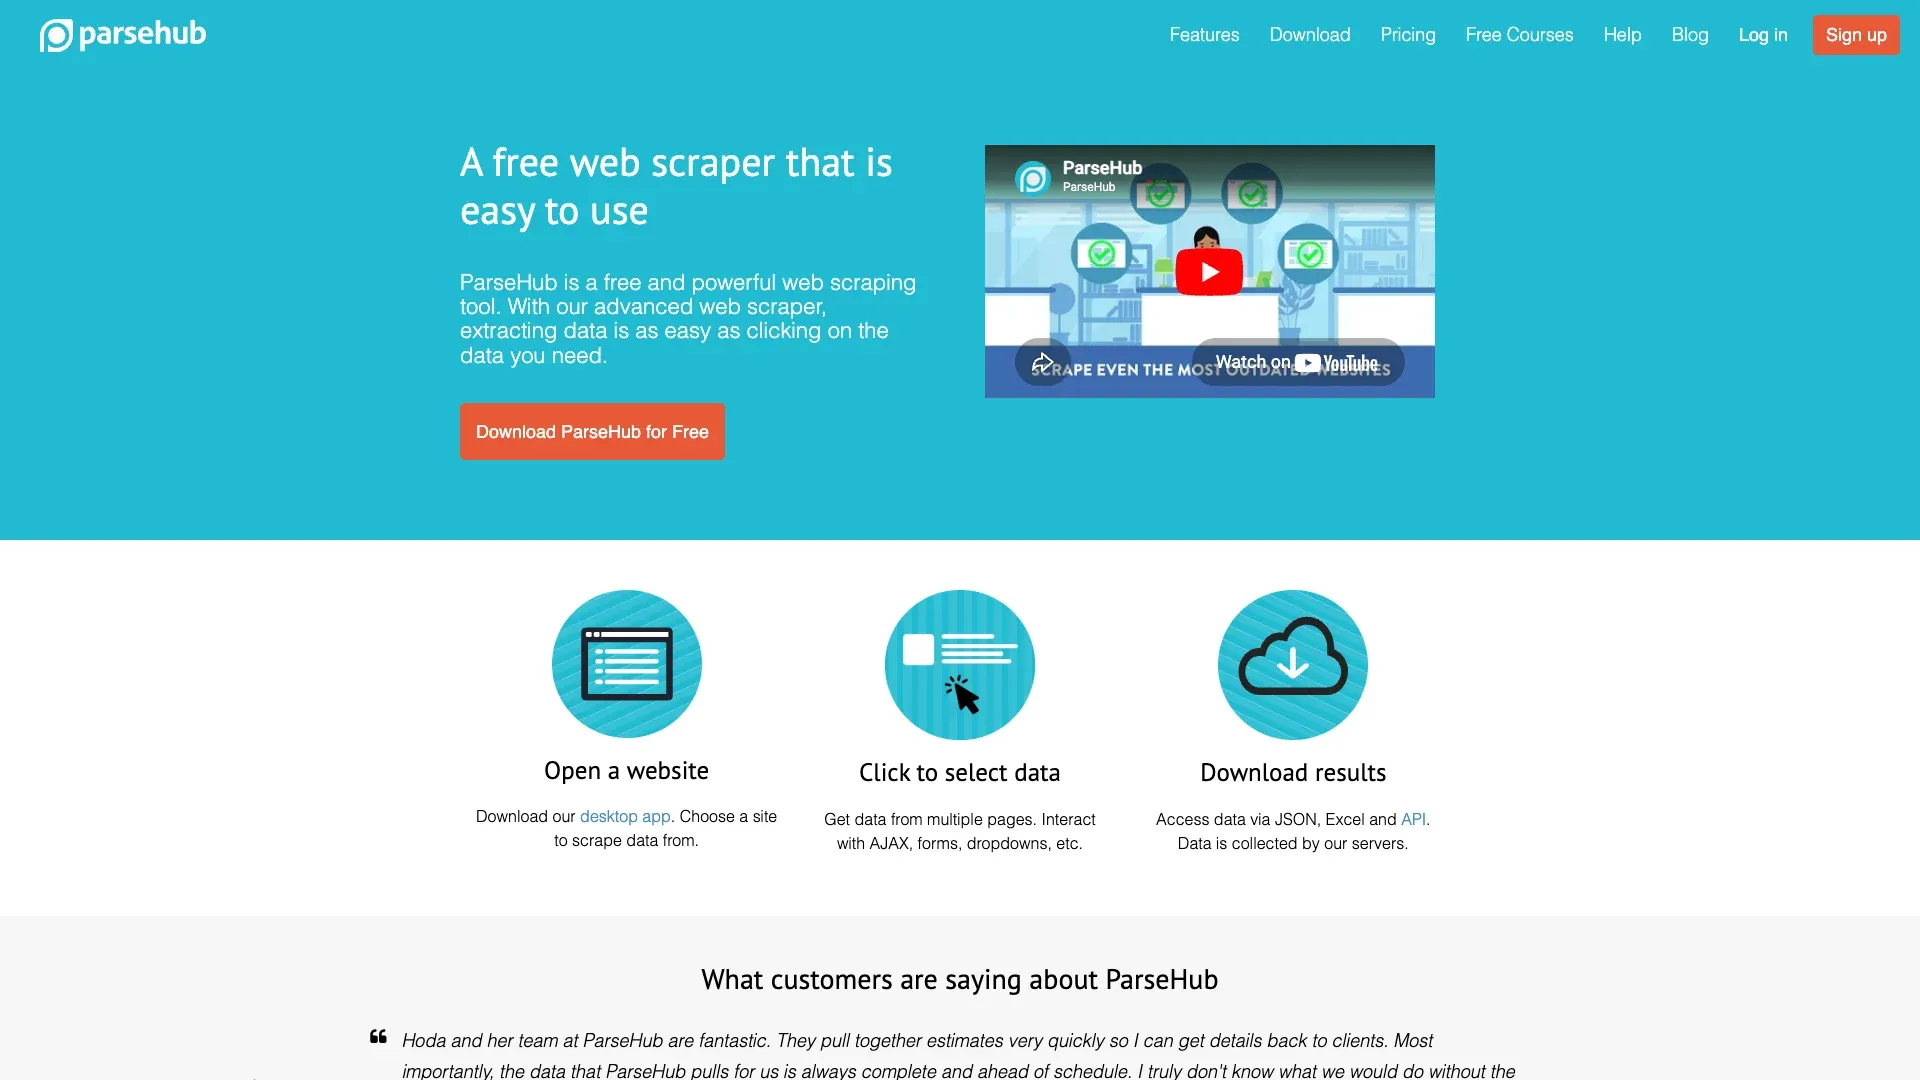
ParseHub adalah extractor visual yang bisa diunduh untuk Windows, macOS, dan Linux (via AppImage). Antarmuka command tree-nya memodelkan seleksi, klik, input form, scroll, dan template halaman. Tool ini mendukung AJAX/JavaScript, dropdown, tab, pop-up, pagination, form login, dan infinite scroll.
Fitur utama:
- Command tree visual untuk alur ekstraksi multi-langkah
- Menangani AJAX, JavaScript, dropdown, tab, dan infinite scroll
- Aplikasi desktop lintas platform (Windows, macOS, Linux)
- Akses API untuk pengambilan data secara programatik
- Ekspor CSV dan JSON
Harga: Ada paket gratis dan berbayar. “Page” yang dikenakan biaya bisa berupa URL atau satu muatan konten dinamis yang dipicu klik atau scroll, jadi jatah page tidak selalu setara dengan jumlah URL yang sama. Pastikan cek batas project, run, dan retensi terbaru sebelum pilih paket.
Catatan privasi: Jangan masukkan kredensial produksi ke crawler pihak ketiga sebelum kamu meninjau cara tool menyimpan input login dan data project. Pakai akun uji yang dibatasi untuk evaluasi.
Cocok untuk: Pemula yang perlu scraping situs dinamis dengan banyak langkah (situs dengan navigasi kompleks, dropdown, atau loading berbasis scroll) tanpa nulis kode.
ParseHub vs. Octoparse: Perbedaan Utama
Keduanya adalah tool desktop tanpa kode yang bisa menangani JavaScript. Model command tree ParseHub memberi kontrol yang lebih eksplisit atas alur multi-langkah—berguna untuk navigasi kompleks, tapi sedikit lebih sulit dipelajari untuk tugas sederhana. Auto-detect Octoparse lebih cepat untuk situs terstruktur yang simpel dan menawarkan batas ekspor yang lebih longgar di free plan. Kalau targetmu terutama tabel dan daftar, mulai dari Octoparse. Kalau kamu perlu memodelkan rangkaian klik, pengisian form, dan navigasi bersyarat, pendekatan ParseHub mungkin terasa lebih jelas.
3. Thunderbit

Thunderbit adalah ekstensi browser web scraping agentic untuk Chrome dan Edge, dibuat untuk pengguna bisnis non-teknis yang ingin mengekstrak data dari halaman yang sedang mereka buka. (Biar transparan: saya bekerja di Thunderbit, jadi saya akan jelaskan kekuatan dan keterbatasannya dengan jujur.)
Fitur utama:
- One Click Extract mendeteksi kolom secara otomatis berdasarkan konten halaman
- Prompt AI di level field untuk kategorisasi, terjemahan, format, dan normalisasi saat ekstraksi
- Ekspor ke Excel/CSV, Google Sheets, Airtable, dan Notion
- Browser Mode bekerja dengan sesi yang dirender pengguna, jadi bisa menangani konten yang dimuat lewat JavaScript pada halaman yang kompatibel
- Tidak perlu instalasi software tambahan selain ekstensi browser
Harga: Tier gratis saat ini mencakup 6 halaman/bulan dengan maksimal 30 credit per halaman. Starter ($15/bulan atau $9/bulan jika ditagih tahunan) menambahkan pagination, scraping subpage, bulk scraping, enrichment, pre-built scrapers, dan schedule. Lihat harga terbaru di sini.
Keterbatasan yang perlu diketahui: Thunderbit berorientasi pada page/schema, bukan spider discovery seluruh domain. Pagination dan scraping subpage adalah fitur Starter, bukan Free. Field yang disarankan AI sebaiknya selalu kamu tinjau sebelum menjalankan scrape—saran AI bagus, tapi tidak selalu sempurna.
Cocok untuk: Tim sales, operations, dan riset yang butuh data terstruktur dari halaman yang sedang dibuka di browser, dengan bantuan AI untuk melewati konfigurasi field manual. Kalau kamu cari cara cepat untuk ambil tabel, daftar, atau kumpulan record dari halaman yang kompatibel lalu mengekspornya ke spreadsheet, ini jalur tercepat yang saya tahu.
Untuk penjelasan lebih lanjut tentang cara kerja ekstraksi berbantuan AI dalam praktik, lihat panduan kami tentang AI web scraping.
Lewati Kode, Mulai dengan Satu Klik Agentic web scraper Thunderbit membaca halaman apa pun dan memilih field sendiri, tanpa perlu kode — pilihan crawler pertama yang bagus untuk pemula. Get Started Free
4. Crawl4AI
Crawl4AI adalah crawler Python open-source yang browser-first, dirancang untuk menghasilkan output bersih bagi workflow LLM. Tool ini mengeluarkan HTML mentah dan bersih, berbagai varian Markdown, konten yang diekstrak secara terstruktur, link, media, tabel, screenshot, PDF, dan MHTML.
Fitur utama:
- AsyncWebCrawler dengan Chromium/Playwright di belakang layar
- Berbagai format output yang dioptimalkan untuk pipeline RAG dan workflow agen
- Adaptive crawling yang mengevaluasi coverage, konsistensi, dan saturation untuk memprioritaskan link relevan dan berhenti saat informasi yang dikumpulkan sudah cukup
- Ekstraksi LLM opsional menggunakan provider lokal (Ollama) atau API cloud
- Lisensi Apache-2.0 dengan persyaratan atribusi tambahan
Harga: Sepenuhnya open source—tanpa biaya per halaman. Kamu yang menanggung infrastruktur dan bayar inference LLM kalau ada (lokal atau cloud).
Keterbatasan: Memerlukan pengetahuan Python async dan dependency browser. Kualitas ekstraksi tergantung pada LLM yang dipakai (kalau ada). Crawler adaptif memprioritaskan link relevan berdasarkan sinyal kecukupan informasi—bukan belajar permanen atau memperbaiki selector CSS secara otomatis.
Cocok untuk: Pengguna Python menengah yang membangun pipeline data AI dan ingin kontrol penuh tanpa biaya vendor per request.
5. Firecrawl
Firecrawl adalah API data web terkelola (dengan SDK untuk Python dan Node.js) serta codebase self-hosted berlisensi AGPL. Layanan cloud-nya menangani rendering JavaScript dan mengembalikan Markdown, ringkasan, HTML, link, gambar, screenshot, JSON, dan pelacakan perubahan.
Fitur utama:
- Endpoint
/crawldengan filter path, discovery depth, sitemap, limit, delay, dan kontrol concurrency - Rendering JavaScript otomatis di cloud terkelola
- Berbagai format output termasuk Markdown bersih
- Endpoint
/mapuntuk penemuan struktur situs dengan cepat - Jalur Browser/Interact dan agen beta untuk interaksi multi-langkah (terpisah dari crawl dasar)
Harga: Cloud Free adalah 1.000 credit/bulan dengan dua request simultan dan batas rate yang rendah. Paket berbayar berbasis credit/concurrency—cek halaman harga untuk angka terbaru. Self-hosting memindahkan infrastruktur dan maintenance ke kamu dan tidak mencakup semua fitur cloud terkelola.
Keterbatasan: /crawl dasar menemukan URL secara rekursif lewat link dan sitemap, tapi tidak menjamin penanganan pagination berbasis klik secara arbitrer. Biaya credit bervariasi tergantung jenis operasi. Fitur self-hosted dan cloud tidak persis sama.
Cocok untuk: Pengguna menengah yang perlu memasukkan konten situs web ke LLM, chatbot, atau knowledge base dan ingin layanan terkelola, bukan nyiapin stack browser sendiri.
Firecrawl vs. Crawl4AI: Mana untuk Pipeline AI?
Firecrawl unggul dalam konversi Markdown terkelola dengan API yang bersih—kamu kirim URL, lalu dapat output terstruktur. Crawl4AI unggul untuk operasi local-first di mana kamu mengendalikan browser dan LLM opsional. Kalau kamu ingin minim urusan infrastruktur, cloud Firecrawl adalah jalur yang lebih mudah. Kalau kamu ingin self-host penuh tanpa biaya halaman dari vendor dan nyaman dengan Python async, Crawl4AI memberi kontrol lebih besar.
6. Scrapy
Scrapy adalah framework crawling dan scraping Python berlisensi BSD yang sudah lama dikenal, dibangun di atas mesin async Twisted. Tool ini menyediakan penjadwalan request, penelusuran link, deduplikasi, middleware, retry, throttling, pipeline, dan ekspor feed ke JSON, JSON Lines, CSV, XML, pickle, dan marshal.
Fitur utama:
- Penanganan request asinkron yang cocok untuk crawling skala besar dengan batas yang terkontrol
- Ekosistem middleware yang luas (proxy, retry, throttling, custom header)
- Arsitektur pipeline terstruktur untuk pembersihan dan penyimpanan data
- Komunitas besar, dokumentasi kuat, dan ekstensi pihak ketiga
- Sepenuhnya open source (lisensi BSD)
Keterbatasan: Tidak ada rendering JavaScript bawaan. Panduan konten dinamis resmi menyarankan cari sumber data di balik layar kalau memungkinkan atau integrasikan komponen browser/rendering secara sengaja (misalnya scrapy-playwright). Arsitektur spider, middleware, item pipeline, dan settings punya kurva belajar yang nyata.
Harga: Gratis. Kamu yang host.
Cocok untuk: Pengguna Python menengah yang perlu crawling situs besar yang sebagian besar statis atau dirender server, dalam skala besar.
Memulai dengan Scrapy: Quickstart yang Dianotasi
Berikut jalur minimal dari instalasi sampai data pertama:
pip install scrapy
scrapy startproject beginner_crawl
cd beginner_crawl
scrapy genspider example example.com
Buka beginner_crawl/spiders/example.py lalu edit seperti ini:
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    allowed_domains = ["example.com"]       # Hanya tetap di domain ini
    start_urls = ["https://example.com"]    # URL awal

    custom_settings = {
        "ROBOTSTXT_OBEY": True,            # Patuhi robots.txt
        "DOWNLOAD_DELAY": 2,               # Tunggu 2 detik antar request
        "CLOSESPIDER_PAGECOUNT": 10,       # Berhenti setelah 10 halaman (batas aman)
        "USER_AGENT": "Beginner-Crawl-Bot (+https://yoursite.com/bot-info)",
    }

    def parse(self, response):
        yield {
            "title": response.css("title::text").get(),
            "url": response.url,
        }
        # Ikuti link di halaman (yang masih dalam allowed_domains)
        for link in response.css("a::attr(href)").getall():
            yield response.follow(link, callback=self.parse)
Jalankan:
scrapy crawl example -o output.json
Uji selector dulu dengan scrapy shell "https://example.com" sebelum memperbesar skala. Waktu setup bervariasi tergantung pengalaman Python kamu—jangan berharap selesai dalam sepuluh menit kalau kamu masih baru dengan virtual environment dan perintah terminal.
7. Crawlee
Crawlee adalah library crawler berlisensi Apache untuk JavaScript/TypeScript dan Python, yang dipelihara oleh Apify. Tool ini menyediakan kelas HTTP-only (seperti CheerioCrawler) serta browser crawler Playwright/Puppeteer, request queue, dataset, session handling, retry, dan kontrol batas.
Fitur utama:
- Pilih HTTP-first (CheerioCrawler) atau browser penuh (PlaywrightCrawler) per proyek
- Request queue, deduplikasi, dan penyimpanan dataset bawaan
- Manajemen sesi, browser fingerprint, retry, dan kontrol batas request
- TypeScript-first dengan dukungan Python yang stabil
- Quickstart resmi merekomendasikan HTTP-first saat HTML memang sudah berisi data
Harga: Gratis. Open source, self-hosted.
Keterbatasan: Memerlukan pengetahuan JavaScript/TypeScript atau Python. Dokumentasi komunitasnya tidak sebanyak Scrapy. Fitur anti-blocking bukan berarti otorisasi atau jaminan akses—fitur ini hanya mengurangi risiko terdeteksi, bukan membuat crawling tanpa izin jadi boleh.
Cocok untuk: Developer JavaScript menengah yang perlu crawling SPA modern dan situs yang dirender JS dengan manajemen antrean dan anti-blocking bawaan.
Crawlee Quickstart: Dari Instalasi ke Data Pertama
npx crawlee create my-crawler
cd my-crawler
Pilih template Playwright saat prompt setup muncul.
Edit handler di src/routes.ts untuk mengekstrak data yang kamu butuhkan, lalu:
npm start
Hasil akan masuk ke direktori dataset lokal dalam bentuk JSON. Tambahkan maxRequestsPerCrawl, batas depth, aturan same-domain, dan batas concurrency yang wajar sebelum naik skala di luar run percobaan.
8. Playwright
Playwright adalah framework automasi browser berlisensi Apache dari Microsoft yang mendukung Python, Node.js, Java, dan .NET. Tool ini mengendalikan browser Chromium, Firefox, dan WebKit sungguhan—jadi sangat cocok untuk halaman yang memuat konten lewat JavaScript, butuh alur login, atau melibatkan interaksi yang kompleks.
Fitur utama:
- Rendering browser sungguhan secara native di tiga engine
- Menangani SPA, login, klik, pengisian form, unduhan file, screenshot, dan PDF
- Dukungan lintas bahasa (Python, JS/TS, Java, .NET)
- Dokumentasi sangat baik dan pengembangan aktif
- Intersepsi network dan request mocking
Yang bukan Playwright: Bukan crawler lengkap. Ia tidak menyediakan URL frontier, antrean deduplikasi, kebijakan politeness, model retry, atau exporter feed data secara native. Kamu harus bangun bagian-bagian itu sendiri—atau gabungkan Playwright dengan framework seperti Crawlee yang sudah menyediakannya.
Harga: Gratis. Open source.
Cocok untuk: Developer menengah yang perlu mengotomasi interaksi browser pada situs berat JS atau situs yang dilindungi login dan nyaman membangun logika crawling sendiri di sekitarnya.
9. Screaming Frog
Screaming Frog SEO Spider adalah crawler SEO teknis desktop untuk Windows, macOS, dan Linux. Ini bukan tool ekstraksi data serbaguna—ini crawler andalan untuk audit SEO, menemukan broken link, redirect chain, konten duplikat, metadata yang hilang, dan ratusan masalah SEO teknis lainnya.
Fitur utama:
- Crawl hingga 500 URL secara gratis (permanen, bukan trial)
- Mengidentifikasi broken link, redirect chain, konten duplikat, metadata yang hilang
- Tab detail untuk page title, meta description, heading, image, dan lainnya
- Versi berbayar menambahkan rendering JavaScript, penyimpanan crawl, custom extraction, integrasi GA/GSC, dan integrasi AI (OpenAI, Gemini, Anthropic, Ollama)
Harga: Versi gratisnya permanen dengan 500 URL/crawl, tapi tidak mencakup rendering JavaScript, konfigurasi lanjutan, custom extraction, dan integrasi. Lisensinya £199 / $279 / €245 per pengguna per tahun.
Keterbatasan: Kurva belajar curam buat pengguna non-SEO. Memakai resource perangkat lokal (bisa terkendala memori untuk situs besar). Tidak ada opsi paket bulanan. Tidak dirancang untuk ekstraksi data umum—ini tool audit.
Cocok untuk: Pemula yang fokus pada audit SEO dan analisis teknis situs. Kalau kamu ingin mengekstrak data produk atau bikin daftar lead, cari tool lain.
10. Colly
Colly adalah framework HTTP crawler/scraper Go berlisensi Apache dengan API berbasis callback, kontrol concurrency, session/cookie, queue, caching, dan backend penyimpanan yang bisa diganti.
Fitur utama:
- Crawling HTTP concurrent yang cepat dengan penggunaan resource rendah
- API bersih berbasis callback
- Penanganan cookie/session dan caching bawaan
- Pembatasan rate per domain melalui LimitRule
- Instalasi saat ini:
go get github.com/gocolly/colly/v2
Catatan penting untuk pemula: Source Colly saat ini menginisialisasi IgnoreRobotsTxt = true secara default. Kamu harus secara eksplisit menyetelnya ke false dan mengonfigurasi LimitRule dengan delay dan paralelisme yang tepat. Tanpa langkah ini, Colly akan mengabaikan robots.txt dan mudah membebani server target.
Harga: Gratis. Open source.
Keterbatasan: Memerlukan pengetahuan pemrograman Go. Tidak ada renderer JavaScript bawaan atau exporter feed universal—output harus kamu serialisasi sendiri. Komunitasnya lebih kecil dibanding tool berbasis Python.
Cocok untuk: Advanced beginner yang menguasai Go dan butuh crawler HTTP yang cepat dan ringan untuk situs statis atau API—dengan catatan robots dan rate limit harus dikonfigurasi secara eksplisit.
Perbandingan Free Tier: Apa yang Benar-Benar Anda Dapat Sebelum Bayar
Ini tabel yang biasanya dicari pemula yang sensitif soal biaya. Setiap tool di bawah dibagi jadi dua kategori: produk freemium (ada batas tapi tanpa infrastruktur yang perlu diurus) dan tool open-source (halaman tak terbatas, tapi kamu harus mengelola semuanya sendiri).
Free Tier Freemium / Desktop
| Tool | Free Limit | Project/Task Cap | Export Restrictions | Time-Limited? | Key Lockouts |
|---|---|---|---|---|---|
| Octoparse | Unlimited pages/crawl | 10 tasks | 10K rows/export; 50K rows/month | No (permanent) | Cloud, scheduling, IP rotation, API |
| ParseHub | 200 pages/run | 5 public projects | CSV/JSON | No (permanent) | Projects/data may be public; 14-day retention |
| Thunderbit | 6 pages/month | N/A | Excel/CSV, Sheets, Airtable, Notion | No (permanent) | Pagination, subpages, bulk, schedules are Starter |
| Firecrawl | 1,000 credits/month | N/A | All formats | No (permanent) | 2 concurrent requests; low rate limits |
| Screaming Frog | 500 URLs/crawl | Unlimited runs | Limited export | No (permanent) | JS rendering, crawl saving, custom extraction, integrations |
Tool Open-Source (Self-Hosted)
| Tool | Page Limit | License | What You Pay For |
|---|---|---|---|
| Scrapy | None | BSD | Compute, bandwidth, storage, optional browser integration |
| Crawlee | None | Apache | Compute, bandwidth, browser processes |
| Crawl4AI | None | Apache-2.0 + attribution | Compute, browser processes, optional LLM inference |
| Playwright | None | Apache | Compute, browser processes (high CPU/memory) |
| Colly | None | Apache | Compute, bandwidth |
Kalau budget software kamu nol dan kamu bisa coding, tool open-source menghindari kuota halaman dari vendor, tapi infrastruktur, batas situs target, dan biaya operasional tetap ada. Tidak bisa coding? Octoparse, ParseHub, dan Thunderbit masing-masing menawarkan jalur gratis—cuma perhatikan batas dan syarat privasinya.
10 Menit Pertama Anda: Panduan Quickstart untuk 3 Level Keahlian
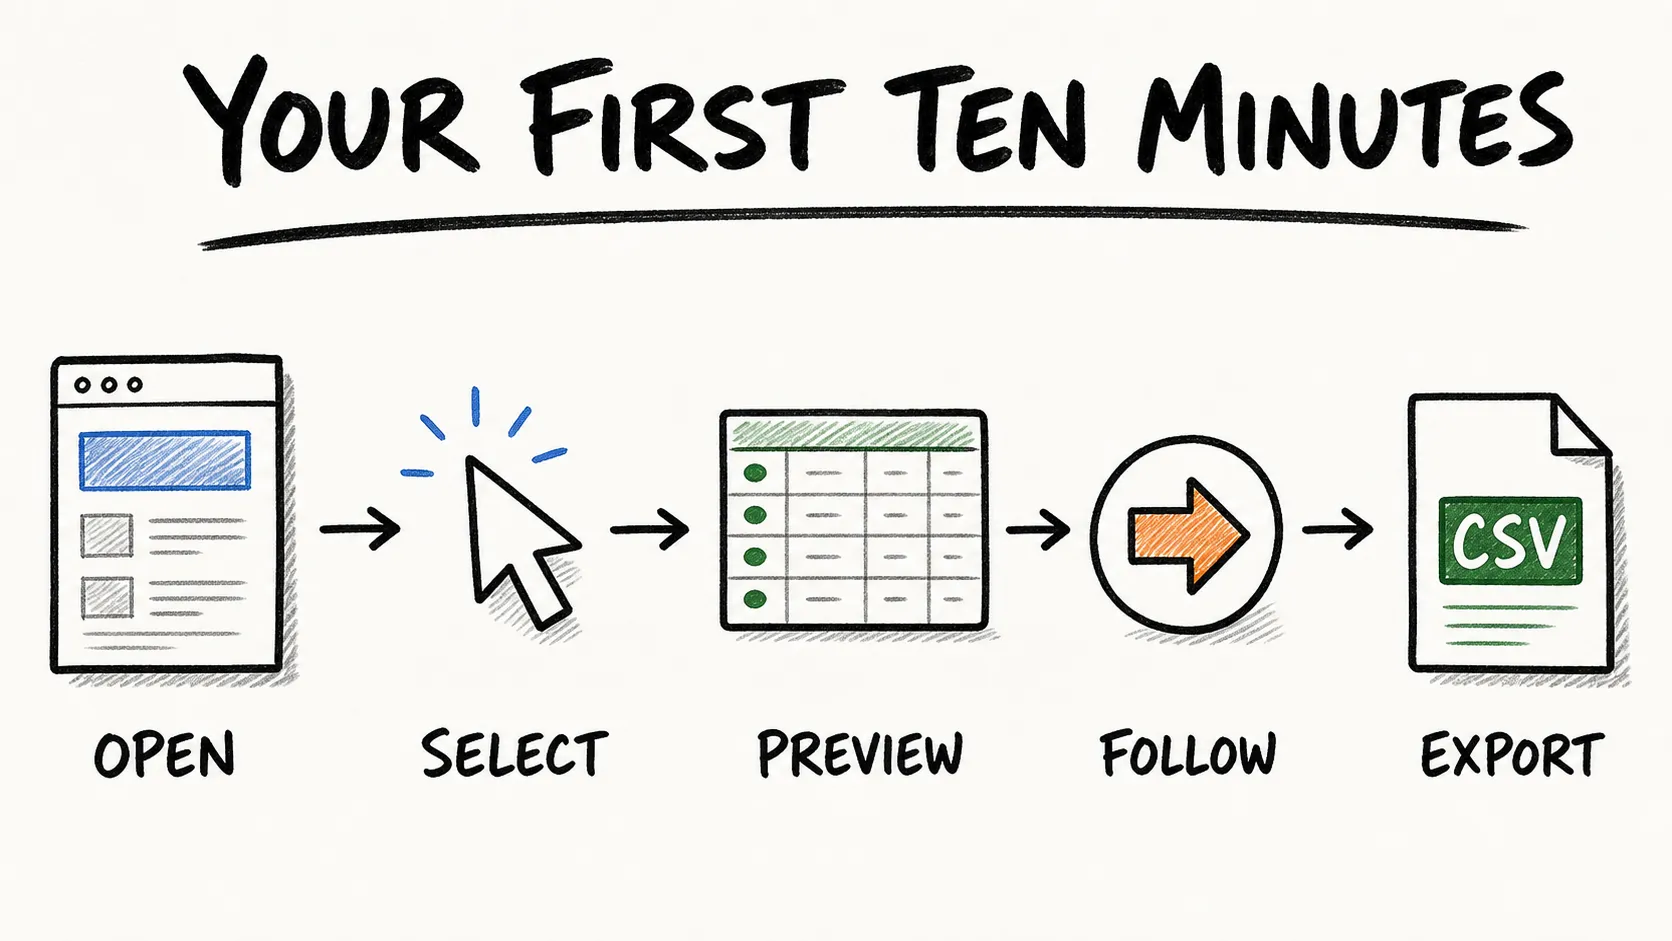
Teori itu bagus. Praktik lebih bagus lagi. Berikut cara pindah dari nol ke ekspor data pertama dalam tiga tool representatif—masing-masing untuk satu tingkat keahlian.
Jalur No-Code: Mulai dengan Thunderbit
- Instal ekstensi browser Thunderbit
- Buka halaman target (misalnya halaman listing produk, direktori, atau hasil pencarian)
- Klik ikon Thunderbit dan pilih One Click Extract — AI membaca halaman, memahami strukturnya, menentukan kolom yang perlu diambil, lalu mengekstraknya sekaligus
- Tinjau hasil di ekstensi — ganti nama, hapus, atau tambahkan kolom dan tambahkan Field AI Prompts kalau ingin menyesuaikan apa pun — lalu ekspor ke Excel, Google Sheets, Airtable, atau Notion
Pada halaman yang kompatibel, alur ini memang dirancang sebagai setup singkat, bukan proyek pemrograman.
Untuk panduan yang lebih detail, lihat artikel kami tentang mengekstrak data dari halaman web menggunakan Thunderbit.
Jalur Pemula Python: Mulai dengan Scrapy
Lihat quickstart yang dianotasi di bagian Scrapy di atas. Perintah intinya adalah pip install scrapy, scrapy startproject, edit spider kamu dengan ROBOTSTXT_OBEY = True dan DOWNLOAD_DELAY, lalu scrapy crawl example -o output.json. Uji selector di scrapy shell sebelum memperbesar skala. Waktu yang dibutuhkan tergantung pengalaman setup Python kamu.
Jalur JavaScript: Mulai dengan Crawlee
Lihat quickstart Crawlee di atas. Jalankan npx crawlee create my-crawler, pilih template Playwright, edit handler kamu, lalu npm start. Hasil akan muncul sebagai JSON di direktori dataset lokal. Tambahkan maxRequestsPerCrawl dan batas domain sebelum memperbesar skala.
Untuk walkthrough yang lebih panjang berbasis Python yang menunjukkan bagaimana sebuah proyek crawler disusun, kursus ini bisa jadi pendamping yang berguna:
Coba Gratis, Tanpa Kartu Kredit Free plan mencakup 6 halaman per bulan, jadi kamu bisa latihan mengekstrak data sebelum pindah ke tool berbayar. Get Started Free
5 Kesalahan Pemula yang Menggagalkan Crawl Pertama Anda (dan Cara Menghindarinya)
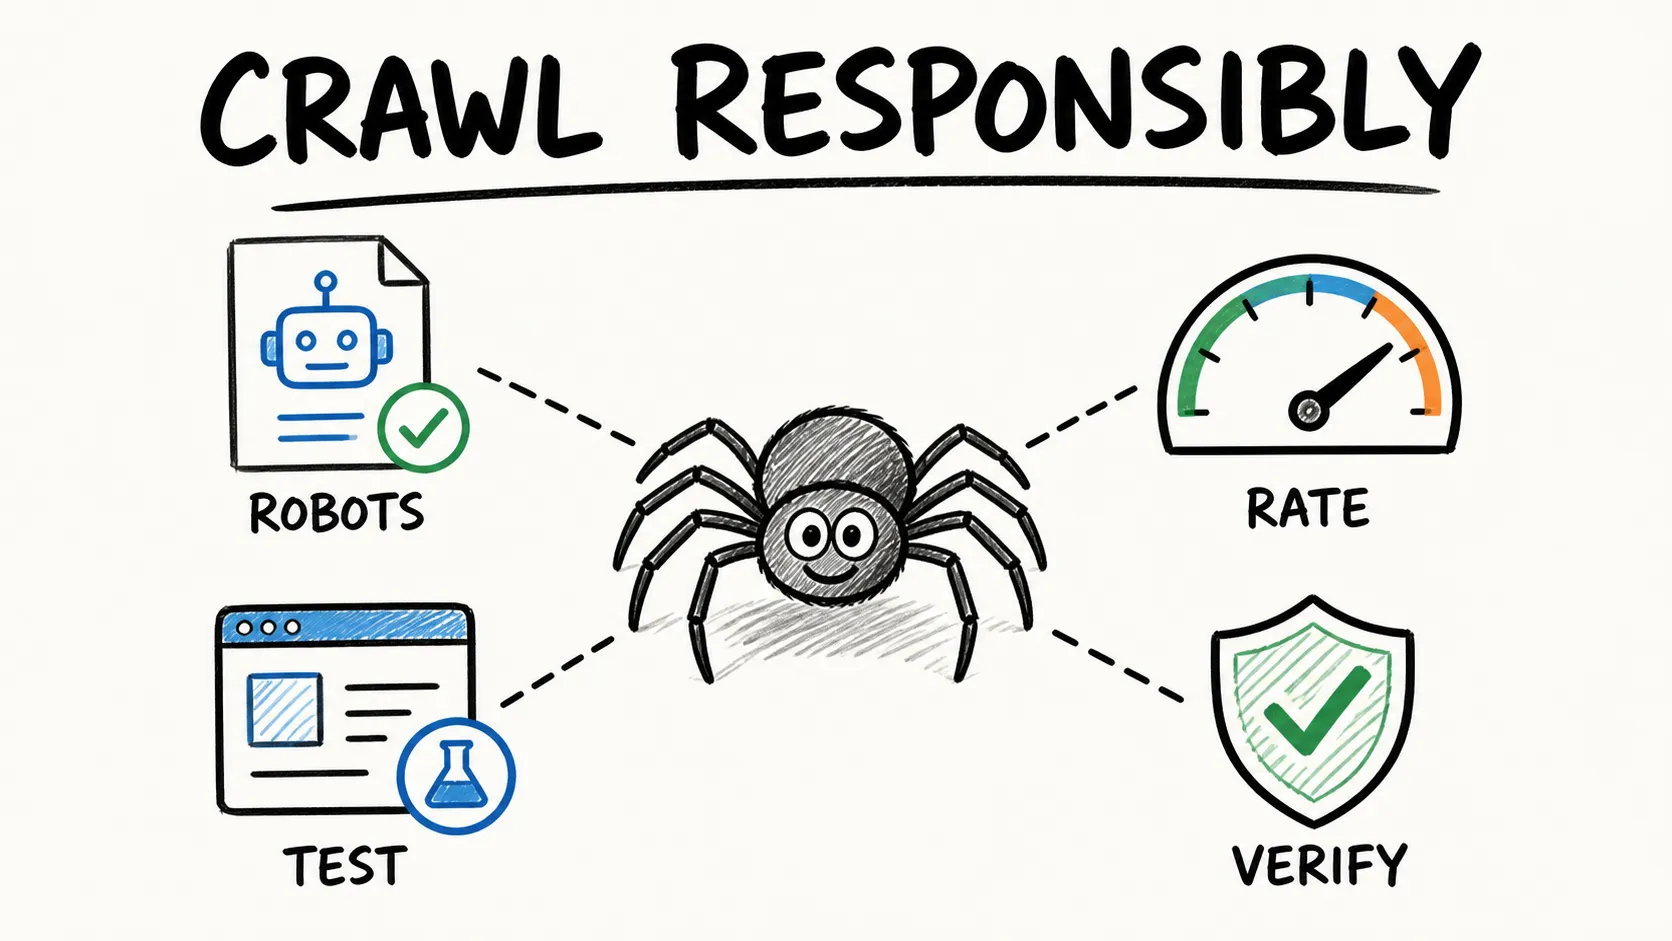
Hal-hal ini terus muncul di forum, tapi tidak banyak artikel besar yang membahasnya sebagai bagian khusus.
Kesalahan 1: Memakai Crawler HTTP-Only pada Situs yang Dirender JavaScript
Masalahnya: banyak situs modern memuat data lewat JavaScript setelah respons HTML awal diterima. Request HTTP sederhana cuma menghasilkan halaman kerangka dengan tag <div> kosong—tanpa data.
Solusi: Sebelum memilih tool, buka halaman target, klik kanan, lalu pilih View Source. Kalau data yang kamu butuhkan tidak ada di HTML mentah, kamu perlu tool dengan browser rendering: Playwright, PlaywrightCrawler milik Crawlee, atau tool no-code seperti Thunderbit atau Octoparse yang merender di browser. Tapi jangan langsung memilih browser kalau HTTP sudah cukup—itu menambah biaya dan kompleksitas.
Kesalahan 2: Mengabaikan robots.txt dan Aturan Crawl-Delay
Masalahnya: robots.txt adalah standar yang mengomunikasikan path mana yang boleh diakses oleh token crawler tertentu. Mengabaikan kebijakan crawling sebuah situs bisa berujung pada pemblokiran, gangguan operasional, dan risiko kepatuhan.
Solusi: Selalu cek yoursite.com/robots.txt sebelum crawling, dan verifikasi default aktual pada tool yang kamu pilih. Default tiap tool berbeda: misalnya Colly menginisialisasi IgnoreRobotsTxt = true dan butuh konfigurasi eksplisit. Ingat, robots.txt adalah sinyal kontrol crawl, bukan otorisasi hukum. Path yang diizinkan bukan berarti kamu bebas mengumpulkan atau memakai ulang datanya untuk tujuan apa pun.
Kesalahan 3: Mengirim Terlalu Banyak Request Tanpa Rate Limiting
Masalahnya: meluncurkan ratusan request per detik bisa membebani server target, bikin IP kamu diblokir, dan secara umum merupakan praktik yang buruk.
Solusi: Atur delay positif. Di Scrapy, gunakan DOWNLOAD_DELAY = 2 dan CONCURRENT_REQUESTS_PER_DOMAIN yang rendah. Di Colly, konfigurasikan LimitRule dengan delay dan paralelisme. Tool cloud/no-code biasanya menanganinya otomatis, tapi tetap cek setelannya. Mulailah dengan satu request aktif per domain lalu tingkatkan hanya kalau perilaku dan ketentuan situs mengizinkan.
Kesalahan 4: Memilih Tool Skala Enterprise untuk Proyek Kecil
Masalahnya: menyiapkan cluster Scrapy terdistribusi dengan rotasi proxy dan message queue untuk proyek 500 halaman itu ibarat sewa truk gandeng cuma buat belanja ke supermarket.
Solusi: Kembali ke flowchart keputusan. Cocokkan kompleksitas tool dengan ukuran proyek. Untuk ekstraksi kecil, sekali jalan, ekstensi browser atau script sederhana hampir selalu jadi pilihan paling tepat.
Kesalahan 5: Tidak Memvalidasi Data Output
Masalahnya: pemula sering mengekspor data tanpa memeriksanya, lalu baru sadar belakangan bahwa separuh baris kosong, duplikat, atau berantakan.
Solusi: Selalu cek 10–20 baris pertama sebelum menjalankan crawl penuh. Cari field kosong, masalah encoding (mojibake), baris duplikat, dan nilai yang tidak semestinya. Tentukan schema yang kamu harapkan sebelum mulai—kolom apa saja yang harus ada, tipe datanya apa, field mana yang wajib. Run crawl yang berhasil tidak otomatis berarti datanya akurat.
Apa Arti "LLM-Ready Output" dan Kenapa Penting Walaupun Anda Tidak Membangun AI
Istilah “LLM-ready” muncul di mana-mana dalam pemasaran crawler pada 2026. Kebanyakan penjelasannya mengasumsikan kamu sudah tahu apa itu vector database. Berikut versi bahasa sederhananya.
LLM-ready output adalah teks yang bersih dan terstruktur, sehingga model AI seperti GPT atau Claude bisa langsung menggunakannya tanpa pembersihan manual. Bayangkan bedanya antara memberi seseorang spreadsheet yang rapi versus setumpuk halaman web cetak yang masih ditempeli iklan, menu navigasi, dan banner cookie.
Kenapa kamu perlu peduli walaupun tidak sedang membangun chatbot? Karena tool yang dirancang untuk output LLM-ready biasanya menghasilkan data yang lebih bersih dan lebih mudah dipakai oleh siapa saja. Lebih sedikit proses lanjutan, lebih sedikit kolom sampah, lebih sedikit masalah encoding. Data yang bersih tetap data yang bersih, entah dibaca manusia atau mesin.
Tool mana dalam daftar ini yang menghasilkan output LLM-ready secara native?
- Firecrawl → Markdown bersih, ringkasan, JSON terstruktur
- Crawl4AI → Berbagai varian Markdown, chunk terstruktur, tabel
- Thunderbit → Field terstruktur yang disarankan AI dengan normalisasi berbasis prompt
Berikut contoh singkat sebelum/sesudah. HTML mentah dari halaman produk mungkin terlihat seperti ini:
<div class="product-card">
  <span class="price">$29.99</span>
  <h2 class="title">Wireless Mouse</h2>
  <p class="desc">Ergonomic design, 2.4GHz...</p>
  <a href="/buy" class="btn">Add to Cart</a>
</div>
Output Markdown yang siap untuk LLM dari Firecrawl:
## Wireless Mouse
- **Price:** $29.99
- **Description:** Ergonomic design, 2.4GHz
Output terstruktur dari Thunderbit:
| Product Name | Price | Description |
|---|---|---|
| Wireless Mouse | $29.99 | Ergonomic design, 2.4GHz |
Keduanya langsung bisa dipakai—tanpa parsing HTML, tanpa buang iklan, tanpa mapping kolom manual. Untuk perbandingan lebih lanjut tentang ekstraksi berbasis AI dibanding scraping tradisional, lihat ringkasan kami tentang best AI web scrapers.
Web Crawling yang Bertanggung Jawab: Tips Singkat Soal Etika dan Kepatuhan
Etika dan kepatuhan dalam web crawling terlalu penting untuk dilewatkan:
- Cek robots.txt sebelum crawling situs mana pun. Itu adalah sinyal kontrol crawl standar (RFC 9309), meskipun bukan otorisasi hukum atau batas keamanan.
- Hormati rate limit dan header Retry-After. Perlambat atau berhenti saat menerima respons 429 dan 503.
- Gunakan hanya data yang tersedia untuk publik atau yang diizinkan. Kalau ada API resmi atau export resmi yang memenuhi kebutuhanmu, utamakan itu.
- Cek syarat layanan situs. Visibilitas publik memang relevan, tapi bukan lisensi universal untuk mengumpulkan atau menggunakan ulang data.
- Perhatikan data pribadi. Minimalkan pengumpulan, tetapkan aturan retensi/penghapusan, dan minta tinjauan yang tepat untuk penggunaan sensitif. GDPR dan regulasi serupa tetap berlaku apa pun tool yang kamu pakai.
Banyak tool menyediakan pengaturan yang mendukung crawl yang bertanggung jawab, tapi konfigurasi tidak memindahkan tanggung jawab dari operator. Untuk penjelasan yang lebih mendalam tentang proses dasarnya, lihat pembahasan kami tentang apa itu web scraping.
Web Crawler Mana yang Sebaiknya Anda Coba Dulu?
Ringkasan cepat berdasarkan tingkat keahlian:
- Tanpa kode: Thunderbit untuk ekstraksi halaman berbantuan AI, Octoparse untuk membangun workflow visual, ParseHub untuk alur multi-langkah yang rumit, Screaming Frog untuk audit SEO
- Python menengah: Scrapy untuk crawl HTTP skala besar, Crawl4AI untuk pipeline LLM
- JavaScript menengah: Crawlee untuk crawling SPA modern, Playwright untuk automasi browser yang kompleks
- Go: Colly untuk crawling HTTP cepat (dengan konfigurasi robots dan rate limit yang eksplisit)
- Managed API: Firecrawl untuk output Markdown bersih tanpa self-hosting
Crawler terbaik adalah yang cocok dengan data, izin, level keahlian, dan batas operasional kamu. Mulai dari yang sederhana, validasi run kecil, dan tambahkan kompleksitas cuma saat proyek memang butuh. Kalau kamu ingin mencoba ekstraksi berbantuan AI, ekstensi browser Thunderbit menyediakan jalur no-code dari halaman yang kompatibel langsung ke spreadsheet.
Pelajari Lebih Lanjut
- AI Web Scraping
- Web Scraping Tanpa Coding
- Apa Itu Web Scraping
- Alternatif Instant Data Scraper
- Scraping LinkedIn
Coba Agentic Web Scraper Thunderbit Get Started Free
FAQ
1. Apa itu web crawler dan apa bedanya dengan web scraper?
Crawler menemukan dan mengambil halaman—dia mengikuti link, mengelola antrean URL, menangani deduplikasi dan batas depth. Scraper mengekstrak data terstruktur tertentu dari halaman-halaman itu—dia mem-parse HTML, memilih field, dan menghasilkan record. Kebanyakan tool modern melakukan keduanya dalam tingkat yang berbeda, dan istilahnya sering dipakai saling menggantikan, tapi perbedaannya penting saat kamu memilih tool: beberapa tool (seperti Playwright) hebat dalam merender halaman tapi tidak menyediakan infrastruktur crawling, sementara yang lain (seperti Scrapy) menyediakan pipeline crawling lengkap tapi butuh plugin untuk rendering JavaScript.
2. Web crawler mana yang paling baik untuk orang tanpa skill coding?
Thunderbit, Octoparse, dan ParseHub adalah opsi no-code terbaik untuk ekstraksi data umum. Thunderbit memakai AI untuk menyarankan field dan bekerja sebagai ekstensi browser; Octoparse menawarkan pembuat workflow visual dengan Auto-detect; ParseHub unggul pada alur multi-langkah yang kompleks. Untuk use case SEO saja, versi gratis Screaming Frog bisa crawl hingga 500 URL tanpa coding.
3. Apakah web crawler bisa dipakai gratis?
Ada dua kategori. Tool open-source penuh (Scrapy, Crawlee, Crawl4AI, Playwright, Colly) tidak mengenakan biaya per halaman, tapi kamu harus menanggung infrastruktur dan membayar komputasi, bandwidth, serta penyimpanan. Tool freemium (Octoparse, ParseHub, Thunderbit, Firecrawl, Screaming Frog) menawarkan tier gratis dengan berbagai batas pada halaman, project, ekspor, atau fitur. Lihat tabel perbandingan free tier di atas untuk detailnya.
4. Apakah web crawler bisa menangani situs berat JavaScript?
Ya, tapi tidak semuanya. Tool dengan rendering browser bawaan—Playwright, Crawlee (PlaywrightCrawler), Octoparse, ParseHub, Crawl4AI, dan Thunderbit (via Browser Mode)—bisa menangani konten yang dimuat lewat JavaScript. Scrapy dan Colly adalah HTTP-first dan butuh integrasi browser terpisah untuk rendering JS. Screaming Frog hanya mendukung rendering JavaScript pada versi berbayar. Selalu cek apakah halaman target benar-benar butuh browser dengan melihat source HTML-nya dulu.
5. Apakah web crawling itu legal?
Tidak ada jawaban universal ya atau tidak. Analisis hukumnya bergantung pada data, metode akses, penggunaan yang direncanakan, syarat situs, kontrak, aturan kekayaan intelektual, kewajiban privasi seperti GDPR, dan yurisdiksi yang berlaku. robots.txt adalah sinyal kontrol crawl, bukan otorisasi hukum, dan visibilitas publik bukan lisensi menyeluruh. Untuk situasi spesifik—terutama yang melibatkan data pribadi, konten berhak cipta, autentikasi, atau penggunaan ulang komersial—konsultasikan dengan profesional hukum yang kompeten.




