
Kalau kamu pernah coba ambil data Twitter secara gratis pada 2023 lalu, terus balik lagi ke 2026 dengan harapan setup-nya masih sama, kamu bakal kaget banget. API gratisnya sudah hilang, jalur riset akademik sudah dihentikan, dan separuh alat open-source yang dulu jadi penopang lab riset sekarang tinggal jadi fosil digital.
Perubahan harga X memaksa peneliti, tim sales, marketer, dan data scientist membangun ulang alur kerja yang sebelumnya bergantung pada akses gratis atau murah. Ada dua belas opsi yang masih aktif pada batas riset Agustus 2026, masing-masing dengan biaya, metode pengambilan data, dan jenis pekerjaan yang berbeda. Istilah “masih berfungsi” berarti produk atau listing yang saat ini ada bisa diverifikasi—bukan berarti semuanya diotorisasi oleh X, lengkap, atau cocok untuk produksi.
Kenapa “Penyedia Data Twitter” Sekarang Jadi Istilah Pencarian?
Beberapa tahun lalu, orang tidak perlu googling “penyedia data Twitter.” Kamu tinggal pakai API gratis, atau menjalankan snscrape, atau memakai library seperti Tweepy lalu jalan terus. Lalu datang akuisisi oleh Musk, dan efek dominonya cepat terasa:
- Awal 2023: Akses gratis API v1.1 ditutup. Tier berbayar diperkenalkan.
- Pertengahan 2023: Jalur Academic Research dihentikan — penyelamat ribuan peneliti, hilang dalam semalam.
- 2023–2024: X memakai tier langganan bernama Basic dan Pro. Tier itu sekarang hanya konteks historis, bukan panduan beli saat ini.
- 2025–2026: X beralih ke model kredit prabayar pay-per-usage. Tidak ada lagi paket bulanan flat. Standard Post read: $0.005. User read: $0.010. Batas self-serve: dua juta Post reads per bulan.
Era library gratis ikut melemah. Pencarian X milik snscrape sudah tidak bisa diandalkan, Twint sudah diarsipkan, dan ekosistem Nitter publik berkali-kali kena gangguan gara-gara perubahan dari X. Itulah kenapa “penyedia data Twitter” jadi query yang nyata: tim butuh alternatif yang lebih tahan lama.
Mana yang Sudah Mati, Mana yang Rusak: Audit Alat Twitter Gratis untuk 2026
Sebelum bahas dua belas opsi yang masih ada, lebih baik kita pisahkan dulu client API dari metode akuisisi, lalu singkirkan rekomendasi yang sudah tidak memberi akses andal.
| Alat | Status (2026) | Catatan |
|---|---|---|
| snscrape | ⚠️ Rusak / tidak terawat | Commit terakhir yang benar-benar andal ada pada 2023; perubahan endpoint X mematikannya |
| Twint | ❌ Mati | Repo diarsipkan; tidak berfungsi sejak deprecation API v1.1 |
| Nitter | ⚠️ Tidak andal sebagai lapisan penyedia | Instance publik dan metode aksesnya berkali-kali terganggu oleh perubahan X |
| Tweepy | ✅ Berfungsi (dengan API key berbayar) | Masih dipelihara, tetapi butuh API key X berbayar — tidak gratis lagi |
| twarc | ✅ Berfungsi (dengan API key berbayar) | Dipelihara komunitas akademik; syaratnya sama, harus pakai key berbayar |
Tweepy dan twarc adalah client API, bukan penyedia data; keduanya baru berguna kalau dipasangkan dengan akses X API yang valid dan aktif. snscrape, Twint, dan Nitter tidak layak direkomendasikan sebagai lapisan akuisisi yang tahan lama untuk workflow produksi baru.
Ada alternatif yang masih aktif, tapi tidak ada yang benar-benar menggantikan kombinasi lama: akses luas, tahan lama, gratis, dan setup minim.
Sebenarnya, Bagaimana Penyedia Data Twitter Mengambil Datanya?
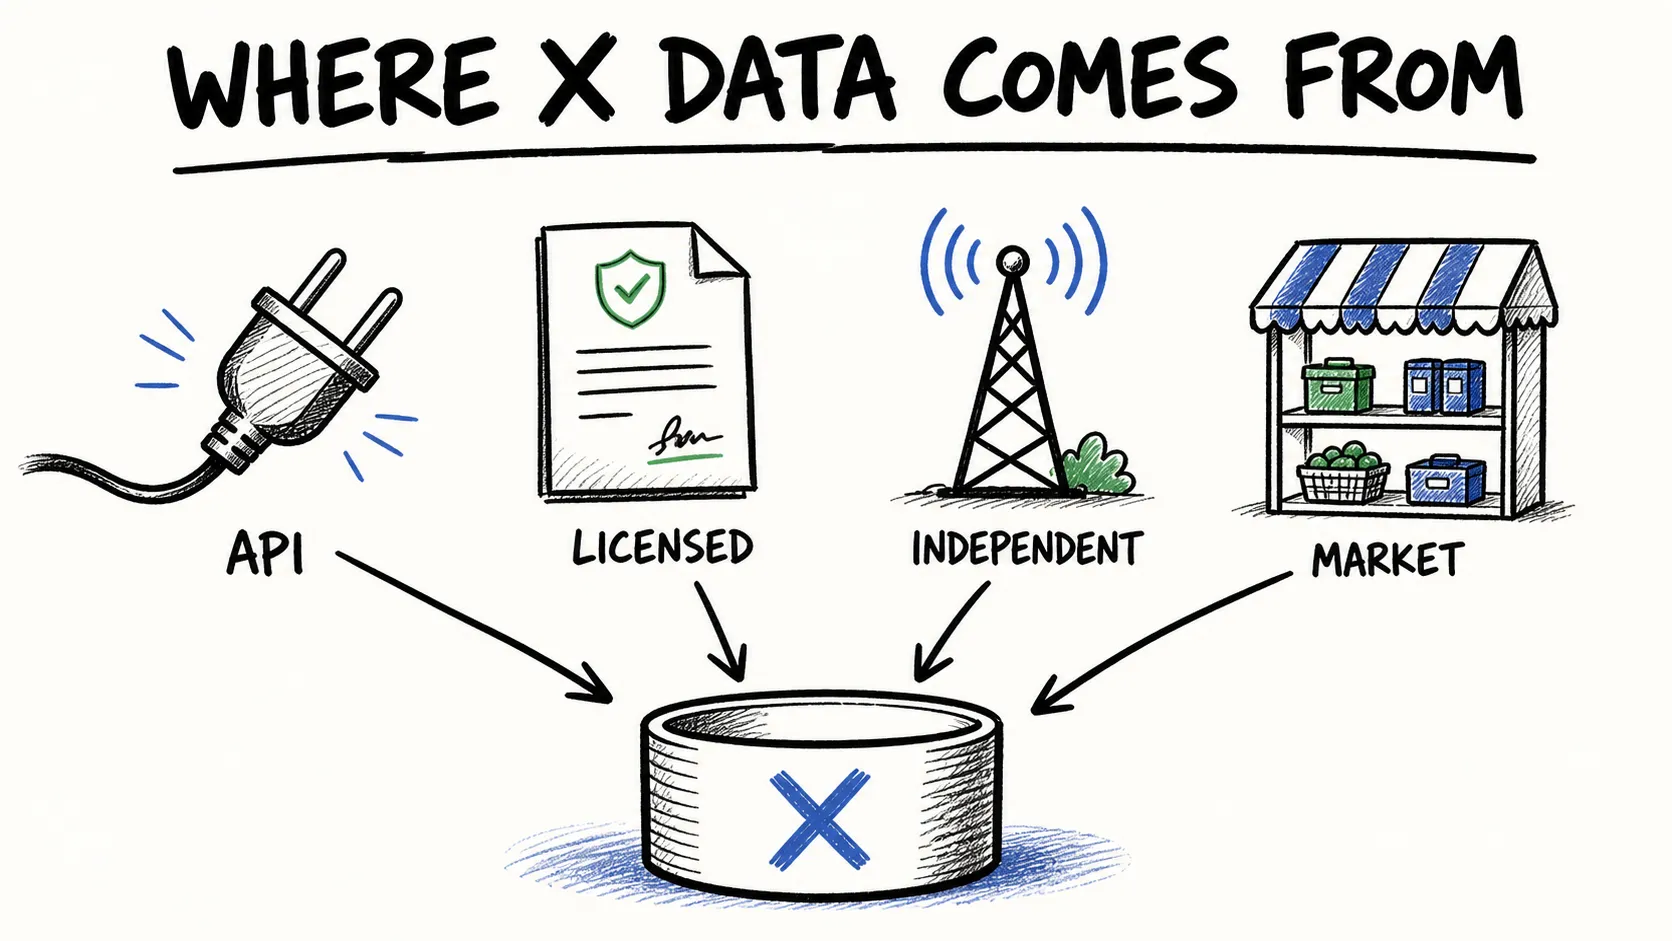
Tidak semua “penyedia data Twitter” bekerja dengan cara yang sama, dan perbedaannya penting — untuk reliabilitas, kepatuhan, dan biaya. Berikut taksonomi yang saya pakai:
-
Akses API resmi — Kamu memakai X API key sendiri, memanggil endpoint X secara langsung, dan mengikuti rate limit serta developer policy X. Tweepy dan twarc masuk kategori ini. X API sendiri juga masuk sini.
-
API berbasis scraping — Vendor menjalankan pengambilan dari web publik secara otomatis (browser, endpoint hasil reverse engineering, dan sebagainya), lalu menjual output-nya sebagai API yang rapi. Lebih cepat dan sering kali lebih murah, tetapi Terms of Service dan aturan otomasi X melarang crawling atau scraping tanpa persetujuan tertulis sebelumnya. Bright Data, SocialData.tools, dan sebagian besar Apify Actors berada di sini.
-
Platform social listening berlisensi — Vendor enterprise seperti Brandwatch dan Meltwater secara historis punya kesepakatan firehose-level dengan Twitter. Sebagian masih memegang kemitraan resmi; yang lain beroperasi di bawah kontrak yang terus berubah. Cakupan, hak ekspor, dan aturan redaksi data berbeda-beda tergantung paket.
-
Alat ekstraksi berbasis browser — Alat seperti Thunderbit dapat menstrukturkan data yang terlihat di halaman yang kompatibel, selama pengguna memang punya izin untuk mengotomasi. Ini beda dari API massal atau firehose dan tidak boleh diperlakukan sebagai cara untuk mengakali kontrol akses X.
Memahami kategori tiap penyedia akan memberi banyak petunjuk soal daya tahannya, posisi hukumnya, dan apa yang terjadi kalau X mengubah sesuatu.
Apa yang Perlu Diperhatikan Saat Memilih Penyedia Data Twitter
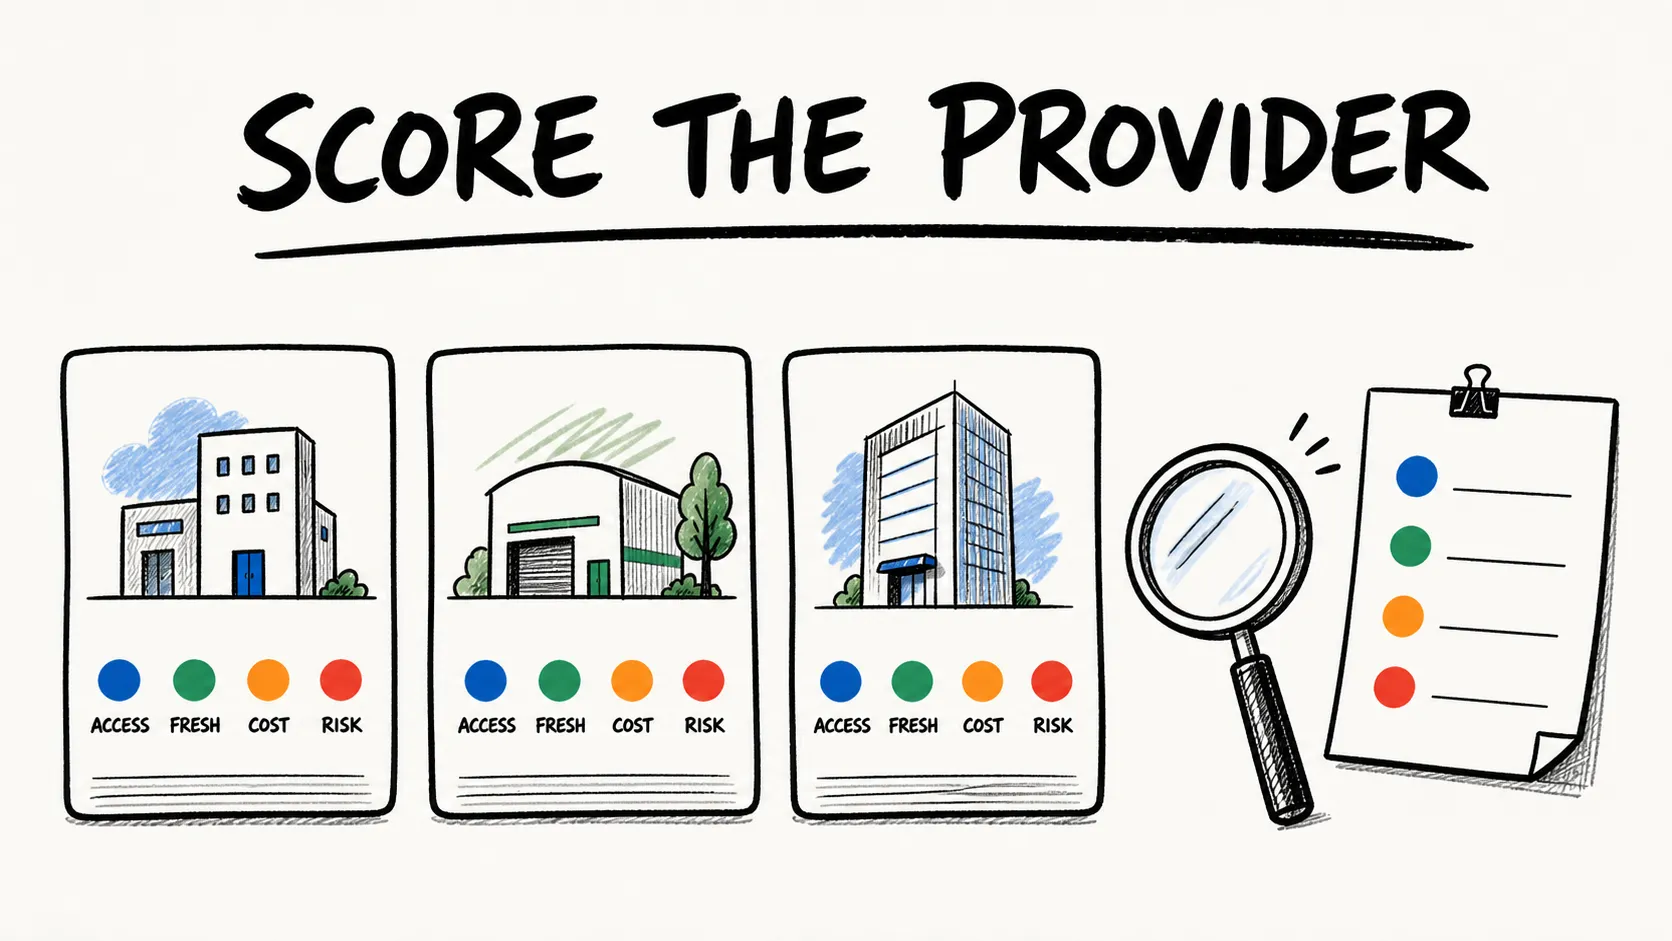
Setiap opsi dievaluasi dengan enam kriteria praktis:
- Metode akses data — API resmi, berbasis scraping, listening berlisensi, atau berbasis browser?
- Transparansi harga dan biaya awal — Apakah harga bisa dilihat sebelum bicara dengan sales?
- Jenis data yang dikembalikan — Post, profil, metrik engagement, arsip historis?
- Posisi kepatuhan — Selaras dengan ToS, siap GDPR/CCPA, bagaimana penanganan data yang dihapus?
- Tingkat kesulitan teknis — Hanya untuk developer, atau bisa dipakai non-coder?
- Bukti reliabilitas — Apakah penyedia mempublikasikan SLA, riwayat status, sinyal maintenance, dan proses notifikasi perubahan?
Tidak ada satu penyedia pun yang menang di semua enam aspek. Pilihan terbaik tergantung volume, budget, skill teknis, dan seberapa besar maintenance yang sanggup kamu tanggung. Dengan kerangka itu, berikut dua belas opsinya.
Perbandingan 12 Penyedia Data Twitter (2026)
Sebelum masuk ke detail, ini tabel perbandingan lengkapnya. Harga berlaku saat publikasi — selalu cek ulang di situs penyedia karena pasar ini bergerak cepat.
| Penyedia | Metode Akses | Harga Mulai | Data Historis | Real-Time | Opsi No-Code | Terbaik Untuk |
|---|---|---|---|---|---|---|
| X Official API | API pihak pertama langsung | $0.005/Post read (pay-per-use) | Full Archive hingga Maret 2006 | Ya (Filtered Stream) | Tidak | Developer yang butuh endpoint resmi |
| Bright Data | Managed scraper + dataset | 5K records/bulan gratis; PAYG $1.50/1K | Opsi dataset/date-window; tidak ditemukan jaminan arsip lengkap | Live scrape on request | Sebagian (control panel) | Pengumpulan web publik yang dikelola |
| SocialData.tools | API berbasis scraping | ~$0.20/1K item | Tergantung query/cursor | Ya | Tidak | Eksperimen developer berbiaya rendah |
| Apify | Marketplace (tergantung Actor) | Platform gratis $5/bulan; harga per Actor berbeda | Tergantung Actor | Ya | Sebagian (GUI Actor) | Workflow otomasi, prototyping |
| Netrows | API enrichment data publik | €99/bulan untuk 10K credit | Tidak ada arsip | Ya (live, uncached) | Sebagian | Enrichment B2B, prototyping |
| PhantomBuster | Otomasi session/browser | $56/bulan (effective annual rate saat cutoff) | Tidak ada arsip terjamin | Scheduled polling / watcher mode | Ya (GUI) | Workflow lead-gen skala kecil |
| Endpoint RapidAPI | Marketplace (tergantung listing) | Gratis 200 req → $9.99/10K | Bervariasi | Bervariasi | Tidak | Uji API cepat, prototyping |
| Phyllo | Infrastruktur API lintas platform | Custom quote | Kedalaman spesifik X tidak jelas | Klaim webhook/real-time | Tidak | Analitik creator/influencer |
| Brandwatch | Enterprise listening (vendor menyebut diri sebagai Official X Partner) | Custom quote | Tergantung produk dan paket; tersedia penawaran full-firehose | Ya, tergantung produk | Ya (dashboard) | Brand monitoring, sentimen, riset |
| Meltwater | Enterprise media + social intel | Custom quote | 15 bulan riwayat sosial instan | Ya | Ya (dashboard) | PR, komunikasi, media intelligence |
| Sprout Social | Social management + add-on Listening | $199/seat/bulan (annual) + Listening ekstra | Sampled; backfill otomatis 30 hari | Ya (sampled) | Ya (dashboard) | Tim sosial, publishing + analytics |
| Thunderbit | Ekstraksi berbasis browser | Ada paket gratis | Hanya level halaman | Level halaman | Ya (extension) | Pengguna non-teknis yang mengekstrak data terlihat |
Sekarang, detailnya.
1. X (Twitter) Official API

X Official API adalah satu-satunya sumber pihak pertama di daftar ini dan satu-satunya opsi dengan dokumentasi arsip pencarian lengkap hingga Maret 2006. Kalau prioritas utama kamu adalah kepatuhan dan asal-usul data, ini tempat memulainya.
Cara kerjanya: Endpoint REST dan streaming langsung. Kamu mendaftarkan aplikasi, mendapatkan API key, autentikasi via OAuth, lalu query endpoint untuk Post, Users, likes, lists, dan lainnya.
Fitur utama:
- Recent Search mencakup 7 hari terakhir (maksimal 100 Post per respons)
- Full-Archive Search menjangkau hingga Maret 2006 (maksimal 500 Post per respons, pay-per-use dan Enterprise)
- Filtered Stream mengalirkan public Post yang cocok hampir real-time (~6–7 detik P99 latency)
- Objek Post lengkap, profil user, metrik engagement, endpoint kepatuhan
Harga: X beralih ke kredit prabayar tanpa langganan atau komitmen minimum. Pada batas riset Agustus 2026: Post read $0.005, User read $0.010, Like read $0.001. Akun self-serve dibatasi dua juta Post reads per bulan. Harga Enterprise bersifat custom. Cek Developer Console sebelum bikin anggaran karena X menyebut harga bisa berubah.
Perlu diperhatikan: Pada migrasi search-index X tanggal 4 Mei 2026, pencarian REST berbasis keyword tidak lagi mengembalikan repost. Filtered Stream tidak terdampak. Ini mengubah komposisi korpus dibanding tutorial lama.
Cocok untuk: Developer yang butuh data mentah resmi dan bisa direproduksi. Organisasi yang sangat peduli kepatuhan. Siapa pun yang butuh arsip historis penuh.
Kurang cocok untuk: Pengguna non-teknis, tim dengan budget ketat, atau siapa pun yang butuh data massal melewati batas self-serve.
2. Bright Data

Bright Data menawarkan API scraping X yang dikelola serta dataset siap pakai. Halaman produk yang ditinjau menunjukkan opsi pengumpulan dan pengiriman saat ini, tetapi tidak menunjukkan kemitraan resmi dengan X atau arsip historis lengkap.
Fitur utama:
- Profil, Post, URL, dan job discovery
- Job sinkron (hingga 20 URL) dan asinkron (hingga 5.000 URL)
- Output dalam JSON, NDJSON, atau CSV via API, webhook, cloud storage, atau data warehouse
- 5.000 record gratis per bulan; PAYG $1.50 per 1.000 record berhasil; paket Scale $499/bulan termasuk 384.000 record
Catatan kepatuhan: Bright Data mempublikasikan kontrol kepatuhan dan keamanan, tetapi halaman yang ditinjau tidak mengklaim otorisasi atau kemitraan resmi dengan X. Ini adalah scraper web publik yang dikelola, bukan reseller API resmi. Tooling operasional memang mengurangi maintenance kolektor, tapi tidak menghapus kewajiban pembeli di bawah ketentuan X, hukum privasi, atau pembatasan penggunaan lanjutan.
Cocok untuk: Tim enterprise yang butuh pipeline data X skala besar dan berkelanjutan, serta siap menerima posisi kepatuhan dari koleksi berbasis scraping.
Dataset vs. Live Scraping di Bright Data
Bright Data menawarkan produk dataset siap pakai dan live scraping melalui infrastrukturnya. Dataset berguna untuk riset satu kali atau snapshot historis; live scraping cocok untuk monitoring berkelanjutan. Pilih sesuai kebutuhan kamu: korpus statis atau feed yang terus berjalan.
3. SocialData.tools

SocialData.tools mengiklankan lebih dari 30 endpoint read-only untuk Post, profil, search, followers, mentions, replies, quotes, threads, lists, Communities, dan Spaces. Harga umumnya $0.20 per 1.000 item, dengan beberapa endpoint spesialis lebih mahal.
Fitur utama:
- API REST/JSON dengan dukungan MCP server
- Pay-per-request, tanpa langganan
- Mencakup beragam jenis data X
Catatan penting: Ketentuan milik SocialData.tools sendiri secara eksplisit menyebut layanan ini sebagai scraping konten. Sumber data hanya disebut sebagai “berbagai sumber.” Pelanggan harus menjamin bahwa pengambilan data diizinkan. Vendor bisa menghentikan layanan kalau sumber target keberatan. Dokumentasi pencarian mereka juga mengakui adanya data yang terlewat dan kegagalan cursor. Meski ada bahasa “Try for Free”, tidak ada paket gratis yang dipublikasikan — hanya demo yang mungkin diberikan oleh support.
Cocok untuk: Developer yang ingin data Post dan profil dengan biaya rendah dan nyaman dengan risiko asal-usul data serta kebijakan setelah melakukan due diligence sendiri.
4. Apify

Apify adalah platform web scraping dan otomasi yang menampung “Actors” buatan komunitas — scraper siap pakai yang berjalan di cloud. Ada banyak Actor X independen di marketplace, masing-masing dengan harga, kualitas, dan jadwal maintenance yang berbeda.
Fitur utama:
- Platform dimulai dengan $5 penggunaan gratis per bulan, lalu $29/$199/$999 per bulan
- Actor perwakilan: xquik/x-tweet-scraper — mulai dari $0.00015 per baris yang dikirim pada paket berbayar; mendukung Post, reply, profil, search, threads, quote, retweeters, media, dan filter tanggal
- Integrasi dengan Zapier, Make, webhook
Catatan krusial: Ketentuan Apify menyatakan bahwa Community Actors tidak ditinjau, tidak diverifikasi, tidak didukung, dan tidak dijamin kualitas, keamanan, akurasi, kepatuhan hukum, maupun maintenance-nya. Artikel harus menyebut Actor spesifik yang dievaluasi — “Apify biayanya X” tidak ada artinya kalau tidak dijelaskan Actor dan unit tagihannya.
Cocok untuk: Workflow otomasi, proyek pengumpulan data sekali pakai, dan developer yang ingin menguji beberapa pendekatan scraping dalam satu platform.
Memilih Twitter Actor yang Tepat di Apify
Sebelum berkomitmen, cek tanggal update terakhir Actor, rating pengguna, dan status maintenance. Beberapa Actor bisa tertinggal berminggu-minggu dari perubahan X dan menghasilkan data usang atau rusak. Badge aktivitas di marketplace membantu menyaring, tapi tidak menjamin reliabilitas.
5. Netrows

Netrows adalah API enrichment data publik B2B yang lebih baru dan menawarkan endpoint X bersama data LinkedIn. Mereka mencantumkan 26 jenis endpoint X yang mencakup profil, followers, Post, replies, quotes, threads, search, lists, Communities, tren, dan Spaces.
Fitur utama:
- €99/bulan untuk 10K credit (50 req/menit), €499 untuk 100K, €1,499 untuk 500K
- Respons live tanpa cache (klaim vendor)
- Halaman status publik aktif pada batas riset; tidak ada SLA spesifik X yang berhasil diverifikasi secara publik
Catatan: Biaya credit pasti per endpoint dan skema respons perlu API key untuk diverifikasi. Materi resmi Netrows menyebut mereka tidak menawarkan arsip historis. Ketentuan mereka menjelaskan retrieval otomatis dari sumber publik, menyangkal afiliasi dengan X, dan menempatkan tanggung jawab atas ketentuan pihak ketiga pada pengguna.
Cocok untuk: Prototyping dan use case SMB, terutama tim yang juga butuh data LinkedIn dari API yang sama.
6. PhantomBuster

PhantomBuster pada dasarnya berbeda dari API di atas. Ini adalah otomasi browser berbasis session untuk prospecting, bukan API data atau feed berlisensi. Saya tekankan perbedaan ini sejak awal.
PhantomBuster tersambung ke session X pengguna lewat browser extension dan bisa mengekspor hasil pencarian yang terlihat, data profil, dan informasi follower ke CSV atau JSON. Tool ini bisa dijalankan terjadwal atau dalam mode watcher.
Fitur utama:
- GUI no-code yang dirancang untuk tim sales dan marketing
- Tarip efektif tahunan: $56/bulan (Start), $128/bulan (Grow), $352/bulan (Scale)
- Fokus pada field yang relevan untuk lead-gen, bukan arsip tweet lengkap
Risiko penting: Dokumentasi PhantomBuster sendiri memperingatkan bahwa melampaui batas platform dapat memicu warning, pembatasan, flag, atau ban. Ini adalah otomasi yang berjalan di dalam session akun X kamu — bukan feed data resmi. Gunakan secara hati-hati dan pahami risikonya terhadap akun.
Cocok untuk: Workflow sales prospecting skala kecil yang perlu membuat daftar target dari profil dan follower X.
7. Endpoint RapidAPI Twitter

RapidAPI adalah marketplace yang menampung puluhan endpoint X API dari developer independen. Ini bukan satu penyedia tunggal — lebih seperti pasar besar.
Listing perwakilan: datahungrybeast/twitter154 ("The Old Bird") — tier Basic gratis dengan 200 request, $9.99 untuk 10K, $49.99 untuk 100K, $299.99 untuk 1M. Menyediakan endpoint user, follower, Post, reply, search, dan list.
Fitur utama:
- Interface REST terpadu di banyak API pihak ketiga
- Beberapa listing menyediakan tier gratis
- Cara cepat untuk menguji banyak pendekatan
Risikonya nyata: Listing ini tidak punya website produk, tidak ada terms of service spesifik API, dan tidak ada otorisasi X, jaminan arsip, SLA real-time, atau proses kepatuhan penghapusan data. Dokumentasi RapidAPI sendiri menegaskan publisher mengontrol listing, harga, versi, dan endpoint mereka. Banyak endpoint yang tercantum sudah ditinggalkan atau rusak.
Cara Menghindari Endpoint Mati di RapidAPI
Cek statistik waktu respons, rating pengguna, tanggal update terakhir, dan selalu uji dengan tier gratis sebelum masuk ke paket berbayar. Banyaknya subscriber bukan berarti ada SLA.
Cocok untuk: Uji API cepat dan prototyping. Tidak disarankan sebagai sumber data produksi tanpa review asal-usul dan legal yang menyeluruh.
8. Phyllo

Phyllo memasarkan API data sosial publik dan terautentikasi yang dinormalisasi di banyak jaringan, termasuk X. Mereka menjelaskan mention kata kunci dan kompetitor, fetch Post terstruktur, analitik creator, job asinkron, polling, dan alert webhook.
Fitur utama:
- Infrastruktur API lintas platform (X, Instagram, YouTube, TikTok, dll.)
- Model berbasis consent untuk data scope creator
- Klaim webhook dan real-time untuk marketing
Catatan: Halaman pihak pertama yang ditinjau tidak mempublikasikan SLA latency khusus X, persentase kelengkapan, tanggal mulai histori, klaim full-firehose, atau kemitraan X yang disebut namanya. Harga bersifat custom (harus hubungi sales).
Cocok untuk: Developer yang membangun produk data creator, influencer, atau lintas platform dan butuh lapisan API yang dinormalisasi — setelah memverifikasi detail cakupan X langsung dengan Phyllo.
9. Brandwatch

Brandwatch menyebut dirinya Official X Partner. Produk Consumer Research mereka mengiklankan full X firehose dan Post historis publik; Listen mengiklankan akses full-firehose dengan sejarah X selama dua belas bulan.
Fitur utama:
- Arsip historis yang dalam (salah satu yang terdalam secara komersial)
- Analisis sentimen, analisis tren, dashboard intelijen kompetitif
- Dokumentasi kepatuhan enterprise, siap GDPR
Catatan ekspor: Dokumentasi developer Brandwatch menyebut teks Post X dan sebagian besar metadata dihapus dari respons API demi kepatuhan. Untuk mendapatkan isi Post lengkap, kamu mungkin perlu memakai ID Post lalu melakukan rehydration via X API. Ini perbedaan penting antara akses dashboard di dalam produk dan ekspor raw tanpa batas.
Harga: Custom quote. Tidak ada daftar harga numerik saat ini di halaman paket Brandwatch yang ditinjau.
Cocok untuk: Brand global, tim riset, dan operasi monitoring krisis yang butuh arsip X mendalam serta analytics enterprise.
10. Meltwater

Meltwater menggabungkan social listening dengan news dan media intelligence. Tur produknya menunjukkan lima belas bulan data sosial historis instan termasuk X, plus alert real-time, Boolean search, dashboard, intelijen kompetitif, dan reporting.
Fitur utama:
- News, PR, dan social intelligence dalam satu platform
- Alert dan dashboard real-time
- Ekspor dan API Analytics/Streaming (tergantung paket)
Catatan: Tidak ada arsip X lengkap atau SLA latency spesifik X yang berhasil dibuktikan. Cakupan bisa bergantung pada paket dan wilayah. Changelog developer Meltwater mendokumentasikan redaksi field X/Twitter demi kepatuhan. Meltwater menyatakan diri sebagai full enterprise partner X, tetapi sertifikasi independen yang terbaru di direktori milik X tidak berhasil dikonfirmasi dalam riset ini.
Harga: Custom quote, kontrak tahunan.
Cocok untuk: Tim PR dan komunikasi yang butuh data X berdampingan dengan monitoring berita, media intelligence, dan analitik sosial lintas kanal.
11. Sprout Social

Sprout Social terutama adalah platform manajemen media sosial — publishing, engagement, care, approvals, analytics milik sendiri, dan reporting. Add-on Social Listening berbayarnya bisa memantau Post publik, replies, mentions, quote reposts, dan repost di X.
Fitur utama:
- Paket inti: $199/$299/$399 per seat/bulan (dibayar tahunan); Listening adalah add-on tambahan
- Berbasis dashboard, dirancang untuk social media manager
- Situs bisnis X sendiri menyebut Sprout sebagai official X partner
Masalah sampling: Pusat bantuan Sprout secara eksplisit menyatakan X Listening memakai sampled data, bukan full firehose. Backfill otomatis hanya 30 hari atau 200.000 pesan terakhir. Public API Sprout mendukung analytics profil milik sendiri, tetapi data Topic X Listening saat ini tidak tersedia lewat API itu.
Cocok untuk: Tim media sosial yang sudah memakai Sprout untuk publishing dan community management serta ingin analytics X yang bersifat arah umum di dashboard yang sama. Bukan pilihan tepat kalau tujuan utama kamu mengekstrak data X mentah dalam skala besar.
12. Thunderbit

Thunderbit adalah alat AI web scraping dan otomasi yang tersedia sebagai ekstensi browser Chrome, dirancang untuk pengguna bisnis yang perlu menstrukturkan data web yang diizinkan tanpa menulis kode.
Cara memposisikannya di sini: Thunderbit bisa menyarankan field, mengikuti pagination atau subpage yang kompatibel, menambahkan enrichment berbasis prompt, lalu mengekspor ke Excel, CSV, Google Sheets, Airtable, atau Notion. Itu semua adalah kemampuan data web umum. Itu tidak berarti ada feed X yang diotorisasi, cakupan X lengkap, atau izin untuk mengotomasi X.
Fitur utama:
- Saran field tanpa kode dan ekspor terstruktur
- Deteksi field berbantuan AI yang menyesuaikan perubahan layout
- Paket dan batas penggunaan perlu dicek di thunderbit.com/pricing
- Hanya cocok untuk halaman yang kompatibel dan penggunaan di mana pengguna memang punya izin untuk mengotomasi
Apa yang bukan Thunderbit: Thunderbit bukan penyedia data X resmi, bukan API X massal, bukan pengganti firehose, dan bukan dataset X siap pakai. Ketentuan X saat ini melarang browser scraping tanpa persetujuan tertulis sebelumnya. Untuk data X, mulai dari API resmi, penyedia berotorisasi yang terdokumentasi, atau arsip akun kamu sendiri. Gunakan Thunderbit untuk workflow data web yang kompatibel dan diizinkan — bukan sebagai jalan pintas untuk akses atau harga API X.
Untuk memahami bagaimana ekstraksi data web bekerja dalam praktik, blog kami membahas apa itu web scraping, cara melakukannya tanpa coding, dan pendekatan praktis untuk pengumpulan data Twitter.
Penyedia Data Twitter Mana yang Cocok untuk Budget dan Use Case Anda?
Tidak ada satu penyedia pun yang paling unggul untuk semua orang. Berikut kerangka keputusan berdasarkan use case dan tier budget:
| Use Case | Pilihan Hemat | Pilihan Menengah | Pilihan Enterprise |
|---|---|---|---|
| Riset akademik / arsip | X Official API (pay-per-use) + twarc | Mitra data berlisensi | X Enterprise / mitra berlisensi kontrak |
| Brand monitoring / sentimen | API resmi dengan query terbatas | Sprout Social (sampled Listening add-on) | Brandwatch atau Meltwater setelah review kontrak |
| Lead gen / sales prospecting | Riset manual berbasis consent | Otomasi yang diizinkan setelah review kebijakan | Penyedia resmi + pipeline CRM terkelola |
| Ekstraksi cepat satu kali (tanpa kode) | Arsip akun atau ekspor resmi | Workflow halaman yang kompatibel dan diizinkan | Dashboard / ekspor enterprise |
| Analitik influencer / creator | Phyllo (setelah review cakupan X) | Phyllo | Brandwatch |
| Pipeline NLP / data science | X Official API (pay-per-use) | Penyedia berotorisasi dengan hak ekspor | X Enterprise / feed berlisensi |
Ada beberapa pola yang langsung kelihatan:
- Kalau kepatuhan dan asal data tidak bisa ditawar, X Official API adalah baseline kamu. Sisanya selalu mengandung trade-off.
- Kalau kamu butuh arsip historis dalam dan dashboard enterprise, Brandwatch dan Meltwater adalah pemain yang sudah mapan — tapi siapkan kontrak custom dan ekspor yang sudah di-redact.
- Kalau kamu pengguna non-teknis, pilih sumber berotorisasi yang menyediakan ekspor CSV atau Sheets. Gunakan otomasi browser hanya pada halaman yang kompatibel dan saat izinnya jelas; itu bukan pengganti pipeline data produksi.
Catatan Singkat soal Kepatuhan: ToS, GDPR, dan Apa yang Perlu Ditanyakan ke Tim Legal
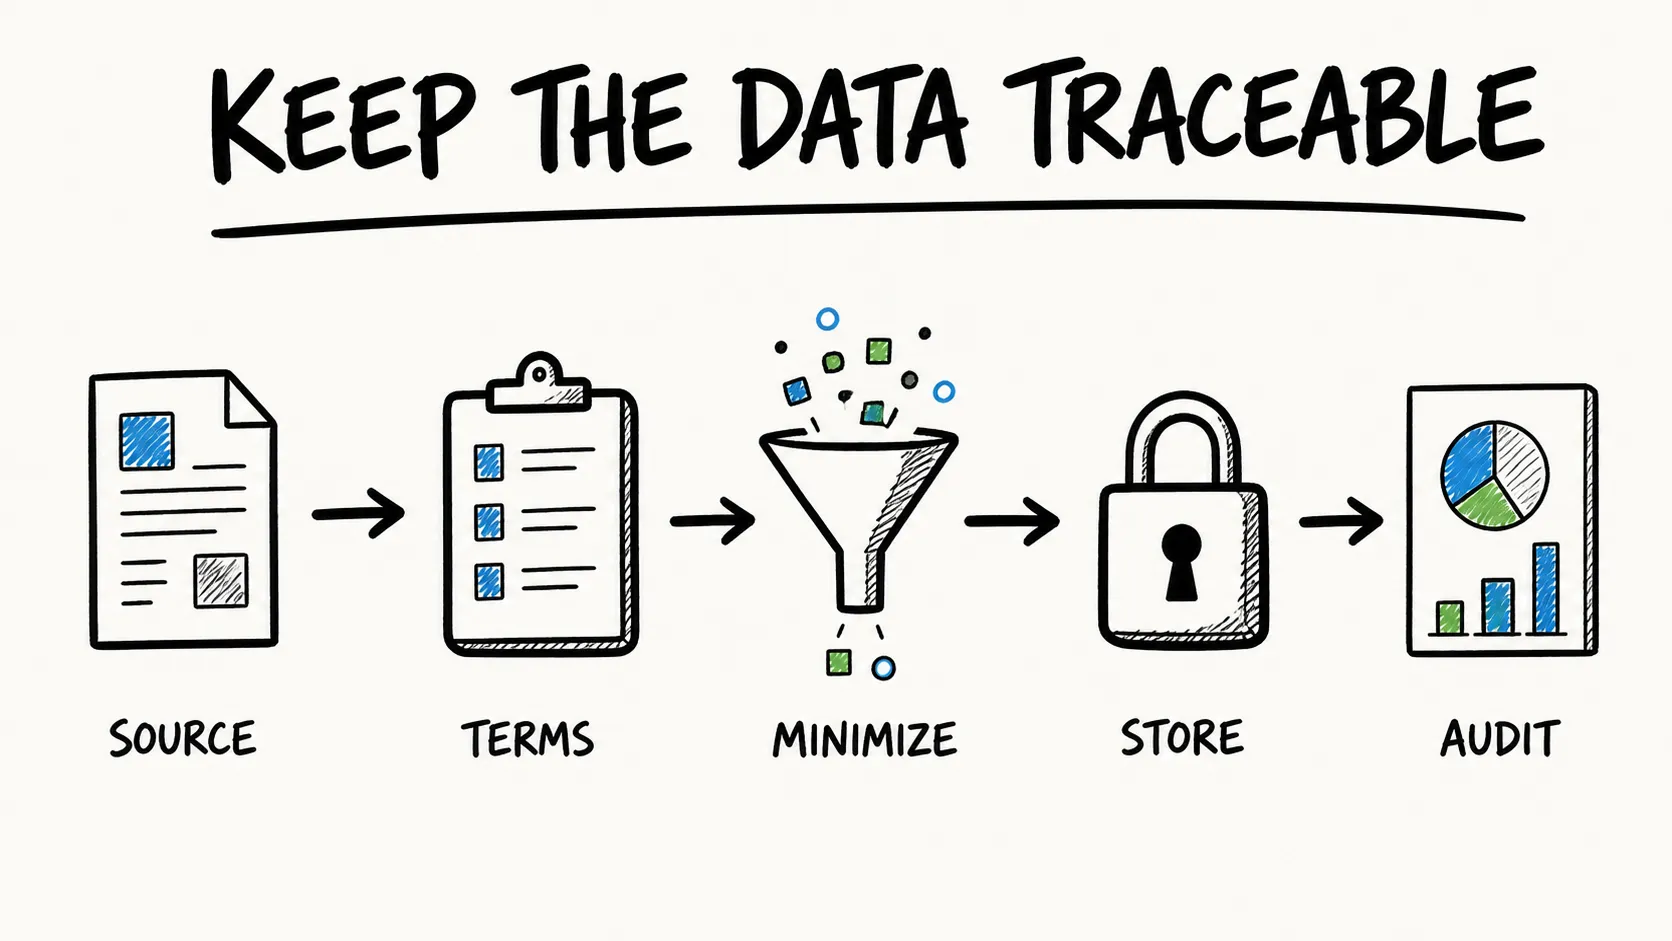
Bagian ini adalah panduan operasional, bukan nasihat hukum.
Terms of Service X melarang crawling, scraping, atau scripting situs tanpa persetujuan tertulis sebelumnya. Developer Policy X menambahkan syarat terkait privasi, transparansi, kontrol pengguna, kepatuhan penghapusan, serta pembatasan inferensi sensitif, matching, redistribusi, dan training model. Ketersediaan teknis tidak berarti izin hukum.
GDPR, CCPA, dan aturan privasi lain bisa berlaku ketika kamu mengumpulkan handle, lokasi, bio profil, atau teks Post. Visibilitas publik sendiri tidak otomatis menyelesaikan masalah otorisasi platform, privasi, kontrak, hak cipta, hukum akses komputer, atau hak penggunaan lanjutan. Terapkan minimisasi data dan kontrol retensi, lalu mintalah review legal untuk yurisdiksi dan use case yang sebenarnya.
Tiga aturan praktis:
- Batasi pada data publik yang memang punya tujuan sah untuk dikumpulkan.
- Jangan menyimpan berlebihan — tetapkan batas retensi dan patuhi permintaan penghapusan.
- Tanyakan ke tim legal sebelum membangun sesuatu dalam skala besar.
Pertanyaan untuk vendor mana pun: Apakah Anda X Official Partner? Metode persis apa yang dipakai produk ini? Bagaimana Post yang dihapus dan akun yang diproteksi ditangani? Apakah Anda bisa menyimpan teks penuh, atau hanya ID dan agregat?
Kesimpulan
Model akses gratis yang lama sudah hilang. Dua belas entri ini mencakup API pihak pertama, layanan web publik yang dikelola, suite enterprise untuk listening, marketplace, dan alat no-code; semuanya tidak menawarkan otorisasi, kelengkapan, atau risiko yang setara.
Pilihan yang tepat tergantung pekerjaannya. Untuk data mentah yang bisa direproduksi dengan provenance pihak pertama, mulai dari X API. Untuk dashboard enterprise dan listening yang terkelola, evaluasi Brandwatch, Meltwater, atau Sprout sesuai kebutuhan kontrak dan ekspor kamu. Perlakukan kolektor independen dan listing marketplace sebagai opsi berisiko lebih tinggi yang butuh pengujian langsung, pengungkapan metode sumber, dan review legal. Gunakan Thunderbit untuk workflow data web yang kompatibel dan diizinkan — bukan sebagai feed X.
Lanskap data X terus berubah. Cek harga secara live, baca ketentuan yang relevan, dokumentasikan sumber data dan query kamu, lalu libatkan reviewer legal dan security sebelum membangun workflow ber-volume tinggi atau sensitif.
Pelajari lebih lanjut:
- Cara Melakukan Analisis Sentimen Twitter untuk Keputusan yang Lebih Baik
- Cara Menguasai Pengumpulan Data Twitter dengan Thunderbit
- Apa Itu Social Media Scraping Tool dan Bagaimana Cara Kerjanya?
- Apakah Web Scraping Ilegal? Memahami Implikasi Hukumnya
- Web Scraping Tanpa Coding
FAQ
1. Apa yang terjadi dengan akses gratis API Twitter?
X menghapus tier baca gratis pada awal 2023. Model saat ini adalah kredit prabayar pay-per-usage — standard Post read biayanya $0.005, dan akun self-serve dibatasi dua juta Post reads per bulan. Jalur Academic Research juga dihentikan, sehingga peneliti kehilangan akses bulk gratis yang dulu mereka punya.
2. Bagaimana penyedia data Twitter pihak ketiga mendapatkan datanya?
Secara umum mereka terbagi dalam tiga kategori: (1) wrapper API resmi yang memakai X API key milik kamu sendiri dan tunduk pada rate limit X; (2) API berbasis scraping yang mengumpulkan data lewat browser otomatis atau endpoint hasil reverse engineering — lebih murah tapi berisiko terhadap ToS dan kontinuitas; dan (3) platform social listening berlisensi seperti Brandwatch dan Meltwater yang punya perjanjian data enterprise dengan X. Alat berbasis browser seperti Thunderbit adalah kategori keempat — mereka mengekstrak apa yang terlihat di halaman pada session browser kamu sendiri.
3. Penyedia data Twitter mana yang paling murah untuk mulai?
Pada cutoff Agustus 2026, X Official API mencantumkan $0.005 per standard Post read tanpa komitmen minimum. Bright Data mengiklankan 5.000 record gratis per bulan, Apify menyertakan penggunaan platform senilai $5 per bulan, listing RapidAPI yang disebut menawarkan 200 request gratis, dan SocialData.tools umumnya mengenakan sekitar $0.20 per 1.000 item. Unit-unit ini tidak setara, dan opsi resmi termurah yang lengkap untuk satu use case bisa berbeda dari request mentah termurah. Pastikan semua harga live dicek sebelum membeli.
4. Bisakah saya mendapatkan tweet historis tanpa membayar X Enterprise API?
Bisa. Full-Archive Search pada X Official API menjangkau hingga Maret 2006 pada akses pay-per-use dan Enterprise, jadi Enterprise bukan satu-satunya jalur resmi. Brandwatch mengiklankan riset historis yang dalam, dengan ketersediaan tergantung produk dan paket. Kolektor independen mungkin menyediakan jendela tanggal atau dataset yang disimpan vendor, tetapi jangkauan dan kelengkapannya tidak setara dengan arsip penuh X yang terdokumentasi.
5. Apakah ada cara no-code untuk mendapatkan data Twitter?
Ada. Sprout Social dan Brandwatch menyediakan workflow berbasis dashboard tanpa coding, dan penyedia berotorisasi mungkin menawarkan ekspor CSV atau spreadsheet. Thunderbit bisa menstrukturkan data pada halaman yang kompatibel ketika kamu punya izin untuk mengotomasi; Thunderbit bukan feed X resmi. PhantomBuster menawarkan otomasi berbasis session tetapi mendokumentasikan risiko terhadap akun dan rate limit. Pastikan cakupan, otorisasi, sampling, dan hak ekspor sebelum memilih jalur no-code apa pun.



