
Satu halaman hasil pencarian Google Shopping bisa saja menyelipkan iklan berbayar di antara listing organik, menyembunyikan harga untuk produk yang stoknya habis, dan menampilkan produk yang sama dari lima penjual berbeda. Selama beberapa minggu terakhir, saya membedah sembilan tools yang mengklaim bisa mengubah kekacauan ini menjadi data yang rapi dan bisa dipakai — dan jawaban jujurnya adalah: “terbaik” sepenuhnya bergantung pada apakah Anda seorang developer yang membangun pipeline atau marketer yang cuma ingin angkanya masuk spreadsheet sebelum Jumat.
Perbedaan itu kelihatan jelas di mana-mana dalam riset. Di r/learnpython dan r/node, orang-orang saling berbagi catatan soal Puppeteer, Playwright, dan rotasi proxy. Di r/PPC, orang-orang cari sesuatu yang lebih mirip “langsung kasih datanya, saya tidak mau sentuh kode.” Jadi alih-alih mengurutkan sembilan tools ini secara alfabetis atau menempelkan label “terbaik secara keseluruhan” ke vendor yang homepage-nya paling mencolok, saya menilai masing-masing berdasarkan enam kriteria konkret dan mengurutkannya menurut alur kerja — dimulai dari managed SERP API, lalu infrastruktur proxy dan scraper, kemudian platform actor untuk developer, dan terakhir tool browser no-code.
Apa yang Membuat Google Shopping Scraper Layak Disebut "Terbaik"? Ini Kriteria Penilaiannya
Kata “terbaik” sering dipakai terlalu gampang di banyak listicle, jadi mari kita luruskan dulu maksudnya di artikel ini. Saya menilai kesembilan tools dengan enam faktor yang sama, bukan mengulang klaim marketing masing-masing vendor:
- Cakupan data — apakah skema yang didokumentasikan benar-benar bisa mengembalikan harga, penjual, rating, jumlah ulasan, ongkir, dan perbedaan nyata antara listing berbayar dan organik?
- Dukungan locale/geo — apakah Anda bisa menargetkan negara, bahasa, atau perangkat tertentu, atau semuanya bergantung pada resolusi IP proxy yang kebetulan dipakai?
- Tingkat kerumitan setup — apakah cukup dengan API key dan request GET, atau perlu task antrian dengan callback, workflow dua langkah yang dirangkai token, atau halaman web yang tinggal diklik?
- Beban maintenance — siapa yang harus menanggung saat Google mengubah struktur HTML atau memunculkan CAPTCHA: Anda, atau vendornya?
- Jalur ekspor/integrasi — hasil JSON biasa, atau bisa langsung masuk ke Sheets, Airtable, atau data warehouse Anda?
- Transparansi harga — apakah vendor menampilkan biaya per unit yang nyata dan bisa dihitung, atau Anda harus “hubungi sales” dulu untuk tahu harga sebenarnya?
Satu hal yang tidak akan saya lakukan di sini adalah mengarang tingkat keberhasilan, benchmark kecepatan, atau persentase akurasi. Tidak ada satu pun vendor di daftar ini yang melakukan benchmark independen terhadap vendor lain, dan klaim seperti “99,9% sukses” atau “super cepat” itu copy marketing, bukan pengukuran. Yang Anda dapatkan di sini adalah apa yang benar-benar dibuktikan oleh dokumentasi masing-masing vendor — dan ternyata itu sudah cukup banyak.
Developer Ingin Kode, Marketer Ingin Tanpa Kode
Kalau Anda pernah berkutat di forum yang berhubungan dengan scraping, Anda pasti tahu pembagian ini memang nyata. Tapi tetap penting dijelaskan karena itulah yang menentukan urutan daftar ini. Developer yang membangun pipeline data ingin API key, JSON yang bisa diprediksi, parameter locale yang eksplisit, dan skema yang bisa divalidasi serta dinormalisasi di tahap berikutnya. Mereka biasanya yang bertanya soal rotasi proxy dan rendering browser headless.
Tim marketing dan PPC lebih suka sesuatu yang mendekati “arah ke halaman, lalu kasih spreadsheet-nya.” Mereka tidak mau merawat script Puppeteer setiap kali Google mengubah layout shopping-nya untuk ketiga kalinya kuartal ini (dan itu pasti terjadi — markup shopping Google cukup sering berubah sampai vendor API pun biasanya mempublikasikan changelog soal ini).
Karena itu, daftar ini bergerak dari penyedia managed SERP API (SerpApi, Serper, SearchAPI, DataForSEO) — JSON terstruktur, tanpa perlu urusan proxy, tetapi tetap butuh kode — lalu ke infrastruktur proxy dan scraper (Bright Data, Oxylabs) yang memberi kontrol lebih besar tapi setup-nya juga lebih berat, kemudian ke platform actor developer yang sangat bisa dikustomisasi (Apify), dan ditutup dengan Thunderbit, tool browser agentik no-code untuk orang-orang yang benar-benar tidak ingin menulis atau memelihara kode scraping.
9 Google Shopping Scraper Terbaik Sekilas
| Tool | Model Pengumpulan | Kompleksitas Setup | Dukungan Locale | Persona Paling Cocok | Beban Maintenance |
|---|---|---|---|---|---|
| SerpApi | Managed Shopping API | Rendah (API key) | Kuat (location, gl, hl, device) | Data engineer, tools SEO | Ditangani vendor |
| Serper | SERP API umum, Shopping sebagai salah satu tipe hasil | Rendah | Sedang (negara/bahasa terdokumentasi) | Developer yang sensitif biaya | Ditangani vendor |
| SearchAPI | Managed Shopping + Product Offers API | Rendah–Sedang (dua langkah untuk offers) | Sedang | Tim perbandingan offers/merchant | Ditangani vendor |
| DataForSEO | Merchant API berbasis task | Sedang (queue/callback) | Kuat | Pipeline bulk/terjadwal | Ditangani vendor |
| Bright Data | Dataset + Scraper API + SERP API | Sedang (tergantung surface) | Sangat kuat | Tim data enterprise | Dibagi |
| Oxylabs | Pencarian dua langkah + API detail produk | Sedang (token chaining) | Sangat kuat | Tim data enterprise | Dibagi |
| Scrapingdog | Endpoint Shopping khusus | Rendah–Sedang | Sedang | Developer yang hemat budget | Ditangani vendor |
| Apify | Platform actor/developer | Sedang–Tinggi | Tergantung actor | Pembuat pipeline kustom | Dikelola pengguna |
| Thunderbit | Ekstraksi browser agentik no-code | Sangat rendah (One Click Extract) | Tergantung halaman target | Marketer/PPC, non-coder | Rendah, tergantung halaman |
(Pastikan mengecek harga terbaru, batas kredit, dan cakupan locale di dokumentasi live masing-masing vendor sebelum memutuskan — ini berubah cepat, dan beberapa vendor di sini sudah merilis perubahan yang mematahkan integrasi pada 2026.)
1. SerpApi — Managed, Kaya Fitur, dan Jelas Soal Cache
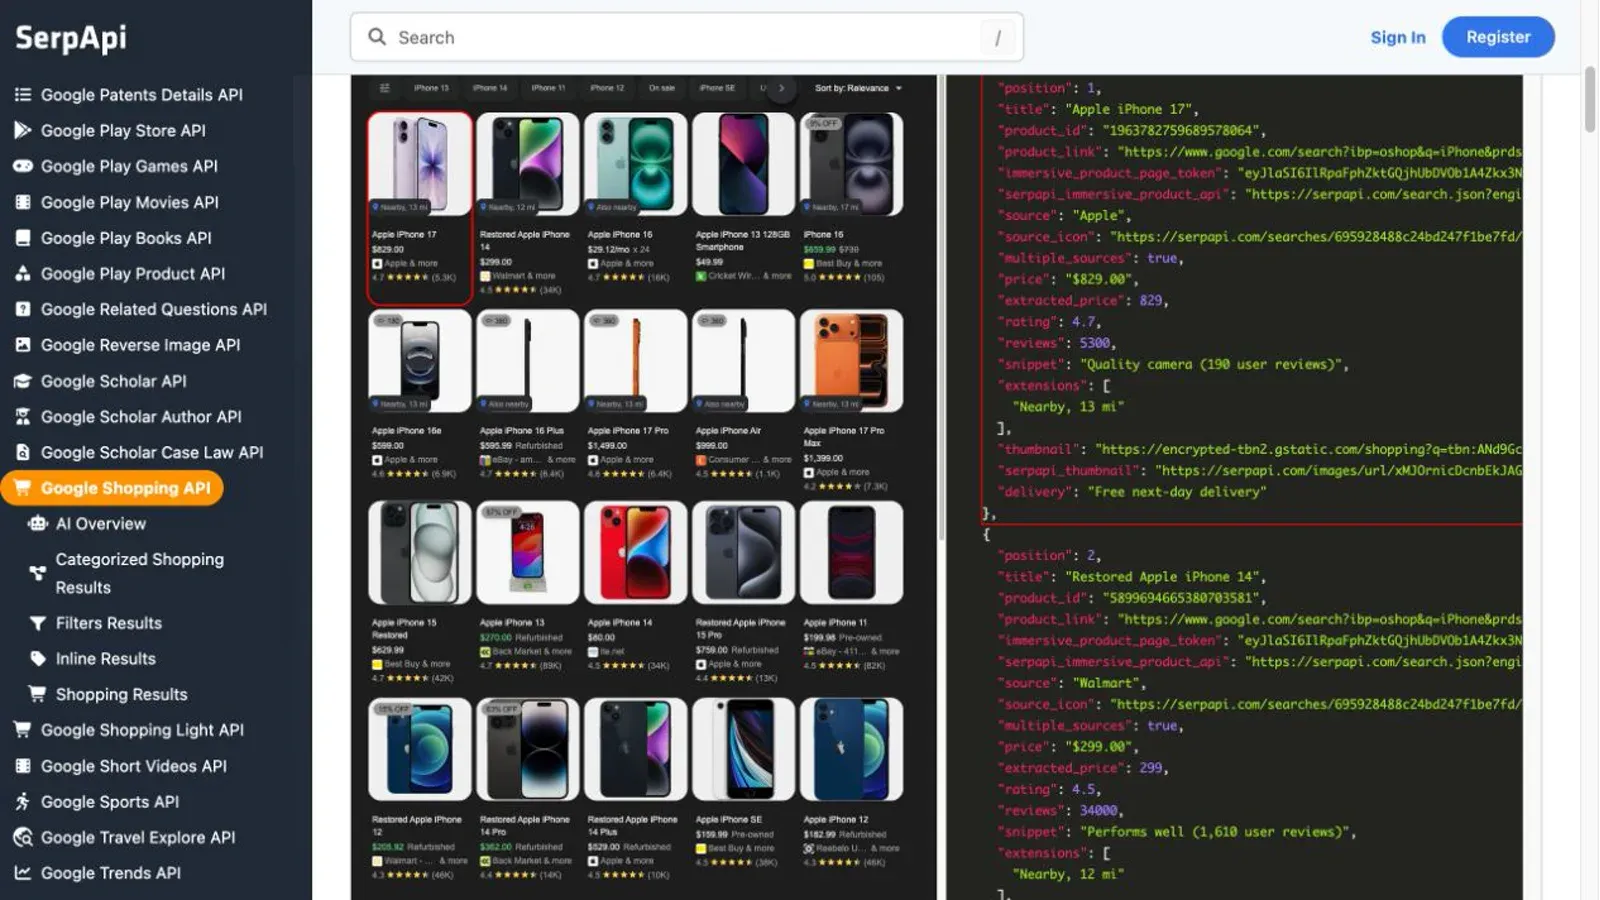
SerpApi menjalankan engine Google Shopping khusus (engine=google_shopping) yang menerima query Anda dan mengembalikan shopping_results terstruktur — posisi, judul, product ID, harga plus angka harga yang diekstrak, harga lama/cicilan, pengiriman, kondisi, rating, jumlah ulasan, dan gambar. Itu skema yang sangat kuat, dan SerpApi juga mendokumentasikan hasil Shopping berbayar melalui skema Google Ads Shopping secara terpisah, jadi Anda bisa menemukan placement sponsored — hanya saja bukan dalam satu flag sponsored: true/false yang langsung tertanam di response Shopping khusus.
Yang membedakan SerpApi adalah keterbukaannya soal hal-hal yang biasanya baru bikin masalah belakangan. Target lokasi mendukung location level kota yang kanonis atau uule yang presisi, plus parameter terpisah gl (negara), hl (bahasa), dan device (desktop, tablet, mobile). Mereka juga menjelaskan dengan terang bahwa query yang sama bisa masuk cache sampai satu jam secara default — hasil cache tidak dikenai biaya, sedangkan no_cache=true memaksa pengambilan data baru. Ini jenis transparansi yang biasanya disembunyikan atau dilewatkan oleh vendor lain.
Harga (dicek 2026-08-13) bersifat publik dan bulanan: Free tier 250 pencarian, Starter $25 untuk 1.000, hingga Big Data $275 untuk 30.000. Hanya pencarian yang berhasil yang dihitung ke kuota — request yang di-cache dan yang gagal tidak dihitung. Perlu diketahui: Google menggugat SerpApi pada awal 2026 terkait metode akses datanya; SerpApi membantah narasi tersebut dan menyatakan mereka mengakses hasil publik tanpa autentikasi. Ini situasi hukum yang masih berjalan, bukan putusan akhir, jadi anggap saja sebagai faktor risiko yang perlu dipantau, bukan alasan otomatis untuk menghindari tool ini.
Cocok untuk: developer yang ingin skema Shopping terdokumentasi paling kaya dan kontrol paling jelas atas cache serta locale.
2. Serper — Cepat, Ramah Budget, dan Klaim Freshness Paling Bersih
Serper memposisikan diri sebagai Google SERP API umum, dengan Shopping sebagai salah satu tipe hasil di samping Search, Images, News, Maps, dan beberapa tipe lainnya. Kalau Anda sudah menarik hasil pencarian biasa dan hanya butuh data Shopping sebagai tambahan, ini jauh lebih ringan dibanding menyalakan vendor khusus kedua.
Contoh publik Shopping mengembalikan judul, sumber, link merchant langsung, harga terformat, pengiriman, rating, jumlah rating, jumlah offer, product ID, dan posisi — cukup solid untuk monitoring kartu produk dasar, walaupun dokumentasi publiknya tidak menampilkan detail offer merchant sedalam SearchAPI atau field pricing promosi seperti yang didokumentasikan Oxylabs. Selling point paling bersih dari Serper adalah janji freshness-nya: setiap panggilan mengambil data langsung dari Google dan tidak ada cache, sehingga Anda tidak perlu memikirkan pengelolaan cache seperti pada SerpApi (dengan konsekuensi tetap membayar setiap query berulang, terlepas dari cache atau tidak).
Harga memakai tier kredit prabayar, bukan langganan — 2.500 query gratis di awal, lalu $50 untuk 50.000 kredit dengan skala turun hingga $0,30 per 1.000 di tier atas, dan kredit berlaku selama enam bulan. Halaman harga juga dengan jujur menyebut bahwa request individual bisa memakan 2–4 detik “when it must retry the request to Google,” yang merupakan ekor latensi nyata dan perlu Anda perhitungkan, bukan sekadar angka benchmark yang harus diabaikan.
Cocok untuk: tim yang sudah mengintegrasikan SERP API yang lebih luas dan ingin Shopping sebagai bonus, bukan produk terpisah.
3. SearchAPI — Detail Offer yang Kuat, Tapi Ada Satu Kerumitan Dokumentasi
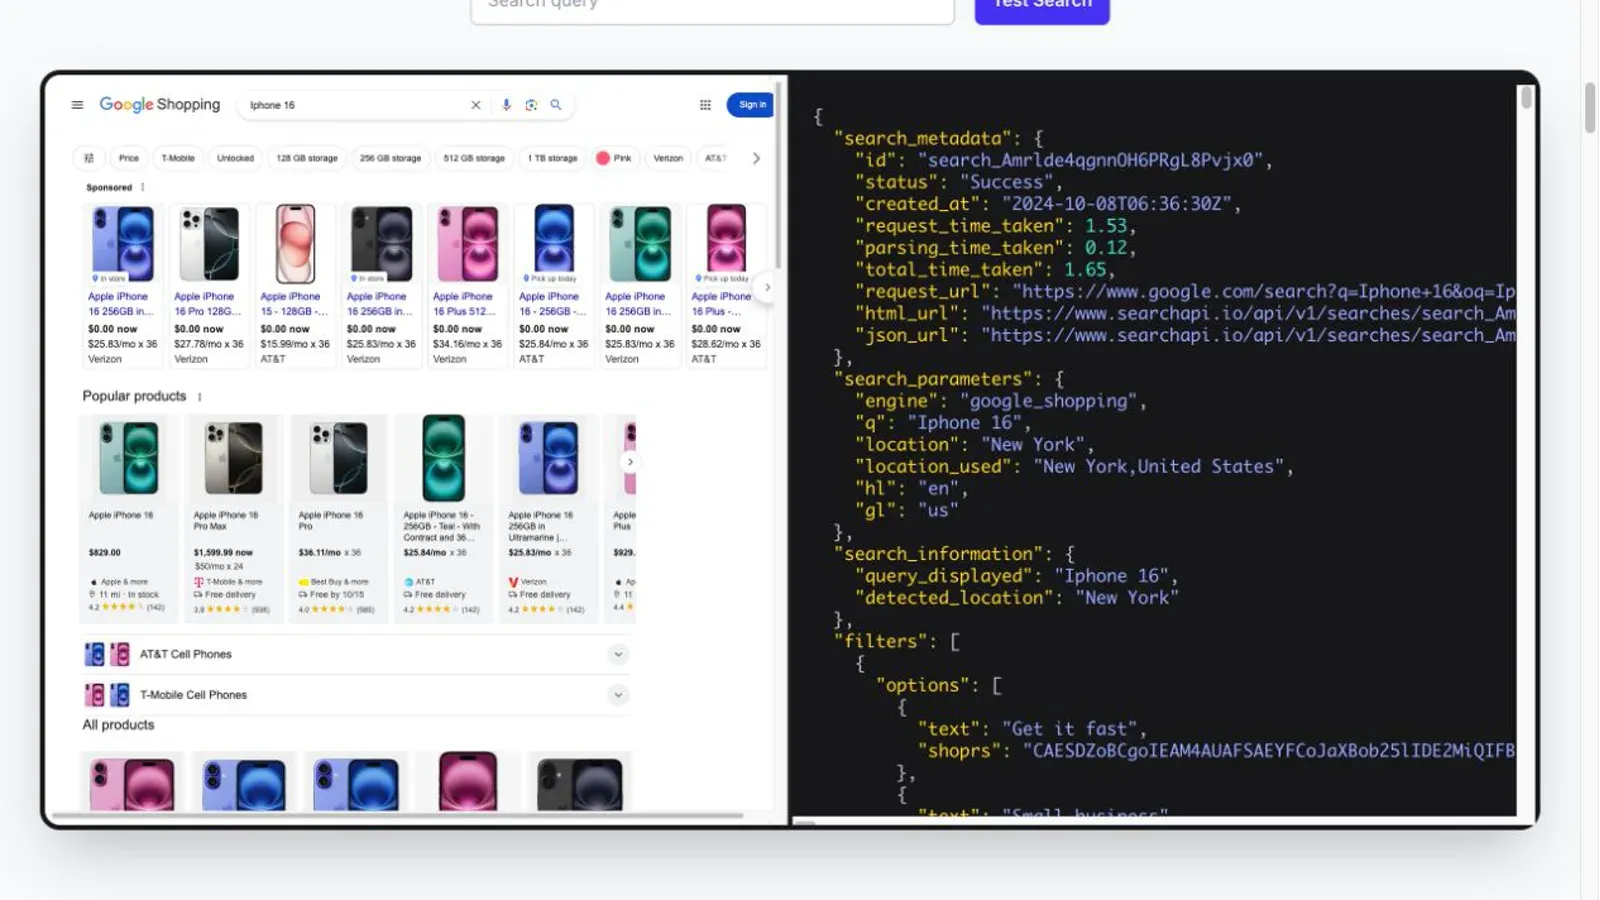
SearchAPI memakai workflow dua langkah yang sangat berguna kalau Anda butuh perbandingan harga di level penjual. Endpoint Shopping mengembalikan field kartu standar plus product_token — dan token itu membuka Product Offers API terpisah yang mengembalikan array offers berisi link merchant, harga, harga pengiriman, total harga, status stok, dan metode pembayaran per penjual. Kalau kebutuhan Anda adalah “tunjukkan semua harga produk ini dari berbagai seller,” ini jalur paling langsung di daftar ini.
Ada satu jebakan penting di sini: per 15 Mei 2026, perubahan dari Google memaksa SearchAPI menggunakan product_token baru untuk setiap request — parameter lama product_id/prds kini menghasilkan error 400 mentah. Kalau Anda mengintegrasikan berdasarkan contoh kode atau tutorial lama, ini akan rusak tanpa terasa sampai Anda menyadarinya.
SearchAPI juga secara eksplisit memperingatkan bahwa filter bahasa alami di dalam query Anda (seperti “di bawah $30” atau “used”) hanyalah petunjuk, bukan filter ketat — Google masih bisa mengembalikan hasil di luar batas itu jika kecocokannya sedikit. Filter shoprs yang dienkode adalah jalur yang benar-benar ketat. Ada juga konflik dokumentasi yang belum selesai dan patut diketahui: SearchAPI memasarkan endpoint ini sebagai “real-time,” tetapi perjanjian pemrosesan datanya sendiri menyatakan bahwa hasil disimpan dalam cache demi performa. Tidak ada TTL publik yang didokumentasikan dalam kedua arah, jadi kalau harga yang bergerak cepat penting bagi Anda, uji dengan query berulang sebelum membangun pipeline di atas asumsi freshness.
Harga (dicek 2026-08-13) dimulai dari $40/bulan untuk tier Developer di $4 per 1.000 pencarian, lalu turun pada volume yang lebih tinggi, dengan batas dokumentasi per jam sebesar 20% dari kredit bulanan Anda.
Cocok untuk: tim yang melakukan perbandingan level seller/offer dan bisa menerima workflow dua request serta menguji freshness sendiri.
4. DataForSEO — Data Merchant dan Shopping Skala Besar, Lewat Queue
DataForSEO benar-benar berbeda dari yang lain di grup ini karena ini bukan API request/response langsung — melainkan queue berbasis task. Anda melakukan POST task dengan keyword, lokasi, dan bahasa, menerima task ID, lalu polling hasilnya atau menyiapkan callback URL. Pengambilan standar saja; tidak ada mode live untuk endpoint Shopping inti, apa pun bahasa marketing umum yang mungkin menyiratkan sebaliknya.
Ini penting karena mengubah cara memandang kompleksitas setup. Tidak sulit, tepatnya, tetapi modelnya berbeda dari “panggil API, dapat JSON” — Anda mengelola status task, dan dokumentasi DataForSEO sendiri menyebut bahwa server callback yang tidak merespons dalam 10 detik akan memindahkan task ke antrean “Tasks Ready” yang kemudian harus Anda polling secara manual.
Alasan ia layak masuk daftar ini adalah riset massal: endpoint Products mengembalikan rank, domain, judul, harga, harga lama, rating, dan jumlah suara, dengan identifier tipe hasil yang secara eksplisit membedakan google_shopping_sponsored_carousel dari google_shopping_paid dan hasil organik — salah satu pemisahan sponsored/organik paling jelas di seluruh daftar ini. Mereka juga secara eksplisit memperingatkan bahwa product_id bersifat dinamis dan bisa null, serta faktor ranking yang dipersonalisasi (riwayat pengguna, preferensi lokasi) sengaja dikeluarkan dari hasil — semacam cek kejujuran yang jarang dilakukan vendor lain.
Harga ditagihkan per blok hasil (40 untuk Products, 10 untuk Sellers/Reviews) dengan kecepatan queue normal hingga 45 menit, atau queue prioritas hingga satu menit dengan harga dua kali lipat. Akun baru mendapat kredit uji coba $1 tanpa masa kedaluwarsa.
Cocok untuk: tim yang nyaman dengan workflow task-based dan butuh data merchant/produk massal secara terjadwal.
5. Bright Data — Tiga Produk dengan Nama yang Sama
Di sini saya perlu melambat, karena Bright Data sebenarnya menawarkan tiga cara berbeda untuk mendapatkan data Google Shopping, dan ketiganya berperilaku sama sekali tidak sama. Ada dataset yang sudah dikumpulkan sebelumnya (dipasarkan dengan lebih dari 7,4 miliar record, dikirim sebagai JSON/CSV/Parquet ke cloud warehouse Anda secara terjadwal), Google Scraper API dengan ID scraper Shopping khusus yang berjalan secara sinkron atau asinkron, dan SERP API yang mengambil URL Shopping live dan mem-parsing hasil secara real time. Menganggap ini satu produk utuh adalah sumber kekeliruan banyak artikel perbandingan — saya tidak akan melakukan itu di sini.
Contoh data dari dataset-nya sendiri menunjukkan nilai null untuk product ID, deskripsi, rating, dan jumlah ulasan pada beberapa record — bukti pertama dari pihak vendor sendiri bahwa “dataset terstruktur” tidak berarti “setiap field selalu terisi.” SERP API mereka secara terpisah mendokumentasikan Product Listing Ads sebagai tipe hasil tersendiri (top_pla, bottom_pla, jackpot_pla) dengan judul, harga, shop, dan rank — pemisahan sponsored-vs-organik yang sangat berguna kalau Anda bekerja khusus dengan SERP API, bukan dataset.
Job asinkron melalui Scraper API bisa mengembalikan status keseluruhan “success” meskipun input tertentu di dalam batch gagal — dokumentasinya secara eksplisit meminta Anda memeriksa field errors dan mengulang item tersebut satu per satu, detail maintenance yang layak dipertimbangkan jika Anda menjalankan batch besar.
Harga (dicek 2026-08-13) sangat bervariasi tergantung surface: dataset menunjukkan $250 untuk 100.000 record sekali beli, SERP API mencantumkan 5.000 request bulanan gratis dengan pay-as-you-go $1,50/1.000, dan Shopping Scraper API khusus mencantumkan tier gratis serta tarifnya sendiri. Jangan anggap angka-angka ini bisa dipertukarkan — cek halaman produk spesifik yang benar-benar Anda pakai.
Cocok untuk: tim enterprise yang ingin satu platform untuk dataset siap pakai sekaligus akses API live, dan bersedia menghitung harga tiap surface secara terpisah.
6. Oxylabs — Rantai Dua Langkah Paling Jelas untuk Search Plus Detail Produk
Oxylabs memecah Shopping menjadi dua target khusus: google_shopping_search untuk hasil level listing, dan google_shopping_product untuk data detail per produk, yang dihubungkan oleh product token. Response pencarian memisahkan dengan rapi pla (paid listing ads) dari produk organic — mungkin pemisahan sponsored/organik paling jelas yang didokumentasikan di seluruh daftar ini — sementara endpoint produk menambahkan offer per seller dengan harga numerik, kondisi, pajak, total harga, dan pengiriman.
Namun ada syarat penting, dan ini benar-benar penting: workflow token ini hanya berjalan jika request pencarian Anda memakai render: "html" dan parse: true sekaligus. Lewatkan salah satunya, Anda tidak akan mendapatkan product token, dan langkah detail produk pun gagal total. Oxylabs juga secara eksplisit memperingatkan bahwa request search dan product harus menggunakan nilai lokalisasi yang identik — jika geo_location berbeda antara dua panggilan, hasil produk bisa tidak lengkap atau salah. Dan jika Anda ingin panel “More stores” dibuka untuk offer seller tambahan, rendering juga harus diaktifkan, yang menambah biaya.
Satu detail yang mudah terlewat: FAQ harga Oxylabs mendefinisikan request yang “successful” dan karenanya ditagihkan sebagai mencakup respons 2xx dan 4xx. Jadi kalau request Anda sendiri salah format, Anda mungkin tetap dikenakan biaya.
Ulasan produk didokumentasikan hanya untuk locale AS, dan locale/language serta locale/results-language memang merupakan kontrol yang terpisah — mengatur salah satunya tidak otomatis mengatur yang lain.
Cocok untuk: tim teknis yang butuh detail level ranking sekaligus detail offer per seller, dan mampu menangani token chaining serta konsistensi locale sebagai bagian dari setup.
7. Scrapingdog — Endpoint Sederhana, Tapi Detail Publiknya Tipis
Scrapingdog menawarkan satu endpoint Google Shopping khusus yang menerima API key dan query, lalu mengembalikan JSON berisi judul, harga dan angka harga hasil ekstraksi, harga lama, rating, ulasan, source/seller, pengiriman, dan posisi. Halaman ini juga menyebut filter berdasarkan harga, brand, negara, dan bahasa, plus kategori respons terpisah untuk “ads” guna melacak listing sponsored — walaupun skema ads yang tepat dan nama parameter pasti untuk filter locale tidak didokumentasikan secara lengkap di halaman publik, jadi sisihkan waktu untuk mengujinya pada use case Anda sendiri sebelum membangun otomatisasi di atasnya.
Ini satu-satunya entri di daftar ini di mana matematika biaya kreditnya memang tidak cukup jelas hanya dari dokumentasi publik: halaman harga Scrapingdog menampilkan alokasi kredit bulanan (LITE $40/bulan untuk 200.000 kredit, STANDARD $90/bulan untuk 1.000.000) tetapi tidak menjelaskan dengan gamblang berapa kredit yang dibutuhkan satu request Google Shopping. Jangan berasumsi 1:1 dengan contoh API pencarian umum mereka — verifikasi langsung ke vendor sebelum Anda menghitung biaya per query yang sebenarnya.
Seperti kebanyakan vendor di sini, Scrapingdog memasarkan rotating residential proxy bawaan dan penanganan CAPTCHA otomatis sebagai sesuatu yang dikelola vendor. Anggap itu sebagai pernyataan batas maintenance, bukan bukti jaminan akses permanen.
Cocok untuk: developer dengan budget terbatas yang ingin endpoint sempit dan khusus, serta bersedia memverifikasi biaya kredit langsung sebelum berkomitmen.
8. Apify — Nilai Actor-nya, Bukan Marketplace-nya
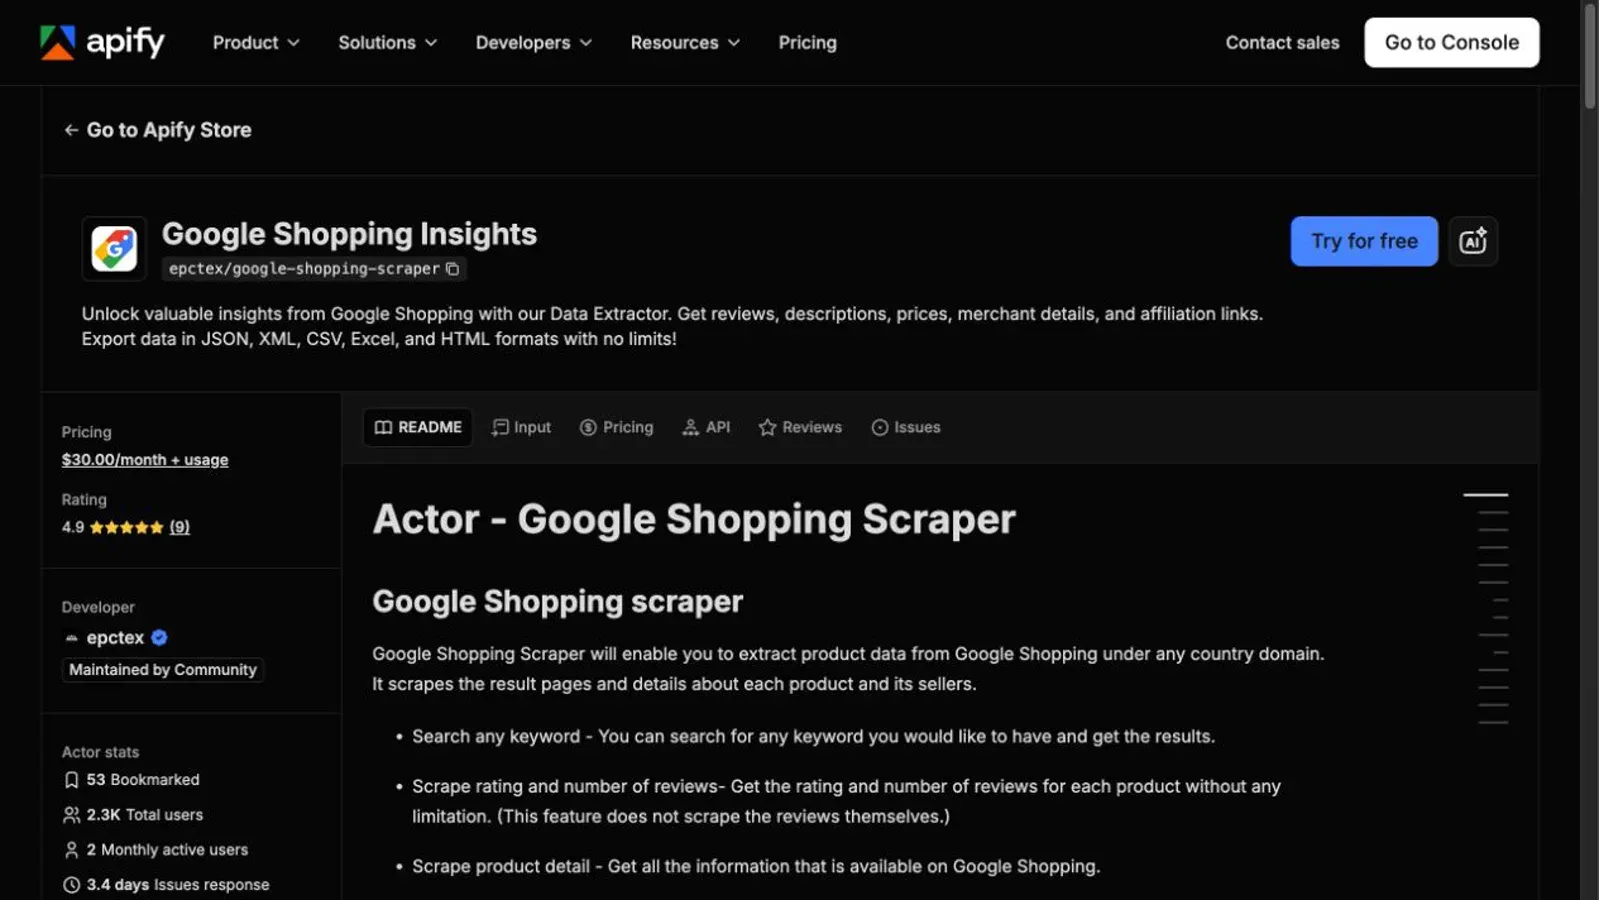
Saya perlu jujur soal satu hal: Apify bukan satu Google Shopping scraper tunggal — ini adalah marketplace berisi “Actors” yang dikelola secara independen, dan yang saya tinjau lebih dekat (Google Shopping Insights, dipublikasikan oleh developer epctex dan diberi label “Maintained by Community”) berperilaku sangat berbeda dari tool milik vendor di atas. Apify menyediakan runtime, infrastruktur proxy, serta tooling dataset/ekspor. Logika ekstraksi Shopping yang sebenarnya — dan maintenance-nya — menjadi tanggung jawab epctex, bukan Apify itu sendiri.
Perbedaan ini penting karena contoh output resmi Actor ini memiliki field price bernilai null. Bukan “kadang-kadang,” bukan “hanya untuk item yang stoknya habis” — record contoh yang didokumentasikan sendiri menunjukkan price: null dan withoutDiscountPrice: null di samping field nama produk, merchant, dan rating yang terisi. Itu bukti pertama dari pihak tool sendiri yang paling kuat di seluruh rangkuman ini bahwa data harga tidak bisa diasumsikan lengkap, dan itu datang langsung dari dokumentasinya.
Anda mendapatkan input yang bisa dikonfigurasi — includeSponsoredResults, includeComparisonPrices untuk harga lintas merchant, target kode negara, maxItemsPerQuery — serta konfigurasi proxy yang wajib (milik Anda sendiri, atau Apify). Hasilnya diekspor sebagai JSON, XML, CSV, atau Excel melalui sistem Dataset Apify. Listing Store yang saya cek menunjukkan sekitar 2.300 total pengguna tetapi hanya 2 monthly active users pada saat itu — metrik yang layak dicatat karena label “community maintained” bisa berarti dua hal: fleksibel, tetapi hanya seandal orang yang aktif memakai dan melaporkan masalahnya.
Cocok untuk: developer yang nyaman mengevaluasi aktivitas maintenance sebuah Actor tertentu dan memeriksa output skemanya sebelum berkomitmen — bukan untuk siapa pun yang mengira brand Apify menjamin perilaku yang konsisten.
9. Thunderbit — Pengumpulan No-Code untuk Marketer
Thunderbit mewakili sisi lain dari daftar ini: workflow browser-based tanpa kode untuk orang-orang yang ingin meninjau halaman yang mereka lihat dan mengubahnya menjadi tabel terstruktur, alih-alih mengintegrasikan Google Shopping API. Itu menjadikannya pilihan paling natural untuk marketer, operator PPC, dan tim ecommerce kecil yang menjalankan pengecekan ad-hoc, bukan pipeline backend ber-volume tinggi.
Yang Anda dapatkan adalah ekstraksi di sisi browser: buka halaman hasil Shopping yang benar-benar Anda butuhkan, biarkan Thunderbit membaca halaman yang dirender hanya dengan satu klik, lalu ekspor field-nya langsung ke Excel, Google Sheets, Airtable, atau Notion. Ada satu catatan penting, tetapi ini berlaku untuk Shopping secara umum, bukan untuk satu tool tertentu — karena ekstraksi berjalan pada halaman yang sedang Anda lihat, hasilnya mewarisi lokasi, bahasa, dan sesi browser tersebut. Kunci pengaturan itu sebelum Anda menganggap data minggu ini sebanding dengan data minggu lalu. Itulah masalah reliabilitas field yang dibahas di bagian berikutnya, dan ini berlaku untuk semua opsi di daftar ini.
Cocok untuk: tim non-teknis yang lebih menghargai ekstraksi browser yang terlihat dan bisa ditinjau daripada pipeline JSON yang dikelola developer — dan yang mengambil halaman Shopping tertentu sesuai kebutuhan, bukan crawl multi-geo ber-volume tinggi.
Data Apa yang Benar-Benar Bisa Dipercaya? Masalah Reliabilitas Field
Ini bagian yang hampir selalu dilewati artikel perbandingan Google Shopping, padahal ini justru hal paling penting untuk dipahami sebelum Anda mengotomatiskan apa pun: tidak semua field muncul di setiap listing, dan menganggap yang “hilang” sebagai “nol” akan diam-diam merusak data Anda.
| Field | Reliabilitas | Catatannya |
|---|---|---|
| Judul | Tinggi | Normalisasi variasi/bundel sebelum mencocokkan produk lintas sumber |
| Product ID | Bersyarat | DataForSEO secara eksplisit mendokumentasikan ini sebagai dinamis dan kadang null |
| Harga | Bersyarat | Contoh resmi Apify sendiri menampilkan harga null pada record yang sepenuhnya terisi |
| Seller/merchant | Biasanya ada | Listing multi-seller berarti satu produk bisa punya beberapa offer terpisah |
| Rating/jumlah ulasan | Bersyarat | Produk baru atau yang belum diberi rating bisa saja tidak menampilkannya — jangan dipaksa jadi nol |
| Pengiriman/delivery | Tidak konsisten | Bisa bergantung pada tujuan, stok penjual, dan sesi |
| Sponsored flag | Tergantung tool | Oxylabs memisahkan pla dari organic dengan jelas; beberapa lainnya memungkinkan Anda memasukkan/mengecualikan hasil sponsored tanpa memberi label per baris yang andal |
Aturan praktisnya: sebelum mengotomatiskan workflow apa pun, ambil sampel nyata dengan keyword yang Anda pakai sungguhan dan cek apa yang benar-benar null, terduplikasi, atau hilang — bukan apa yang seharusnya ada menurut dokumentasi.
Google Merchant Center Resmi vs Google Shopping Scraper: Mana yang Anda Butuhkan?
Ini pertanyaan yang sering diajukan tim ecommerce bahkan sebelum mereka mulai membandingkan vendor, dan jawabannya layak dibuat tegas: jika Anda mengelola listing produk, pricing, atau iklan Shopping Anda sendiri, itu tugas untuk tool resmi Google Merchant Center — bukan scraper pihak ketiga. Tool scraping di daftar ini dipakai untuk mengamati listing milik orang lain: harga kompetitor, visibilitas pasar, riset kategori, pemantauan placement sponsor. Jangan tertukar. Cek dokumentasi resmi Google yang paling baru secara langsung untuk nama dan cakupan API first-party mereka saat ini, karena hal-hal seperti ini kadang berganti nama dan struktur secara berkala.
Bagaimana Tool Ini Menangani Pertahanan Anti-Bot Google
Saya akan membingkai ini sebagai pertanyaan tata kelola, bukan tutorial “cara mengalahkan Google”, karena itulah cara paling jujur memikirkannya. Beberapa vendor di sini — SerpApi, SearchAPI, Bright Data, Oxylabs, Scrapingdog — secara publik menyatakan bahwa mereka mengelola rotasi proxy, rendering browser, dan penanganan CAPTCHA di sisi mereka. Itu batas maintenance yang nyata dan patut dihargai: artinya Anda bukan pihak yang harus mengutak-atik IP yang diblokir jam 2 pagi. Itu bukan, dan tidak boleh dibaca sebagai, jaminan akses permanen atau universal.
Yang tidak hilang bahkan dengan vendor yang sepenuhnya dikelola: kontrol rate dan pengeluaran, klasifikasi error, retry, dan monitoring saat Google mengubah sesuatu (yang, berdasarkan changelog yang saya temukan untuk SearchAPI dan Oxylabs, terjadi cukup rutin). Bright Data mendokumentasikan kegagalan sebagian batch secara eksplisit; DataForSEO mendokumentasikan perilaku timeout callback; Oxylabs mendokumentasikan kegagalan token tidak valid. Semua ini bukan instruksi untuk melewati apa pun — ini adalah penjelasan jujur soal siapa yang bertanggung jawab atas mode kegagalan yang mana.
Cara Memilih Google Shopping Scraper Terbaik untuk Tim Anda
Ikuti langkah berikut secara berurutan:
- Tentukan persona Anda. Apakah Anda developer yang membangun pipeline, atau marketer/ops yang ingin hasil tanpa menyentuh kode?
- Definisikan field yang benar-benar Anda butuhkan. Data level ranking berbeda dari detail pricing di level merchant/offer — SearchAPI dan Oxylabs layak masuk justru karena yang terakhir.
- Jujurlah soal kapasitas maintenance Anda. Mapping API dan penanganan error, konfigurasi Actor dan setup proxy, atau ekstraksi berbasis halaman yang sudah ditinjau — pilih yang benar-benar bisa dikelola tim Anda dalam jangka panjang.
- Uji perilaku locale/device dengan query nyata sebelum berkomitmen pada vendor, karena dokumentasi publik tidak selalu persis sama dengan perilaku live.
- Validasi jalur ekspor agar cocok dengan stack yang sudah ada — dump JSON ke data warehouse itu jauh berbeda dari spreadsheet yang bisa langsung dibuka marketer.
Kesimpulan: Google Shopping Scraper Mana yang Sebaiknya Anda Pakai?
Tidak ada satu jawaban “terbaik” di sini, dan kalau ada listicle yang bilang sebaliknya, Anda patut skeptis. Jika Anda developer yang membangun pipeline data dan ingin skema terdokumentasi paling kaya dengan kontrol cache dan locale yang jelas, mulai dari SerpApi. Jika tujuan Anda benar-benar perbandingan harga per seller pada level offer, workflow token chaining dari SearchAPI atau Oxylabs membawa Anda ke sana lebih langsung. Jika Anda menjalankan riset bulk terjadwal dan bisa menerima queue task, DataForSEO sangat cocok untuk skala besar. Jika Anda ingin satu platform enterprise untuk dataset siap pakai sekaligus query live, Bright Data mencakup area paling luas — hanya saja harga tiap surface harus dihitung terpisah.
Dan jika Anda berada di tim PPC atau marketing yang tidak ingin menyentuh API key, kategori browser-based yang diwakili Thunderbit adalah jawaban langsung untuk “saya cuma butuh datanya, bukan proyek coding.” Yang penting, pahami dulu surface mana yang Anda pilih: workflow browser dirancang untuk halaman yang Anda buka dan tinjau sendiri, sedangkan dokumentasi API Thunderbit dan CLI adalah jalur terpisah yang lebih berorientasi developer. Pilih yang sesuai dengan cara kerja tim Anda yang sebenarnya.
Apa pun pilihannya, ambil sampel nyata dulu. Setiap vendor di sini mendokumentasikan setidaknya satu field yang tidak selalu ada — cek milik Anda sebelum membangun apa pun di atasnya.
FAQ
Apakah legal melakukan scraping data Google Shopping?
Ini bukan pertanyaan yang bisa saya jawab secara mutlak, dan tidak seharusnya ada listicle yang mengklaim bisa menjawabnya. Data yang terlihat publik dan klaim kepatuhan vendor tidak otomatis membuat semua penggunaan menjadi legal. Sebelum membangun apa pun, cek syarat layanan Google yang terbaru, tinjau hukum yang berlaku di yurisdiksi Anda, dan pastikan metode pengumpulan data yang Anda gunakan memang diizinkan. Anggap ini sebagai situasi “silakan verifikasi dengan penasihat hukum Anda sendiri”, bukan sesuatu yang bisa diselesaikan oleh sebuah artikel blog.
Apa bedanya SERP API dan Google Shopping scraper?
SERP atau Shopping API menerima parameter request yang terstruktur lalu mengembalikan JSON yang sudah diparse — vendor menangani sebagian besar infrastruktur pengambilannya. Scraper berbasis browser (seperti Thunderbit) mengekstrak dari halaman yang benar-benar Anda atau pengguna buka. Produk dataset (seperti sebagian penawaran Bright Data) mengirim record yang sudah dikumpulkan sebelumnya secara terjadwal, bukan request live. Tujuannya memang tumpang tindih, tetapi berbeda besar dalam hal freshness, kontrol locale, dan seberapa banyak maintenance yang benar-benar ada di tangan Anda.
Apakah saya perlu skill coding untuk scraping Google Shopping?
Tidak selalu. Seluruh pendekatan Thunderbit memang no-code dan berbasis klik. Apify secara teknis bisa dijalankan lewat web UI tanpa menulis kode, meski untuk kustomisasi yang serius tetap lebih nyaman jika Anda punya sedikit kemampuan teknis. Setiap tool berbasis API di daftar ini — SerpApi, Serper, SearchAPI, DataForSEO, Bright Data, Oxylabs, Scrapingdog — membutuhkan setidaknya kemampuan developer dasar: autentikasi, penanganan parameter, dan pengecekan error.
Seberapa sering data Google Shopping berubah?
Lebih sering daripada yang banyak orang kira, tetapi tidak ada aturan universal seperti “update setiap X jam” yang bisa Anda andalkan. Harga, stok, placement sponsored, dan ranking bisa berubah tergantung sesi, locale, dan waktu. Beberapa vendor di sini menawarkan mode live/real-time justru karena data cache cepat basi di kategori ini. Jika keputusan Anda bergantung pada harga terkini, jalankan query ulang, jangan percaya hasil kemarin.
Pelajari Lebih Lanjut




