
Saya perlu memantau lebih dari 200 sumber berita untuk menemukan artikel yang lagi tren. Kalau dilakukan manual? Itu sama saja seperti kerja full-time. Kalau pakai scraper tradisional? Alatnya sering bermasalah setiap kali situs mengubah tata letaknya.
Lalu saya coba AI article scraper. Sekali klik, datanya langsung rapi tanpa perlu CSS selector. Bedanya benar-benar jauh.
Kalau Anda jurnalis, ahli SEO, atau peneliti yang perlu mengambil artikel dalam skala besar, perbandingan ini bisa menghemat banyak waktu buat coba-coba. Saya sudah menguji scraper no-code tradisional dan yang berbasis AI — ini hasil yang benar-benar bisa dipakai.
Ambil data dari situs apa pun dengan AI Get Started Free
Ringkasan Singkat
| Kelebihan | Kekurangan | Paling Cocok Untuk | |
|---|---|---|---|
| AI Article Scraper | - Bisa mengambil data dari banyak situs dengan akurasi tinggi - Otomatis membersihkan noise - Menyesuaikan diri saat struktur web berubah - Mendukung konten yang dimuat secara dinamis - Biaya pembersihan data rendah | - Biaya komputasi lebih tinggi - Waktu pemrosesan lebih lama - Beberapa halaman mungkin perlu intervensi manual - Bisa memicu mekanisme anti-scraping | - Mengambil data dari situs dengan konten kompleks atau dinamis (misalnya portal berita, media sosial) - Pengumpulan data skala besar |
| Traditional No-code Article Scraper | - Eksekusi cepat - Biaya lebih rendah - Penggunaan resource server dan lokal rendah - Kontrol tinggi | - Perlu sering dipelihara karena perubahan struktur web - Tidak bisa mengambil data dari banyak situs sekaligus - Tidak bisa menangani konten dinamis - Biaya pembersihan data tinggi | - Scraping cepat skala besar untuk halaman web statis yang sederhana - Keterbatasan resource komputasi, anggaran terbatas |
Apa Itu Article Scraper? Kenapa AI Article Scraper Penting?
Article scraper adalah jenis web scraper yang bisa menemukan dan mengambil informasi seperti judul, penulis, tanggal terbit, isi artikel, kata kunci, gambar, dan video dari situs berita, lalu menyusunnya ke dalam format terstruktur seperti JSON, CSV, atau Excel.
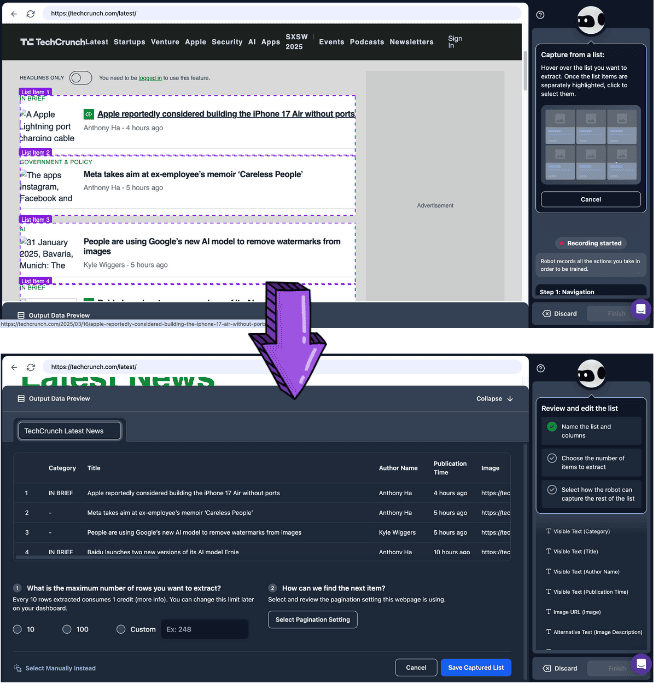
Traditional no-code article scrapers mengandalkan CSS selector untuk mengekstrak konten berdasarkan struktur HTML halaman. Tapi, pendekatan ini punya beberapa kelemahan:
- Tidak Universal: Setiap struktur web butuh CSS selector yang spesifik untuk tiap situs, dan kalau struktur web berubah, alat ini bisa langsung tidak efektif sehingga harus sering diperbarui.
- Tidak Mampu Menangani Konten Dinamis: Banyak situs memakai AJAX atau JavaScript untuk memuat konten, dan hal ini tidak bisa diambil langsung oleh CSS selector.
- Pemrosesan Data Terbatas: CSS selector hanya bisa mengambil potongan HTML tanpa pembersihan data lanjutan, pemformatan, analisis semantik, atau analisis sentimen.
 Masuklah ke AI article scraper.
-
Teknologi ini menggunakan LLM untuk memahami halaman web, sehingga menawarkan:
- Pengenalan Cerdas: Mengenali judul, penulis, ringkasan, dan isi utama.
- Penghapusan Noise Otomatis: Membedakan konten utama dari navigasi, iklan, dan artikel terkait, sehingga kualitas data dan efisiensi scraping meningkat.
- Adaptif terhadap Perubahan Web: Bahkan kalau struktur atau gaya web berubah, AI tetap bisa melakukan scraping lewat pemahaman semantik dan fitur visual.
- Lintas Situs yang Lebih Fleksibel: Berbeda dari traditional scrapers, AI scraper bisa dipakai di berbagai situs tanpa penyesuaian manual.
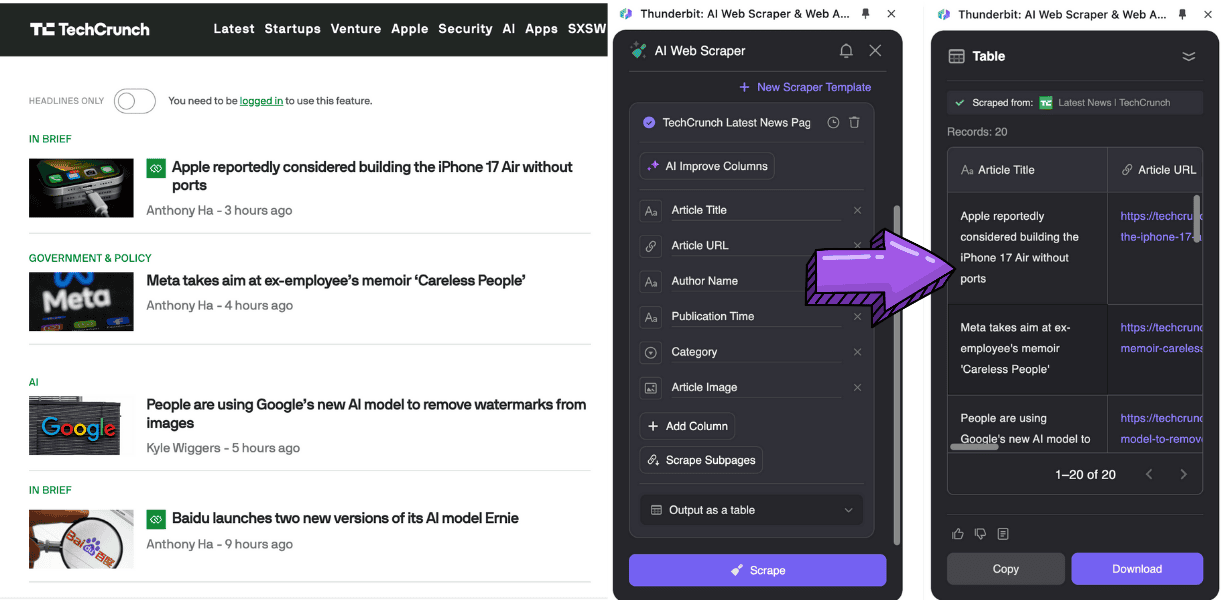
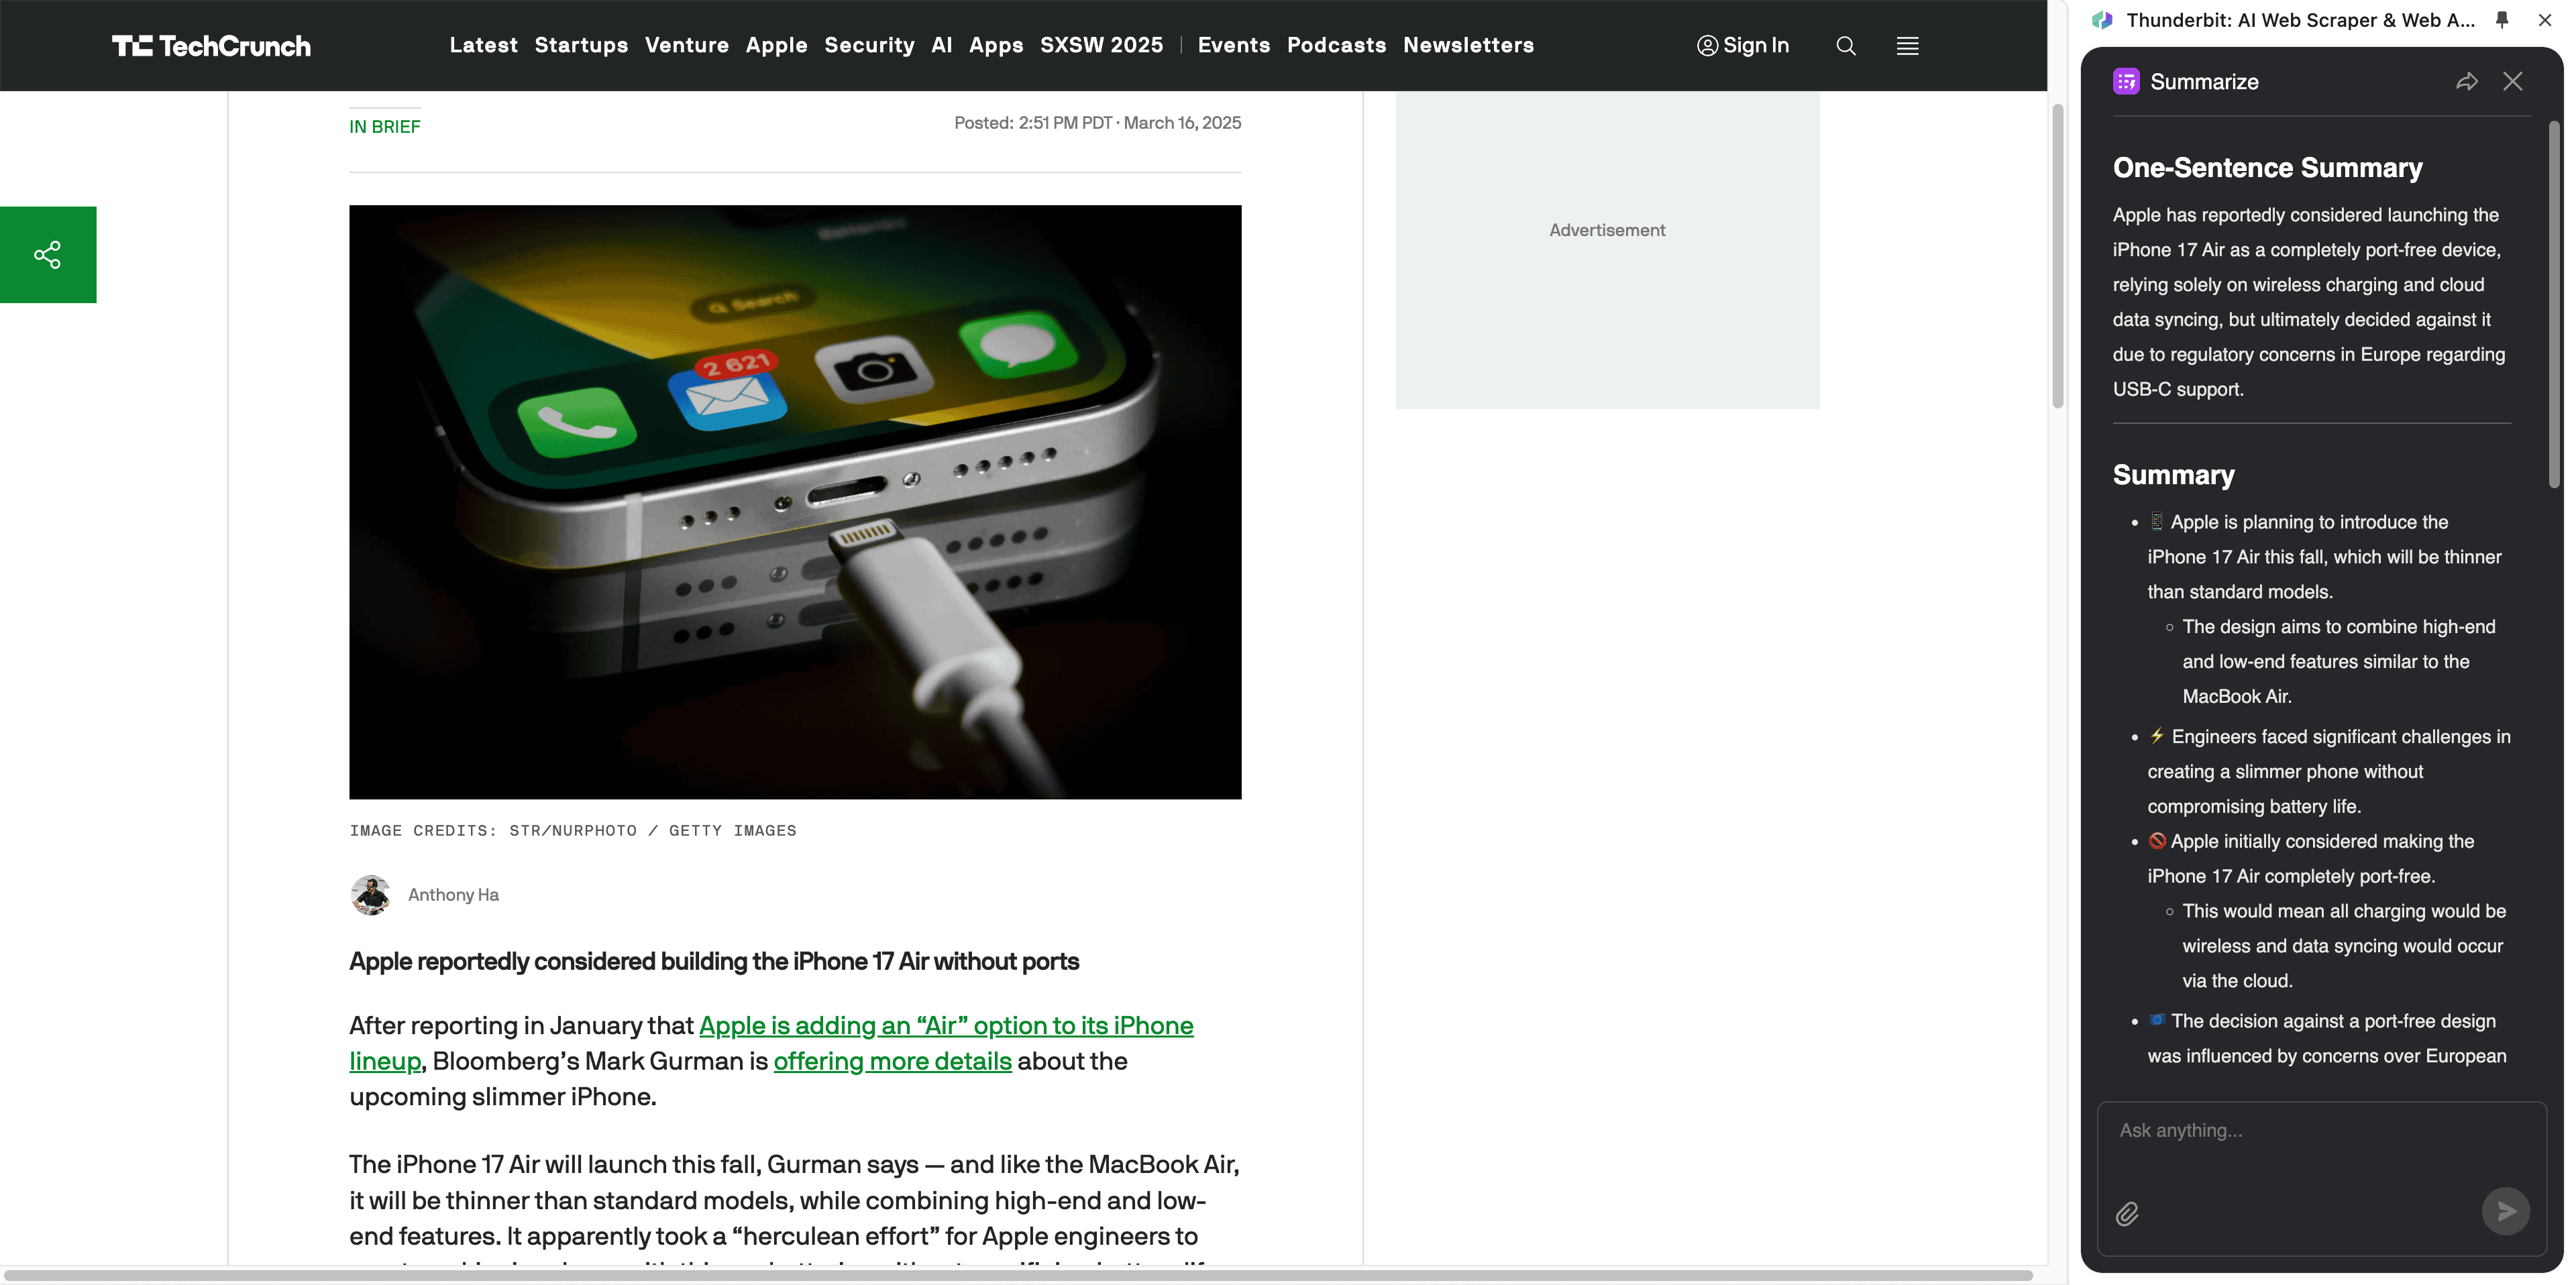
- Terintegrasi dengan NLP dan Deep Learning: Menyelesaikan tugas seperti terjemahan, ringkasan, dan analisis sentimen.
Apa yang Membuat Article Scraper Terbaik di 2026?
Article scraper terbaik harus bisa menyeimbangkan performa, biaya, kemudahan penggunaan, fleksibilitas, dan skalabilitas. Berikut kriteria memilih article scraper terbaik di 2026:
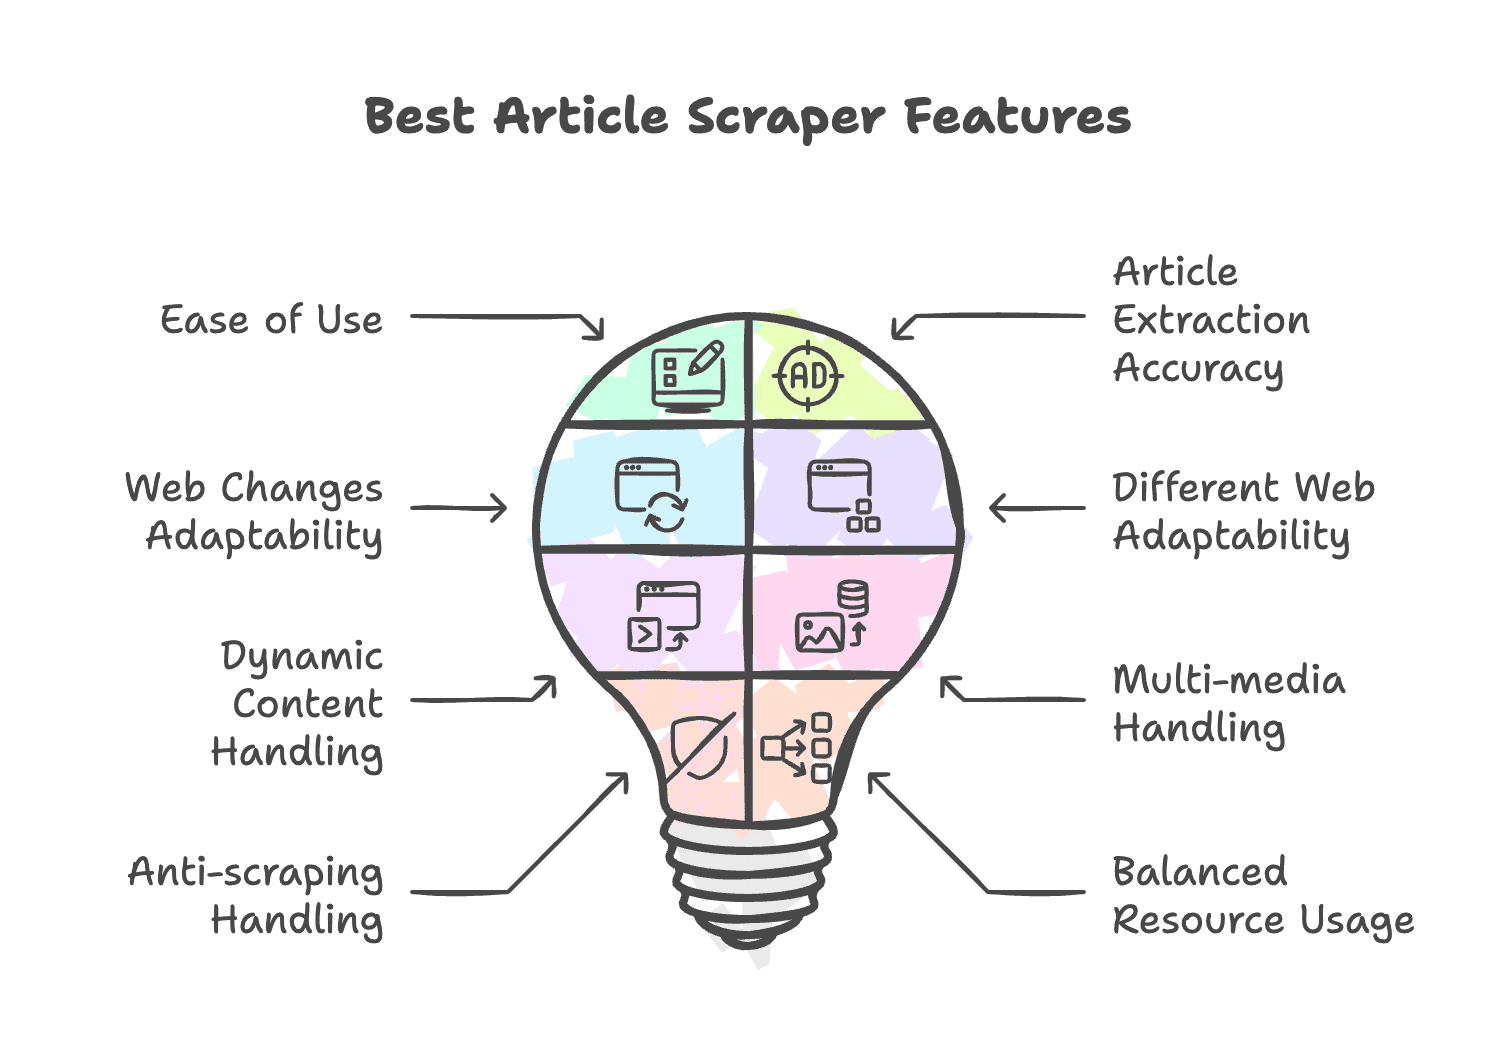
- Mudah Digunakan: Antarmuka intuitif, tanpa perlu coding.
- Akurasi Ekstraksi Artikel: Mampu mengidentifikasi informasi relevan dengan tepat tanpa iklan atau menu navigasi.
- Adaptif terhadap Perubahan Web: Otomatis menyesuaikan diri saat struktur atau gaya web berubah tanpa perlu sering dipelihara.
- Kompatibel di Berbagai Web: Bisa bekerja di beragam struktur situs.
- Mampu Menangani Konten Dinamis: Mendukung pemuatan konten dinamis via JavaScript atau AJAX.
- Mampu Menangani Multi-media: Mengenali gambar, video, dan audio.
- Mampu Mengatasi Anti-Scraping: Menggunakan rotasi IP, solusi CAPTCHA, dan proxy untuk melewati mekanisme anti-scraping.
- Penggunaan Resource Seimbang: Tidak boros memori dan daya komputasi.
Gambaran Cepat Article & News Scraper Terbaik
| Tools | Fitur Utama | Paling Cocok Untuk | Harga |
|---|---|---|---|
| Thunderbit | AI-powered scraper; template siap pakai; dukungan scraping pdf, image, & docs; kemampuan pemrosesan data tingkat lanjut | Pengguna non-teknis yang perlu scraping dari banyak situs niche | Gratis uji coba 7 hari, mulai dari $9/bulan (paket tahunan) |
| WebScraper.io | Ekstensi browser; dukungan konten dinamis; termasuk integrasi proxy | Pengguna yang tidak berurusan dengan halaman web yang kompleks atau fitur tingkat lanjut | Gratis uji coba 7 hari, mulai dari $50/bulan (paket tahunan) |
| Browse.ai | Web scraper dan monitor no-code; robot siap pakai; virtual browser; berbagai metode pagination; integrasi yang kuat | Perusahaan yang membutuhkan scraping situs kompleks dalam skala besar | $19/bulan (paket tahunan) |
| Octoparse | Scraper no-code berbasis CSS selector; auto-detect dan pembuatan workflow scraping otomatis; template article scraper siap pakai; virtual browser; mekanisme anti-anti scraping | Bisnis yang membutuhkan scraping situs kompleks | Mulai dari $58.44/bulan (paket tahunan) |
| Bardeen | Kemampuan otomatisasi web yang komprehensif; template siap pakai; scraper no-code; integrasi mulus dengan workspace | Tim GTM yang ingin menyisipkan scraping artikel ke workflow yang sudah ada | Mulai dari $10/bulan (Basic); termasuk 100 kredit/bulan, tanpa free trial |
| Ultimate Web Scraper | UI ramah pengguna; deteksi dan pelabelan otomatis | Pengguna yang butuh ekstraksi cepat satu klik tanpa setup rumit | Ekstraksi lokal gratis; cloud mulai dari $60/tahun (Pro) |
AI Article Scraper Terkuat untuk Pengguna Bisnis
- Kelebihan:
- Memakai bahasa alami untuk memanggil AI dalam mengenali dan menganalisis informasi web, jadi CSS selector tidak diperlukan
- Analisis data berbasis AI, termasuk konversi format, ringkasan, klasifikasi, terjemahan, dan tagging
- Template artikel siap pakai untuk mengambil daftar artikel dan isi artikel hanya dengan satu klik
- Harga terjangkau dengan nilai ekonomis tinggi
- Kekurangan:
- Saat ini hanya tersedia sebagai ekstensi Chrome
- Tidak cocok untuk scraping data skala sangat besar
- Kecepatan scraping multi-halaman lebih lambat, tetapi bisa berjalan di latar belakang agar hasil lebih cepat
Coba Thunderbit AI Article Scraper
Article Scraper Berbasis AI untuk Kebutuhan Enterprise
Browse.ai
- Kelebihan:
- Article scraper dan monitor no-code
- Mendukung operasi virtual browser untuk menghindari pemicu mekanisme anti-scraping
- Banyak robot scraping artikel siap pakai untuk scraping satu klik dari Google News, Medium, Hacker News, dan lainnya
- Integrasi mendalam dengan platform seperti Zapier dan Make untuk menghubungkan tool
- Kekurangan:
- Menggunakan deep extract perlu membuat dua robot, sehingga prosesnya lebih rumit
- CSS selector kurang presisi untuk situs niche
- Mahal, lebih cocok untuk tugas scraping berkelanjutan dalam skala besar
Scraper No-Code untuk Ekstraksi Data Skala Kecil
Ultimate Web Scraper
- Kelebihan:
- Secara otomatis mengenali daftar artikel dan detailnya dengan antarmuka yang ramah pengguna
- Bisa mengekstrak daftar, detail, email, dan gambar, cocok untuk scraping data terstruktur skala kecil
- Harga tahunan terjangkau, mulai dari $60/tahun (Pro)
- Kekurangan:
- Hanya tersedia sebagai ekstensi browser, tidak bisa berjalan di cloud
- Versi gratis hanya mendukung copy, bukan ekspor ke CSV, JSON, dll.
Article Scraper Siap Pakai untuk Organisasi
Octoparse
- Kelebihan:
- Article scraper no-code dengan auto-detect untuk mengenali struktur web dan membuat workflow scraping
- Banyak template article scraper siap pakai
- Menggunakan virtual browser dengan rotasi IP, solusi CAPTCHA, dan proxy untuk melewati mekanisme anti-scraping
- Kekurangan:
- Auto-detect masih bergantung pada logika CSS selector, dengan akurasi rata-rata
- Fitur lanjutan memerlukan pembelajaran dan skill teknis
- Biaya tinggi untuk scraping data skala besar
Otomatisasi Paling Lengkap untuk Tim GTM
Bardeen
- Kelebihan:
- Article scraper no-code yang memakai LLM untuk otomatisasi satu klik
- Terintegrasi dengan lebih dari 100 aplikasi, termasuk Google Sheets, Slack, dan Zoom
- Tool otomasi web yang kuat untuk analisis AI setelah data di-scraping
- Ideal untuk menyisipkan scraping data ke workflow yang sudah ada
- Kekurangan:
- Sangat bergantung pada playbook siap pakai; workflow kustom perlu uji-coba berulang
- Meski no-code, memahami dan menyiapkan otomasi kompleks tetap bisa butuh waktu belajar bagi pengguna non-teknis
- Setup ekstraksi subpage cukup rumit
- Sangat mahal
Article Scraper Ringan untuk Ekstraksi Data Instan
Webscraper.io
- Kelebihan:
- Scraper no-code dengan antarmuka point-and-click
- Mendukung pemuatan konten dinamis
- Beroperasi berbasis cloud
- Terintegrasi dengan Dropbox, Google Sheets, dan Amazon
- Kekurangan:
- Tidak ada template siap pakai, perlu membuat sitemap kustom
- Ada kurva belajar bagi pengguna yang belum familiar dengan CSS selector
- Setup pagination dan ekstraksi subpage cukup kompleks
- Versi cloud mahal
Solusi Lebih Lanjut untuk Engineer
Bagi yang punya latar belakang teknis, tersedia API article scraper. Solusi ini menawarkan:
- Fleksibilitas: Panggilan API langsung untuk scraping kustom, mendukung rendering dinamis dan rotasi IP
- Skalabilitas: Bisa diintegrasikan ke pipeline data kustom untuk kebutuhan enterprise dengan frekuensi tinggi dan skala besar
- Biaya Pemeliharaan Rendah: Tidak perlu mengelola pool proxy atau strategi anti-scraping, sehingga menghemat waktu operasional
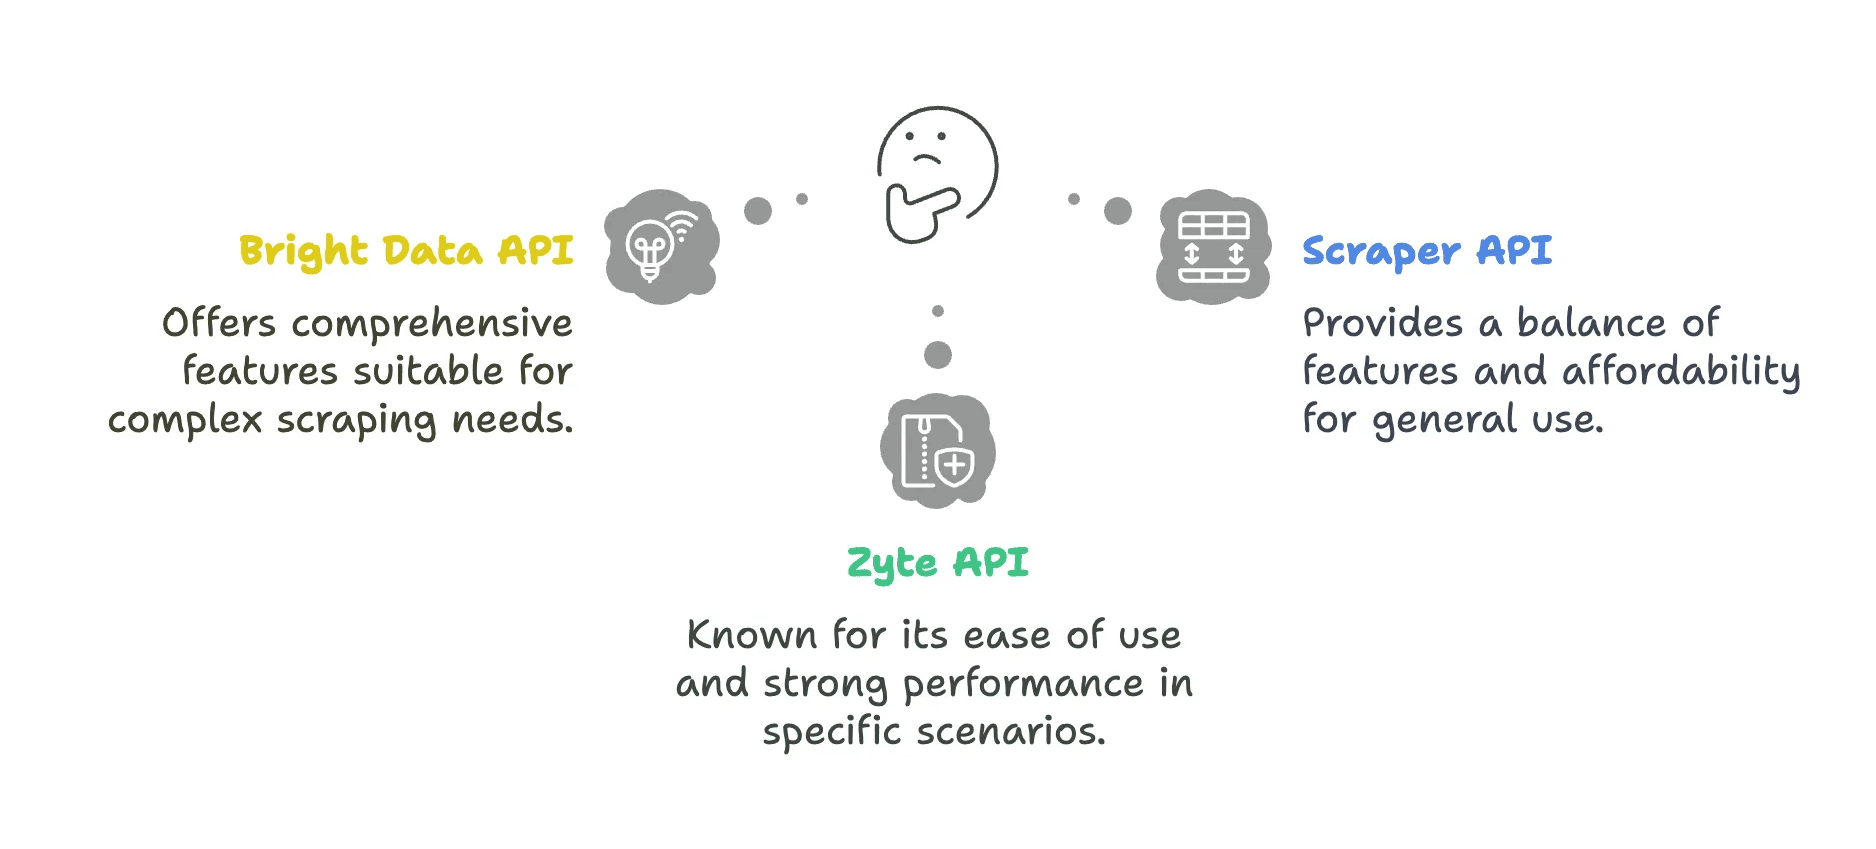
Gambaran Singkat Solusi API
| API | Kelebihan | Kekurangan |
|---|---|---|
| Bright Data API | - Jaringan proxy sangat luas (72M+ IP di 195 negara) - Geo-targeting canggih hingga level kota/ZIP - Proxy Manager tangguh untuk rotasi IP | - Waktu respons lebih lambat (rata-rata 22,08 detik) - Harga lebih tinggi, kurang cocok untuk tim kecil - Kurva belajar konfigurasi lebih curam |
| ScraperAPI | - Harga awal lebih rendah, mulai $49 - Fitur autoparse untuk ekstraksi data otomatis - Web UI player untuk pengujian | - Sering mengenakan biaya untuk request yang diblokir - Fitur rendering JavaScript terbatas - Biaya bisa membengkak dengan parameter premium |
| Zyte API | - Kemampuan parsing berbasis AI - Tidak mengenakan biaya untuk request yang gagal | - Biaya awal lebih tinggi (~$100/bulan) - Kredit tidak dibawa ke bulan berikutnya |
- Bright Data Web Scraper API
- Kelebihan:
- Kekurangan:
- Biaya tinggi (ditagih per request dan bandwidth), kurang hemat untuk proyek kecil
- Scraper API
- Kelebihan:
- 40M proxy global, pergantian otomatis IP data center/residential, bisa melewati verifikasi Cloudflare, serta terintegrasi dengan solusi CAPTCHA pihak ketiga (misalnya 2Captcha)
- Endpoint terstruktur dan scraper asinkron untuk kecepatan scraping yang lebih tinggi
- Kekurangan:
- Biaya tambahan untuk rendering halaman dinamis, dukungan terbatas untuk situs AJAX yang kompleks
- Kelebihan:
- Zyte API
- Kelebihan:
- Ekstraksi data web otomatis berbasis AI, tidak perlu membuat dan memelihara aturan ekstraksi untuk tiap situs
- Harga pay-as-you-go yang fleksibel
- Kekurangan:
- Fitur lanjutan (misalnya session handling, browser yang bisa di-scripting) memerlukan pembelajaran
- Kelebihan:
Bagaimana Memilih Article & News Scraper?
Saat memilih article & news scraper, pertimbangkan kebutuhan bisnis, latar belakang teknis, dan anggaran Anda.
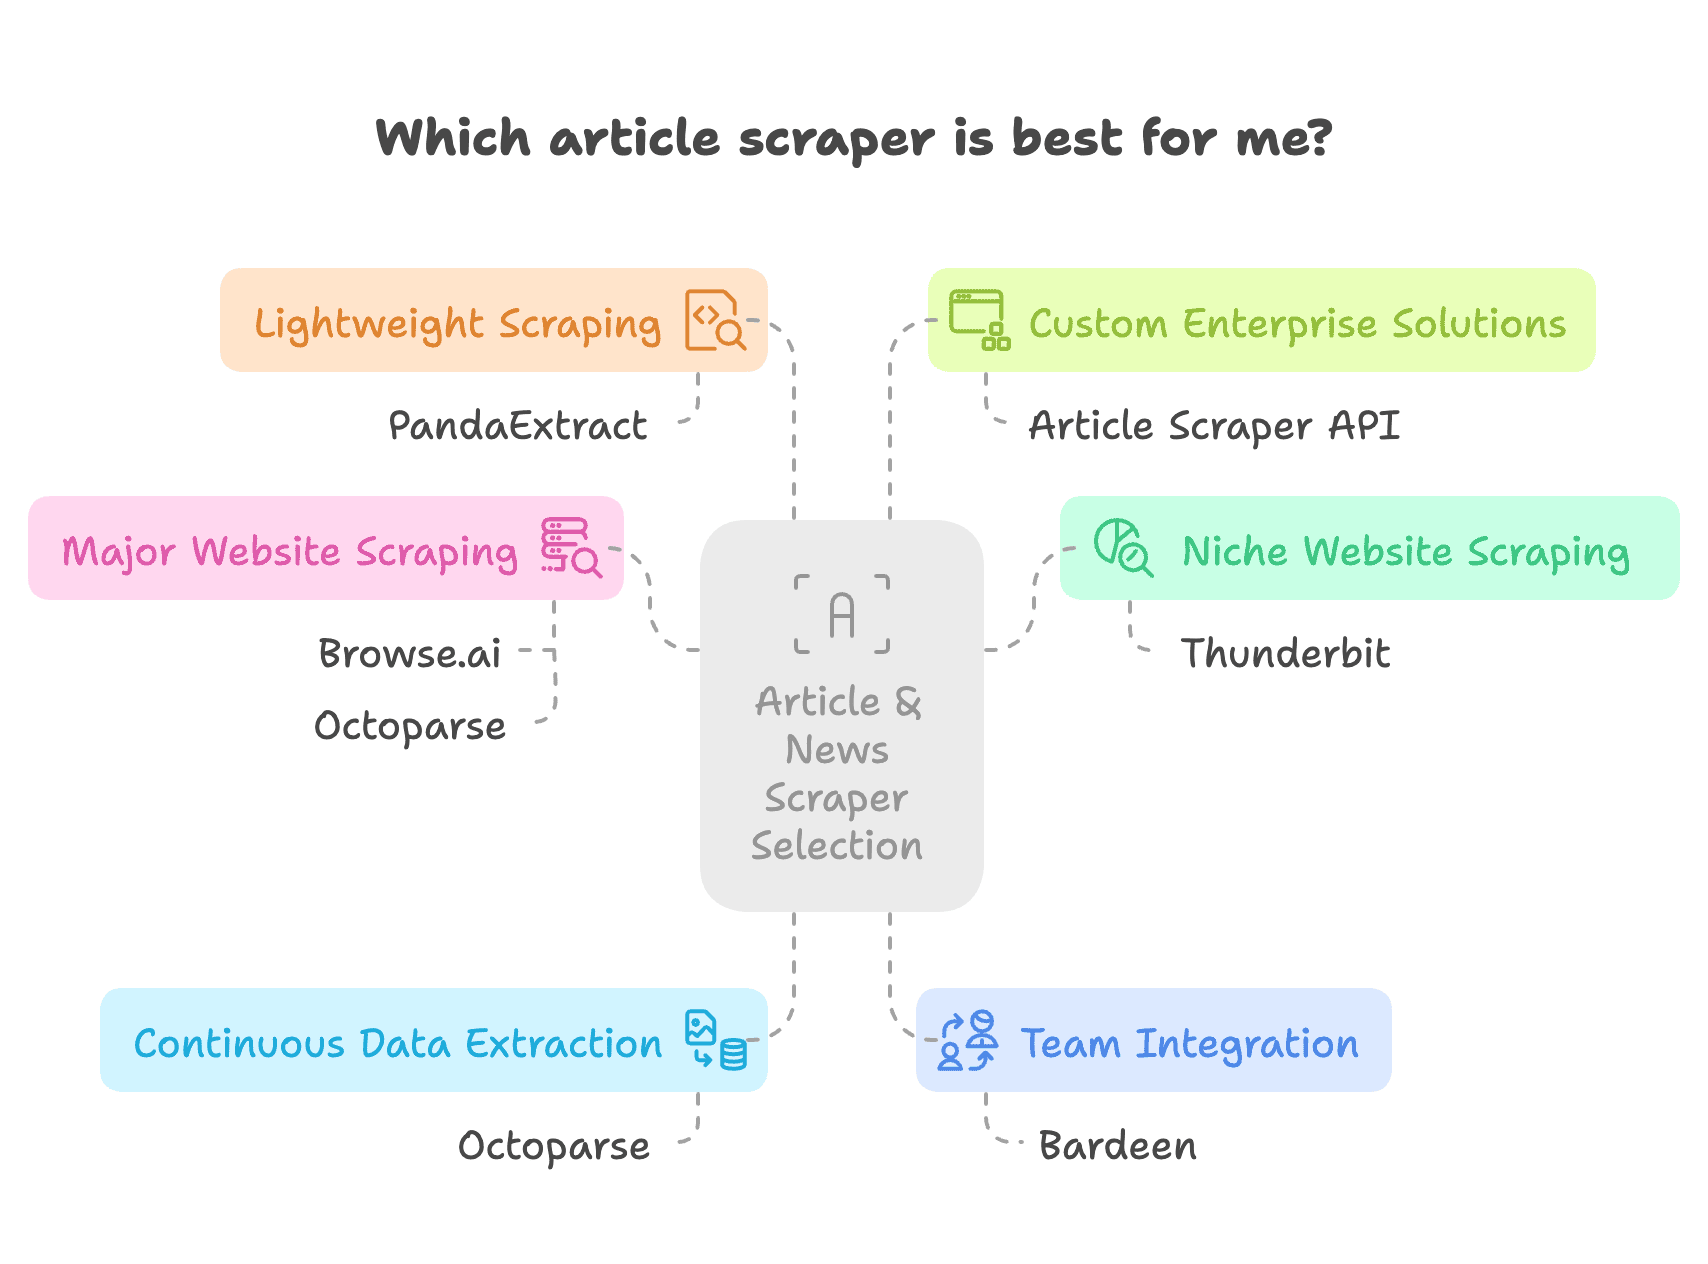
- Kalau Anda perlu scraping banyak situs niche tanpa harus membangun scraper untuk tiap halaman dan punya anggaran, Thunderbit adalah pilihan terbaik. Thunderbit tidak bergantung pada CSS selector, melainkan memakai AI untuk menganalisis struktur web, sekaligus memungkinkan analisis AI setelah data diambil. Bagi Thunderbit AI, semua situs diperlakukan sama, jadi artikel lengkap bisa ditangkap dengan akurat.
- Untuk scraping berita dan artikel dari situs besar seperti Wall Street Journal atau Google News, Anda butuh article scraper dengan mekanisme anti-scraping yang kuat dan template siap pakai, seperti Browse.ai atau Octoparse. Namun, opsi terbaik adalah Chrome Extension seperti Thunderbit: proses scraping meniru cara browsing dan copy manual, sehingga login tetap bisa dipakai tanpa setup yang ribet.
- Kalau Anda butuh scraping data berkelanjutan dalam skala besar, tool dengan fitur penjadwalan seperti Octoparse lebih cocok.
- Untuk penggunaan tim dan integrasi mulus ke workflow yang sudah ada, Bardeen sangat ideal karena menawarkan berbagai tool otomasi web di luar article scraping.
- Kalau Anda ingin article scraper ringan untuk ekstraksi data kecil tanpa repot belajar, pilih article scraper point-and-click seperti Ultimate Web Scraper.
- Kalau Anda punya latar belakang teknis atau sedang membangun article scraper enterprise, pertimbangkan tool API atau membangun scraper sendiri di samping no-code scrapers ini.
Kesimpulan
Artikel ini memperkenalkan konsep dan skenario bisnis dari article & news scraper. Traditional scrapers dibangun di atas CSS selector, jadi memerlukan pemahaman tertentu tentang HTML dan CSS web, terutama untuk operasi lanjutan. Generasi baru AI-powered article scrapers sepenuhnya mengandalkan kemampuan pemahaman semantik dan pengenalan visual AI, sehingga lebih unggul daripada traditional scrapers dalam beradaptasi terhadap perubahan struktur web, generalisasi lintas situs, penanganan konten dinamis, serta pembersihan dan analisis data lanjutan.
Artikel ini juga menampilkan enam article & news scraper dan tool API yang berguna bagi developer, lalu membandingkan kelebihan dan kekurangannya, skala data yang cocok, fitur web, serta target penggunanya. Saat mempertimbangkan scraping artikel & berita, pilihlah solusi yang sesuai dengan kebutuhan bisnis Anda sambil menyeimbangkan performa dan biaya.
FAQ
1. Apa itu AI article scraper, dan bagaimana cara kerjanya?
- Menggunakan AI untuk menganalisis dan mengekstrak konten dari halaman web tanpa perlu CSS selector.
- Mengidentifikasi judul, penulis, tanggal terbit, dan isi utama dengan akurasi tinggi.
- Secara otomatis menghapus iklan, menu navigasi, dan elemen lain yang tidak relevan.
- Menyesuaikan diri dengan perubahan struktur web dan bisa digunakan di berbagai situs.
2. Apa manfaat menggunakan AI-powered article scraper dibanding scraper tradisional?
- Bisa mengekstrak konten dari banyak situs dengan satu tool.
- Mampu menangani konten dinamis, termasuk halaman yang dimuat dengan JavaScript dan AJAX.
- Membutuhkan setup dan pemeliharaan manual yang lebih sedikit dibanding scraper berbasis CSS.
- Menawarkan fitur tambahan seperti ringkasan, terjemahan, dan analisis sentimen.
3. Apakah saya bisa menggunakan Thunderbit untuk AI article scraping tanpa kemampuan coding?
- Ya, Thunderbit dirancang untuk pengguna non-teknis dengan antarmuka no-code yang sederhana.
- Menggunakan AI untuk mendeteksi dan mengekstrak konten artikel secara otomatis.
- Menyediakan template siap pakai untuk scraping yang cepat dan efisien.
- Memungkinkan ekspor data ke berbagai format seperti CSV, JSON, dan Google Sheets.
Pelajari Lebih Lanjut:
- Apa Itu Web Scraping
- Cara Menggunakan AI untuk Web Scraping
- Modern Web Scraping: A Deep Dive into AI-Powered Tools
- News Scraping: Tools, Use Cases, and Challenges
Coba AI Web Scraper Get Started Free




