
Bulan lalu, integrasi Stripe milik seorang teman diam-diam mulai balikin 503 pada pukul 11 malam di hari Jumat. Nggak ada yang sadar sampai Sabtu pagi — pas inbox support sudah penuh lebih dari 200 email marah dari pelanggan yang gagal checkout.
Kisah seperti itu bukan hal yang aneh. Sebuah benchmark yang sering dikutip memperkirakan rata-rata downtime mencapai $5.600 per menit, sementara gangguan berdampak besar bisa tembus jutaan dolar per jam. Angka pastinya memang tergantung pada traffic, conversion rate, nilai pesanan, eksposur SLA, dan biaya pemulihan — tapi arah kesimpulannya jelas: API yang nggak dipantau adalah risiko bisnis, bukan sekadar gangguan kecil buat tim engineering. Apalagi organisasi sekarang rata-rata menjalankan 131 API pihak ketiga dan hanya 16% yang melaporkan kemampuan tinggi untuk memitigasi risiko API pihak ketiga, jadi monitoring sudah bukan opsional lagi. Lewat panduan ini, saya ingin melakukan sesuatu yang jarang saya temui di tempat lain: mengelompokkan tools berdasarkan use case Anda, mengevaluasi kualitas alert (bukan cuma ada atau tidaknya alert), menampilkan harga nyata untuk 2026, dan mengukur seberapa cepat Anda benar-benar bisa mulai pakai. Bukan sekadar daftar logo yang datar.
Satu hal lagi: kalau kerja API Anda melibatkan pengumpulan data web, feeding LLM, membangun sistem RAG, memantau halaman kompetitor, atau mengambil data harga/produk dari website, maka pembahasan tentang "API tool" nggak boleh berhenti di uptime monitoring. Anda juga butuh cara yang andal untuk mengubah halaman web yang berantakan jadi data terstruktur. Di sinilah Thunderbit Open API masuk ke panduan ini: ini bukan monitor uptime, tapi salah satu cara tercepat untuk mengubah website jadi Markdown yang rapi atau JSON berbasis schema lewat API.
Apa Itu API Monitoring (dan Kenapa Tim Anda Harus Peduli)?
API monitoring berarti mengecek terus-menerus bahwa endpoint API Anda tersedia, responsif, dan mengembalikan data yang benar. Bukan cuma "server-nya hidup atau nggak?" — monitor yang bagus memvalidasi HTTP status code, payload respons, latensi, sertifikat SSL, alur multi-langkah (seperti login → search → checkout), bahkan kebenaran schema.
Ini beda dari website monitoring umum (yang cuma ngecek apakah halaman bisa dimuat) dan dari APM (Application Performance Monitoring), yang masuk lebih dalam ke trace level kode, query database, dan detail runtime internal. API monitoring berada di garis tengah: ia menguji apa yang benar-benar dialami pengguna, partner, dan integrasi saat memanggil endpoint Anda.
Ada juga kategori terkait yang patut disebut: web data APIs. Alat ini bukan memantau kesehatan API milik Anda, melainkan membantu produk atau workflow Anda mengumpulkan data web eksternal secara andal. Misalnya, Thunderbit Open API bisa mengubah halaman web menjadi Markdown yang bersih, mengekstrak field terstruktur sebagai JSON, dan menjalankan batch job di banyak URL. Kalau proyek "API" Anda bergantung pada data vendor yang selalu baru, halaman produk, listing publik, dokumentasi, atau sumber riset, API untuk ekstraksi data seperti ini bisa sama pentingnya secara operasional dengan cek uptime.
Kenapa non-engineer perlu peduli? Karena API menyumbang 71% traffic web dinamis dan 62% profesional API mengatakan API langsung menghasilkan pendapatan. Saat payment gateway, layanan autentikasi, atau API pengiriman gagal, itu bukan sekadar masalah infrastruktur abstrak — itu berarti pendapatan hilang, kontrak partner terganggu, lonjakan ticket support, dan kepercayaan yang turun. Product manager, sales, ops, dan customer success semuanya kena dampaknya.
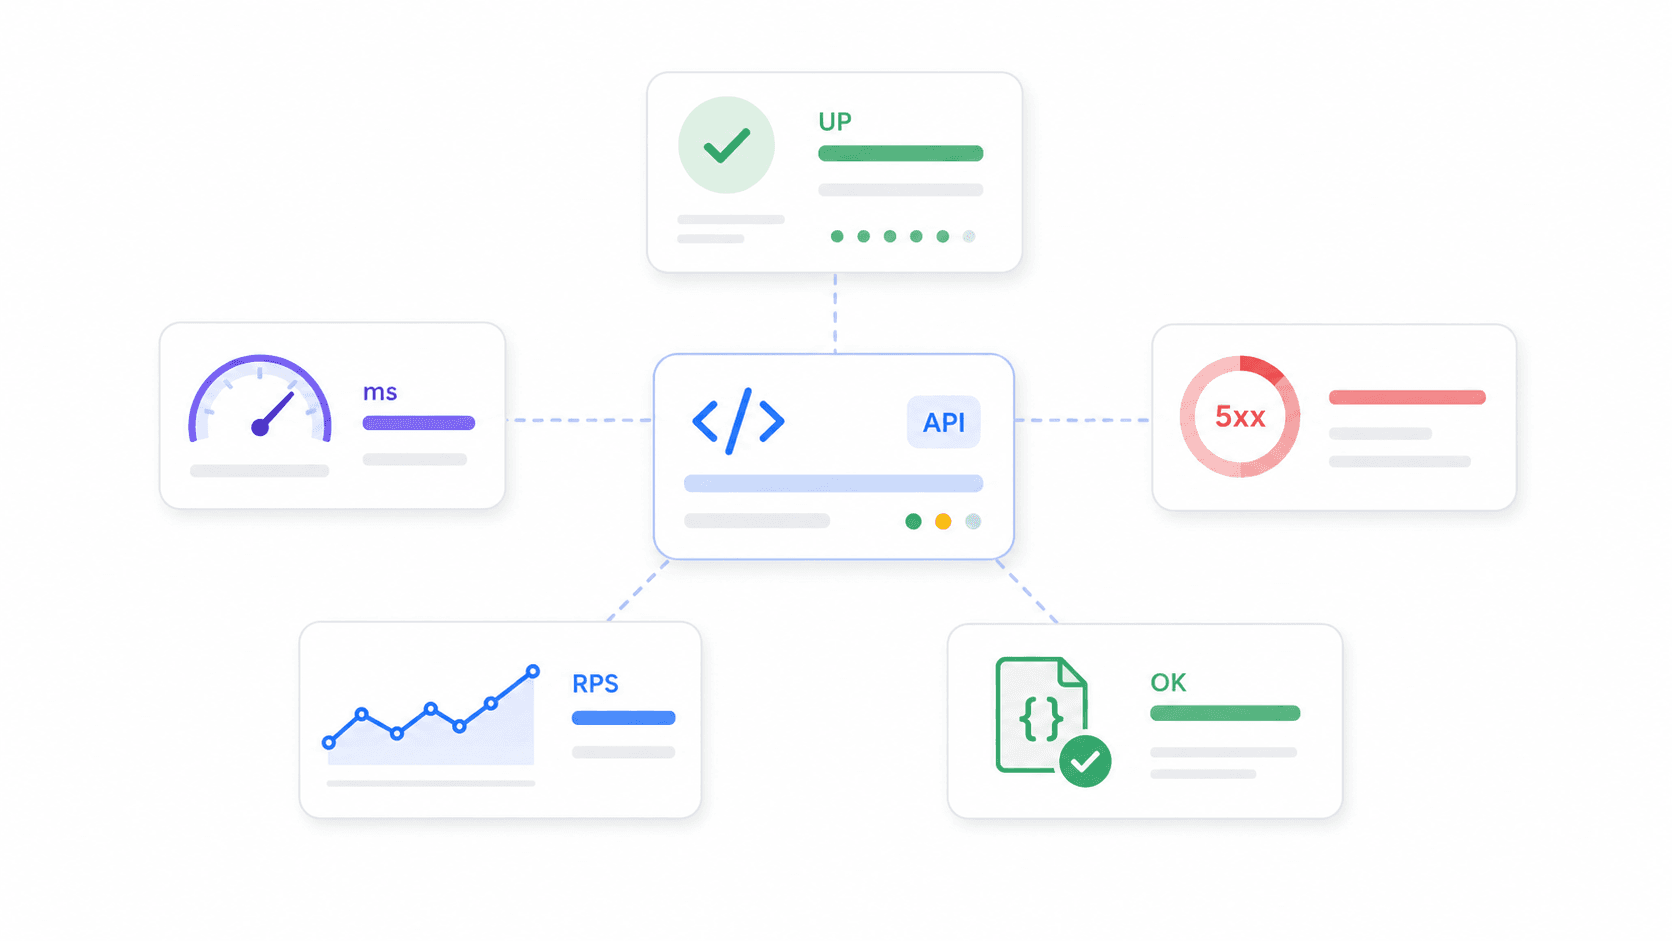
Metrik utama yang perlu dipantau:
- Persentase uptime: proporsi waktu endpoint tersedia
- Response time / latency: seberapa lama endpoint merespons (rata-rata, p95, p99)
- Error rate: proporsi request yang menghasilkan 5xx, timeout, atau assertion failure
- Throughput: request per detik/menit
- Kebenaran data: apakah API mengembalikan data yang diharapkan, bukan cuma 200 OK
Cara Kami Mengevaluasi Tools Monitoring API Terbaik untuk 2026
Kebanyakan artikel "best API monitoring tools" cuma numpuk nama vendor dan fitur. Saya ingin lebih disiplin soal kriteria pemilihan — sebagian karena saya menghabiskan banyak waktu baca forum developer, dan sebagian lagi karena tim Thunderbit membantu saya mengekstrak data harga dan fitur secara massal dari situs vendor untuk bikin perbandingan yang nyata (lebih lanjut soal workflow ini nanti).
Berikut bobot penilaian kami:
| Kriteria | Kenapa Penting |
|---|---|
| Kemudahan setup / waktu ke alert pertama | Tim kecil butuh coverage hari ini, bukan setelah proyek platform selesai |
| Kecerdasan alert & pengurangan noise | Kalau alert terlalu berisik, tim bakal mengabaikannya dan melewatkan insiden nyata |
| Kedermawanan free tier | Side project dan startup tahap awal sering mulai dari gratis |
| Transparansi harga | Tagihan observability bisa membengkak lewat host, seat, log, synthetic run, dan ingest data |
| Cakupan integrasi | Alert harus masuk ke tempat kerja tim yang sudah ada (Slack, PagerDuty, dll.) |
| Skalabilitas & kedalaman data | Tim matang butuh trace, log, APM, RBAC, SSO, retention |
| Kualitas komunitas & support | Tim open-source butuh cadence rilis; tim enterprise butuh SLA |
| Kemampuan ekstraksi data web | Aplikasi AI, workflow RAG, dan tools riset pasar sering butuh data eksternal yang rapi, bukan cuma uptime endpoint |
Kami juga membagi rekomendasi berdasarkan use case — solo dev, startup, e-commerce/SaaS, enterprise, open-source purist, tim produk API, dan tim web data/AI — supaya Anda bisa langsung lompat ke konteks Anda, bukan baca 14 ringkasan tool sambil nebak-nebak mana yang cocok. Survei Grafana 2025 menemukan 46% responden menyebut interoperabilitas dan 35% menyebut kemudahan berpindah di masa depan sebagai kriteria seleksi, yang menegaskan bahwa hal-hal ini bukan cuma nice-to-have.
Tools Monitoring API Terbaik per Use Case: Tabel Pilihan Cepat
Ini versi singkatnya. Temukan baris yang sesuai, lalu buka bagian tool di bawah untuk pembahasan lengkap.
| Use Case | Tools yang Direkomendasikan | Pembeda Utama |
|---|---|---|
| Tim web data / aplikasi AI | Thunderbit Open API, Moesif, Apitally | Mengubah website menjadi Markdown bersih atau JSON terstruktur untuk LLM, RAG, harga, dan workflow riset |
| Solo dev / side project | UptimeRobot, Uptime Kuma, Gatus | Gratis atau self-hosted, konfigurasi minimal, setup cepat |
| Startup (tim 5–15 orang) | Checkly, Better Stack, Postman | Alert cerdas, setup cepat, harga terjangkau, status page |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Metrik bisnis, APM/tracing, depth SDK, synthetic multi-langkah |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, compliance, hybrid, RBAC/SSO |
| Penganut open-source murni | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Kontrol penuh, native OTel, tanpa vendor lock-in |
| Tim produk API | Moesif, Apitally, New Relic | Usage per pelanggan, tren endpoint, alert anomali |
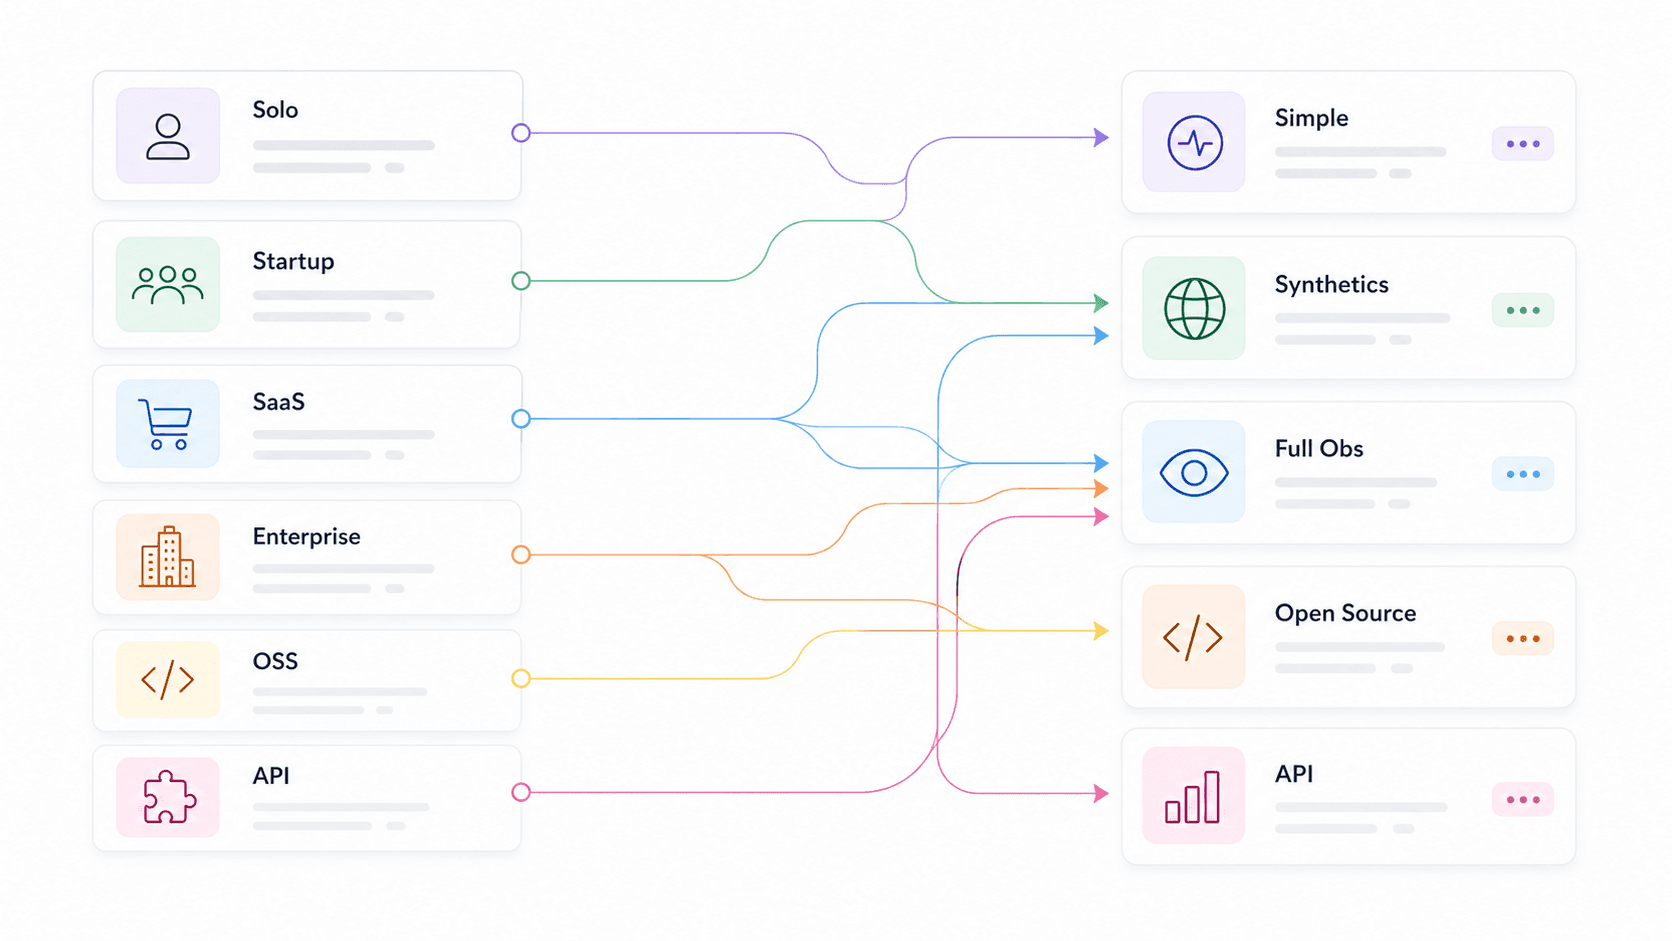
Pola terbesarnya: tools yang paling cepat dipasang biasanya punya analytics yang lebih ringan, sementara platform yang paling dalam butuh konfigurasi dan disiplin biaya yang lebih tinggi. Itu bukan kekurangan — itu tradeoff yang perlu dipahami. Thunderbit ada di jalur yang sedikit berbeda: ia paling cepat kalau tugasnya mengubah halaman web jadi data siap pakai via API, bukan membunyikan alarm saat downtime.
Thunderbit Open API: Terbaik untuk Mengubah Website Menjadi Data API Terstruktur
Mulai membangun dengan Thunderbit Open API Ubah halaman menjadi Markdown, ekstrak JSON terstruktur, dan proses URL dalam batch tanpa perlu memelihara infrastruktur scraping. Get Started Free
Thunderbit Open API adalah API yang akan saya taruh di urutan pertama untuk tim yang workflow "monitoring" atau risetnya bergantung pada data web eksternal. Ini bukan tool monitoring uptime tradisional seperti Checkly atau UptimeRobot. Sebaliknya, Thunderbit mengubah halaman web apa pun menjadi data terstruktur yang bisa benar-benar dipakai aplikasi, agent, dashboard, dan pipeline LLM.
API ini punya tiga workflow inti. Distill mengubah halaman jadi Markdown bersih yang siap untuk LLM. Extract mengambil schema lalu mengembalikan field JSON terstruktur seperti nama produk, harga, ketersediaan, ukuran perusahaan, tahap pendanaan, atau rating ulasan. Batch memungkinkan Anda memproses hingga 100 URL secara asynchronous dengan webhook, berguna saat Anda memantau halaman harga, katalog kompetitor, dokumentasi vendor, sumber berita, atau daftar riset besar.
Alasan ini layak masuk ke panduan API tools adalah karena banyak tim meremehkan betapa banyak infrastruktur yang dibutuhkan untuk "cuma scrape halaman ini". Situs yang berat di JavaScript perlu rendering. Sebagian halaman butuh geo-routing. HTML harus dibersihkan dari navbar, iklan, modal, dan boilerplate sebelum berguna bagi LLM. Selector bisa rusak saat layout berubah. Rotasi proxy, penanganan anti-bot, retry, queue, dan polling hasil bisa mengubah workflow data kecil jadi proyek pemeliharaan. Thunderbit menyerap banyak pekerjaan itu di balik satu API.
Cocok untuk: builder aplikasi AI, tim RAG, ops e-commerce, sales ops, growth team, peneliti pasar, dan developer yang butuh data website lewat API tanpa membangun dan mengawasi sendiri scraping stack.
Harga: Gratis: 600 unit API sekali pakai, termasuk hingga 600 halaman Distill atau 30 halaman Extract, dengan 2 concurrent request. Starter tercantum $16/bulan bila dibayar tahunan untuk 60.000 unit API/tahun dan 30 concurrent request. Pro tercantum $40/bulan bila dibayar tahunan untuk 600.000 unit API/tahun dan 50 concurrent request.
Kecepatan setup: sekitar 5–15 menit untuk mendapatkan API key dan menjalankan request Distill atau Extract pertama dengan cURL, SDK, atau Thunderbit CLI.
Kekurangan: Thunderbit nggak akan menggantikan Datadog, New Relic, Better Stack, atau Checkly untuk cek uptime, eskalasi insiden, trace, log, atau routing on-call. Anggap saja ini sebagai API untuk mengumpulkan dan menyusun data web — termasuk harga vendor, docs, halaman kompetitor, listing produk, atau dataset publik — bukan sistem yang membunyikan alarm ke engineer on-call Anda.
Datadog: Terbaik untuk Visibilitas Full-Stack
Datadog adalah tool yang paling sering saya lihat di stack enterprise dan SaaS mid-market, dan alasannya jelas. Ini bukan sekadar API monitoring — ini platform observability penuh yang menghubungkan synthetic API test ke distributed trace, log, metrik infrastruktur, dan real user monitoring dalam satu tampilan.
Secara khusus untuk API monitoring, Datadog mendukung HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC, dan multi-step API tests. Anomaly detection monitor miliknya mempelajari pola yang diharapkan dan memberi alert saat ada deviasi, bukan sekadar threshold statis — ini lompatan yang berarti dibanding "alert kalau latency > 500ms". Datadog juga menawarkan forecast monitor yang memprediksi kapan metrik akan menembus threshold, plus composite monitor yang menggabungkan beberapa kondisi.
Cocok untuk: tim e-commerce, SaaS, dan enterprise yang butuh satu tampilan terpadu untuk API, infrastruktur, log, dan trace.
Harga: Detail free tier beda-beda tergantung produk. Infrastructure Pro mulai dari $15/host/bulan; synthetic API test seharga $5 per 10.000 run. 800+ integrasi.
Kecepatan setup: sekitar 15–30 menit untuk instal agent plus synthetic test dasar.
Kekurangan: Bisa jadi mahal saat skala membesar — "bill shock" adalah tema yang sering muncul di Hacker News dan Reddit. Banyaknya SKU (host, log, custom metric, synthetics, user) berarti Anda butuh orang yang mantau tagihan, bukan cuma dashboard. Kurva belajar untuk platform penuh juga nyata.
Checkly: Terbaik untuk Synthetic Check yang Developer-First
Checkly adalah tool yang akan saya kasih ke tim engineering startup yang ingin API checks-nya dekat dengan code. Ide utamanya adalah "monitoring as code": definisikan API dan browser check secara programatik, jalankan dari lokasi global, integrasikan dengan pipeline CI/CD, dan kelola semuanya lewat Git.
Dari sisi kualitas alert, tool ini kuat. Logika retry milik Checkly secara eksplisit diposisikan sebagai "garis pertahanan pertama" terhadap false positive — Anda bisa mengatur retry tetap, linear, atau eksponensial, retry dari lokasi yang sama atau berbeda, dan durasi retry maksimum sebelum alert dipicu. Checkly juga membedakan state degraded, failed, dan recovered, yang bantu mengurangi notifikasi berisik.
Cocok untuk: startup dan tim dev yang menginginkan API check yang bisa diprogram, browser check berbasis Playwright, integrasi CI/CD, dan setup cepat.
Harga: Data publik terbaru menunjukkan free plan dengan 10 uptime monitor, 1.000 browser check, dan 10.000 API check. Starter sekitar $24/bulan jika dibayar tahunan — verifikasi halaman harga resmi sebelum beli.
Kecepatan setup: sekitar 10–20 menit untuk API check pertama dan channel alert.
Kekurangan: Fokus pada synthetic checks. Bukan pengganti APM yang dalam, analitik log, atau distributed tracing. Kalau Anda perlu menghubungkan kegagalan API dengan bottleneck database, Anda tetap butuh tool lain di sampingnya.
UptimeRobot: Terbaik untuk Pelacakan Uptime yang Sederhana dan Terjangkau
UptimeRobot adalah Honda Civic-nya API monitoring. Tool ini melakukan satu hal dengan baik: Anda bikin monitor HTTP, keyword, ping, port, SSL, atau heartbeat, pilih interval, lalu terima alert saat gagal. Selesai.
Cocok untuk: solo dev, tim kecil, agency, atau siapa pun yang butuh tracking uptime dan latency dasar tanpa kerumitan.
Harga: Gratis: 50 monitor, interval 5 menit. Paket Solo berbayar sekitar $7/bulan bila dibayar tahunan. Nggak perlu kartu kredit untuk free plan. Kecepatan setup: sekitar 2–5 menit — paling cepat di daftar ini.
Kekurangan: Alert intelligence terbatas. Cuma alert threshold dasar, tanpa anomaly detection, tanpa distributed tracing, tanpa analitik mendalam. Kalau Anda perlu tahu kenapa endpoint lambat, bukan cuma bahwa dia lambat, UptimeRobot nggak akan cukup.
Uptime Kuma: Tools Monitoring API Self-Hosted Gratis Terbaik
Uptime Kuma adalah favorit komunitas self-hosting, dan angka GitHub-nya mendukung itu: 86.637 star, 7.831 fork, 1.060 kontributor, dengan rilis 2.3.2 per Mei 2026. Tool ini berlisensi MIT, mendukung HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, beberapa status page, dan 90+ layanan notifikasi.
Cocok untuk: solo dev dan tim yang ingin kontrol penuh, privasi, dan tanpa biaya SaaS berulang — asalkan Anda punya server.
Harga: Gratis. Biaya sebenarnya adalah VM/container, backup, update, dan memastikan monitor itu sendiri tetap hidup. Kecepatan setup: sekitar 5–15 menit dengan Docker untuk cek dasar; 15–30 menit kalau ingin notifikasi dan status page yang lebih rapi.
Kekurangan: Anda yang memelihara. Dan ini jebakan penting: kalau Uptime Kuma di-host di infrastruktur yang sama dengan yang dipantau, outage cloud atau DNS bisa menjatuhkan aplikasi dan monitornya sekaligus. Host di luar atau pasangkan dengan SaaS check.
Better Stack: Terbaik untuk Respons Insiden yang Cepat
Better Stack (sering masih disebut Better Uptime oleh pengguna) menggabungkan monitoring uptime dengan incident management, penjadwalan on-call, escalation policy, dan status page dalam satu platform. Kekuatan utamanya bukan sebagai tool analytics, melainkan sebagai tool workflow insiden yang dibungkus monitoring.
Escalation policy menentukan siapa yang di-alert, urutannya seperti apa, dan jeda waktunya bagaimana, sampai ada acknowledgment. Routing berbasis metadata mengirim insiden berdasarkan severity atau kepemilikan. Integrasinya dengan Slack, Teams, webhook, dan Zapier.
Cocok untuk: startup dan tim menengah yang ingin monitoring + respons insiden + status page tanpa merakit tiga tool terpisah.
Harga: Free tier: 10 monitor/heartbeat, 1 status page. Paket Team sekitar $29/bulan bila dibayar tahunan. Kecepatan setup: sekitar 5–10 menit via wizard GUI.
Kekurangan: Kedalaman analitik payload API, distributed tracing, atau analisis KPI bisnis lebih dangkal dibanding Datadog, New Relic, atau Moesif.
Prometheus + Grafana: Stack Monitoring API Open-Source Terbaik
Ini adalah kombinasi open-source standar industri. Prometheus melakukan scrape dan menyimpan metrik time-series. Grafana (73.705 star GitHub, 3.010 kontributor) menyediakan dashboard dan alerting. Alertmanager menangani routing, grouping, deduplication, silencing, dan inhibition. Untuk cek endpoint API, tim menambahkan Blackbox Exporter untuk probing HTTP, HTTPS, DNS, TCP, ICMP, dan gRPC.
Cocok untuk: penganut open-source murni, tim Kubernetes/SRE, dan organisasi yang sudah menstandarkan metrik di Prometheus.
Harga: Gratis kalau self-hosted. Grafana Cloud punya free tier (100k eksekusi API test per bulan) dan paket berbayar berbasis pemakaian.
Kecepatan setup: 1–4 jam untuk Blackbox + Prometheus + Grafana + Alertmanager dasar. Butuh hari untuk HA production dan tuning alert.
Kekurangan: PromQL, YAML, relabeling, desain dashboard, retention, storage, HA, dan tuning alert adalah pekerjaan operasional sungguhan. Tradeoff yang sering muncul adalah "lebih sedikit UI, lebih banyak YAML." Ini stack untuk tim yang sudah berpikir dalam metrik dan ingin satu control plane — bukan untuk tim yang ingin monitoring aktif sebelum makan siang.
New Relic: Terbaik untuk Performa Aplikasi SaaS
New Relic menggabungkan APM, monitoring infrastruktur, log, distributed tracing, synthetic monitoring, alert, dashboard, dan analisis insiden berbantuan AI. Free tier-nya — 100 GB data ingest per bulan dan 1 full platform user — benar-benar dermawan untuk tim kecil.
Kecerdasan alert adalah titik kuat New Relic dalam diskusi alert fatigue. Fitur incident intelligence mencakup korelasi event, anomaly detection, predictive alert, root-cause analysis, dan flapping suppression. New Relic pernah mempublikasikan contoh bahwa efektivitas flapping 97,2% berarti hanya 28 isu yang muncul dari 1.000 insiden flapping — ini angka konkret untuk pengurangan noise.
Cocok untuk: tim SaaS dan platform e-commerce yang ingin monitoring API yang terhubung erat dengan trace level aplikasi, error, throughput, dan dampak pengguna.
Harga: Gratis: 100 GB/bulan, 1 full user. Paket berbayar memakai pricing per user dan data.
Kecepatan setup: sekitar 15–30 menit untuk instal agent dan setup terpandu.
Kekurangan: Harga bisa jadi kompleks saat skala membesar. Konfigurasi alert juga punya kurva belajar — platform ini kuat, tapi nggak langsung terasa intuitif.
Moesif: Terbaik untuk Analitik API dan Metrik Bisnis
Moesif bukan monitor uptime tradisional. Ini adalah analitik API dan product intelligence: memahami penggunaan API per pelanggan, endpoint, cohort, perusahaan, geografi, SDK, paket, dan perilaku. Kalau pertanyaan Anda adalah "pelanggan mana yang terdampak?" alih-alih "apakah endpoint-nya hidup?", Moesif memang dibangun untuk itu.
Tool ini mendukung static threshold alert dan dynamic anomaly alert untuk metrik API seperti lonjakan/penurunan traffic, latency, dan perubahan perilaku. Dynamic alert butuh beberapa hari data perilaku API untuk membangun model, tetapi setelah terlatih, ia bisa menangkap perubahan yang lolos dari rule statis.
Cocok untuk: tim produk API, perusahaan SaaS, dan platform e-commerce yang perlu menghubungkan performa API dengan revenue, engagement, dan retention.
Harga: Tersedia free/trial; paket berbayar menyesuaikan volume event API. Nominal self-service tidak sepenuhnya bisa saya crawl dalam riset ini — cek halaman terbaru.
Kecepatan setup: sekitar 20–45 menit (integrasi SDK/proxy/gateway lebih dalam daripada ping eksternal).
Kekurangan: Lebih fokus pada analytics dibanding monitoring uptime tradisional. Kemungkinan besar Anda tetap ingin memasangkan Moesif dengan Checkly, UptimeRobot, atau Datadog synthetics untuk cek availability eksternal.
Splunk: Terbaik untuk Analisis Log Enterprise dan Compliance
Splunk adalah tool yang Anda pilih ketika agregasi log, pencarian, korelasi, auditability yang siap compliance, dan dukungan hybrid/multi-cloud nggak bisa ditawar. Splunk Observability Cloud mencakup infrastruktur, APM, synthetics, real user monitoring, log, dan respons insiden. ITSI/Event Analytics dapat mengelompokkan event penting menjadi episode dan mengurangi noise di seluruh silo monitoring.
Riset observability 2025 milik Splunk cukup menyadarkan: 73% responden ITOps/engineering melaporkan outage karena alert diabaikan atau ditekan, 59% kesulitan karena terlalu banyak tool yang terpisah, dan 52% kesulitan dengan false alert.
Cocok untuk: tim enterprise dan multi-cloud dengan kebutuhan ketat soal compliance, security, audit, dan pencarian log.
Harga: Berbasis pemakaian dan umumnya lewat penawaran. Nggak ada free tier produksi yang sederhana.
Kecepatan setup: onboarding cloud bisa lebih cepat, tapi deployment enterprise sering makan waktu dari beberapa hari sampai minggu.
Kekurangan: Mahal saat skala besar. Setup kompleks. Berlebihan untuk solo dev dan startup kecil.
Postman: Terbaik untuk Tim yang Sudah Menguji API
Postman utamanya adalah platform development dan testing API, tetapi produk monitoring miliknya memungkinkan tim menjadwalkan collection Postman dan menjalankannya dari lokasi cloud. Argumen terkuatnya adalah reuse: kalau tim QA atau dev Anda sudah punya collection Postman dengan assertion, mengubahnya jadi monitor adalah langkah natural berikutnya.
Cocok untuk: tim dev dan QA yang sudah memakai collection Postman dan ingin scheduled check tanpa beli tool synthetic terpisah.
Harga: Ada free tier. Kelebihan monitoring dikenakan $0,75 per 1.000 call; paket tambahan 50.000 call seharga $20/bulan. Verifikasi halaman paket terbaru — kemasan paket Postman sering berubah.
Kecepatan setup: sekitar 10 menit kalau collection sudah ada.
Kekurangan: Kemampuan monitoring lebih ringan dibanding tool khusus seperti Checkly, Datadog, atau New Relic. Opsi alert juga dasar.
Tools Monitoring API Lain yang Layak Dilihat
Gatus: dashboard health self-hosted yang ringan dan berbasis konfigurasi. 10.906 star GitHub, mendukung HTTP, ICMP, TCP, DNS, metrik ramah Prometheus, dan uptime badge. Cocok untuk solo dev yang ingin sesuatu lebih sederhana dari Prometheus tapi lebih suka YAML/config-as-code dibanding UI Uptime Kuma.
Apitally: tool yang lebih baru, fokus pada analitik traffic API dan tracking kualitas untuk startup. Mengklaim setup di bawah 5 menit dengan custom alert di 14 metrik. Cocok untuk analitik API ringan tanpa mengadopsi platform observability penuh.
Sematext: monitoring full-stack dengan log, synthetics, dan visibilitas infrastruktur. Synthetics sekitar $2 per HTTP monitor, $7 per browser monitor, minimum $5/bulan. Alternatif Datadog yang lebih murah untuk tim mid-market.
Uptrace: backend APM, tracing, metrics, dan log native OpenTelemetry. 4.198 star GitHub. Bukan checker uptime murni, tapi ideal untuk tim yang menstandarkan OTel dan ingin backend tracing yang ramah open-source.
Build vs. Buy: Perlukah Anda Merakit Sendiri Monitoring API?
"Apa saya cukup bikin script yang ping endpoint, atau pakai tool khusus?"
Pertanyaan ini muncul terus-menerus di forum developer. Saya sudah baca cukup banyak thread Reddit untuk lihat polanya jelas: tim mulai dengan curl + cron, itu bekerja cukup baik untuk sementara, lalu mereka pindah saat butuh dashboard, data historis, cek multi-region, routing alert yang andal, atau visibilitas lintas tim.
Matriks keputusan yang jujur:
| Faktor | Script Kustom | Tool Spesialis |
|---|---|---|
| Waktu setup | 1–4 jam (dasar); hari (robust) | 5–30 menit |
| Pemeliharaan | Anda yang tanggung selamanya | Provider menangani update |
| Kualitas alert | Dasar (up/down) | Cerdas (tren latency, anomali, retry) |
| Biaya | Gratis (waktu Anda) | $0–$500+/bulan |
| Dashboard | Dibuat dari nol | Siap pakai, bisa dikustomisasi |
| Paling cocok saat… | ≤3 endpoint, tim sangat teknis, proyek hobi | 5+ endpoint, tim ops/produk, pendapatan dipertaruhkan |
Insight utama dari forum: orang yang membangun sendiri sering menyesal begitu mereka butuh dashboard, data historis, atau visibilitas lintas tim. Dan ada masalah meta — "Anda butuh monitoring untuk monitoring Anda sendiri." Monitor self-hosted, database, backup, network path, dan provider alert semuanya juga harus andal.
Bikin sendiri kalau Anda punya 2 endpoint dan suka ngoprek. Beli kalau Anda punya produk yang harus dikirim.
Logika yang sama berlaku untuk ekstraksi data web. Anda bisa menulis scraper, menjalankan headless browser, memutar proxy, memelihara selector, membersihkan HTML, dan membangun queue. Tapi kalau tugasnya adalah memasok data web secara andal ke produk API, agent AI, atau workflow riset, memakai Thunderbit Open API biasanya jauh lebih cepat daripada membangun sendiri infrastruktur scraping.
Alert Fatigue: Kenapa Kualitas Alert Lebih Penting daripada Jumlah Alert
Ini mungkin kriteria yang paling diremehkan saat memilih tool monitoring API. Alert fatigue terjadi ketika tim menerima terlalu banyak alert yang berisik, duplikat, atau nggak bisa ditindaklanjuti, sehingga mereka mulai mengabaikan semuanya — lalu melewatkan insiden nyata.
Angkanya cukup mencolok. Laporan BigPanda 2025 menemukan organisasi median menghasilkan 2.350 alert per hari dan 803.406 alert per tahun. Actionability insiden median cuma 18% — artinya kurang dari satu dari lima insiden yang berasal dari alert benar-benar bisa ditindaklanjuti. Survei NeuBird 2026 menemukan 77% tim on-call menerima setidaknya 10 alert per hari dan 80% mengatakan setengah atau kurang dari alert itu benar-benar actionable.
Tool monitoring terbaik adalah tool yang alert-nya benar-benar Anda percayai. Berikut perbandingan cara tools menangani alert intelligence:
| Tool | Jenis Alert | Metode Pengurangan Noise | Channel Alert |
|---|---|---|---|
| Datadog | Anomali ML, forecast, composite | Historical anomaly band, dynamic baseline, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Threshold + berbasis degradasi | Retry sebelum firing, retry lokasi sama/berbeda | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI issue grouping, anomaly, predictive | Korelasi event, flapping suppression, konteks root cause | Slack, PagerDuty, Teams, webhook |
| Moesif | Behavioral anomaly | Model dinamis setelah beberapa hari perilaku | Slack, PagerDuty, email, SMS |
| Better Stack | Uptime/insiden/on-call | Escalation policy, routing kepemilikan, delay | Slack, Teams, webhook, Zapier |
| Prometheus + Alertmanager | Alert rule PromQL | Grouping, deduplication, silencing, inhibition | Email, PagerDuty, Opsgenie, webhook |
| Splunk | Event, episode, service health | ITSI Event Analytics, episode grouping, ticketing | Splunk On-Call, ServiceNow, webhook |
| Thunderbit Open API | Bukan platform alerting | Dipakai bersama scheduler, workflow tool, atau stack monitoring Anda sendiri | Webhook untuk batch job; alert ditangani secara eksternal |
Saran praktis: Mulailah dengan alert yang lebih sedikit tapi lebih bisa dipercaya. Gunakan retry-before-firing, konfirmasi multi-region, alert SLO burn rate, deduplication, dan routing berdasarkan ownership. Alert-kan dampak ke pengguna dan alur bisnis yang kritis (gagal checkout, gagal auth, payment 5xx), bukan setiap gejala internal.
Free Tier dan Harga 2026: Apa yang Sebenarnya Anda Bayar
Halaman harga berubah. Free tier bergeser. Biaya tersembunyi (host, seat, log, synthetic run, ingest data) bisa mengejutkan. Ini bagian yang saya harap ada di setiap artikel "best tools". Snapshot 2026:
| Tool | Free Tier | Mulai Berbayar | Perlu Kartu Kredit? | Use Case Gratis Terbaik |
|---|---|---|---|---|
| Thunderbit Open API | 600 unit API sekali pakai | ~$16/bulan tahunan | Tidak | Ekstraksi data web untuk LLM, RAG, harga, dan riset |
| Uptime Kuma | Tidak terbatas (self-host) | — | Tidak | Monitoring penuh, server sendiri |
| UptimeRobot | 50 monitor, interval 5 menit | ~$7/bulan | Tidak | Cek uptime dasar |
| Better Stack | 10 monitor, 1 status page | ~$29/bulan | Tidak | Startup uptime + status page |
| Checkly | 10 uptime, 10k API check | ~$24/bulan | Ya | Synthetic API check |
| Postman | Akun gratis + kuota monitoring | ~$14/user/bulan | Tidak | Memakai ulang collection yang sudah ada |
| Prometheus + Grafana | Tidak terbatas (self-host) | — | Tidak | Metrik + visualisasi |
| Grafana Cloud | 100k eksekusi API test/bulan | $29/bulan platform + usage | Perlu dicek | Trial synthetics terkelola |
| New Relic | 100 GB/bulan, 1 full user | Per user + data | Beberapa paket | APM + observability dasar |
| Datadog | Trial/bervariasi tergantung produk | $15/host/bulan (Infra Pro) | Sering ya | Evaluasi full-stack |
| Moesif | Free/trial tersedia | Berbasis volume | Perlu dicek | Evaluasi analitik API |
| Splunk | Trial tersedia | Berdasarkan penawaran | Alur sales | Proof of concept enterprise |
| Gatus | Tidak terbatas (self-host) | — | Tidak | Status dashboard berbasis YAML |
| Apitally | Free/trial tersedia | Perlu dicek | Perlu dicek | Analitik API ringan |
| Sematext | Trial/free bervariasi | ~$2/HTTP monitor | Perlu dicek | Synthetics/log yang lebih murah |
| Uptrace | Gratis self-hosted | Tier cloud bervariasi | Perlu dicek | Evaluasi APM OTel |
Catatan biaya tersembunyi: Tool self-hosted (Uptime Kuma, Prometheus, Gatus) memang "gratis" secara lisensi, tapi VM kecil, backup, waktu maintenance, dan failover eksternal bisa cepat jadi biaya sebenarnya. Untuk API data web, biaya tersembunyi biasanya beda: memelihara headless browser, selector yang rusak, proxy pool, workaround anti-bot, dan pembersihan HTML.
Estimasi tim kecil: Untuk 10 endpoint API dan 3 anggota tim, jalur SaaS termurah biasanya UptimeRobot free atau paid rendah, Better Stack free/Team, atau Checkly kalau volume eksekusinya cocok. Datadog dan New Relic bisa terjangkau untuk evaluasi, tapi tagihan sebenarnya tergantung pada host, user, log, trace, dan volume synthetic run. Kalau proyek Anda butuh data website sebagai API, unit API gratis Thunderbit cukup untuk menguji workflow sebelum komit ke paket berbayar.
Skor Kompleksitas Setup: Seberapa Cepat Anda Sampai ke Alert Pertama?
Belum ada artikel kompetitor yang saya temukan yang benar-benar mengevaluasi time-to-value — berapa lama dari daftar sampai menerima alert bermakna pertama. Untuk tim kecil, ini sering lebih penting daripada kedalaman fitur.
| Tool | Waktu ke Alert Pertama | Skill Teknis yang Dibutuhkan | Pendekatan Konfigurasi |
|---|---|---|---|
| Thunderbit Open API | ~5–15 menit | Rendah–Sedang | API key, cURL/SDK/CLI |
| UptimeRobot | ~2–5 menit | Rendah | GUI, klik untuk tambah |
| Better Stack | ~5–10 menit | Rendah | Wizard GUI |
| Checkly | ~10–20 menit | Rendah–Sedang | Code atau GUI |
| Postman | ~10 menit (jika collection sudah ada) | Rendah–Sedang | Scheduler collection |
| Uptime Kuma | ~5–30 menit | Sedang | Docker + GUI |
| Gatus | ~15–45 menit | Sedang | YAML + Docker |
| Datadog | ~15–30 menit | Sedang | Instal agent + GUI |
| New Relic | ~15–30 menit | Sedang | Agent + setup terpandu |
| Moesif | ~20–45 menit | Sedang | Integrasi SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 menit | Sedang | GUI, Terraform opsional |
| Prometheus + Grafana | 1–4 jam | Sedang–Tinggi | YAML, PromQL |
| Uptrace | 30–90 menit | Sedang–Tinggi | Integrasi OTel SDK |
| Splunk | Jam hingga minggu | Tinggi | Onboarding enterprise |
Kalau monitoring harus aktif hari ini, mulai dari bagian atas tabel itu. Kalau tujuannya observability platform yang tahan lama, rencanakan proyek terpisah untuk bagian bawah. Dan kalau milestone pertama Anda adalah "ambil data bersih dari 100 halaman web ini ke dalam app", mulai dengan Thunderbit sebelum bangun infrastruktur scraping sendiri.
Perbandingan Lengkap Tools Monitoring API Terbaik
Satu tabel untuk dipindai sebelum ambil keputusan:
| Tool | Use Case Terbaik | Free Tier | Kecerdasan Alert | Waktu Setup | Hosting | Fitur Unggulan |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Ekstraksi data web / pipeline data API | 600 unit API | Bukan tool alerting | 5–15 menit | Cloud | Mengubah halaman menjadi Markdown atau mengekstrak JSON berbasis schema |
| Datadog | Enterprise/SaaS full-stack | Trial/bervariasi | Anomali, forecast, AI | 15–30 menit | Cloud | Menghubungkan synthetics dengan log/trace/infra |
| Checkly | Synthetic yang developer-first | Kuota check yang dermawan | Retry, degradasi | 10–20 menit | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Uptime sederhana | 50 monitor | Threshold dasar | 2–5 menit | Cloud | Monitor dasar termurah dan tercepat |
| Uptime Kuma | Self-hosted gratis | Tidak terbatas | Status/threshold dasar | 5–30 menit | Self-hosted | UI bersih, tanpa biaya SaaS |
| Better Stack | Respons insiden/status page | 10 monitor | Eskalasi, routing | 5–10 menit | Cloud | Monitoring + on-call + status page |
| Prometheus + Grafana | Stack metrik open-source | Tidak terbatas (self-host) | Grouping Alertmanager | 1–4 jam | Self-hosted/cloud | Kedalaman ekosistem PromQL |
| New Relic | APM SaaS + API check | 100 GB/bulan, 1 user | AI grouping, flapping suppression | 15–30 menit | Cloud | APM kuat dan synthetics dalam satu paket |
| Moesif | Analitik API / metrik bisnis | Free/trial | Behavioral anomalies | 20–45 menit | Cloud | Analitik perilaku API per pelanggan |
| Splunk | Log enterprise / compliance | Trial | Episode ITSI, AIOps | Hari+ | Cloud/self-managed | Pencarian log dan governance enterprise |
| Postman | Tim yang sudah menguji API | Akun gratis | Alert monitor dasar | 10 menit | Cloud | Memakai ulang collection test API |
Bagaimana Thunderbit Bisa Mempercepat Evaluasi Tool API Anda
Keterbukaan penuh: Thunderbit bukan tool monitoring API — ini web scraper agentic dan Open API untuk mengubah halaman web jadi Markdown yang rapi atau JSON terstruktur. Itu bikin ia berguna di bagian lain dari proses pemilihan tool monitoring: mengumpulkan harga vendor, batasan paket, klaim fitur, detail dokumentasi, dan daftar integrasi sebelum Anda memilih platform.
Alih-alih membuka 10+ halaman harga vendor secara manual, menyalin nama paket, batas monitor, interval cek, integrasi, dan syarat kartu kredit ke spreadsheet, kami menggunakan Thunderbit Chrome Extension untuk mengekstrak data terstruktur dari halaman harga dan fitur tiap tool. AI Thunderbit membaca tiap halaman dan menyarankan field — nama paket, detail free tier, harga berbayar, integrasi yang didukung — lalu menyusun output jadi spreadsheet yang siap diekspor.
Untuk workflow developer, Thunderbit Open API kasih pendekatan yang sama secara programatik. Pakai Distill kalau Anda ingin Markdown bersih untuk LLM atau RAG. Pakai Extract kalau Anda butuh field tertentu dalam JSON. Pakai Batch kalau Anda perlu memproses daftar halaman harga, URL dokumentasi, halaman produk, atau halaman kompetitor dan menerima hasil secara asynchronous.
Workflow-nya:
- Buka halaman harga vendor (Datadog, Checkly, UptimeRobot, dll.)
- Klik "One Click Extract" — AI Thunderbit membaca halaman, memahami strukturnya, dan mengisi tabel dalam satu kali jalan
- Gunakan subpage scraping untuk mengambil halaman harga, fitur, dan docs dari tiap vendor
- Ekspor ke Google Sheets, Excel, Airtable, Notion, atau CSV
Untuk tim API-first, workflow API-nya sama langsungnya:
- Dapatkan API key gratis dari Thunderbit
- Panggil endpoint Distill untuk Markdown bersih dari halaman publik mana pun
- Panggil endpoint Extract dengan deskripsi schema untuk JSON terstruktur
- Gunakan endpoint Batch dan webhook untuk daftar URL yang lebih besar
- Kirim output ke app, spreadsheet, warehouse, vector database, atau workflow monitoring Anda
Untuk perbandingan lintas 10+ vendor, copy-paste manual bisa gampang memakan 2–3 jam begitu Anda menghitung subpage harga, docs, dan halaman integrasi. Thunderbit memangkas waktu ekstraksi tahap awal kami jadi sekitar 15–30 menit, dengan sisa waktu dipakai untuk verifikasi dan pengambilan keputusan. Kalau tim ops, procurement, riset, atau AI product Anda sedang mengevaluasi tools dalam tekanan waktu, ini adalah jalan pintas yang praktis. Anda bisa baca lebih lanjut tentang workflow seperti ini di panduan web scraping tanpa coding, lihat harga API Thunderbit, atau cek channel YouTube untuk walkthrough.
Cara Memilih Tools Monitoring API Terbaik untuk Tim Anda
Tools monitoring API "terbaik" tergantung pada ukuran tim, kedalaman teknis, anggaran, dan seperti apa kegagalan berarti bagi produk Anda.
Solo dev nggak butuh Splunk. Enterprise yang teregulasi nggak boleh bergantung pada cron job. Tim produk API mungkin lebih butuh analytics pelanggan ala Moesif daripada ping uptime. Tim e-commerce harus memprioritaskan cek critical path untuk login, search, add-to-cart, checkout, dan otorisasi pembayaran. Tim produk AI atau data mungkin perlu ekstraksi data web ala Thunderbit sebelum membutuhkan observability penuh.
Tiga prinsip yang konsisten sepanjang riset saya:
- Cocokkan tool dengan use case Anda. Tabel pilihan cepat ada bukan tanpa alasan — mulai dari sana.
- Prioritaskan kualitas alert, bukan jumlah alert. Kalau tim Anda mengabaikan alert, berarti Anda nggak punya monitoring. Anda punya noise.
- Jangan remehkan kecepatan setup. Monitor yang aktif hari ini dan ngirim alert yang bisa dipercaya lebih baik daripada rencana platform sempurna yang membiarkan checkout nggak terpantau selama sebulan lagi.
Kalau Anda sedang membandingkan beberapa tool sekaligus dan ingin mempercepat riset, coba Thunderbit untuk mengekstrak data vendor secara massal ke satu spreadsheet. Kalau Anda membangun produk API, pipeline RAG, agent AI, atau workflow market intelligence yang butuh data web bersih, mulai dengan Thunderbit Open API. Ini mungkin nggak memilihkan tool monitoring untuk Anda — tapi akan membawa Anda ke keputusan lebih cepat, dan juga bisa memberi produk Anda sendiri layer data web yang andal.
FAQ Tentang Tools Monitoring API Terbaik
Apa tool monitoring API gratis terbaik di 2026?
Untuk kesederhanaan ala SaaS, UptimeRobot menawarkan 50 monitor gratis dengan interval 5 menit tanpa perlu kartu kredit. Untuk kontrol self-hosted, Uptime Kuma open-source, tanpa batas, dan punya UI yang bersih dengan 90+ layanan notifikasi. Untuk tim yang menginginkan kedalaman metrik dan sudah punya skill teknis, Prometheus + Grafana + Alertmanager adalah stack open-source terbaik — meski setup-nya butuh jam, bukan menit.
Kalau tujuan Anda bukan monitoring uptime melainkan mengekstrak data web lewat API, Thunderbit Open API punya free tier dengan 600 unit API sekali pakai, cukup untuk menguji distilasi halaman ke Markdown atau ekstraksi JSON berbasis schema sebelum scaling.
Apa perbedaan antara API monitoring dan APM?
API monitoring ngecek ketersediaan endpoint, response time, error, dan kebenaran data dari luar — mensimulasikan apa yang dialami user atau integrasi. APM (Application Performance Monitoring) masuk lebih dalam ke aplikasi: trace level kode, query database, error runtime, latensi antrian, dan dependensi layanan. Tools seperti Datadog dan New Relic menyediakan keduanya; UptimeRobot dan Uptime Kuma fokus pada cek uptime eksternal.
Thunderbit Open API beda dari keduanya: ini adalah API ekstraksi data web. Ia membantu Anda mengubah website eksternal menjadi Markdown atau JSON terstruktur, berguna untuk aplikasi LLM, workflow riset, pricing intelligence, dan pipeline data.
Seberapa sering saya harus memantau API?
API produksi yang kritis terhadap pendapatan (checkout, auth, payments) biasanya perlu dicek setiap 1 menit. API internal atau dengan traffic rendah sering kali cukup dicek setiap 5 menit. Namun frekuensi saja bukan segalanya — gunakan retry, beberapa region, dan assertion yang bermakna agar setiap cek cepat sekaligus bisa dipercaya. Cek 1 menit yang sering false alarm lebih buruk daripada cek 5 menit yang bisa diandalkan.
Untuk workflow ekstraksi data web, frekuensinya tergantung pada seberapa cepat sumber berubah. Halaman harga mungkin perlu diekstrak harian atau mingguan. Data inventory, travel, atau marketplace yang bergerak cepat mungkin memerlukan refresh per jam atau lebih sering. Batch API dan webhook Thunderbit berguna saat Anda perlu memproses banyak URL berdasarkan jadwal.
Bisakah saya memantau API tanpa menulis kode?
Bisa. UptimeRobot, Better Stack, dan Uptime Kuma bisa dipakai sepenuhnya lewat GUI. Checkly mendukung setup lewat GUI maupun code. Postman menggunakan interface berbasis collection. Prometheus/Grafana biasanya memerlukan YAML dan PromQL. Datadog dan New Relic bisa dimulai lewat setup terpandu, tapi jadi lebih kuat dengan instrumentation yang lebih dalam.
Kalau Anda ingin mengekstrak data website tanpa menulis kode, Chrome Extension Thunderbit adalah jalur no-code-nya. Kalau Anda ingin mengotomatiskan workflow yang sama dari aplikasi, Thunderbit Open API memberi developer endpoint Distill, Extract, dan Batch.
Bagaimana cara mengurangi alert fatigue dari monitoring API?
Pilih tools dengan alerting cerdas: anomaly detection (Datadog, New Relic), retry-before-firing (Checkly), behavioral anomaly (Moesif), atau grouping/silencing (Prometheus Alertmanager). Mulailah dengan alert yang lebih sedikit tapi lebih tinggi tingkat keyakinannya, fokus pada dampak ke user. Gunakan alert SLO burn rate вместо threshold statis, lakukan deduplication lintas layanan, routing berdasarkan ownership, dan ukur actionability — kalau kurang dari 20% alert Anda benar-benar menghasilkan tindakan, kurangi noise dulu.
Coba Thunderbit Open API untuk Ekstraksi Data Web Get Started Free
Pelajari Lebih Lanjut



