
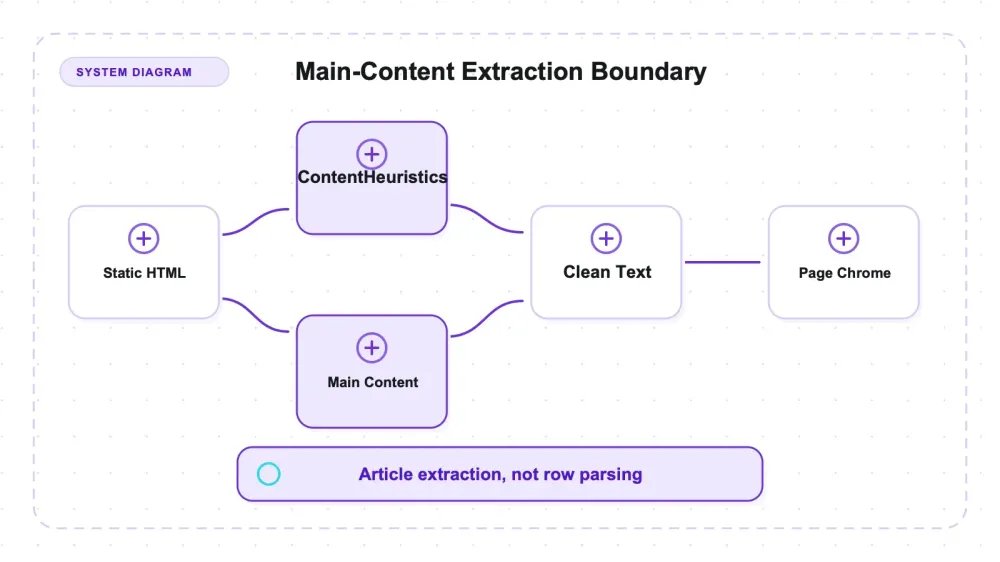
trafilatura הוא מחלץ תוכן לפייתון שעובד בלי דפדפן. מבין דפי הבדיקה המתויגים במאמר הזה, היריב היחיד באיכות החילוץ מאותו HTML הוא Mozilla Readability: trafilatura פספס יחידת boilerplate אחת מתוך 17, בעוד Readability פספסה חמש. כלים שמבוססים על דפדפן מופיעים כאן רק בהקשר של טביעת רגל תפעולית, ולא עברו בדיקות איכות על הדפים האלה.
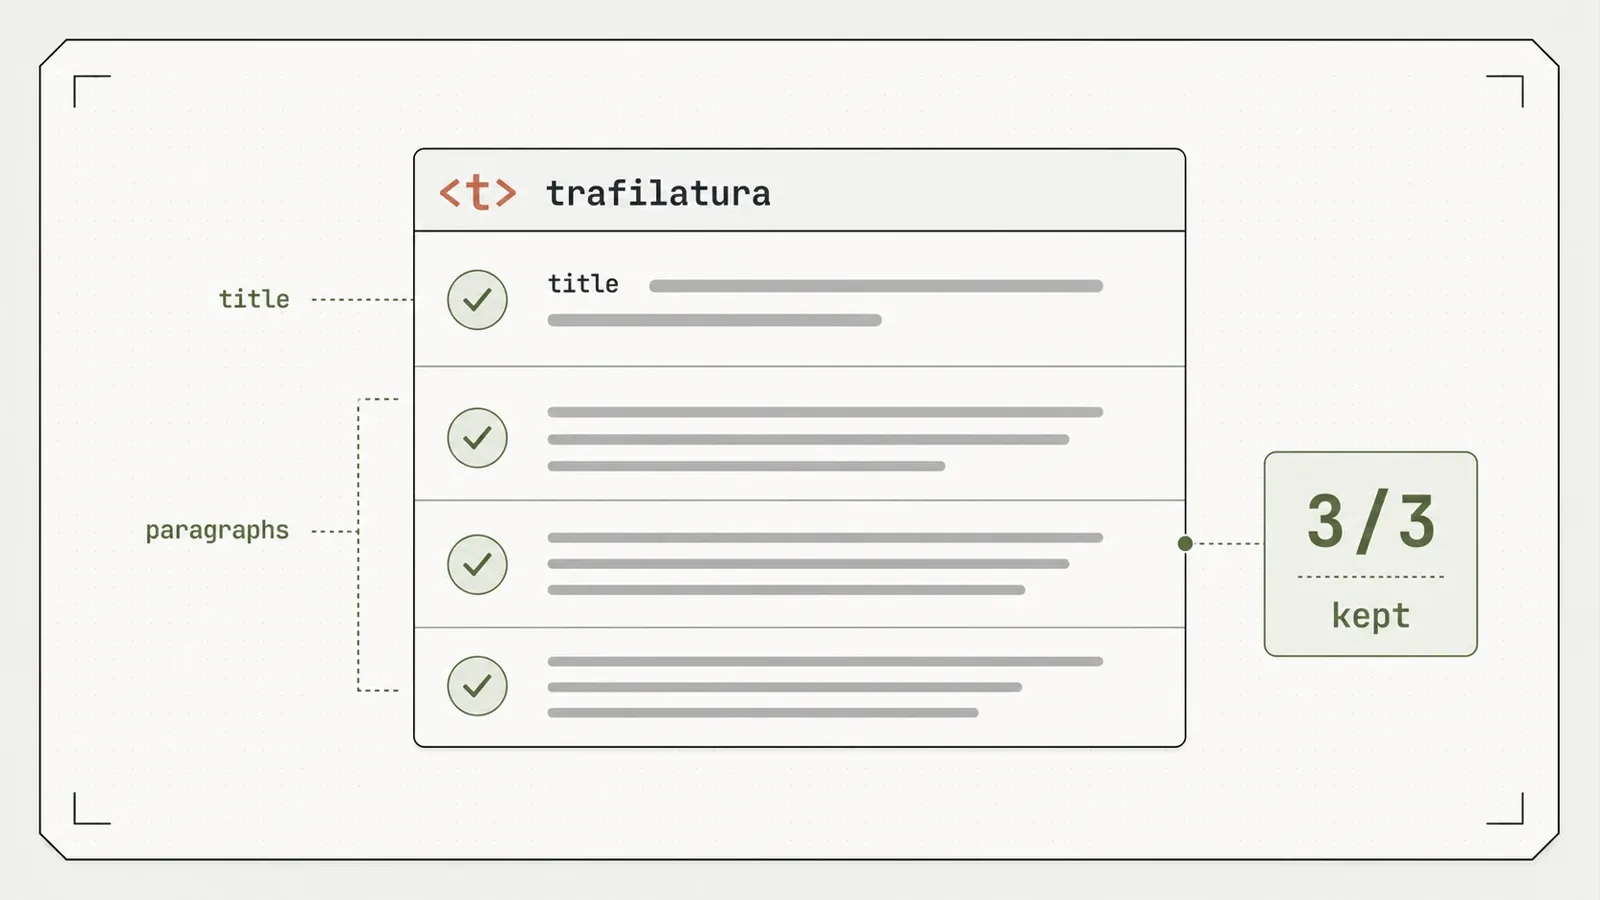
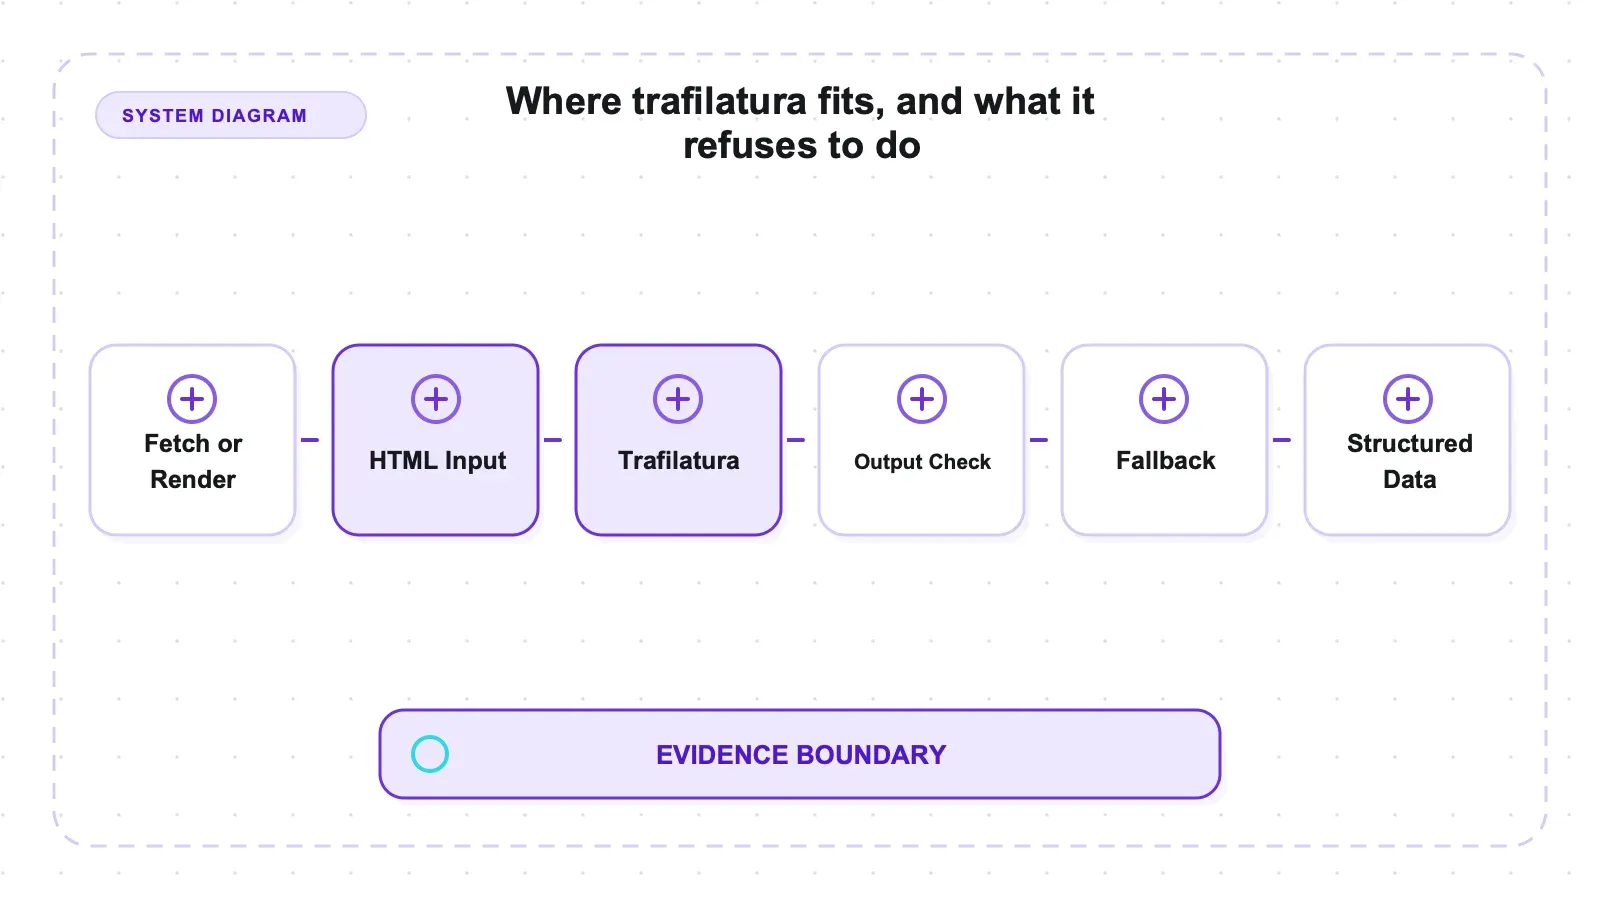
התפקיד המרכזי שלו הוא חילוץ התוכן העיקרי: HTML נכנס, וטקסט ומטא־דאטה בסגנון מאמר יוצאים, כשהאלמנטים הנלווים של הדף מסוננים לפי היוריסטיקות. אפשר לייצא את הפלט כ־JSON ובפורמטים נוספים, אבל הוא לא מייצר סכמת שורות מוגדרת מראש או רשומות קטלוג חוזרות ומסוגות. נבדקה גרסה 2.1.0. הוא לא מריץ JavaScript, וההשוואה מול Readability מראה פשרה בין דיוק לשימור תוכן, לא ניצחון גורף בכל קטגוריה.
איפה trafilatura משתלב, ומה הוא לא מנסה לעשות
trafilatura מתאר את עצמו ככלי בפייתון ובשורת הפקודה לאיסוף טקסט ומטא־דאטה מהאינטרנט — crawling, scraping, extraction — עם פלט כ־CSV, JSON, HTML, Markdown, TXT או XML. זו הצהרת יכולות רחבה. בפועל, החלק שבאמת מגדיר את הכלי צר יותר וחד יותר: הוא מקבל מסמך HTML ומחזיר את התוכן המרכזי, כשהרעש והקישוטים של הדף מוסרים.
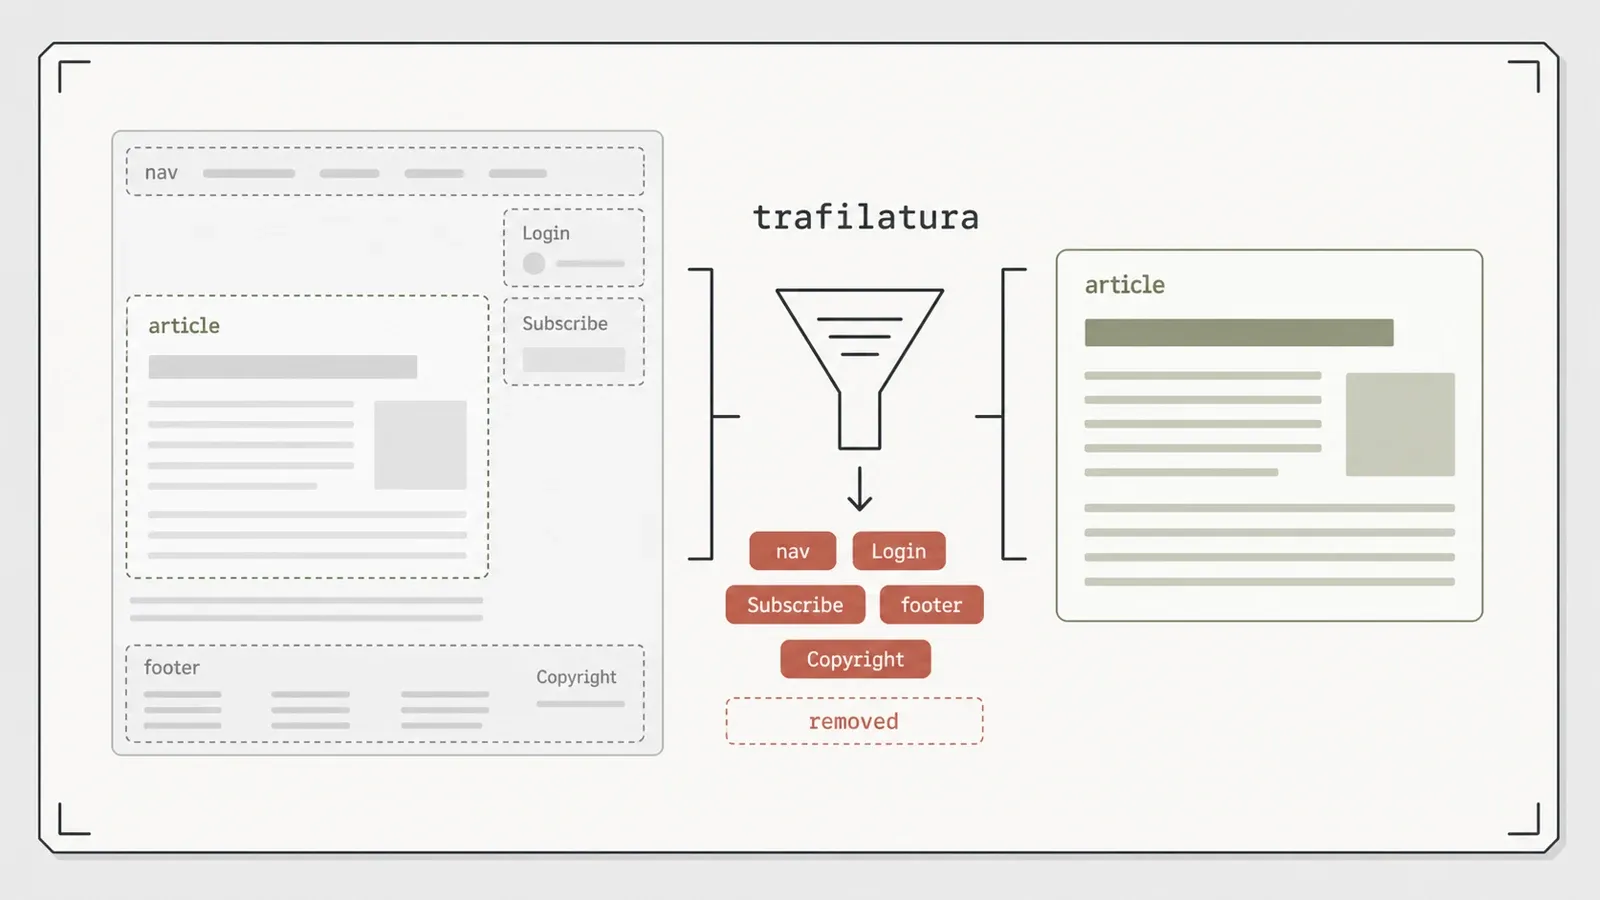
הנה מודל החשיבה, כי הוא מסביר גם את החוזקה וגם את הגבול. רוב כלי ה-scraping שמכוונים אליהם בעמוד עובדים לפי סלקטורים — אומרים להם "קח את האלמנט עם המחלקה product-price", והם מחזירים את מה שנמצא בכתובת הזו. trafilatura עובד הפוך. הוא קורא את כל המסמך ומחליט אילו בלוקים הם המאמר האמיתי ואילו הם boilerplate, בעזרת היוריסטיקות של תוכן ולא בעזרת סלקטור שכתבתם. לכן הוא לא צריך חוקים ייעודיים לכל אתר כדי לנקות דף. וזה גם בדיוק למה הוא לא יכול להחזיר לכם קטלוג מובנה: אין סכימה, אין שורות מסוגות, רק "הנה הטקסט המשמעותי". זהו מחלץ, לא מפרש שאתם מכוונים.
הוא גם לא דורש runtime של דפדפן שמורידים בנפרד. עץ התלויות כולל wheel-ים לפלטפורמה כמו lxml, כך ש“אין הורדת דפדפן” לא אומר התקנה שמבוססת רק על קוד מקור או חסרת קוד נייטיב.
התקנה: טביעת רגל תלותית קטנה, בלי דפדפן
pip install trafilatura בתוך virtualenv חדש על Python 3.14 התקין 17 חבילות; ה־wheel הגדול ביותר שתועד היה lxml במשקל 8.6 MB, לפי pip-install-trafilatura.log. לא נדרשה התקנת דפדפן נפרדת או פקודת post-install לדפדפן.
כדי להשוות בהיקף, חבילת Scrapling באותו בסיס מחקר דרשה ארבע הרצות pip נפרדות כדי לגרום ל-fetchers לעבוד, והסתיימה עם 26 חבילות, שתיים מהן הן wheel-ים של Playwright בגודל 42.2 MB (tools/scrapling/artifacts/logs/pip-install-scrapling.log) — וזה עוד לפני שמורידים binary של דפדפן. חבילת Crawlee מדדה את ההורדה הנפרדת של Chromium בכ־81.7 MiB (tools/crawlee/research-materials.md). הכלים האלה עושים עבודה רחבה יותר, אז זו לא השוואה הוגנת מבחינת יכולות; זו פשוט מה שהדיסק וה־CI cache שלכם רואים. והגרסה שקיבלתי מ־pip (2.1.0) זהה לגרסה הנוכחית, כך שאין כוכבית של "בדקתם משהו מיושן" על הנתונים למטה.
ניסיון מעשי: מה המחלץ באמת החזיר
הרצתי אותו מול fixtures שנבנו כדי לפגוע גם בנקודת החוזקה שלו וגם בקיר שלו, כשהפלטים הגולמיים שמורים ב-benchmark repo. מבחן המאמר הוא זה ששכנע אותי.
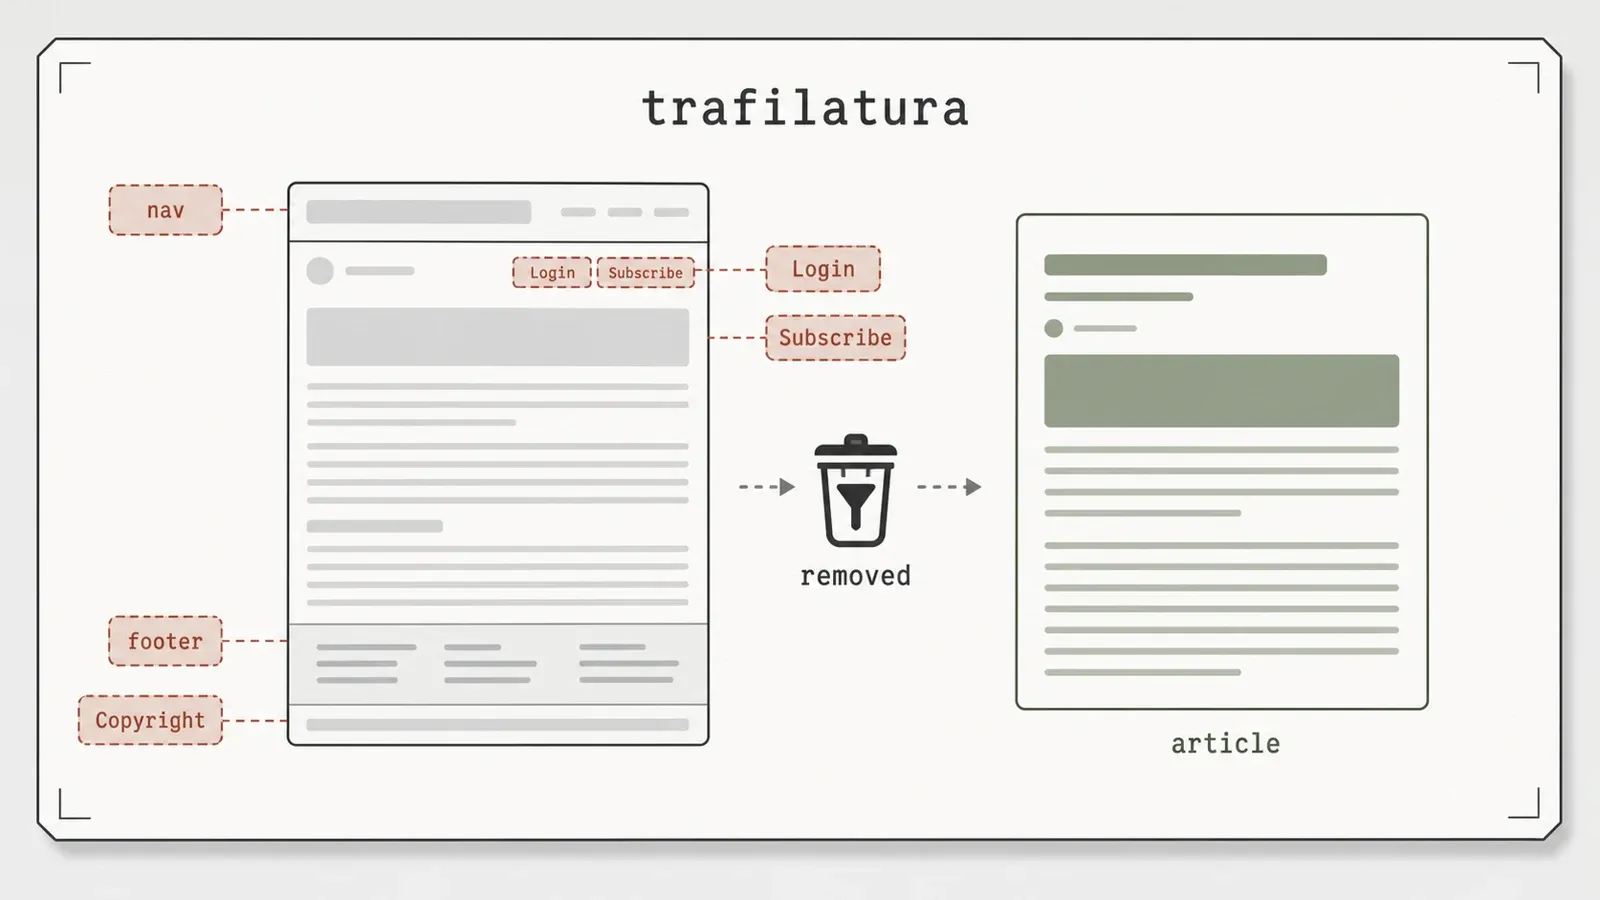
לקחתי fixture מקומי של מאמר ועטפתי את התוכן האמיתי ברעש: בקשת התחברות, הודעת "Subscribe", קישורי ניווט, כותרת תחתונה של זכויות יוצרים — אותו boilerplate סטנדרטי שסקרייפר נאיבי היה מושך יחד עם הגוף. trafilatura החזיר את הכותרת וכל 3 מתוך 3 פסקאות הגוף, וכל סימוני ה-boilerplate האלה — Login, Subscribe, Copyright — נעלמו מהפלט. מעבר לטקסט, הוא שלף נכון גם את המחבר והתאריך ממטא־דאטת הדף. התוצאה המלאה, ב־.txt, .md ו־.json, נמצאת ב-results/local_article.json.
אותו HTML שנשמר יובא כטקסט רגיל, Markdown ו־JSON. המאמר לא מוכיח שכל שלושת הפורמטים הגיעו מקריאה סימולטנית אחת; אלה דרכי סריאליזציה חלופיות של מסלול החילוץ. JSON כאן עוטף טקסט ומטא־דאטה מחולצים, לא רשומות חוזרות ומוגדרות על ידי המשתמש.
הנה כל הריצה הראשונה במקום אחד, כדי שתוכלו לבדוק את הטענות למעלה במקום לקבל אותן כמובן מאליו:
| Fixture | מה חזר | זמן ריצה | ראיה |
|---|---|---|---|
| מאמר מקומי, עטוף ב-nav / login / subscribe / copyright | כותרת + 3/3 פסקאות, אפס דליפת boilerplate, מחבר Thunderbit Research Lab, תאריך 2026-07-09 | 0.007 שנ׳ | local_article.json |
| קטלוג מוצרים מקומי | 12 שמות מוצרים ו-12 מחירים כטקסט שטוח, 0 שורות מובנות, 478 תווים | 0.064 שנ׳ | local_catalog_extraction.txt |
| דף שמחזיר HTTP 500 | fetch_url החזיר None, בלי לזרוק חריגה | 30.012 שנ׳ | local_failure_500.json |
| דף מוצר מ-Books to Scrape (ציבורי) | 1,324 תווים של טקסט נקי, ועוד התאום ב-Markdown | 0.753 שנ׳ | public_books_product.txt / .md |
כל שורה נקראת מתוך artifacts/raw/trafilatura-test-summary.json בחבילת trafilatura — trafilatura 2.1.0, Python 3.14, macOS arm64, ריצה אחת על מכונה אחת. התייחסו לזמנים כאל תצפיות, לא כאל בנצ'מרק.
ב־fixture של ה-500, fetch_url החזיר None אחרי בערך 30 שניות, בזמן שנקודות קצה מקומיות סמוכות היו מהירות. הריצה מוכיחה את ההשהיה, לא אם retry/backoff, timeout קבוע או מסלול פנימי אחר גרמו לה. המאמר הזה לא אימת פרמטר timeout נתמך ברמת קריאה ל־fetch_url; השליטה המוכחת היא להביא עם קליינט שנמצא בשליטת הקורא, ואז להעביר את ה־HTML שנוצר ל־trafilatura.
אותם מבחנים גם חושפים שלושה גבולות.
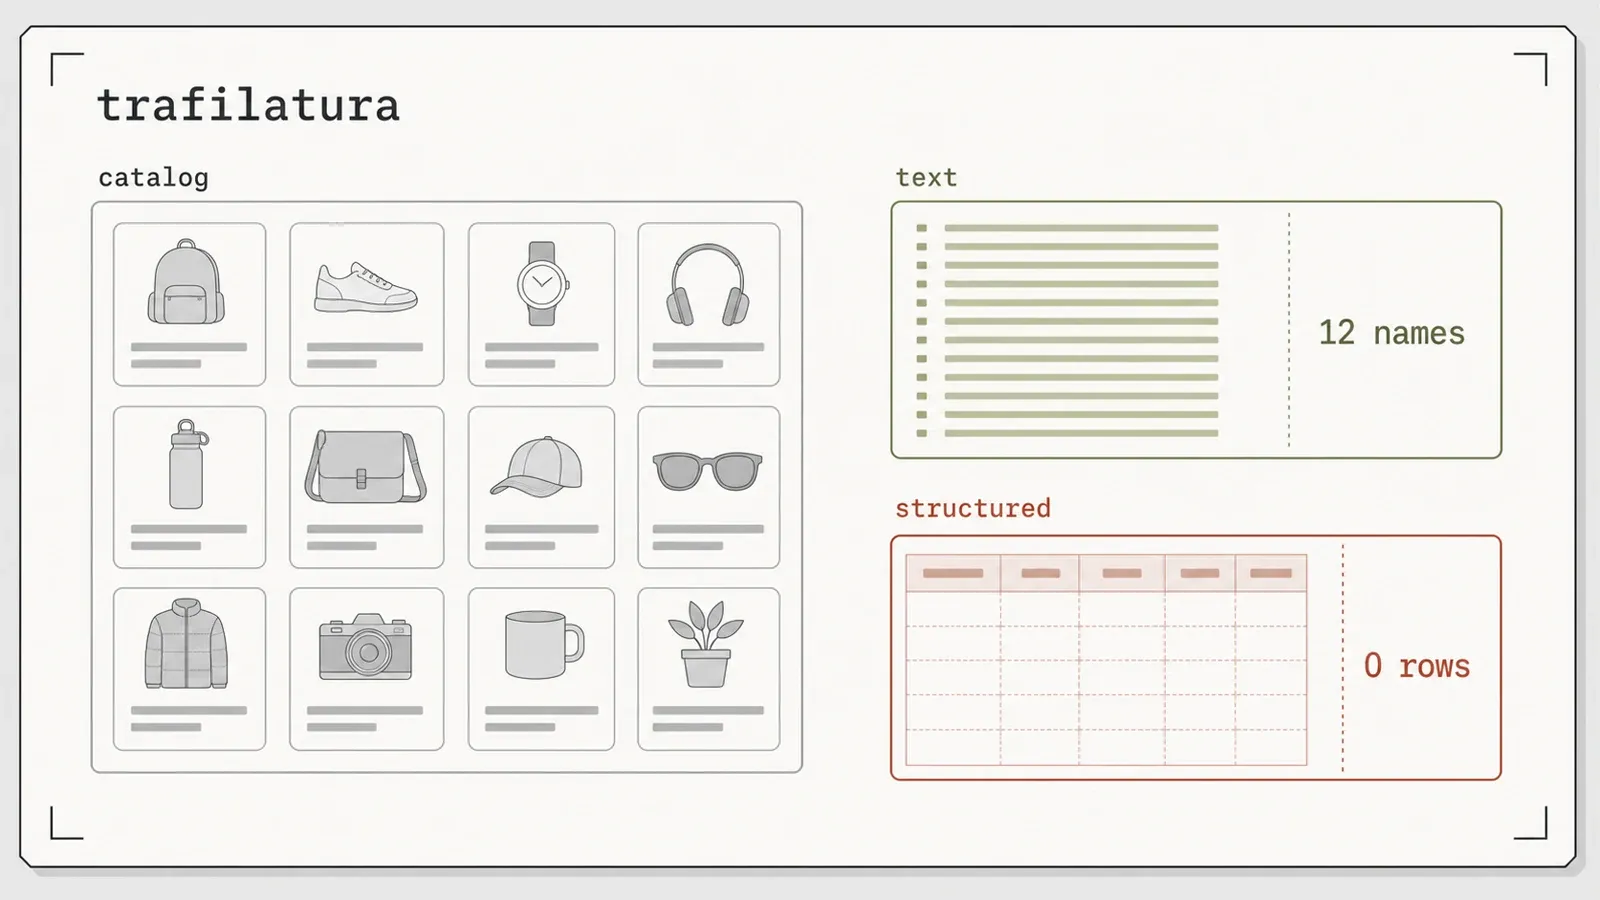
ראשית והכי חשוב: trafilatura הוא מחלץ תוכן, לא סקרייפר מובנה. הרצתי אותו על fixture של קטלוג מוצרים. הוא החזיר את כל 12 שמות המוצרים — כטקסט — ודיוק 0 של שורות מובנות (478 תווים של טקסט שטוח, לפי results/local_catalog_extraction.txt). המחירים עברו גם כן, מ־$18.00 עד $51.00, כל אחד בשורה משלו מתחת לשם המתאים. כל מה שרציתם נמצא בתוך הפלט; אף אחד מהם לא נמצא כשדה. אם אתם צריכים [{name, price, rating}, …], זה הכלי הלא נכון, ושום שינוי הגדרות לא יהפוך אותו לכזה — זו בחירת תכנון, לא באג.
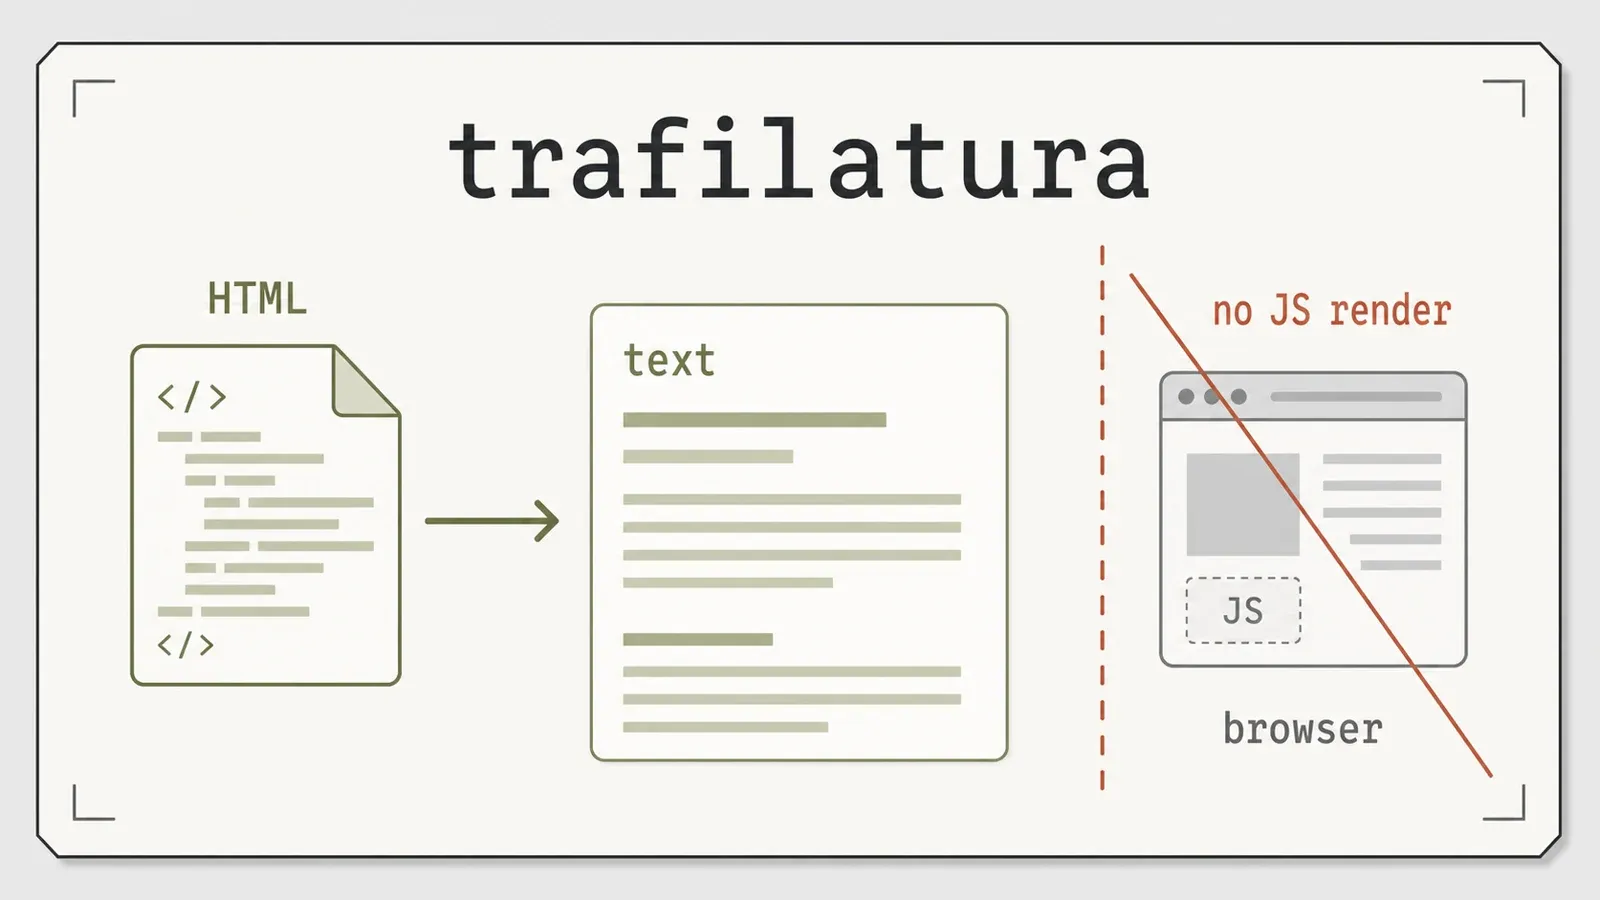
שנית: הוא לא מרנדר JavaScript. הוא צורך HTML סטטי. אם תפנו אותו לעמוד שמרונדר בצד הלקוח, תקבלו את מה שהשרת שלח לפני שה־JS רץ, ולעיתים קרובות זה פשוט לא שימושי. אם היעדים שלכם כבדים ב־JS, חברו לו renderer; trafilatura לא יעשה את החצי הזה במקומכם.
שלישית, הסתייגות לגבי הראיות שלי: מבחן החילוץ הציבורי הראשון השתמש בבלוק תיאור מוצר, לא במאמר חדשות אמיתי, כי בסביבת הבדיקה הציבורית אין דפי חדשות. תוצאת ניקוי המאמר למעלה מגיעה מ־fixture מקומי מבוקר. אני סומך עליה — הסרת ה-boilerplate חד-משמעית — אבל לא רציתי להלביש דף מוצר כהוכחה לחילוץ ברמת חדר חדשות, ולכן החבילה שמרה את זה כפער פתוח. ריצה חוזרת ב־2026-07-14 סגרה אותו, והתוצאות הן בסעיף הבא.
בדיקת sanity של boilerplate מדפים אמיתיים
שני דפים אמיתיים נמשכו פעם אחת, נשמרו כ־fixtures לא מקוונים עם hash מסוג SHA-256, ואז הורצו שוב בלי גישה לרשת. לא נרשמו זמנים או ground truth מתויג. זוהי בדיקת sanity ל-boilerplate בדפים אמיתיים, לא ציון נאמנות.
| Fixture של מאמר אמיתי | HTML גולמי | גוף מחולץ | גוף/גולמי | דגלי page-furniture שהוסרו | title | date | hostname | author | sitename |
|---|---|---|---|---|---|---|---|---|---|
| Wikipedia, "Web scraping" | 230,049 bytes | 26,673 bytes | 0.116 | 4 מתוך 4 | yes | 2005-09-17 | wikipedia.org | null | null |
| Wikinews, "7th Heaven" (archived) | 79,716 bytes | 2,200 bytes | 0.028 | 5 מתוך 5 | yes | 2005-11-29 | wikinews.org | null | null |
שתי השורות מגיעות מ־artifacts/results/trafilatura-fidelity-summary.json. הדגלים שנבדקו היו "Jump to content", "Privacy policy", "Powered by MediaWiki", "This page was last edited", ובנוסף "free news source" בדף Wikinews — כולם הוסרו, אף אחד לא דלף, בשני הדפים.
היחס body/raw מודד צמצום, לא דיוק; תוכן מאמר שהושמט לא קיבל ניקוד. author ו־sitename היו null בשתי תבניות MediaWiki האלה, בעוד ה-fixture המקומי המבוקר סיפק author. זו החמצה ספציפית ל־MediaWiki שנצפתה בבדיקה, לא הוכחה לאמינות כללית של byline. התאריכים המחולצים מדווחים כפי שהוחזרו ולא אומתו מול ground truth.
שני מחלצים, אותם בתים של HTML, סקריפט ניקוד אחד
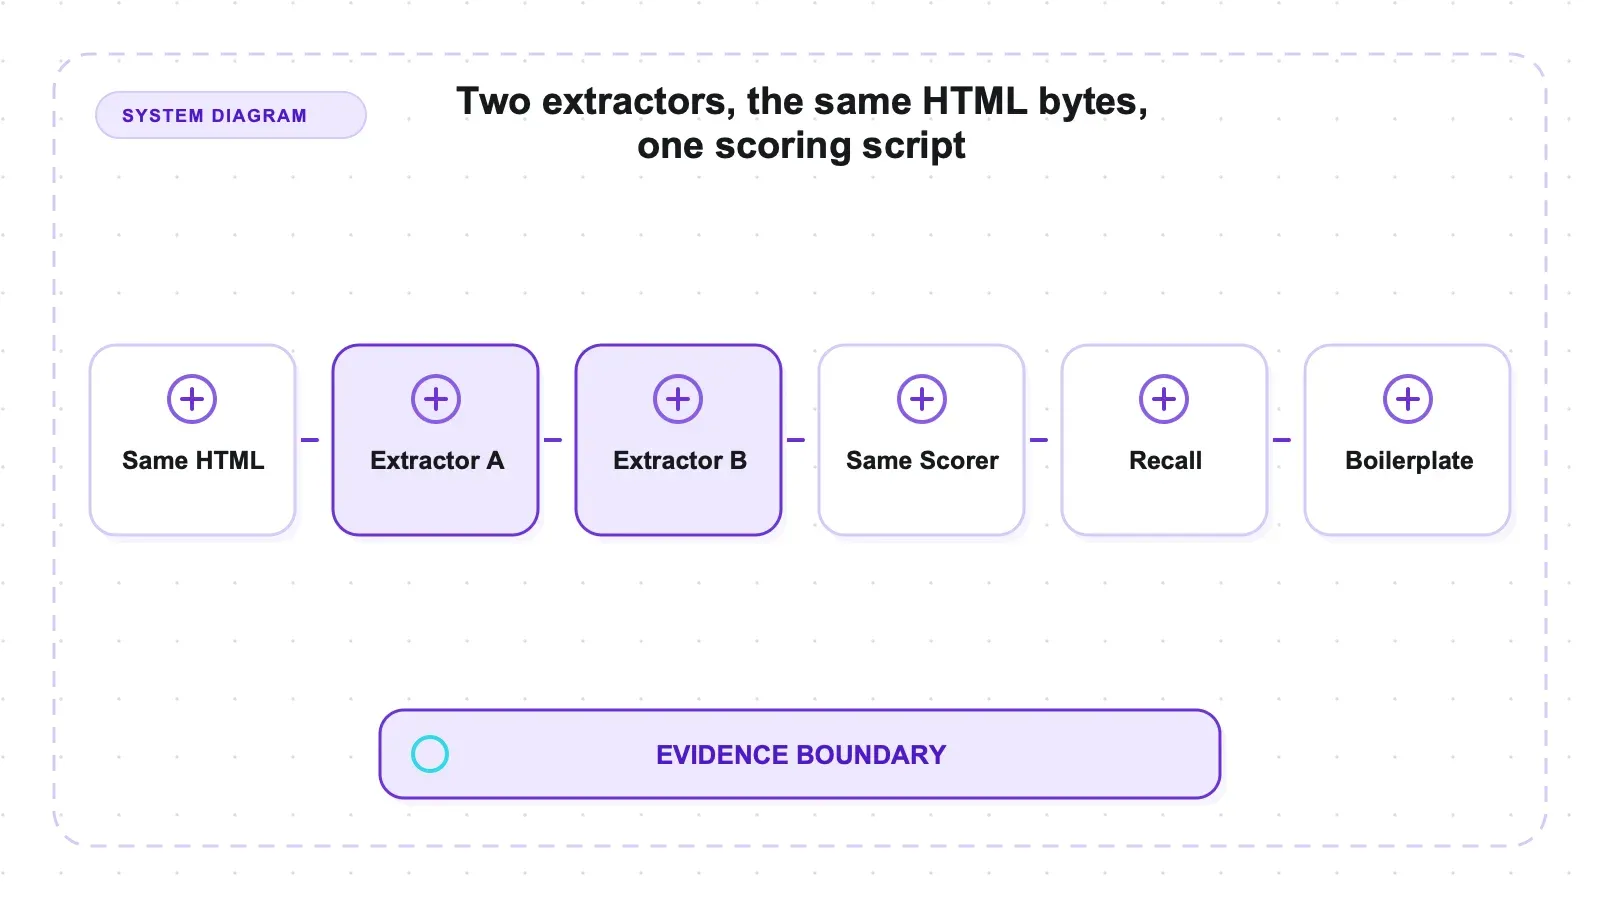
יש בדיוק השוואה אחת באותו testbed ל-trafilatura בבסיס המחקר הזה, וחבילת trafilatura עצמה לא בנתה אותה. חבילת mozilla-readability בנתה אותה, כזרוע בקרה: 22 fixtures מתויגים ידנית, שבהם כל בלוק טקסט מסומן כ-ARTICLE או BOILERPLATE, וכל מילה נושאת token סנטינל ייחודי, כך שכל מילה מחולצת יכולה להיות משויכת בדיוק לבלוק מתויג אחד. שני הכלים קיבלו בדיוק אותם בתים של HTML. Readability רצה תחת jsdom 29.1.1 על Node v22.22.3; trafilatura רצה על המפרש שלו עצמו.
| מדד (ממוצע מיקרו, סט content-fidelity) | trafilatura 2.1.0 | @mozilla/readability 0.6.0 | ראיה |
|---|---|---|---|
| יחידות מאמר ששוחזרו | 40 מתוך 40 | 40 מתוך 40 | comparison.json |
| יחידות boilerplate שזלגו | 1 מתוך 17 | 5 מתוך 17 | comparison.json |
| tokens של boilerplate שזיהמו את הפלט | 3 | 41 | comparison.json |
| דיוק token | 0.939 | 0.902 | comparison.json |
| F1 של token | 0.969 | 0.948 | comparison.json |
recall של non-prose, fixture f6_nonprose | 7 מתוך 8 | 8 מתוך 8 | comparison.json |
F1 במאמר קצר מאוד, fixture f3_short_120 | 0.571 | 0.800 | comparison.json |
מקור: tools/mozilla-readability/artifacts/raw/comparison.json בבסיס המחקר הזה — 11 fixtures בסט content-fidelity, 40 יחידות מאמר ו-17 יחידות boilerplate. אלה fixtures סינתטיים שנשענו בכוונה על מקרי קצה אגרסיביים, אז צריך לקרוא אותם כמנגנון, לא כדירוג של קורפוס אמיתי.
אף כלי לא מנקה הכול, והפיצול הזה הוא הדבר המעניין. trafilatura שומר את רעשי הממשק בחוץ — בלוק דלוף אחד מול חמישה ב-Readability, שלושה tokens מזהמים מול 41. זהו חצי הדיוק של "טקסט מאמר נקי", והחצי שקובע אם חלון ההקשר של ה-LLM שלכם מתמלא בקישורי sidebar. אבל Readability משחזרת תוכן ש-trafilatura זורק: ב-fixture הלא-פרוזאי, trafilatura הפיל <figcaption> ש-Readability שמרה, ובמאמר קצר מאוד הוא קיבל 0.571 מול 0.800 של Readability. ניקוי אגרסיבי הוא עסקה, לא ניצחון חינם. אם הקורפוס שלכם מלא בקטעי קצה, כיתובים ודפים כבדי טבלאות, העסקה הזו עובדת נגדכם.
איך להפוך את ההשוואה למבחן בחירה
התחילו בהגדרה איזה סוג שגיאה יקר יותר לצינור שלכם. אם אלמנטים נלווים צורכים tokens downstream או מזהמים תוצאות חיפוש, דליפת boilerplate וספירת tokens מזהמים צריכים לקבל משקל גבוה יותר. אם אובדן של כיתוב, פוסט קצר או בלוק non-prose אינו מתקבל על הדעת, recall של תוכן לפי צורת הדף צריך לקבל משקל גבוה יותר. סט ה-fixtures המשותף הופך את העסקה לגלויה, אבל הוא לא מחליט איזה משקלים נכונים לארכיון חדשות, לקורפוס תיעוד או ל-pipeline של שליפה.
הקשר רחב יותר של stress-test נמצא ב-השוואת הזיכרון וה-HTML הפגום של עשר ספריות.
בנו את מבחן ההשוואה מתוך HTML שנשמר, ולא מתוך URLs חיים, כך ששני המחלצים יקבלו בדיוק אותם בתים. כללו מאמרים רגילים ארוכים, הודעות קצרות, קטעים כבדי כיתובים, מסמכים כבדי טבלאות או קוד, ותבניות מכל מפרסם שאתם באמת קולטים ממנו נתונים. תייגו מספר קטן של יחידות תוכן נדרשות ובלוקי boilerplate ידועים לפני הרצת אחד הכלים. אחר כך נקדו בנפרד פלט ריק, שחזור של יחידות נדרשות, דליפה של יחידות לא רצויות ושדות מטא־דאטה. ציון איכות מצטבר אחד יכול להסתיר בדיוק את מצב הכשל שבאמת חשוב תפעולית.
כדאי גם לאמת את חוזה הפלט downstream. ה-JSON של trafilatura יכול לשאת תוכן ומטא־דאטה מחולצים, אבל סריאליזציית JSON אינה אותו דבר כמו סכמת שורות מסוגות. עבור טקסט של מאמר, בדקו אורך גוף מינימלי וסימנים נדרשים במקום לקבל כל פלט שאינו ריק. עבור מטא־דאטה, הבחינו בין היעדרות לערכים שגויים ושמרו גם את כתובת המקור ואת גרסת החילוץ כדי שאפשר יהיה לשחזר החמצות.
את שלב ה-fetch יש לבדוק כשכבה נפרדת. תצפית הכשל המקומית של 30 שניות שייכת ל־fetch_url, לא לחילוץ מ־HTML שכבר נמצא אצלכם, והמנגנון הפנימי שלו לא הוכח. אם deadlines, retries, אימות או מדיניות proxy חשובים לכם, השתמשו בלקוח שההתנהגות שלו בשליטתכם, תעדו את בתיי התגובה הסופיים, והעבירו את הבתים האלה למחלץ. כך מפרידים בין כשלי acquisition לבין כשלי בחירת תוכן, וההשוואות נעשות שחזרות.
לבסוף, מדדו מאפייני פריסה בפלטפורמה היעודה. ההתקנה של 17 חבילות על Python 3.14 לא דרשה דפדפן נפרד, אבל זה לא קובע throughput, גידול בזיכרון, זמינות wheel-ים בכל ארכיטקטורה, או התנהגות תחת workers מקבילים. המאמר הזה מוכיח מנגנון דיוק/שימור מול Readability; התאמה לייצור עדיין תלויה בקורפוס ובבדיקות זמן ריצה.
לבדיקת עזר חיצונית שאינה עבודה של בסיס המחקר הזה, עמוד ההערכה של trafilatura עצמו עמוד ההערכה שלו וה-ScrapingHub article-extraction-benchmark הציבורי מציבים אותו לפני readability-lxml ב-word-F1 על פני כ-181 דפים אמיתיים — כיוון זהה לטבלה למעלה. הסתייגות אחת שרוב הסקירות שמצטטות את הבנצ'מרק הזה מדלגות עליה: ה-F1 המפורסם של trafilatura (~0.945) קשור לענף ישן יותר, 0.5.1, ולא ל-2.1.0 שנבדקה כאן.
יתרונות וחסרונות
יתרונות:
- דליפת boilerplate מתויג נמוכה יותר מ-Readability בסט ה-fixtures המשותף: בלוק אחד מתוך 17 מול 5.
- שלף נכון מחבר ותאריך ב-fixture המקומי, ובשני דפי המאמר האמיתיים title/date/hostname.
- אותו HTML יכול להיות מסוריאל כטקסט, Markdown או JSON.
- התקנה של 17 חבילות בלי runtime נפרד של דפדפן.
- כשל שקט:
fetch_urlמחזירNoneעל HTTP 500 במקום לזרוק חריגה. - הגרסה שנבדקה זהה לגרסה האחרונה (2.1.0) — בלי סטיית גרסאות.
- רישיון Apache-2.0 — מקל ונוח לשימוש מסחרי.
חסרונות:
- לא סקרייפר מובנה: מבחן הקטלוג החזיר 12 שמות ו-12 מחירים כטקסט ו-0 שורות מסוגות. אין סכימה, אין שדות.
- אין rendering ל-JavaScript — רק HTML סטטי; נדרש renderer נפרד לדפים בצד לקוח.
authorו־sitenameחזרו כ-null בשני דפי MediaWiki אמיתיים, כך שחילוץ byline אינו מובטח.- ניקוי אגרסיבי עולה במחיר: הוא הפיל
<figcaption>ש-Readability שמרה, וקיבל 0.571 מול 0.800 של Readability במאמר קצר מאוד. - ה-500 השקט הזה לקח 30.012 שניות כדי להחזיר
None; השתמשו ב-fetcher שבשליטתכם כשצריך שליטה ב-deadline. - הסורק המובנה ל-crawl/sitemap ופורמטי הפלט CSV/XML לא נבחנו בסבב הזה, ולכן אין לי טענות לגביהם.
למי הוא מתאים — ולמי עדיף לוותר
trafilatura מיועד לחילוץ תוכן מרכזי בסגנון מאמר. הוא מועמד טוב לבניית קורפוסים טקסטואליים, ארכיונים קריאים או קלט ל-NLP מתוך HTML סטטי כשניקוי היוריסטי מקובל עליכם. ההשוואה על ה-fixtures המשותפים תומכת בדליפת boilerplate נמוכה יותר מ-Readability, בעוד Readability שמרה יותר במקרים הקצרים והלא-פרוזאיים.
דלגו עליו אם מה שאתם באמת צריכים הוא חילוץ מובנה — שורות מוצרים עם מחיר, רשומות מסוגות, שדות key: value — כי הוא נותן לכם טקסט, לא טבלאות (מבחן הקטלוג שחזר את כל 12 השמות ואת כל 12 המחירים, ו-0 שורות). דלגו עליו גם אם היעדים שלכם מרנדרים תוכן בדפדפן ואתם לא מוכנים להוסיף renderer נפרד, כי trafilatura קורא HTML סטטי ועוצר שם. ותחשבו פעמיים אם הקורפוס שלכם מורכב בעיקר מקטעים קצרים, כיתובי תמונה ודפים כבדי טבלאות: ב-fixtures המתויגים, זה בדיוק המקום שבו הניקוי שלו חותך לתוך תוכן אמיתי (0.571 F1 במאמר הקצר מאוד, <figcaption> שנעלם). התאימו את הכלי למשימה: טקסט מלא של מאמר — כן; JSON מובנה, דפי JS או קטעים בני 100 מילים — חפשו מקום אחר.
חלופות, כולל איפה Thunderbit משתלב
trafilatura הוא ספרייה עצמאית תחת Apache-2.0, ללא עמלת ספק פר קריאה; עלויות חישוב, רוחב פס, fetch, ניטור ותחזוקה נשארות אצל המפעיל. הוא מטפל בחילוץ בסגנון מאמר מתוך HTML שסופק לו, אבל לא בהרצת דפדפן או בסכמות שורות חוזרות שמוגדרות על ידי המשתמש.
לאותם fixtures בכל ששת המחלצים, ראו את השוואת החילוץ בין שש ספריות.
שירות מנוהל יכול לשים acquisition, rendering ויצירת סכימה מאחורי גבול של ספק. אנחנו בונים את Thunderbit, אבל לא הרצנו אותו על ה-fixtures האלה, לכן המאמר הזה לא תומך בהשוואת איכות, rendering, latency, anti-bot או עלות. ההחלטה היא בין שליטה עצמית ב־HTML-to-content לבין גבול מנוהל של acquisition וחילוץ מובנה.
סקירות בנצ'מרק קשורות: ההשוואה המלאה של הסקרייפרים בקוד פתוח, סקירת Markdown של Crawl4AI שמבוססת דפדפן, ו-סקירת Markdown של Firecrawl בהתקנה עצמית.
נסו את Thunderbit לחילוץ נתונים מהאינטרנט
פסק דין
כדאי לשקול את trafilatura כשהמשימה היא חילוץ בסגנון מאמר מתוך HTML סטטי, והעדיפות שלכם היא סינון boilerplate מתויג. ב-fixtures המשותפים הוא דלף יחידת boilerplate אחת מתויגת מול חמש של Readability. היתרון הזה הגיע עם שימור נמוך יותר ב-fixtures הקצר מאוד והלא-פרוזאי, כך שצורת הקורפוס צריכה להכריע.
הוא לא מריץ JavaScript ולא מפיק שורות חוזרות שמוגדרות על ידי המשתמש. בשני דפי MediaWiki, author ו־sitename חזרו כ-null, תצפית שקשורה לתבנית. Readability שמרה את הכיתוב ש-trafilatura הפילה וקיבלה ציון גבוה יותר ב-fixture המסומן f3_short_120; הראיה הגלויה תומכת ב"F1 נמוך יותר ב-fixture הקצר מאוד", לא בספירת תווים או בטענה שהפלט היה משובש.
נסו את Thunderbit לחילוץ נתונים מהאינטרנט Get Started Free
שאלות נפוצות
איזה מבנה trafilatura מחזיר? אפשר לסריאל את התוכן והמטא־דאטה שחולצו כ־JSON, Markdown, טקסט, HTML, XML או CSV. זו סריאליזציה מובנית, אבל לא סכמת שורות חוזרות שמוגדרת על ידי המשתמש כמו שם מוצר, מחיר ודירוג. ב-fixture של הקטלוג הערכים חזרו כתוכן שטוח ולא כשורות מסוגות.
האם trafilatura יכול לסרוק קטלוג מוצרים לשורות מובנות? לא. זהו מחלץ תוכן, לא סקרייפר מובנה. ב-fixture של קטלוג הוא החזיר את כל 12 שמות המוצרים כטקסט שטוח ו-0 שורות מובנות — השמות נמצאים בפלט, אבל הם לא שדות. אם אתם צריכים רשומות מסוגות כמו name/price/rating, השתמשו במקום זאת בפסֵר מבוסס סלקטורים או ב-API לחילוץ שמבוסס על סכימה.
האם trafilatura מרנדר JavaScript? לא. הוא צורך HTML סטטי בלבד. אם תפנו אותו לעמוד שמרונדר בצד הלקוח, תקבלו את מה שהשרת שלח לפני שה-JavaScript רץ, ולעיתים קרובות זה לא התוכן שאתם מחפשים. חברו לו renderer נפרד אם היעדים שלכם כבדי JS.
האם קשה להתקין את trafilatura?
ב-virtualenv של Python 3.14 שנבדק, ההתקנה משכה 17 חבילות ולא דרשה runtime נפרד של דפדפן. ה-wheel הגדול ביותר שתועד היה lxml במשקל 8.6 MB. בנוסף, קריאת 500 מקומית אחת לקחה 30.012 שניות כדי להחזיר None; אם אתם צריכים deadline מאומת, השתמשו בלקוח HTTP שבשליטתכם.
האם trafilatura חינמית לשימוש מסחרי? כן, היא תחת רישיון Apache-2.0, שהוא מקל ונוח לשימוש מסחרי. כרגיל, מומלץ לאמת את הרישיון הנוכחי ב-repo לפני שבונים עליו.




