
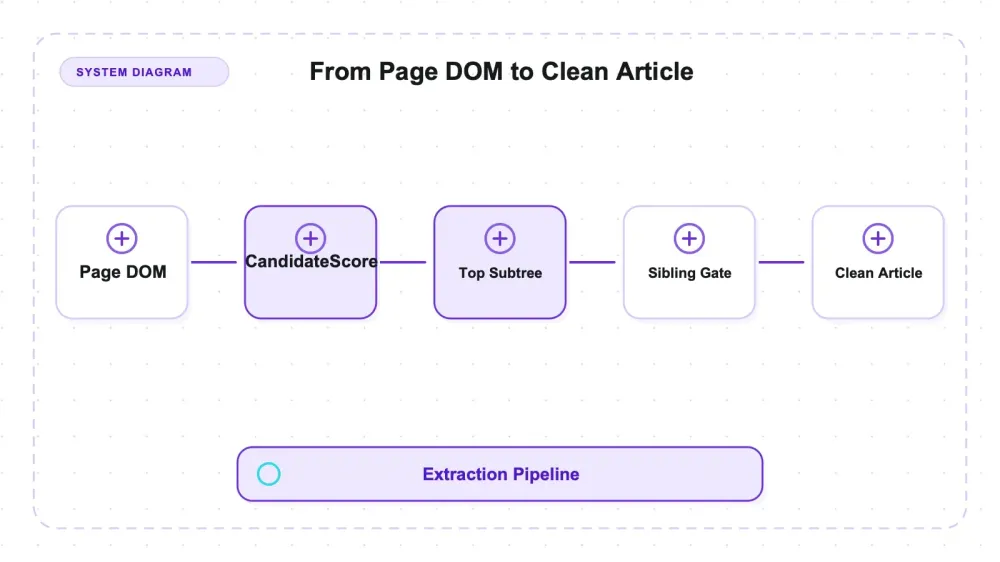
Mozilla's Readability הוא מימוש JavaScript עצמאי של המחלץ שמפעיל את Firefox's Reader View. הוא מפורסם כחבילת Apache-2.0 בשם @mozilla/readability, ומאתר את תוכן המאמר מתוך DOM חי. לכן, ב-Node הוא זקוק למימוש DOM כמו jsdom. הוא לא מבצע הבאת דפים, לא מריץ JavaScript של הדף, ולא מפיק נתונים לפי סכמה.
הגרסה שנבדקה היא npm latest ב-0.6.0, שפורסמה ב-3 במרץ 2025, ובזמן הבדיקה שלי ב-27 ביולי 2026 היו לריפו 11,361 כוכבים (ה-push האחרון היה ב-9 ביולי 2026, כך ש-main מתקדם בהרבה מהחבילה שפורסמה). הרצתי אותה תחת jsdom 29.1.1 על Node v22.22.3, ב-macOS arm64, מול 22 תבניות HTML מתויגות שנבנו במיוחד לצורך הניסוי, וכל המדידות כאן מגיעות מהמערך הזה. מבחינת עבודה ידנית זה הכלי הכי פחות תובעני בקטגוריה: שתי דקות להתקנה, בלי בינאריים, בלי דפדפן שיושב במטמון, ותוצאה זהה בכל הרצה חוזרת. מה שהופך אותו למעניין הוא לא השימוש בו — אלא שהכשלים שלו ניתנים לניבוי מתוך כמה קבועים בקוד המקור, ואחד מהם קובע יותר ממה שהמסמכים מרמזים.
ב-22 תבניות סינתטיות ומבוקרות, Readability שחזר את כל 74 מקטעי המאמר שסומנו. אבל התוצאה הזאת לא אומרת שהוא אף פעם לא מאבד טקסט: בבנצ'מרק ציבורי של דפים אמיתיים מדווח Recall של 0.982, וצורות תקלה ידועות לא חזרו כאן. הכשל הבולט ביותר בתבנית היה תוכן אחים נוסף שנכנס דרך שער link-density ברמת המקור, עם סף 0.25. החומרה הנראית שלו משתנה לפי סביבת הבדיקה.
מה בעצם readability.js הוא, ומה הוא לא
Readability הוא שלב ניקוד מבוסס חוקים מעל DOM. הוא עובר על רכיבי מועמדים, מעניק לכל אחד ציון תוכן, מעביר את הציונים להורים, בוחר את תת-העץ בעל הציון הגבוה ביותר, ואז מבצע שלבי ניקוי שמסירים מה שנראה כמו רכיבי מעטפת של הדף. זו כל אסטרטגיית חילוץ המאמר — בלי מודל, בלי נתוני אימון, בלי חוקים ייעודיים לאתר מסוים. בגלל זה הוא עובד גם על דף שמעולם לא ראה — ובגלל זה הכשלים שלו ניתנים לצפייה מתוך הקוד, וזה החלק המעניין.
שלושה דברים שהוא לא, וכולם מבלבלים אנשים:
- לא מבצע fetch. הוא מקבל
document, לא URL. הבאה, ניסיונות חוזרים, הגנות נגד בוטים וכותרות HTTP — זה כבר באחריותך. - לא renderer. אין הרצת JavaScript. מה שנמצא ב-DOM שאתה מוסר לו — זה מה שהוא רואה.
- לא מחלץ מבנה נתונים. תקבל
title,byline,excerpt,content(HTML),textContent,length,siteName. אין סכמה, אין שורות מטיפוס מובנה, ואין{name, price}.
ארבעה קבועים עושים את רוב העבודה
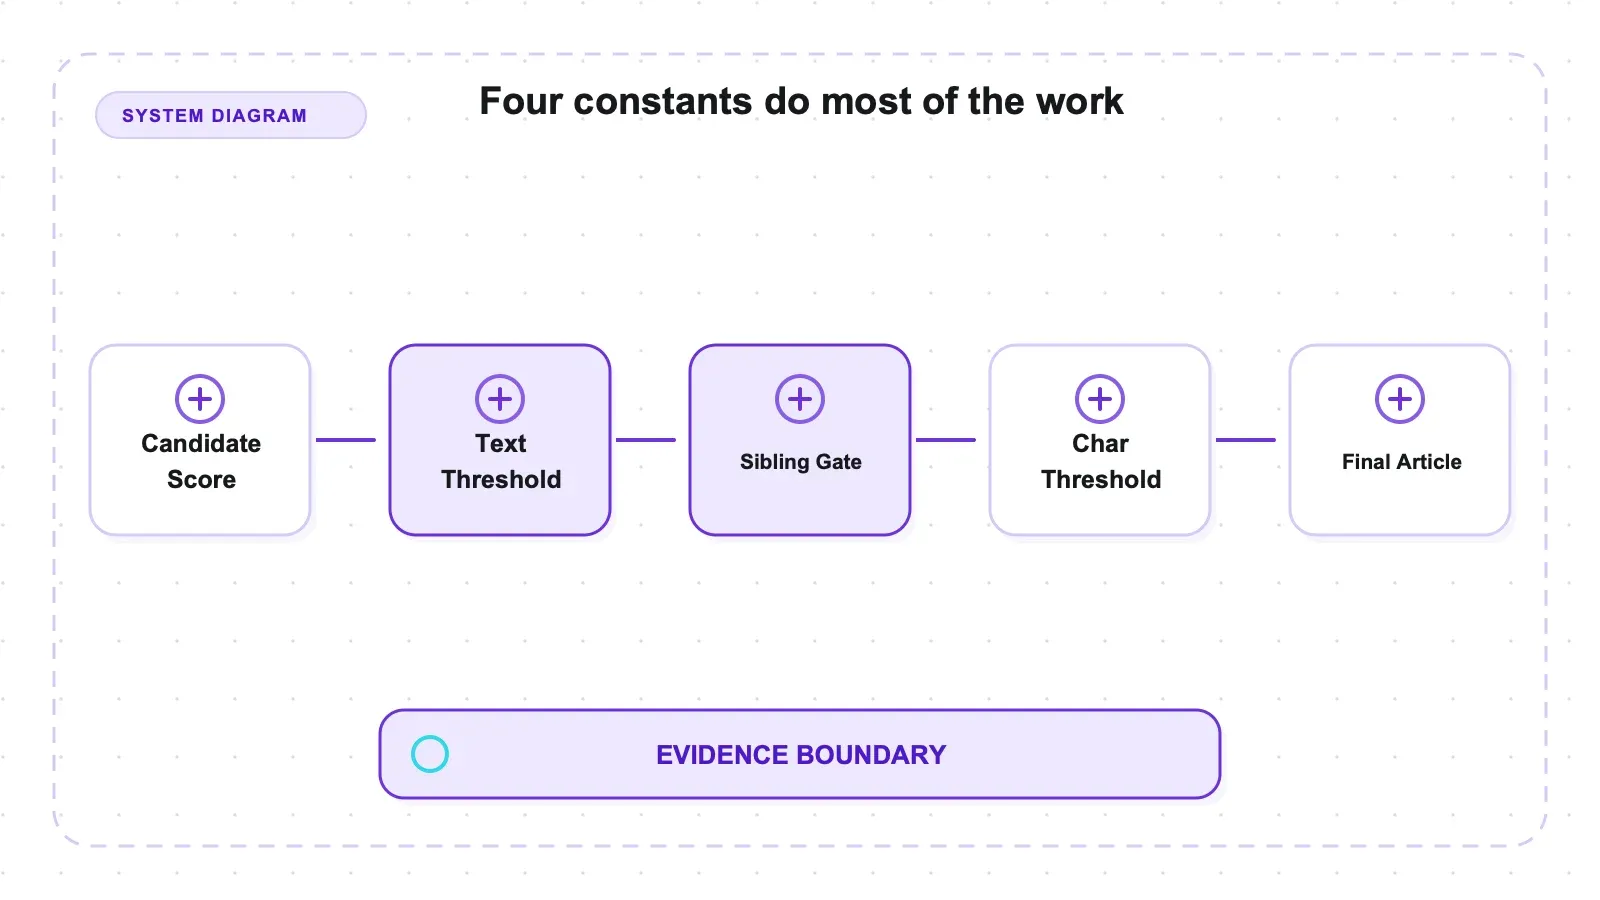
קריאה של Readability.js מתוך node_modules מלמדת יותר על ההתנהגות מכל עמוד תיעוד. ארבעה מנגנונים אחראים לרוב מה שהספרייה עושה:
- ציון תוכן לכל פסקה מנוקדת:
1 + (commaCount + 1) + min(floor(len / 100), 3). פסקאות קצרות מ-25 תווים לא נספרות בכלל. הציונים עוברים להורים עם מחלקים — ההורה מקבל את מלוא הניקוד, הסב חצי, ואבות רחוקים יותר לפיlevel · 3. DEFAULT_CHAR_THRESHOLD = 500— אורך המאמר המינימלי לצורך ניתוח "מוצלח". מתחת לזה, מופעל שוב מסנן שמנסה לחלץ את הטקסט עם פחות שלבי ניקוי.- ביטוי ה-
unlikelyCandidates— תואם substrings של class ו-id כמוcomment,footer,menu,related,sidebar,social,sponsor. צמתים תואמים נזרקים לפני שלב הניקוד. - שער צירוף האחים ב-
grabArticle— אחרי בחירת המועמד המוביל, בודקים האם לצרף את ה-siblings שלו. אחים מצורפים אם הציון שלהם עובר את הסף, או אםnodeLength > 80 && linkDensity < 0.25, או אםnodeLength < 80 && nodeLength > 0 && linkDensity === 0 &&יש בהם נקודה.
Link density היא Σ(linkText.length · coef) / textLength, עם coef = 0.3 ל-#-href רגיל ו-1 בכל מקרה אחר. השער הזה מסביר את הדליפות שנמדדו כאן; הוא לא כל אלגוריתם החילוץ.
ההגדרה, והתלות שלא מופיעה במצגת
npm install @mozilla/readability jsdom ואתה בפנים. שתי דקות, בלי בינאריים, בלי הורדה לאחר ההתקנה, בלי דפדפן במטמון. בציר ההתקנה זה כמעט אידיאלי.
אבל "ללא תלויות" מתייחס לאלגוריתם, לא לזמן הריצה. Readability עובד על document חי, וב-Node זה אומר שאתה מספק מימוש DOM — במקרה שלי jsdom, בגרסה 29.1.1. jsdom עצמו לא קטן, וברוב הצינורות הוא העלות הדומיננטית בלולאה, לא החילוץ. צריך לתקצב את זה.
עוד מלכודת אחת שעלתה לי בהרצה חוזרת: Readability.parse() משנה את ה-DOM שהוא מקבל. אם תנתח את אותו מסמך jsdom פעמיים, הקריאה השנייה תראה מסמך שהראשונה כבר פירקה. כל parse במערך שלי בונה jsdom חדש. אם אתה עושה לולאה על דפים ומשתמש מחדש באובייקט Document כדי לחסוך זמן, זו הבאג שתדווח עליו.
איך בדקתי את זה
לא כיוונתי את זה לאתרי חדשות חיים. דפים חיים נותנים לך ציון בלי דרך להבין למה — ובשיטה היוריסטית, ה"למה" הוא כל הערך. לכן יצרתי 22 תבניות HTML עם 91 בלוקים מתויגים (74 מאמר, 17 boilerplate), שבהן כל מילה בבלוק מקבלת קידומת של מחרוזת sentinel ייחודית לאותו בלוק. אוצר המילים בין הבלוקים מנותק, כך שטוקן שהופק ממופה לבלוק יחיד, ו-"שוחזר" או "דלף" הם בדיקת שיוך מדויקת ולא התאמה רופפת.
שלב החילוץ ושלב הניקוד מופרדים בכוונה. ראנר ה-Node מפיק רק את הטקסט הגולמי שחולץ, את ערכי ה-isProbablyReaderable, ואת צפיפויות ה-link שנמדדו. כל מדדי ה-precision וה-recall מחושבים לאחר מכן מהטקסט הגולמי מול התיוגים, באמצעות סקריפט נפרד. אין אף קבוע של מדד שנכתב ידנית במערך, וזו הדרך היחידה שבה אני סומך על המספרים שלי.
אחר כך הזנתי את אותם בתים בדיוק ל-trafilatura 2.1.0 להשוואה על אותו testbed. כל תבנית נותחה שלוש פעמים; כולן החזירו טקסט זהה-בייט-בייט בכל הרצה.
אפשר לבדוק כל שלב במקום להסתמך על טבלת הסיכום. tests/build_fixtures.mjs יוצר את ה-HTML המסומן ואת ה-ground truth; tests/run_readability.mjs מתעד את תוצאות החילוץ והמנבא; ו-tests/metrics.py מדרג את הרשומות בדיעבד. פלט ה-Readability הגולמי, המדדים שחושבו וההשוואה על קלט זהה שמורים ב-artifacts/raw/. ההפרדה הזו חשובה כשנראה שמשהו חשוד: אפשר לדעת אם המנתח החזיר טקסט לא צפוי, אם קבוצת התוויות הייתה שגויה, או אם קוד הניקוד סיווג לא נכון. שחזור על החבילה הזו מאמת את הטענות כאן, אבל זו עדיין בדיקת harness — לא הוכחה שלדפים אמיתיים בפריסה יש אותה התפלגות כשלים.
מגבלת ההיקף היא אמיתית ומשמעותית: אלו דפים סינתטיים מבוקרים, לא קורפוס מהעולם האמיתי. הנתונים הסמכותיים על דפים אמיתיים מגיעים מה-article-extraction-benchmark הציבורי, שמדרג את readability_js 0.6.0 — בדיוק הגרסה שנבדקה כאן — על word-F1 0.947 ± 0.005 (precision 0.914 ± 0.008, recall 0.982 ± 0.003) על פני בערך 181 דפים אמיתיים. אני מצטט את זה; לא שיחזרתי את הניסוי.
כאן נעשה שימוש בשורות בנצ'מרק של המהדורה הנוכחית; שורות היסטוריות שהוחלפו הושמטו. התבניות המבוקרות מוסיפות פירוק לפי בלוק שמראה איזה מבנה תוכן מפעיל איזה כלל, במקום להחליף את קורפוס הדפים האמיתי.
ה-Recall היה מושלם בחבילת התבניות הסינתטית
74 מתוך 74. לאורך כל 22 התבניות, Readability לא איבד אף בלוק מאמר שסומן — ובאחת-עשרה התבניות הסינתטיות הנקיות ששילבו מאמר ו-boilerplate, ה-micro-averaged token recall הגיע ל-1.000. אף משפט מאמר לא נעלם.
שתי הסתייגויות מצורפות לזה:
אלו דפים סינתטיים נקיים, בעמודה אחת. מאמרים אמיתיים מקוננים עמוק יותר, משלבים מודעות באמצע הגוף, ולעיתים מאבדים את הפסקה הראשונה שלהם בגלל ארטיפקט של הניקוד — סוג התקלה הזה מדווח ב-tracker (#437, #901, ו-content-before-a-table ב-#922). התבניות שלי לא הפעילו אף אחת מהן, אז אני לא טוען שתוקנו — אני אומר שהבדיקה שלי לא הגיעה אליהן. בדפים אמיתיים ה-Recall של הבנצ'מרק עבור הגרסה הזו הוא 0.982, לא 1.000.
ובכל זאת, הכיוון של התוצאה הוא החלק החשוב. הבעיה של Readability היא לא שהוא זורק את המאמר שלך. אלא מה שהוא מביא איתו.
מספר ה-Precision, ולמה צריך שלוש תוויות
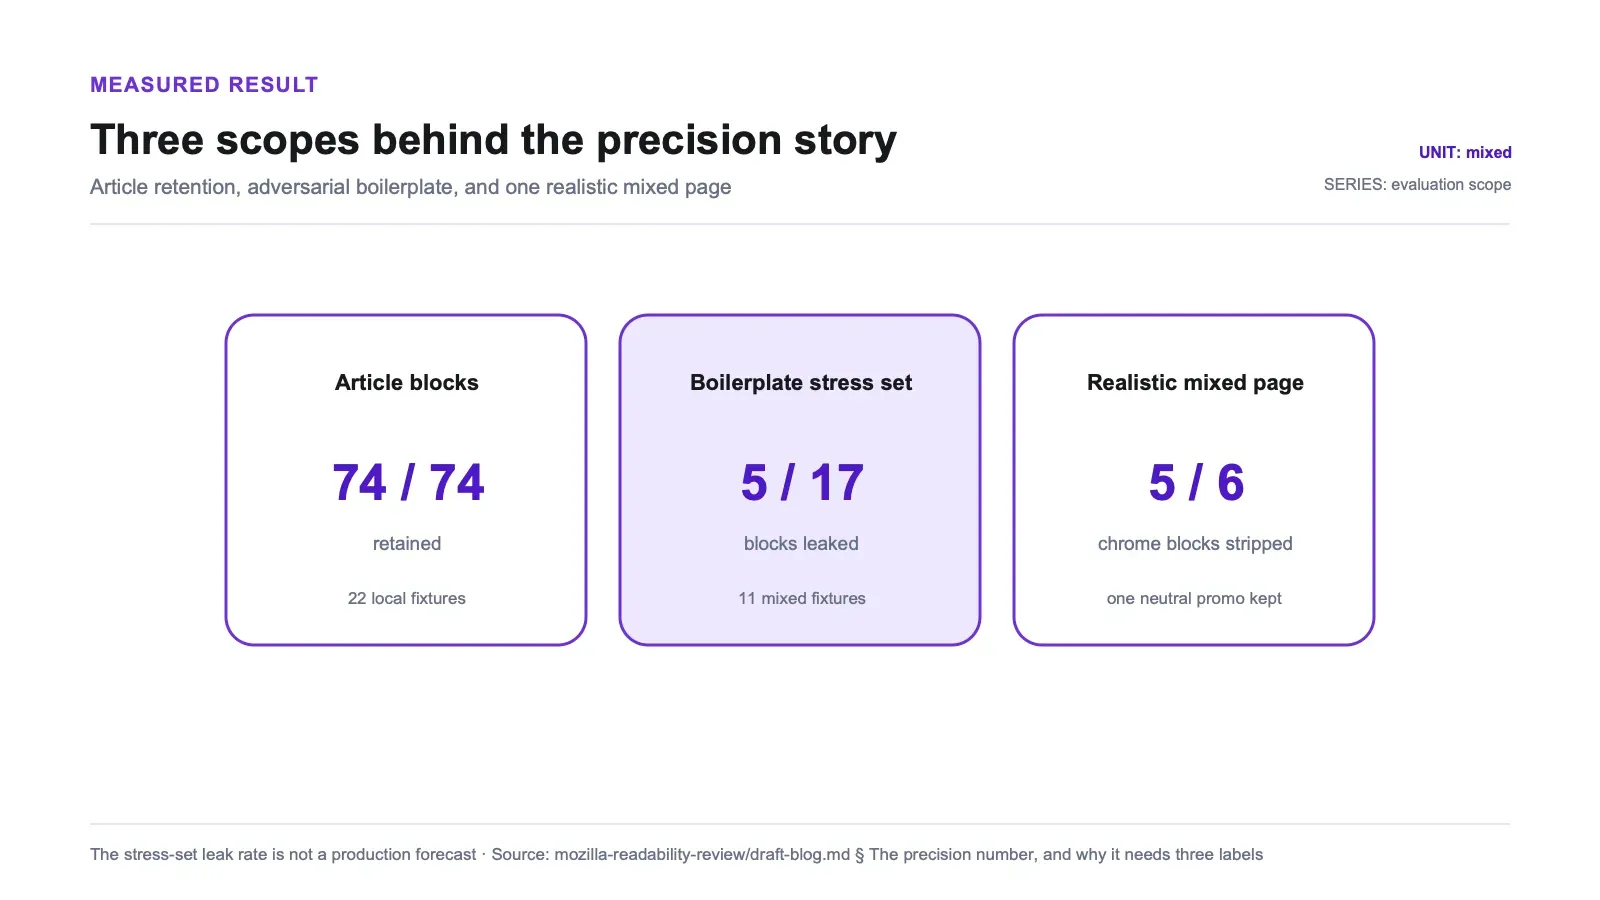
מספר אחד קל לצטט וקשה להגן עליו. באחת-עשרה התבניות המעורבות, Readability שמר 5 מתוך 17 בלוקי boilerplate — שיעור דליפה של 0.294.
זה לא שיעור דליפה מהעולם האמיתי. שלוש סביבות שונות מודדות שלושה דברים שונים, ורק אחת מהן מתארת דפים רגילים:
| מה המספר מודד | תוצאה |
|---|---|
| סט תבניות משוקלל-אדברסרי — 6 מתוך 11 הדפים המעורבים נבנו במכוון כדי לנצח את שער האחים | 5 מתוך 17 בלוקי boilerplate נשמרו (0.294) |
הדף הריאליסטי היחיד — גוף <article> מוקף ב-nav, באנר פרסומת, sidebar, תגובות, footer, ועוד promo אחד עם class נייטרלי | 5 מתוך 6 בלוקי מעטפת הוסרו; 1 נשאר |
| ~181 דפים אמיתיים, בנצ'מרק ציבורי (לא ההרצה שלי) | precision 0.914, recall 0.982, word-F1 0.947 — readability_js 0.6.0 |
קראו את השורה הראשונה כבדיקת עומס, לא כתחזית. Readability לא מדליף 29% מה-boilerplate בעולם האמיתי. בדף הריאליסטי, כל מה שנשא class שה-unlikelyCandidates regex תואם — nav-menu, ad-banner, sidebar, comments, site-footer — הוסר נקי, כולם חמישה. הניצול היחיד היה הבלוק היחיד שבניתי כך שינסה להתחמק מה-regex הזה.
שער ה-0.25: איפה הסרת ה-boilerplate נעצרת
כלל צירוף האחים מתועד בקוד המקור. אבל מה שאף אחד לא מדד, ככל הידוע לי, הוא בדיוק איפה הוא מתהפך. אז בניתי גרדיאנט: <p class="teaser-block"> נייטרלי מחוץ ל-<article>, מאמר מובהק בן ארבע פסקאות שמובטח לנצח כמועמד המוביל, וכל מה שמשתנה הוא אורך ה-promo וצפיפות הקישורים שלו. הצפיפויות מחושבות לפי הנוסחה של Readability עצמה, ונמדדות בזמן ריצה ולא לפי הנחה:
| בלוק Promo | אורך הטקסט הפנימי | מעל 80 תווים | Link density שנמדדה | תוצאה |
|---|---|---|---|---|
| בלי קישורים בכלל | 126 | כן | 0.000 | נשמר |
| קישור קצר אחד | 126 | כן | 0.143 | נשמר |
| קישור ארוך יותר | 126 | כן | 0.278 | הוסר |
| חצי מהטקסט מקושר | 126 | כן | 0.476 | הוסר |
| משפט יחיד, נגמר בנקודה | 60 | לא | 0.000 | נשמר |
| אותו טקסט, בלי נקודה | 59 | לא | 0.000 | הוסר |
התנאי בקוד משתמש בסף 0.25; הדוגמאות שנמדדו תחמו אותו, עם 0.143 שנשמר ו-0.278 שהוסר. ענף נפרד שמר משפט בן 60 תווים שמסתיים בנקודה והסיר גרסה בת 59 תווים בלי נקודה. ה-Recall של המאמר נשאר 4/4 בכל ענף, כך שהדוגמאות האלה מבודדות אפקט של Precision.
מחוץ ל-harness, השער הזה אומר בפועל: פרוזה ארוכה, עם מעט קישורים, וללא סימן מזהה, שנמצאת ליד המאמר — נחשבת למאמר. וזה מתאר הרבה דברים שאינם המאמר — תקציר "קריאה נוספת" שנכתב כפסקה, פיץ' לניוזלטר, הערת עורך, או טיזר ממומן שצוות שיווק ניסח במשפטים מלאים כשהקישור הוסר לצורכי מעקב.
באינדקס RAG, פסקת promo עם מעט קישורים יכולה להפוך ל-chunk שחולץ, וליצור סיכון שבשלב retrieval או generation יתייחסו אליה כתוכן מאמר. כלל המקור הופך את כשלון-המצב הזה לסביר; הביקורת הזו לא הריצה הערכה מלאה של retrieval או quotation מול מודל.
לצורך סינון קשיח ברמת אתר, אפשר לבצע pre-filter למכלי DOM ידועים במקור, לשמור את שרשרת האבות של צומת המקור להשוואה לפני serialization, או להחיל בהמשך סינון טקסט מבוקר ומאומת היטב. HTML שהוחזר לבדו כבר לא בהכרח שומר אם צומת ישב במקור מחוץ למכל הראשי. שער האחים אינו ניתן לכיוון דרך האפשרויות הציבוריות.
שלוש הנחות שהתבניות הפריכו
התבניות הפריכו שלוש הנחות: ש-charThreshold דוחה מאמרים קצרים, שתגיות סמנטיות הכרחיות, ושתוכן קצר שאינו פרוזה נזרק. הראיות למטה הן החלק הרלוונטי; אין צורך בטענה של preregistration.
charThreshold = 500 הוא לא צוק
הקריאה העממית היא שמאמר מתחת ל-500 תווים מחזיר null. זה לא נכון. סרקתי אורך גוף מ-120 עד 1500 תווים מול ערכי charThreshold של 200, 500 ו-1000:
| אורך גוף | הניתוח הצליח בכל הספים | אורך שהופק |
|---|---|---|
| 120 | כן | 161 |
| 300 | כן | 342 |
| 460 | כן | 509 |
| 520 | כן | 569 |
| 800 | כן | 841 |
| 1500 | כן | 1555 |
שטוח. אותו אורך שחולץ בכל שלוש הגדרות הסף, בכל גודל גוף. הסף לא חוסם את ערך ההחזרה — הוא קובע אם להריץ שוב את ה-grab עם פחות דגלי ניקוי, ובדף נקי אין מה להסיר, כך שהמסנן מחזיר את אותו תוכן בכל מקרה. גבול ה-null האמיתי הוא "אין טקסט שניתן לחילוץ בכלל".
ואז מתקבלת כאן התקלה האמיתית, והיא מגעילה יותר מ-null שגוי. הזנתי דף כמעט ריק — פס ניווט ותיאור בן ארבע מילים. הוא חזר בהצלחה, ו-"המאמר" שהוחזר כלל את ה-nav. כשאין מאמר אמיתי, Readability מחזיר boilerplate שמסומן כמאמר. אם אתה סורק בהיקף גדול ומתייחס לתוצאה שאינה null כאל "יש תוכן בדף", ההנחה הזו שגויה.
תגיות סמנטיות אינן מה שעושה את העבודה
ציפיתי שה-Recall ייפול כשאסיר את השלד. אותו טקסט מאמר, שתי מעטפות: אחת עם <main><article><h1> ושמות class תיאוריים, ואחת עם <div class="x1"> ופסקאות כ-<div> חשוף. התוצאה: 4 מתוך 4 בלוקי מאמר שוחזרו בשתיהן, ואפס boilerplate דלף בשתיהן. כשהמאמר הוא בבירור בלוק הטקסט הצפוף ביותר בדף, הניקוד לפי אורך ומספר פסיקים מוצא אותו גם בלי עזרה סמנטית. הטענה ש-"Readability צריך תגיות <article>" היא פולקלור.
המגבלה ההוגנת על הטענה הזו: בדף שלי היה בלוק תוכן אחד וברור. המקום שבו סמנטיקה עשויה באמת לעזור הוא דף עם שני תתי-עצים צפופים שמתחרים זה בזה, ואת זה לא בדקתי.
תוכן שאינו פרוזה נשמר בשלמותו
הכלל שלפיו "פסקאות מתחת ל-25 תווים לא נספרות" גרם לי לצפות לאובדן בטבלאות ובכותרות משנה. שוב טעיתי — הכלל הזה משפיע על ניקוד המועמד, לא על שמירה. ברגע שהמכל מנצח, כל מה שבתוכו מגיע איתו:
| סוג תוכן בתוך המאמר | Readability | trafilatura |
|---|---|---|
| פסקאות פרוזה (×2) | נשמר | נשמר |
| תאי טבלה עם נתונים (×2) | נשמר | נשמר |
בלוק קוד <pre> | נשמר | נשמר |
פסקת <p> קצרה מתחת ל-25 תווים (×2) | נשמר | נשמר |
<figcaption> | נשמר | הוסר |
| סה"כ | 8/8 | 7/8 |
זהו ציר שבו המנקה הנוקשה יותר מפסיד. אם הדפים שלך הם תיעוד, מדריכים, או כל דבר עם בלוקי קוד ואיורים עם כיתוב, ההתנהגות של Readability של "לשמור את כל תת-העץ המנצח" היא יתרון.
isProbablyReaderable אומר לא כש-parse() אומר כן
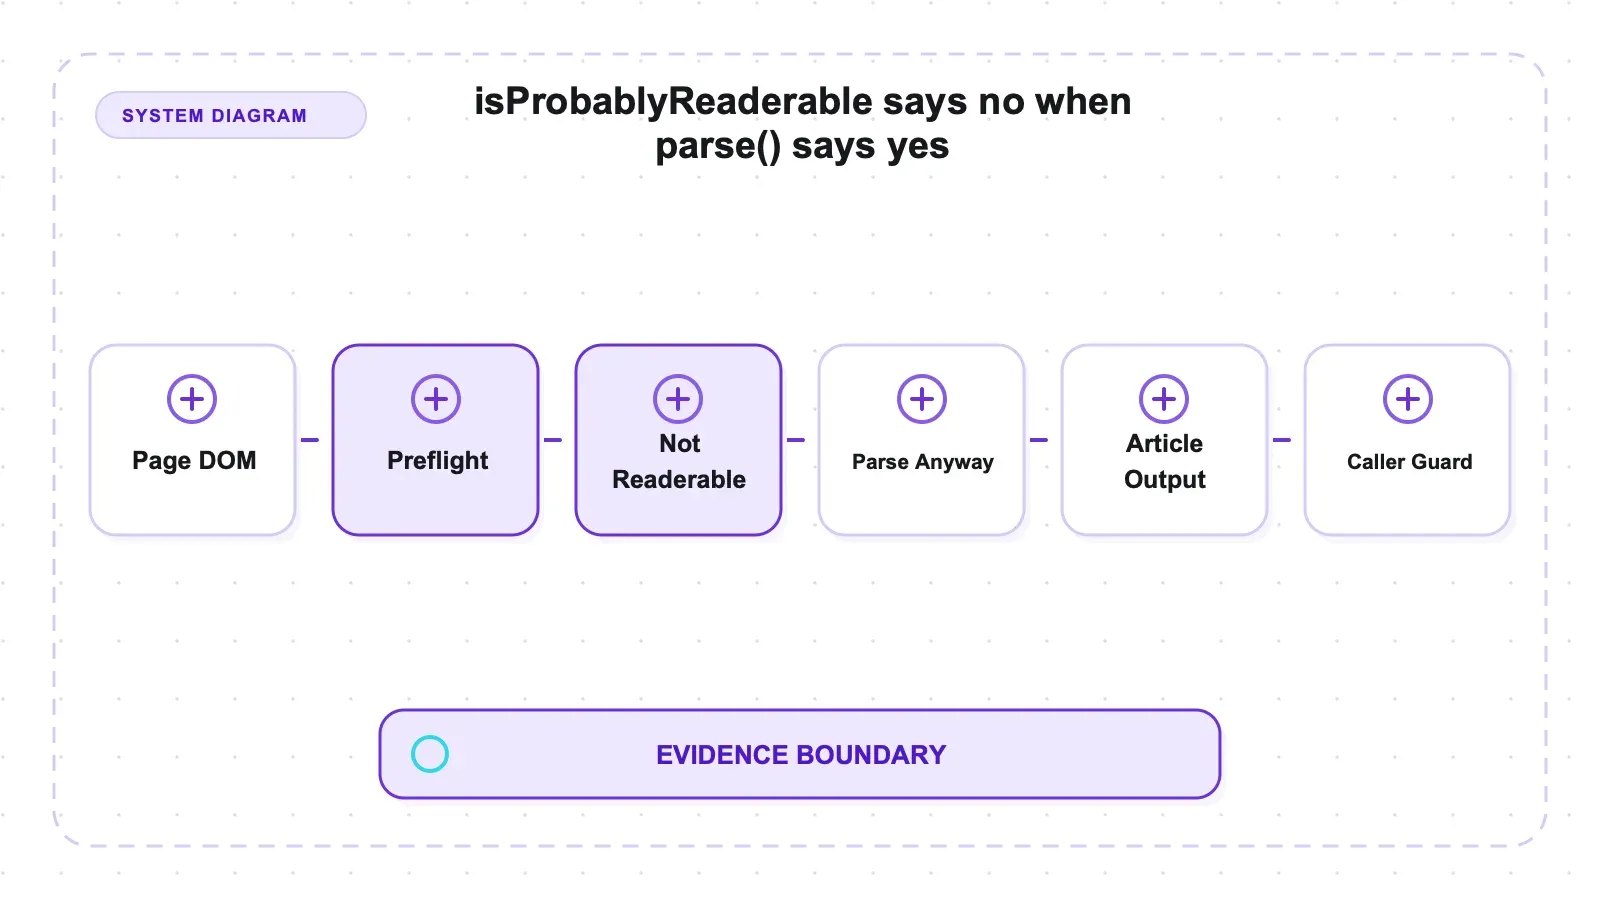
ה-README מציע לקרוא ל-isProbablyReaderable(doc) כבדיקת pre-flight זולה לפני parse מלא. בבדיקות שלי השער הזה דחה שלושה מבני דף שונים ש-parse() טיפל בהם בהצלחה:
| מבנה הדף | תשובת המנבא | parse() | איזה מנוף מתקן את זה |
|---|---|---|---|
תוכן רק בתוך רכיבי <li> | false | מצליח | אין — false בכל minScore 1–80 וגם בכל minContentLength 40–200 |
| עשר פסקאות, כל אחת מתחת ל-140 תווים | false | מצליח | minContentLength ≤ 100 (minScore לא משפיע) |
| פסקה אחת באורך 408 תווים | false | מצליח | minScore ≤ 10 (הציון הוא בערך 16.4) |
| מאמר רגיל (בקרה) | true | מצליח | — |
לשלושת הכשלים יש שלושה גורמים שונים, ורק שניים מהם ניתנים לכוונון. מקרה ה-<li> הוא מבני: המנבא נותן ניקוד רק לצמתים מסוג p, pre, ו-article (וגם להורים של div > br), כך שדף שהתוכן שלו יושב בפריטי רשימה לא תואם כלום, מקבל אפס, ושום כוונון סף לא מציל אותו — צורה שכבר דווחה ב-issue #662. המקרה של הרבה-קצרים הוא שער minContentLength שקופץ מעל כל פסקה לפני הניקוד, כך שעשר פסקאות משמעותיות מסתכמות לאפס; הורדת הערך הזה פותרת את הבעיה, ושינוי minScore לא. המקרה של פסקה יחידה הוא אריתמטי: הניקוד הוא sqrt(408 − 140) ≈ 16.4, מתחת ל-minScore ברירת המחדל של 20 — פסקה בודדת צריכה 540 תווים כדי לעבור לבדה (140 + 20²).
ה-README כן מזהיר שהמנבא מייצר false negatives. מה שהייתי מוסיף הוא כלל פרקטי: אל תשתמשו בו כשומר סף יחיד. אם דף חשוב, נתחו אותו ובדקו את אורך התוצאה. הניתוח עצמו לא יקר במיוחד ביחס לבניית ה-jsdom שכבר שילמת עליה.
אותם בתים, שני מחלצים
הרצה של trafilatura 2.1.0 על אותן תבניות נותנת תמונה נקייה יותר מאשר להשוות שני מספרים שנמדדו על שני testbeds שונים, כי הקלט זהה ברמת הבייט:
| מדד (11 תבניות מעורבות) | @mozilla/readability | trafilatura |
|---|---|---|
| Recall של בלוקי מאמר | 1.000 | 1.000 |
| בלוקי boilerplate שנשמרו | 5/17 (0.294) | 1/17 (0.059) |
| Token F1 (micro) | 0.948 | 0.969 |
| Recall של תוכן לא-פרוזי | 8/8 | 7/8 |
| מאמר קצר מאוד (120 תווים), Token F1 | 0.800 | 0.571 |
אף אחד מהם לא שולט בתבניות האלה. trafilatura שמרה פחות בלוקי אחים, בעוד ש-Readability שמר יותר תוכן קצר ולא-פרוזי. ה-precision הטוקני הגולמי של שני הכלים נפגע מטקסט כותרות לא מתויג, כך שספירת הדליפות ברמת הבלוק היא האות הישיר הנקי יותר. הבנצ'מרק הציבורי על דפים אמיתיים אמנם מסדר אותם באופן דומה לפי word-F1, אבל הקורפוסים והמדדים שונים וזה לא אימות בין testbeds.
בקצרה על חוסן: הרצתי גרסה מכוונת-שבירה של הדף הקנוני (פסקה <p> שלא נסגרה, <b>/<i> מקוננים לא נכון, ו-</div> בודד) וה-Recall היה 3/3 עם אפס דליפות, זהה לגרסה התקינה. הקרדיט כאן שייך ל-jsdom ולבונה העץ של HTML5 שלו, שמתקן את הבלגן לפני ש-Readability בכלל רואה אותו. אף תבנית לא קרסה את המנתח.
יתרונות וחסרונות
יתרונות
- Recall של מאמרים הוא הציר החזק: 74/74 בלוקים מתויגים שוחזרו ב-22 תבניות סינתטיות, ו-token recall של 1.000 בסט המעורב.
- הסרת מעטפת דף לפי regex עובדת בצורה אמינה — nav, באנר פרסומת, sidebar, תגובות ו-footer הוסרו כולם בדף הריאליסטי (5 מתוך 6).
- תוכן לא-פרוזי נשמר במלואו: טבלאות, קוד
<pre>, כיתובי איורים ושורות קצרות מ-25 תווים כולן שרדו (8/8), בעוד trafilatura הסירה כיתוב אחד. - אין תלות בסימון סמנטי — מאמר נייטרלי ב-
<div>קיבל בדיוק אותו ניקוד כמו הגרסה עם<article>/<main>. - מאמרים קצרים לא נדחים בטעות: תוכן נקי שוחזר עד 120 תווים, זהה עבור
charThreshold200/500/1000. - דטרמיניסטי לחלוטין: כל 22 התבניות החזירו טקסט זהה בשלוש הרצות.
- התקנה של שתי דקות, Apache-2.0, והגרסה ב-npm היא בדיוק הגרסה שבדקתי (0.6.0), כך ששום דבר כאן לא מיושן.
חסרונות
- שער צירוף האחים ניתן לניצול: פרוזת promo ארוכה, עם מעט קישורים וללא class מזהה, נראית כמו טקסט מאמר ורוכבת פנימה ב-
linkDensity < 0.25. - בדפים דלים בתוכן הוא מחזיר boilerplate כמאמר במקום
null— התבנית הכמעט-ריקה חזרה עם פס ה-nav שלה כגוף. isProbablyReaderableמייצר false negatives בשלושה מבני דף שונים, ואחד מהם לא ניתן לתיקון בכוונון.- דורש DOM מלא בזמן ריצה — המסגור של "ללא תלויות" מסתיר את עלות jsdom, ששולטת בלולאה.
parse()משנה את מסמך הקלט, כך שחייבים לבנות מחדש את ה-DOM לכל דף.- בלי הבאה, בלי rendering של JavaScript, בלי פלט מובנה. זה שלב אחד בצינור, לא כל הצינור.
- החמצות בדפים אמיתיים שדווחו ב-tracker (אובדן פסקת פתיחה ותוכן לפני טבלה) לא הופיעו בתבניות שלי, כך שאינני יכול לומר אם הן נדירות או שפשוט הדפים שלי לא הגיעו אליהן.
למי זה מתאים, ומי צריך לעבור הלאה
תעדיף את Readability אם כבר יש לך HTML ביד ואתה רוצה להוציא ממנו את המאמר ב-JavaScript טהור, בתוך שירות Node שבו הוספת תלות Python תהיה מסורבלת. (לא אספתי תזמונים כהתפלגות מסודרת, אז אני לא טוען דבר על מהירות מעבר ל-"בניית ה-jsdom שולטת בלולאה, לא החילוץ.") יכולות של reader mode, ארכוב מאמרים אופליין, ניוזלטרים במייל, כפתורי "תצוגה נקייה", תוספי דפדפן, וצינורות תיעוד עם בלוקי קוד וכיתובים — זה התחום, ומספרי ה-Recall אומרים שזה תחום טוב. גם קל לקרוא את ההתנהגות ישר מתוך קוד המקור, וזה שווה יותר ממה שנדמה כשצריך להסביר לעמית למה בלוק מסוים עבר.
תדלג עליו אם דיוק הסרת ה-boilerplate הוא המדד שעליו אתה נבחן, ובמיוחד אם אתה מזין אינדקס LLM שבו פסקת promo תועה הופכת ל-chunk שניתן לאחזור. תדלג עליו אם הדפים שלך מרנדרים תוכן בצד הלקוח, כי הוא קורא את ה-DOM שאתה מוסר לו ולא מריץ JavaScript. תדלג עליו אם מה שאתה צריך הוא {title, price, sku} ולא פרוזה — שום הגדרה לא תהפוך מחלץ תוכן למחולל סכמה. ואם אתה מעבד דפים שבהם "האם היה כאן מאמר בכלל" היא שאלה אמיתית, אל תסמוך על תוצאה שאינה null כתשובה שלך.
חלופות, ואיפה Thunderbit נכנס לתמונה
שום דבר כאן אינו ביקורת על ספריית Apache-2.0 חינמית שמתוחזקת בידי Mozilla — Readability הוא תשתית, הוא רץ בתוך Firefox כבר שנים, ובחילוץ reader-mode הוא מימוש הייחוס מסיבה טובה. אם אתה רוצה את השוק הרחב יותר, אני מחזיק השוואה שוטפת ב-open-source scrapers roundup וסקר רחב יותר ב-the best web scraping tools.
לאותן תבניות על פני כל ששת המחלצים, ראו את six-library extraction comparison.
הערת מחבר: Thunderbit היא האפשרות המנוהלת שלנו לביצוע rendering וחילוץ מ-URL פנימה. היא לא הופעלה על התבניות האלה, כך שאין כאן טענה תואמת לאיכות. הגבול הרלוונטי הוא האם כבר יש לך DOM ואתה רוצה חילוץ מאמר מקומי, או שאתה רוצה הבאה/הרצה/מבנה כ-service. אירוח עצמי חוסך דמי שימוש לספק, אבל עדיין כולל עלויות תשתית ותחזוקה.
הפשרה הכנה: Readability הוא חינמי, שקוף, ושלך להפעלה — אתה יכול לקרוא את השער המדויק שקבע את הפלט שלך, וזה לא משהו ש-API מנוהל נותן. סטאק מנוהל עולה כסף ומסתיר את המנגנון, אבל הוא מכסה עבורך את שלבי ההבאה-הרצה-מבנה שאחרת היית בונה לבד. אם אתה רוצה את הקצה המסייע-ב-AI של הספקטרום הזה, כתבתי גם על scraping any website with AI ועל AI crawlers במקום אחר. תבחר לפי השלבים שבאמת אתה רוצה להחזיק בעצמך.
נסה את Thunderbit לחילוץ נתוני רשת
פסק דין
Readability הוא מועמד טוב כשכבר יש לך DOM, אתה עובד ב-JavaScript/Node, ואתה מעדיף מדי פעם תוכן אחים נוסף על פני השמטה אגרסיבית. בחבילת התבניות הזו הוא שחזר את כל 74 בלוקי המאמר המסומנים ושמר טבלאות, קוד וכיתובים. אבל התוצאה הזו מוגבלת לדפים סינתטיים בעמודה אחת; ה-Recall הציבורי על דפים אמיתיים הוא 0.982, החמצות ידועות ליד פסקת פתיחה/טבלה לא חזרו כאן, ודפים דלים בתוכן יכולים להחזיר boilerplate כמאמר.
רק יש להגדיר נכון את החולשה. שטח הכשל העיקרי שלו בתבניות האלה הוא Precision, והוא יושב על שורה מסוימת ומתועדת בקוד המקור: אחים מעל 80 תווים עם link density מתחת ל-0.25 מצורפים למאמר, בין אם הם חלק ממנו ובין אם לא. ראיתי את המתג הזה מתהפך בין 0.143 ל-0.278 על טקסט זהה. הבנצ'מרק בדפים אמיתיים מדווח precision 0.914 ו-recall 0.982. אם אתה מזרים טקסט מחולץ לאינדקס שמודל יצטט ממנו אחר כך, בדוק גם boilerplate שנשמר וגם גוף שנשמט במקום להניח שאף אחת משתי השגיאות לא קיימת.
נסה את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
האם Mozilla Readability מסיר את כל ה-boilerplate?
לא, והמספר תלוי מאוד במה מודדים. בבנצ'מרק הציבורי של דפים אמיתיים, readability_js 0.6.0 מקבל precision של 0.914 — כלומר בערך 8.6% ממה שהוא מחזיר אינו תוכן גוף. בדף בדיקה ריאליסטי שלי הוא הסיר 5 מתוך 6 בלוקי מעטפת (nav, באנר פרסומת, sidebar, תגובות ו-footer נעלמו כולם), והשאיר רק פסקת promo עם class נייטרלי. בסט תבניות ששקללתי במכוון עם בלוקים שנבנו כדי לנצח את ההיוריסטיקה, הוא שמר 5 מתוך 17 — והמספר האחרון הוא מבחן עומס, לא שיעור אמיתי בעולם.
האם צריך jsdom כדי להשתמש ב-readability.js ב-Node?
כן, או מימוש DOM אחר. Readability הוא JavaScript טהור, אבל הוא פועל על אובייקט document חי, כך שב-Node אתה מספק את ה-DOM בעצמך — אצלי זה היה jsdom 29.1.1. התיאור "ללא תלות" מתייחס לאלגוריתם, לא לזמן הריצה. שים לב גם ש-parse() משנה את המסמך שניתן לו, לכן כדאי לבנות DOM חדש לכל דף במקום לעשות בו שימוש חוזר.
מה בעצם עושה option בשם charThreshold?
לא מה שרוב האנשים מניחים. הוא לא גורם למאמרים קצרים לחזור כ-null — שחזרתי מאמרים נקיים עד 120 תווים, עם אורך מחולץ זהה בכל ערכי charThreshold של 200, 500 ו-1000. הסף קובע אם המנתח יריץ שוב את ה-grab שלו עם פחות דגלי ניקוי; בדף נקי אין מה להסיר, ולכן הפלט זהה בכל מקרה. המקרה האמיתי של null הוא דף ללא טקסט שניתן לחילוץ בכלל, ואפילו דף עם nav בלבד חזר לא-null, כשה-nav הוחזר כמאמר.
האם כדאי לקרוא ל-isProbablyReaderable לפני parse()?
תשתמשו בו כרמז, לא כשער. הוא החזיר false בשלושה מבני דף שבהם parse() דווקא הצליח: תוכן בתוך <li>, עשר פסקאות שכל אחת מתחת ל-140 תווים, ופסקה אחת באורך 408 תווים. את מקרה ה-<li> אי אפשר לתקן בכוונון, כי המנבא נותן ניקוד רק ל-p, pre, ו-article; המקרה של הרבה-קצרים דורש minContentLength נמוך יותר; המקרה של אחת-ארוכה דורש minScore נמוך יותר, כי פסקה בודדת צריכה להגיע ל-540 תווים כדי לעבור את ברירת המחדל. אם דף חשוב, תנתח אותו ותבדוק את התוצאה.
Readability או trafilatura לחילוץ מאמרים?
על אותם בייטים של תבניות, trafilatura שמרה פחות boilerplate (1/17 בלוקים לעומת 5/17), בעוד ש-Readability שחזר יותר תוכן קצר ושמר <figcaption> ש-trafilatura הסירה. תבחר לפי סיבולת לשגיאות וזמן ריצה. הבנצ'מרק הציבורי הוא הקשר נפרד, לא אימות של תוצאת התבניות הזו.




