
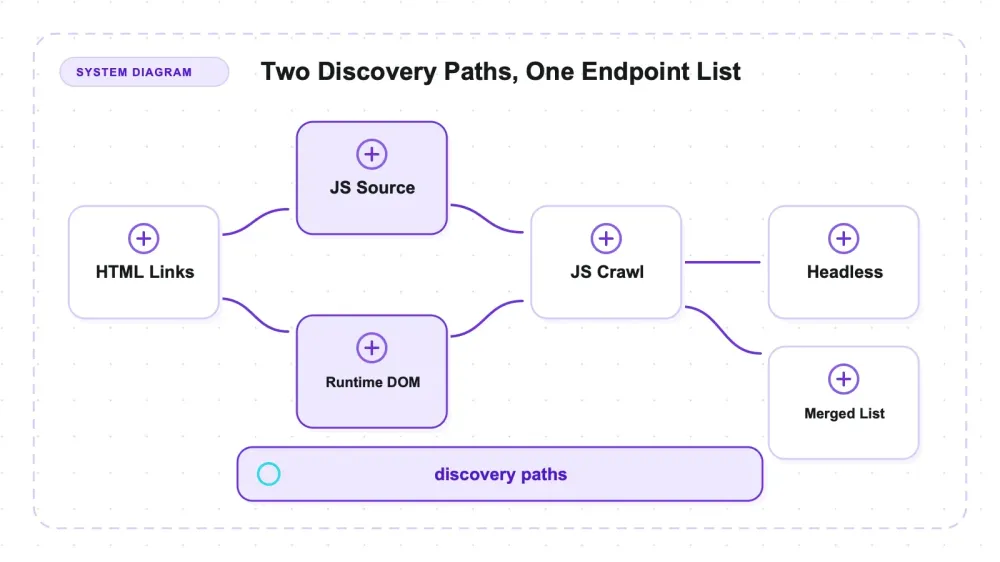
Katana הוא הסורק של ProjectDiscovery לגילוי נקודות קצה — בינארי ב-Go, ברישיון MIT, שמקבל יעד ומחזיר כתובות URL ונקודות קצה עבור הכלי הבא בפייפליין. הוא סורק במצב HTTP בלי דפדפן, או עם -headless, שמפעיל את Chromium. ההנחיה הרשמית מציגה את מצב headless כאפשרות עם כיסוי רחב יותר; הבדיקה הזאת מראה למה סוג נקודת הקצה חשוב לא פחות מהכמות.
בניתי אתר קטן עם שלוש מחלקות שונות בכוונה של נקודות קצה, ובדקתי איזה מצב מצא כל אחת ב-v1.6.1 עם -d 4. HTML רגיל הגיע ל-4/4 קישורים ולשרשרת המלאה של שלושה צעדים בכל ארבע התצורות. הפער הופיע בנקודות קצה שנחשפות דרך קוד JavaScript לעומת שינויים ב-DOM בזמן ריצה.
במבחן הזה, מצב headless מצא את מחלקת ה-DOM בזמן ריצה שהתצורות בלי דפדפן פספסו, בעוד שמצב רגיל עם -jc מצא ליטרלים מתוך קבצי JavaScript ששתי הריצות ב-headless פספסו. אף שורה במטריצת ארבע הפקודות לא כיסתה את שתי המחלקות יחד. גם התנהגות ה-scope, ה-resume וקובצי known-files הגדירו גבולות פרקטיים נוספים.
מה Katana באמת הוא
סורק Katana — projectdiscovery/katana ב-GitHub — כתוב ב-Go ומופץ ברישיון MIT. בדקתי v1.6.1 ב-27 ביולי 2026; הגרסה חשובה כי ממצאי הכיסוי וה-known-files שלמטה הם תצפיות שתלויות בבנייה הספציפית הזאת.
כאן חשוב במיוחד הסיווג. Endpoint-discovery crawler הוא לא מחלץ שדות. אם אתם מחפשים סורק Go שיחזיר לכם שמות מוצרים ומחירים כ-JSON מובנה, Katana פשוט נמצא במדף הלא נכון — הוא יגיד לכם בשמחה ש-/products/1138 קיים, אבל לא יאמר דבר על מה יש בדף הזה. זה מכוון, ושיפוט שלו לפי יכולות חילוץ יהיה כמו לבחון גלאי מתכות לפי היכולת שלו להעריך תכשיטים.
התחום הטבעי שלו הוא סיור לאבטחת מידע ואוטומציה של פייפליינים: נכנס STDIN, יוצאות כתובות URL, ומעבירים אותן לכלי הבא. ומכאן מגיעה גם האזהרה הברורה — כל המדידות כאן בוצעו מול fixture מקומי על 127.0.0.1 שכתבתי בעצמי. הפעילו את Katana רק על מארחים שבבעלותכם או שיש לכם הרשאה מפורשת לבדוק, ולא מעבר לזה. זה לא עניין של עקיפת הגנות של מישהו; זה עניין של כמה משטח נקודות הקצה של אתר מסוים באמת ממופה על ידי פקודה נתונה.
שלושת המצבים, ומה כל אחד מהם רואה
מצב רגיל הוא לקוח HTTP של Go. הוא מבצע fetch, מפענח HTML, עוקב אחרי hrefs, ומעולם לא מפעיל דפדפן. מהיר, זול, ועיוור לכל מה שקיים רק אחרי ש-JavaScript רץ.
-jc (-js-crawl) מוסיף מנתח JavaScript למסלול בלי דפדפן. הוא מוריד קבצי .js מקושרים ושולף מקוד המקור מחרוזות שנראות כמו כתובות URL. בלי הרצה, רק קריאה. יש גם -jsl (jsluice), שמתואר ב-README כמנתח כבד יותר שצורך יותר זיכרון — לא בדקתי אותו, ולכן אין לי מה לומר אם הוא משנה את תמונת הכיסוי.
-headless מפעיל את Chromium ומריץ את סקריפטי הדף. במבחן הזה, זה היה מצב Katana היחיד שבדקתי שהצליח לשחזר את הנתיב שנבנה מחלקים והוזרק ל-DOM בזמן ריצה. התוצאה הזו לא מוכיחה מה כל מנתח או כל מצב עתידי של Katana עשוי לשחזר.
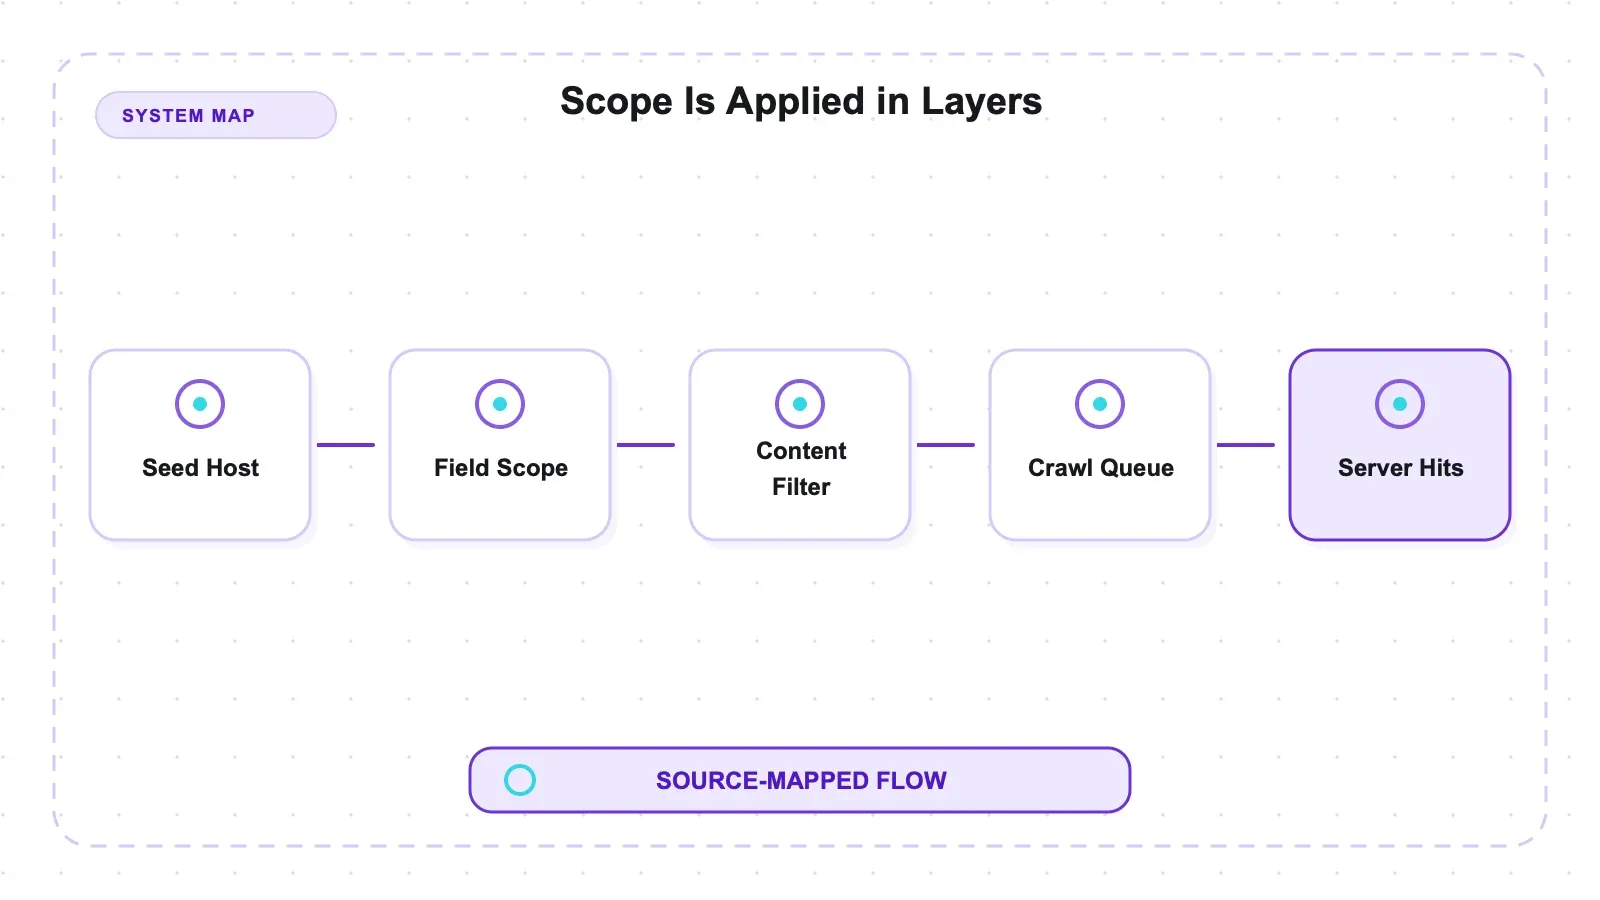
ואז יש את מודל ה-scope, וזה החלק שהייתי מפנים לפני שהייתי מקליד משהו בסביבת production.
| דגל | מה הוא שולט | ערכים / ברירת מחדל |
|---|---|---|
-fs (field scope) | אילו מארחים כלולים | dn, rdn, fqdn, או regex מותאם אישית — ברירת המחדל היא rdn |
-cs ו--cos | regex-ים של URL שמסננים בתוך ה-field scope הזה | — |
-kf | קבצים ידועים: robots.txt ו-sitemap.xml | לפי ה-README צריך עומק מינימלי של 3 |
-d | עומק | ברירת מחדל 3 |
-resume | ממשיך זחילה שנקטעה | — |
הסדר הזה לא קוסמטי: הוא קובע אם regex למארח ירחיב את הזחילה או פשוט ירוקן אותה בשקט.
ההתקנה: בינארי אחד, כוכבית אחת
שלוש דרכי התקנה, ורק אחת מהן דורשת toolchain:
| מסלול התקנה | תנאי מקדים |
|---|---|
מקוד מקור: go install github.com/projectdiscovery/katana/cmd/katana@latest | הדרישה המוצהרת היא Go 1.25 או חדש יותר |
| בינארים מוכנים מראש בעמוד ה-releases | אין צורך ב-toolchain |
| תמונת Docker | אין צורך ב-toolchain |
אצלי זה הגיע ל-~/go/bin/katana והחזיר Current version: v1.6.1 בכל ריצה. עד כאן, הסיפור ה-Go הקלאסי והנעים: קובץ אחד, בלי סביבת ריצה.
הכוכבית היא headless, שבה הדפדפן הוא תנאי נפרד מהבינארי:
איפה -headless רץ | מה הוא צריך |
|---|---|
| המכונה שלי | Katana זיהה אוטומטית Chromium שכבר היה מותקן; לא תיעדתי את גרסת הדפדפן ולא סיפקתי נתיב דפדפן |
| שרת בסיסי, לפי ההוראות של הפרויקט לאובונטו | צריך להריץ apt install google-chrome-stable לפני ש-headless בכלל יעבוד |
| מסלול Docker | רץ headless עם -system-chrome |
בשרת בסיסי הנוחות הזו נעלמת. צריך לתקצב גם דפדפן, לא רק בינארי, ברגע ש--headless נכנס לשורת הפקודה.
עוד דבר קטן שכדאי לדעת אם מריצים את זה ב-CI: Katana מבצע בדיקת גרסה מול GitHub בעת ההפעלה. -duc מבטל זאת. בלפטופ זה כמעט רעש; במכונה מנותקת מהרשת או מוגבלת ברייט-לימיט, זו עוד קריאת רשת לכל ריצה שלא ביקשתם. מדידות הזמן שלי כוללות -duc, כדי שהמספרים ימדדו את הזחילה ולא שיחת טלפון הביתה.
איך בדקתי את זה
שלוש מחלקות של נקודות קצה, שנבחרו במיוחד כי הן מפרידות בין המצבים. הכול יושב על שרת fixture מקומי, והאמת הקרקעית נכתבה לפני שהרצת זחילה כלשהי, כך שה-recall נמדד מול סט קבוע ולא מול מה ש-Katana החליט להדפיס במקרה.
- מחלקה A — HTML רגיל.
/page/a,/page/b,/page/c, וגם שרשרת של שלושה צעדים/depth/1 → /depth/2 → /depth/3. כל סורק אמור למצוא את אלה. - מחלקה B — ליטרלים בתוך קובץ JavaScript.
/api/js-endpoint-7ו-/api/js-endpoint-8קיימים רק כליטרלים של מחרוזת בתוך/static/app.jsמקושר. אפשר לקרוא אותם בלי דפדפן, אם מישהו בכלל טורח לקרוא את ה-JS. - מחלקה C — רק DOM בזמן ריצה. נתיב אחד שנבנה בזמן ריצה מחלקים (
'endpoint' + (6 * 7)) והוזרק ל-DOM על ידי סקריפט. המחרוזת/runtime-only/endpoint42לעולם לא מופיעה ברצף באף בייט שהשרת שולח — לא ב-HTML ולא בקוד ה-JS. רק הרצה מגלה אותה.
בנוסף יש robots.txt, sitemap.xml עם שני <loc>-ים שלא מופיעים בשום מקום אחר, נתיב שמחזיר 500, קישור שבור, וקישור מחוץ ל-scope שמצביע לשרת שני על hostname אחר.
גם לאמצעי המדידה יש משקל: השרת סופר מה באמת נשלף, כך שטענות על scope ו-resume נשענות על אמת של hit ולא על ה-stdout של Katana. הריצות הגולמיות שמורות ב-benchmark repo אם תרצו לבדוק את החשבון שלי.
פער הכיסוי שאף אחד לא מכמת
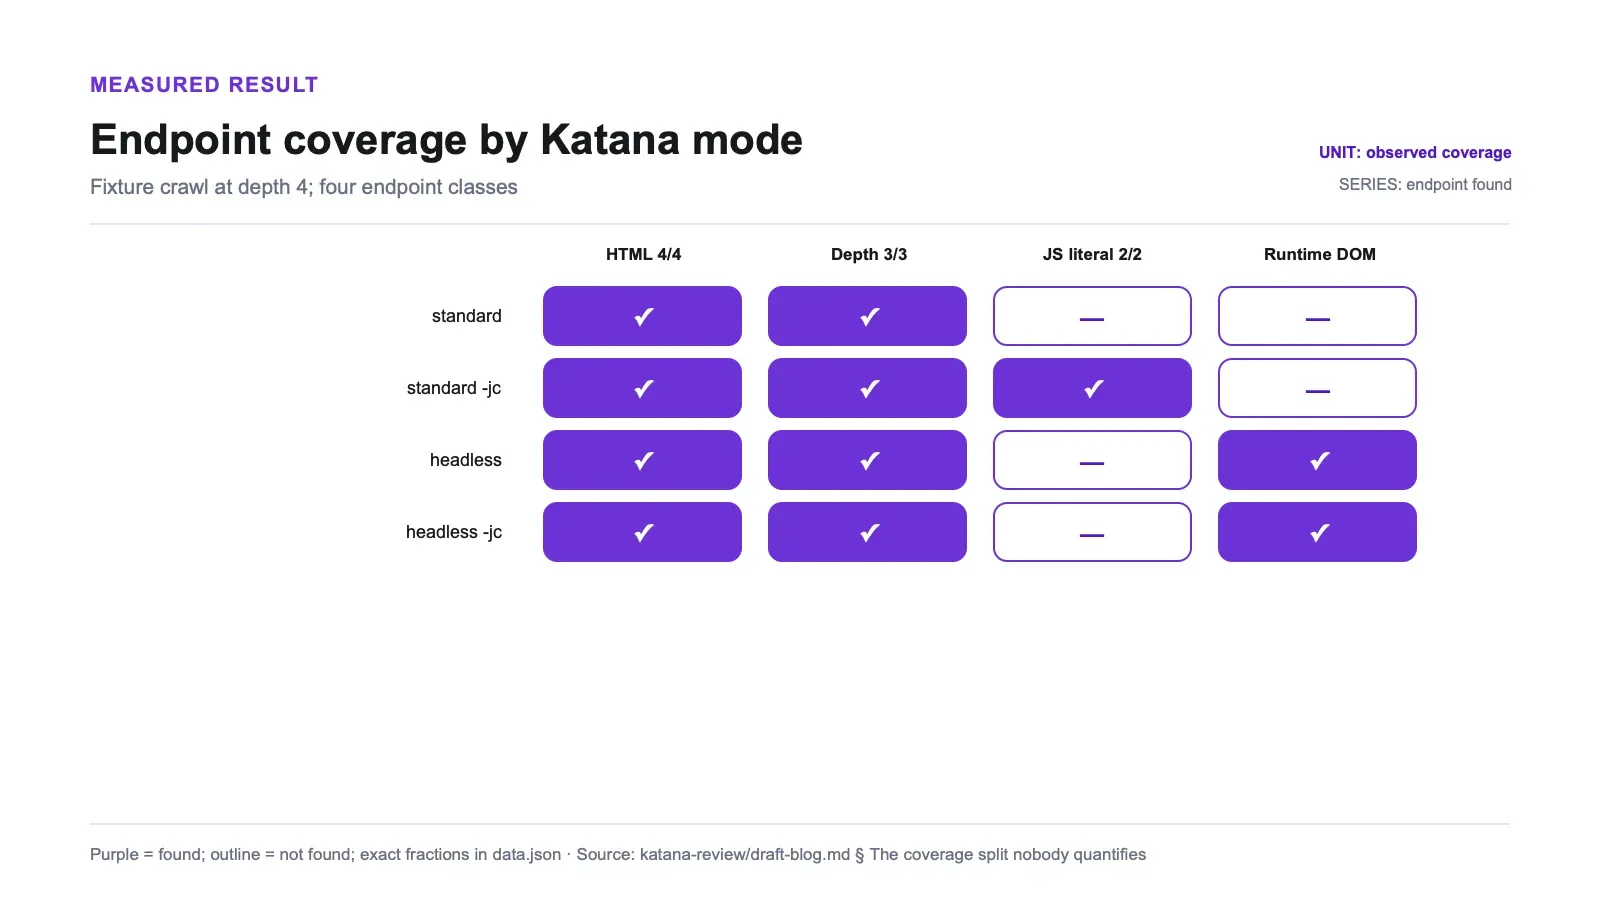
המטריצה, לפי מצב ולפי מחלקת נקודת קצה, ב--d 4:
| מצב | קישורי HTML (A) | שרשרת עומק (A) | ליטרלים בקובץ JS (B) | DOM בזמן ריצה (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | לא נמצא |
standard -jc | 4/4 | 3/3 | 2/2 | לא נמצא |
-headless | 4/4 | 3/3 | 0/2 | נמצא |
-headless -jc | 4/4 | 3/3 | 0/2 | נמצא |
אם קוראים את שתי העמודות האחרונות יחד, הבעיה קופצת לעין. מחלקה B נמצאה בדיוק בתצורה אחת: מצב רגיל עם -jc. מחלקה C נמצאה בדיוק בשתי תצורות: שתי הריצות עם headless. אין אף שורה עם פגיעה בשתי העמודות יחד. המטריצה המלאה נמצאת ב-discovery-summary.json, שם השדה המחושב headless_jc_covers_both מופיע כ-false.
המסקנה המעשית היא ש"פשוט להשתמש ב-headless בשביל כיסוי טוב יותר" היה ניסוח חלקי מדי למבחן הזה. headless לא הוסיף את מחלקה B מעל תוצאת ה-standard; הוא שחזר את מחלקה C אבל פספס את מחלקה B. כיסוי מלא של כל המחלקות שהושתלו ב-fixture הזה דרש שתי זחילות ומיזוג:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
השורה -headless -jc היא זו שהכי הייתי רוצה עליה תשובה מהפרויקט עצמו. הוספת מנתח ה-JavaScript לריצת headless לא שיפרה כלום — עדיין 0/2 במחלקה B, בכל ריצה, כולל שחזור נקי. אני מדווח על ההתנהגות, לא טוען שפיצחתי את המנגנון; לא instrumented את המימוש הפנימי של Katana כדי להבין למה הנתיב של הדפדפן מפסיק לתרום ליטרלים מקבצי JS. קחו את זה כתצפית שניתנת לשחזור וכ-issue טוב ב-GitHub, לא כאבחנה. (שווה לציין לצידה: השילוב -hl -jc הושלם בהצלחה עם קוד חזרה 0 ב-v1.6.1 על macOS ARM, וזה לא תמיד היה נכון היסטורית.)
ה-docs הרשמיים מתארים את headless ככזה שנותן כיסוי טוב יותר, ואכן כאן הוא עזר למחלקה שעובדה בזמן ריצה. אבל ההנחיה שנבדקה לא פירקה במפורש את הפער בין source-literal ל-runtime-DOM, ולכן כדאי לראות במטריצה סיבה לבדוק את שני המסלולים מול מחלקות נקודות הקצה שלכם, ולא טקסונומיה אוניברסלית.
כמה headless עולה בזמן אמת
שלוש ריצות רצופות לכל מצב על מכונה סרק יחסית:
| מצב | p50 | טווח min–max | ממוצע |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
זה יחס של 5.1x עם טווחים שלא מתקרבים בכלל לחפיפה — הריצה האיטית ביותר של standard שלי (13.17s) עדיין עקפה את הריצה המהירה ביותר של headless שלי (66.78s) ביותר מ-53 שניות (cost-summary.json). זו לא רעש מדידה.
אזהרה קטנה לגבי 13 השניות האלה: ה-fixture שלי כולל במכוון נתיב 500 וקישור שבור, ו-mצב standard יושב על tail הריטריי של -timeout 10 בשניהם כברירת מחדל. לא כיווננתי את הזמן כדי להחמיא למצב המהיר, כך שריצה סטנדרטית מכוונת הייתה כנראה מגדילה את הפער ולא מקטינה אותו.
היחס הוא אות קיבולת מקומי, לא תחזית ל-production. יעדים אמיתיים משתנים בהשהיה, בכשלים, בעבודת סקריפטים ובתזמון, בעוד שה-fixture הזה כולל את הזנב של ה-timeout כברירת מחדל. השתמשו בהפרש המדוד של 5.1x כדי להחליט אם headless ראוי לתקציב נפרד ולתת-סט של יעדים, ואז בצעו benchmark לתוכנית הזו על מארחים מייצגים ומורשים.
ה-scope נשמר, אבל דגל אחד פשוט לא עשה כלום
בדיקת ה-scope השתמשה בשני שרתים: הראשי ב-127.0.0.1, ושרת שני שנגיש כ-localhost על פורט אחר, שמגיש נתיב שקיים רק שם. לכן פגיעה בנתיב הזה מוכיחה שהמארח שמחוץ ל-scope באמת נשלף, ולא רק הודפס.
| תצורה | המארח שמחוץ ל-scope נשלף? | פגיעות בשרת השני |
|---|---|---|
ברירת מחדל (-fs rdn) | לא | 0 |
-fs fqdn | לא | 0 |
-cs localhost | לא | 0 |
| `-fs '(127.0.0.1 | localhost)'` | כן |
משמעת scope היא חדשות טובות: כברירת מחדל Katana נשאר בבית, ורק פעולה מפורשת הרחיבה אותו. זו ברירת המחדל הנכונה לכלי שמופנה גם לתשתיות של אחרים.
השורה המעניינת היא -cs localhost. היא לא הרחיבה את הזחילה לשרת השני — וגם הפיקה אפס כתובות URL בכלל. מכיוון ש--cs מסנן בתוך ה-field scope, וה-field scope עדיין היה המארח הראשי, ה-regex לא התאים לשום דבר והזחילה החזירה סט ריק במקום שגיאה. אם אי פעם כתבתם regex ל-scope של זחילה, שציינתם בו מארח שרציתם לכלול, ובהיתם בקובץ פלט ריק — זה המנגנון (scope-summary.json). כדי להוסיף מארח, קובעים -fs. כדי לצמצם בתוך מארחים שכבר יש לכם, משתמשים ב--cs/-cos.
ה-resume גס יותר ממה שהדגל מרמז
ה-README מתאר את הדגל כך: -resume string resume scan using resume.cfg, מה שנשמע כמו קובץ שנופל לתיקיית העבודה. בפועל, זה לא כך. על המכונה שלי נקודת הבקרה נכתבה ל-~/.config/katana/resume-<xid>.cfg — נמדד, לא נקרא מדף תיעוד, כי התיעוד לא מציין נתיב.
וההפתעה החשובה יותר היא מה יש בפנים. הקובץ הכיל מיפוי InFlightUrls עם דבר אחד בדיוק: seed URL. לא הסט המבוקר, לא ה-frontier. אז זה מה שקרה כשהפסקתי זחילה עם SIGINT אחרי שלוש שניות והמשכתי אותה:
| ריצה | נתיבים ייחודיים |
|---|---|
| זחילת baseline מלאה | 11 |
| נשלפו לפני ההפסקה | 10 |
| נשלפו מחדש בריצת ה-resume | כל 11, כולל כל 10 שכבר הושלמו |
ה-resume הגיע לאותו סט סופי של נקודות קצה, כך ששום דבר לא נשבר. אבל רמת ה-checkpoint היא לכל seed קלט, לא לכל URL — מנגנון ה-dedupe שבזיכרון לא נשמר, ולכן חידוש של זחילה עם seed יחיד מזחיל מחדש את ה-seed הזה מאפס (resume-summary.json). אם מזינים ל-Katana רשימה של 500 מארחים, resume אמור לחסוך לכם את המארחים שהושלמו עד הסוף; ההתנהגות הזו עם כמה seeds נובעת מאיך שהמצב נשמר, אבל אני מדדתי רק את המקרה של seed יחיד. אם אתם עמוק בתוך אתר ענק אחד, resume קונה לכם נכונות, לא זמן.
known files: נדרש, ואז נפל בדרך
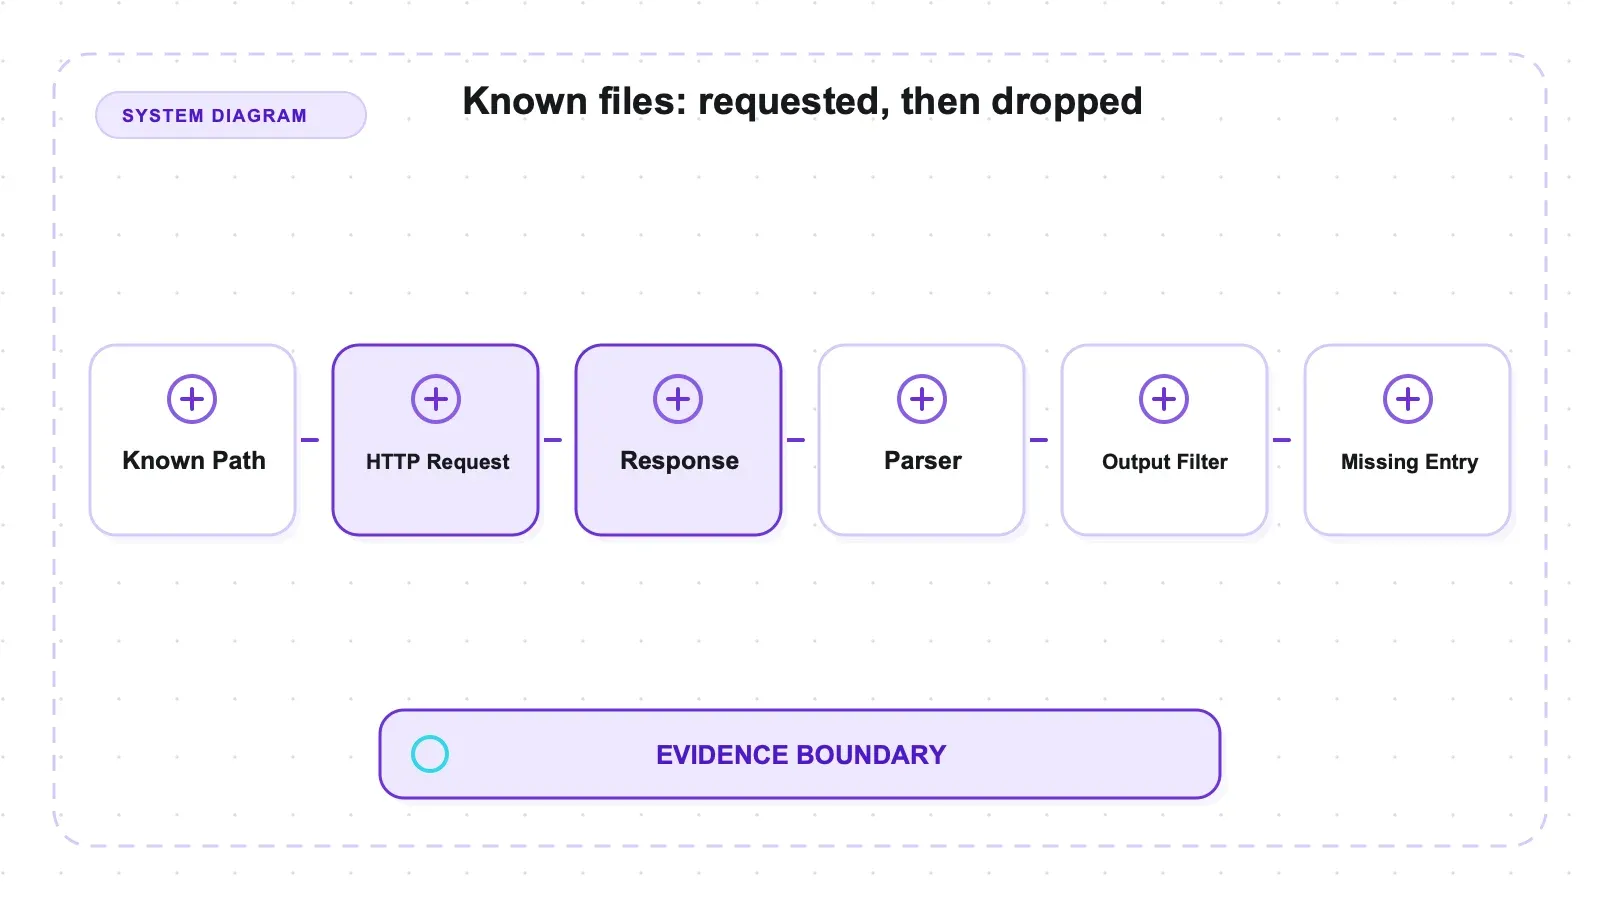
-kf all -d 3 אכן ביקש את שני הקבצים — robots.txt ו-sitemap.xml הופיעו בלוג הפגיעות של השרת — ואז שחזר 0 מתוך 2 נקודות הקצה שהופיעו ב-<loc> של ה-sitemap. כלומר recall של 0.0.
לפני שאקרא לזה מגבלה ניסיתי לגרום לזה להיות באשמתי. כל וריאציה החזירה את אותו דבר:
| וריאציה שנבדקה | נקודות קצה מ-<loc> של sitemap ששוחזרו |
|---|---|
-kf all | 0/2, recall 0.0 |
-kf sitemapxml | 0/2, recall 0.0 |
-kf robotstxt | 0/2, recall 0.0 |
| עומק 3 | 0/2, recall 0.0 |
| עומק 4 | 0/2, recall 0.0 |
| עומק 5 | 0/2, recall 0.0 |
עם -jc נוסף | 0/2, recall 0.0 |
seed ישיר על /sitemap.xml | 0/2, recall 0.0 |
דרישת התיעוד — להשתמש ב--kf, וללכת לפחות שלוש שכבות עמוק — התקיימה בכל פעם. זה לא סיפור של דגל חסר.
ההחלטה השימושית מגיעה קודם: במבחן הזה עם IP-literal, אל תניחו שביקוש של known files אומר ש-<loc>-ים שלהם צורפו לזחילה. בדקו recall, או שלפו את ה-URLs האלה ותנו אותם ל-Katana בעצמכם כ-seed.
מסלול הקוד ב-v1.6.1 עקבי עם התצפית, אבל לא instrumented אותו במהלך הריצה. ב-sitemapxml.go ב-v1.6.1, הפונקציה NewNavigationRequestURLFromResponse בונה בקשות ניווט מתוך response בלי RootHostname מלא. אחר כך הבקשה מגיעה ל-ValidateScope; ב-scope.go ב-v1.6.1, ענף ה-IP-literal משווה את host של ה-URL מול root ריק ויכול לדחות אותו. הפקודה המותאמת -fs '(127.0.0.1|localhost)' עברה בענף scope שונה בבדיקת scope נפרדת, כך שזה פתרון שמוסבר מראש מהקוד ולא workaround שנמדד עם -kf. ניסיון לאימות נחסם בגלל בעיות דיאלינג לסירוגין בלקוח של known-files על המארח הזה; לכן התוצאה המדווחת נשארת 0/2.
מה שהייתי עושה בפועל ב-production, עד שמישהו יאשר את הדגל: שולף את ה-sitemap בעצמי, מחלץ את ה-<loc>-ים, ונותן אותם ל-Katana כרשימת seeds. שתי שורות shell, בלי אימות scope מעורב.
דבר אחד כן התנהג בדיוק כפי שפורסם וראוי למשפט: נתיב ה-500 והקישור השבור נשלפו, נרשמו, והמשיכו הלאה. כל ריצה ללא דפדפן הסתיימה עם return code 0. סורק שנופל על התגובה השגויה הראשונה הוא חסר ערך ללא השגחה, ו-Katana לא כזה.
בדיקת כיסוי ייעודית ליעד לפני פריסה
מטריצת ה-fixture היא הכי שימושית כתבנית לבדיקה של יעדים מורשים משלכם. הגדירו מחלקות של נקודות קצה לפני שמריצים את Katana: קישורים רגילים, ליטרלים בסקריפטים מקושרים, נתיבים שנוצרים רק אחרי הרצה, וערכים מתוך known-files הם ארבעה buckets סבירים להתחלה. שמרו sample קטן של אמת קרקעית לכל מחלקה. בלי הרשימה המוקדמת הזו, קובץ stdout גדול יותר יכול להיראות כמו כיסוי טוב יותר גם כשמחלקה שלמה נעלמה.
הריצו תחילה את המסלולים בלי דפדפן ועם דפדפן כמדידות נפרדות. שמרו את הפקודות המדויקות, גרסת Katana, גרסת הדפדפן, קודי חזרה, והפלטים. נרמלו והשוו את סטי נקודות הקצה, במקום להשוות רק ספירת שורות. אם -jc במצב standard לא תורם שום דבר ייחודי על sample שלכם, ייתכן שמדיניות של headless בלבד מספיקה; אם הסטים מתפצלים כמו כאן, שמרו את שתי הריצות נפרדות ומזגו אחרי האיסוף. הוספת שני הדגלים לאותה פקודה לא צריכה להיחשב אוטומטית כשווה לאיחוד, עד שה-diff הספציפי ליעד מוכיח זאת.
אמתו scope עם ראיות מחוץ לפלט של Katana. שימו URL-קנרי על מארח שאמור להישאר מחוץ ל-scope ובדקו את לוג הבקשות של אותו שרת. בדקו גם מארח שני מיועד, אם הזחילה אמורה להתרחב. הריצה -cs localhost כאן הפיקה פלט ריק כי סינון scope תוכן לא הרחיב scope שדה; ההפעלה המותאמת -fs '(127.0.0.1|localhost)' אכן יצרה קשר עם השרת השני. חשוב לתעד את הביטוי הרגולרי המדויק, כי שינוי של תו אחד יכול לשנות את ה-regex ולא רק את ההצגה שלו.
בדקו הפרעה ו-known files בנפרד מ-recall של discovery. עבור resume, הפסיקו seed מייצג אחרי כמה דפים, שמרו את נתיב ה-checkpoint שנוצר, וספרו כמה URL-ים שכבר הושלמו נמשכו שוב. עבור -kf, ודאו גם שה-robots/sitemap אכן נבקשו וגם שה-<loc>-ים שהושתלו נקבעו בפועל לתזמון. אלו טענות שונות. ב-fixture הזה הקבצים נשלפו בעוד שני נקודות הקצה של ה-sitemap נותרו מחוץ לתוצאה, כך שגם לוג הבקשות וגם פלט נקודות הקצה היו נחוצים כדי לראות את הגבול.
לבסוף, קבעו baseline מקומי של עלות בעזרת ריצות רצופות על מכונה סרק יחסית, ואז חזרו על זה על מארחים מייצגים. שמרו min, max ו-median ולא רק מכפיל. ה-5.1x כאן כולל את התנהגות הכשלים וה-timeout של ה-fixture; הוא אומר לכם ש-headless צריך תקציב משלו, לא כמה זמן ייקח inventoy ב-production.
יתרונות וחסרונות
יתרונות:
- Recall מושלם ב-HTML רגיל בכל מצב — 4/4 קישורים ושרשרת עומק מלאה של 3/3, בלי צורך בהגדרות מיוחדות.
-jcעובד באמת בלי דפדפן: 2/2 נקודות קצה שוחזרו מליטרלים בתוך קובץ JS מקושר, בלי עלות דפדפן.-headlessהוא היחיד שמצא נקודת קצה שנבנתה בזמן ריצה — מחלקה שאינה נראית מטבעה לניתוח מקור.- ברירות המחדל של scope שמרניות. המארח שמחוץ ל-scope לא נשלף בברירת מחדל, ב-
-fs fqdn, או ב--cs. - בינארי Go יחיד, רישיון MIT, בנייה מוכנה מראש ותמונת Docker, ופלט שמתאים לפייפליין.
- עמיד בכשלונות: 500-ים וקישורים שבורים לא עוצרים את הזחילה.
חסרונות:
- שום הרצה אחת לא כיסתה גם נקודות קצה מתוך קובץ JS וגם נקודות קצה מ-DOM בזמן ריצה. כיסוי מלא דורש שתי ריצות ומיזוג.
-jcלא תרם דבר תחת-headless— 0/2 במחלקה B בכל ריצת headless.- Headless עולה 5.1x בזמן הריצה המקומי (66.82s מול 13.08s p50, טווחים ללא חפיפה).
-resumeמזחיל מחדש דפים שהושלמו בתוך seed. הוא משחזר את סט נקודות הקצה, לא את הזמן שנחסך.- known files ביקש robots.txt ו-sitemap.xml אבל שחזר 0/2 של נקודות
<loc>מול יעד IP. - Headless דורש בשקט Chromium על המכונה; הסיפור של "בינארי אחד" נעצר בדפדפן.
- גילוי בלבד. בלי חילוץ מובנה, בלי המרת תוכן, בלי סכימת שדות.
לא נבדקו, ולכן מחוץ למה שכל המספרים האלה מכסים: -jsluice, בדיקת cutoff לעומק ייעודית ב--d 1/-d 2, resume עם כמה seeds, מילוי טפסים אוטומטי, וכל אתר ייצור אמיתי כבד ב-JavaScript או מוגן. כל המספרים הם ממכונה אחת (macOS arm64) מול fixture מקומי.
למי זה מתאים, ומי יכול לדלג
אם התפקיד שלכם הוא לייצר inventory של נקודות קצה עבור תשתיות שמותר לכם לגעת בהן, ל-Katana יש מבנה פייפליין נכון: חיבורי STDIN/STDOUT, בינארי שניתן להפצה, וגם מצבים בלי דפדפן ועם דפדפן. המיזוג בשתי ריצות היה הכרחי למחלקות שהושתלו ב-fixture הזה; האם היעדים שלכם דורשים שתי ריצות, זה משהו שצריך לקבוע מדפים מייצגים.
דלגו עליו אם אתם צריכים נתונים ולא כתובות. Katana לעולם לא ייתן לכם טבלת מוצרים; הוא נותן לכם את ה-URLs שבהם מוצרים עשויים להימצא, ומשהו אחר מבצע את החילוץ. דלגו גם אם אתם צריכים שפקודה אחת תהיה שלמה — המיזוג בשתי ריצות עובד מצוין בתוך פייפליין אבל מעצבן בשורת פקודה. ואם הספירה שלכם נשענת על <loc>-ים של sitemap מול יעדי IP, בדקו מה אתם באמת מקבלים לפני שאתם סומכים על הפלט, כי ב-fixture שלי המסלול הזה החזיר כלום.
חלופות, וגבול החילוץ
Katana הוא חינמי, ברישיון MIT, ומתארח-עצמית. הוא משאיר את הגילוי, בחירת המצב, פריסת הדפדפן ומיזוג התוצאות בצד שלכם של הגבול.
בתוך עולם הקוד הפתוח, ההשוואות השימושיות הן לפי משימה ולא לפי שפה. Colly הוא אופציית Go אחרת, אבל זה ספרייה שאתם מקמפלים עם callbacks משלכם, והוא בכלל לא מרנדר JavaScript. Crawl4AI מריץ דפדפן אמיתי ומפיק Markdown לפייפלייני LLM, שזה פלט שונה לגמרי. אם אתם שוקלים כמה כלים כאלה יחד, ה-open-source scraper roundup שלנו מסדר את הקטגוריות זו לצד זו.
חשיפת נאותות: Thunderbit הוא המוצר של המפרסם ולא נבדק ב-fixture הזה של Katana. הוא יושב במורד הזרם בקטגוריית החילוץ המנוהל, והופך דפים לטקסט או לרשומות מובנות במקום למפות את משטח נקודות הקצה של יעד מורשה. ייתכן שפייפליין ישתמש בשתי הקטגוריות, אבל הביקורת הזו מספקת ראיות רק להתנהגות הגילוי של Katana.
נסו את Thunderbit לחילוץ נתוני רשת
מסקנה
השתמשו ב-Katana כשמה שצריך למסירה הוא רשימת נקודות קצה עבור יעדים שמותר לכם לסרוק, וכשאתם יכולים לאמת כיסוי לפי מצב מול היעדים האלה. ב-fixture הזה, -jc רגיל שחזר את הליטרלים שהושתלו בקובץ JavaScript, בעוד ש-headless שחזר את נקודת הקצה שב-DOM בזמן ריצה; המצבים בלי דפדפן שנבדקו לא שחזרו את הנתיב בזמן ריצה הזה. גם ברירת המחדל של scope שמרה על המארח השני מחוץ לזחילה, וריצות בלי דפדפן המשיכו מעבר ל-500 ולקישור השבור.
הסייגים הם תפעוליים: ייתכן שתצטרכו מיזוג בשתי ריצות למחלקות נקודות קצה מעורבות, headless עלה בערך פי חמישה בזמן הריצה המקומי, resume של seed יחיד קרא מחדש נתיבים שכבר הושלמו, ו-known-files הראה recall של 0/2 מול יעד IP. אלה תוצאות של v1.6.1 ב-fixture הזה, לא הבטחות לגבי כל אתר. אבל הן מספיקות כדי להגדיר את הבדיקות ש-evaluation ב-production צריך לחזור עליהן.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
איפה Katana שומר את קובץ ה-resume, והאם חידוש באמת מדלג על דפים שכבר זחלתי אליהם?
נקודת הבקרה נכתבה ל-~/.config/katana/resume-<xid>.cfg, ולא ל-resume.cfg בתיקיית העבודה כפי שמרמז טקסט העזרה של הדגל. ולא, הוא לא מדלג על דפים שהושלמו: הקובץ שומר רק seed-ים שנמצאים בתנועה, כך שחידוש של זחילה עם seed יחיד שלף שוב את כל 11 הנתיבים הבסיסיים, כולל 10 שכבר הושלמו. מקבלים את אותו סט סופי של נקודות קצה, פשוט לא את הזמן שנחסך.
למה -kf all ביקש את sitemap.xml שלי אבל לא זחל את ה-URL-ים שבתוכו?
מול יעד IP, התוצאה עקבית עם גבול של אימות scope ולא עם טעות בדגל. בקוד של v1.6.1, מנתח ה-sitemap של Katana בונה כל בקשת <loc> בלי להעביר קדימה את RootHostname, ואז בדיקת scope ל-hosts מסוג IP literal יכולה לדחות את ה-URL הזה; לא instrumented את הריצה כדי לאמת את המנגנון הזה. זה נשאר על 0 recall בכל דגל, עומק ו-seed שניסיתי. regex מותאם של -fs למארחים עובר דרך ענף אימות אחר והוא התיקון שהמקור מנבא — אבל לא הצלחתי לאשר אותו מול -kf על המכונה שלי, אז ראוי להתייחס אליו כלא נבדק. כרגע הייתי סומך על שליפה עצמית של <loc>-ים והזנה שלהם ל-Katana.
מה כדאי לשמר כשמדווחים על בדיקת כיסוי של Katana?
רשמו את גרסת Katana המדויקת ואת הפקודה, כולל ביטוי -fs בדיוק של בתים; הגדירו מחלקות נקודות קצה לפני הריצה; שמרו לוגי פגיעות בצד השרת בנוסף ל-stdout; והפרידו בין התנהגות שנמדדה לבין השערות שמבוססות על הקוד. בריצות headless, תעדו גם את גרסת הדפדפן — המבחן הזה לא עשה זאת, וזה מגביל שחזור.
האם להשתמש ב--jc, ב--headless, או בשניהם?
בחרו לפי מחלקות נקודות הקצה שאתם צריכים. ב-fixture הזה, -jc רגיל מצא ליטרלים שמאוחסנים בקובץ JavaScript, בעוד ש-headless מצא את נקודת הקצה שהוכנסה ל-DOM בזמן ריצה. אף מצב לא כיסה את שתי המחלקות לבדו, כך שהרצה בשני שלבים ואחריה דה-דופליקציה הייתה הבחירה ההגיונית עבור יעדים מעורבים.
האם URL כושל אחד יעצור את הזחילה? לא במבחן המבוקר הזה. Katana המשיך גם אחרי תגובת 500 וגם אחרי קישור שבור, ועדיין החזיר את שאר הנתיבים הנגישים. זה לא תחליף לחשבונאות שגיאות ב-production: שמרו לוגים של בקשות שנכשלו והגדירו שיעור כשל מקובל, כדי שזחילה חלקית לא תתפרש בטעות ככיסוי מלא.




