
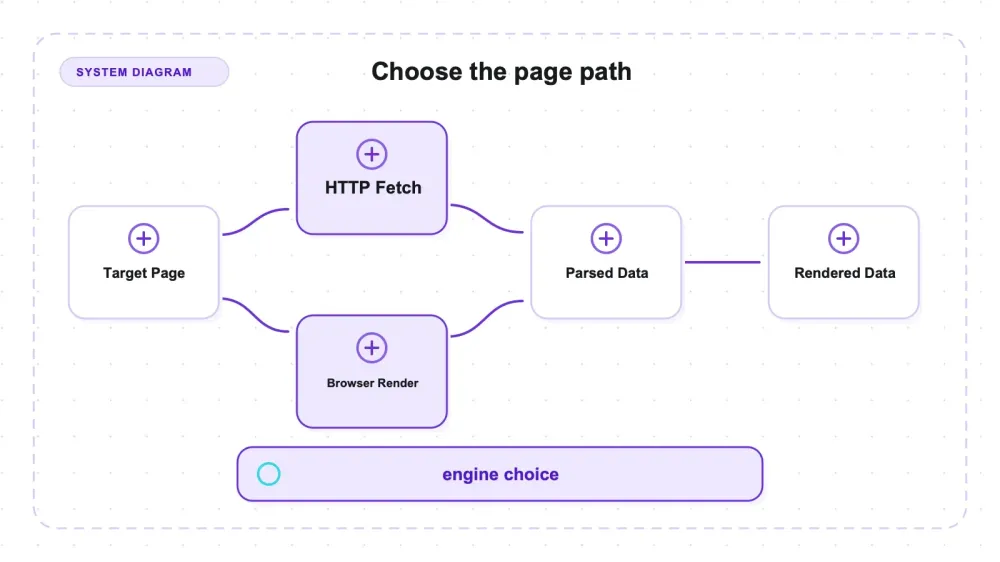
מה שהופך את Crawlee לשימושי הוא שמנגנון התזמור של הסריקה שלו תומך גם בפענוח HTTP וגם בהרצה בדפדפן. לכן אותו URL יכול להחזיר תוצאות שונות בהתאם לסורק שנבחר ולתנאי המוכנות.
בדף הציבורי Quotes to Scrape JS, CheerioCrawler מצא 0 ציטוטים יעד, בעוד PlaywrightCrawler מצא 10 לאחר שהמתין ל-.quote. מחזור החיים של הסריקה דומה, אבל זו לא הייתה החלפה של שורה אחת רק ברמת המחלקה: בהנדלר של Cheerio השתמשו ב-$, ואילו בהנדלר של Playwright השתמשו ב-page, בהמתנה מפורשת ובשליפה מתוך צד הדפדפן.
מה זה Crawlee באמת
Crawlee (הפרויקט apify/crawlee, גרסה 3.17.0) הוא ספריית Web Scraping ואוטומציית דפדפן ל-Node.js ול-TypeScript. הוא תומך בסריקת HTTP שמבוססת על Cheerio או JSDOM, ובסריקת דפדפן שמבוססת על Playwright או Puppeteer. הפרויקט מופץ תחת Apache-2.0; חשוב לעיין בהודעות הרישוי ובחובות הייחוס לפני הפצה.
המודל המנטלי החשוב כאן הוא להפריד בין “להביא את הדף” לבין “לקרוא את הדף”. במסלול אחד מורידים HTML גולמי בלי להריץ JavaScript. במסלול השני מפעילים את Chromium ויכולים להריץ את הסקריפטים של הדף, אבל עדיין צריך תנאי מוכנות מתאים, וגם אז אפשר לפספס תוכן שמופיע רק אחרי אינטראקציה, טעינה עצלה, Shadow DOM, כשלי API או חסימות בוטים. Crawlee מציג מושגי מחזור חיים תואמים בין שני המסלולים האלה, ולא פרימיטיבים זהים של DOM.
זהו החלק שכדאי להבין לפני שכותבים ולו סלקטור אחד, כי הבחירה בין שני המנועים הללו קובעת אם הסקרייפר יחזיר נתונים או יחזיר כלום באתר מסוים.
תכונות עיקריות: שני מנועים, ממשק API אחד
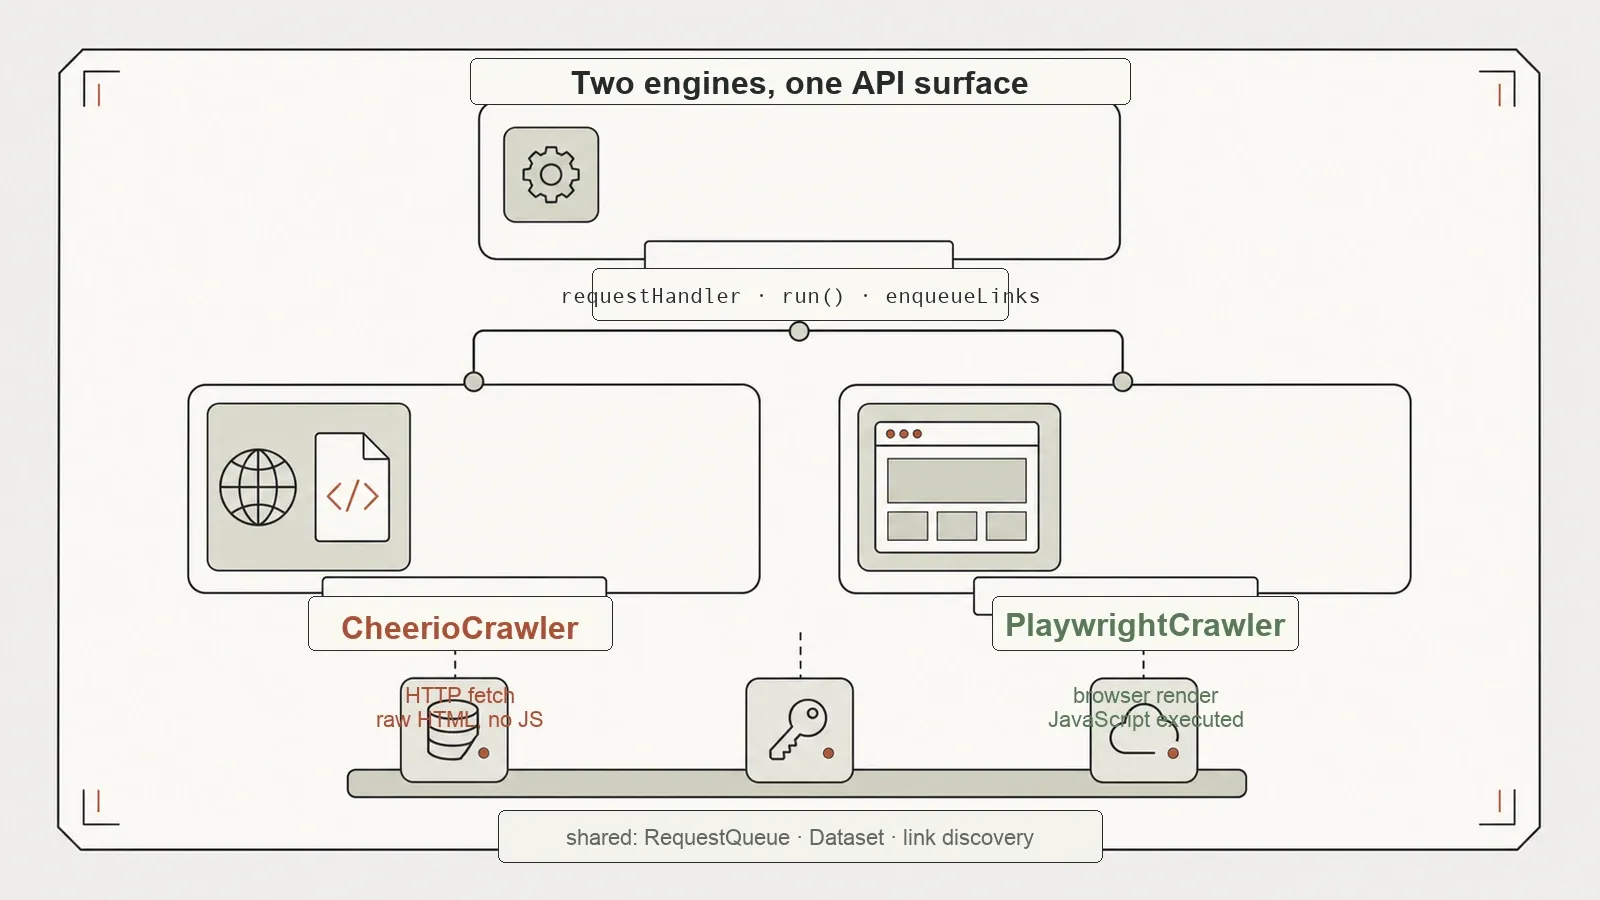
CheerioCrawler מביא HTML ומנתח אותו עם Cheerio; PlaywrightCrawler מפעיל את Chromium ויכול לצלם צילומי מסך. שניהם משתמשים ב-requestHandler, חושפים run(), ומשתפים מושגי סריקה כמו תורים וגילוי קישורים. ההקשרים של ההנדלר שונים: במסלול Cheerio שנבדק הוצאו הנתונים דרך $, ואילו במסלול הדפדפן נעשה שימוש ב-page, waitForSelector ו-$$eval. אפשר להשאיר את התשתית של התור והמחזור המוכר, אבל לוגיקת השליפה עצמה עלולה לדרוש התאמה או כתיבה מחדש.
מתחת לזה, Crawlee נותן את כל הצנרת שסריקה אמיתית צריכה. RequestQueue מנהל את חזית ה-URLs לביקור, מבטל כפילויות ועוקב אחרי מה שכבר טופל. enqueueLinks מגלה URLs חדשים ומכניס אותם לתור (עם סינון לפי selector ולפי אותו hostname) כך שהסריקה יכולה להתפשט לבד. Dataset אוסף את הרשומות ששלפתם לצורך ייצוא. כברירת מחדל Crawlee שומר את כל זה בתיקיית storage/ מקומית על הדיסק — נוח מאוד לחידוש עבודה, וקצת מעצבן בפעם הראשונה כשמגלים תיקיית storage/ שלא ביקשתם יושבת בפרויקט (בסביבת הבדיקה שלי ה-harness הפנה זאת לתיקיית temp וכיבה persistence כדי לשמור על בדיקה נקייה).
החלקים האלה לא מרשימים כשמסתכלים עליהם כל אחד בנפרד. הנקודה היא שהם משותפים לשני המנועים, כך שהתור, גילוי הקישורים וה-dataset מתנהגים אותו דבר בין אם סורקים דרך HTTP או דרך דפדפן. לומדים API אחד ומקבלים שתי אסטרטגיות שליפה.
התקנה: הדפדפן מותקן בנפרד
בהתקנה שנבדקה לא היה קובץ הרצה של Chromium אחרי התקנת החבילות.
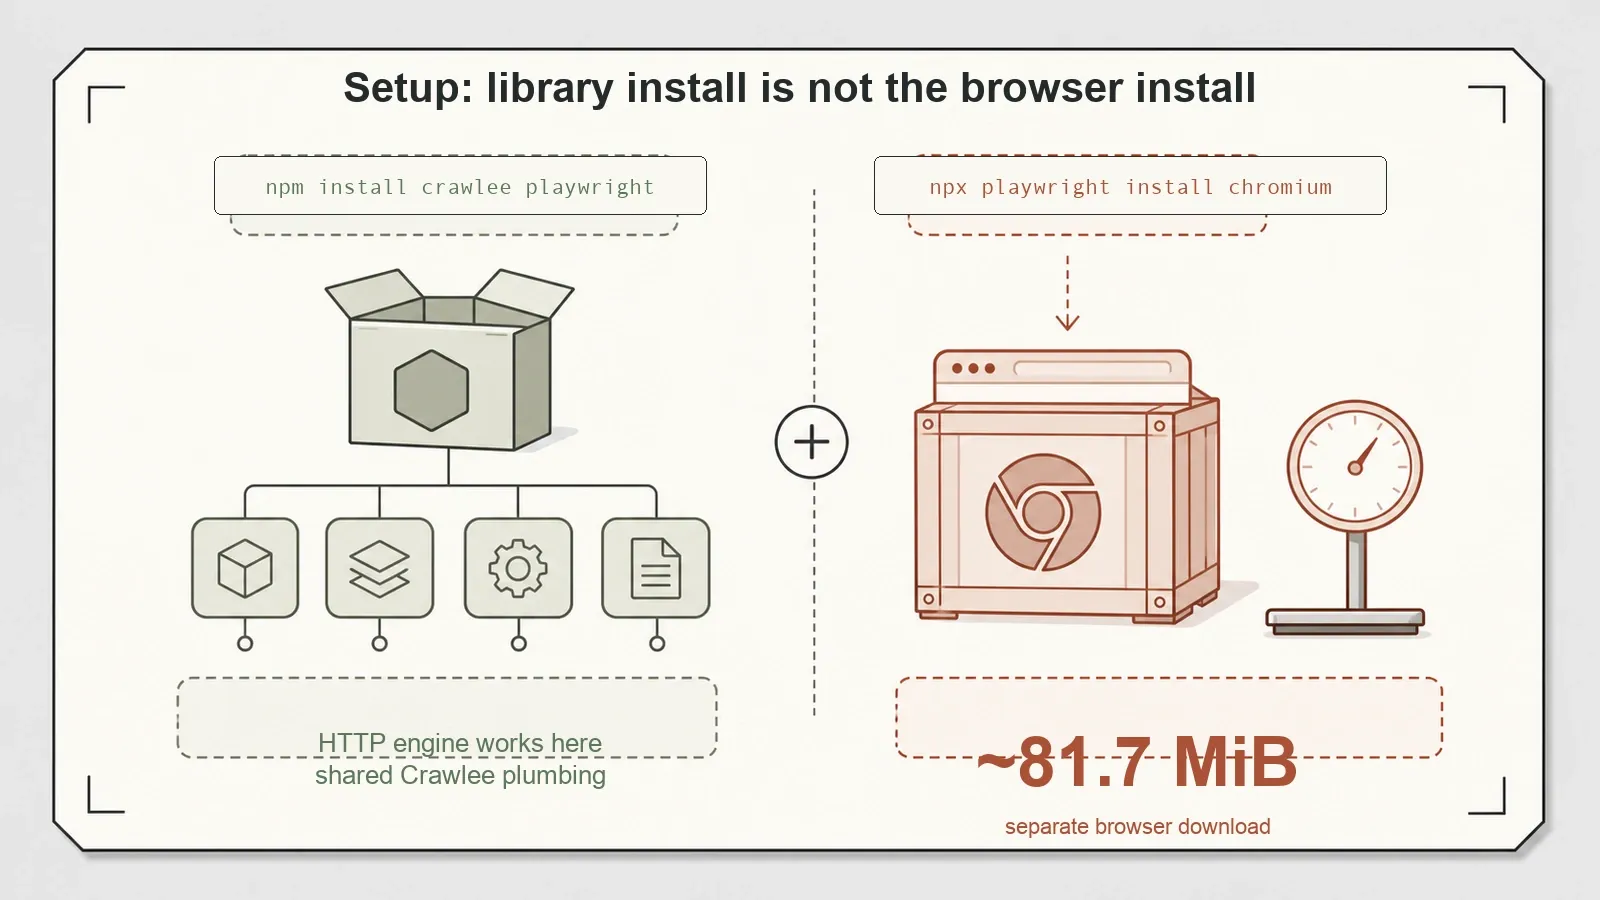
npm install crawlee playwright הותקן אצלי בצורה חלקה — 85 חבילות, 0 פרצות אבטחה, בלי דרמה. אם עוצרים שם ומריצים CheerioCrawler, הכול עובד, כי סריקת HTTP לא צריכה דפדפן.
בסביבה הזו היה צריך להתקין את Chromium בנפרד באמצעות npx playwright install chromium; בלעדיו PlaywrightCrawler לא הצליח להיפתח. עומס הדפדפן שנצפה היה בערך 82 MiB, אבל בהערות המקוריות לא נשמר האם זה היה גודל העברה או גודל על הדיסק. זו תצפית התקנה תלויה במכונה, לא תכונה קבועה של המוצר. מסלולי תיעוד והתנהגות חבילות יכולים להשתנות, ולכן המאמר הזה לא טוען שההשמטה היא אוניברסלית או שלא תתועד בעתיד.
כדאי לתכנן את ההתקנה שנבדקה כשני שלבים: קודם מתקינים את חבילות ה-Node, ואז מתקינים את הדפדפן שבו משתמש מסלול Playwright. יש לבדוק שוב את הוראות ההתקנה המעודכנות של Crawlee ו-Playwright לפי הגרסאות והפלטפורמה שבה אתם פורסים.
שימוש מעשי: אותו עמוד, שתי תשובות שונות מאוד
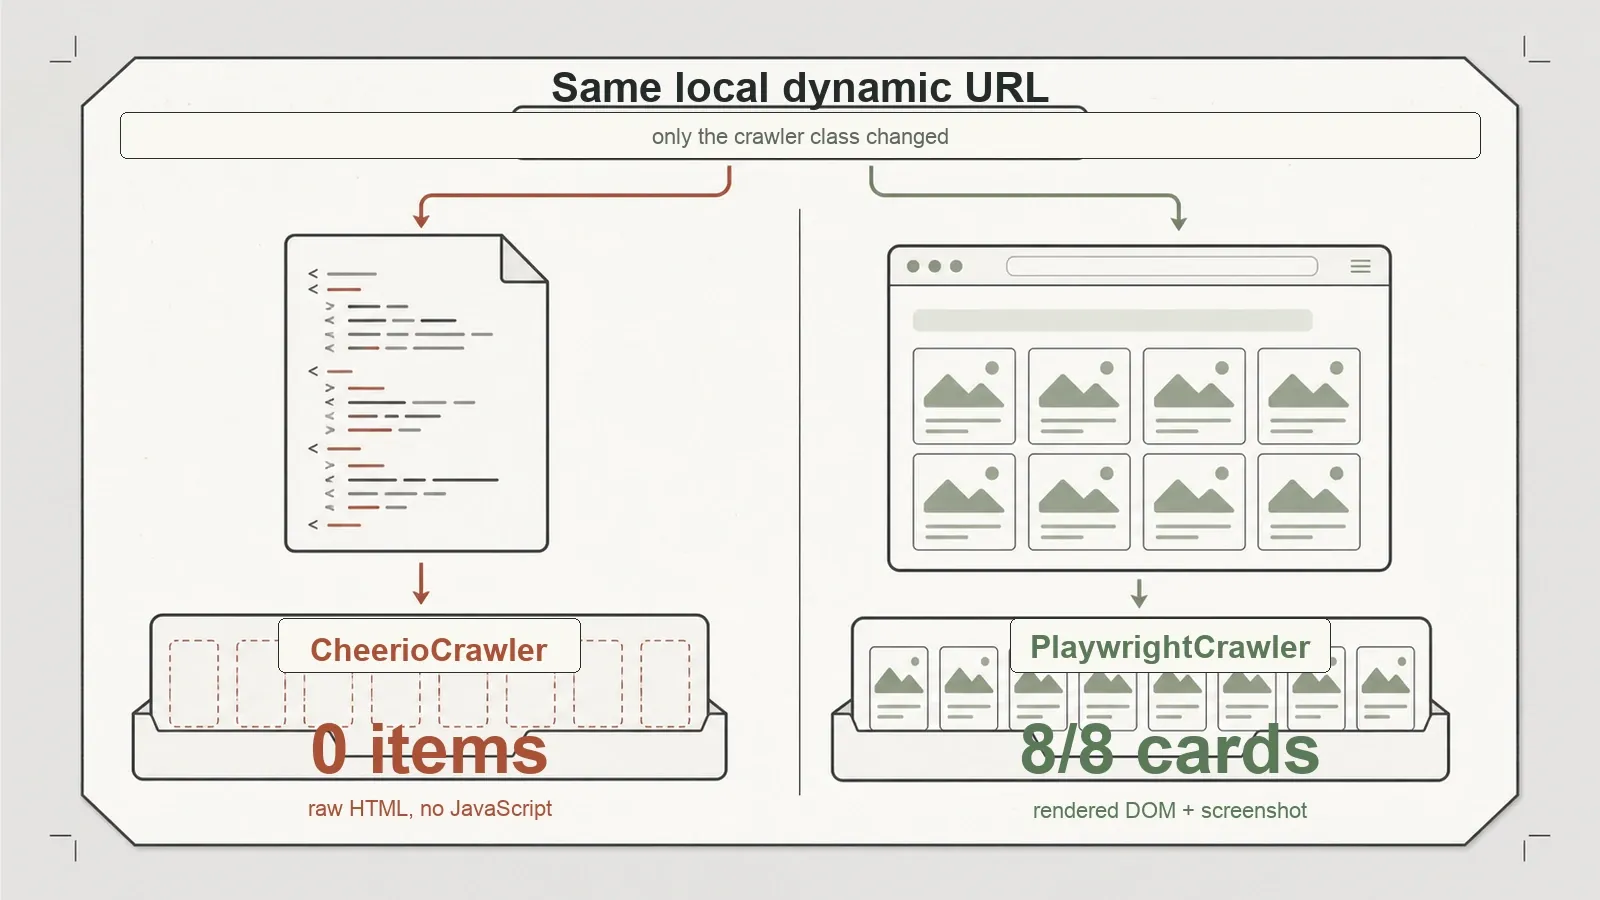
המבחן המרכזי שלח את אותו fixture שנבנה ב-JavaScript דרך שני הסורקים. ה-URL ושדות היעד היו משותפים; פרימיטיבי השליפה לא היו.
ב- fixture המקומי, CheerioCrawler החזיר 0 כרטיסי יעד כי הם לא הופיעו ב-HTML הגולמי. PlaywrightCrawler המתין ל-#dynamic-products article.product-card, ואז החזיר את כל 8 הכרטיסים הצפויים וגם צילם screenshot. התוצאה הזו מאששת שלמות ברמת ה-fixture עבור השדות שנבחרו לאחר ההמתנה הזו; היא לא אומרת שדפדפן רואה כל מצב אפשרי של עמוד. הקבצים הגולמיים וה-screenshot נמצאים בריפו של הבנצ'מרק.
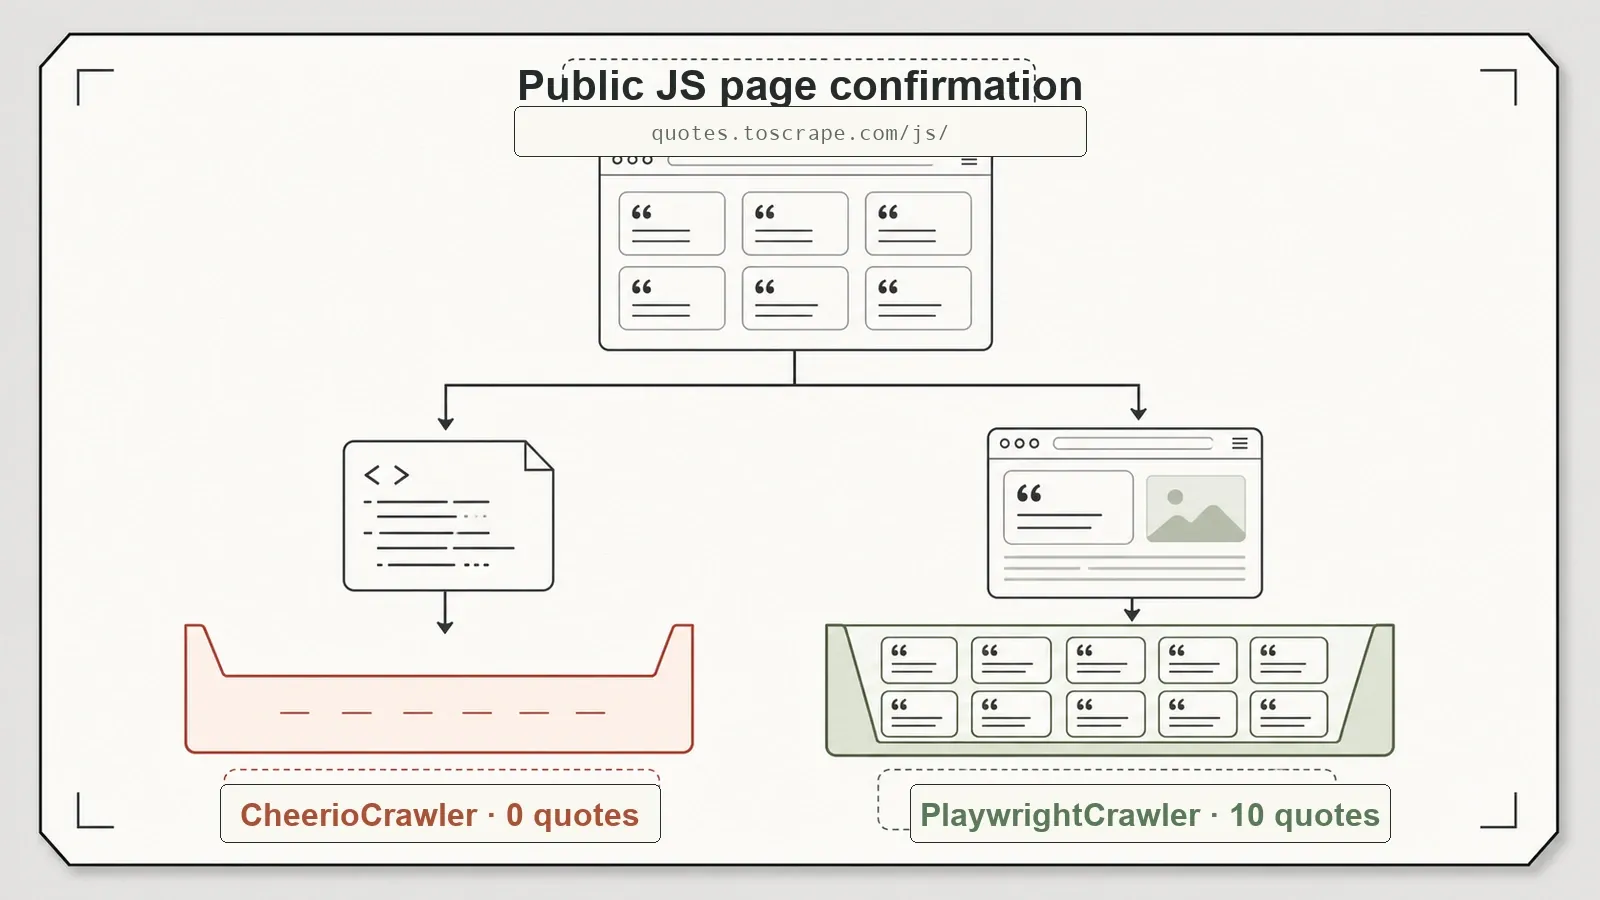
בדף הציבורי Quotes to Scrape JS, CheerioCrawler מצא 0 ציטוטי יעד ו-PlaywrightCrawler המתין ל-.quote לפני שחילץ 10. זה מאשר את אותו גבול בין HTTP לדפדפן גם ביעד ציבורי, בעוד שמחלקת הסורק, הקשר ההנדלרי, תנאי ההמתנה ופרימיטיב השליפה שונים בין המסלולים.
המסקנה השימושית צרה יותר: יש לוודא את השדות הנדרשים במסלול HTTP, ולעבור לסורק דפדפן כשהתגובה הגולמית לא כוללת אותם. גם בהנדלר הדפדפן צריך להמתין לתנאי שמחובר לשדות האלה.
מסלול ה-HTTP הפיק את כל הרשומות הצפויות בקטלוג הסטטי וב-fixtures של המאמרים, פענח את כל שמונת הפריטים הצפויים מתוך תגובת JSON ישירה, עבר גרף חסום של 11 עמודים, והעביר תגובת 500 אחת אל failedRequestHandler. אלו בדיקות יכולת נפרדות ולא ציון דיוק אחד. מול דף Books to Scrape הציבורי, הסלקטור שהוגדר החזיר 20 מוצרים כבדיקת smoke.
| בדיקה | מנוע | תוצאה |
|---|---|---|
| שליפה סטטית: קטלוג + עימוד | CheerioCrawler | 12/12 מוצרים צפויים |
| שליפת מאמרים | CheerioCrawler | כותרת + 3/3 פסקאות |
| תחבורה: תגובת JSON ישירה | CheerioCrawler | 8/8 מוצרים צפויים |
| ניווט: גרף קישורים פנימיים | CheerioCrawler | 11 עמודים, עומקים {0:1, 1:3, 2:7} |
| ניתוב כשל: HTTP 500 | CheerioCrawler | הסטטוס הגיע ל-handler של כשל |
| רינדור: fixture מקומי | CheerioCrawler | 0 כרטיסי יעד ב-HTML הגולמי |
| רינדור: fixture מקומי | PlaywrightCrawler | 8/8 אחרי המתנה לסלקטור היעד |
| רינדור: Quotes JS | CheerioCrawler | 0 ציטוטי יעד ב-HTML הגולמי |
| רינדור: Quotes JS | PlaywrightCrawler | 10 אחרי המתנה לסלקטור היעד |
זמני הריצה המלאים והמספרים לכל בדיקה נמצאים ב-results/crawlee-test-summary.json.
ועכשיו לסייגים הכנים, כי לריצה אחת על מכונה אחת יש מגבלות, ואני לא מתכוון להעמיד פנים אחרת. אלו זמנים, לא בנצ'מרקים — מכונה אחת, ריצה אחת לכל בדיקה, אז כדאי להתייחס לעלות הגבוהה יותר של מסלול הדפדפן לעמוד כאל "איטי משמעותית מהריצות של Cheerio שנמשכות פחות משנייה", ולא כמספר רשמי שפורסם. ויש גם לא מעט דברים שלא נבדקו כאן: סיבוב פרוקסי, מאגרי session, ריצות בקנה מידה גדול של מאות עד אלפי עמודים, persistence של RequestQueue וחידוש אחרי קריסה, מנוע Puppeteer, וארגונומיית הייצוא של Dataset/KeyValueStore (כאן כתבתי ייצוא ידני). אני יכול להעיד על סיפור שני המנועים ועל הדיוק ברמת ה-fixture. אני לא יכול להעיד על סקייל או על התמודדות עם חסימות, ולכן לא אטען שכן.
מה משותף, ומה חייב להשתנות
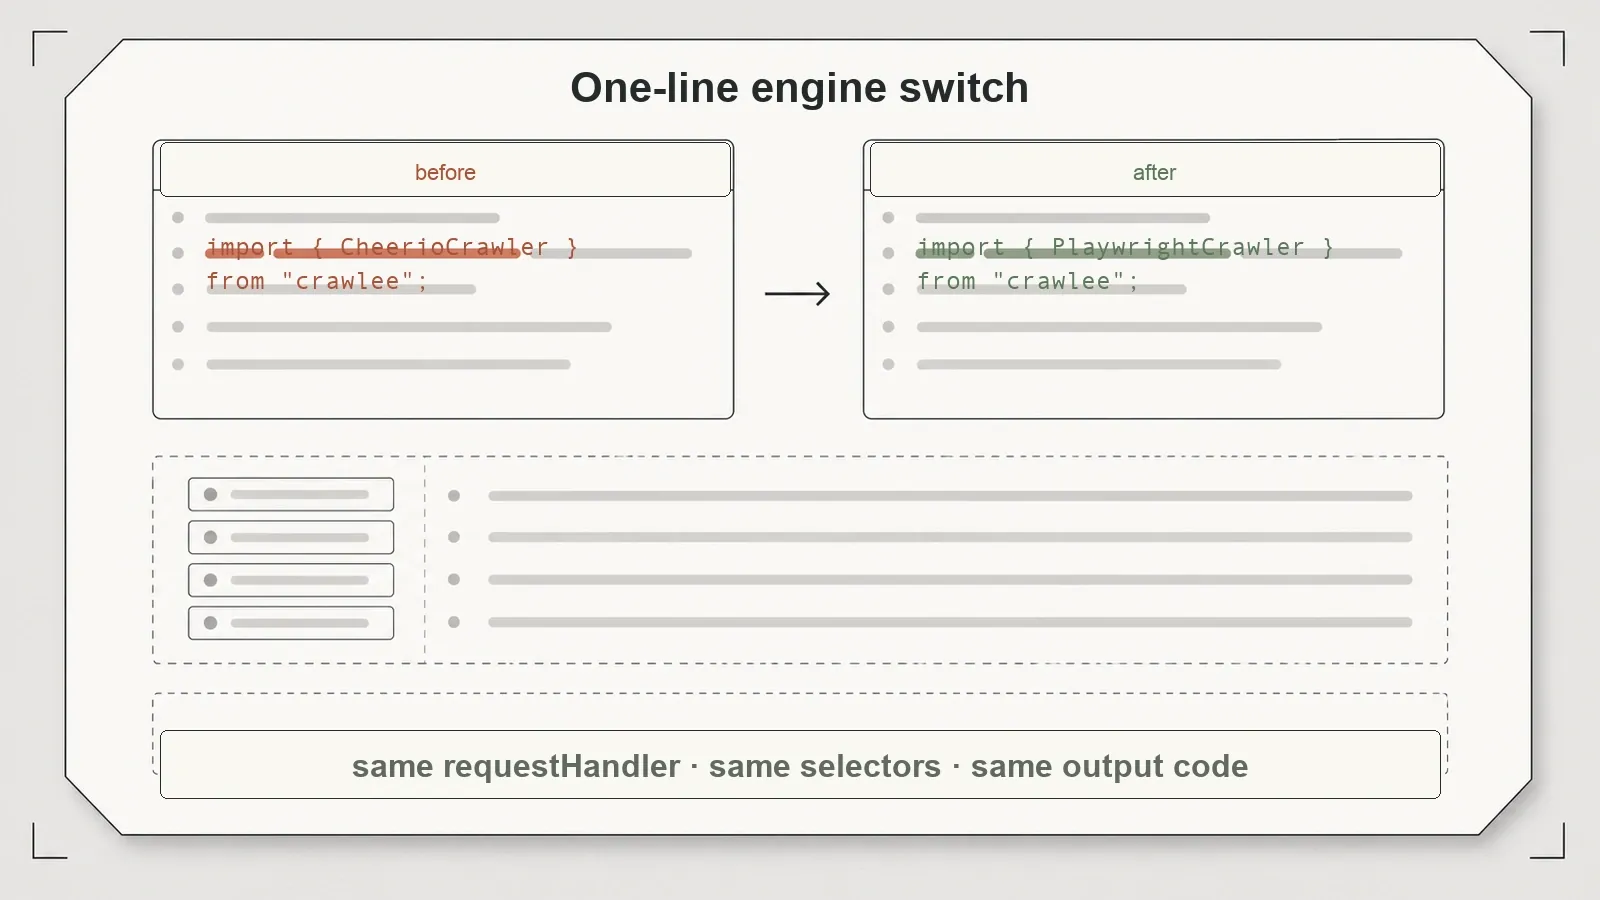
החזית המשותפת היא תזמור הסריקה. שתי מחלקות הסורק מקבלות requestHandler וחושפות run(). תורים, מטא-דאטה של בקשות, גילוי קישורים, hooks של כישלון ומושגי אחסון אפשר לארגן באופן עקבי סביב כל אחד ממסלולי הביצוע. זה מפחית את כמות התשתית שצוות צריך ללמוד מחדש כשיעד אחד דורש דפדפן.
החזית של הגישה לדף אינה משותפת. ההנדלר של CheerioCrawler מקבל גישה שמבוססת על Cheerio, כמו $, ויכול לעבוד עם גוף התגובה בלי דפדפן. ההנדלר של PlaywrightCrawler שנבדק מקבל page; הוא ממתין ל-selector ומבצע הערכות מעל ה-DOM של הדפדפן. גם כששני ההנדלרים מפיקים את אותו סכמת רשומה, הם מגיעים אליה דרך ממשקי API שונים. Adapter לשימוש חוזר יכול להסתיר חלק מהפער הזה, אבל ה-harness הזה לא מימש ולא הדגים כזה.
ההבחנה הזו חשובה להערכות. החלפת מחלקת הסורק אולי תשמור על התור, ה-dataset ומדיניות ה-URL, אבל selectors, בדיקות מוכנות, screenshots, שלבי אינטראקציה וטיפול בשגיאות עדיין יכולים להשתנות. לכן המאמר מתייחס ל“צנרת סריקה משותפת” כאל היתרון שאומת, ודוחה את הטענה ל“מיגרציה של שורה אחת” כהבטחה לא מגובה.
זרימת בחירה מעשית בין מנועים
כדאי להתחיל במסלול ה-HTTP כשה-HTML המוחזר או תגובת JSON ישירה כוללים את השדות הנדרשים. הגדירו חוזה של שלמות — מפתחות חובה, מינימום פריטים, או selector יעד — וכשלו במפורש כשהוא לא מתקיים. מערך ריק אינו הוכחה לכך שאין לדף נתונים; בשני המקרים של JavaScript כאן הוא פשוט אמר שהייצוג שנבחר לא כלל את האלמנטים המבוקשים.
| תנאי יעד | להתחיל עם | לעבור הלאה כש... |
|---|---|---|
| השדות הנדרשים קיימים ב-HTML המוחזר | CheerioCrawler | הסלקטורים או השדות הנדרשים חסרים |
| תגובת JSON שחוזרת באופן עקבי מכילה את הנתונים | CheerioCrawler | הבקשה תלויה במצב שרק דפדפן מייצר |
| העמוד מוסיף את רכיבי היעד לאחר הרצה | PlaywrightCrawler | לא רלוונטי; הגדירו בדיקת מוכנות ייעודית ליעד |
| לא ידוע איזה שילוב מופיע ביעד | HTTP תחילה עם ולידציית שלמות | הוולידציה נכשלת עם תוצאה טיפוסית של “הייצוג לא שלם” |
כשנדרשת הרצה, יש להעביר את הכשל הטיפוסי הזה להנדלר דפדפן. ב-harness הזה הדף המקומי המתין ל-#dynamic-products article.product-card, בעוד שדף הציטוטים הציבורי המתין ל-.quote. התנאים האלה הם חלק מחוזה השליפה. אירוע טעינה כללי לא מוכיח שנתוני האפליקציה כבר הגיעו, והבדיקה לא תומכת בכלל המתנה אוניברסלי.
אחרי המעבר למנוע הדפדפן, חשוב לשמור על סכמת פלט יציבה גם אם פרימיטיבי ה-DOM שונים. יש לתעד איזה מנוע הפיק את התוצאה, איזה תנאי מוכנות עבר, והאם ולידציית השדות הנדרשים הצליחה. כך fallback מ-HTTP לדפדפן נשאר גלוי במקום להפוך בשקט שדות חסרים לרשומות תקינות לכאורה.
לבסוף, צריך להתייחס להתקנת הדפדפן ולעלות ההפעלה כאל קלט לפריסה. התצפית של כ-82 MiB שימושית רק כסדר גודל מקומי; כדאי למדוד במדויק את גרסת הדפדפן, הפלטפורמה, התנהגות המטמון והשפעת התמונה בסביבה שלכם. גם סיבוב פרוקסי, sessions, persistence, התאוששות מקריסה ומקביליות מתמשכת צריכים בדיקות משלהם לפני ש-fixture כזה יכול להנחות בחירה בקנה מידה של production.
יתרונות וחסרונות
יתרונות:
- סורקי HTTP ודפדפן חולקים מושגי מחזור חיים, אבל מציעים הקשרי שליפה ייחודיים למנוע.
- דיוק מלא של 1.0 בשליפת HTTP בקטלוגים סטטיים, מאמרים ו-API-ים של JSON.
- תשתית משותפת בין שני המנועים:
RequestQueue, enqueueLinksעם שליטה בעומק, Dataset. - מסלול הדפדפן הריץ את הסקריפטים של ה-fixture ושיחזר את כל פריטי היעד הצפויים בשתי בדיקות ה-JS.
- טיפול נקי בכשלים — HTTP 500 עלה בלי לקריס את הריצה.
- רישיון Apache-2.0; משתמשים downstream צריכים לעיין בחובות ההודעה והייחוס.
חסרונות:
- בסביבה שנבדקה מנוע הדפדפן דרש התקנת Chromium נפרדת; בלעדיה
PlaywrightCrawlerלא הופעל. - מסלול ה-HTTP לא יכול לחשוף אלמנטים שמהם היעד פשוט לא נמצא ב-HTML הגולמי; בלי ולידציית שלמות זה עלול להיראות כמו תוצאה ריקה תקינה.
- מסלול הדפדפן נושא עמו גם בינארי דפדפן נוסף וגם עלות גבוהה יותר לעמוד בריצה הזו; הגודל והזמנים משתנים לפי build ופלטפורמה.
- ריצות ברירת המחדל משאירות אחריהן תיקיית
storage/על הדיסק. - מיועד רק ל-Node/TypeScript — לא נותן מענה אם הסטאק שלכם הוא Python.
למי זה מתאים — ולמי עדיף לוותר
Crawlee מתאים לצוותי Node או TypeScript שצריכים גם HTTP וגם סריקת דפדפן תחת מושגי תור ומחזור חיים משותפים. דרך עבודה פרקטית היא לנסות קודם את סורק ה-HTTP, לאמת את השדות הנדרשים, ולהעביר כשל של שלמות לטיפול דפדפן עם תנאי מוכנות שמותאם ליעד. קוד הגישה ל-DOM של ההנדלר הוא ייעודי למנוע, גם כשצנרת התור וגילוי הקישורים משותפת.
כדאי לאפס ציפיות, או לחפש פתרון אחר, אם אתם צוות Python (Crawlee הוא ל-Node/TS — יש פורט נפרד ל-Python, אבל הבדיקה כאן נעשתה על ספריית Node), אם כל היעדים שלכם סטטיים והייתם מעדיפים סקרייפר HTTP רזה וממוקד, או אם אתם צריכים התנהגות מוכחת בקנה מידה — סיבוב פרוקסי, מאגרי session, חידוש אחרי קריסה — שהבדיקה המעשית הזו לא כיסתה. ואם אתם בוחרים ב-PlaywrightCrawler, תתקינו קודם את Chromium, אחרת הוא פשוט לא ירוץ.
חלופות, כולל המקום של Thunderbit
Crawlee הוא קוד פתוח שמריצים ומתחזקים בעצמכם. אין בו עמלת ספק לפי קריאה, אבל עלויות המחשוב של הדפדפן, רוחב פס, פרוקסי, אחסון, תצפית והנדסה נשארות עליכם. אתם אחראים לבחירת הסורק, לבינארי של הדפדפן, למצב האחסון וללוגיקת המוכנות.
סקירה קשורה: סקירת scrapy-playwright.
שירות חילוץ מנוהל מעביר את האחריות על האיסוף ועל עיצוב הסכמה לספק. אנחנו בונים את Thunderbit, אבל לא הרצנו אותו מול ה-fixtures האלה, ולכן המאמר הזה לא תומך בשום השוואה של איכות, latency, התאמת יכולות או עלות. ההחלטה הרלוונטית היא אם הצוות שלכם רוצה שליטה בתוך התהליך כמו של Crawlee, או גבול שירות לפי קריאה.
סקירות בנצ'מרק קשורות: ההשוואה המלאה של סקרייפרים בקוד פתוח, Playwright מול Puppeteer על אותם עמודים, ו-סקירת Scrapy ללא-דפדפן של replay לבקשות.
נסו את Thunderbit לחילוץ נתוני רשת
שורה תחתונה
Crawlee הוא מועמד חזק לצוותי Node או TypeScript שרוצים תזמור סריקה משותף בין HTTP לבין הרצה בדפדפן. ההנדלרים שנבדקו לא היו ניתנים להחלפה: המעבר ל-Playwright דרש page, המתנה ל-selector יעד ושליפה מצד הדפדפן. Proxy, sessions, persistence, resume והתנהגות בקנה מידה גדול עדיין פתוחים.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
מה ההבדל האמיתי בין שני הסורקים של Crawlee?
CheerioCrawler מביא HTML דרך HTTP ולא מריץ JavaScript. PlaywrightCrawler מפעיל את Chromium ויכול להריץ סקריפטים של הדף וגם לצלם screenshots, בעלות מקומית גבוהה יותר לעמוד. הם חולקים מושגי מחזור חיים, אבל לא הקשרי הנדלר זהים: כאן נעשה שימוש ב-$ במסלול ה-HTTP וב-page, בהמתנה ל-selector יעד ובביצוע הערכות מצד הדפדפן במסלול Playwright.
למה PlaywrightCrawler לא רץ אחרי שהתקנתי את Crawlee?
בסביבה שנבדקה, התקנת החבילה לא סיפקה קובץ הרצה של דפדפן. התקנת Chromium עם npx playwright install chromium פתרה את כשל ההפעלה. העומס שנצפה היה בערך 82 MiB, אבל המדידה המקורית לא שמרה האם זה היה גודל העברה או גודל על הדיסק, אז כדאי למדוד מחדש לפי הפלטפורמה וה-build שלכם.
האם CheerioCrawler יכול לסרוק דפים שמרונדרים ב-JavaScript?
הוא לא יכול להריץ את ה-JavaScript של הדף. אבל הוא כן יכול לבקש נקודת קצה JSON נגישה שבה הלקוח משתמש, כפי שמראה ה-fixture של התגובה הישירה. כשנתוני היעד קיימים רק אחרי הרצת דפדפן, צריך להשתמש בסורק דפדפן ובתנאי מוכנות שמחובר לשדות האלה.
האם Crawlee מדויק לשליפה סטטית רגילה? ב-fixtures המבוקרים, ההנדלרים הפיקו 12/12 מוצרים צפויים מהקטלוג, 3/3 פסקאות צפויות מהמאמר, ו-8/8 פריטי JSON ישיר צפויים. אלו בדיקות של שלמות ה-fixture, לא ציון דיוק כללי לאתרים שלא נבדקו.
האם Crawlee חינם לשימוש מסחרי? הוא מופץ תחת Apache-2.0. יש לאשר את הרישיון הנוכחי ב-repository ולעיין בחובות ההודעה והייחוס עבור ההפצה שלכם.
לפני מעבר לייצור, בדקו את החלקים שה-fixture הזה משאיר פתוחים: מקביליות חוזרת על דפים מייצגים, התנהגות פרוקסי ו-session, התאוששות תור מתמשך אחרי הפרעה, ניקוי תהליכי דפדפן, וייצוא dataset תחת כשל. שמרו יחד עם התוצאות את גרסת הדפדפן שנפתרה ואת נתיב ההתקנה. שתי מחלקות הסורק מצמצמות הבדל בתזמור, אבל הן לא מבטלות את הצורך בבדיקות מוכנות ייעודיות למנוע, בתקציבי משאבים ובהתמודדות תפעולית עם כשלים.




