
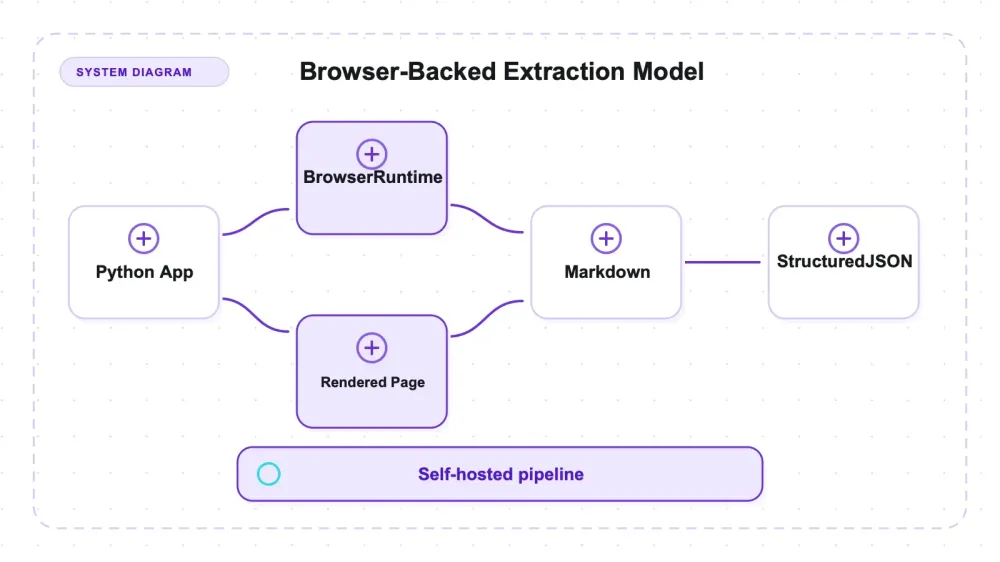
חלק מההשוואות של סקרייפרים מצד שלישי מייחסות ל־"Adaptive Intelligence" — כלומר סלקטורים שלומדים אתר ומתקנים את עצמם אחרי שינויי HTML — ל־Crawl4AI. בבדיקת ממשקי ה־API שנחשפו לא מצאתי התנהגות כזו. מה ש־Crawl4AI כן מספק הוא יצירת Markdown על בסיס דפדפן יחד עם חילוץ באמצעות CSS/XPath. Scrapling מציג יכולת נפרדת של סלקטורים אדפטיביים, בתוך המגבלות שמתוארות בסקירה שלו.
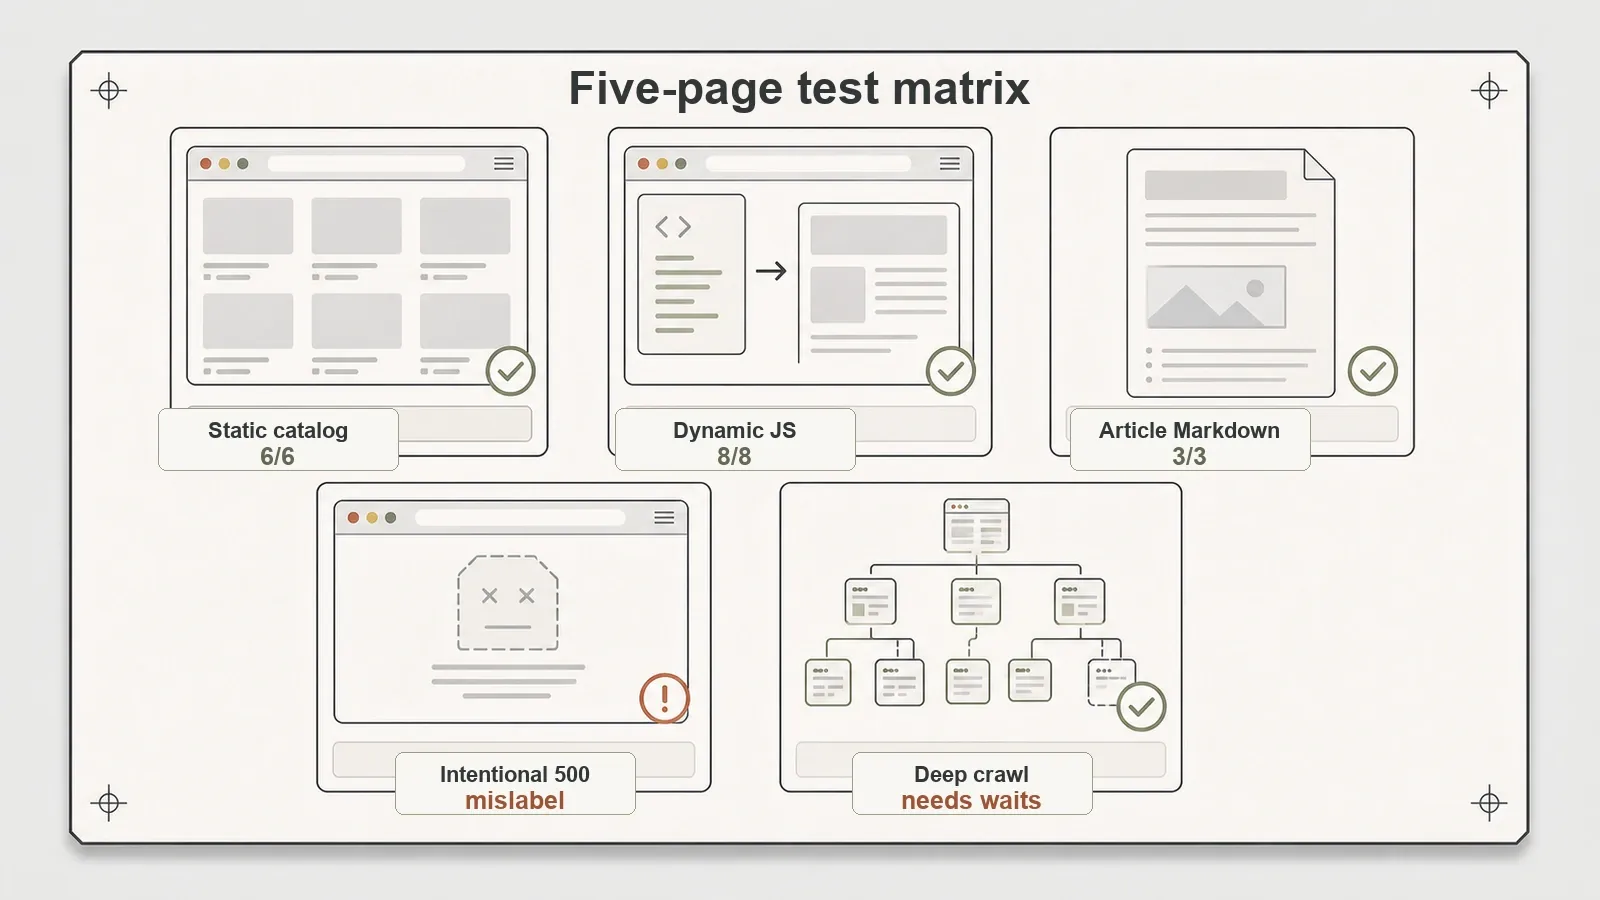
הרצתי את Crawl4AI בגרסה 0.9.0 על חמישה סוגי דפים עם אמת מידה ידועה: קטלוג סטטי, קטלוג שמרונדר ב־JavaScript, מאמר עם הרבה מעטפת סביבו, שגיאת 500 מכוונת, וגרף רב־עמודי מקושר. נתיבי ה־Markdown וה־schema שנבדקו החזירו את התוכן הצפוי. ה־Markdown הגולמי שמר את כל ה־boilerplate, סריקה עמוקה דרשה המתנות ייעודיות לדף, ושגיאת 500 רגילה קיבלה תווית שדומה לאנטי־בוט.
מה Crawl4AI באמת הוא
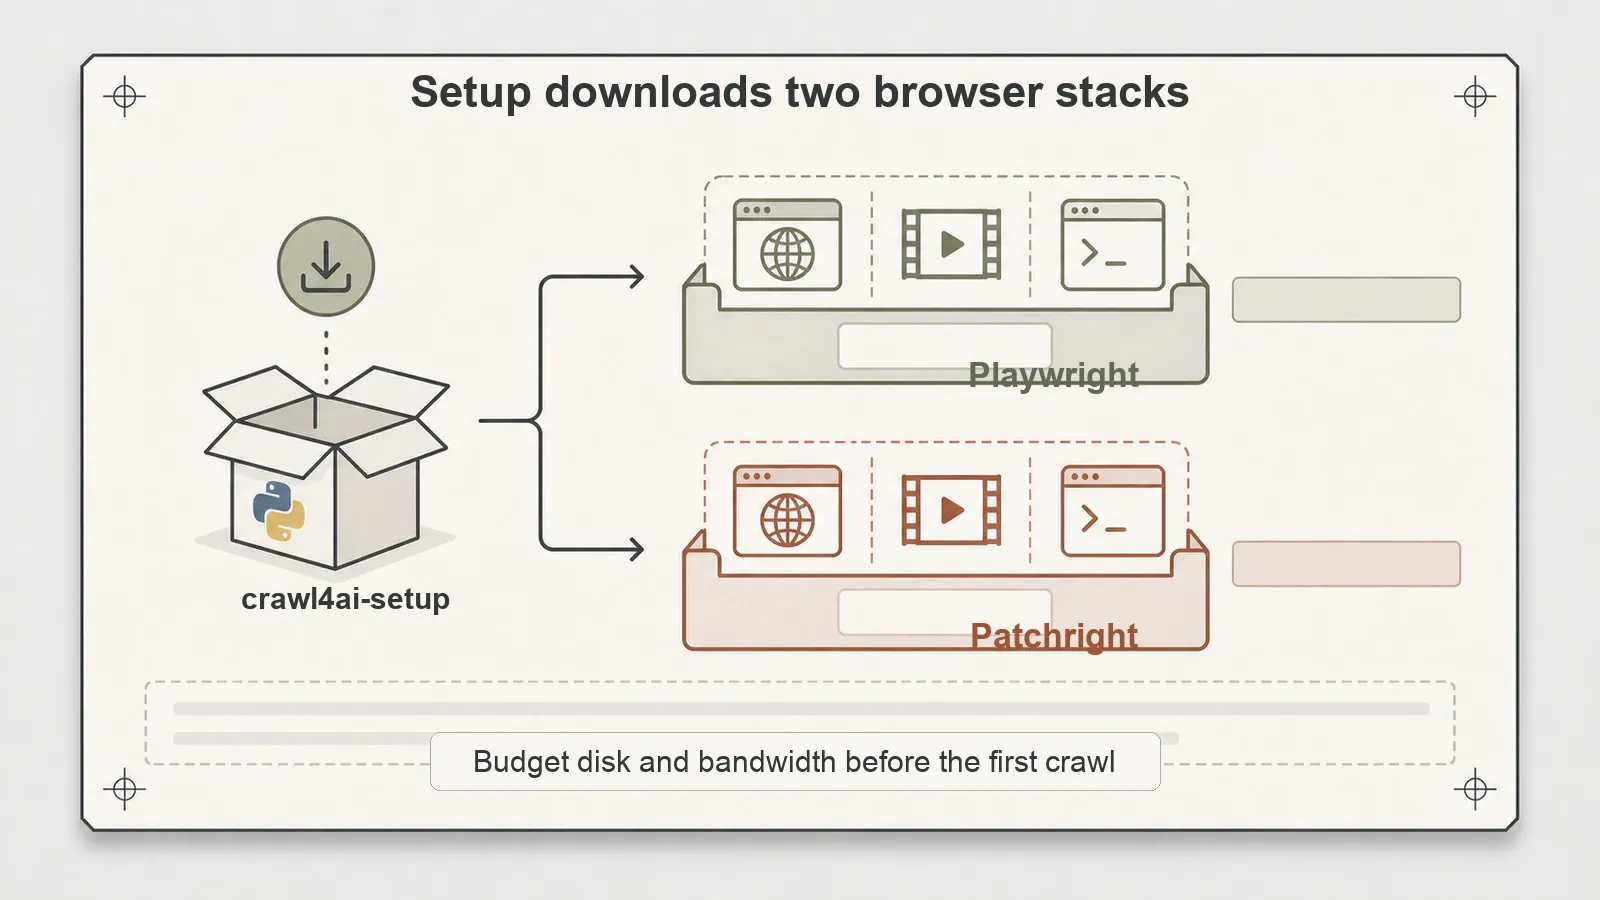
נתחיל במה שהרבה אנשים מפספסים כבר בשלב ההתקנה. Crawl4AI הוא לא parser קטן ב־Python. הרצת crawl4ai-setup הראשונה מורידה בשקט שני סטאקים מלאים של דפדפן — גם Playwright וגם Patchright — וכשמסתכלים על זה כך, הכל מסתדר: זה דפדפן headless מנוהל, עם ממיר ל־Markdown מעליו, שפשוט לובש תחפושת של סקרייפר.
רשמית, זו ספריית קוד פתוח תחת Apache-2.0 שממירה דפי אינטרנט ל־Markdown עבור pipelines של RAG, סוכנים וזרימות עבודה של נתונים. בדקתי את v0.9.0. אבני הבניין המרכזיות שלה כוללות AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, יצירת Markdown, ואסטרטגיות חילוץ מבוססות CSS/XPath או LLM, לפי המדריך הרשמי לתחילת עבודה.
המודל המחשבתי החשוב כאן הוא כזה: רוב ספריות ה־parsing שולחות בקשת HTTP ומפרשות את הבתים שחוזרים; Crawl4AI מפעיל דפדפן אמיתי. רינדור בתוך הדפדפן כבר מובנה, וזה הופך את ההתקנה לכבדה יותר מ־HTTP parser טהור, אבל חילוץ אמין מאלמנטים שמופיעים באיחור עדיין עשוי לדרוש המתנה מפורשת. שום דבר שנבדק כאן לא שינה סלקטורים אחרי redesign. כדאי להתייחס לטענת ה־self-healing כאל טעות של השוואה מצד שלישי, אלא אם מוצג מקור רשמי ספציפי יחד עם API שניתן לשחזר.
תכונות מרכזיות, ואיך הן עובדות מתחת למכסה המנוע
הנתיב של דף בודד הוא הלב של הכלי. מעבירים את AsyncWebCrawler ל־URL, הוא טוען את הדף בדפדפן, ומחזיר Markdown. ב־quickstart הרשמי של example.com הסבב הזה לקח 1.81 שניות והחזיר 200 נקי. אין כאן משהו נוצץ, אבל זה מוכיח שהמסלול המינימלי עובד כמעט בלי קונפיגורציה — בלי schema, בלי waits, בלי הגדרות דפדפן.
מדריך וידאו (1:02:38): Crawl4AI Official Tutorial, Full 1hr with Quickstart Examples.
חילוץ מובנה הוא העמודה השנייה, והוא הדבר הכי קרוב שיש ל־Crawl4AI ל"הבנת" דף — כלומר, לא הסקה, אלא פשוט schema שאתה מגדיר. במקום לזרוק רק Markdown, מעבירים לו schema של CSS דרך JsonCssExtractionStrategy ומקבלים אובייקטי JSON עם השדות המדויקים שביקשת. בקטלוג הסטטי המקומי שלי הוא החזיר 6 רשומות JSON נקיות — שם מוצר, קטגוריה, מחיר, דירוג, וקישור לפרטים — תואם ל־6 המוצרים הצפויים. זה ההבדל בין "הנה הדף כטקסט" לבין "הנה הנתונים כשורות", ו־Crawl4AI עושה את שניהם מאותה סריקה. אבל הסלקטורים הם באחריותך; הכלי מתאים את עצמו למה שנתת לו, הוא לא מסיק את ה־schema בשבילך.
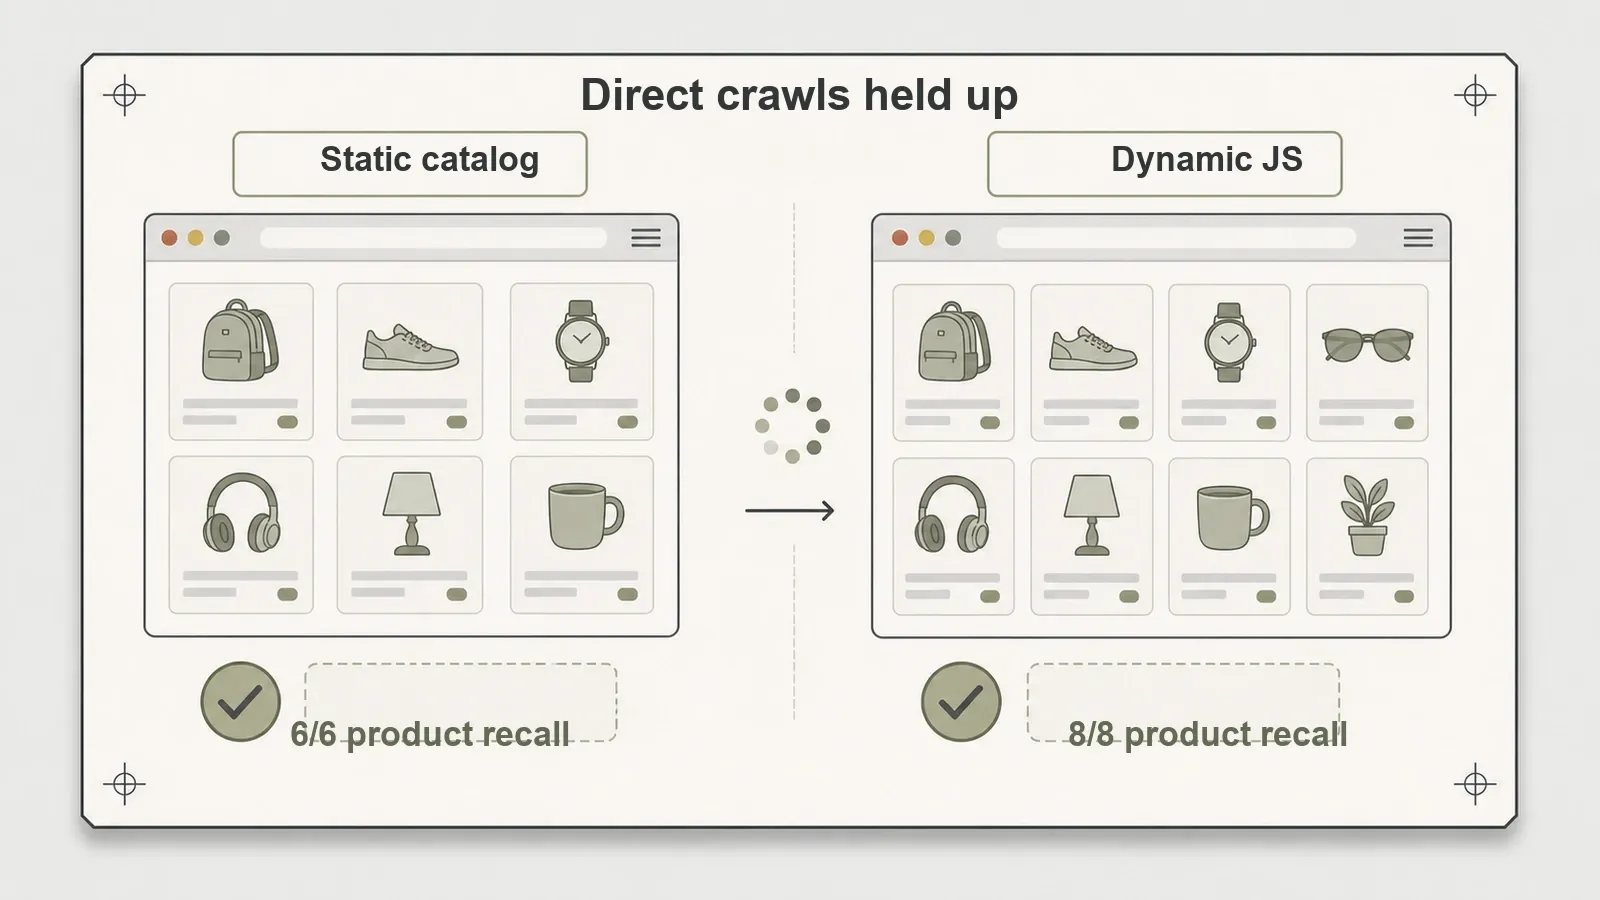
רינדור דינמי הוא המקום שבו התמיכה בדפדפן באמת משתלמת. הצבעתי עליו על קטלוג שמרונדר ב־JavaScript עם wait_for="css:.product-card", והוא המתין עד שהרינדור בצד הלקוח הסתיים לפני החילוץ. זה הניב 8/8 שליפה של מוצרים גם ב־Markdown וגם בפלט schema ב־fixture ה־JS המקומי שלי, בכ־1.56 שניות. בדף הציבורי Quotes to Scrape JS page הוא קלט את הציטוטים המרונדרים ושמר צילום מסך שימושי — תוכן שבקשת HTTP רגילה לעולם לא תראה, כי ב־HTML הראשוני פשוט אין מה לפרש.
יש גם עניין של קנה מידה וסריקה. arun_many() רץ על שישה דפי פירוט מקומיים במקביל עם 6/6 שליפה מלאה בתוך 3.76 שניות. ו־Crawl4AI מגיע גם עם אסטרטגיות deep-crawl — BFS, DFS, BestFirst — שסורקות גרף קישורים עם מגבלות עומק, תקרות כמות, סינון ודירוג. BFS deep crawl עבר על גרף הקישורים של דף הבית ב־fixture שלי ומשך פנימה חמישה דפים. כאן מתחיל הפער בין ההבטחה לבין המציאות, ואגיע לזה מיד.
ההתקנה: החלק שאף אחד לא שם בהקדמה של ה־README
אצלי ההתקנה עברה חלק יותר מהצפוי מצד אחד, וכבדה יותר מצד שני. pip install -U crawl4ai ו־smoke test הצליחו על Python 3.14.2 ב־macOS arm64. ה־specifier של PyPI >=3.10 כבר כולל 3.14; התוצאה הזו מאשרת רק את ההתקנה והזרימה שנבדקו, לא תאימות רחבה יותר.
החיכוך האמיתי הוא שלב ההכנה. crawl4ai-setup מוריד נכסי דפדפן עבור גם Playwright וגם Patchright — Chrome for Testing, FFmpeg, Headless Shell. אם אתה על לפטופ עם מקום מוגבל בדיסק או חיבור מדוד, זה מחיר ממשי, ובתיעוד מזכירים אותו כבדרך אגב ולא מראש. לאחר מכן crawl4ai-doctor עבר וביצע crawl ל־crawl4ai.com בתוך 14.65 שניות, וזה smoke test סביר מקצה לקצה אבל לא benchmark של שום דבר — לא הייתי מסיק מהמספר הזה מסקנות על מהירות.
המסקנה לחלק ההתקנה בהערכה שלך: תתקצב את ההורדה של הדפדפן, לא רק את pip install. זה קרוב יותר להקמת סביבת headless browser מאשר להוספת ספרייה לסקריפט. שני סטאקים של דפדפן נוחתים על הדיסק לפני שסורקים אפילו דף אמיתי אחד, וזה עלות חד־פעמית שמשלמים גם אם עומס העבודה שלך לעולם לא יצטרך את שכבת ההתגנבות של Patchright.
עבודה מעשית: מה החזיק מעמד, ומה הייתי מסמן
ארבע תוצאות שווה לכתוב בזהירות, כי הן בדיוק מה שספיישל שיווקי נוטה להחליק — ובמקרה אחד אפילו לתייג לא נכון.
שני דפי הדגמה ציבוריים עברו גם הם את המסלול החיובי. בדף הבית של Books to Scrape Crawl4AI ייצר 13,476 תווים של Markdown ב־2.43 שניות. דף ה־Quotes JS הציבורי החזיר 1,666 תווי Markdown מרונדרים בכ־3.1 שניות. אף אחד מהם לא אומר משהו על קנה מידה, על אתרים עוינים, על יציבות לטווח ארוך, סשנים, פרוקסים, retries או התנהגות זיכרון.
ה־fixture של המאמר חושף הסתייגות לגבי איכות ה־Markdown. Crawl4AI קלט את הכותרת ואת כל 3/3 פסקאות הגוף — מצוין. אבל ה־Markdown הגולמי שמר גם טקסט של ניווט, קישורים קשורים, שורת subscription וטקסט של footer. זו לא תקלה; בלי content filter או target selector, "להמיר את הדף ל־Markdown" באמת אומר את כל הדף. הלקח הוא להבחין בין המרה גולמית ל־Markdown לבין חילוץ נקי של מאמר. אם רוצים את השני, פונים ל־content filter כמו PruningContentFilter או ל־target selector — ושם עדיין לא עשיתי stress test, כך שלא אנקוב במספר ניקיון.
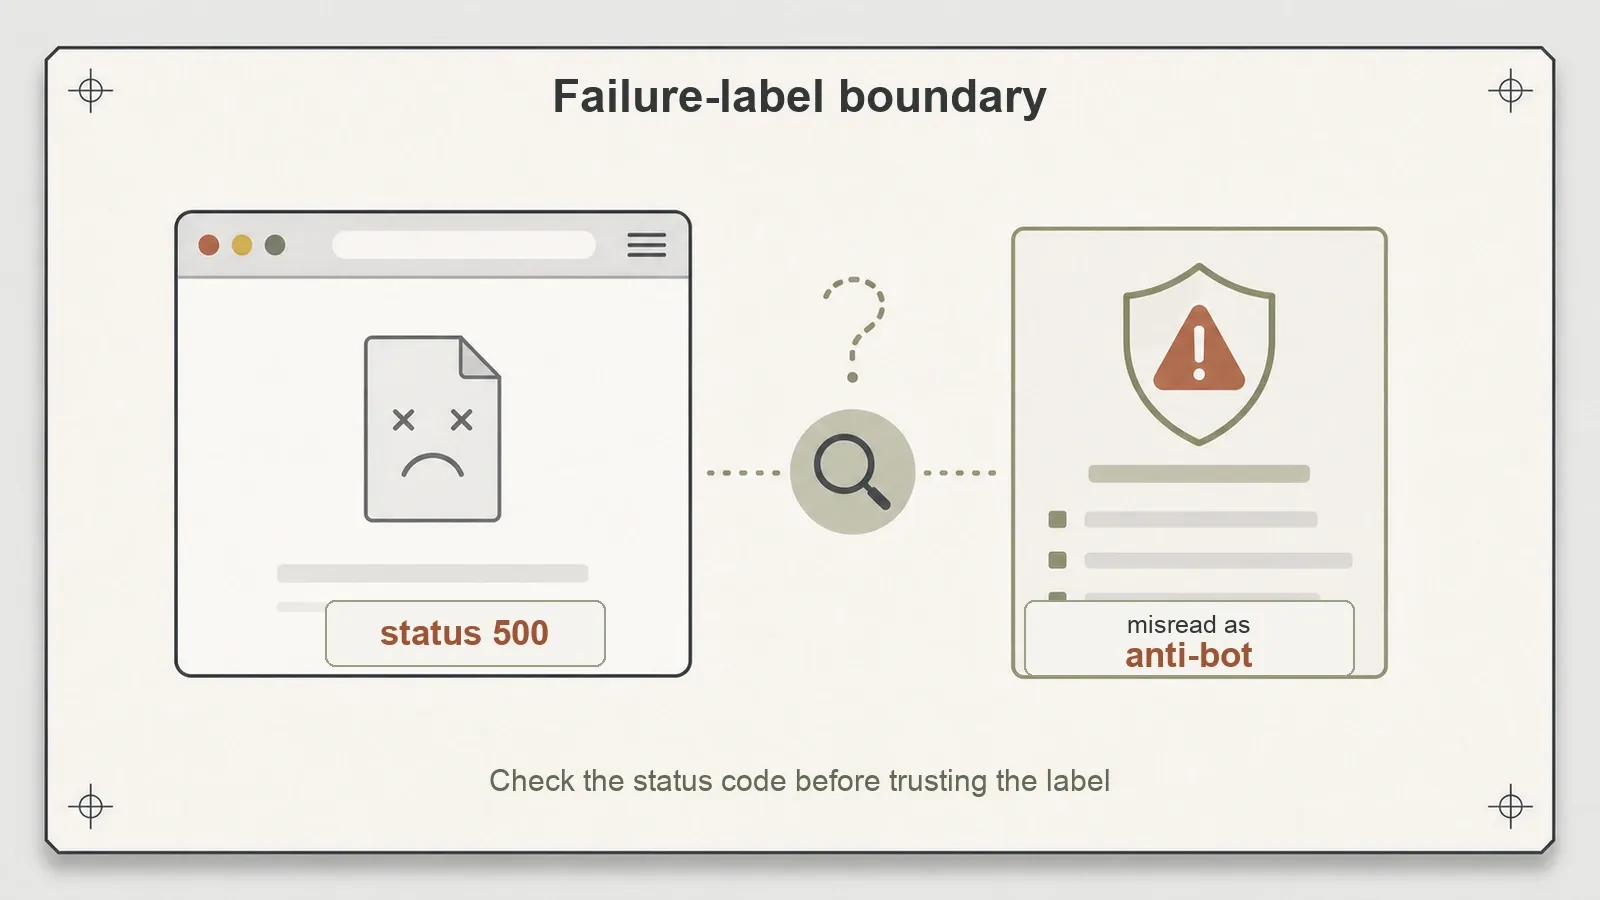
הדף השבור היה התוצאה הכי חושפת. הגשתי במכוון HTTP 500 עם גוף קטן מאוד. Crawl4AI החזיר success=false וסטטוס 500 — נכון — אבל הודעת השגיאה תייגה זאת כ־"Blocked by anti-bot protection: Structural: minimal_text on small page." לא הייתה כאן חומת אנטי־בוט. זה היה דף שגיאה קטן. ההיוריסטיקה המבנית של Crawl4AI ראתה מעט מאוד טקסט גלוי והסיקה הסבר של אנטי־בוט. למי שבונה עליו, זה חשוב: אל תסמכו על תווית ה־"anti-bot" כעל עובדה. בדקו את קוד הסטטוס ואת התגובה בפועל לפני שמסיקים שהאתר נלחם בכם. התוצאה הגולמית נמצאת במאגר ה־benchmark ב־results/local_failure_500.json.
סריקה עמוקה דורשת קונפיגורציה מכוונת. crawl דינמי ישיר עם wait_for עבד בצורה נקייה, בעוד ש־BFS deep crawl גילה את הקטלוג הדינמי והחזיר כישלון. הסיווג של minimal-text תואם קריאה לפני שהכרטיסים רונדרו, וה־deep crawl לא הפעיל את ה־wait של ה־crawl הישיר. מתוך חמישה דפים, שלושה הצליחו ושניים נכשלו. מכיוון שלא מוצג כאן rerun עם wait מתאים, זו נשארת השערה ולא סיבה מוכחת.
לאן המספרים באמת נוחתים
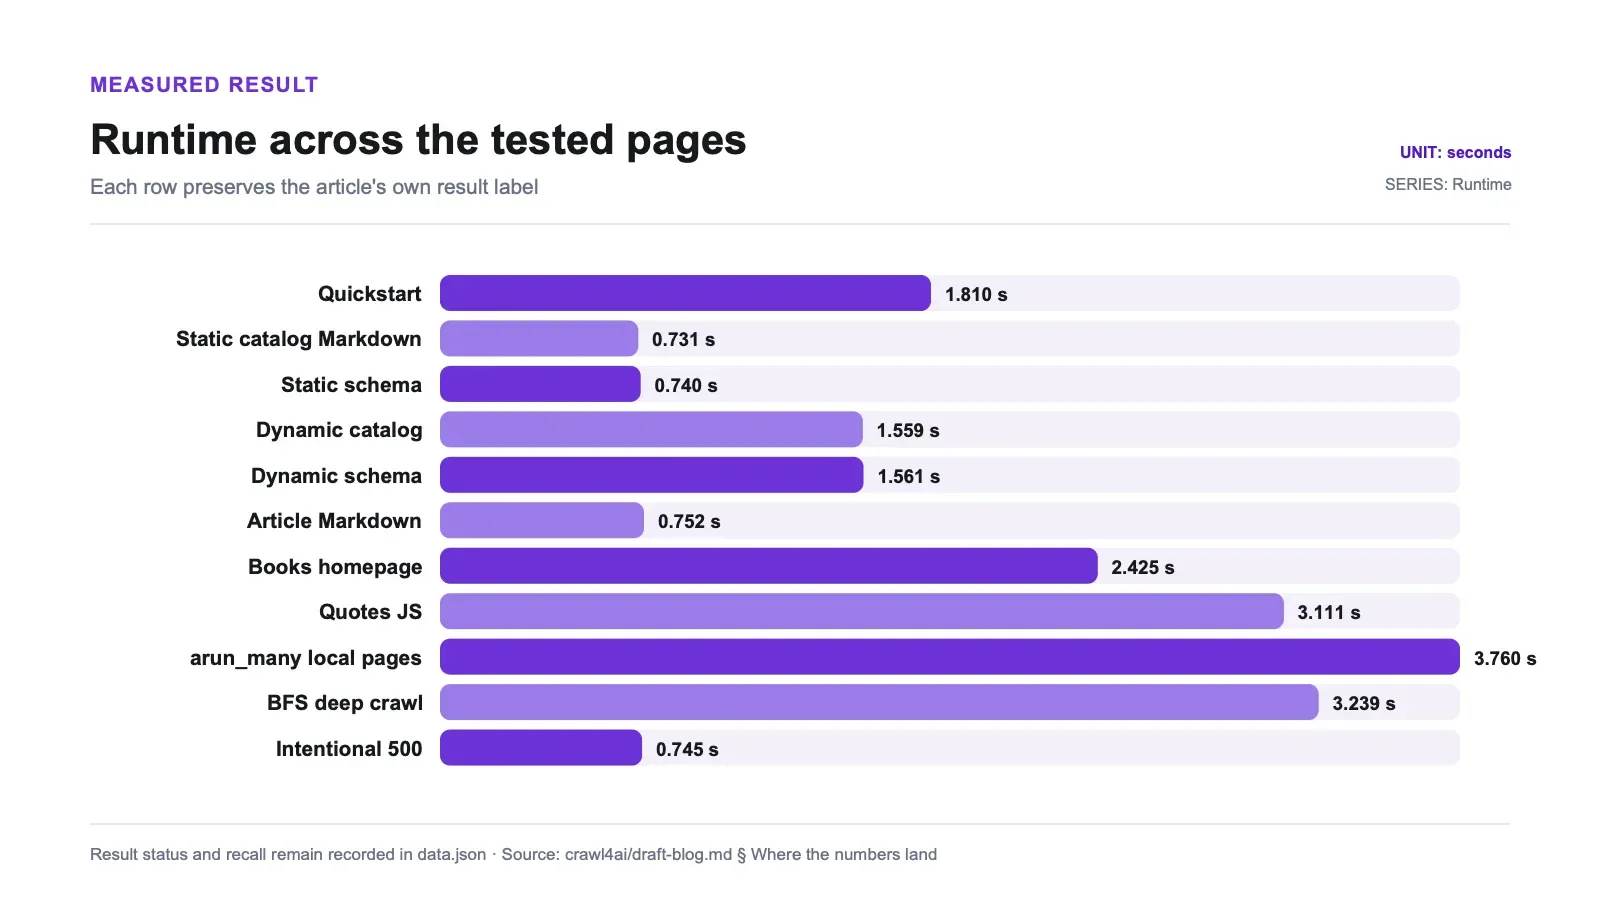
| בדיקה | תוצאה | זמן ריצה נצפה (הרצה אחת שנלכדה) |
|---|---|---|
Quickstart (example.com) | הצלחה, 200 | 1.81 שנ׳ |
| קטלוג סטטי מקומי (Markdown) | שליפה של 6/6 מוצרים | 0.731 שנ׳ |
| חילוץ CSS schema סטטי מקומי | 6 רשומות JSON | 0.740 שנ׳ |
קטלוג דינמי מקומי (wait_for) | שליפה של 8/8 מוצרים | 1.559 שנ׳ |
| חילוץ CSS schema דינמי מקומי | 8 רשומות JSON | 1.561 שנ׳ |
| Markdown של מאמר | 3/3 פסקאות (+ boilerplate) | 0.752 שנ׳ |
| דף הבית הציבורי של Books to Scrape | 13,476 תווי Markdown | 2.425 שנ׳ |
| דף ה־Quotes JS הציבורי | 1,666 תווי Markdown, מרונדר | 3.111 שנ׳ |
arun_many() (6 דפים מקומיים) | 6/6 שליפה | 3.760 שנ׳ |
| BFS deep crawl מקומי | נמצאו 5 דפים, 3 הצליחו / 2 נכשלו | 3.239 שנ׳ |
| דף 500 מכוון | כישלון, 500 (תיוג שגוי כ־"anti-bot") | 0.745 שנ׳ |
אלו זמני smoke test, לא benchmark של ביצועים: במאמר לא מפורטים חומרה, מספר חזרות, מצב warm/cold, מצב cache, בקרות concurrency או שונות. הם כן מראים שהזרימות המופיעות פה הושלמו על המכונה הזו. כל ארטיפקטי ההרצה המלאים נמצאים בתיקיית מאגר ה־benchmark.
להערכה שראויה להחלטה על רכישה או אימוץ, חזרו על כל זרימה בסשני דפדפן חדשים ומשומשים, דווחו על התפלגויות ולא על מספר בודד עם ספרה אחת אחרי הנקודה, קבעו גרסאות דפדפן, ורשמו CPU, זיכרון, מצב cache ו־concurrency. כך אפשר להפריד בין overhead של הספרייה לבין עליית הדפדפן לבין רעש רשת.
| דרישה | התאמה בסקירה הזו | תנאי מרכזי |
|---|---|---|
| רינדור דף והחזרת Markdown | מועמד טוב | לסנן boilerplate לפני שמתייחסים לפלט כמאמר נקי |
| חילוץ JSON לפי schema | מועמד טוב | עדיין צריך לכתוב ולתחזק את סכימת ה־CSS |
| המתנה לתוכן דף אסינכרוני | נתמך | להגדיר תנאי wait_for מפורש וספציפי ליעד |
| סריקת דפים דינמיים לעומק | מותנה | צריך להעביר כללי מוכנות; ברירת המחדל שנבדקה יצרה כשלים חלקיים |
| שימוש כ־HTTP parser קטן ודל־תלויות | התאמה חלשה | נכסי הדפדפן והתחזוקה שלהם הם חלק מהפריסה |
| שימוש בסלקטורים self-healing | לא נתמך בבדיקה הזו | לא להסיק זאת מטקסט השוואתי לא קשור |
יתרונות וחסרונות
יתרונות:
- ספרייה אחת מטפלת גם ב־Markdown גולמי וגם ב־JSON מובנה לפי CSS schema — לא צריך לחבר שני כלים.
- רינדור בדפדפן מובנה; יעדים שמרונדרים באיחור עשויים לדרוש
wait_forמפורש. - זרימות העבודה של דף בודד שנבדקו הושלמו בזמנים שצוינו למעלה; אין כאן טענת מהירות יחסית.
- רישיון Apache-2.0 — ידידותי לשימוש מסחרי, בלי הפתעות של copyleft.
- פרויקט פעיל עם גרסה עדכנית וקהילה גדולה ומעורבת.
חסרונות:
- התקנה ראשונית כבדה (שני סטאקים של דפדפן) שהפתיחה במבוא לא משקפת מספיק.
- Markdown גולמי כולל boilerplate אם לא מגדירים content filters.
- סריקה עמוקה לא ממתינה אוטומטית לדפים דינמיים — צריך להגדיר זאת לכל crawl, אחרת מקבלים כישלונות.
- הודעות כישלון יכולות לתייג שגיאה רגילה כ־"anti-bot", וזה מבלבל בלוגים.
- אין סלקטורים שמסתגלים מעצמם, למרות מה שחלק מההשוואות מרמזות — הסכימות נכתבות ידנית וקבועות.
- אתם מפעילים ומתחזקים בעצמכם את סביבת הדפדפן, כולל עדכונים ושבירות.
למי זה מתאים — ולמי עדיף לדלג
כדאי לבדוק את Crawl4AI אם אתם מפתחים צינור RAG או agent, נוח לכם לעבוד עם סביבת headless browser, ואתם רוצים גם Markdown וגם JSON מובנה מאותה סריקה. הבדיקות לא כיסו עמידות לאתרים עוינים, יציבות לטווח ארוך, זיכרון, sessions, retries, פרוקסים או פריסה בייצור, כך שההמלצה מוגבלת לזרימות שנבחנו כאן.
כדאי לדלג — או לפחות לעצור לשקול — אם חיפשתם HTTP parser קטן ודל־תלות (זה ההפך ממנו), אם אין לכם מקום ורוחב פס להורדת דפדפנים, או אם אינכם רוצים לקחת אחריות על תחזוקת סטאק דפדפן בייצור. ובמיוחד דלגו אם באתם בשביל self-healing selectors: זה לא מה שהכלי הזה, ובניית workflow סביב יכולת שאין בו תעלה לכם ביוקר בהמשך. לחילוץ טקסט נקי של מאמרים עם הסרת boilerplate, ייתכן שכלי קל יותר שמיועד בדיוק לזה ישרת אתכם טוב יותר.
חלופות, כולל איפה Thunderbit נכנס לתמונה
המסגור הכנה הוא זה: Crawl4AI היא ספריית קוד פתוח חינמית שאתם מאחסנים ומתחזקים בעצמכם. מקבלים שליטה מלאה וללא דמי שימוש לספק, אבל עדיין משלמים על compute, רוחב פס, אחסון, עדכוני דפדפן, סכמות ועבודה תפעולית.
בקצה השני יש שירות סקרייפינג מנוהל כמו Thunderbit, שבו שליפה וחילוץ יושבים מאחורי API. Thunderbit לא נבחן על ה־fixtures האלה, ולכן המאמר הזה לא טוען כאן דבר תואם לגבי רינדור, טיפול באנטי־בוט, CAPTCHAs, דיוק או מהירות. ההשוואה הרלוונטית היא בעלות תפעולית: להרים לבד ספרייה שמבוססת על דפדפן, או לשלם לשירות שיפעיל את השכבה הזו.
ההבדל הוא מי מפעיל את הדפדפן. עם Crawl4AI אתם אחראים לרינדור, ל־waits, ל־schemas ולתחזוקה. עם API מנוהל משלמים לפי קריאה ומעבירים חלק מהאחריות התפעולית לספק. הניסוי הזה לא השווה בין שני המסלולים לפי תוצאות.
סקירות benchmark קשורות: ההשוואה המלאה של סקרייפרים בקוד פתוח, הסקירה של Firecrawl ב־self-hosted, וסקירת חילוץ המאמרים של trafilatura.
נסו את Thunderbit לחילוץ נתוני אינטרנט
מסקנה
Crawl4AI הוא מועמד סביר אם אתם רוצים חילוץ בקוד פתוח שמבוסס על דפדפן, מפיק גם Markdown וגם JSON לפי schema, ואתם מוכנים לקחת בעלות על סביבת הדפדפן. זרימות העבודה הישירות של סטטי ושל דינמי עם המתנה הצליחו ב־fixtures האלה. Apache-2.0 הוא רישיון מקל, אם כי עדיין צריך לבצע בדיקה רגילה של תלויות והפצה.
תתקצבו את נכסי הדפדפן. Markdown גולמי צריך סינון לפני שהוא נחשב clean article text. ל־deep crawl צריך להגדיר waits באופן מכוון, והודעת לוג שמכילה "anti-bot" צריכה להיבדק מול קוד הסטטוס והתגובה. סלקטורי schema עדיין נכתבים ומנוהלים על ידכם. אלו גבולות ההחלטה שנבדקו; קנה מידה בייצור והתנהגות מול אתרים עוינים נשארים שאלות פתוחות.
נסו את Thunderbit לחילוץ נתוני אינטרנט Get Started Free
שאלות נפוצות
האם ל־Crawl4AI יש סלקטורים אדפטיביים או self-healing? לא. למרות שחלק מההשוואות מייחסות לו "adaptive intelligence", Crawl4AI מתאים ל־CSS/XPath שאתם כותבים — הוא לא מזהה אלמנטים מחדש ולא מאתר אותם שוב אחרי שינוי ב־markup. בבדיקה, החילוץ המובנה הגיע ל־6/6 ול־8/8 שליפה באמצעות סכמות שהגדרתי ידנית. אם אתר משנה מחלקות CSS, הסכמה שלכם נשברת עד שתעדכנו אותה. tracking של אלמנטים שמתקן את עצמו הוא פיצ'ר של ספרייה אחרת, לא של זו.
למה ההתקנה כל כך גדולה?
crawl4ai-setup מוריד נכסי דפדפן מלאים גם עבור Playwright וגם עבור Patchright — Chrome for Testing, FFmpeg ו־Headless Shell. זה המחיר של רינדור אמיתי בדפדפן. צריך להקצות לזה מקום בדיסק ורוחב פס; זה כבד יותר מ־HTTP parser טהור, ואתם משלמים את המחיר גם אם ה־workload שלכם לעולם לא משתמש בשכבת ההתגנבות.
האם Crawl4AI מטפל בדפים שמרונדרים ב־JavaScript?
כן, כי הוא מפעיל דפדפן headless אמיתי. בבדיקה, קטלוג דינמי עם wait_for="css:.product-card" החזיר שליפה מלאה של 8/8 מוצרים, וגם דף ה־Quotes JS הציבורי רונדר כראוי. הבעיה היא שסירקות עמוקות לא מחילות את ה־wait הזה אוטומטית על דפים שנתגלו — BFS crawl נכשל על דף דינמי שמצא כי לא חיכה. את ההמתנה מגדירים ידנית, לכל crawl בנפרד.
האם Crawl4AI נותן לי טקסט נקי של מאמר או את כל הדף?
כברירת מחדל, את כל הדף. בבדיקה הוא קלט את כל פסקאות הגוף אבל גם שמר טקסט של ניווט, קישורים קשורים ו־footer. כדי לחלץ מאמר נקי צריך להפעיל content filter (כמו PruningContentFilter) או target selector, ולא להסתמך על Markdown גולמי.
האם אפשר לסמוך על הודעות השגיאה של Crawl4AI? כדאי לקרוא אותן בזהירות. דף שגיאת 500 מכוון עם גוף קטן מאוד קיבל תיוג "Blocked by anti-bot protection" רק בגלל היוריסטיקה של מעט טקסט גלוי — לא הייתה כאן חומת אנטי־בוט. התוצאה הגולמית נמצאת במאגר ה־benchmark. תמיד כדאי לבדוק את קוד ה־HTTP האמיתי ואת גוף התגובה לפני שמסיקים שהאתר חוסם אתכם.




