
בניתי אתר בדיקה ייעודי כדי לבדוק את מה שמדד של מספר דפים או מוניטין של מהירות לא באמת מספרים עליו: האם ה־callbacks של Colly באמת מחלצים את הרשומות הצפויות, מנתבים שגיאת HTTP, עוברים בגרף מוגבל, וחושפים תוכן שמגיע מחוץ ל־HTML שמוצג. זו הייתה בדיקה של דיוק וגבולות, לא מבחן ביצועים.
ב־fixtures המבוקרים הוא חילץ את כל הרשומות הסטטיות הצפויות, ניתב תגובת 500 אחת אל OnError, וביקר ב־17 כתובות בגרף המוגבל לפי עומק שהוגדר. בשני דפים שבהם האלמנטים הופיעו רק אחרי הרצת JavaScript הוא החזיר אפס אלמנטים מתאימים. לעומת זאת, נקודת קצה JSON נגישת ישירות נשארה שמישה בלי דפדפן — הבדל חשוב לעומת רינדור בצד הלקוח.
מהו Colly בפועל
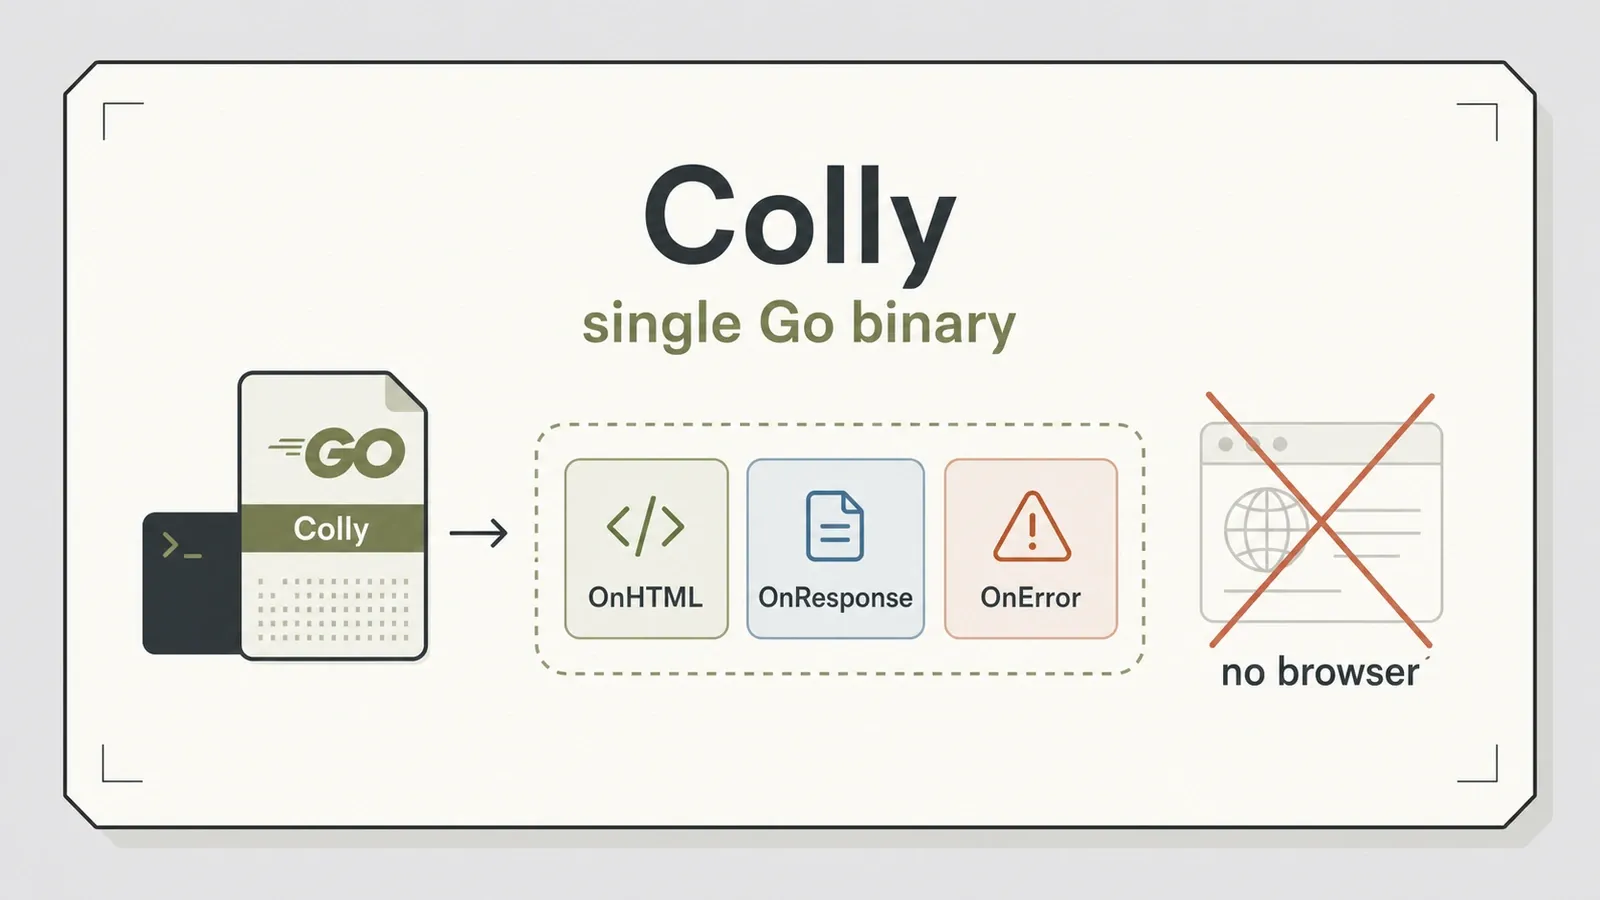
Colly מתאר את עצמו כ־"elegant scraper and crawler framework for Golang", והניסוח הזה מדויק יותר ממה שנראה במבט ראשון. זו ספריית Go — עם בערך 25,300 כוכבי GitHub ו־1,850 forks — ברישיון Apache-2.0. זו לא אפליקציית CLI שמורידים ומכוונים ל־URL. כותבים קוד ב־Go, מייבאים את Colly, רושמים כמה callbacks, ומקמפלים את הכול לקובץ הרצה אחד.
המודל המחשבתי הוא מונע־אירועים. מחברים handlers ל־Collector: OnHTML מפעיל את לוגיקת החילוץ עבור selectors של CSS, OnResponse מספק את גוף התגובה הגולמי, ו־OnError מטפל בכשלים בבקשות. Handlers לקישורים קוראים ל־Visit() על כתובות שהתגלו, בעוד MaxDepth מגביל את ה־traversal. עבור מסלולי HTTP בלבד אין צורך ב־Go runtime מותקן בנפרד או בדפדפן על מכונת היעד; האם הקובץ המהודר הוא סטטי לחלוטין תלוי בדגלי הבנייה ובשימוש ב־CGO, דבר שלא תועד בבדיקה הזו.
תכונות מרכזיות, ואיך הן פועלות מתחת למכסה המנוע
דגם ה־callbacks הוא הדבר שצריך להבין, כי הוא הסיבה לכך ש־Colly מרגיש שונה מסקריפט של בקשה־ופרשנות. שלושה callbacks כיסו כל בדיקה שביצעתי.
OnHTML(selector, handler) הוא סוס העבודה. מגדירים אותו מול .product או article p, ו־Colly מפעיל את ה־handler פעם אחת לכל אלמנט תואם בזמן שהוא מנתח את ה־DOM. כאן מתבצע חילוץ מובנה, וזה כתוב בצורה נקייה — אתה מתאר מה רוצים לאסוף, לא כותב לולאת parse.
OnResponse(handler) יושב שכבה מתחת ומחזיר את הבתים הגולמיים. כשיעד מחזיר JSON במקום HTML, מדלגים על ה־DOM לחלוטין ומבצעים unmarshal לגוף בעצמנו. ה־callback היחיד הזה הוא הסיבה לכך ש־Colly טיפל ב־API מבוסס JSON בצורה חלקה בבדיקה שלי, בלי שום parsing של HTML.
OnError(handler) מטפל בכשלים בבקשות ויכול לחשוף את סטטוס התגובה לקוד הקורא. בבדיקה הזו תגובת fixture אחת עם סטטוס 500 הגיעה ל־callback הרשום. לא נבדקו retries, timeouts, כשלי DNS, איפוסי חיבור, panics בתוך callbacks, persistence, או alerting.
מעל ה־callbacks יש שתי יכולות תפעוליות. MaxDepth מגביל את מעבר הקישורים לפי סמנטיקת העומק של Colly. קובץ Go מהודר גם מונע צורך ב־runtime של שפה שמותקן בנפרד על מכונת היעד. הריצה הזו לא תיעדה דגלי בנייה או מצב CGO, ולכן היא לא טוענת שכל binary שהתקבל הוא סטטי לחלוטין.
התקנה: נדרש Go toolchain
סיפור התלויות קצר אבל ממשי, אז הנה הוא לפני שמתקינים משהו. במכונה שבדקתי לא היה Go מותקן, ו־Colly הוא ספריית Go — לכן הצעד הראשון היה להתקין Go toolchain על המערכת (התקנתי Go 1.26.5 דרך Homebrew). אם הצוות שלך לא חי כבר בעולם של Go, זה מקור החיכוך: לא Colly עצמו, אלא סביבת השפה שהוא דורש לפני שאפילו שורה אחת מתקמפלת.
אחרי ש־Go היה זמין, go get github.com/gocolly/colly/v2 נפתר ל־v2.3.0. המסלולים שנבדקו לא דרשו דפדפן או Chrome ללא ממשק.
יש נקודת גרסה אחת שיכולה לבלבל קוראים. ה־Go module נפתר ל־v2.3.0 (פורסם בדצמבר 2025), בעוד שב־GitHub Releases הגרסה החדשה ביותר שנראתה בזמן הבדיקה הייתה v2.2.0 (מרץ 2025). ההבחנה היא בין גרסת ה־module/הריפוזיטורי לבין רשומת GitHub Release, לא בין module ל־Git tag. בדקתי את v2.3.0.
עבודה מעשית: חילוץ ומגבלות תפעול
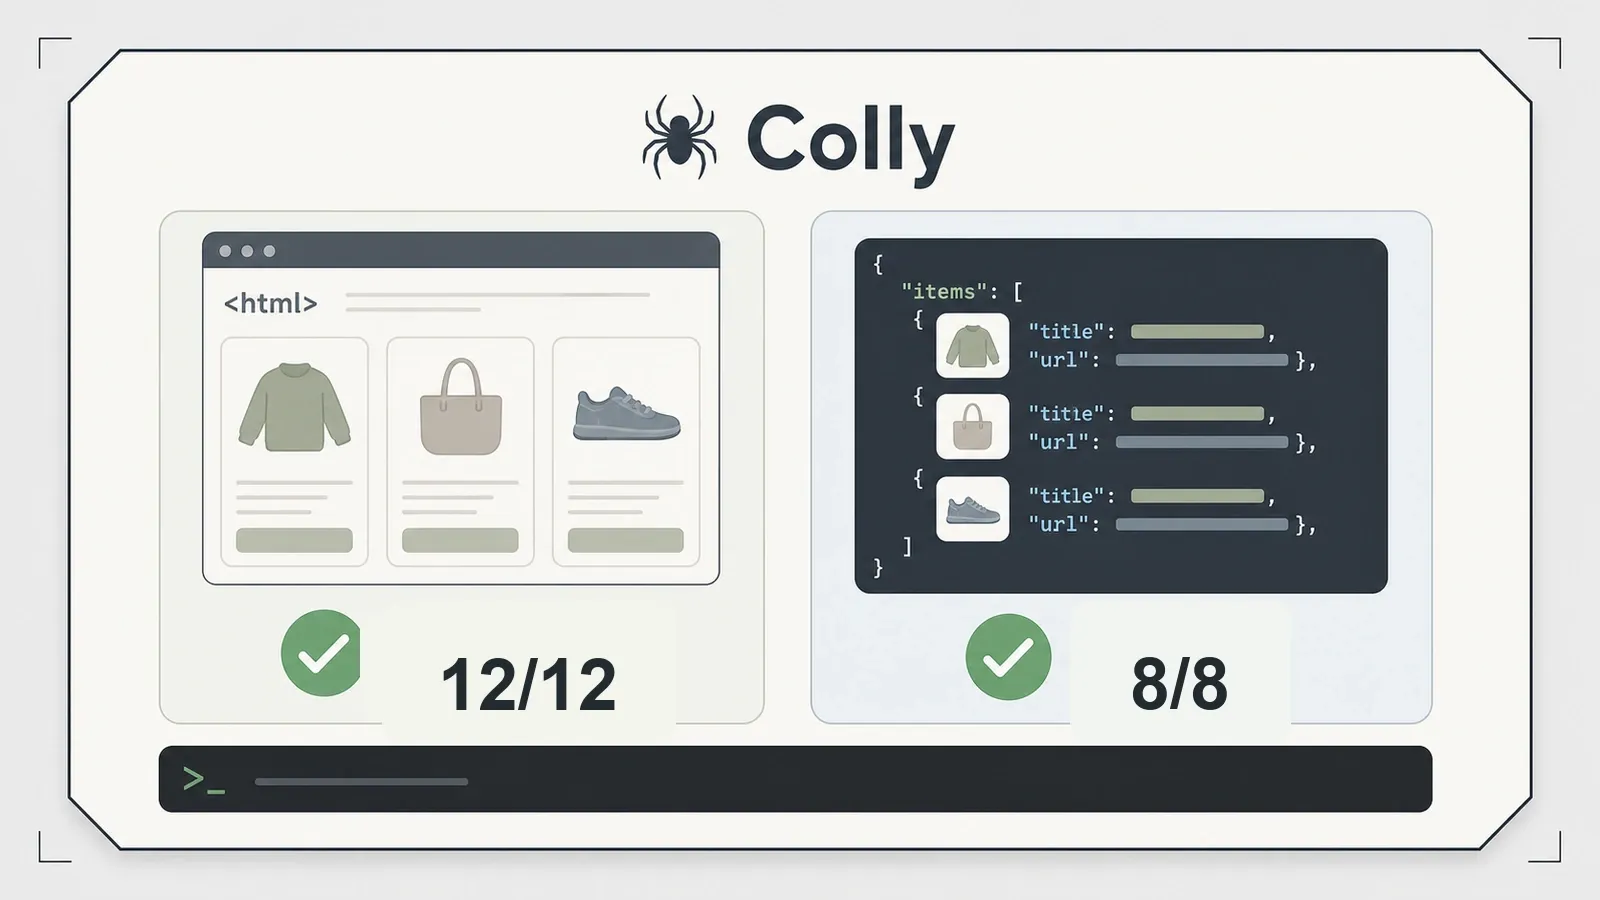
הרצתי את Colly מול שרת fixture סגור־לחלוטין (באמצעות httptest של Go) וגם מול שני אתרי דמו ציבוריים. תיקיית benchmark הנוכחית ו־results/colly-test-summary.json חושפות את הארטיפקטים, אבל שני הקישורים נשענים על branch נייד. המאמר לא מספק commit שנבדק, פקודה מדויקת, דגלי build או seed של ה־fixture, ולכן זה עדיין לא מתכון שחזור בלתי־משתנה.
| בדיקה | יעד | תוצאה |
|---|---|---|
| קטלוג סטטי + עימוד | fixture מקומי | חולצו 12/12 מוצרים צפויים |
| חילוץ מאמר | fixture מקומי | כותרת + 3/3 פסקאות |
| תגובת JSON ישירה | fixture מקומי | 8/8 פריטים צפויים דרך OnResponse |
| טיפול ב־HTTP 500 | fixture מקומי | נותב ל־OnError, סטטוס 500 |
גרף זחילה (MaxDepth 2) | fixture מקומי | 17 דפים |
| Books to Scrape | דמו ציבורי | 20 מוצרים |
| דף דינמי (ללא JS) | fixture מקומי | 0 כרטיסים (כצפוי) |
| Quotes JS (ללא render) | דמו ציבורי | 0 (כצפוי) |
ב־fixtures הסטטיים המבוקרים, ה־selectors שהוגדרו הפיקו 12 מתוך 12 רשומות המוצר הצפויות ואת כל שלוש הפסקאות הצפויות של המאמר. תגובת ה־JSON הישירה כלל לא עברה דרך parser של HTML: OnResponse סיפק את הגוף, וה־harness פענח את כל שמונת הפריטים הצפויים. ה־fixture של 500 הגיע ל־OnError כשהסטטוס שלו נחשף, ולא קרס בריצה הזו; זה לא מוכיח אמינות ללא השגחה. בעמוד הציבורי Books to Scrape ה־selector החזיר 20 מוצרים בתור smoke test של אתר ציבורי.
עבור מעבר בגרף, ה־collector הוגדר עם MaxDepth(2) לפי מוסכמת seed-depth של ה־harness וביקר ב־17 כתובות בגרף ה־fixture. התוצאה היא כיסוי זחילה, לא מהירות. העקיבה שנצפתה — ולא טענה רחבה על גרפים שרירותיים — נמצאת ב־results/local_crawl_graph.json.
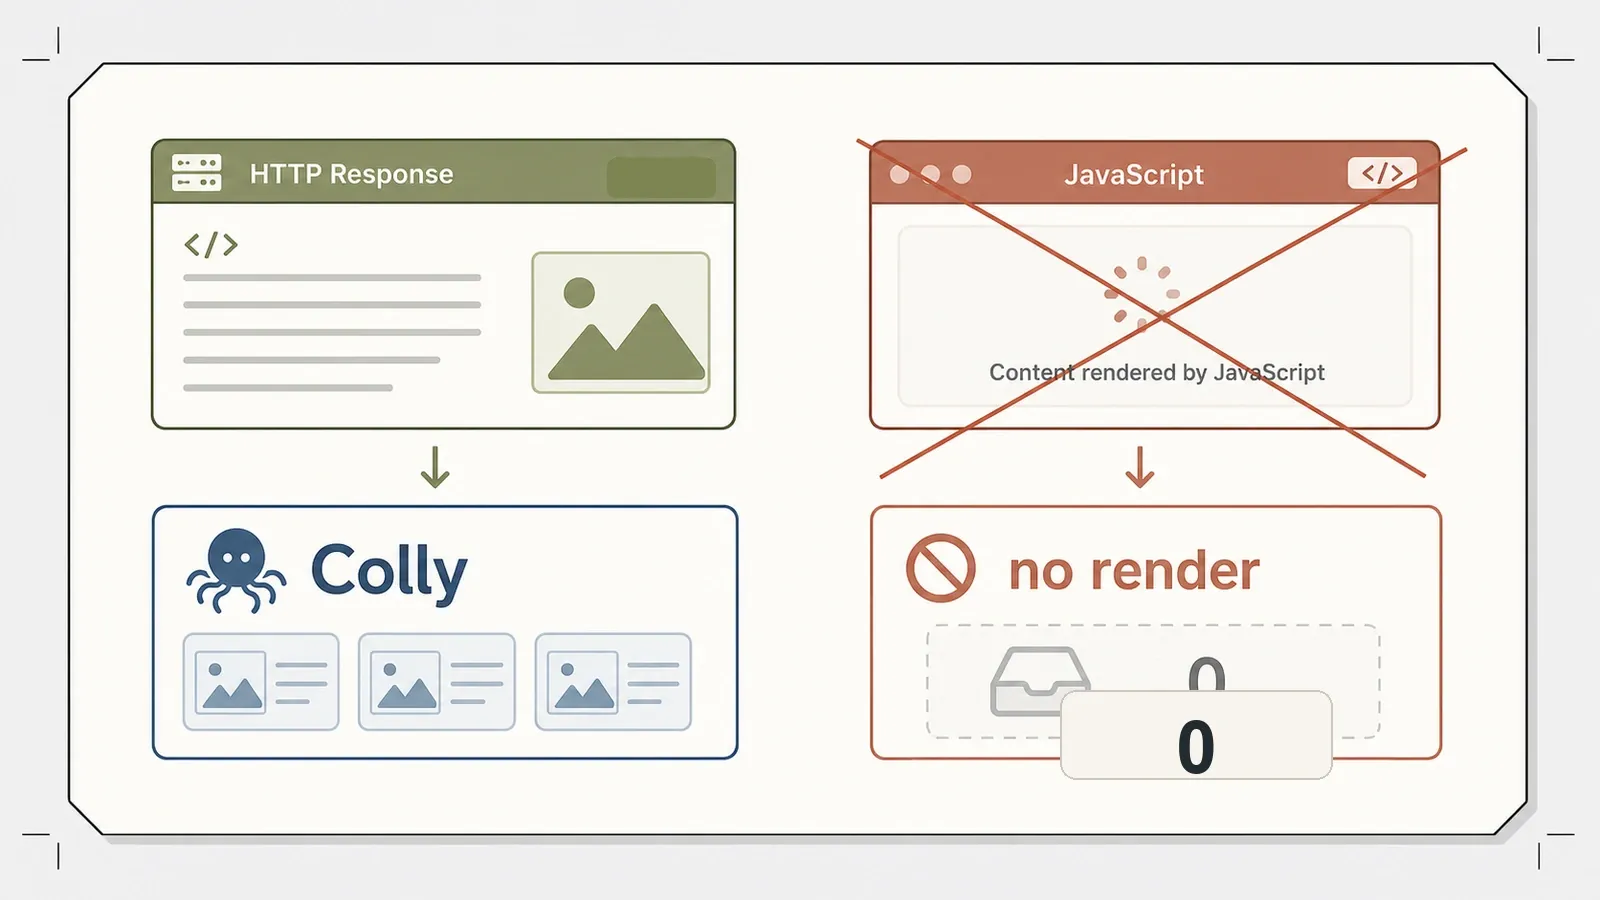
Colly לא מריץ JavaScript. ה־fixture שעבר רינדור JavaScript הפיק 0 כרטיסים מתאימים, וגם דף Quotes to Scrape JS הציבורי הפיק 0 ציטוטים מתאימים. אם האלמנטים קיימים רק אחרי הרצת דפדפן ואין endpoint תומך זמין שמחזיר אותם, מסלול ה־HTTP בלבד לא יכול לראות אותם כ־DOM מרונדר. צריך לצרף renderer, או לקרוא ישירות ל־endpoint התומך כשיש כזה — כפי שמדגים ה־fixture של JSON.
לא בדקתי לעומק את ה־async collector, הגבלות קצב או הגדרות politeness, סבב proxy, retries, או backend-ים של queue ו־storage. לא נמדדו זמן ריצה, throughput, concurrency, CPU, זיכרון, latency של היעד או קו בסיס להשוואה. לכן המאמר הזה לא טוען שום דבר על מהירות או על אמינות ללא השגחה.
איך לפרש את תוצאות ה־fixture
שלושת נתיבי התוכן המוצלחים בודקים חוזים שונים. המקרים של הקטלוג והמאמר בודקים בחירת CSS מול HTML שמוחזר מהשרת. המכנים שלהם הם ציפיות fixture שנכתבו לפני החילוץ: שתים־עשרה רשומות מוצר ושלוש פסקאות מאמר. הדיווח עליהם כ־"expected records extracted" הוא מכוון. הריצה לא מגדירה fuzzy matching, טיפול בכפילויות, סבילות לשדות חסרים, או מדד recall על כלל הקורפוס, ולכן אסור להפוך את התוצאה לדיוק חילוץ כללי.
מקרה ה־JSON עוקף בחירת DOM. Colly מקבל את הבתים של התגובה דרך OnResponse, וה־harness מבצע את פענוח ה־JSON. לכן העובדה ש־"Colly לא מריץ JavaScript" לא אומרת שכל אתר שמבוסס על client-side אינו נגיש. אם מקור הנתונים שבו משתמש הלקוח הוא endpoint שאפשר לקרוא אליו ישירות והבקשה ניתנת לשחזור מחוץ לדפדפן, ייתכן ש־crawler ב־HTTP בלבד יספיק. אימות, חתימות שנוצרות בזמן ריצה, מצב שרק הדפדפן מחזיק, ובקרות anti-bot יכולים לשנות את התשובה הזו; כאן לא נבדק אף אחד מאלה.
נתיב ה־500 בודק dispatch, לא recovery. הוא מראה שה־callback הרשום OnError קיבל את תגובת ה־fixture ואת הסטטוס שלה. crawler בייצור עדיין צריך מדיניות מפורשת לסטטוסים שניתנים ל־retry, backoff, כשלים סופיים, persistence ו־alerting. הבדיקה לא מספקת הוכחה לשיקולים הללו, ו־"ה־callback הופעל" לא צריך להתפרש כ־"אפשר לסמוך על המשימה ללא השגחה".
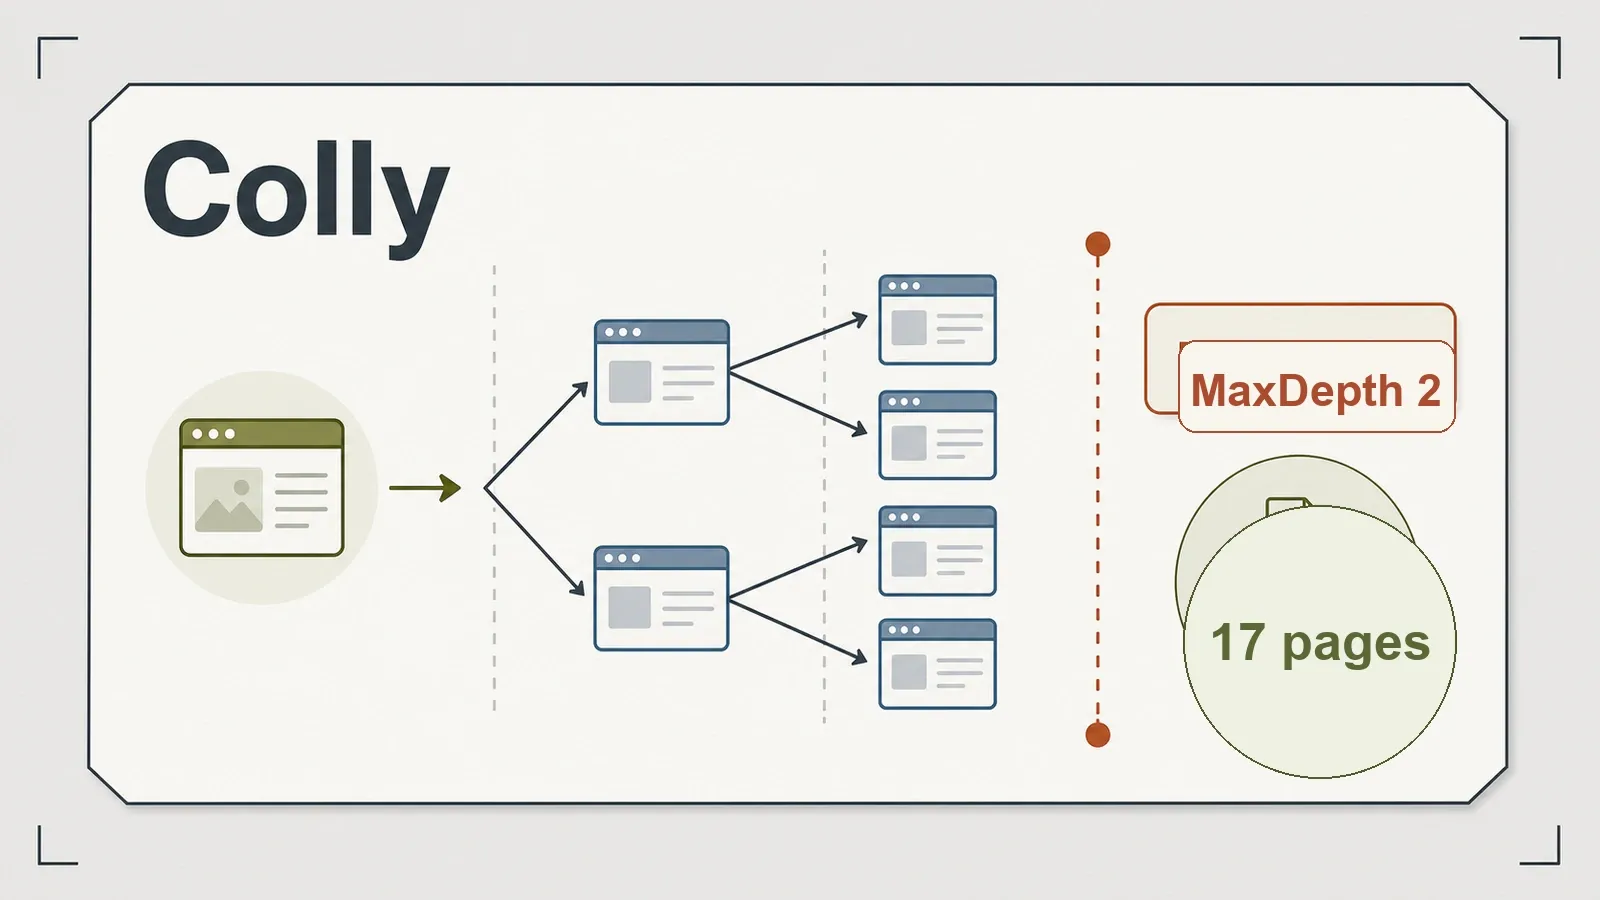
גם גרף 17 הכתובות הוא צר־היקף. הוא מאשר את קבוצת הכתובות שנצפתה ב־fixture הזה, עם מוסכמת seed הזו, ועם MaxDepth(2). הוא לא מוכיח דפים לשנייה, הוגנות בין hosts, גידול בזיכרון, או התנהגות על מחזורים וצורות URL כפולות. לזה נדרשות בדיקות עומס ותור נפרדות.
צ'קליסט לבחירה, המבוסס על הריצה הזו
התחל מלבדוק איזה תגובה Colly באמת מקבל. אם השדות הדרושים נמצאים ב־HTML שמוחזר מהשרת, השתמש ב־OnHTML ואמת ספירות שדות או מפתחות חובה לפני קבלת הרשומה. אם התגובה היא JSON, טפל בגוף דרך OnResponse ואמת את הסכמה שלו. אם ה־HTML הוא רק shell של אפליקציה, בדוק האם בקשה תומכת נגישה מכילה את הנתונים לפני שמוסיפים דפדפן.
| מה התגובה מכילה | נתיב ב־Colly | בדיקת קבלה |
|---|---|---|
| שדות נדרשים ב־HTML שמוחזר מהשרת | selectors של OnHTML | מפתחות חובה וספירת רשומות צפויה |
| payload JSON שניתן לקרוא אליו ישירות | OnResponse יחד עם פענוח JSON | אימות סכמה ושדות חובה |
| HTML shell שמגובה בבקשה ניתנת לשחזור | בקשה ל־endpoint התומך | סטטוס תגובה, סכמה ושלמות |
| נתונים שנוצרים רק אחרי הרצת דפדפן | הוסף renderer או בחר crawler מבוסס דפדפן | מוכנות ושלמות ספציפיות ליעד |
כאשר נדרש רינדור דפדפן, התייחס אליו כעוד רכיב במערכת ולא כאל משהו שאפשר להפעיל רק עם דגל של Colly. הדפדפן צריך לקבוע מוכנות, לחשוף את התוכן המרונדר או את התגובות התומכות, ולהעביר את הנתונים לשאר הצינור. הסקירה הזו לא בדקה אינטגרציה כזו.
לפריסה, תעדו את גרסת Go, גרסת ה־module, דגלי build, מצב CGO, הפקודה המדויקת, seed של ה־fixture, ו־commit של הריפוזיטורי. הפרטים האלה חסרים בקישורי הפרסום הנוכחיים, והם ההבדל בין ארטיפקטים שניתן לבדוק לבין שחזור עמיד. לתפעול, הוסיפו מטריצת כשל ומדדו את העומס שבאמת מעניין אתכם לפני שמכריזים על המערכת כמהירה או אמינה.
יתרונות וחסרונות
יתרונות:
- חילוץ 12/12 מוצרי קטלוג צפויים ו־3/3 פסקאות מאמר צפויות באמצעות
OnHTML. - טיפול נקי ב־JSON דרך
OnResponse, בלי צורך ב־DOM parsing — 8/8 פריטי API. - תגובת ה־500 שנבדקה הגיעה ל־
OnErrorכשהסטטוס נחשף. - זחילה מוגבלת לעומק הגיעה ל־17 דפים עם collector יחיד.
- מתקמפל לקובץ Go הרצה; היעד לא צריך Go runtime מותקן בנפרד עבור המסלולים שנבדקו.
- רישיון Apache-2.0 מקל יחסית.
חסרונות:
- אין הרצת JavaScript — תוכן שמורנדר בצד הלקוח חוזר כ־0, בלי יוצא מן הכלל.
- נדרש Go toolchain; צוותים שאינם עובדים עם Go משלמים את עלות ההקמה הזאת לפני כתיבת scraper כלשהו.
- ה־module שנבדק (
v2.3.0) מתקדם מעבר לרשומת GitHub Release החדשה ביותר שנצפתה (v2.2.0). - הפלט הוא הקוד שלך — Colly נותן callbacks, לא dataset/exporter מובנה כמו של Scrapy.
- קיימים async, rate-limiting, proxy ו־queue backends, אבל הם לא נבחנו כאן; throughput והיקף עדיין לא נמדדו.
למי זה מתאים — ולמי עדיף לוותר
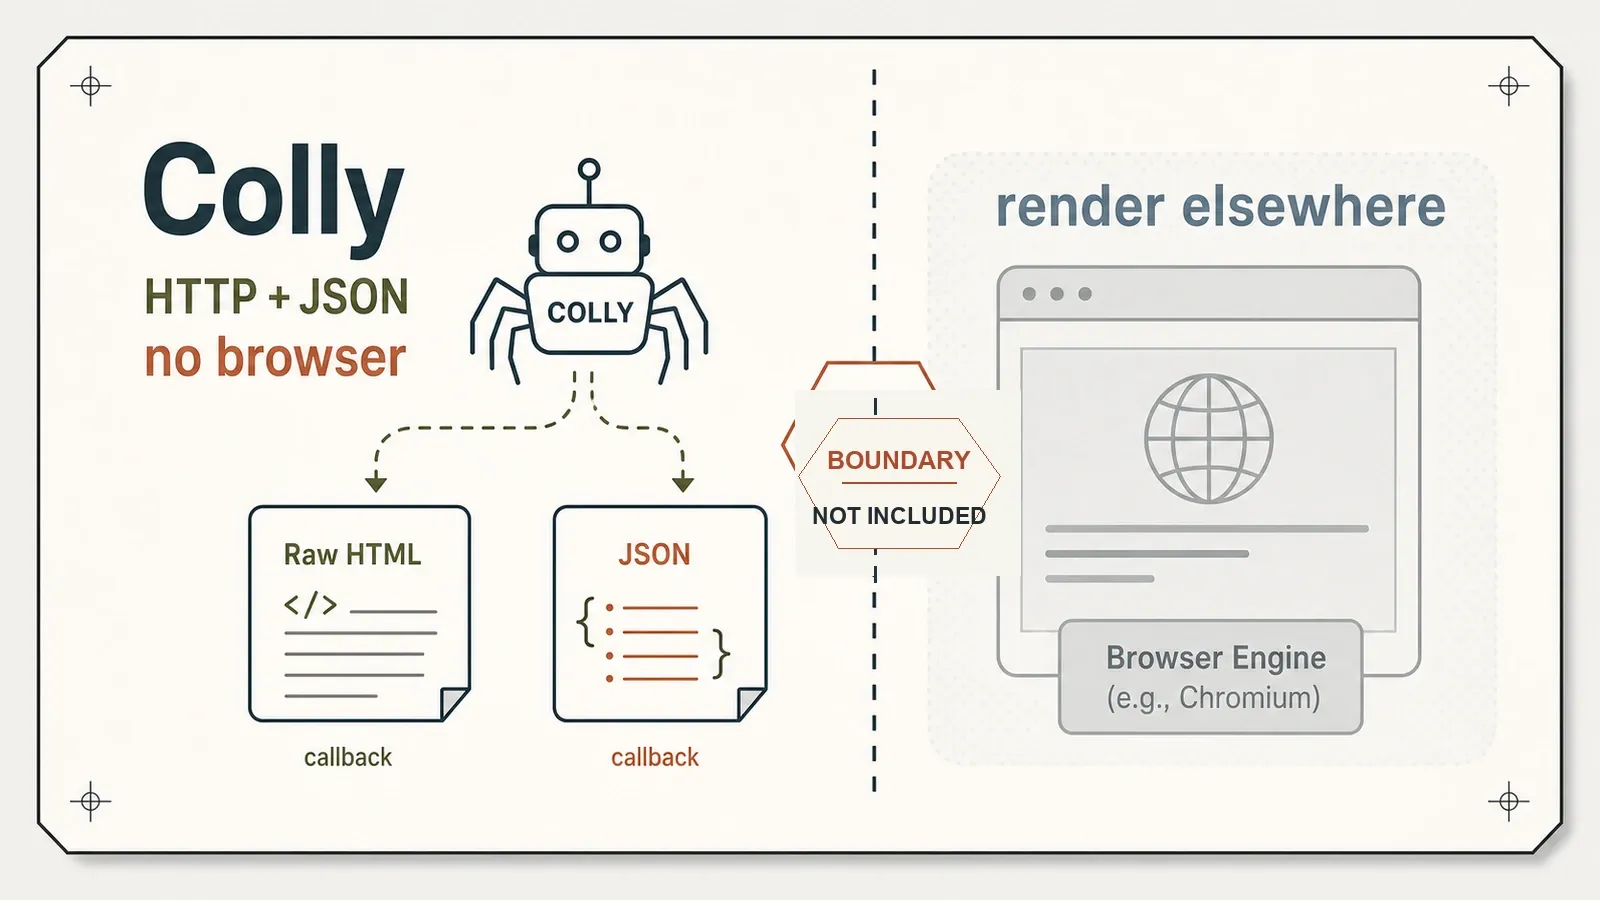
Colly מתאים אם אתם כבר כותבים ב־Go ומכוונים ל־HTML שמוחזר מהשרת או ל־JSON שנגיש ישירות. מודל ה־callbacks מפריד בין התאמות מובנות, payload-ים גולמיים וכשלים בבקשות. קובץ הרצה מהודר גם מונע צורך בסביבת שפה מותקנת בנפרד על מכונת היעד, אף שהקישור הסטטי המלא לא אומת כאן.
הוסיפו renderer כשאלמנטים נדרשים מופיעים רק אחרי הרצת דפדפן ואין endpoint תומך שמיש. עדיין אפשר לפנות ישירות ל־endpoint JSON כשיש כזה. Colly גם פחות מתאים לצוותים שלא רוצים Go toolchain, או לכאלה שרוצים ששירות חילוץ יטפל עבורם בעיצוב הסכמה ובתחזוקת selectors.
חלופות, כולל המקום של Thunderbit
Colly הוא קוד פתוח שאתם מפעילים בעצמכם. אין לו דמי שימוש לספק, אבל מחשוב, bandwidth, proxies, אחסון, observability והנדסה עדיין יהיו העלות שלכם. אתם הבעלים של התנהגות הבקשות, callbacks של parsing, לוגיקת הזחילה, ושילוב דפדפן אם היעד דורש רינדור.
שירות חילוץ מנוהל מעביר חלק מהאחריות הזו לספק. אנחנו בונים את Thunderbit, אבל לא בדקנו אותו מול ה־fixtures האלה, ולכן המאמר הזה לא מבצע השוואה של רינדור, anti-bot, איכות, latency או עלות. ההבחנה הנתמכת היא בבעלות: Colly חושף responses ו־callbacks בתוך תהליך ה־Go שלכם; שירות מנוהל יכול לקחת בעלות על האיסוף ועל עיצוב הסכמה תמורת תשלום לכל קריאה.
סקירות benchmark קשורות: ההשוואה המלאה של סקרייפרים בקוד פתוח, הסקירה של זחלן Python של Scrapy, ו־סקירת ה־selector האדפטיבי של Scrapling.
נסו את Thunderbit לחילוץ נתוני אינטרנט
מסקנה
Colly הוא מועמד חזק לצוותי Go שמכוונים ל־HTML שמוחזר מהשרת או ל־JSON ישיר, ומוכנים לכתוב ולתחזק בעצמם את קוד החילוץ. ה־fixtures תומכים בחילוץ רשומות צפוי, בעקיבת זחילה אחת מוגבלת, ובקריאת 500 אחת דרך callback — לא במהירות, לא בהיקף, ולא באמינות ללא השגחה. עבור DOM שמורנדר בדפדפן צריך נתיב אחר, אלא אם אפשר לקרוא ישירות ל־endpoint הנתונים שמאחוריו.
נסו את Thunderbit לחילוץ נתוני אינטרנט Get Started Free
שאלות נפוצות
האם הסקירה הזו מדדה את המהירות של Colly? לא. היא מדדה חילוץ של רשומות צפויות, טיפול ישיר ב־JSON, callback אחד של שגיאה, וכיסוי של גרף זחילה מבוסס fixture. לא נמדדו זמן ריצה, throughput, concurrency, CPU, זיכרון או baseline להשוואה.
האם Colly יכול לגרד דפים שמורנדרים ב־JavaScript? Colly לא מריץ את ה־JavaScript של הדף. לכן מסלול ה־HTTP שנבדק לא מצא אלמנטים שהופיעו רק ב־DOM המרונדר. הוא עדיין יכול לבקש ישירות endpoint JSON תומך ונגיש, כפי שמדגים ה־fixture של JSON. יש להשתמש ב־renderer כשהרצה היא תנאי הכרחי ואין בקשה תומכת שניתנת לשחזור ומספקת את הנתונים.
האם צריך לדעת Go כדי להשתמש ב־Colly?
כן. Colly הוא ספריית Go, לא CLI עצמאי — מייבאים אותו, רושמים callbacks (OnHTML, OnResponse, OnError), ומקמפלים. במכונה שבדקתי לא היה Go, לכן ההתקנה התחילה מהוספת Go toolchain (1.26.5). אם הצוות שלכם לא כבר עובד עם Go, זו עלות ההקמה האמיתית.
למה הגרסה שאני מתקין לא תואמת ל־GitHub release החדש ביותר של Colly?
ה־Go module נפתר ל־v2.3.0 (דצמבר 2025), בעוד שרשומת ה־GitHub Release החדשה ביותר שנצפתה הייתה v2.2.0 (מרץ 2025). בדקתי את v2.3.0; מדובר בהבחנה בין surfaces של גרסאות, לא בהוכחה שההתקנה שבורה.
האם Colly חינמי לשימוש מסחרי? כן. הוא ברישיון Apache-2.0, רישיון מקל וידידותי לשימוש מסחרי. כמו תמיד, כדאי לאמת את הרישיון הנוכחי ב־repo לפני שמבנים עליו מוצר.
לפני אימוץ בייצור, הוסיפו בדיקות שמתאימות לסיכון התפעולי במקום להרחיב את תוצאת ה־fixture בהנחת דמיון. מדדו זחילות חוזרות על יעדים מייצגים, תעדו CPU ושיא זיכרון, הפעילו כשלי retry וכשלים סופיים, ואמתו politeness תחת concurrency. אם persistence חשוב, עצרו והמשיכו זחילה תוך בדיקת טיפול בכפילויות ומצב התור. אם פשטות פריסה חשובה, תעדו את הגדרות ה־compiler וה־linker המדויקות ובדקו את התלויות בזמן ריצה של הקובץ שהופק. אף אחת מהבדיקות האלה לא משנה את מה שה־fixture הנוכחי הוכיח; הן קובעות אם אותה תצורת ספרייה מתאימה למשימת ייצור מסוימת.




