
הרשת מלאה בנתונים, ובואו נהיה כנים — לאף אחד אין זמן לעבור ידנית על אלפי דפי מוצרים או עמודי מחירים של מתחרים. אם אתם עובדים על Linux (כמוני, ברוב עבודת האוטומציה והפיתוח שלי), אתם כבר יודעים שהפלטפורמה הזו היא כוח-על לצוותים שעובדים עם דאטה. למעשה, מערכות ממשפחת Unix מפעילות 91.9% מהאתרים שמערכת ההפעלה שלהם ידועה, כאשר Linux היא הגרסה המזוהה הגדולה ביותר בפער משמעותי. אבל יש כאן אתגר: למצוא Web Scraper ל-Linux שבאמת מתאים לזרימת העבודה שלכם — בין אם אתם משתמשים עסקיים בלי רקע טכני ובין אם אתם מפתחים כבדים — זה יכול להרגיש כמו לחפש מחט בערימת שחת.
לכן הרכבתי את המדריך המקיף הזה ל-18 כלי ה-Web Scraping הטובים ביותר ללינוקס ב-2026. מפתרונות מבוססי AI וללא קוד כמו Thunderbit (כן, זה שאני והצוות שלי בנינו) ועד מסגרות קלאסיות למפתחים כמו Scrapy ו-Beautiful Soup, הרשימה הזו תעזור לכם לבחור את ה-Web Scraper המתאים ביותר לצרכים שלכם — בלי כאב הראש של ניסוי וטעייה.
למה כלי Web Scraping ללינוקס חשובים למשתמשים עסקיים
תחסכו את ההעתקה-הדבקה עוד לפני שבחרתם כלי Thunderbit פועל ב-Chrome על שולחן העבודה שלכם בלינוקס — בלי חבילות, בלי דרייברים, רק טבלה מסודרת בלחיצה אחת. Get Started Free
בואו נדבר ישר: איסוף נתונים ידני הוא מכונת השמדה לפרודוקטיביות. מחקרים מראים שצוותים שנשענים על העתקה-הדבקה מבזבזים שעות בכל שבוע ומגיעים לשיעורי שגיאה של כמעט 5% — מתכון בטוח לטעויות יקרות ולהחמצת הזדמנויות (Thunderbit Blog). Linux, בזכות היציבות, האבטחה והגמישות שלו, הוא פלטפורמת הבחירה להרצת סקרייפרים שצריכים לעבוד 24/7 — על מחשב, בשרת או בענן.
שימושים עסקיים נפוצים לכלי Web Scraping ללינוקס:
- יצירת לידים: צוותי מכירות אוספים פרטי קשר ממדריכים, רשתות חברתיות או אתרי ביקורות, בלי העבודה הידנית המפרכת (Thunderbit Blog).
- ניטור מחירים: צוותי e-commerce מושכים אוטומטית מחירי מתחרים ונתוני מלאי, ושומרים על תמחור חד ועדכני.
- מחקר מתחרים: צוותי שיווק ותפעול עוקבים אחרי השקות מוצרים, ביקורות ומילות מפתח ל-SEO — בלי “לשחות בעיניים עצומות”.
- מודיעין שוק: אנליסטים מרכזים חדשות, פורומים ונתוני רשתות חברתיות כדי לזהות מגמות בזמן אמת.
- אוטומציה של תהליכי עבודה: חלק מהכלים (במיוחד מבוססי AI) יכולים אפילו לאוטומט תהליכי עבודה ברשת, כמו מילוי טפסים או ניווט בדשבורדים, ישירות ממכונת הלינוקס שלכם.
והחלק הכי טוב? הכלי הנכון ל-Web Scraping בלינוקס יכול להעצים גם משתמשים לא-טכניים — לא רק מפתחים — לגשת לנתוני רשת ולנצל אותם לקבלת החלטות עסקיות חכמות ומהירות יותר.
איך בחרנו את ה-Web Scraper הטוב ביותר ללינוקס
לא כל הסקרייפרים נולדו שווים, במיוחד בלינוקס. הנה מה שחיפשתי:
- תאימות ללינוקס: כל כלי כאן פועל באופן מקורי על Linux, דרך הדפדפן, או עם פתרון עוקף פשוט (כמו Wine או גישה דרך הענן).
- קלות שימוש: מהנחיות AI בשפה טבעית ועד ממשקי point-and-click ויזואליים, העדפתי כלים שמאפשרים גם לא-מפתחים להגיע לתוצאות מהר — אבל לא שכחתי את המשתמשים המתקדמים שרוצים שליטה מלאה.
- עוצמת חילוץ הנתונים: האם הוא מתמודד עם תוכן דינמי, עימוד, תתי-עמודים וסוגי נתונים שונים? האם הוא שורד טריקים נגד סקרייפינג?
- סקייל ואוטומציה: תזמון, scraping בענן, crawling מבוזר — אלה הכרחיים לפרויקטי נתונים רציניים.
- אינטגרציה וייצוא: CSV, Excel, Google Sheets, APIs — אם אי אפשר להוציא את הנתונים החוצה, מה הטעם?
- מחיר ורישוי: חינם, קוד פתוח או בתשלום — יש משהו לכל תקציב, ממייסדים יחידים ועד צוותי אנטרפרייז.
- קהילה ותמיכה: בסיסי משתמשים פעילים, תיעוד טוב ותמיכה מגיבה עושים הבדל גדול כשנתקעים.
שילבתי גם משוב אמיתי של משתמשים, ביקורות מהתעשייה והניסיון שלי עם הכלים האלה בשטח. בואו נצלול לרשימה.
1. Thunderbit
 Thunderbit הוא הבחירה המובילה שלי עבור משתמשים עסקיים שרוצים Web Scraper ללינוקס שבאמת קל להשתמש בו. בתור תוסף Chrome מבוסס AI, הוא פועל מצוין על Linux (פשוט פותחים Chrome או Chromium) ומאפשר לכם לחלץ נתונים מכל אתר בלחיצה אחת.
מה מייחד את Thunderbit:
- הנחיות בשפה טבעית: פשוט תארו מה אתם רוצים (“חלץ את כל שמות המוצרים והמחירים מהעמוד הזה”) וה-AI של Thunderbit יעשה את השאר.
- הצעת שדות באמצעות AI: לחיצה אחת, ו-Thunderbit סורק את העמוד, מציע עמודות וסוגי נתונים — בלי בחירה ידנית של שדות.
- חילוץ מתתי-עמודים ומעמודי עימוד: צריכים עוד פרטים? Thunderbit יכול להיכנס לכל תת-עמוד (כמו דפי מוצר) ולהעשיר את הטבלה שלכם אוטומטית.
- חילוץ בענן או מקומית: עד 50 עמודים במקביל בענן, או מצב דפדפן לאתרים שדורשים התחברות.
- ייצוא מיידי: ייצוא בלחיצה אחת ל-Excel, Google Sheets, Airtable, Notion, CSV או JSON — תמיד בחינם.
- כלים נוספים: חילוץ אימיילים, מספרי טלפון ותמונות בלחיצה אחת. גם AI autofill יכול לאוטומט הזנת טפסים.
מחיר: שכבה חינמית (6 עמודים בחודש), תוכניות בתשלום מתחילות ב-$15 לחודש עבור 500 שורות (Thunderbit Pricing). משתמשים אוהבים את זה ש”אין עקומת למידה” ושזה “הופך שעות עבודה לדקות” (Product Hunt Reviews). עבור עבודות גדולות, ייתכן שתצטרכו לפצל להרצות קטנות יותר, אבל ברוב השימושים העסקיים זה חיסכון עצום בזמן.
תאימות ללינוקס: 100%. פשוט מריצים Chrome/Chromium על שולחן העבודה או השרת שלכם בלינוקס.
מתאים במיוחד ל: משתמשים עסקיים בלי רקע טכני (מכירות, שיווק, תפעול) שרוצים את ההתקנה הכי מהירה והכי פשוטה.
נסו את Thunderbit בחינם על לינוקס פועל ב-Chrome על כל שולחן עבודה של Linux — בלי לבנות חבילות, בלי להתקין דרייברים, לחיצה אחת לחילוץ. Get Started Free
2. Scrapy
 Scrapy הוא הסטנדרט הזהב למפתחי Python שרוצים Web Scraper גמיש וסקיילבילי ללינוקס. זהו פרויקט קוד פתוח, מהיר במיוחד (crawling אסינכרוני), ויכול להתמודד עם הכול — מסקרייפים פשוטים ועד crawls מבוזרים עצומים.
תכונות מרכזיות:
- Crawling אסינכרוני ומהיר במיוחד — מושלם לחילוץ אלפי עמודים.
- ניתן להרחבה מאוד: תוספים לפרוקסי, CAPTCHA ועוד.
- משתלב עם סטאק הנתונים של Python: פלט ל-JSON, CSV, מסדי נתונים או pandas.
- מטפל בקוקיז, סשנים ו-throttling אוטומטי.
מחיר: חינם לחלוטין ובקוד פתוח.
תאימות ללינוקס: מקורי (התקנה דרך pip). עובד מצוין על שרתים וקונטיינרים.
מתאים במיוחד ל: מפתחים שבונים סקרייפרים מותאמים אישית ובקנה מידה גדול.
שימו לב: יש עקומת למידה למי שלא כותב קוד, אבל אם אתם יודעים Python, קשה לנצח את Scrapy.
3. Beautiful Soup
 Beautiful Soup היא ספריית Python קלת משקל ל-פירוק HTML ו-XML. היא הבחירה הקלאסית לסקרייפינג מהיר ו”מלוכלך” או לניקוי דפי אינטרנט מבולגנים.
תכונות מרכזיות:
- API פשוט וידידותי לאדם — מצוין למתחילים.
- עובדת נהדר עם requests כדי להביא דפים.
- מטפלת ב-HTML שבור בצורה חיננית.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: 100% (Python טהור).
מתאים במיוחד ל: מפתחים ומדעני נתונים שעושים משימות חילוץ או פירוק קטנות עד בינוניות.
מגבלות: לא מטפלת ב-JavaScript או בתוכן דינמי — שלבו אותה עם Selenium או Puppeteer אם אתם צריכים את זה.
4. Selenium
 Selenium הוא מסגרת ה-browser automation הקלאסית. הוא מאפשר לכם לשלוט ב-Chrome, Firefox או דפדפנים אחרים כדי לבצע סקרייפינג לאתרים דינמיים וכבדי JavaScript.
תכונות מרכזיות:
- מפעיל דפדפנים אמיתיים — יכול להתחבר, ללחוץ, לגלול ולתקשר כמו אדם.
- תמיכה ב-Python, Java, C# ועוד.
- מצב Headless להרצה על שרתי Linux.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: תמיכה מלאה (צריך רק להתקין את הדרייבר הנכון לדפדפן).
מתאים במיוחד ל: מהנדסי QA, מפתחי סקרייפינג וכל מי שצריך לדמות התנהגות משתמש.
שימו לב: צורך יותר משאבים ואיטי יותר מסקרייפרים מבוססי HTTP, אבל לפעמים זו הדרך היחידה להשיג את הנתונים.
5. Puppeteer
 Puppeteer היא ספריית Node.js של Google ל-שליטה ב-Chrome/Chromium headless. זה כמו Selenium, אבל עם API מודרני ב-JavaScript ואינטגרציה הדוקה עם היכולות של Chrome.
תכונות מרכזיות:
- מריץ JavaScript, מטפל בתוכן דינמי ולוקח צילומי מסך.
- מהיר, יציב וקל לשימוש עבור מפתחי Node.js.
- מיירט בקשות רשת וחוסם משאבים מיותרים.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: מתקין Chromium אוטומטית; עובד במצב headless כברירת מחדל.
מתאים במיוחד ל: מפתחים שסורקים אפליקציות web מודרניות או אתרי Single Page.
6. Octoparse
 Octoparse הוא Web Scraper ללא קוד עם ממשק drag-and-drop והמון תבניות מוכנות מראש. אמנם אפליקציית הדסקטופ זמינה רק ל-Windows/Mac, משתמשי Linux יכולים לגשת ל-פלטפורמת הענן של Octoparse דרך הדפדפן או להריץ את אפליקציית Windows באמצעות Wine.
תכונות מרכזיות:
- מעל 100 תבניות סקרייפינג מוכנות לאתרים כמו Amazon, eBay, Zillow ועוד.
- מעצב תהליכי עבודה ויזואלי — בונים סקרייפר ב-click-and-point.
- חילוץ ותזמון בענן — נותנים לשרתים של Octoparse לעשות את העבודה הקשה.
- ייצוא ל-Excel, CSV, JSON ומסדי נתונים.
מחיר: שכבה חינמית (10 משימות, כ-50K שורות בחודש). תוכניות בתשלום מתחילות ב-$69 לחודש לתוכנית Standard (בחיוב שנתי); Professional עולה $249 לחודש. (Octoparse Pricing)
תאימות ללינוקס: גישה בענן/דפדפן; אפליקציית דסקטופ דרך Wine.
מתאים במיוחד ל: לא-מפתחים שצריכים במהירות נתוני e-commerce או marketplace.
7. PhantomJS
 PhantomJS הוא דפדפן WebKit headless שבעבר היה הבחירה המובילה לאוטומציית דפדפן קלה. כיום הוא כבר הוצא משימוש, אבל עדיין רץ בלינוקס עבור משימות ישנות או פשוטות.
תכונות מרכזיות:
- ניתן לסקריפט ב-JavaScript.
- מטפל ב-JavaScript ברמה בינונית ויכול לצלם מסכים/להפיק PDF.
- בלי צורך ב-GUI.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: בינארי מקורי.
מתאים במיוחד ל: פרויקטים ישנים או סביבות שבהן אי אפשר להתקין Chrome.
הערה חשובה: הכלי הוגדר רשמית כמיושן ב-2017 והפיתוח הופסק במרץ 2018; הגרסה האחרונה היא v2.1.1. אין תיקוני אבטחה, אין מנוע JavaScript מודרני, והוא נשבר ברוב האתרים העכשוויים. לכל פרויקט חדש, עדיף להשתמש ב-Puppeteer או Playwright. הוא מופיע כאן כי עדיין תיתקלו בו בשרשראות scraping ישנות בלינוקס שאולי תירשו.
8. ParseHub
 ParseHub הוא Web Scraper ויזואלי, חוצה-פלטפורמות עם אפליקציית Linux מקומית. הוא מצוין למי שלא כותב קוד ורוצה לגרד אתרי אינטרנט מורכבים ודינמיים.
תכונות מרכזיות:
- ממשק point-and-click — בוחרים רכיבים ובונים תהליכי עבודה באופן ויזואלי.
- מטפל בתוכן דינמי, מפות, infinite scroll ועוד.
- הרצה ותזמון בענן.
- ייצוא ל-CSV, JSON או דרך API.
מחיר: תוכנית חינמית (5 פרויקטים), תוכניות בתשלום החל מ-$189 לחודש.
תאימות ללינוקס: אפליקציה מקומית ל-Linux, Windows ו-Mac.
מתאים במיוחד ל: אנליסטים ומשתמשים חצי-טכניים שרוצים שליטה בלי קוד.
9. Kimurai
 Kimurai היא מסגרת Web Scraping ב-Ruby עם תמיכה מקורית בלינוקס. אפשר לחשוב עליה כמו Scrapy, רק למפתחי Ruby.
תכונות מרכזיות:
- תמיכה בכמה דפדפנים: Headless Chrome, Firefox, PhantomJS או HTTP רגיל.
- עיבוד אסינכרוני לריבוי בקשות במקביל.
- DSL נקי ב-Ruby לכתיבת spiders.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: 100% (Ruby).
מתאים במיוחד ל: מפתחי Ruby או צוותי Rails שצריכים scraping מותאם אישית ובקנה מידה גבוה.
10. Apify
 Apify היא פלטפורמת Web Scraping בענן עם SDKs בקוד פתוח ושוק של “actors” מוכנים. אפשר להריץ סקרייפרים על מחשב Linux או בענן.
תכונות מרכזיות:
- SDKs ל-Node.js, Python ועוד.
- שוק של סקרייפרים מוכנים מראש.
- הרצה בענן, תזמון ואינטגרציה עם API.
מחיר: שכבה חינמית, תשלום לפי שימוש עבור הענן.
תאימות ללינוקס: CLI/SDK פועלים על Linux; הפלטפורמה בענן נגישה דרך הדפדפן.
מתאים במיוחד ל: מפתחים שרוצים שילוב של קוד מותאם אישית ותשתית ענן מוכנה.
11. Colly
 Colly היא מסגרת Web Scraping מבוססת Go שנבנתה למהירות ויעילות. אם אתם מפתחי Go, זה הכלי שלכם.
תכונות מרכזיות:
- Scraping סופר-מהיר ובמקביליות גבוהה — מעל 1,000 בקשות בשנייה על ליבה אחת.
- crawling מנומס (שומר על robots.txt), ניהול סשנים/קוקיז.
- טביעת זיכרון נמוכה.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: בינאריים מקוריים של Go.
מתאים במיוחד ל: מפתחי Go שצריכים scraping בעל ביצועים גבוהים.
12. PySpider
 PySpider היא מערכת crawler ב-Python עם ממשק web — אפשר לנהל, לתזמן ולנטר crawls מהדפדפן. חשוב לציין מראש: המאגר סומן בארכיון ציבורי ב-GitHub והיוצר המקורי לא משחרר גרסאות חדשות, אז מה שיש הוא מה שיש. אם אתם צריכים רק את דפוס הממשק/דשבורד שלה בלינוקס, היא עדיין רצה; לכל דבר שאתם מתכננים להישען עליו לטווח ארוך, צריך להתייחס אליה כאל legacy.
תכונות מרכזיות:
- ממשק מבוסס-אינטרנט לסקריפטים ולניטור.
- crawling מבוזר, תזמון וניסיונות חוזרים.
- אינטגרציה עם מסדי נתונים ותורי הודעות.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: תוכננה לפריסה בלינוקס.
מתאים במיוחד ל: צוותים שמרגישים בנוח לעשות fork ולתחזק בעצמם ממשק web למספר פרויקטי scraping (אל תצפו לתיקונים מהמקור).
13. WebHarvy
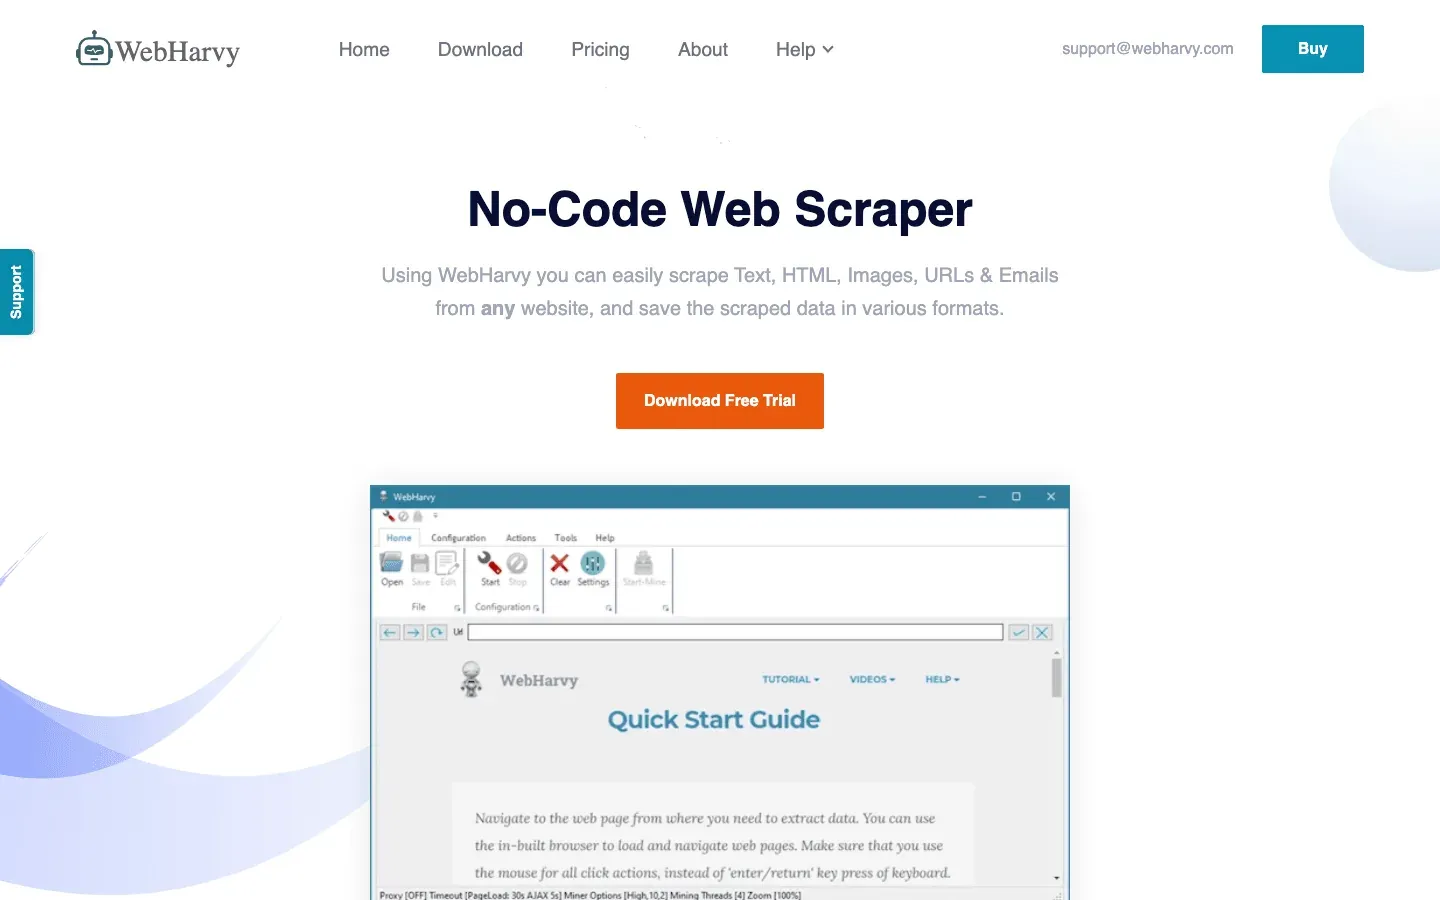 WebHarvy הוא סקרייפר ויזואלי של point-and-click ל-Windows, אבל משתמשי Linux יכולים להריץ אותו דרך Wine. הוא ידוע בזיהוי תבניות ובמודל של רכישה חד-פעמית.
תכונות מרכזיות:
- גולשים ולוחצים כדי לבחור נתונים — בלי קוד.
- זיהוי אוטומטי של תבניות ברשימות.
- ייצוא ל-CSV, JSON, XML, SQL.
מחיר: רישיון חד-פעמי של כ-$129.
תאימות ללינוקס: פועל תחת Wine או ב-VM.
מתאים במיוחד ל: מתחילים או אנשי מקצוע עצמאיים שרוצים סקרייפר מהיר וויזואלי.
14. OutWit Hub
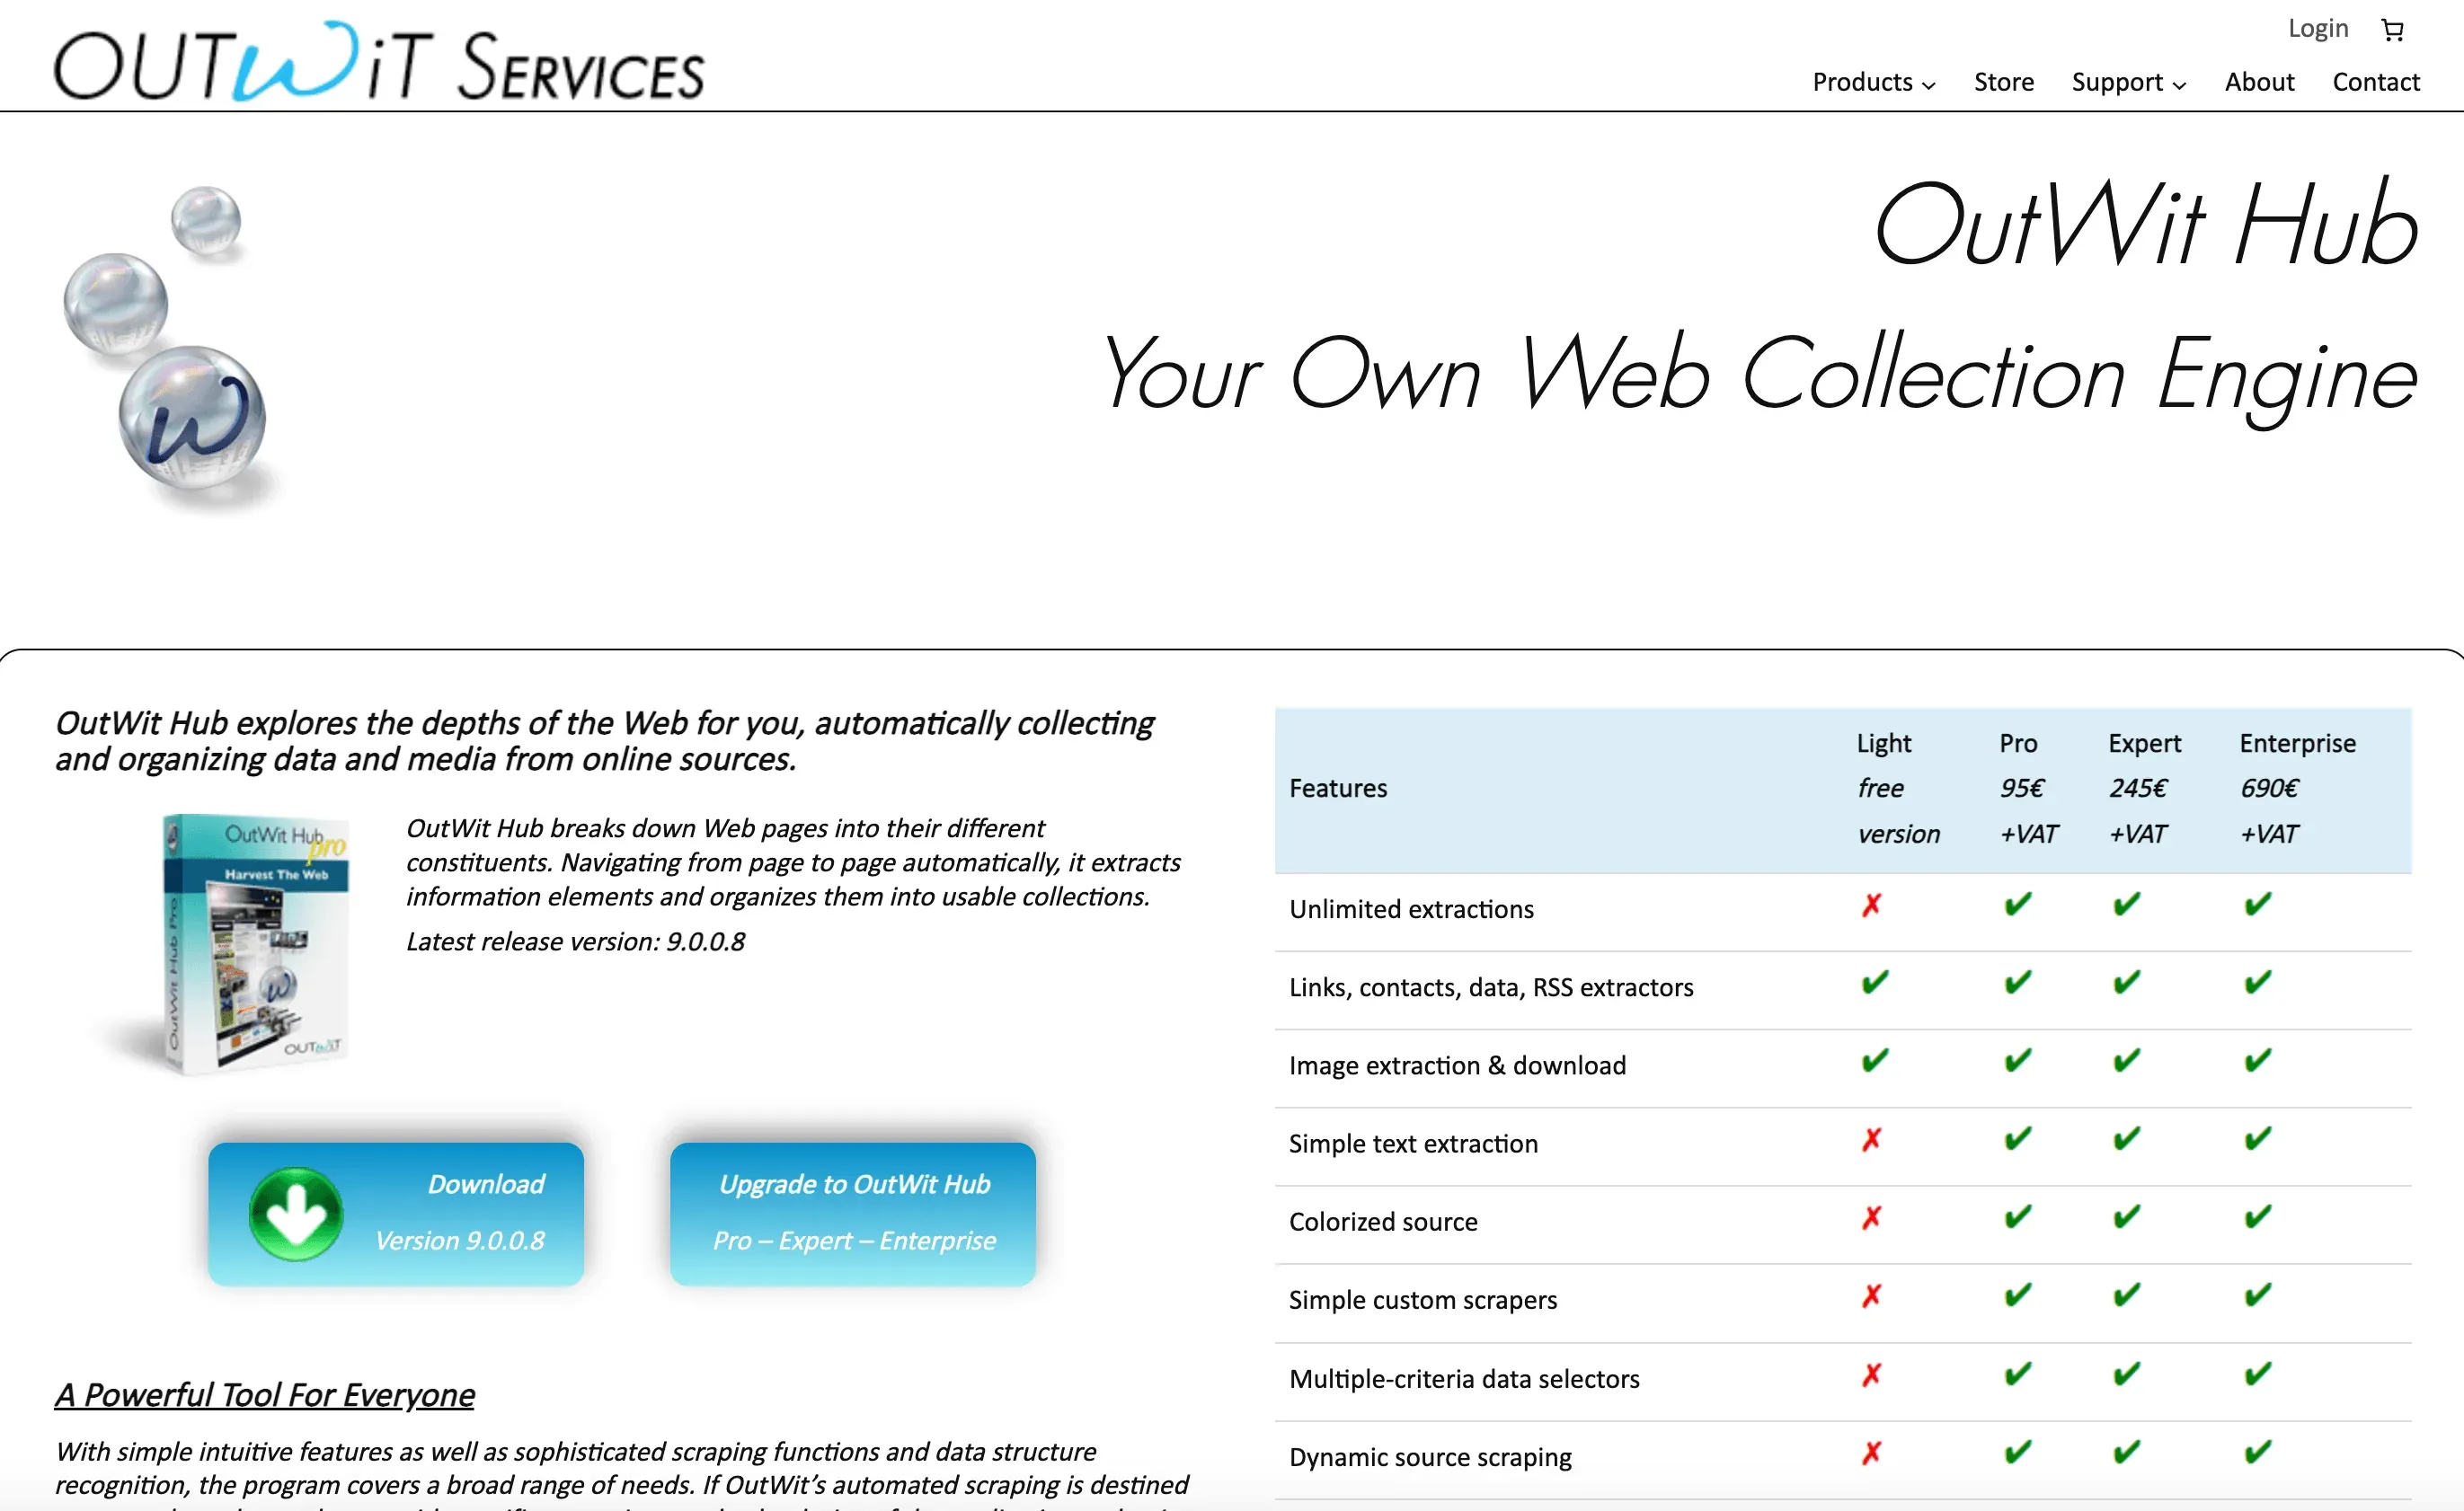 OutWit Hub היא אפליקציית GUI מקורית ללינוקס ל-Web Scraping. היא מזהה אוטומטית תבניות נתונים ומציעה יכולות חילוץ ואוטומציה חזקות.
תכונות מרכזיות:
- מזהה אוטומטית קישורים, תמונות, טבלאות, אימיילים ועוד.
- עורך סקריפטים לחילוץ מותאם אישית.
- אוטומציית מאקרו ותזמון.
מחיר: גרסה חינמית (מוגבלת); רישיון Pro בתשלום — בדקו בחנות הספק את המחיר העדכני.
תאימות ללינוקס: אפליקציה מקומית ל-Linux, Windows ו-Mac.
מתאים במיוחד ל: לא-מפתחים עם נטייה טכנית שרוצים סקרייפר דסקטופ עם GUI.
15. Portia
 Portia היא Web Scraper ויזואלי בקוד פתוח מבית Scrapinghub. היא רצה בדפדפן ומאפשרת לכם לסמן דפים כדי לאמן סקרייפרים — אבל שימו לב, המאגר לא ראה ממש פיתוח משמעותי כבר יותר משנה, אז הוא נמצא באזור של “שימוש על אחריותכם”. אם אתם רוצים את הרעיון של annotation ויזואלי עם פיתוח פעיל מאחוריו, ParseHub או Thunderbit הן בחירות נקיות יותר.
תכונות מרכזיות:
- ממשק מבוסס דפדפן לחילוץ ויזואלי.
- אינטגרציה עם Scrapy לפרויקטים מותאמים אישית.
- קוד פתוח וניתן להרחבה.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: מבוסס דפדפן; עובד בכל מערכת הפעלה.
מתאים במיוחד ל: משתמשים שרוצים scraping ויזואלי בקוד פתוח עם אינטגרציה ל-Scrapy.
16. Sequentum Enterprise (לשעבר Content Grabber)
 Sequentum Enterprise היא סקרייפר ויזואלי ברמת אנטרפרייז ל-Windows, אבל אפשר להריץ אותה על Linux דרך Wine או וירטואליזציה.
תכונות מרכזיות:
- עורך ויזואלי יחד עם סקריפטינג ב-C# ללוגיקה מתקדמת.
- ניהול ותזמון של כמה agents.
- אינטגרציה עם מסדי נתונים, APIs ועוד.
מחיר: רישוי אנטרפרייז, לפי הצעת מחיר לכל פריסה.
תאימות ללינוקס: דרך Wine או VM.
מתאים במיוחד ל: סוכנויות וצוותים גדולים שמנהלים הרבה פרויקטי scraping.
17. Helium
 Helium היא ספריית Python שמפשטת אוטומציית Selenium. היא נועדה להפוך סקריפטים לדפדפן לידידותיים יותר לאדם.
תכונות מרכזיות:
- פקודות אינטואיטיביות כמו
click("Login")אוwrite("email"). - מפעילה את Chrome ו-Firefox.
- מעולה לסקריפטים מהירים ומשימות אוטומציה.
מחיר: חינם ובקוד פתוח.
תאימות ללינוקס: עובדת על Linux (מבוססת Selenium).
מתאים במיוחד ל: משתמשי Python שמרגישים ש-Selenium מסורבל מדי.
18. Dexi.io
 Dexi.io היא פלטפורמה מבוססת ענן לחילוץ נתונים ואוטומציה. אפשר לגשת אליה דרך הדפדפן, כך שמשתמשי Linux יכולים להשתמש בה בלי להתקין כלום.
תכונות מרכזיות:
- מעצב תהליכי עבודה ויזואלי לסקרייפינג ואוטומציה.
- תזמון, טרנספורמציה של נתונים ואינטגרציה עם API.
- סקייל ותמיכה ברמת אנטרפרייז.
מחיר: נמכרת כעת תחת Mozenda: ניסיון חינם ל-14 יום, Pilot ב-$500 לחודש, ואנטרפרייז לפי הצעת מחיר.
תאימות ללינוקס: אפליקציית web — עובדת בכל מערכת הפעלה.
מתאים במיוחד ל: אנשי מקצוע וארגונים שצריכים חילוץ נתונים מהאינטרנט עם אינטגרציות וסקייל.
טבלת השוואה מהירה: כלי Web Scraping ללינוקס במבט חטוף
| כלי | סוג / תכונות עיקריות | מתאים במיוחד ל | מחיר | תאימות ללינוקס |
|---|---|---|---|---|
| Thunderbit | תוסף AI ל-Chrome, בלחיצה אחת, תתי-עמודים, ענן/מקומי | משתמשים עסקיים לא-טכניים | חינם, מ-$15 לחודש | ✔ Chrome על Linux |
| Scrapy | מסגרת Python, אסינכרונית, CLI, ניתנת להרחבה מאוד | מפתחים, סקרייפרים מותאמים בקנה מידה גדול | חינם | ✔ מקורי |
| Beautiful Soup | ספריית Python, פירוק HTML/XML פשוט | מפתחים, מדעני נתונים, משימות קטנות | חינם | ✔ מקורי |
| Selenium | אוטומציית דפדפן, אתרים כבדי JS | QA, מפתחים, תוכן דינמי | חינם | ✔ מקורי |
| Puppeteer | Node.js, Chrome headless, רנדור JS | מפתחי Node, אפליקציות web מודרניות | חינם | ✔ מקורי |
| Octoparse | ללא קוד, drag-and-drop, תבניות ענן | לא-מפתחים, e-commerce | חינם, מ-$69 לחודש | ◐ ענן/Wine |
| PhantomJS | WebKit headless, סקריפטבילי ב-JS | legacy, קליל, בלי Chrome | חינם | ✔ מקורי |
| ParseHub | ויזואלי, חוצה-פלטפורמות, point-and-click | אנליסטים, משתמשים חצי-טכניים | חינם, מ-$189 לחודש | ✔ מקורי |
| Kimurai | מסגרת Ruby, כמה דפדפנים, אסינכרוני | מפתחי Ruby, ריבוי בקשות | חינם | ✔ מקורי |
| Apify | פלטפורמת ענן, SDKs, marketplace | מפתחים, שילוב של קוד וענן | שכבה חינמית, לפי שימוש | ✔ מקורי/ענן |
| Colly | מסגרת Go, מהירה, במקביליות גבוהה | מפתחי Go, ביצועים גבוהים | חינם | ✔ מקורי |
| PySpider | Python, ממשק web, תזמון, מבוזר | צוותים, כמה פרויקטים | חינם | ✔ מקורי |
| WebHarvy | ויזואלי, זיהוי תבניות, רישיון חד-פעמי | מתחילים, אנשי מקצוע יחידים | כ-$129 חד-פעמי | ◐ Wine/VM |
| OutWit Hub | GUI מקורי, זיהוי אוטומטי של נתונים, סקריפטים | לא-מפתחים, GUI דסקטופ | חינם; Pro בתשלום (בדקו אצל הספק) | ✔ מקורי |
| Portia | קוד פתוח, ויזואלי, מבוסס דפדפן | קוד פתוח, אינטגרציה עם Scrapy | חינם | ✔ דפדפן |
| Sequentum Enterprise | אנטרפרייז, ויזואלי, סקריפטינג, multi-agent | סוכנויות, צוותים גדולים | $$$, לפי הצעת מחיר | ◐ Wine/VM |
| Helium | Python, Selenium פשוט יותר, API אינטואיטיבי | משתמשי Python, אוטומציה מהירה | חינם | ✔ מקורי |
| Dexi.io | ענן, תהליך עבודה ויזואלי, תזמון, API | אנטרפרייז, אוטומציה סקיילבילית | מ-$500 לחודש (דרך Mozenda) | ✔ דפדפן |
איך לבחור את ה-Web Scraper הנכון ללינוקס: שיקולים מרכזיים
לא בטוחים איזו רמה אתם צריכים? התחילו מהצד הפשוט אם אתם מעדיפים לא לתחזק selectors, תנו ל-AI למצוא את השדות בשבילכם — לחיצה אחת, ואז ייצוא ל-Sheets, Excel, Airtable או Notion. Get Started Free
בחירת הכלי הנכון היא קודם כול התאמה בין הצרכים שלכם לרמת המיומנות שלכם:
- רמת ידע טכני: מי שלא כותב קוד צריך להסתכל קודם על Thunderbit, ParseHub, Octoparse או OutWit Hub. מפתחים יכולים לפתוח יותר כוח עם Scrapy, Puppeteer, Colly או Kimurai.
- מורכבות הנתונים: לדפים סטטיים, Beautiful Soup או Colly הן מהירות ופשוטות. לאתרים דינמיים וכבדי JavaScript, תצטרכו Selenium, Puppeteer או כלי ויזואלי שתומך ב-JS.
- סקייל ותדירות: למשימות חד-פעמיות, כלים ללא קוד או סקרייפרים בענן יעשו את העבודה. ל-crawls מתוזמנים ובקנה מידה גדול, לכו על Scrapy, PySpider או Apify.
- צרכי אינטגרציה: צריכים לייצא ל-Excel, Sheets או מסד נתונים? ודאו שהכלי תומך בזרימת העבודה שלכם.
- תקציב: יש plenty של אפשרויות חינמיות וקוד פתוח למפתחים. למשתמשים עסקיים, Thunderbit ו-ParseHub מציעים נקודות כניסה משתלמות, בעוד שצוותי אנטרפרייז עשויים להשקיע ב-Dexi.io או Sequentum Enterprise.
- תמיכה וקהילה: לכלי קוד פתוח יש קהילות גדולות; לכלים מסחריים יש תמיכה ייעודית.
טיפ מקצועי: אל תפחדו לשלב כלים. השתמשו ב-Thunderbit כדי ליצור אבטיפוס ולזהות דפוסי נתונים, ואז עברו ל-Scrapy להרצות ברמת ייצור. או השתמשו ב-Selenium כדי להתחבר ולחלץ קוקיז של סשן, ואז העבירו את המושכות ל-Colly או Scrapy לחילוץ מהיר.
סיכום: מצאו את כלי ה-Web Scraping הטוב ביותר שלכם ללינוקס ל-2026
משתמשי Linux מפונקים מבחירה ב-2026. בין אם אתם רוצים כלי ללא קוד, מבוסס AI, שמספק תוצאות תוך דקות (Thunderbit), מסגרת מפתחים חזקה (Scrapy, Colly), או פלטפורמת אנטרפרייז (Dexi.io), יש Web Scraper ללינוקס שמתאים לצרכים ולזרימת העבודה שלכם.
נקודות עיקריות:
- Linux הוא עמוד השדרה של תשתיות הנתונים המודרניות — רוב הסקרייפרים המובילים פועלים עליו באופן מקורי או דרך הדפדפן.
- כלי AI וללא קוד דמוקרטיזציה של web scraping עבור משתמשים עסקיים.
- מסגרות למפתחים עדיין מובילות בגמישות, מהירות וסקייל.
- תמיד כדאי לנסות לפני שקונים — רוב הכלים מציעים שכבות חינמיות או תקופות ניסיון.
מוכנים להתחיל? הורידו את Thunderbit או קפצו ל-Thunderbit Blog למדריכים נוספים על web scraping, אוטומציה וצמיחה מבוססת נתונים.
גלו את ה-AI Web Scraper של Thunderbit תחסכו סקריפטים ומשימות cron — תנו ל-AI לקרוא את העמוד ולמסור לכם טבלה בלחיצה אחת. Get Started Free
שאלות נפוצות
1. מהו ה-Web Scraper הכי קל ללינוקס אם אני לא יודע לקודד?
Thunderbit הוא הבחירה המובילה למשתמשים לא-טכניים. הוא פועל כתוסף Chrome על Linux, משתמש ב-AI כדי לאוטומט הכול, ומאפשר לכם לחלץ נתונים בלחיצה אחת.
2. איזה Web Scraper ללינוקס הכי טוב לפרויקטים מותאמים בקנה מידה גדול?
Scrapy הוא הבחירה הטבעית למפתחים. הוא מהיר, סקיילבילי וניתן להתאמה אישית ברמה גבוהה — מושלם ל-crawls גדולים וחוזרים.
3. האם אפשר לחלץ אתרים כבדי JavaScript או דינמיים על Linux?
כן! השתמשו ב-Selenium או ב-Puppeteer כדי לשלוט בדפדפנים אמיתיים ולחלץ תוכן דינמי. גם כלים ויזואליים כמו ParseHub ו-Thunderbit תומכים באתרים דינמיים.
4. האם יש כלי Web Scraping חינמיים ללינוקס לשימוש עסקי?
בהחלט. Scrapy, Beautiful Soup, Selenium, Colly, PySpider ו-Kimurai כולם חינמיים ובקוד פתוח. Thunderbit ו-ParseHub מציעים שכבות חינמיות לעבודות קטנות יותר.
5. איך בוחרים בין סקרייפר ללא קוד לסקרייפר מבוסס קוד בלינוקס?
אם אתם רוצים מהירות ופשטות, לכו על ללא קוד (Thunderbit, ParseHub, Octoparse). אם אתם צריכים גמישות, אוטומציה או אינטגרציה עם מערכות אחרות, כלים מבוססי קוד (Scrapy, Puppeteer, Colly) הם הבחירה הטובה יותר.
סקרייפינג שמח — ושהפרויקטים שלכם על בסיס Linux ירוצו חלק יותר מהתקנה טרייה של Ubuntu. אם אתם רוצים לראות עוד טיפים ל-web scraping, בקרו ב-Thunderbit Blog או הירשמו ל-ערוץ YouTube שלנו לקבלת הדרכות מעשיות.
נסו AI Web Scraper ללינוקס Get Started Free
מידע נוסף



