
בשבוע שעבר אחד מהמשתמשים שלנו כתב לנו: "אני צריך מחירים, תיאורים ונתוני וריאנטים מ-14 חנויות Shopify של מתחרים — עד יום שישי." זה בערך 4,000 עמודי מוצר. להעתיק ולהדביק? ממש לא ריאלי.
אם אי פעם ניסיתם לשלוף נתוני מוצר מחנות Shopify — מחירים, תמונות, תיאורים, וריאנטים, ביקורות — אתם כבר מכירים את כאב הראש. נכון ל-2026 יש יותר מ-2.8 מיליון חנויות Shopify פעילות, ואף אחת מהן לא מגיעה עם כפתור "ייצוא למתחרים". במקביל, 72% מהעסקים מדווחים שהם עוקבים באופן פעיל אחרי מחירי מתחרים, וספקי שירותי ecommerce מציינים שהעלאה ידנית של אפילו מוצר אחד עם וריאנטים ותמונות יכולה לגזול 15 עד 30 דקות. תכפילו את זה בכמה מאות מוצרים — וכל השבוע שלכם פשוט נעלם.
לכן תוספי Chrome ל- Shopify scraper הפכו לחלק קבוע בערכת הכלים של ecommerce — למחקר תחרותי, לאיתור מוצרים לדרופשיפינג, להעברת קטלוגים ועוד. אבל רוב כתבות ה"הכי טוב" רק מונות פיצ'רים בלי להראות מה באמת קורה כשמריצים אותן על חנויות Shopify אמיתיות. הפעם זה שונה. בדקתי שמונה תוספים מול חנויות פעילות בפועל, נתקלתי בחומות אנטי-בוט אמיתיות, וגיליתי אילו כלים באמת מוציאים את עומק נתוני המוצר שאתם צריכים — ואילו נשארים רק בשכבה העליונה.
למה צוותי Ecommerce צריכים תוסף Chrome ל- Shopify Scraper
חנויות Shopify הן ממש מכרות זהב של נתוני מוצר שימושיים לעסק. אבל כשאתם נמצאים מחוץ לחנות, אין לכם כפתור CSV להורדה. יש לכם חזית חנות. כדי להפוך את חזית החנות לתובנות שאפשר לעבוד איתן, צריך scraper — והשימושים שלו הרבה יותר רחבים מ"אני רק רוצה רשימה של שמות מוצרים".
השאלה האמיתית היא: אילו נתונים אתם באמת צריכים, ולאיזו משימה? הנה איך מקרי השימוש הנפוצים ביותר ב- ecommerce מתורגמים לשדות נתונים ספציפיים:
מחקר מחירים של מתחרים
אתם צריכים: כותרות מוצרים, מחירים, מחירי השוואה, ותמחור ברמת וריאנט. זה הבסיס של אסטרטגיית תמחור דינמית — להבין לא רק כמה המתחרה גובה, אלא גם איך הוא נותן הנחות, בונה חבילות, ומתמחר לפי גדלים או צבעים.
איתור מוצרים לדרופשיפינג
אתם צריכים: כותרות, כל התמונות (לא רק תמונות ממוזערות), תיאורים מלאים, ותאריכי פרסום. מיון לפי תאריך פרסום חדש עוזר לזהות מוצרים טרנדיים או מוצרים שזה עתה הושקו, לפני שהם מציפים את השוק.
ייבוא קטלוג לחנות שלכם
אתם צריכים: כותרות, body HTML, כל התמונות, וריאנטים, SKU ומחירים — רצוי בפורמט CSV שמוכן לייבוא ל- Shopify. לא כל כלי מייצר את זה בצורה נקייה.
הערכת קצב מכירות
אתם צריכים: כותרות מוצרים וכמויות מלאי, לאורך זמן. אם מצלמים את רמות המלאי באופן קבוע, אפשר להעריך כמה מהר מתחרה מזיז מלאי — מדד מקורב, אבל שימושי כשאין לכם נתוני מכירות ישירים.
יצירת לידים (איתור בעלי חנויות)
אתם צריכים: שם החנות, אימייל ליצירת קשר, מספר טלפון, ולפעמים גם האפליקציות או ה- tech stack שהחנות משתמשת בו. צוותי מכירות משתמשים בזה כדי לבנות רשימות פנייה לפי נישה או לפי טכנולוגיה.
הנה טבלת עזר מהירה:
| Use Case | Key Data Fields Needed | Recommended Workflow |
|---|---|---|
| Competitor pricing research | Title, price, compare-at-price, variant prices | Scrape listing page + subpage enrichment for variants |
| Dropshipping product discovery | Title, price, images (all), description, publish date | Subpage scrape + sort by newest publish date |
| Catalog import to your store | Title, body HTML, images, variants, SKU, price | Full subpage scrape → export as Shopify-import CSV |
| Sales estimation | Title, inventory quantity (over time) | Scheduled scraping → Google Sheets tracking |
| Lead generation (store owners) | Store name, email, phone, apps used | Scrape store contact pages + email/phone extractors |
איך הערכתי את 8 תוספי ה- Shopify Scraper האלה ל- Chrome
התקנתי את כל שמונת התוספים והרצתי אותם על אותו סט של חנויות Shopify אמיתיות — כולל חנויות ציבוריות, חנויות מוגנות Cloudflare, וחנויות עם products.json מושבת. לא בדקתי רק רשימות פיצ'רים. רציתי לראות מה באמת קורה כשאתם לוחצים "scrape" על עמוד קולקציה חי של Shopify.
הנה שמונת הקריטריונים שבהם השתמשתי, ולמה כל אחד מהם חשוב במיוחד ל- Shopify:
| Criteria | Why It Matters for Shopify Scraping |
|---|---|
| Ease of Setup | Can a non-technical dropshipper start scraping in under 5 minutes? |
| Data Fields Extracted | Does it get title, price, images, descriptions, variants, AND reviews — or just surface-level data? |
| Subpage Enrichment | Can it scrape a listing page then auto-visit each product page for full details? |
| Pagination Handling | Can it scrape beyond the first page of products (click pagination or infinite scroll)? |
| Anti-Bot Resilience | Does it handle Cloudflare Turnstiles or Shopify's bot protection without breaking? |
| Export Formats | CSV, Excel, Google Sheets, Airtable, Notion, Shopify-import-ready CSV? |
| Scheduled/Recurring Scraping | Can it monitor prices or inventory changes automatically over time? |
| Pricing Transparency | Free tier limits, credit system, flat-fee — and what you actually get |
עם המסגרת הזו בראש, הנה איך כל כלי ביצע.
1. Thunderbit — ה- AI Web Scraper ל- Shopify שנבנה למי שלא כותב קוד
Thunderbit הוא הכלי שפיתחנו ב- Thunderbit במיוחד למשתמשי עסק שרוצים נתוני מוצר עמוקים בלי לכתוב קוד, להגדיר CSS selectors או לבזבז 20 דקות על הכנות. הזרימה על חנות Shopify היא באמת בלחיצה אחת: פותחים עמוד קולקציה ולוחצים על One Click Extract — ה- AI קורא את העמוד, מזהה את העמודות (כותרת, מחיר, תמונה וכו') ושולף את נתוני הרשימה.
אבל ההבדל האמיתי — והדבר שרוב הכתבות המתחרות מפספסות — הוא מה שקורה אחר כך.
העשרת תתי-עמודים: הפיצ'ר שמשנה הכול
אחרי שסורקים את עמוד הרשימה, לוחצים על "Scrape Subpages". ה- AI של Thunderbit מבקר בכל כתובת מוצר ומוסיף לטבלה המקורית נתוני עמודי פרטים: תיאורים מלאים, כל תמונות הגלריה, אפשרויות וריאנטים, SKU, מספרי ביקורות ועוד. זה השלב שהופך גיליון שטחי למאגר נתונים שימושי למחקר תחרותי.
בהמשך אסביר למה זה כל כך חשוב ואציג השוואת לפני/אחרי בסעיף ייעודי למטה.
נקודות חוזק מרכזיות ל- Shopify Scraping
- One Click Extract קורא את עמוד ה- Shopify ומבין את מבנה העמודות הנכון — בלי CSS selectors, בלי הגדרה ידנית
- Subpage scraping ממלא את הפערים שעמודי רשימה מפספסים (תיאורים מלאים, אפשרויות וריאנטים, גלריות תמונות, ביקורות)
- Cloud scraping mode לשליפה מהירה בכמות גדולה מחנויות ציבוריות; browser scraping mode לחנויות מוגנות Cloudflare או חנויות שדורשות התחברות
- Pagination handling (גם בלחיצה וגם בגלילה אינסופית)
- Scheduled scraping לניטור מחירים/מלאי לאורך זמן — מתארים את לוח הזמנים באנגלית פשוטה (למשל: "every Monday at 9am")
- חילוצי אימייל וטלפון בחינם למקרי שימוש של lead generation
- ייצוא ל- Excel, Google Sheets, Airtable, Notion, CSV, JSON — כולל פורמטים נוחים לייבוא ל- Shopify
- Field AI Prompt מאפשר להוסיף הוראות מותאמות לכל עמודה (למשל: "לסווג ל- 3 סוגי מוצרים" או "לתרגם את התיאור לאנגלית")
איפה הוא חלש יותר
- תמחור מבוסס קרדיטים אומר שסקרייפינג בהיקף גדול מאוד (עשרות אלפי מוצרים) ידרוש תוכנית בתשלום
- עיבוד AI מוסיף כמה שניות לכל שורה לעומת scrapers מבוססי תבניות בדפים פשוטים מאוד
תמחור
- תוכנית חינמית: 6 עמודים (או עד 10 עם ניסיון חינם), כל הייצואים בחינם
- Starter: $15 לחודש, 500 קרדיטים בחודש
- Professional tiers: מ- $38 לחודש (3,000 קרדיטים) עד $249 לחודש (20,000 קרדיטים)
- כללי קרדיטים: שורת פלט אחת = קרדיט אחד ל- web scraping; שורת פלט אחת = 2 קרדיטים ל- subpage scraping; הייצוא תמיד חינם
מתאים במיוחד ל: צוותי ecommerce לא טכניים שצריכים את עומק נתוני המוצר הגבוה ביותר מ- Shopify עם מינימום הגדרה — ורוצים גם לעקוב אחרי מתחרים לאורך זמן.
נסו את Thunderbit ל- Shopify Scraping כותרות מוצרים, מחירים, וריאנטים ותמונות מכל חנות Shopify — בלחיצה אחת, בלי להגדיר selectors. Get Started Free
2. Instant Data Scraper — אפשרות אוטומטית בלי הגדרות
Instant Data Scraper הוא תוסף Chrome חינמי שמשתמש באלגוריתמים היוריסטיים כדי לזהות אוטומטית נתונים טבלאיים בעמודי אינטרנט. אין כאן שום קונפיגורציה — פותחים עמוד קולקציה של Shopify, לוחצים על אייקון התוסף, והוא מנסה לזהות ולהציג את נתוני המוצרים בטבלה.
בבדיקות שלי הוא עבד טוב על עמודי קולקציה סטנדרטיים של Shopify עם תבנית Dawn, וזיהה כותרות, מחירים ו- thumbnail URLs בתוך שניות. בחנויות עם מבנים לא סטנדרטיים הוא לפעמים תפס קישורי ניווט או תוכן footer במקום מוצרים — לכן צריך לבדוק את הפלט בעין.
נקודות חוזק מרכזיות ל- Shopify Scraping
- חינמי לחלוטין, בלי מגבלות שימוש
- זיהוי אוטומטי אומר זמן הגדרה אפסי — טוב לייצוא מהיר וחד-פעמי
- תומך ב- pagination (יכול ללחוץ אוטומטית על "next page")
- מייצא ל- CSV ו- XLSX
איפה הוא חלש יותר
- הזיהוי האוטומטי לא עקבי בחנויות Shopify עם מבנים לא סטנדרטיים
- אין העשרת תתי-עמודים: מקבלים רק מה שנמצא בעמוד הרשימה (כותרת, מחיר, תמונה ממוזערת), בלי תיאורים מלאים, וריאנטים או ביקורות
- אין AI לניקוי, תיוג או טרנספורמציה של נתונים
- אין תזמון, אין cloud scraping
- אין ייצוא ישיר ל- Google Sheets, Airtable או Notion
תמחור
- חינם לחלוטין
מתאים במיוחד ל: מי שצריך ייצוא מהיר, חינמי וללא הגדרה של נתוני עמוד רשימה גלויים מחנות Shopify סטנדרטית.
3. Web Scraper — בונה Sitemap ויזואלי
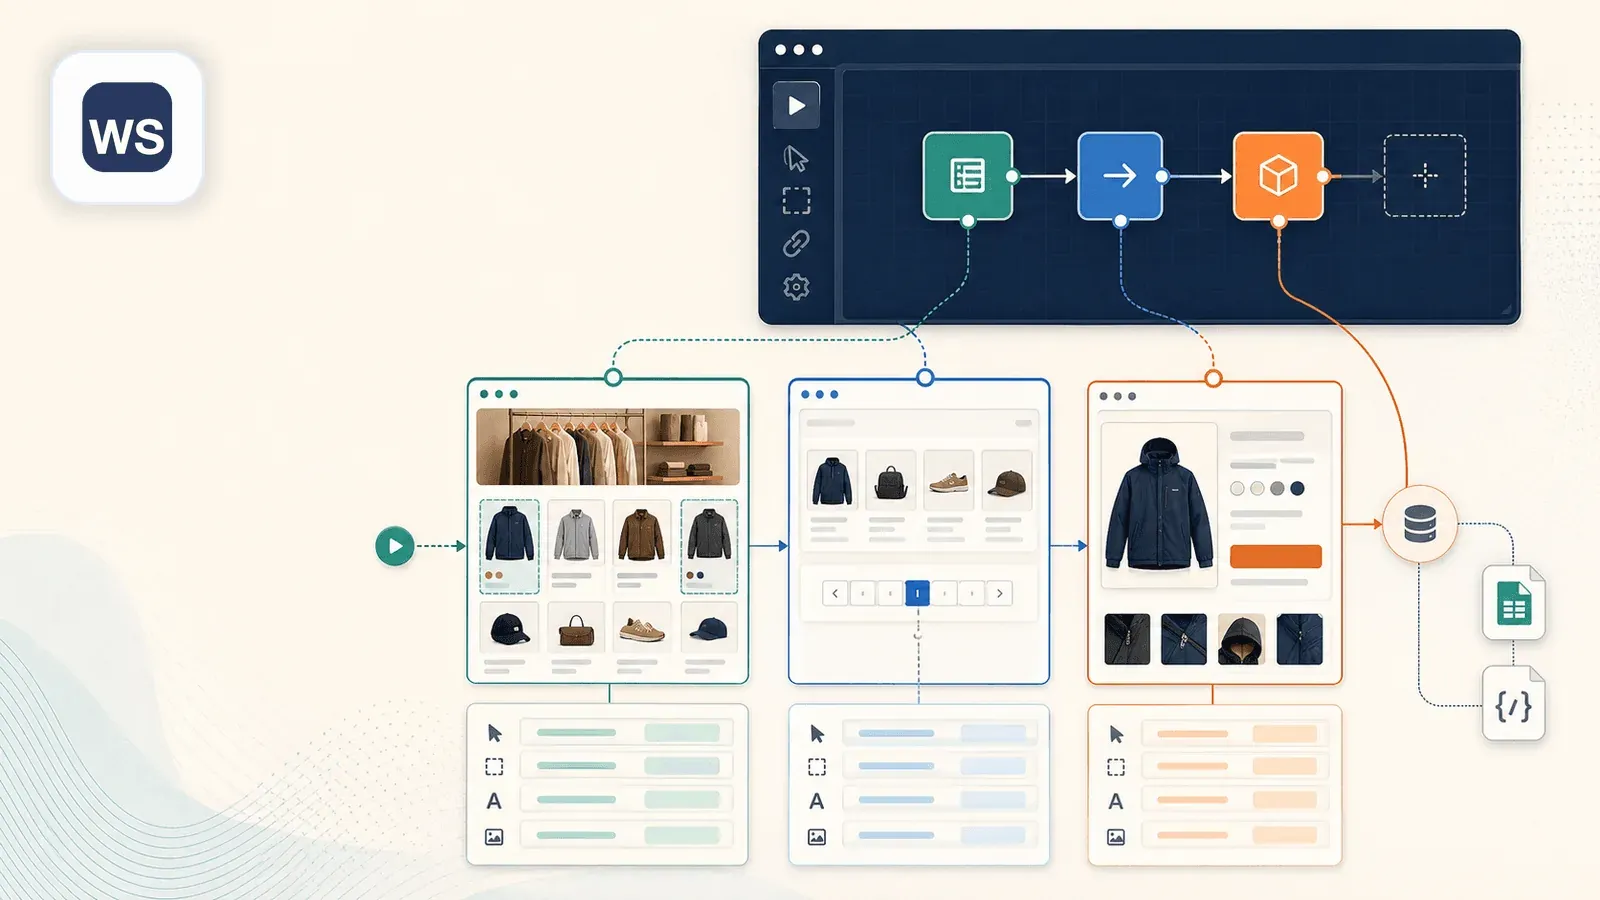
Web Scraper (webscraper.io) הוא תוסף Chrome קלאסי של point-and-click לבניית "sitemaps" — מתכוני scraping שבהם בוחרים אלמנטים בעמוד ומגדירים את זרימת האיסוף. ב- Shopify תבנו sitemap על ידי לחיצה על כותרות מוצרים, מחירים, תמונות והגדרת כללי pagination ומעקב אחרי קישורים.
נקודות חוזק מרכזיות ל- Shopify Scraping
- בונה selectors ויזואלי נותן יותר שליטה מכלי זיהוי אוטומטי
- יכול לעקוב אחרי קישורים לתתי-עמודים (עמודי פרטי מוצר) — אבל דורש הגדרה ידנית של parent-child selectors בתוך ה-sitemap
- מטפל ב- pagination כשמגדירים אותו נכון
- scraping מקומי בדפדפן הוא חינמי; יש גם תוכניות cloud בתשלום (מ- $50 לחודש)
- ייצוא ל- CSV; תוכניות cloud תומכות גם ב- Google Sheets ובפורמטים נוספים
איפה הוא חלש יותר
- ההגדרה גוזלת יותר זמן: יצירת sitemap עם parent-child selectors לקחה לי בערך 15 דקות עבור חנות Shopify חדשה
- subpage scraping דורש הגדרה ידנית של link selectors ו-child sitemaps — לא העשרה בלחיצה אחת
- sitemaps נשברים כשהחנויות משנות פריסה או CSS classes
- עקומת הלמידה תלולה יותר לעומת חלופות מבוססות AI
תמחור
- תוסף בדפדפן: חינם
- Cloud plans: Project $50 לחודש, Professional $100 לחודש, Scale מ- $200 לחודש
מתאים במיוחד ל: משתמשים טכניים שרוצים שליטה מדויקת בזרימת ה-scraping ולא אכפת להם לבנות את המתכון בעצמם.
4. Data Miner — scraper מבוסס מתכונים
Data Miner (dataminer.io) בנוי סביב "recipes" — תבניות scraping מוכנות או מותאמות אישית שמפעילים על עמוד. יש ספריית מתכונים ציבורית, כך שאולי תמצאו תבנית Shopify שמישהו אחר שיתף, או שתוכלו לבנות אחת משלכם על ידי בחירת אלמנטים בעמוד.
נקודות חוזק מרכזיות ל- Shopify Scraping
- ספריית מתכונים עשויה לכלול תבניות Shopify מוכנות שמשתמשים אחרים שיתפו
- בונה מתכונים ויזואלי לקונפיגורציית scraping מותאמת
- מטפל ב- pagination באמצעות הגדרת המתכון
- מייצא ל- CSV, Excel, Google Sheets ו- TSV
- יש workflows של crawl לביקור בעמודי פרטים אחרי עמודי רשימה
איפה הוא חלש יותר
- התוכנית החינמית מוגבלת ל-500 עמודים בחודש
- המתכונים מבוססים על CSS selectors, ולכן נשברים כשהפריסה של החנות משתנה
- אין הצעת שדות או טרנספורמציה בעזרת AI
- אין workflow מובנה של העשרה בלחיצה אחת לתתי-עמודים — צריך מתכון crawl נפרד לעמודי פרטים
- יש crawls מתוזמנים, אבל זה לא סיפור התזמון הכי פשוט
תמחור
- חינם: 500 עמודים בחודש
- Solo: $19.99 לחודש
- Small Business: $49 לחודש
- Business: $99 לחודש
- Business Plus: $200 לחודש
מתאים במיוחד ל: משתמשים שאוהבים לעבוד עם תבניות ורוצים ספריית מתכונים שתאיץ את ההתחלה באתרי נפוצים.
5. Simplescraper — מחלץ קל משקל
Simplescraper (simplescraper.io) הוא תוסף Chrome מינימליסטי ו- scraper מבוסס ענן שמדגיש פשטות. לוחצים על רכיבי נתונים בעמוד Shopify, Simplescraper יוצר CSS selectors, ושולף את הנתונים התואמים.
נקודות חוזק מרכזיות ל- Shopify Scraping
- ממשק נקי ומינימליסטי — קל ללמוד במהירות
- cloud scraping זמין למשימות מתוזמנות ובאצווה
- גישה ל- API למפתחים שרוצים לשלב נתונים שנאספו ב-workflows
- ייצוא ל- CSV, JSON, Google Sheets, Airtable ובאמצעות webhooks
- קונספט של deep scraping למעקב אחרי קישורים לעמודי פרטים
- workflows שיכולים לעבוד גם עם login עבור חנויות תלויות-סשן
איפה הוא חלש יותר
- גישה ידנית מבוססת selectors — אין AI שמזהה שדות אוטומטית
- subpage scraping דורש הגדרה נוספת
- קהילה קטנה יותר ופחות תבניות מוכנות לעומת Web Scraper או Data Miner
- התוכנית החינמית: 100 קרדיטים (עמוד אחד שמרונדר ב- JS = 2 קרדיטים)
- תמחור התוכניות בתשלום פחות שקוף באתר הרשמי מאשר אצל רוב המתחרים
תמחור
- חינם: 100 קרדיטים
- Paid plans: מקורות צד שלישי מציינים Plus בכ- $39 לחודש, Pro בכ- $70 לחודש, Premium בכ- $150 לחודש (לפי נתוני תמחור של G2)
מתאים במיוחד ל: מי שרוצה scraper מודרני וקל משקל עם אינטגרציות טובות ולא צריך זיהוי שדות מבוסס AI.
6. Octoparse — תוסף Chrome שמופעל דרך אפליקציית דסקטופ
Octoparse (octoparse.com) היא בעיקר אפליקציית דסקטופ עם תוסף Chrome משלים. היא מציעה גם בונה workflow ויזואלי וגם תבניות מוכנות לאתרים פופולריים, כולל מדריך scraping ייעודי ל- Shopify.
נקודות חוזק מרכזיות ל- Shopify Scraping
- תבניות Shopify מוכנות למשימות scraping נפוצות
- אפליקציית דסקטופ חזקה עם יכולות מתקדמות: IP rotation, scraping מתוזמן, cloud extraction
- מטפלת היטב ב- pagination, infinite scroll ותוכן שמיטען ב- AJAX
- טיפול האנטי-בוט המתועד החזק ביותר ברשימה, כולל טיפול אוטומטי ב- CAPTCHA
- ייצוא ל- CSV, Excel, JSON, HTML, XML, מסדי נתונים ו- Google Sheets
איפה הוא חלש יותר
- תוסף Chrome לבדו מוגבל — רוב הפיצ'רים החזקים דורשים את אפליקציית הדסקטופ
- לאפליקציית הדסקטופ יש עקומת למידה תלולה יותר עם בונה ה-workflow הוויזואלי שלה
- התוכנית החינמית מוגבלת; שימוש משמעותי דורש תוכנית בתשלום
- ההתקנה כבדה יותר בהשוואה לכלי Chrome טהורים — לא אידיאלי ל-scrape מהיר של 5 דקות
- אפליקציית הדסקטופ זמינה ל- Windows/Mac בלבד (לא רק בדפדפן)
תמחור
- תוכנית חינמית זמינה
- Basic: $39 לחודש
- Standard: כ- $83 לחודש (חודשי), כ- $75 לחודש (שנתי)
- Professional: כ- $299 לחודש (חודשי), כ- $208 לחודש (שנתי)
- Enterprise: מותאם אישית
מתאים במיוחד ל: צוותים שצריכים scraping בהיקף ארגוני עם IP rotation, טיפול אנטי-בוט ומשימות ענן חוזרות — ולא אכפת להם מאפליקציית דסקטופ.
7. Bardeen — scraper שמתחיל מאוטומציה
Bardeen (bardeen.ai) הוא פלטפורמת אוטומציית דפדפן שמשלבת web scraping עם workflow automation. משתמשים בונים "playbooks" שיכולים לסרוק נתונים ואז לשלוח אותם לאפליקציות אחרות — תחשבו על זה כעל "אם סקרפתי את זה, אז תדחוף את זה ל- CRM שלי".
נקודות חוזק מרכזיות ל- Shopify Scraping
- אוטומציית workflow מעבר ל-scraping: סורקים נתוני Shopify → מעשירים → שולחים ל- CRM או לגיליון אחד בתוך playbook אחד
- אינטגרציות עם יותר מ-100 אפליקציות (Google Sheets, Airtable, Notion, HubSpot, Slack ועוד)
- יכולות AI לשליפה ולסיווג נתונים
- רץ בדפדפן — אין צורך באפליקציית דסקטופ
- אוטומציות מבוססות זמן/תאריך לתזמון
איפה הוא חלש יותר
- בעיקר כלי אוטומציה, לא scraper ייעודי — יכולות הסקרייפינג פחות עמוקות מכלים מתמחים
- יצירת playbook יכולה לבלבל משתמשים שרק רוצים לחלץ רשימת מוצרים
- התוכנית החינמית מוגבלת ל-100 קרדיטים
- העשרת תתי-עמודים וטיפול ב- pagination פחות אינטואיטיביים מכלי scraping ייעודיים
- מוגזם אם אתם רק צריכים לסרוק נתונים בלי אוטומציה בהמשך
תמחור
- חינם: 100 קרדיטים
- Basic: $10 לחודש, 100 קרדיטים בחודש
- Premium: $50 לחודש, 1,000 קרדיטים בחודש (~$40 לחודש בתשלום שנתי)
- Enterprise: מותאם אישית
- מודל קרדיטים: קרדיט אחד לכל שורת scraper, 3 קרדיטים לכל שורת enrichment
מתאים במיוחד ל: צוותים שרוצים לסרוק נתוני Shopify ולדחוף אותם מיד לאפליקציות המשך (CRMs, גיליונות, Slack) בתוך workflow אוטומטי אחד.
8. Listly — ממיר רשימות לגיליון
Listly (listly.io) נבנה במיוחד כדי להמיר רשימות וטבלאות מעמודי אינטרנט לנתונים מוכנים לגיליון. לוחצים על התוסף בעמוד קולקציה של Shopify, ו- Listly מנסה לזהות את רשימת המוצרים ולייצא אותה כגיליון.
נקודות חוזק מרכזיות ל- Shopify Scraping
- ממשק פשוט מאוד — מיועד לחילוץ רשימות בלחיצה אחת
- טוב בזיהוי מבני רשימה חוזרים (כמו product grids)
- מייצא ישירות ל- Excel ול- Google Sheets
- תכונת Group scraping לעיבוד כמה כתובות בבת אחת
- תזמון זמין בתוכניות Business
איפה הוא חלש יותר
- מוגבל למה שהכלי מזהה אוטומטית בעמוד — בלי קונפיגורציית שדות מותאמת
- אין העשרת תתי-עמודים — מייצא רק נתונים ברמת עמוד הרשימה
- מתקשה עם תבניות Shopify לא סטנדרטיות או חנויות עם rendering כבד ב- JavaScript
- התוכנית החינמית מאוד מוגבלת (10 כתובות בחודש)
- פחות אפשרויות ייצוא לעומת המתחרים (בעיקר Excel ו- Sheets)
תמחור
- חינם: 10 כתובות בחודש, חילוץ בסיסי של עמוד אחד, הורדה ל- Excel, ייצוא ל- Google Sheets
- Light: $30 לחודש ($187.20 לשנה בתשלום שנתי)
- Business: $90 לחודש ($993.60 לשנה בתשלום שנתי) — מוסיף חילוץ מתקדם, group extraction, תזמון, auto-scroll/click, API בגרסת בטא
מתאים במיוחד ל: משתמשים שרוצים את הדרך הכי פשוטה שאפשר מעמוד קולקציה של Shopify אל גיליון — ולא צריכים נתוני מוצר עמוקים.
השוואה מלאה של כל 8 תוספי ה- Shopify Scraper ל- Chrome
הנה ההשוואה המלאה זה לצד זה. ניסיתי להיות ספציפי בכל תא ולא רק לסמן וי — כי "תומך ב- pagination" אומר דברים שונים מאוד בכל כלי.
| Tool | Ease of Setup | Data Fields | Subpage Enrichment | Pagination | Anti-Bot Handling | Export Formats | Scheduling | Free Tier / Pricing |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Very easy (AI-led, 1 click) | Strongest for non-technical users (the AI works out all relevant fields) | Yes — one-click enrichment | Yes (click + infinite scroll) | Cloud for public, browser for protected | Sheets, Airtable, Notion, CSV, JSON, Excel | Yes (plain-English scheduling) | Free 6 pages; paid from $15/mo |
| Instant Data Scraper | Extremely easy (zero config) | Good for listing-level data only | No | Yes (auto-detect next page) | Browser-only, no anti-bot story | CSV, XLSX | No | Free |
| Web Scraper | Medium-hard (manual sitemap) | Flexible if sitemap is built well | Yes, but manual via link selectors | Yes (with sitemap config) | Browser locally; proxy rotation on cloud plans | CSV locally; broader on cloud | Yes on cloud plans | Free extension; cloud from $50/mo |
| Data Miner | Medium (recipe-based) | Good if recipe exists or is built | Yes, but multi-step crawl setup | Yes (recipe config) | Mostly browser-side | CSV, Excel, Sheets, TSV | Automated crawls exist | Free 500 pages/mo; paid from $19.99/mo |
| Simplescraper | Easy-medium (selector-based) | Solid for lightweight extraction | Deep scraping exists, but not one-click | Yes (infinite scroll supported) | Proxy rotation and login-friendly | CSV, JSON, Sheets, Airtable, webhooks | Yes | Free 100 credits; paid tiers exist |
| Octoparse | Harder (desktop app) | Very strong when configured | Yes, via workflows or templates | Yes (AJAX, infinite scroll) | Strongest anti-bot (IP rotation, CAPTCHA) | CSV, Excel, JSON, HTML, XML, DBs, Sheets | Yes on Standard+ | Free; Basic $39/mo; cloud from ~$83/mo |
| Bardeen | Medium (playbook builder) | Good when tied to automation | Possible in workflow logic, not Shopify-first | Possible | Runs in browser, anti-bot not core | CSV, Sheets, Airtable, Notion | Yes via automations | Free 100 credits; Basic $10/mo; Premium $50/mo |
| Listly | Very easy (one-click list detect) | Best for visible list rows only | No | Limited to detected list structure | Minimal | Excel, Sheets, CSV/JSON API on Business | Yes on Business | Free 10 URLs/mo; Light $30/mo; Business $90/mo |
מסקנה מהירה לפי עדיפות
אם אתם צריכים את נתוני המוצר העמוקים ביותר מ- Shopify עם מינימום הגדרה, השילוב של AI + העשרת תתי-עמודים ב- Thunderbit הוא החזק ביותר. אם אתם צריכים ייצוא חינמי, מהיר ונטול הגדרה, Instant Data Scraper עובד טוב לדפים פשוטים. אם אתם רוצים שליטה מלאה ולא אכפת לכם לבנות מתכונים, Web Scraper או Octoparse יתנו לכם את העוצמה הזו. ואם המטרה האמיתית שלכם היא לסרוק → לאוטומט → לדחוף ל- CRM, Bardeen היא פלטפורמת ה-workflow שכדאי לבדוק.
סריקת עמוד הרשימה היא רק חצי עבודה: Workflow של העשרת תתי-עמודים
זה הסעיף שהייתי רוצה לראות בכל כתבה אחרת על Shopify scraper — כי זה הפער הגדול ביותר בתוכן המתחרים, וזה גם התסכול מספר 1 שאני שומע ממשתמשי ecommerce.
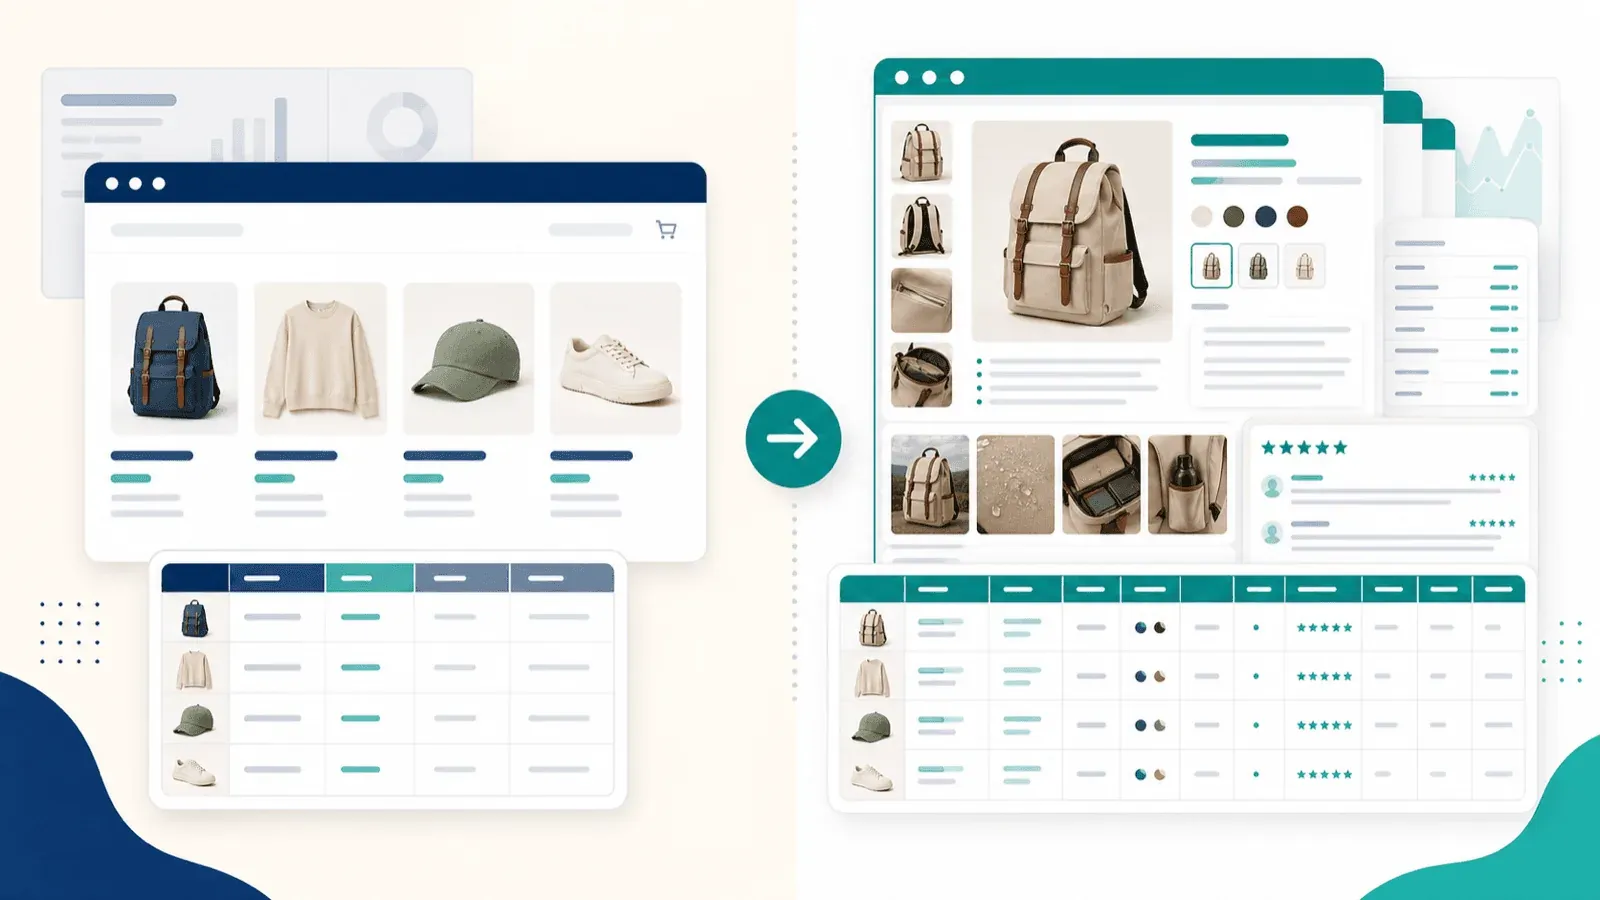
כשסורקים עמוד קולקציה של Shopify (עמוד הרשימה), מקבלים נתוני שכבה עליונה: כותרות, מחירים, תמונות ממוזערות, אולי תיאור מקוצר. אבל השדות שבאמת צריכים לניתוח מתחרים, ייבוא קטלוג או מחקר דרופשיפינג נמצאים בעמודי פרטי המוצר הבודדים.
מה מקבלים מעמוד הרשימה לעומת אחרי העשרה של תתי-עמודים
| Data Field | From Listing Page Only | After Subpage Enrichment |
|---|---|---|
| Product Title | ✅ | ✅ |
| Price | ✅ | ✅ |
| Thumbnail Image | ✅ | ✅ + all gallery images |
| Short Description | ⚠️ Truncated | ✅ Full HTML description |
| Variants (size, color) | ❌ | ✅ |
| SKU / Inventory | ❌ | ✅ |
| Reviews / Ratings | ❌ | ✅ |
זה הבדל עצום.
ייצוא רק מעמוד הרשימה נותן לכם גיליון שטחי. ייצוא שעבר העשרת תתי-עמודים נותן לכם מאגר נתונים שימושי למחקר תחרותי.
איך subpage scraping עובד ב- Thunderbit, שלב אחר שלב
- נכנסים לעמוד הקולקציה/הרשימה של חנות Shopify
- לוחצים על "One Click Extract" — Thunderbit קורא את העמוד ומבין את העמודות (כותרת, מחיר, תמונה, קישור וכו')
- לוחצים על "Scrape" כדי לחלץ את נתוני עמוד הרשימה
- לוחצים על "Scrape Subpages" — ה- AI מבקר בכל כתובת מוצר ומצרף ל- table המקורי את נתוני עמוד הפרטים (תיאור מלא, כל התמונות, וריאנטים, ביקורות)
- מייצאים את הטבלה המועשרת ל- Excel, Google Sheets, Airtable, Notion או CSV
כל התהליך לוקח כמה דקות עבור קולקציה טיפוסית, ובסוף מקבלים מאגר שהיה לוקח שעות להרכיב ידנית.
נסו את Thunderbit ל- Subpage Scraping עוברים מעבר לעמוד הקולקציה: Thunderbit מבקר בכל עמוד מוצר ומצרף את השדות העמוקים לטבלה שלכם. Get Started Free
אילו כלים אחרים תומכים בהעשרת תתי-עמודים?
- Web Scraper: כן, אבל דורש הגדרה ידנית של sitemap עם link selectors ו- child sitemaps — צפו ל- 15-20 דקות הגדרה לכל חנות
- Octoparse: כן, דרך workflow builder או תבניות — חזק אבל עם הגדרה כבדה יותר
- Data Miner: כן, דרך workflows של crawl בכמה שלבים — לא בלחיצה אחת
- Simplescraper: יש קונספט של deep scraping, אבל פחות מוכן-לשימוש
- Instant Data Scraper, Listly, Bardeen: אין תיעוד להעשרה בלחיצה אחת של תתי-עמודים ב- Shopify
ההבדל בין "אפשר טכנית לעקוב אחרי קישורים עם 20 דקות של הגדרה ידנית" לבין "העשרה בלחיצה אחת" הוא ההבדל בין כלי למהנדסי scraper לבין כלי לאנשי ecommerce.
כש- products.json של Shopify לא עובד — ולמה תוספי Chrome הם תוכנית הגיבוי שלכם
אם קראתם מדריכי Shopify scraping אחרים, כנראה ראיתם את טריק /products.json: פשוט מוסיפים /products.json לכתובת של חנות Shopify ומקבלים נתוני מוצר מובנים בפורמט JSON. זה endpoint אמיתי, וכשזה עובד — זה נוח.
איך products.json עובד
חנויות Shopify חושפות נקודת קצה API ב- JSON ב- /products.json שמחזירה נתוני מוצר מובנים. אפשר לעבור בין עמודים עם ?page=2&limit=250 (מקסימום 250 מוצרים לעמוד).
שדות שבדרך כלל מוחזרים כוללים: title, body_html, vendor, product_type, tags, published_at, variants (עם price, compare_at_price, sku, available), ו- images.
מה products.json מפספס
- אין נתוני ביקורות או ספירת דירוגים
- עיצוב תיאור מוגבל יותר לעומת עמודים מרונדרים
- custom metafields לרוב לא כלולים
- תמונות ברמת וריאנט יכולות להיות לא עקביות
- אין תוכן merchandising מרונדר, badges או social proof
מתי products.json נשבר
הרצתי בדיקות HTTP ישירות מול שמונה חנויות Shopify אמיתיות ב- 27 באפריל 2026. התוצאות היו די ברורות:
| Store | Result |
|---|---|
| kith.com | ✅ Worked — clean JSON |
| colourpop.com | ✅ Worked |
| allbirds.com | ✅ Worked |
| brooklinen.com | ✅ Worked |
| negativeunderwear.com | ✅ Worked |
| gymshark.com | ❌ Blocked — 403 HTML instead of JSON |
| mvmt.com | ⚠️ Partially disabled — 200 HTML page, not JSON |
| fashionnova.com | ❌ Disabled — 404 |
חמש מתוך שמונה החזירו JSON נקי. שלוש לא.
משתמשים בפורומים מדווחים על אותו דבר: "מסיבה כלשהי, חלק מחנויות Shopify בוחרות לא לחשוף products.json." חנויות מוגנות סיסמה, חנויות עם הגדרות API מותאמות, ודומיינים מוגני Cloudflare יכולים כולם לשבור את הדפוס.
חלופת Chrome Extension
כש- products.json לא זמין, scraper מבוסס Chrome שולף נתונים ישירות מהעמוד המרונדר (ה- DOM). זה הערך המרכזי של scrapers מבוססי דפדפן: הם רואים ושולפים את מה שאתם רואים בדפדפן, בלי קשר לזמינות API. לכן תוספי Chrome הם תוכנית B אמינה — ולעיתים קרובות גם תוכנית A כשצריך נתוני עמוד מרונדר כמו ביקורות, תוכן merchandising או גלריות תמונות מלאות.
הגנות אנטי-בוט: מה באמת קורה כשסורקים חנויות Shopify
רוב הכתבות על Shopify scraper מתנהגות כאילו כל חנות פתוחה לרווחה. זה לא המצב. לפי Store Leads, 99.2% מחנויות Shopify משתמשות בתשתית Cloudflare. זה לא אומר שכל חנות חוסמת scrapers באגרסיביות, אבל זה כן אומר שהתשתית לחסימה נמצאת כמעט בכל מקום.
בפועל, הסקאלה נראית כך:
קל יחסית לסרוק
- חנויות ציבוריות בלי הגנת Cloudflare אגרסיבית
- חנויות עם products.json פעיל
- חנויות עם תבניות Shopify סטנדרטיות (מבנה DOM עקבי)
קשה יותר לסרוק
- חנויות מוגנות Cloudflare (אתגרי CAPTCHA, Turnstiles)
- חנויות שדורשות התחברות או מוגנות בסיסמה
- Shopify Plus עם שכבות אבטחה מותאמות
- חנויות עם rate limiting אגרסיבי
איך כל כלי מתמודד עם אנטי-בוט
| Scenario | Best Approach | Tools That Handle It |
|---|---|---|
| Public store, no anti-bot | Cloud scraping (fast) | Thunderbit (cloud mode), Instant Data Scraper, most others |
| Cloudflare-protected store | Browser-based scraping (uses your session) | Thunderbit (browser mode), Web Scraper, Octoparse |
| Login-required / private store | Browser scraping with your logged-in session | Thunderbit (browser mode), Web Scraper, Simplescraper |
| products.json disabled | DOM-based extraction from rendered page | All Chrome extensions (this is their strength) |
שני המצבים של Thunderbit — cloud ו- browser scraping — רלוונטיים כאן מאוד. מצב cloud מהיר לסריקה בכמות גדולה של חנויות ציבוריות. מצב browser משתמש בסשן ה- Chrome האמיתי שלכם כשיש צורך להתמודד עם הגנות אנטי-בוט. הגמישות הזו הצילה אותי ב- gymshark.com, שם בקשות cloud נחסמו אבל מצב browser עבד מצוין.
Shopify Scraping מתוזמן: מעקב אחר מחירים ומלאי לאורך זמן
סריקה חד-פעמית היא שימושית. אבל צוותי ecommerce בדרך כלל צריכים מודיעין תחרותי מתמשך — לא רק תמונת מצב אחת. שינויי מחיר, תנודות מלאי, השקות מוצרים חדשים: כל אלה קורים כל הזמן. משתמש אחד בפורום ניסח זאת בפשטות: "יותר מועיל לראות את רמת המלאי הנוכחית שלהם וצילומי מצב של הירידה בה."
ובכל זאת כמעט אף כתבה מתחרה לא מזכירה סריקה מתוזמנת או חוזרת. זהו עיוורון ברור.
איך ניטור Shopify מתוזמן עובד
- מגדירים סריקה חוזרת של קולקציה או עמודי מוצר של מתחרה
- הנתונים נשלחים ל- Google Sheets (או Airtable) בכל הרצה, וכך נבנה time-series של מחירים ומלאי
- משתמשים בנתונים כדי לעקוב אחרי: ירידות/עליות מחיר, חוסרי מלאי, מוצרים חדשים, דפוסים עונתיים
הגדרת scraping מתוזמן עם Thunderbit
Thunderbit הופך את זה לפשוט באופן כמעט מגוחך.
מתארים את לוח הזמנים באנגלית פשוטה (למשל: "every Monday at 9am"), מזינים את כתובות חנויות Shopify, ולוחצים על "Schedule". Thunderbit מריץ את הסריקה אוטומטית ומייצא ליעד שבחרתם. בלי cron jobs, בלי קוד, בלי מתזמן חיצוני.
תמיכת תזמון בכל 8 הכלים
| Tool | Scheduling? |
|---|---|
| Thunderbit | Yes — plain-English scheduling |
| Instant Data Scraper | No |
| Web Scraper | Yes — on cloud plans |
| Data Miner | Automated crawls exist, but not the simplest scheduling |
| Simplescraper | Yes |
| Octoparse | Yes — on Standard and above |
| Bardeen | Yes — via time/date automations |
| Listly | Yes — on Business plan |
אם ניטור מתחרים שוטף הוא חלק מהעבודה שלכם, זה הבדל קריטי. רוב תוספי Chrome בחינם לא מציעים את זה בכלל.
איזה תוסף Chrome ל- Shopify Scraper מתאים למקרה השימוש שלכם?
במקום סיכום גנרי של "תבחרו את מה שאתם אוהבים", הנה מטריצת החלטה שממופה למקרי שימוש ספציפיים:
| Use Case | Best Recommendation | Why |
|---|---|---|
| Competitor pricing research | Thunderbit | Listing + subpage enrichment + scheduling = complete pricing workflow |
| Quick one-time export | Instant Data Scraper | Fastest free path when all you need is visible list data |
| Catalog import to your Shopify store | Thunderbit | Full subpage data + Shopify-import-friendly CSV/Excel export |
| Ongoing price/inventory monitoring | Thunderbit or Octoparse | Easiest no-code scheduling vs. strongest enterprise-style scheduling |
| Lead generation (store owner contacts) | Thunderbit | Built-in email/phone extractors + structured export |
| Complex multi-step automations | Bardeen | Scrape, enrich, and push into downstream apps in one workflow |
| Technical users who want full control | Web Scraper or Octoparse | Best manual control over selectors, flow, and extraction logic |
לסיכום
Shopify scraping ב- 2026 הוא לא שאלה של האם אפשר להשיג נתוני מוצר — אלא של כמה עמוק, כמה מהר וכמה חוזר על עצמו ה-workflow שלכם. רוב הכתבות בתחום נעצרות בעמוד הרשימה. הערך האמיתי נמצא בהעשרת תתי-עמודים, בניטור מתוזמן, ובהתמודדות עם ההפתעות האנטי-בוטיות שהחנויות האמיתיות זורקות עליכם.
אם אתם רוצים לראות איך זה נראה בפועל — מעמוד קולקציה ועד dataset מועשר לחלוטין בכמה קליקים — נסו את Thunderbit. ואם Thunderbit לא מתאים לכם באופן מושלם, Instant Data Scraper הוא נקודת פתיחה חינמית טובה למשימות פשוטות, בעוד Web Scraper ו- Octoparse הם בחירות חזקות למשתמשים טכניים שרוצים יותר שליטה.
סריקה נעימה — ושנתוני המוצר שלכם יהיו תמיד מלאים, מובנים ועשירים בוריאנטים.
נסו את Thunderbit ל- Shopify Scraping Get Started Free
שאלות נפוצות
1. האם מותר לסרוק נתונים מחנויות Shopify מבחינה חוקית?
נתוני מוצר ציבוריים בחנויות Shopify בדרך כלל נגישים לכל מי שנכנס לאתר. עם זאת, החוקיות תלויה בתחומי השיפוט שלכם, בתנאי השימוש של החנות, ובמה שאתם עושים עם הנתונים. סריקה של מחירים ציבוריים לצורך ניתוח תחרותי היא פרקטיקה נפוצה; העתקה מלאה של תוכן לצורך פרסום מחדש כרוכה ביותר סיכון. זו לא ייעוץ משפטי — כדאי להתייעץ עם איש מקצוע בהתאם למקרה שלכם.
2. האם אפשר לסרוק חנויות Shopify שדורשות התחברות או סיסמה?
כן, אבל תצטרכו scraper מבוסס דפדפן שמשתמש בסשן ה- Chrome המחובר שלכם. Scrapers בענן בדרך כלל לא יכולים לגשת לעמודים מוגני התחברות. מצב browser של Thunderbit, Web Scraper (מקומי), ו-workflows של login ב- Simplescraper תומכים במצב הזה.
3. כמה מוצרים אפשר לסרוק מחנות Shopify בבת אחת?
זה תלוי בכלי ובתוכנית. נקודת הקצה products.json של Shopify מחלקת לעמודים של 250 מוצרים לעמוד. מצב cloud של Thunderbit מעבד עד 50 עמודים בכל פעם. תוכניות חינמיות ברוב הכלים מגבילות עמודים, שורות או קרדיטים — לכן כדאי לבדוק את מגבלות התוכנית לפני שמתחילים משימה גדולה.
4. מה ההבדל בין cloud scraping ל- browser scraping ב- Shopify?
Cloud scraping רץ על שרתים מרוחקים — הוא מהיר יותר וטוב יותר לחנויות ציבוריות בלי הגנת אנטי-בוט. Browser scraping משתמש בסשן ה- Chrome המקומי שלכם, ולכן הוא יכול להתמודד עם חנויות מוגנות Cloudflare, חנויות שדורשות התחברות, או חנויות רגישות לאזור. Thunderbit מציע את שני המצבים, והבחירה בדרך כלל תלויה בשאלה האם החנות חוסמת בקשות מרוחקות.
5. האם אפשר לייצא נתוני Shopify שנסרקו ישירות ל- Google Sheets או Airtable?
כן, אבל לא כל הכלים תומכים בזה. Thunderbit מייצא ל- Google Sheets, Airtable, Notion, Excel, CSV ו- JSON — כולם בחינם. Data Miner ו- Listly תומכים ב- Google Sheets. Simplescraper תומך ב- Sheets ו- Airtable. Octoparse תומך ב- Google Sheets בתוכניות פרימיום. Bardeen משתלב עם Sheets, Airtable ו- Notion. Instant Data Scraper מייצא רק ל- CSV ו- XLSX בלי אינטגרציה ישירה ל- Sheets.
לקריאה נוספת




