
האינטרנט צומח מהר יותר מההתמכרות שלי לקפה – ותאמינו לי, זה אומר משהו. בשנת 2026, מיצוי נתוני אינטרנט הוא כבר לא רק מיומנות נישתית לחנוני נתונים; הוא עמוד השדרה של בינה עסקית, אימון AI ואוטומציה. בין אם אתם עוקבים אחר מגמות שוק, מזינים את ה-LLM (מודל שפה גדול) הבא שלכם, או סתם מנסים לעמוד בקצב התמחור של המתחרים שלכם, הצורך בנתוני אינטרנט מובנים בזמן אמת מעולם לא היה גבוה יותר. ובלב הבהלה לזהב של הנתונים הזו? פייתון. עם המערכת האקולוגית העצומה והתחביר הנגיש שלה, פייתון נשארת השפה המועדפת ל-Web Scraping, המניעה הכל, החל מסקריפטים חד-פעמיים מהירים ועד לזחלנים בקנה מידה תעשייתי.
אבל הנה הקאץ': בחירת חבילות ה-Web Scraping הנכונות של פייתון יכולה להצליח או להרוס את הפרויקט שלכם. ראיתי צוותים מבזבזים ימים בלחימה בחומות אנטי-בוטים עם הכלי הלא נכון, או שורפים שעות בניתוח HTML מבולגן כאשר ספרייה חכמה יותר הייתה עושה את העבודה תוך דקות. אז, כמי שבילה שנים ב-SaaS, אוטומציה ו-AI (ובנה את Thunderbit כדי להקל על ה-Scraping לכולם), ריכזתי את 12 חבילות ה-Web Scraping הטובות ביותר של פייתון לשנת 2026 – כל אחת עם החוזקות, המוזרויות ומקרי השימוש האידיאליים שלה. בואו נצלול פנימה ונמצא את ההתאמה המושלמת להרפתקת הנתונים הבאה שלכם.
למה חבילות ה-Web Scraping הנכונות של פייתון כל כך חשובות
גרדו נתונים מכל אתר באמצעות AI Get Started Free
בואו נהיה כנים: לא כל פרויקטי ה-Web Scraping נוצרו שווים. לפעמים אתם רק צריכים לתפוס כמה מחירי מוצרים מדף סטטי. בפעמים אחרות, אתם מתמודדים עם אתר עמוס ב-JavaScript שהוא עקשן יותר מחתול בזמן אמבטיה. החבילה הנכונה יכולה לחסוך לכם שעות (או ימים), להפחית שגיאות ולעזור לכם להתחמק ממלכודות נפוצות כמו חסימות אנטי-בוטים או HTML שבור.
הפופולריות של פייתון ב-Web Scraping אינה רק הייפ. ספריות כמו requests ו-urllib3 רואות למעלה מ-מיליארד הורדות בחודש, וכמעט כל כלי Scraping מרכזי הוא מבוסס פייתון. אבל עם כוח גדול באה אחריות גדולה: בחרו את הכלי הלא נכון, ואתם עלולים למצוא את עצמכם תקועים בפרויקט איטי יותר מאינטרנט בחיוג. בחרו בחוכמה, ואתם תשחו בנתונים נקיים ומובנים לפני שהקפה שלכם יתקרר.
איך בחרנו את חבילות ה-Web Scraping הטובות ביותר של פייתון
לא סתם זרקתי חיצים על תרשים PyPI. הנה איך הערכתי כל חבילה:
- ביצועים ומקביליות: האם היא יכולה לאחזר מאות (או אלפים) של דפים במהירות?
- קלות שימוש: האם היא ידידותית למתחילים, או שהיא דורשת תואר דוקטור במדעי המחשב?
- כוח ניתוח HTML: האם היא מטפלת בסימון שבור, תומכת בבוררי XPath/CSS, והופכת את מיצוי הנתונים ללא כאבים?
- תמיכה בתוכן דינמי: האם היא יכולה להתמודד עם אתרים עמוסים ב-JavaScript, או שהיא מיועדת אך ורק לדפים סטטיים?
- קהילה ותיעוד: האם יש בסיס משתמשים משגשג ותיעוד מוצק, או שתהיו תקועים בפורום Stack Overflow?
- מקרה שימוש מיטבי: האם היא מיועדת לסקריפטים מהירים, לזחלנים בקנה מידה גדול, או למשהו שביניהם?
לקחתי בחשבון גם משוב ממפתחים בעולם האמיתי, מדדי ביצועים עדכניים, והחוויות שלי (שלפעמים היו כואבות) בתחום. עכשיו, בואו נפגוש את המתמודדים.
1. Thunderbit
 Thunderbit אינה ספריית פייתון טיפוסית – זוהי הרחבת Chrome מבוססת AI שמשנה את כללי המשחק עבור Web Scraping, במיוחד עבור מפתחי פייתון שרוצים מהירות, דיוק ומגע של קסם AI. מה מייחד את Thunderbit? היא מאפשרת לכם להשתמש בהוראות בשפה טבעית כדי לומר ל-AI אילו נתונים אתם רוצים, ואז היא מטפלת בהכל: הצעות שדות, ניווט בדפי משנה, חלוקה לעמודים, ואפילו ייצוא ל-Excel, Google Sheets, Notion או Airtable.
Thunderbit היא מצילת חיים עבור Scraping של נתונים מורכבים ולא מובנים – חשבו על ספריות מבולגנות, רשימות מוצרים, או אתרים שבהם ה-HTML הוא יותר "אמנות מופשטת" מאשר "מסמך מובנה". תכונת AI Suggest Fields שלה קוראת את הדף ומציעה את העמודות הטובות ביותר, בעוד שSubpage Scraping מאפשרת לכם להעשיר את מערך הנתונים שלכם על ידי ביקור אוטומטי בדפי פרטים מקושרים. ואם נמאס לכם מכאבי ראש של אנטי-בוטים, אפשרויות ה-Scraping מבוססות הדפדפן והענן של Thunderbit מכסות אתכם.
מפתחי פייתון אוהבים את Thunderbit עבור אב טיפוס מהיר, יצירת לידים ומחקר שוק. אתם יכולים להשתמש בפלט שלה ישירות בצינור הנתונים של פייתון שלכם, או אפילו להפוך תהליכי Scraping לאוטומטיים באמצעות ה-API שלה. זו אינה ספריית קוד מסורתית, אבל היא הופכת במהירות למועדפת על כל מי שרוצה להשקיע פחות זמן בקידוד ויותר זמן בניתוח נתונים.
תכונות עיקריות:
- הצעת שדות ומיצוי נתונים מבוססי AI
- מטפלת בדפי משנה, חלוקה לעמודים, ואפילו קובצי PDF/תמונות
- ייצוא ל-CSV, Excel, Google Sheets, Notion, Airtable
- אין צורך בקידוד – מושלם הן למשתמשים לא טכניים והן למקצועני פייתון שרוצים לנוע במהירות
- שכבה חינמית זמינה; תוכניות בתשלום מתרחבות בהתאם לצרכים שלכם
הטוב ביותר עבור: יצירת לידים, מחקר שוק, אב טיפוס מהיר, ו-Scraping של נתוני אינטרנט מורכבים או מבולגנים.
נסה את Thunderbit AI Web Scraper בחינם
2. Beautiful Soup
 Beautiful Soup היא ה-OG של ניתוח HTML בפייתון. אם אתם רק מתחילים, או צריכים לחלץ נתונים מדפי אינטרנט סטטיים, זו החברה הכי טובה שלכם. Beautiful Soup מצטיינת בניווט וניתוח HTML לא מובנה היטב ("מרק תגים"), מה שהופך אותה למצילת חיים עבור Scraping של אתרים שאינם פועלים לפי הכללים.
ה-API ידידותי למתחילים – חשבו על .find(), .select() ו-.text – והוא משתלב בצורה מושלמת עם requests לאחזור דפי אינטרנט. מתחת למכסה המנוע, אתם יכולים לבחור מנתחים שונים (כמו lxml למהירות או html5lib לתאימות מרבית). התיעוד מעולה, והקהילה ענקית.
תכונות עיקריות:
- API אינטואיטיבי, פייתון-י לניווט HTML/XML
- מטפל בסימון שבור או לא עקבי בחן
- עובד עם מספר מנתחים למהירות או תאימות
- קהילה ענקית ושפע של מדריכים
הטוב ביותר עבור: סקריפטים מהירים, Scraping של דפים סטטיים, ומתחילים שרוצים עקומת למידה עדינה.
3. Scrapy
 Scrapy היא האלופה הבלתי מעורערת של זחילה אוטומטית בקנה מידה גדול. אם אתם צריכים לגרד מאות או אלפי דפים, לנהל צינורות נתונים, או לתזמן משימות חוזרות, Scrapy היא המסגרת שרוב הצוותים בוחרים בה. היא עדיין פועלת על Twisted reactor מתחת למכסה המנוע, אך החל מגרסה 2.14, חלק גדול מהמנגנונים האסינכרוניים הפנימיים שלה נכתבו מחדש כ-coroutines מקוריים של
asyncio, וכעת יש נקודות כניסה AsyncCrawlerProcess / AsyncCrawlerRunner שמשתלבות היטב עם שאר המערכת האקולוגית האסינכרונית המודרנית של פייתון. היא מהירה, תומכת בזחילה מקבילית, צינורות פריטים לניקוי נתונים, ומייצאת ל-JSON, CSV או מסדי נתונים.
Scrapy ניתנת להרחבה, עם תוספים עבור פרוקסי, שמירה במטמון, ואפילו רינדור JavaScript מוגבל (באמצעות שילוב Splash או Selenium). עקומת הלמידה תלולה יותר מ-Beautiful Soup, אבל אם אתם רציניים לגבי נתוני אינטרנט בקנה מידה, Scrapy היא מה שאתם גדלים אליו.
תכונות עיקריות:
- זחילה אסינכרונית באמצעות Twisted reactor + coroutines מקוריים של
asyncio(Scrapy 2.14+, Python 3.10+) - צינורות מובנים לניקוי ואחסון נתונים
- ייצוא למספר פורמטים (JSON, CSV, DB)
- קהילה גדולה ופעילה ומערכת אקולוגית של תוספים
הטוב ביותר עבור: פרויקטי Scraping בקנה מידה גדול וחוזרים, צינורות נתונים, וכל מי שזקוק למהירות ואמינות.
4. Selenium
 Selenium הוא הכלי המועדף ל-Scraping של אתרים עמוסים ב-JavaScript או אינטראקטיביים. הוא מבצע אוטומציה של דפדפנים אמיתיים (Chrome, Firefox וכו'), ומאפשר לכם לדמות פעולות משתמש כמו לחיצות, גלילה ושליחת טפסים. אם הנתונים שאתם צריכים מופיעים רק לאחר הפעלת JavaScript, Selenium יכולה להשיג אותם – לא משנה כמה עקשן האתר.
הפשרה? Selenium איטית וצורכת משאבים. אתם מריצים דפדפן מלא עבור כל Scraping, אז אל תצפו לעבד אלפי דפים בדקה. אבל עבור תרחישים של "שום כלי אחר לא יכול לעשות את זה", Selenium היא מצילת חיים.
תכונות עיוריות:
- אוטומציה מלאה של דפדפן (תומך ב-Chrome, Firefox, Edge וכו')
- מטפל בתוכן המרונדר ב-JavaScript וברכיבים אינטראקטיביים
- תומך במצב Headless ל-Scraping מהיר יותר וללא ממשק משתמש
- קהילה גדולה ותיעוד נרחב
הטוב ביותר עבור: Scraping של אתרים דינמיים ועמוסים ב-JavaScript, אוטומציה של תהליכי התחברות, וטיפול ב-CAPTCHAs או אינטראקציות משתמש מורכבות.
קרא עוד על החוזקות והחולשות של Selenium
5. PyQuery
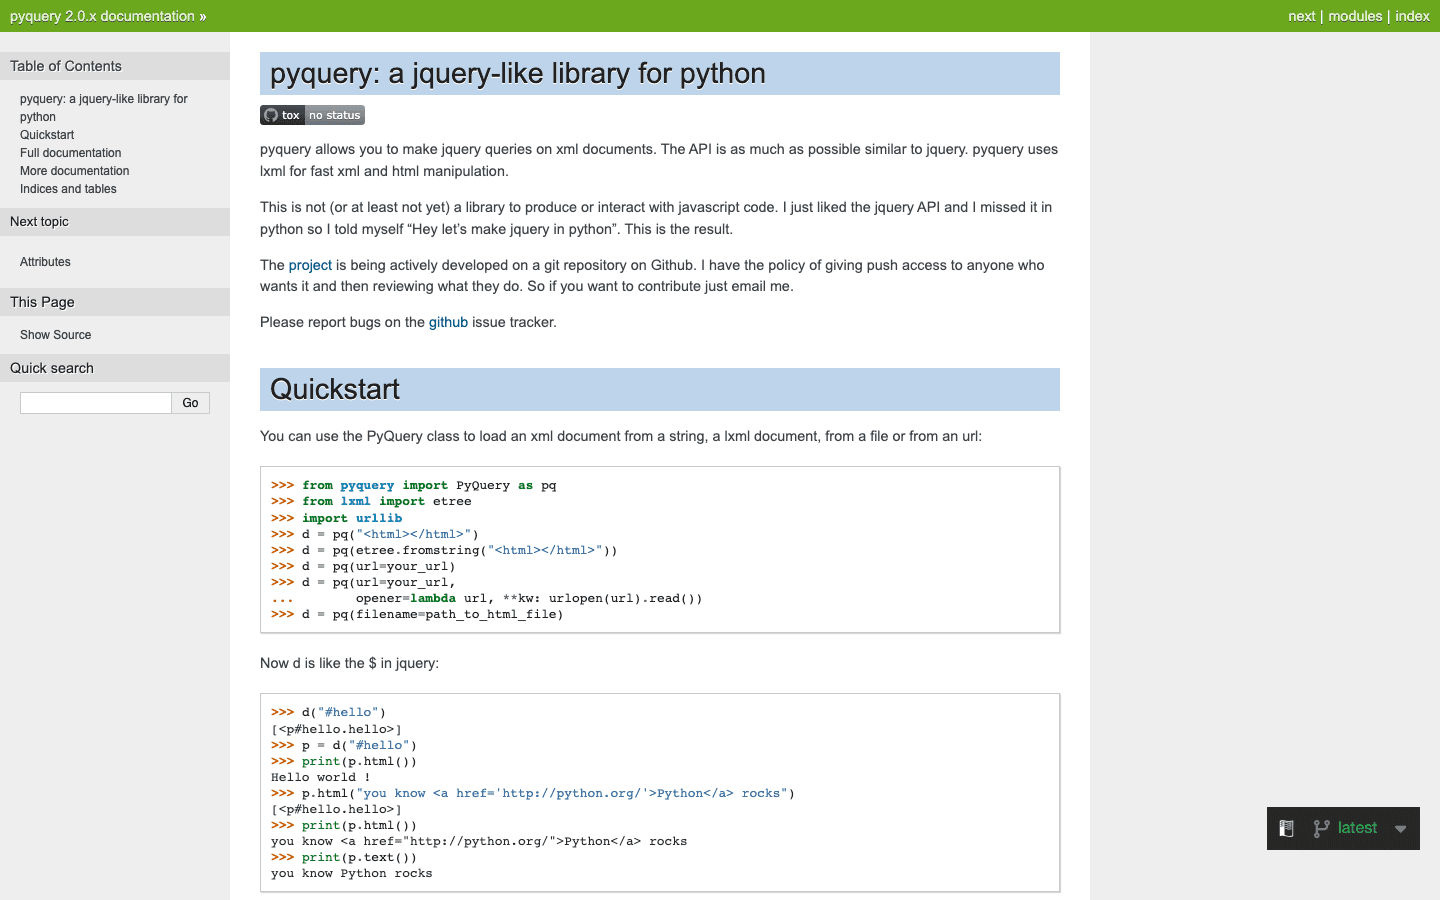 PyQuery מביאה תחביר בסגנון jQuery לפייתון, מה שהופך את ניתוח ה-HTML למוכר לכל מי שעבד עם jQuery ב-JavaScript. היא עוטפת את מנתח ה-
lxml המהיר ומאפשרת לכם להשתמש בבוררי CSS כמו $('div.classname') כדי למצוא אלמנטים.
PyQuery מצוינת עבור אב טיפוס מהיר ועבור מפתחים שרוצים קוד תמציתי וקריא. היא מהירה יותר מ-Beautiful Soup עבור שאילתות מורכבות ומשתלבת בקלות עם כלים אסינכרוניים או Selenium עבור תהליכי עבודה מתקדמים יותר.
תכונות עיקריות:
- בוררים ותחביר דמויי jQuery בפייתון
- ניתוח מהיר עם קצה אחורי של lxml
- מצוין למפתחים העוברים מ-JavaScript
- תומך בשרשור ובשאילתות תמציתיות
הטוב ביותר עבור: אב טיפוס, חובבי jQuery, וכל מי שרוצה לכתוב פחות קוד לניתוח HTML.
מדריך PyQuery והשוואה
6. LXML
 LXML היא מפלצת המהירות של ניתוח HTML ו-XML בפייתון. היא בנויה על גבי ספריות ה-C
libxml2 ו-libxslt, והיא ידועה בביצועיה ובתמיכתה החזקה בבוררי XPath ו-CSS. אם אתם מתמודדים עם מסמכים גדולים או צריכים להריץ שאילתות מורכבות, lxml היא הבחירה הטובה ביותר שלכם.
ניתן להשתמש בה ישירות או כקצה אחורי עבור Beautiful Soup או PyQuery. ה-API קצת יותר מתקדם, אבל המהירות והגמישות שוות את זה עבור עבודות גדולות.
תכונות עיקריות:
- הניתוח המהיר ביותר הזמין בפייתון
- תמיכה מלאה בבוררי XPath ו-CSS
- מטפל במסמכים גדולים ומורכבים ביעילות
- ניתן להשתמש בה באופן עצמאי או כמנתח עבור ספריות אחרות
הטוב ביותר עבור: ניתוח בעל ביצועים גבוהים, Scraping בקנה מידה גדול, ופרויקטים הדורשים שאילתות מתקדמות.
7. Requests
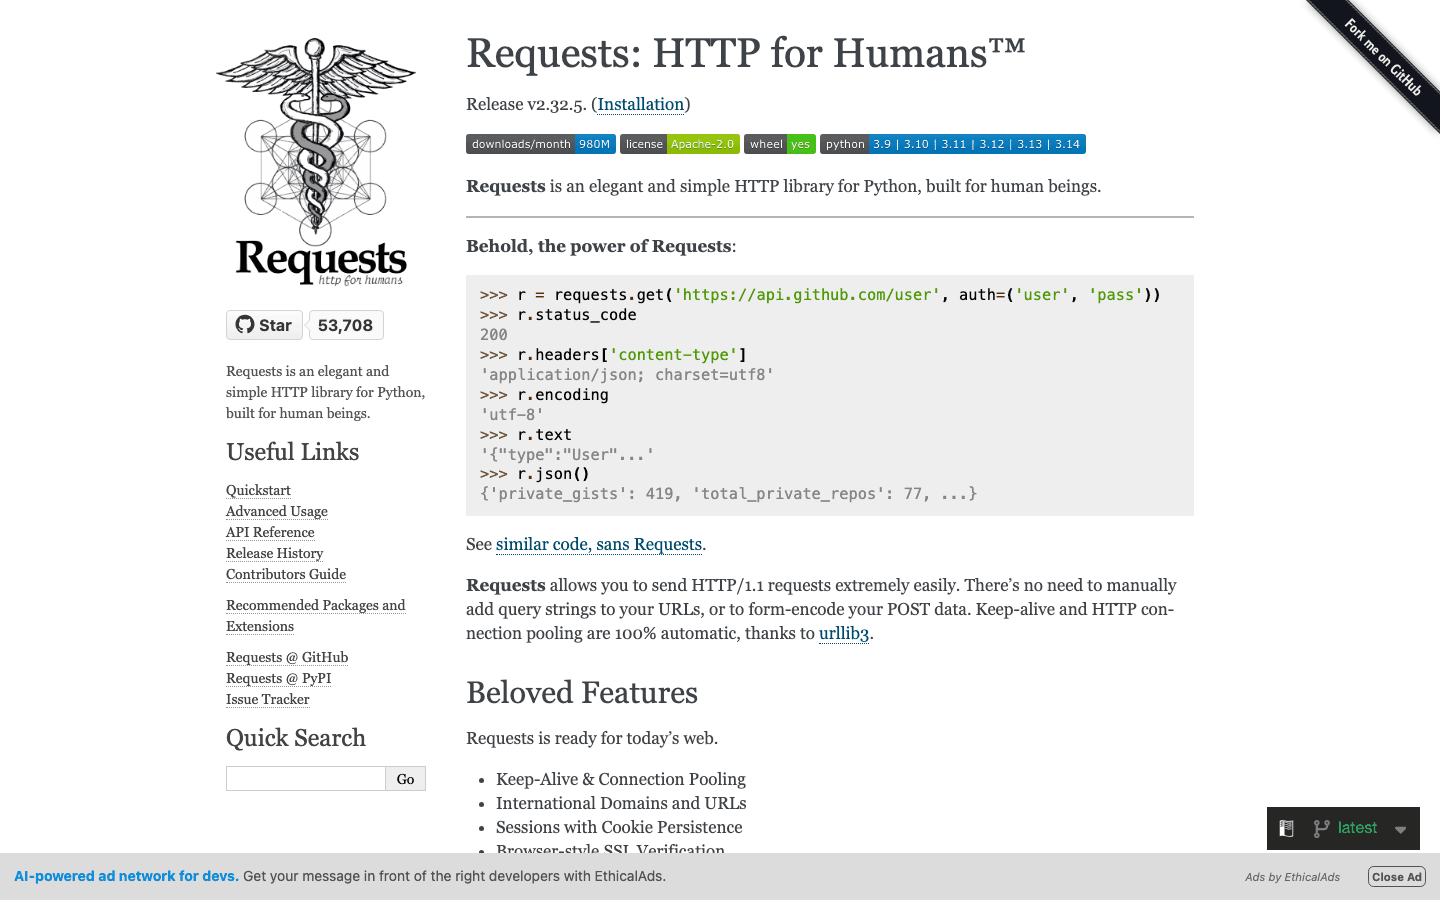 Requests היא הסטנדרט בפועל לביצוע בקשות HTTP בפייתון. ה-API הנקי והאינטואיטיבי שלה הופך אחזור דפי אינטרנט לקל כמו
requests.get(url). היא מטפלת בעוגיות, סשנים ואפילו פענוח JSON מחוץ לקופסה.
בעוד ש-Requests היא סינכרונית (כל בקשה ממתינה להשלמה), היא מושלמת עבור סקריפטים מהירים ו-Scraping בקנה מידה קטן. שלבו אותה עם Beautiful Soup או lxml עבור זרימת עבודה קלאסית של Scraping.
תכונות עיקריות:
- API פשוט, פייתון-י לבקשות HTTP
- מטפל בעוגיות, סשנים והפניות מחדש
- משתלב בצורה חלקה עם ספריות ניתוח
- קהילה ותיעוד ענקיים
הטוב ביותר עבור: סקריפטים פשוטים, Scraping של דפים סטטיים, ומתחילים שרוצים להתחיל במהירות.
ראה מדוע Requests כל כך פופולרית
8. MechanicalSoup
 MechanicalSoup היא ספרייה קלת משקל שמבצעת אוטומציה של אינטראקציות דפדפן פשוטות – כמו מילוי טפסים או ניווט בתהליכי התחברות מרובי שלבים – מבלי להפעיל דפדפן מלא. היא עוטפת את
requests ו-Beautiful Soup, מה שהופך אותה למהירה וקלה בהרבה מ-Selenium עבור אתרים שאינם מסתמכים במידה רבה על JavaScript.
אם אתם צריכים להתחבר, לשלוח טפסים, או ללחוץ על כמה דפים (והאתר אינו דינמי מדי), MechanicalSoup היא פשרה מצוינת.
תכונות עיקריות:
- מבצעת אוטומציה של מילוי טפסים וניווט
- בנויה על גבי Requests ו-Beautiful Soup
- קלת משקל ומהירה (ללא תקורה של דפדפן)
- קלה לשימוש עבור אינטראקטיביות מתונה
הטוב ביותר עבור: אתרים הדורשים התחברות או שליחת טפסים, משימות אוטומציה פשוטות, וכל מי שרוצה להימנע מהתקורה של Selenium.
9. Aiohttp
 Aiohttp היא תחנת הכוח האסינכרונית לבקשות אינטרנט מהירות במיוחד ומקביליות. אם אתם צריכים לגרד מאות דפים במהירות, aiohttp מאפשרת לכם לשלוח בקשות במקביל, ובכך להפחית באופן דרמטי את זמן הריצה הכולל. במדד ביצועים אחד, Scraping של 50 דפים ארך 3 שניות בלבד עם aiohttp, לעומת 16 שניות באמצעות בקשות סינכרוניות (ראה את הבדל הביצועים).
Aiohttp דורשת כתיבת קוד async def ושימוש ב-await, אך רווחי המהירות שווים את זה עבור עבודות בקנה מידה גדול.
תכונות עיקריות:
- מסגרת לקוח/שרת HTTP אסינכרונית
- תומך בסשנים, עוגיות ו-HTTP/2
- האצה מסיבית עבור בקשות מקביליות
- משתלב עם ספריות ניתוח אסינכרוניות
הטוב ביותר עבור: Scraping מהיר במיוחד ובקנה מידה גדול, איסוף API, וכל מי שמרגיש בנוח עם תכנות אסינכרוני.
10. Twisted
 Twisted הוא מנוע הרשת מונחה האירועים שמניע את Scrapy. למרות שזו אינה ספריית Scraping כשלעצמה, משתמשים מתקדמים יכולים להשתמש ב-Twisted ישירות כדי לבנות זחלנים מותאמים אישית, לטפל בפרוטוקולים שאינם HTTP, או ליישם עכבישים היפר-מקביליים.
Twisted חזקה אך מגיעה עם עקומת למידה תלולה. היא הטובה ביותר עבור תרחישים מותאמים אישית במיוחד או בעת בניית מסגרות מאפס.
תכונות עיקריות:
- רשת מונחית אירועים עבור HTTP, WebSockets, SSH ועוד
- תומך ב-SSL, מקביליות ופרוטוקולים מותאמים אישית
- מניע את המנוע האסינכרוני של Scrapy
- גמיש במיוחד למקרי שימוש מתקדמים
הטוב ביותר עבור: פרוטוקולים מותאמים אישית, בניית מסגרות Scraping, ומשתמשים מתקדמים שזקוקים לשליטה מרבית.
11. Grab
 Grab היא ערכת כלים מקיפה ל-Scraping המשלבת בקשות HTTP, ניתוח, אוטומציה, סיבוב פרוקסי וטיפול ב-CAPTCHA. היא דומה ברוחה ל-Scrapy אך שואפת להיות קלה יותר ללמידה ולשימוש, עם תמיכה מובנית בפרוקסי, שמירה במטמון ועכבישים אסינכרוניים.
התכונה הבולטת של Grab היא מערכת ה-Grab:Spider שלה, שיכולה להריץ אלפי בקשות במקביל באמצעות multicurl. אם אתם זקוקים לפתרון מקיף עם פחות הגדרה מ-Scrapy, Grab שווה בדיקה.
תכונות עיקריות:
- תמיכה מובנית בפרוקסי, סיבוב סוכן משתמש ושמירה במטמון
- מערכת עכבישים אסינכרונית למקביליות גבוהה
- ניתוח XPath וארכיטקטורה מודולרית
- בשימוש בייצור עבור Scraping בקנה מידה גדול
הטוב ביותר עבור: פרויקטי Scraping מקיפים, משימות עמוסות פרוקסי, ומשתמשים שרוצים כוח ללא המורכבות של Scrapy.
12. Urllib3
 Urllib3 הוא מנוע ה-HTTP ברמה נמוכה שמניע לקוחות פייתון רבים, כולל Requests. הוא מציע איגום חיבורים, בטיחות תהליכים, ניסיונות חוזרים ושליטה מדויקת על חיבורי HTTP. בעוד שרוב המפתחים משתמשים בו בעקיפין, urllib3 הוא הבחירה שלכם כאשר אתם זקוקים לביצועים מרביים או בונים ספריות ברמה גבוהה יותר.
הוא אינו ידידותי למתחילים כמו Requests, אך הוא נבדק בקרב קרבות ואמין ביותר.
תכונות עיקריות:
- איגום חיבורים ובטיחות תהליכים
- שליטה מדויקת על חיבורי HTTP
- משמש כבסיס לספריות רבות אחרות
- ביצועים גבוהים עבור בקשות חוזרות
הטוב ביותר עבור: לקוחות HTTP מותאמים אישית, זחלנים מרובי תהליכים, ומפתחים הבונים על גבי ערימת ה-HTTP של פייתון.
ראה את תפקידו של urllib3 ב-Scraping
טבלת השוואה: חבילות Web Scraping של פייתון במבט חטוף
| חבילה | קלות שימוש | ביצועים | תוכן דינמי | כוח ניתוח | קהילה/תיעוד | הטוב ביותר עבור |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (ממשק משתמש גרפי/AI) | מהיר (ענן/מקומי) | כן (באמצעות AI) | שדות אוטומטיים, דף משנה | צומח (מגמת AI) | יצירת לידים, מחקר שוק, משתמשים ללא קוד |
| Beautiful Soup | ★★★★★ (קל) | בינוני | לא | HTML/XML, סלחני | ענק | דפים סטטיים, מתחילים |
| Scrapy | ★★☆☆☆ (תלול) | ★★★★★ (גבוה מאוד) | תוספים בלבד | CSS/XPath, צינורות | גדול, פעיל | Scraping בקנה מידה גדול וחוזר |
| Selenium | ★★☆☆☆ (בינוני) | ★☆☆☆☆ (איטי) | כן (מלא) | DOM מלא, JS | בוגר | אתרים עמוסים ב-JS, אינטראקטיביים |
| PyQuery | ★★★★☆ (jQuery) | מהיר (lxml) | לא* | בוררי jQuery | מתון | אב טיפוס, מפתחי jQuery |
| LXML | ★★★☆☆ (מתקדם) | ★★★★★ (המהיר ביותר) | לא | XPath/CSS, XML | מתון | מסמכים גדולים, שאילתות מתקדמות |
| Requests | ★★★★★ (קל מאוד) | ★★☆☆☆ (סינכרוני) | לא | HTTP, JSON | ענקית | סקריפטים פשוטים, דפים סטטיים |
| MechanicalSoup | ★★★★☆ (קל) | ★★☆☆☆ (סינכרוני) | לא | טפסים, ניווט | קטן | תהליכי התחברות, אוטומציה של טפסים |
| Aiohttp | ★★☆☆☆ (אסינכרוני) | ★★★★★ (מקבילי) | לא | HTTP אסינכרוני | גדול (אסינכרוני) | Scraping מהיר במיוחד, מקבילי |
| Twisted | ★☆☆☆☆ (מורכב) | ★★★★★ (מותאם אישית) | לא | רשת, פרוטוקולים | נישה | מסגרות מותאמות אישית, משתמשים מתקדמים |
| Grab | ★★★☆☆ (מודולרי) | ★★★★☆ (אסינכרוני) | לא | פרוקסי, XPath | קטן | הכל באחד, עמוס פרוקסי/קאפצ'ה |
| Urllib3 | ★★★★☆ (רמה נמוכה) | ★★★★☆ (מאוגם) | לא | HTTP, איגום | ענקית | לקוחות מותאמים אישית, זחלנים מרובי תהליכים |
*ניתן לשלב PyQuery עם Selenium עבור אתרים דינמיים.
איך לבחור את חבילת ה-Web Scraping הנכונה של פייתון לצרכים שלכם
מהו Data Scraping וכיצד לבצע אותו בשנת 2026 Get Started Free
אז, איזו חבילה כדאי לכם לבחור? הנה דף הרמאות שלי:
- דפים סטטיים, עבודות קטנות, או שאתם חדשים ב-Scraping: התחילו עם Requests + Beautiful Soup.
- Scraping בקנה מידה גדול, חוזר, או בייצור: Scrapy או Grab (לצרכים מקיפים).
- אתרים עמוסים ב-JavaScript או אינטראקטיביים: Selenium (או Thunderbit אם אתם רוצים Scraping מבוסס AI וללא קוד).
- Scraping מהיר במיוחד ומקבילי: Aiohttp (אם אתם מרגישים בנוח עם אסינכרוני).
- אוטומציה של טפסים או תהליכי התחברות: MechanicalSoup (לאתרים פשוטים), Selenium (ל-JS מורכב).
- ניתוח מתקדם או מסמכים ענקיים: LXML או PyQuery.
- עבודת רשת או פרוטוקול מותאמת אישית: Twisted.
- אב טיפוס מהיר, יצירת לידים, או נתונים מבולגנים/לא מובנים: Thunderbit.
ואל תפחדו לשלב – זרימות עבודה רבות משלבות כלים אלה ליעילות מרבית. לדוגמה, אתם יכולים להשתמש ב-Selenium כדי לרנדר דף, ואז להעביר את ה-HTML ל-Beautiful Soup או PyQuery לניתוח.
מסקנה: שפרו את ה-Web Scraping שלכם עם כלי הפייתון הנכונים
Web Scraping בשנת 2026 חזק יותר – ונחוץ יותר – מאי פעם. עם חבילות ה-Web Scraping הנכונות של פייתון, אתם יכולים להפוך את הכאוס של האינטרנט לנתונים נקיים וניתנים לפעולה עבור העסק, המחקר או הרעיון הגדול הבא שלכם. בין אם אתם מפתחים מנוסים או רק טובלים את בהונותיכם בבריכת הנתונים, יש כלי ברשימה זו שמתאים לצרכים שלכם.
אם אתם רוצים לראות איך נראה Scraping מבוסס AI וללא קוד, נסו את Thunderbit. ואם אתם רעבים לעוד טיפים, צלילות עמוקות ומדריכים, בדקו את הבלוג של Thunderbit לקבלת העדכונים האחרונים ב-Web Scraping, אוטומציה וזרימות עבודה מונעות נתונים.
נסה את Thunderbit AI Web Scraper
Scraping שמח – ושהבוררים שלכם תמיד יתאימו, שהפרוקסי שלכם לעולם לא ייכשלו, ושהנתונים שלכם יהיו נקיים כמו הקוד שלכם.
שאלות נפוצות
1. מהי חבילת ה-Web Scraping הטובה ביותר של פייתון למתחילים? עבור רוב המתחילים, השילוב של Requests ו-Beautiful Soup הוא הדרך הקלה ביותר להתחיל. לשניהם יש ממשקי API אינטואיטיביים, שפע של מדריכים, והם מטפלים ברוב משימות ה-Scraping של דפים סטטיים.
2. כיצד אני מגרד אתרי אינטרנט עמוסים ב-JavaScript עם פייתון? השתמשו ב-Selenium כדי לבצע אוטומציה של דפדפן אמיתי, או נסו את Thunderbit עבור Scraping מבוסס AI וללא קוד שיכול לטפל בתוכן דינמי. לצרכים בקנה מידה גדול, ניתן לשלב את Scrapy עם Splash או Selenium.
3. איזו חבילה הטובה ביותר עבור Scraping בקנה מידה גדול ומהיר במיוחד? Scrapy בנויה לזחילה אסינכרונית בקנה מידה גדול. אם אתם זקוקים למהירות רבה עוד יותר ומרגישים בנוח עם קוד אסינכרוני, aiohttp היא הבחירה המובילה לבקשות מקביליות.
4. האם אני יכול לשלב חבילות אלה בזרימת העבודה שלי? בהחלט! מפתחים רבים משתמשים ב-Requests או Selenium כדי לאחזר דפים, ואז מנתחים עם Beautiful Soup, lxml או PyQuery. את הפלטים של Thunderbit ניתן להזין לסקריפטים של פייתון לניתוח נוסף.
5. האם Thunderbit היא ספריית פייתון או כלי עצמאי? Thunderbit היא הרחבת Chrome ופלטפורמה מבוססת AI, לא ספריית פייתון מסורתית. עם זאת, הפלט שלה (CSV, Excel, Sheets, Notion, Airtable) משתלב בצורה חלקה בצינורות נתונים של פייתון, מה שהופך אותה לבת לוויה חזקה עבור מפתחי פייתון.
6. האם סוכני קידוד AI מחליפים ספריות Scraping של פייתון בשנת 2026? עדיין לא, אבל כדאי לדעת עליהם. כלים כמו Claude Code ו-OpenAI Codex יכולים ליצור סקריפט Requests + Beautiful Soup או Scrapy עובד מהנחיה בשפה פשוטה תוך שניות, וזה שימושי באמת עבור עבודות חד-פעמיות ואב טיפוס. עבור זרימות דפדפן בשפה טבעית (התחברות, JS דינמי, ניווט מרובה שלבים), Browser Use היא האפשרות בקוד פתוח שאנשים פונים אליה, ו-Firecrawl פופולרית כאשר המטרה היא הזנת markdown נקי ל-LLM. אף אחד מאלה לא מסיר את החלקים הקשים – הגנות אנטי-בוטים, מגבלות קצב ותנאי שימוש עדיין חלים – ועבור זחלני ייצור בקנה מידה, Scrapy + aiohttp עדיין מנצחים בעלות ובשליטה. התייחסו לסוכני AI כדרך מהירה יותר לכתוב את ה-Scraper, לא כתחליף ישיר לספריות ברשימה זו.
רוצים להישאר בחזית עולם ה-Web Scraping? הירשמו ל-ערוץ היוטיוב של Thunderbit ועקבו אחר הבלוג של Thunderbit לקבלת מדריכים נוספים, השוואות וטיפים לאוטומציה.
נסה את Thunderbit AI Web Scraper בחינם Get Started Free
למד עוד




