
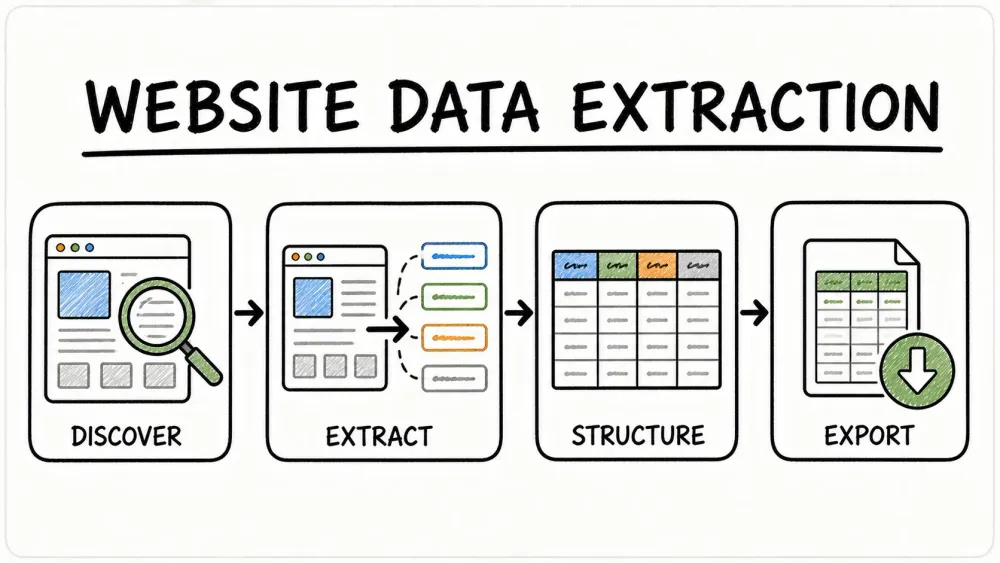
האינטרנט מוצף במידע, אבל להפוך את כל הכאוס הזה לנתונים עסקיים שאפשר באמת לפעול לפיהם? כאן נמצא האתגר האמיתי — וגם ההזדמנות. לאורך השנים שבהן בניתי כלי SaaS ואוטומציה, ראיתי איך העולם עובר מהחלטות שמבוססות על תחושת בטן לכל מה שמונע על ידי נתונים. זה כבר לא רק משחק של ענקיות הטכנולוגיה; גם צוותים קטנים ממהרים extract data מ-website כדי להניע מכירות, שיווק, תמחור והחלטות מוצר. אבל ככל שהרשת נעשית מבולגנת ודינמית יותר, היכולת להוציא ממנה מידע נקי, תואם ויעיל הופכת למשחק חדש לגמרי.
בואו נרד לקרקע: אעבור איתכם על הסיבות לכך שהפקת נתונים מאתרים קריטית לעסקים מודרניים, על האתגרים הגדולים שתפגשו, ועל השיטות המומלצות — כולל לקחים שנצברו בעבודה הקשה של צוות Thunderbit — כדי לעשות זאת נכון, כחוק, ביעילות ובקנה מידה רחב. בין אם אתם מתמודדים עם תוכן לא מובנה, חוששים מ-GDPR, או פשוט רוצים להפסיק להעתיק ולהדביק לגיליונות אלקטרוניים, המדריך הזה בשבילכם.
למה חשוב להפיק נתונים מאתרים בעסקים מודרניים
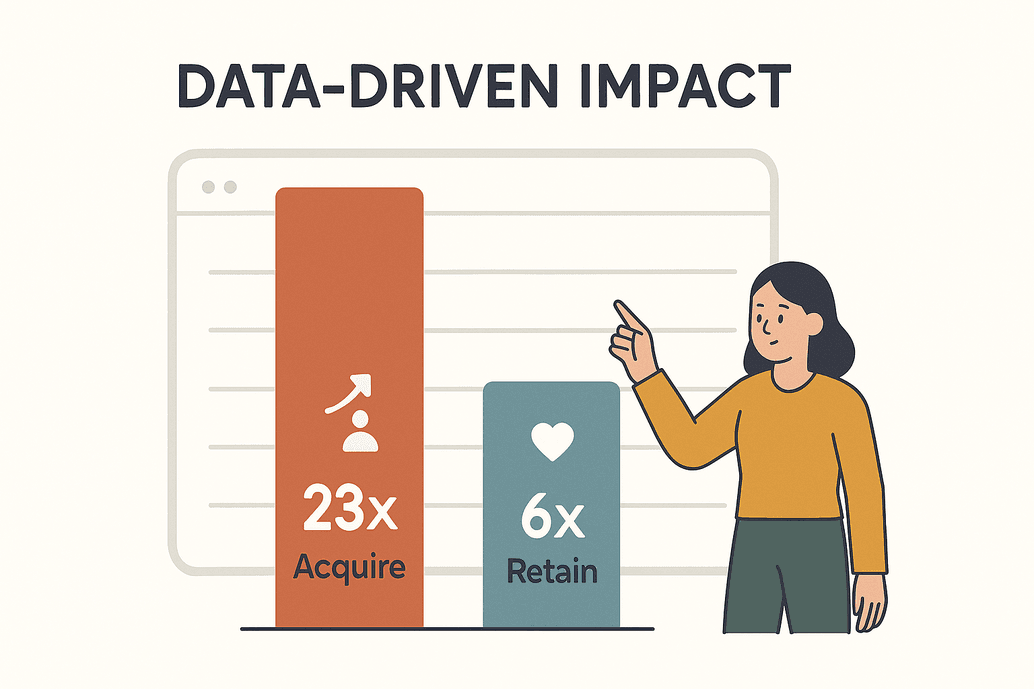 נתונים הם לא רק מילת באז — הם הדלק שמניע עסקים תחרותיים היום. לפי סקר של McKinsey, ארגונים שמבוססים על נתונים הם סבירים פי 23 לרכוש לקוחות ופי 6 לשמר אותם. זה לא רק מרשים — זה קריטי. עד 2025, עסקים יגרדו מיליארדי דפי אינטרנט מדי יום כדי להזין אנליטיקה, מודלי AI וקבלת החלטות בזמן אמת (kanhasoft.com).
אז איך זה נראה בפועל? הנה רק כמה דוגמאות שאני פוגש כל שבוע:
| יישום עסקי | תיאור ויתרונות | דוגמה/נתון |
|---|---|---|
| ניטור מחירים | מעקב בזמן אמת אחרי מחירי מתחרים, מלאי ומבצעים; התאמת האסטרטגיה שלכם כדי להישאר צעד אחד קדימה. | יותר מ-80% מהקמעונאים המובילים אונליין מפיקים נתוני מחירים של מתחרים מדי יום (kanhasoft.com). |
| יצירת לידים | הפקת נתונים ממדריכים, רשתות חברתיות או אתרי ביקורות כדי למצוא לידים ופרטי קשר חדשים. | חילוץ נתונים אוטומטי ממלא מערכות CRM מהר יותר מכל מחקר ידני. |
| ניתוח מגמות שוק | איגום ביקורות, פורומים וחדשות כדי לזהות מגמות או שינויים בסנטימנט מוקדם. | 26% מהשימוש בגרידה מתמקד ברשתות חברתיות לצורך תובנות על מגמות (blog.apify.com). |
| איסוף תוכן | איסוף חדשות, רשימות מוצרים או אירועים ממספר אתרים כדי לגשת אליהם בקלות. | צוותי מדיה אוצרים פידים עבור הקהלים שלהם. |
| נתוני מוצר ומחקר | איסוף פרטי מוצר, ביקורות או נתוני מחקר לצורך ניתוח ופיתוח. | 67% מיועצי ההשקעות משתמשים בנתוני רשת חלופיים (scrap.io). |
| נתוני אימון ל-AI | שליפה של כמויות עצומות של טקסט, תמונות או רשומות כדי לאמן מודלי AI. | כ-70% מהמודלים הגדולים של AI נשענים על נתונים שנגרדו מהרשת (kanhasoft.com). |
אם אתם לא extract data מ-website, אתם לא רק מאחור — אתם כמעט שקופים בשוק שלכם. ראיתי צוותי e-commerce משלשים את ה-ROI שלהם בתוך חצי שנה רק על ידי אוטומציה של גרידת מחירי מתחרים (kanhasoft.com). השורה התחתונה: נתוני רשת הם נכס אסטרטגי, והפקה טובה שלהם היא כבר תנאי בסיס.
האתגרים המרכזיים כשמפיקים נתונים מכל אתר
כמובן, לא הכול שמש ו-CSV. הרשת היא מקום פרוע, והפקת נתונים מאתרים מגיעה עם אתגרים אמיתיים:
- נתונים לא מובנים: בערך 80% מהנתונים המקוונים אינם מובנים — הם קבורים ב-HTML מבולגן, מפוזרים בין עמודים או מוסתרים מאחורי רכיבים אינטראקטיביים. להפוך את זה לטבלה נקייה זו משימה לא פשוטה (scrapingapi.ai).
- אתרים שמשתנים כל הזמן: אתרים מעדכנים את המבנה שלהם בלי הפסקה. ראיתי סקרייפרים נשברים 15 פעמים בחודש אחד רק כי אתר יעד שינה קצת את העיצוב שלו (scrap.io).
- כמות וקנה מידה: עסקים צריכים extract data ממאות או מאלפי עמודים — לרוב לפי לוח זמנים קבוע. העתק-הדבק ידני פשוט לא עומד בקצב.
- הגנות נגד גרידה: CAPTCHA, מגבלות קצב, קירות התחברות… אתרים נעשים חכמים יותר בבלימת בוטים. כיום למעלה משליש מתעבורת הרשת היא בוטים (scrap.io), וטכנולוגיות נגד בוטים מתקדמות במהירות.
- טעויות ידניות: העתקה והדבקה אנושית היא איטית ומועדת לשגיאות. בורר אחד שגוי, ואתם מושכים את המידע הלא נכון — או כלום.
שיטות מסורתיות פשוט לא מתאימות להיקפים כאלה. לכן יותר ויותר צוותים עוברים לפתרונות חכמים ואוטומטיים — וזה גם למה אני כל כך מאמין בכלים מבוססי AI.
שיטות מומלצות משפטיות, תואמות ומאובטחות להפקת נתוני אתרים
בואו נשים את זה על השולחן: רק כי אפשר extract data מ-website, לא אומר שצריך — לפחות לא בלי לחשוב על ההיבט המשפטי והאתי. הנה מה שכל עסק צריך לדעת:
- מידע ציבורי מול פרטי: גרידה של מידע זמין לציבור היא בדרך כלל חוקית במקומות רבים. אבל כל מה שמאחורי התחברות? מחוץ לתחום. עקיפת אימות היא לא אופציה (xbyte.io).
- תנאי שימוש: תמיד בדקו את תנאי השימוש של האתר. אם גרידה אסורה, אתם מסתכנים בתביעות או בחסימה. כשיש ספק — בקשו אישור או השתמשו ב-API רשמי.
- חוקי פרטיות (GDPR, CCPA): אם אתם אוספים מידע אישי, צריך בסיס חוקי (כמו אינטרס לגיטימי), לאסוף רק את המינימום הנדרש, ולהיות מוכנים למחוק נתונים אם מתבקשים. אי-עמידה עלולה להוביל לקנסות כבדים (xbyte.io).
- כבדו את robots.txt: זה לא מסמך מחייב משפטית, אבל זו התנהלות ראויה. עמדו בכללי crawl-delay ואל תעמיסו על השרתים.
- אבטחת מידע: התייחסו לנתונים שנגרדו כאל מידע רגיש. שמרו אותם בצורה מאובטחת, הגבילו גישה ונקו אותם לפני שימוש.
רשימת בדיקה לעמידה בדרישות:
| נושא | שיטה מומלצת |
|---|---|
| גישה חוקית | גרדו רק מידע ציבורי; לעולם אל תעקפו התחברויות (xbyte.io). |
| תנאי שימוש | עברו על תנאי האתר וכבדו אותם; השתמשו ב-API אם גרידה אסורה. |
| מידע אישי | הימנעו כשאפשר; אם חייבים, צמצמו למינימום ועמדו ב-GDPR/CCPA. |
| robots.txt וזמני השהיה | כבדו את כללי האתר; הגבילו את קצב הבקשות. |
| אבטחת מידע | הצפינו, הגבילו גישה ומחקו כשאין עוד צורך. |
שיפור היעילות: איך AI משדרג הפקת נתונים מאתרים
כאן מתחיל להיות מעניין. AI שינה לגמרי את המשחק בהפקת נתונים מאתרים. במקום להיאבק בבוררים או לכתוב סקריפטים שבריריים, אפשר כיום להשתמש בכלים מבוססי AI ש“קוראים” את העמוד ומבינים בעצמם מה צריך לחלץ — לעיתים בכמה קליקים בלבד.
מה זה אומר בפועל?
- הגדרה מינימלית: סקרייפרים מונעי AI כמו Thunderbit יכולים לזהות שדות אוטומטית. פשוט לוחצים על “One Click Extract”, והכלי מציע את העמודות הנכונות — בלי קוד, בלי ניסוי וטעייה.
- התאמה לשינויים: סקרייפרים מבוססי AI מזהים תבניות, לא רק פריסות קבועות. אם אתר משתנה, ה-AI לרוב מסתגל לבד. פחות תחזוקה, פחות חירום באמצע הלילה.
- דיוק: AI יכול לסנן רעש, להסיר כפילויות ואפילו לנקות נתונים מבולגנים בזמן הגרידה. חלק מהצוותים מדווחים על דיוק של עד 99.5% עם מחלצי נתונים מבוססי AI (scrapingapi.ai).
- תוכן דינמי: סקרייפרים מבוססי AI יכולים להתמודד עם אתרים עתירי JavaScript, גלילה אינסופית, ואפילו extract data מתוך תמונות או PDF.
- עיבוד תוך כדי פעולה: צריכים שהנתונים יתורגמו, יסווגו או יסוכמו בזמן הגרידה? AI יכול לעשות זאת במעבר אחד.
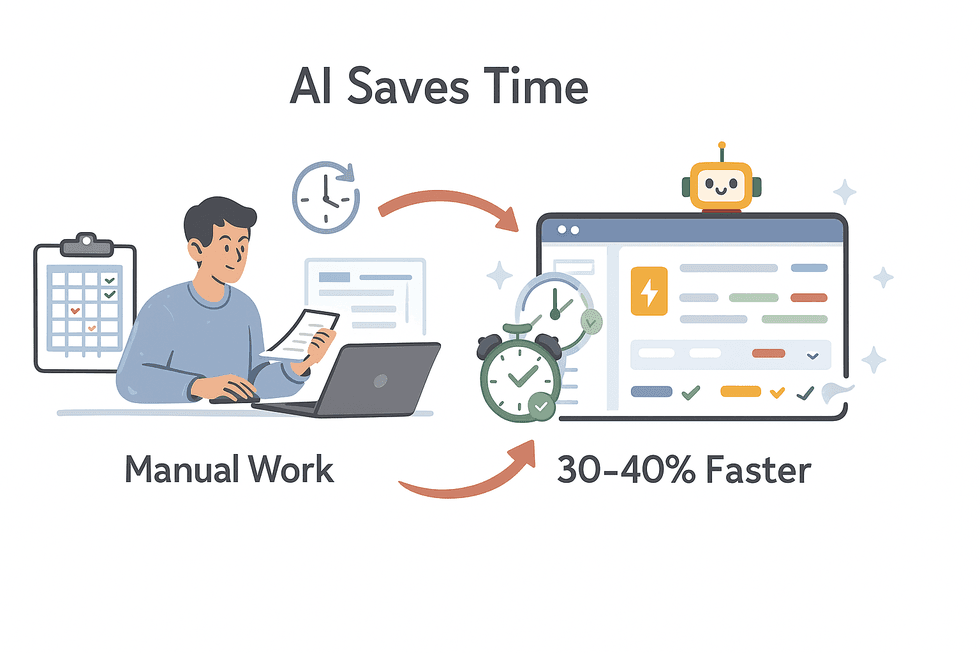 ראיתי צוותים חוסכים 30%–40% מהזמן שלהם על חילוץ נתונים רק באמצעות מעבר לכלים מבוססי AI (scrapingapi.ai). זה לא רק שיפור בפרודוקטיביות — זה יתרון תחרותי.
חלצו נתונים מכל אתר באמצעות AI הסקרייפר הסוכן של Thunderbit קורא כל אתר בעצמו ובוחר אילו שדות לחלץ — בלחיצה אחר לחיצה. Get Started Free
Thunderbit נבנה כדי להפוך חילוץ נתונים לפשוט, מדויק ונגיש — גם למי שמעולם לא כתב שורת קוד. (וכן, גם אמא שלי יודעת להשתמש בו. עדיין עובדת על Netflix, אבל.)
Thunderbit Agentic Web Scraper: תכונות מרכזיות למשתמשים עסקיים
אולי מותר לי קצת להתגאות במה שבנינו ב-Thunderbit (היי, מותר לי, נכון?). Thunderbit מיועד למשתמשים עסקיים — מכירות, תפעול, שיווק, נדל״ן — שרוצים תוצאות, לא כאב ראש. הנה מה שמייחד אותו:
- One Click Extract: לוחצים פעם אחת, וה-AI של Thunderbit סורק את העמוד, מציע עמודות ומגדיר את הסקרייפר עבורכם. אין יותר התעסקות בבוררים.
- 2-Click Scraping: אחרי שהשדות מוגדרים, פשוט לוחצים “Scrape” ומקבלים טבלה נקייה — בלי קוד, בלי התקנה.
- Subpage Scraping: צריכים יותר פרטים? Thunderbit יכול לבקר אוטומטית בכל תת-עמוד (כמו עמודי מוצר או פרופיל) ולהעשיר את הטבלה במידע נוסף.
- תבניות מוכנות מראש: עבור אתרים פופולריים (Amazon, Zillow, Instagram, Shopify וכו׳), פשוט בוחרים תבנית ומתחילים — בלי הגדרה.
- ייצוא לכל מקום: ייצוא חינמי ל-Excel, Google Sheets, Airtable, Notion או CSV. בלי עמלות נסתרות.
- Scheduled Scraping: אוטומציה של גרידות חוזרות — פשוט מתארים את התדירות (“כל יום שני ב-8 בבוקר”) ו-Thunderbit עושה את השאר.
- גרידה בענן או בדפדפן: אפשר להשתמש בשרתי הענן של Thunderbit למהירות, או בדפדפן שלכם עבור אתרים שדורשים התחברות.
- תמיכה רב-לשונית: גרידה ב-34 שפות, כולל אנגלית, ספרדית, סינית ועוד.
נסו את Thunderbit Agentic Web Scraper בחינם תוכנית חינמית כוללת 6 עמודים בחודש, ללא צורך בכרטיס אשראי — דרך טובה לבדוק את החילוץ באתר היעד שלכם. Get Started Free
אוטומציה והרחבה: שימוש בכלי תזמון ואינטגרציה להפקת נתונים
גרידה ידנית זה כל כך 2015. הערך האמיתי מגיע כשמכניסים אוטומציה ומשלבים את הפקת הנתונים בתוך תהליכי העבודה:
- Scheduled Scraping: הגדירו ל-Thunderbit להריץ גרידות יומיות, שבועיות או בכל תדירות שתרצו. מושלם לניטור מחירים, יצירת לידים או איסוף חדשות.
- אינטגרציה ישירה: ייצוא נתונים שנגרדו ישירות ל-Google Sheets, Excel, Airtable או Notion. בלי להוריד ולהעלות קבצים שוב ושוב.
- אינטגרציה עם CRM ואנליטיקה: הזרימו נתונים ל-CRM או לכלי BI לצורך דשבורדים בזמן אמת, התראות או פניות אוטומטיות.
דוגמה: תהליך אוטומטי לניטור מחירים
- מגדירים את Thunderbit בעמוד מוצר של מתחרה.
- משתמשים ב-“One Click Extract” כדי ללכוד שם מוצר, מחיר ו-URL.
- מתזמנים את הגרידה לכל בוקר ב-7:00.
- מייצאים את התוצאות ל-Google Sheets שמחובר לדשבורד.
- מנהל התמחור בודק את השינויים ומתאים את האסטרטגיה לפני שהמתחרים בכלל מתעוררים.
עם אוטומציה, אתם לא רק מהירים יותר — אתם תמיד מעודכנים.
שיטות מומלצות להתמודדות עם נתונים לא מובנים בעת הפקה מאתרים
בואו נודה באמת: רוב נתוני הרשת אינם מסודרים ונקיים. הם לא מובנים, לא עקביים, ולפעמים פשוט מוזרים לגמרי. כך תסדרו אותם:
- תנו ל-AI להגדיר את המבנה: השתמשו ב-One Click Extract או בתבנית כדי להכניס סדר — ה-AI יקבע את העמודות ואת סוגי הנתונים, ואתם תוכלו לכוונן אחר כך אם צריך.
- הנחיות AI ברמת שדה: Thunderbit מאפשר להוסיף הוראות מותאמות לכל שדה. רוצים לסווג מוצרים, לעצב מספרי טלפון או לתרגם תיאורים? פשוט אומרים ל-AI מה רוצים.
- ניצול NLP: עבור ביקורות, תגובות או מאמרים, השתמשו ביכולות NLP מובנות כדי לסכם, לנתח סנטימנט או לחלץ מילות מפתח.
- נרמול נתונים: נקו פורמטים של תאריכים, מחירים ומספרי טלפון בזמן הגרידה, לא אחרי. עקביות היא שם המשחק.
- הסרת כפילויות ואימות: הסירו כפילויות ובצעו בדיקת דגימה לתוצאות. אם משהו נראה חריג, כוונו את ההנחיות או ההגדרות.
הנחיות AI ברמת שדה: התאמה אישית של הפקת הנתונים לתוצאות טובות יותר
זו אחת התכונות האהובות עליי. עם הנחיות AI ברמת שדה אפשר:
- לתייג ולסווג: “סווג את המוצר הזה כאלקטרוניקה, ריהוט או ביגוד על סמך התיאור שלו.”
- לאכוף פורמטים: “הצג את התאריך בפורמט YYYY-MM-DD.” “חלץ רק את המחיר המספרי.”
- לתרגם בזמן אמת: “תרגם את תיאור המוצר לאנגלית.”
- לנקות רעש: “חלץ את הביו של המשתמש, תוך התעלמות מקישורי ‘קרא עוד’ או מודעות.”
- לשלב שדות: “מזג את שורות הכתובת לשדה אחד.”
זה כמו לקבל אנליסט זוטר מובנה בתוך הסקרייפר — כזה שלעולם לא מתלונן על הפסקות קפה.
הבטחת איכות ועקביות של הנתונים בעת הפקה מאתרים
הפקת נתונים טובה לא מסתיימת ברגע שלוחצים “Export”. כך תשמרו על הנתונים נקיים ואמינים:
- בדיקות אימות: השתמשו בבדיקות טווח, שדות חובה ומפתחות ייחודיים כדי לגלות שגיאות.
- ביקורת מדגמית: עברו ידנית על מדגם של נתונים שנגרדו מול אתר המקור — במיוחד אחרי ההגדרה הראשונית או אם האתר השתנה.
- טיפול בשגיאות: רשמו כישלונות בגרידה והגדירו התראות על חריגות (כמו ירידה פתאומית במספר השורות).
- ניקוי שוטף: השתמשו בכלי גיליונות או בסקריפטים כדי להסיר רווחים מיותרים, לתקן קידוד ולנרמל טקסט.
- עקביות בסכימה: שמרו על שמות השדות והפורמטים יציבים לאורך זמן. תעדו שינויים כדי שהצוות לא יצטרך לנחש.
אמון בנתונים הוא הכול. קצת הקפדה בהתחלה חוסכת הרבה כאב ראש בהמשך.
ראו איך Thunderbit משתווה בדקו היכן החילוץ בלחיצה אחת של Thunderbit, מבוסס AI, משתלב בין כלי הגרידה האחרים בשוק. Get Started Free
השוואת כלי חילוץ: על מה להסתכל כשבוחרים פתרון
לא כל כלי גרידה נוצר שווה. הנה מה שכדאי לשקול:
| כלי | חוזקות | שיקולים |
|---|---|---|
| Thunderbit | הכי קל למשתמשים לא טכניים; זיהוי שדות באמצעות AI; גרידת תתי-עמודים; תבניות מוכנות; ייצוא חינמי; תוכניות במחיר נגיש (Thunderbit Blog). | לא נבנה לפרויקטים ענקיים במיוחד עם כבדות פיתוח; פועל על מערכת קרדיטים. |
| Browse AI | ללא קוד, טוב לניטור שינויים; אינטגרציה עם Google Sheets; חילוץ בכמות גדולה. | תוכניות התחלה יקרות יותר; ההגדרה עשויה להיות ממושכת. |
| Octoparse | עוצמתי, מטפל באתרים דינמיים; תכונות מתקדמות למשתמשים טכניים. | עקומת למידה תלולה; תמחור גבוה יותר. |
| Web Scraper (webscraper.io) | חינמי לפרויקטים קטנים; הגדרה ויזואלית; קהילה חזקה. | ההגדרה הידנית יכולה להיות מבלבלת; תמיכת AI מוגבלת. |
| Diffbot | מבוסס AI, מנתח עמודים לא מובנים דרך API; מצוין למפתחים. | יקר, מבוסס API, לא מתאים למשתמשים לא טכניים. |
העצה שלי: אם אתם משתמשים עסקיים שרוצים תוצאות מהירות ומדויקות, Thunderbit הוא התאמה מצוינת. למשתמשים מתקדמים או למפתחים, Octoparse או Diffbot עשויים להצדיק את המורכבות הנוספת. תמיד כדאי לנסות גרסה חינמית או תקופת ניסיון לפני שמתחייבים.
סיכום: הפיכת שיטות מומלצות להפקת נתונים מאתרים לפעולה
הפקת נתונים מאתרים כבר לא “נחמד שיהיה” — היא חובה לכל עסק שרוצה להישאר תחרותי. הנה מה שאני מקווה שתיקחו מכאן:
- ערך: נתוני רשת מניעים החלטות חכמות ומהירות יותר. אל תשאירו אותם על השולחן.
- התמודדות עם אתגרים: השתמשו בכלים מבוססי AI כדי לטפל בנתונים לא מובנים, בנפחים גדולים ובשינויים באתר.
- שמירה על חוקיות: כבדו חוקי פרטיות, כללי אתרים ואבטחת מידע.
- אוטומציה: תזמנו ושלבו את ההפקה בתהליכי העבודה היומיים שלכם.
- איכות קודם כול: תקפו, נקו ופקחו על הנתונים שלכם כדי לשמור על אמון לאורך זמן.
רוצים לראות כמה זה יכול להיות פשוט? הורידו את תוסף Chrome של Thunderbit ונסו אותו בפרויקט הנתונים הבא שלכם. ואם תרצו להעמיק עוד יותר, בדקו את בלוג Thunderbit לעוד מדריכים, טיפים ודוגמאות מהשטח.
גרידה נעימה — ושהנתונים שלכם יהיו תמיד מובנים, תואמים ומוכנים לפעולה.
התחילו להפיק נתונים עם Thunderbit התקינו את תוסף Chrome החינמי של Thunderbit והתחילו לחלץ נתונים מובנים מכל דף בלחיצה אחת. Get Started Free
שאלות נפוצות
1. האם זה חוקי להפיק נתונים מכל אתר?
בדרך כלל, גרידה של מידע ציבורי היא חוקית בתחומי שיפוט רבים, אבל חשוב להימנע מעקיפת התחברויות או מנגנוני אבטחה. תמיד בדקו את תנאי השימוש של האתר והקפידו על חוקי פרטיות כמו GDPR ו-CCPA (xbyte.io).
2. איך AI משפר את תהליך הפקת הנתונים מאתרים?
כלים מבוססי AI כמו Thunderbit יכולים לזהות שדות אוטומטית, להסתגל לשינויים בפריסה, לנקות ולעצב נתונים, ואפילו להתמודד עם תוכן דינמי או תרגומים — הכול בהגדרה מינימלית ובדיוק גבוה (scrapingapi.ai).
3. מהן השיטות המומלצות לטיפול בנתונים לא מובנים?
הגדירו מראש את מבנה הנתונים, השתמשו בהנחיות AI ברמת שדה כדי להכווין את החילוץ, נרמלו פורמטים בזמן הגרידה, ותקפו את התוצאות. כלים כמו Thunderbit מקלים על סיווג, עיצוב ותוויות של נתונים בזמן אמת.
4. איך אפשר לאוטמט ולהרחיב הפקת נתונים מאתרים?
השתמשו ביכולות תזמון כדי להריץ גרידות במרווחים קבועים, ושלבו את הפלט ישירות בכלים כמו Google Sheets, Airtable או ה-CRM שלכם. אוטומציה מבטיחה שהנתונים יישארו עדכניים ומפחיתה עבודה ידנית.
5. איך מבטיחים איכות ועקביות של נתונים שנגרדו?
הטמיעו בדיקות אימות, בצעו ביקורות מדגמיות באופן קבוע, טפלו בשגיאות בצורה מסודרת, ושמרו על סכימה עקבית לאורך זמן. שיפור מתמיד וניטור הם המפתח לשמירה על נתונים אמינים.
רוצים לראות את השיטות המומלצות האלה בפעולה? נסו את הגרסה החינמית של Thunderbit וגלו כמה קל, חוקי וניתן להרחבה יכול להיות חילוץ נתוני רשת.
נסו סקרייפר סוכן Get Started Free
למידע נוסף




