
Craigslist נראה כאילו הוא לא השתנה מאז 2003, אבל המידע שמסתתר בתוך המודעות הפשוטות שלו שווה לא מעט. עם כ-127 מיליון ביקורים חודשיים ו-עשרות מיליוני פרסומים חדשים בכל חודש, הוא עדיין אחת מפלטפורמות המודעות המסווגות הגדולות בארה"ב — ואין לו API ציבורי שאפשר להתחבר אליו.
במשך שנים בניתי כלי אוטומציה ב-Thunderbit, ואחד הדברים שאני שומע שוב ושוב מצוותי מכירות, תפעול ונדל"ן הוא: "אני צריך את הנתונים של Craigslist בגיליון, ולא רוצה לעשות העתק-הדבק במשך שלוש שעות." הבעיה היא שרוב המדריכים של "ה-scraper הטוב ביותר ל-Craigslist" או מיושנים, או מדלגים על החלקים הקשים (כמו הגנות נגד בוטים), או סתם מפרטים כלים בלי להשוות ביניהם באמת.
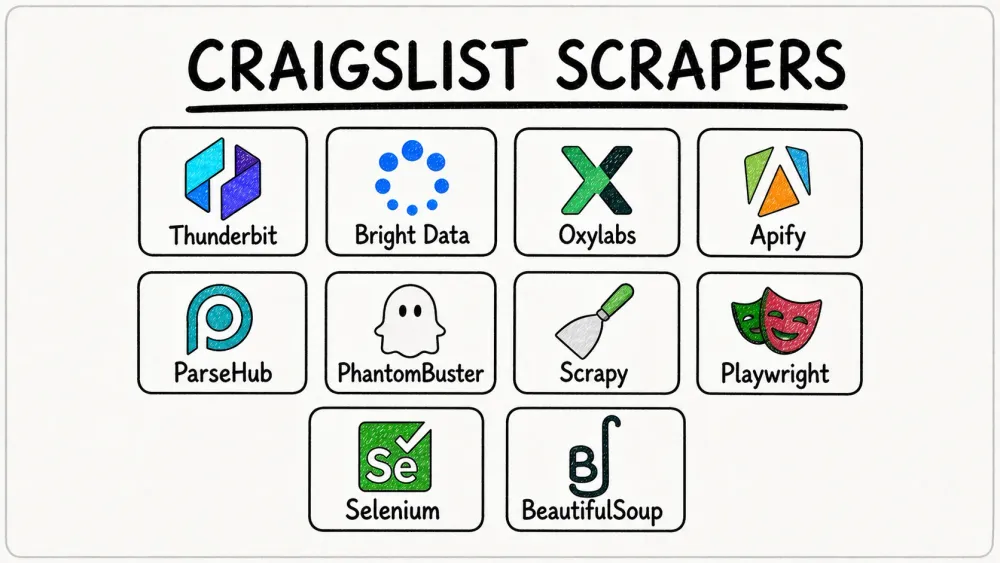
אז ריכזתי כאן מדריך עם 10 כלים שבאמת עדיין עובדים ב-2026 — מהרחבות Chrome בלי קוד, דרך פלטפורמות פרוקסי לארגונים ועד ספריות Python בקוד פתוח. בין אם אתם משתמשים עסקיים שמעולם לא כתבו שורת קוד אחת ובין אם אתם מפתחים שחיים ונושמים Python, יש כאן משהו בשבילכם.
למה בכלל לגלוש ל-Craigslist ב-2026? מקרי שימוש מובילים לצוותים עסקיים
Craigslist אולי נראה מיושן, אבל זה בדיוק חלק מהקסם שלו — וגם מהערך שלו. הוא עדיין מדורג במקום השלישי בעולם בין אתרי המודעות, ופועל ב-416 ערים/אזורים בארה"ב ובטריטוריות דרך הספרייה הרשמית שלו. זה מלאי מקומי מאוד שפשוט לא קיים במקום אחד אחר.
אלו מקרי השימוש שאני רואה צוותים חוזרים אליהם שוב ושוב:
- יצירת לידים: פרסומי שירותים והופעות צדיות כוללים לעיתים תיאור עסקי, אזור גיאוגרפי ונתיב יצירת קשר דרך Craigslist — מספיק כדי לבנות רשימת לידים מקומית.
- ניטור נדל"ן: דפי דיור חושפים שכירות, שכונה, מספר חדרים/אמבטיות, שטח ומועדי פרסום — מושלם להשוואת שכירויות ולמעקב אחרי זמינות.
- השוואת מחירים תחרותית: מודעות למכירה מציגות כותרת, מחיר, מצב ונקודת מיקום — מידע זהב למחקר על מכירה חוזרת או ארביטראז'.
- גיוס וניטור שוק העבודה: קטגוריות Jobs ו-Gigs חושפות תגמול, סוג העסקה ותיאורי תפקיד לצורך סריקת שוק כישרונות מקומי.
- ניתוח שוק רב-אזורי: מכיוון ש-Craigslist מחולק לפי תת-דומיינים וערים, אפשר לשאול אזור אחרי אזור כדי לנתח מחירים, נפח או תמהיל קטגוריות.
- אוטומציה של תהליכים: הרבה משתמשים פשוט רוצים שהנתונים מ-Craigslist יזרמו ל-CSV, Google Sheets, Airtable או CRM — בלי גלישה ידנית.
משתמש אחד דיווח שסקירה יומית של Craigslist שדרשה בעבר 60–90 דקות ירדה לכ-5 דקות בלבד בעזרת אוטומציה. זה בדיוק סוג החיסכון בזמן שמצטבר מהר.
לחלץ נתוני Craigslist עם AI ה-web scraper האגנטי של Thunderbit קורא בעצמו את דפי המודעות של Craigslist ושולף מחירים, תיאורים ופרטי קשר בלחיצה אחת. Get Started Free
איך בחרנו את ה-scrapers הטובים ביותר ל-Craigslist: קריטריוני ההערכה שלנו
לא כל ה-scrapers של Craigslist נולדו שווים, וה"טוב ביותר" תלוי מאוד במי אתם ומה אתם צריכים. הערכתי כל כלי לפי שישה ממדים:
- קלות ההקמה — האם הוא מתאים למתחילים (ללא קוד), או שצריך מפתח?
- התמודדות עם מנגנוני anti-bot של Craigslist — האם יש בו סיבוב פרוקסי מובנה, טיפול ב-CAPTCHA או fingerprinting לדפדפן?
- תמחור — חינמי, freemium, בתשלום או enterprise?
- אפשרויות ייצוא נתונים — CSV, Excel, Google Sheets, Airtable, Notion, JSON, מסד נתונים?
- תמיכה רב-אזורית — האם הוא יכול לעבוד מול כל 416 האתרים של Craigslist בארה"ב, או שהוא מוגבל לעיר אחת בכל פעם?
- מאמץ תחזוקה — האם הכלי נשבר כש-Craigslist משנה את פריסת הדף, או שהוא מסתגל אוטומטית?
לא מצאתי אף מאמר מתחרה שנותן השוואה זה לצד זה לפי קריטריונים עקביים כאלה — כך שאם נמאס לכם מרשימות מעורפלות של "טופ 10", זה בשבילכם.
10 ה-scrapers הטובים ביותר ל-Craigslist במבט חטוף
לפני שנצלול לעומק של כל כלי, הנה טבלת ההשוואה המרכזית. חילקתי אותם לשלושה מסלולים: כלים ללא קוד למשתמשים עסקיים, פלטפורמות enterprise לסקייל, וספריות open-source למפתחים.
| כלי | סוג | יש גרסה חינמית? | תמיכת Proxy / Anti-Bot | טיפול ב-CAPTCHA | פורמטי ייצוא | הכי מתאים ל |
|---|---|---|---|---|---|---|
| Thunderbit | הרחבת Chrome ללא קוד | כן (6 דפים לחודש) | מצב דפדפן (לא צריך proxy בהרצות בינוניות) | לא רלוונטי (סשן דפדפן) | Excel, Sheets, Airtable, Notion, CSV, JSON | משתמשים עסקיים ללא רקע טכני |
| Bright Data | סקרייפר ארגוני + proxy + dataset | ניסיון | Managed unblocking, proxies, retries, rendering | כן (נפתר אוטומטית) | JSON, NDJSON, CSV, Parquet, XLSX, API | איסוף בקנה מידה ארגוני |
| Oxylabs | API + תשתית proxies | ניסיון | Managed unblocking, residential/ISP proxies | כן | HTML, screenshot, API outputs | מפתחים שצריכים תשתית enterprise |
| Apify | שוק actors בענן | כן ($5 זיכוי לחודש) | סיבוב פרוקסי (תלוי ב-actor) | חלקי / תלוי actor | JSON, CSV, XML, Excel, JSONL | אוטומציה גמישה בענן עם מעט קוד |
| ParseHub | scraper ויזואלי ללא קוד | כן | סיבוב פרוקסי בתשלום, הרצות בענן | לא תכונה מרכזית | CSV, JSON, API/S3/Dropbox (בתשלום) | משתמשים ללא קוד בתקציב מוגבל |
| Phantombuster | פלטפורמת אוטומציה בענן | כן (מוגבל) | יש תמיכה ב-proxy | קרדיטים / מבוסס workflow | CSV, JSON (בתשלום) | אוטומציית מכירות רב-פלטפורמית |
| Scrapy | crawler ב-Python בקוד פתוח | חינם (OSS) | מביאים proxies משלכם / middleware | לא | JSON, JSONL, CSV, XML, DB | סורקי production |
| Playwright | אוטומציית דפדפן בקוד פתוח | חינם (OSS) | מביאים browser/proxy משלכם | לא | ייצוא מותאם אישית | שליטה ברמת הדפדפן |
| Selenium | אוטומציית דפדפן בקוד פתוח | חינם (OSS) | מביאים browser/proxy משלכם | לא | ייצוא מותאם אישית | סטאקים ותיקים רב-שפתיים |
| BeautifulSoup | מנתח HTML בקוד פתוח | חינם (OSS) | אין בפני עצמו | לא | ייצוא מותאם אישית | ניתוח קל משקל |
שלושה מסלולים בולטים כאן:
- כלים ללא קוד (Thunderbit, ParseHub, Phantombuster) למשתמשים עסקיים שרוצים נתונים בלי עומס הנדסי.
- פלטפורמות enterprise (Bright Data, Oxylabs, Apify) לצוותים שצריכים סקייל, תשתית anti-bot ואספקה מנוהלת.
- כלי open-source למפתחים (Scrapy, Playwright, Selenium, BeautifulSoup) לשליטה מקסימלית — במחיר של הקמה, תחזוקה וניהול proxies.
ועכשיו, הניתוחים המעמיקים.
1. Thunderbit
 Thunderbit הוא תוסף Chrome מבוסס AI שנבנה עבור אנשים שרוצים נתונים מובנים מכל אתר — כולל Craigslist — בלי לכתוב קוד או להגדיר proxies.
יש פה קצת הטיה, כי אנחנו בנינו אותו, אבל הסיבה שאני מציב את Thunderbit ראשון היא שהוא פותר בדיוק את נקודות הכאב ש-Craigslist יוצר למשתמשים לא טכניים: פריסות דפים משתנות בין קטגוריות, העשרת דפי פירוט, והתקיעות התכופה כשסלקטורי CSS משתנים.
איך זה עובד על Craigslist:
- מתקינים את Thunderbit Chrome Extension ופותחים כל דף תוצאות ב-Craigslist (נניח, דירות בעיר שלכם).
- לוחצים על "One Click Extract" — ה-AI של Thunderbit קורא את הדף, מבין את המבנה שלו, מחליט אילו עמודות מתאימות, ושולף את הנתונים לטבלה בפעולה אחת. בדיור תקבלו Title, Price, Sqft, Bedrooms, Location, Date Posted, Link. במשרות תקבלו Title, Compensation, Job Type וכן הלאה. בלי להגדיר ידנית סלקטורים.
- מטפלים ב-paginations — Thunderbit עובד עם הניווט מבוסס-הקליקים של Craigslist.
- משתמשים ב-"Scrape Subpages" כדי להיכנס לכל מודעה בנפרד ולחלץ שדות שרק בדף הפירוט: תיאור מלא, כל התמונות, פרטי קשר מוטמעים ועוד.
- מייצאים ל-Google Sheets, Excel, Airtable, Notion או CSV — בחינם.
תכונות מרכזיות:
- זיהוי שדות מבוסס AI: מתאים את עצמו אוטומטית לקטגוריות שונות ב-Craigslist — בדיור מקבלים עמודות של sqft/bedrooms, במשרות compensation/job type, ובמכירה condition/price. בלי עבודה ידנית עם CSS.
- Scraping של תתי-דפים: אחרי סריקת דף תוצאות, נכנסים לכל מודעה כדי למשוך שדות מדף הפירוט (תיאור מלא, תמונות, פרטי קשר).
- מצב scraping מבוסס דפדפן: פועל בתוך סשן ה-Chrome שלכם, כך שאין צורך ב-proxy עבור נפחים בינוניים. זה לבדו חוסך שכבת עלות ומורכבות גדולה.
- אפס תחזוקה: ה-AI קורא את הדף מחדש בכל פעם. כש-Craigslist משנה את הפריסה שלו (וזה קורה), הסקרייפר שלכם לא נשבר.
- ייצוא חינם: Excel, Google Sheets, Airtable, Notion, CSV, JSON — בלי חומת תשלום על הייצוא.
תמחור: תוכנית חינמית (6 דפים/חודש), ניסיון חינמי (10 דפים), ו-תוכניות בתשלום לנפח גבוה יותר.
הכי מתאים ל: צוותי מכירות שמחפשים לידים ב-Craigslist מקטגוריות שירותים/הופעות צדיות, צוותי נדל"ן שמנטרים שכירויות, צוותי תפעול שצריכים נתונים מובנים בלי תמיכה של מפתח, וכל מי שרוצה לחלץ, לתייג ולייצא נתונים בצעד אחד.
נסו את Thunderbit לסקרייפינג של Craigslist התוכנית החינמית כוללת 6 דפים בחודש — מספיק כדי לבדוק את Craigslist לפני שעוברים לתוכנית בתשלום. Get Started Free
2. Bright Data
 Bright Data היא אופציית הענק לארגונים. זו הפלטפורמה היחידה ברשימה עם גם דף מוצר ייעודי של Craigslist Scraper וגם שוק Craigslist Dataset.
אם אתם צריכים לגרד אלפי מודעות Craigslist ביום בכל אזורי ארה"ב, Bright Data בנויה בדיוק לזה. ה-Web Unlocker שלה מטפל ב-IP-ים, ניסיונות חוזרים, rendering וחסימות — כולל פתרון אוטומטי של CAPTCHAs כברירת מחדל. ה-Web Scraper IDE מאפשר לבנות תהליכי איסוף מותאמים ל-Craigslist, ואפשר לעבור בצורה פרוגרמטית על כל 416 כתובות האזורים.
תכונות מרכזיות:
- רשת ענקית של residential proxies (מיליוני IP-ים)
- פתרון CAPTCHA מובנה ועקיפת anti-bot
- מוצרים ייעודיים ל-Craigslist: scraper ו-dataset
- ייצוא: JSON, NDJSON, CSV, Parquet, XLSX, אספקת API, webhooks
תמחור: ה-scraper של Craigslist עולה 0.5 דולר לכל 1,000 טעינות דף בתשלום לפי שימוש, עם חבילות כמו 380 אלף טעינות דף ב-499 דולר. residential proxies מתחילים מ-4 דולר ל-GB בתשלום לפי שימוש. יש ניסיון חינם של 1,000 בקשות לשבוע אחד.
הכי מתאים ל: צוותי enterprise שצריכים איסוף בנפח גבוה, רב-אזורי, עם uptime מובטח ותמיכה ייעודית. צוותים קטנים עם תקציב מוגבל צריכים לחפש חלופות.
3. Oxylabs
 Oxylabs היא ספקית פרימיום של תשתית proxies ו-scraping, עם Craigslist Scraper API ייעודי ודף Craigslist proxies.
Oxylabs מכוונת יותר למפתחים לעומת הגישה הכוללת של Bright Data. ה-Web Scraper API ו-Web Unblocker שלה תומכים ב-JS rendering, ניסיונות חוזרים, ניהול סשנים, יצירת fingerprints והתמודדות רחבה יותר עם anti-bot. הניסיון החינמי של Craigslist Scraper API מגיע עד 2,000 תוצאות.
תכונות מרכזיות:
- מאגרי residential ו-ISP proxies (Residential החל מ-6 דולר ל-GB, ISP החל מ-0.60 דולר ל-IP)
- Web Unblocker עם ניהול fingerprint וסשן אוטומטי
- נקודת API ייעודית ל-Craigslist
- ניסיון חינם ל-7 ימים
תמחור: ה-scraper API ל"אתרים אחרים" מתחיל בערך ב-0.15 דולר ל-1,000 תוצאות בלי JS, ו-0.35 דולר ל-1,000 עם JS. ה-Web Unblocker ברמת micro מתחיל סביב 75 דולר לחודש. residential proxies בקנה מידה גדול יכולים לרדת ל-0.50 דולר ל-GB בנפח של 1TB.
הכי מתאים ל: צוותי מפתחים שרוצים תשתית proxy מנוהלת ותהליכי עבודה מבוססי API לסקרייפינג מתמשך של Craigslist. צוותים שכבר משתמשים ב-Oxylabs בפרויקטים אחרים ימצאו שקל להוסיף גם את Craigslist.
4. Apify
 Apify היא פלטפורמת web scraping ואוטומציה בענן עם שוק של "Actors" מוכנים מראש — תבניות scraper שאפשר להריץ בלי לכתוב קוד.
הנוף של Craigslist ב-Apify מעניין: יש כמה Actors קהילתיים ל-Craigslist, אבל רמת האיכות שלהם משתנה מאוד. ה-actor של ivanvs/craigslist-scraper הגיע ל-829 משתמשים ולדירוג 5.0, בעוד automation-lab/craigslist-scraper עומד על 44 משתמשים ודירוג 1.0. האיכות לא אחידה, אז שווה לבדוק לפני שמתחייבים.
תכונות מרכזיות:
- כמה Actors ל-Craigslist זמינים (חלקם מחלצים כ-120 מודעות לדף עם השהיות מובנות)
- הרצה בענן, תזמון, גישה ל-API ואינטגרציות webhook
- סיבוב פרוקסי זמין
- ייצוא: JSON, CSV, XML, Excel, JSONL
תמחור: תוכנית חינמית עם קרדיטים בשווי 5 דולר לחודש, ותוכניות בתשלום החל מכ-49 דולר לחודש. התמחור לפי compute יכול לטפס בשימוש כבד — שימו לב לצריכת ה-CU שלכם.
הכי מתאים ל: צוותים שרוצים פתרון בענן בלי לנהל תשתית, משתמשים שמרגישים בנוח עם הגדרה של מעט קוד, וצוותים שצריכים סקרייפים חוזרים ומתוזמנים של Craigslist.
5. ParseHub
 ParseHub הוא כלי ויזואלי לסקרייפינג שפועל על שולחן העבודה, שבו לוחצים על רכיבי הדף כדי להגדיר מה לחלץ.
כדי להגדיר סקרייפינג של Craigslist ב-ParseHub, לוחצים על כותרות המודעות, המחירים והקישורים כדי ללמד את הכלי מה למשוך. הוא מטפל ב-pagination באמצעות לולאות לחיצה של AJAX ותומך בהרצות בענן בתוכניות בתשלום. התוכנית החינמית נותנת עד 5 פרויקטים, שזה סביר בהחלט לעבודה בקנה מידה קטן.
תכונות מרכזיות:
- בונה workflow ויזואלי של point-and-click
- טיפול ב-pagination ובתוכן דינמי
- הרצות בענן ותזמון בתוכניות בתשלום
- ייצוא: CSV, Excel, JSON
תמחור: תוכנית חינמית (5 פרויקטים), ותוכניות בתשלום החל מכ-189 דולר לחודש עבור יותר דפים והרצות מתוזמנות.
מגבלות: יכול להיות איטי בסקרים גדולים, יש מגבלת הרצות מתוזמנות בתוכנית החינמית, וחשוב מכך — הוא מבוסס CSS selectors, כך שהוא דורש תחזוקה ידנית כש-Craigslist משנה את הפריסה שלו.
הכי מתאים ל: משתמשים בודדים או צוותים קטנים עם צרכי סקרייפינג מתונים שרוצים כלי ויזואלי ללא קוד, אבל לא צריכים זיהוי שדות מבוסס AI.
6. Phantombuster
 Phantombuster היא פלטפורמת אוטומציה בענן שהייתה פופולרית במקור עבור LinkedIn ו-scraping של רשתות חברתיות. היא לא כלי מקורי ל-Craigslist, אבל Web Element Extractor שלה יכול לגרד דפים ציבוריים באמצעות CSS selectors.
הקמת סקרייפינג של Craigslist ב-Phantombuster דורשת יותר עבודה מאשר כלי ייעודי — תצטרכו להגדיר selectors, לבנות workflow ולהגדיר תזמון. אבל אם אתם כבר משתמשים ב-Phantombuster ל-LinkedIn או ליצירת לידים מרשתות חברתיות, הוספת Craigslist לצינור העבודה קלה יחסית.
תכונות מרכזיות:
- תבניות אוטומציה מוכנות והרצה בענן
- תזמון ואינטגרציות CRM
- תמיכה ב-proxy ואפשרות לקרדיטים לפתרון CAPTCHA
- ייצוא: CSV, JSON בתוכניות בתשלום (בתוכנית החינמית מוגבל ל-10 שורות)
תמחור: תוכנית חינמית עם 5 slots, 2 שעות בחודש ומגבלת ייצוא של 10 שורות. תוכניות שנתיות בתשלום מתחילות בכ-56 דולר לחודש בחיוב שנתי.
הכי מתאים ל: צוותי מכירות שכבר משתמשים ב-Phantombuster ליצירת לידים רב-פלטפורמית ורוצים להוסיף את Craigslist לתהליך.
7. Scrapy
 Scrapy היא מסגרת ה-web scraping הפופולרית ביותר בקוד פתוח ל-Python, והיא הבחירה המתבקשת לצוותי מפתחים שרוצים שליטה מקסימלית על הסריקה של Craigslist.
הגרסה היציבה האחרונה היא 2.15.0 (9 באפריל 2026). Scrapy תומכת בסריקה רב-אזורית (מעבר על כל ה-URLs האזוריים), בתזמון והאטת בקשות מובנים, ב-downloader middleware לסיבוב פרוקסים, וב-feed exports ל-CSV, JSON, JSONL, XML וצינורות למסדי נתונים. תוסף scrapy-playwright מוסיף rendering ברמת דפדפן כשצריך.
תכונות מרכזיות:
- crawler ברמת production, מותאם מאוד
- middleware ל-proxies, ניסיונות חוזרים, cookies וסיבוב user-agent
- feed exports: JSON, JSONL, CSV, XML, צינורות למסדי נתונים
- חינם ובקוד פתוח
העלות הסמויה: Scrapy עצמה חינמית, אבל הפעלתה בקנה מידה על Craigslist דורשת מנויי proxy (50–500+ דולר לחודש), עלויות אירוח/שרתים, ותחזוקה מתמדת כש-Craigslist משנה את מבנה ה-HTML שלו.
הכי מתאים ל: צוותי מפתחים עם ניסיון ב-Python שצריכים גמישות מקסימלית, תשתית proxy קיימת, וסריקה רב-אזורית בנפח גבוה.
8. Playwright
 Playwright היא ספריית אוטומציית דפדפן מודרנית של Microsoft, שמאפשרת לשלוט באופן פרוגרמטי ב-Chromium, Firefox ו-WebKit. קצב השחרורים פעיל מאוד — v1.59.1 יצאה ב-1 באפריל 2026.
בקהילות מפתחים Playwright נחשבת יותר ויותר לבחירה המומלצת על פני Selenium לסקרייפינג של Craigslist. היא מהירה יותר, אמינה יותר, ויש לה יכולות stealth טובות יותר נגד זיהוי, במיוחד עם תוספים קהילתיים כמו playwright-extra. היא תומכת במצבי headless ו-headed, בהמתנה אוטומטית לאלמנטים, ביירוט רשת, ובצילום screenshot/PDF.
תכונות מרכזיות:
- תומכת ב-Python, JavaScript/TypeScript, Java ו-.NET
- מצבי דפדפן headless ו-headed
- המתנה אוטומטית לאלמנטים, יירוט רשת
- חינם ובקוד פתוח
היתרון מול Craigslist: Playwright יכולה לדמות התנהגות משתמש אמיתית בצורה משכנעת יותר מבקשות HTTP גולמיות, מה שמקטין את סיכון החסימה. התחושה בקהילת Reddit נוטה בעקביות לטובת Playwright על פני Selenium בפרויקטים חדשים.
עלויות נסתרות: אותן עלויות כמו ב-Scrapy — proxies, אחסון, ותחזוקה כשסלקטורים נשברים.
הכי מתאים ל: מפתחים שצריכים שליטה מדויקת בדפדפן, צוותים שבונים סקרייפרים לתוכן שמרונדר ב-JavaScript, וכל מי שמעדיף חלופה מודרנית ל-Selenium.
9. Selenium
 Selenium היא מסגרת ותיקה ונפוצה מאוד לאוטומציית דפדפן. הגרסה האחרונה היא 4.43.0 (10 באפריל 2026), והיא ממשיכה להרחיב את יכולות BiDi ושליטה ברשת.
Selenium תומכת בכמה שפות (Python, Java, C#, JavaScript) ובכל הדפדפנים המרכזיים. היא יכולה לדמות סשן דפדפן מלא, לטפל בלוגין אם צריך, ולגלול בדפים. אבל ביחס ל-Playwright היא איטית יותר, מילולית יותר בקוד, וקל יותר לזהות אותה כבוט בלי ספריות stealth נוספות כמו undetected-chromedriver.
תכונות מרכזיות:
- תמיכה רב-שפתית (Python, Java, C#, JavaScript)
- סימולציה של סשן דפדפן מלא
- אקוסיסטם בשל עם תיעוד נרחב
- חינם ובקוד פתוח
מגבלות: התחושה בקהילה ב-2026 נוטה לכיוון Playwright בפרויקטים חדשים. באחד הדיונים ב-Reddit ציינו ש-Cloudflare עדיין מזהה Selenium "גם עם residential proxies" — כלומר, קשה יותר להשיג stealth כברירת מחדל.
הכי מתאים ל: צוותי מפתחים שכבר מושקעים ב-Selenium ולא רוצים לעבור, פרויקטים שדורשים תמיכה רב-שפתית (Java, C#), והגדרות סקרייפינג ותיקות.
10. BeautifulSoup
 BeautifulSoup היא ספריית Python קלת משקל לניתוח HTML ו-XML. הגרסה הנוכחית ב-PyPI היא 4.14.3 (30 בנובמבר 2025).
הבהרה חשובה: BeautifulSoup היא parser, לא scraper מלא. היא לא מביאה דפי אינטרנט ולא מטפלת באוטומציית דפדפן. בדרך כלל משלבים אותה עם הספרייה requests כדי למשוך את ה-HTML, ואז היא מפרקת את ה-HTML שאתם מספקים לה. זה הופך אותה לנקודת כניסה הכי פשוטה למפתחים — אבל גם למוגבלת ביותר.
תכונות מרכזיות:
- קלה מאוד ללמידה — דורשת מעט מאוד קוד
- מצוינת לסקרייפים קטנים או חד-פעמיים ב-Craigslist
- חינם ובקוד פתוח
מגבלות: אין טיפול מובנה ב-pagination, אין rendering ל-JavaScript, אין סיבוב פרוקסים — הכול צריך להתווסף ידנית. אם Craigslist משנה את מבנה ה-HTML שלו, הסלקטורים נשברים ואתם מתקנים אותם ידנית.
הכי מתאים ל: מתחילי Python שרוצים לנסות סקרייפינג של Craigslist עם מינימום הקמה, משיכות נתונים מהירות וחד-פעמיות מקטגוריה או אזור יחיד, ומפתחים שצריכים פשוט parser קל.
ספר ההישרדות נגד חסימות ב-Craigslist: proxies, rate limits ומה גורם לחסימה
זה החלק שרוב מדריכי הסקרייפינג ל-Craigslist מדלגים עליו — והוא גם הכי חשוב. הבדיקות של Scraperly מאפריל 2026 מדרגות את Craigslist כיעד ברמת קושי 3/5, תוך ציון CAPTCHA מותאם, rate limiting וחסימת IP. המדריך של Bright Data דוחף משתמשים לכיוון Web Unlocker או Scraping Browser מבוסס Playwright במקום HTTP פשוט. דף ה-proxy של Oxylabs מציין ש-Craigslist יכול לזהות proxies ושהבחירה הטובה ביותר היא residential proxies.
כך זה באמת עובד:
| אסטרטגיה | יעילות ב-Craigslist | עלות | מורכבות |
|---|---|---|---|
| Residential proxies | ✅ גבוהה | $$ (4–6 דולר ל-GB) | בינונית |
| ISP proxies | ✅ גבוהה | $ (0.60–0.80 דולר ל-IP) | בינונית |
| Datacenter proxies | ⚠️ נמוכה (לרוב נחסמת) | $ (0.20–0.40 דולר ל-IP) | נמוכה |
| סקרייפינג מבוסס דפדפן (סשן אישי) | ✅ בינונית-גבוהה | חינם | נמוכה |
| Rate limiting + השהיות אקראיות | ✅ בסיס חיוני | חינם | נמוכה |
טיפים מעשיים:
- השהיות בין בקשות: לפחות 2–5 שניות בין בקשות. Scraperly מציע להישאר סביב 5–10 בקשות לדקה לכל IP ולבצע סבב אחרי 20–30 בקשות.
- סיבוב סשנים: סובבו user agents ו-browser fingerprints. דפוסי סריקה צפויים נתפסים מהר.
- להימנע מ-datacenter proxies: הם זולים אבל נחסמים מהר ב-Craigslist.
- סקרייפינג מבוסס דפדפן חוסך לגמרי את בעיית ה-proxy בנפחים בינוניים. מצב הדפדפן של Thunderbit פועל בתוך סשן ה-Chrome שלכם — בלי הגדרת proxy, בלי סבב IP-ים, בלי עלות. לרוב המשתמשים העסקיים שמגרדים כמה מאות מודעות, זה לגמרי מספיק.
ועוד נקודה שרבים מפספסים: כש-Craigslist משנה את ה-CSS שלו (וזה קורה מדי פעם), כל scraper שמבוסס CSS selectors נשבר. צריך לבדוק את הדף, למצוא selectors חדשים, לעדכן את הקוד ולבדוק שוב. כלים מבוססי AI כמו Thunderbit עוקפים את זה לחלוטין — ה-AI קורא את מבנה הדף מחדש בכל פעם, כך ששינויים בפריסה לא שוברים את ה-workflow שלכם.
קוד מול ללא קוד: שני walkthroughs מלאים לסקרייפינג של Craigslist
אני יודע שהקהל של המאמר הזה מחולק בערך 50/50: משתמשים עסקיים לא טכניים שרק רוצים את הנתונים, ומפתחים מתחילים-בינוניים שרוצים קוד שעובד. אז הנה שני המסלולים, זה לצד זה.
ללא קוד: איך לגרד Craigslist עם Thunderbit (צעד אחר צעד)
- מתקינים את Thunderbit Chrome Extension מ-Chrome Web Store.
- ניגשים לדף תוצאות ב-Craigslist — למשל, דירות בעיר שלכם (
https://yourcity.craigslist.org/search/apa). - לוחצים על "One Click Extract" — ה-AI של Thunderbit קורא את הדף, מבין את המבנה, מחליט אילו עמודות מתאימות לקטגוריה, וממלא טבלה מובנית בפעולה אחת. בדיור תראו Title, Price, Sqft, Bedrooms, Location, Date Posted, Link. אפשר להתאים כל עמודה אחר כך אם רוצים משהו אחר.
- מטפלים ב-pagination — עוברים בין הדפים או נותנים ל-Thunderbit לטפל בזה.
- משתמשים ב-"Scrape Subpages" כדי להיכנס לכל מודעה בנפרד ולהעשיר אותה בשדות מדף הפירוט: תיאור מלא, כל התמונות, פרטי קשר מוטמעים.
- מייצאים ל-Google Sheets, Excel, Airtable, Notion או CSV — בחינם.
כל התהליך לוקח בערך 2 דקות עבור דף תוצאות. בלי CSS selectors, בלי proxies, בלי קוד.
מסלול קוד: איך לגרד Craigslist עם Python + Playwright
Playwright היא הספרייה המומלצת ביותר לסקרייפינג של Craigslist בפורומי מפתחים ב-2026. הנה קטע Python עובד שמגרד דף תוצאות של דיור ב-Craigslist, מחלץ title/price/link, מטפל ב-pagination ומייצא תוצאות.
הגישה: קודם מנסים JSON-LD structured data (לפעמים Craigslist מטמיע schema מסוג ItemList בדפים מסוימים), ואז נופלים חזרה ל-DOM selectors. דפדוף לפי s=120.
import asyncio, json
from urllib.parse import urlparse, parse_qs, urlencode, urlunparse
from playwright.async_api import async_playwright

def next_page_url(url, step=120):
    p = urlparse(url)
    qs = parse_qs(p.query)
    offset = int(qs.get("s", ["0"])[0]) + step
    qs["s"] = [str(offset)]
    return urlunparse((p.scheme, p.netloc, p.path, "", urlencode(qs, doseq=True), ""))

async def scrape_page(page, url):
    await page.goto(url, wait_until="domcontentloaded")
    await page.wait_for_timeout(1500)
    data = []
    # Try JSON-LD first
    for raw in await page.locator('script[type="application/ld+json"]').all_text_contents():
        try:
            obj = json.loads(raw)
        except Exception:
            continue
        if isinstance(obj, dict) and obj.get("@type") == "ItemList":
            for item in obj.get("itemListElement", []):
                thing = item.get("item", {})
                data.append({
                    "title": thing.get("name"),
                    "price": thing.get("offers", {}).get("price"),
                    "link": thing.get("url"),
                })
            if data:
                return data
    # Fallback: DOM selectors
    cards = page.locator("div.cl-search-result, li.cl-static-search-result")
    count = await cards.count()
    for i in range(count):
        card = cards.nth(i)
        title = await card.locator("a.posting-title, a.titlestring").first.text_content()
        link = await card.locator("a.posting-title, a.titlestring").first.get_attribute("href")
        price = (await card.locator(".price, .result-price").first.text_content()
                 if await card.locator(".price, .result-price").count() else None)
        data.append({"title": (title or "").strip(), "price": (price or "").strip(), "link": link})
    return data

async def main():
    start_url = "https://newyork.craigslist.org/search/apa?query=studio"
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        url = start_url
        all_rows = []
        for _ in range(3):  # scrape 3 pages
            rows = await scrape_page(page, url)
            if not rows:
                break
            all_rows.extend(rows)
            url = next_page_url(url)
        await browser.close()
        for row in all_rows[:10]:
            print(row)

asyncio.run(main())
מה תצטרכו מעבר לסקריפט הזה: התקנה של Playwright (pip install playwright && playwright install), הגדרת proxy להרצות בנפח גבוה, וטיפול ידני ב-CAPTCHA אם תגיעו ל-rate limits. זה הטרייד-אוף: שליטה מלאה, אבל גם אחריות מלאה.
חינם מול בתשלום: פירוט עלויות כנה לכל scraper של Craigslist
זאת הטבלה שהייתי רוצה שתהיה לי כשהתחלתי לחקור את הנושא. "חינם" היא מילה טעונה בעולם ה-web scraping.
| כלי | באמת חינמי לגמרי? | מגבלות בתוכנית החינמית | מחיר התחלתי בתשלום | עלויות נסתרות |
|---|---|---|---|---|
| Thunderbit | תוכנית חינמית (6 דפים) | 6 דפים/חודש; ניסיון חינם = 10 דפים | תוכניות בתשלום לנפח גבוה יותר | אין — הייצוא חינמי |
| Scrapy | ✅ קוד פתוח | ללא הגבלה | $0 | עלויות proxy, אחסון, תחזוקה |
| BeautifulSoup | ✅ קוד פתוח | ללא הגבלה | $0 | עלויות proxy, אחסון, תחזוקה |
| Playwright | ✅ קוד פתוח | ללא הגבלה | $0 | עלויות proxy, אחסון, תחזוקה |
| Selenium | ✅ קוד פתוח | ללא הגבלה | $0 | עלויות proxy, אחסון, תחזוקה |
| ParseHub | תוכנית חינמית | 5 פרויקטים | כ-189 דולר לחודש | הרצות מתוזמנות מוגבלות בחינם |
| Apify | תוכנית חינמית | קרדיטים בשווי 5 דולר לחודש בחינם | כ-49 דולר לחודש | תמחור לפי compute יכול לזנק |
| Phantombuster | תוכנית חינמית | 5 slots, 2 שעות/חודש, ייצוא של 10 שורות | כ-56 דולר לחודש (שנתי) | תמחור לפי slot |
| Bright Data | ניסיון בלבד | 1,000 בקשות/שבוע אחד | כ-500+ דולר לחודש | עלויות proxy נפרדות |
| Oxylabs | ניסיון בלבד | 2,000 תוצאות / 1GB | כ-75+ דולר לחודש (Unblocker) | תמחור enterprise |
הכוכבית הגדולה ליד כלי open-source "חינמיים": Scrapy, Playwright, Selenium ו-BeautifulSoup עולים $0 להתקנה, אבל הרצה שלהם בקנה מידה על Craigslist דורשת שעות של זמן מפתח להקמה, 50–500+ דולר לחודש עבור residential proxies, ותחזוקה שוטפת בכל פעם ש-Craigslist משנה את ה-HTML שלו. ה-AI של Thunderbit קורא את הדף מחדש בכל פעם (אפס תחזוקה), הייצוא חינמי, וסקרייפינג מבוסס דפדפן מבטל עלויות proxy בנפחים בינוניים. זה יתרון אמיתי למי שלא מפתח.
מה באמת אפשר לחלץ: שדות נתונים של Craigslist לפי קטגוריה
לקטגוריות שונות ב-Craigslist יש מבני נתונים שונים לגמרי. מודעת דיור לא נראית כמו מודעת דרושים. הנה מה שבאמת אפשר לחלץ מכל חלק מרכזי:
| קטגוריית Craigslist | שדות שאפשר לחלץ | יש פרטי קשר? |
|---|---|---|
| דיור / דירות | Title, Price, Sqft, Bedrooms, Bathrooms, Location, Date, Images, Description, Map Link, Availability, Pet Policy, Laundry/Parking | ⚠️ לפעמים (email relay אנונימי) |
| למכירה | Title, Price, Condition, Location, Date, Images, Description, Make/Model/Year (משתנה) | ⚠️ לפעמים |
| Jobs | Title, Company, Compensation, Location, Job Type, Experience Level, Date, Description | לעיתים נדירות (רק קישור להגשה) |
| שירותים | Title, Location, Description, Images | ⚠️ לפעמים |
| Gigs | Title, Compensation, Location, Date, Description | ⚠️ לפעמים |
כמה הערות חשובות:
- פרטי קשר: Craigslist משתמש ב-email relays אנונימיים במיוחד כדי למנוע סקרייפינג ישיר של כתובות מייל. כלים שטוענים שהם "מחלצים emails" לרוב שולפים את כתובת ה-relay (
reply+randomstring@craigslist.org) ולא את המייל האמיתי של המפרסם. - שדות מדף פירוט כמו תיאור מלא, כל התמונות ופרטי קשר מוטמעים מופיעים רק כשנכנסים לכל מודעה בנפרד — לא בדף תוצאות החיפוש.
- ה-"One Click Extract" של Thunderbit מזהה אוטומטית אילו שדות זמינים בדף הנוכחי ומציע מבנה עמודות נכון. מי שמגרד דיור מקבל עמודות sqft/bedrooms; מי שמגרד משרות מקבל compensation/job-type — בלי תצורה ידנית. לאחר מכן, scraping של תתי-דפים נכנס לכל מודעה כדי למשוך את השדות שקיימים רק בדף הפירוט.
בדיקת מציאות משפטית: תנאי השימוש של Craigslist, תיק 3Taps ומה חשוב לדעת
אני לא עורך דין, וזה לא ייעוץ משפטי. אבל אני יודע שמשתמשים מודאגים מזה, ומגיע להם מענה ישיר.
התקדים המרכזי: ב-Craigslist v. 3Taps (2013), Craigslist קיבלה צו מניעה נגד 3Taps על סקרייפינג ופרסום מחדש של מודעות אחרי מכתב התראה. לפי הטענות, 3Taps עקפה חסימות IP באמצעות שרתי proxy, ובית המשפט התייחס לגישה לאחר החסימה כאל גישה שעשויה להיות "ללא הרשאה". ה-EFF ציין שהתיק הסתיים בפשרה ב-2015.
תנאי השימוש של Craigslist אוסרים במפורש שימוש ב"robots, spiders, scripts, scrapers, crawlers, or any automated or manual equivalent" כדי לעבוד מול האתר. הם אפילו קובעים פיצוי מוסכם של 0.25 דולר לכל דף לאחר 1,000 צפיות הדף הראשונות בתוך 24 שעות במקרה של הפרה.
הנחיות מעשיות:
- ✅ גרדו נתונים ציבוריים של מודעות לצורכי מחקר שוק או שימוש אישי
- ✅ כבדו robots.txt ו-rate limits
- ⚠️ אל תפרסמו מחדש בכמויות גדולות מודעות שנגרדו
- ⚠️ אל תשתמשו בפרטי קשר שנגרדו לשיווק לא רצוי
- ❌ אל תעקפו הגבלות גישה טכניות אחרי שחסמו אתכם
ההבחנה חשובה: סקרייפינג של נתונים ציבוריים ונראים לעין לצורך ניתוח עצמי שונה מפרסום מחדש בקנה מידה או איסוף מיילים לספאם. אבל חשוב לזכור ש-Craigslist בעבר עבר מאכיפת תנאים, לחסימות IP, ועד פעולה משפטית.
איזה scraper של Craigslist הכי מתאים לכם?
אחרי בדיקה והערכה של כל 10 הכלים, הנה ההמלצה שלי לפי תרחישים:
- משתמש עסקי לא טכני שצריך נתוני Craigslist מהר → Thunderbit. בלי קוד, זיהוי שדות מבוסס AI, אפס תחזוקה, ייצוא חינם. הנתיב המהיר ביותר מ"אני צריך את הנתונים האלה" ל"הם כבר בגיליון שלי".
- צוות enterprise שמגרד אלפי מודעות ביום בכל האזורים → Bright Data. scraper ייעודי ל-Craigslist, תשתית proxies ענקית, פתרון CAPTCHA אוטומטי, תמיכה ייעודית.
- צוות מפתחים שצריך תשתית API/proxy מנוהלת → Oxylabs לתהליכים מבוססי proxy, או Apify לגמישות של marketplace של actors.
- מפתח שרוצה שליטה והתאמה מלאה → Scrapy + Playwright. קוד פתוח, גמישות מקסימלית, אבל תביאו proxies ותחזוקה משלכם.
- משתמש עם תקציב מוגבל וצרכים מתונים → Apify בתוכנית החינמית ($5 קרדיטים לחודש) או ParseHub בתוכנית החינמית (5 פרויקטים).
- צוות מכירות שכבר משתמש בכלי לידים רב-פלטפורמיים → Phantombuster. מוסיפים את Craigslist לצינור הקיים.
- מתחיל ב-Python שעושה סקרייפ חד-פעמי → BeautifulSoup + requests. מינימום קוד, מינימום הקמה, מינימום יכולת.
עבור רוב המשתמשים העסקיים הלא-טכניים, Thunderbit מציע את האיזון הטוב ביותר בין קלות, דיוק ועלות. עבור מפתחים, Scrapy + Playwright הוא השילוב החזק ביותר. עבור סקייל ארגוני, Bright Data קשה מאוד לנצח.
אם אתם רוצים לראות איך נראה בפועל סקרייפינג של Craigslist מבוסס AI, נסו את Thunderbit — התוכנית החינמית מספיקה כדי לבדוק אותו על המקרה שלכם. ואם תרצו להעמיק בטכניקות web scraping, בדקו את המדריכים שלנו על איך לגרד ל-Google Sheets, הכלים האוטומטיים הטובים ביותר ל-web scraping, ו-web scraping בלי להיחסם. אפשר גם להיכנס ל-ערוץ YouTube שלנו להדרכות וידאו צעד-אחר-צעד.
סקרייפינג נעים — ושכל הנתונים שלכם יהיו תמיד נקיים, מובנים ומוכנים לפעולה.
שאלות נפוצות
האם זה חוקי לגרד מודעות מ-Craigslist?
תנאי השימוש של Craigslist אוסרים במפורש סקרייפינג אוטומטי, ותיק Craigslist v. 3Taps הוא התקדים המשפטי המוביל בנושא. סקרייפינג של נתונים ציבוריים לצורכי שימוש אישי או אנליטי בדרך כלל נבחן אחרת מפרסום מחדש המוני או ספאם, אבל תמיד חשוב לכבד rate limits ואת כללי האתר — וזה לא ייעוץ משפטי.
אפשר לגרד את Craigslist בלי לכתוב קוד?
כן. כלים כמו Thunderbit, ParseHub ו-Apify מציעים אפשרויות ללא קוד או עם מעט קוד לחילוץ נתונים מ-Craigslist. זיהוי השדות מבוסס ה-AI של Thunderbit הופך את זה לקל במיוחד — פשוט לוחצים על "One Click Extract" ואז "Scrape".
מהו ה-Craigslist scraper החינמי הטוב ביותר?
למפתחים, Scrapy או BeautifulSoup הם חינמיים לגמרי ובקוד פתוח (אם כי עלויות proxy ותחזוקה מצטברות). למי שלא כותב קוד, התוכנית החינמית של Thunderbit (6 דפים לחודש) היא נקודת ההתחלה הטובה ביותר, עם התוכנית החינמית של ParseHub (5 פרויקטים) כאופציה נוספת.
איך נמנעים מחסימה כשמגרדים את Craigslist?
משתמשים ב-rate limiting (לפחות 2–5 שניות השהיה בין בקשות), מסובבים user agents, נמנעים מ-datacenter proxies (residential או ISP proxies עובדים הרבה יותר טוב ב-Craigslist), ולא עובדים בדפוסי סריקה צפויים. בנפחים בינוניים, כלים מבוססי דפדפן כמו Thunderbit עוקפים לגמרי את בעיית ה-proxy על ידי הרצה בתוך סשן ה-Chrome שלכם.
אפשר לגרד את כל אזורי Craigslist בבת אחת?
עם כלי מפתחים כמו Scrapy או Playwright, אפשר לולא פרוגרמטית על כל 416 כתובות האזורים בארה"ב/טריטוריות. כלים ארגוניים כמו Bright Data ו-Oxylabs מגיעים עם סקרייפינג רב-אזורי מובנה. עם Thunderbit, אפשר לפתוח כל אתר אזורי ולגרד באותו workflow — ה-AI מתאים את עצמו לכל דף אוטומטית.
נסו את Thunderbit לסקרייפינג של Craigslist Get Started Free
למידע נוסף



