
Trustpilot réunit 361 millions d'avis actifs sur 1,27 million d'entreprises — et la plupart des extracteurs conçus pour récupérer ces données ne tiennent plus la route depuis plusieurs mois. Si tu as essayé d’extraire des avis récemment, tu es sans doute tombé sur le fameux mur de connexion à la page 10 et tu as vu ton outil ne renvoyer qu’une erreur.
J’ai passé les dernières semaines à tester, creuser et comparer les outils qui arrivent encore à extraire de façon fiable les avis Trustpilot en 2026. Le décor a beaucoup changé : les protections anti-bot de Trustpilot sont plus costaudes, son interface Next.js génère des noms de classes qui bougent à chaque déploiement et — surtout — l’accès sans authentification s’arrête désormais après seulement 10 pages d’avis. Un fil Reddit de fin 2025 résumait parfaitement la frustration : « aucun des acteurs de la boutique ne fonctionne ».
Alors, quels outils tiennent vraiment la route ? J’en ai évalué cinq selon leur capacité à gérer le mur de connexion, les mécanismes anti-bot, l’effort de maintenance, ainsi que les besoins concrets des équipes marketing et des développeurs.
Pourquoi extraire des avis Trustpilot est plus difficile qu’il n’y paraît en 2026
Trustpilot n’est pas un simple site statique qu’on interroge avec une requête HTTP basique avant de le parser avec BeautifulSoup. C’est une plateforme moderne, rendue dynamiquement avec Next.js, dont les défenses se sont nettement renforcées au cours de l’année écoulée.
Ce à quoi tu fais vraiment face :
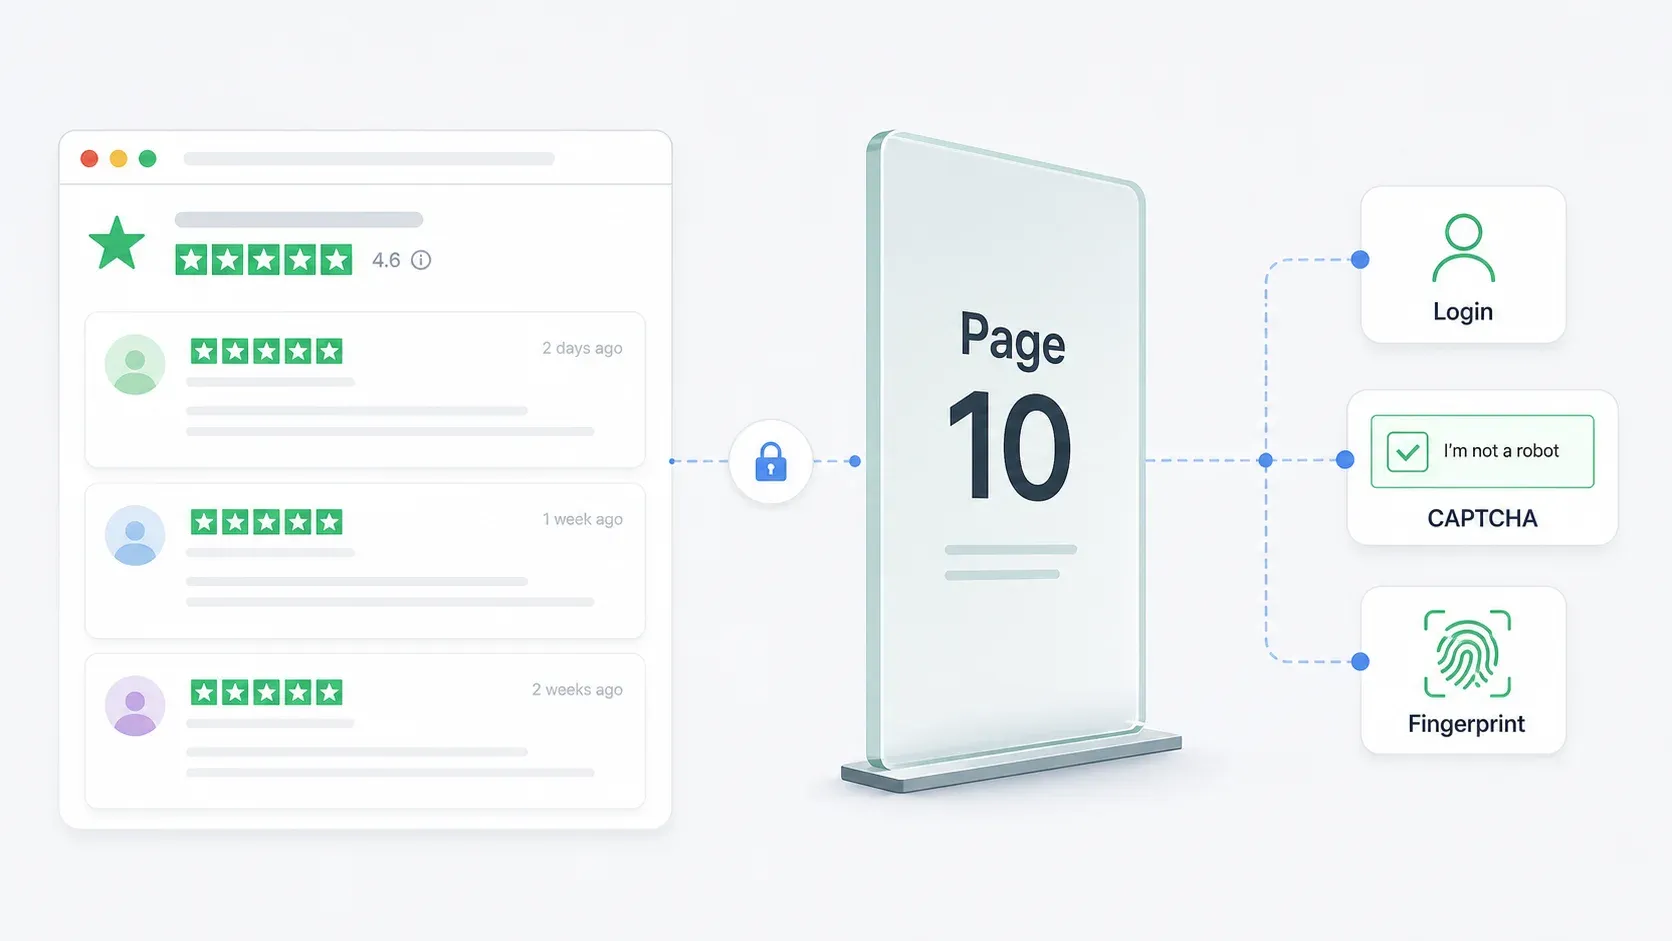
Le mur de connexion de la page 10. C’est le principal point de blocage. Le guide Trustpilot de Web Scraper publié en mars 2026 confirme que Trustpilot n’autorise que les 10 premières pages d’avis avant d’afficher une invite de connexion. Pour une entreprise qui a 2 000 avis (soit environ 100 pages à 20 avis par page), tu perds 90 % des données, sauf si tu disposes d’une session authentifiée.
Les protections anti-bot. Trustpilot utilise reCAPTCHA, le blocage par session, le filtrage des requêtes au niveau CDN et l’empreinte navigateur. Sa page À propos indique clairement que le site est « protégé par reCAPTCHA » et qu’il collecte des signaux liés à l’appareil et aux interactions.
Les noms de classes CSS dynamiques. Comme Trustpilot utilise Next.js avec des CSS modules, des noms comme styles_reviewCardInner__EwDq2 sont générés au moment du build et changent à chaque mise à jour. Le tutoriel de ScraperAPI repose justement sur ces sélecteurs exacts — ce qui veut dire que tout code qui suit ce guide cassera dès la prochaine modif du front-end de Trustpilot.
Les changements de structure DOM. Au-delà des noms de classes, la hiérarchie HTML elle-même peut évoluer. Les éléments sont imbriqués différemment, de nouveaux conteneurs apparaissent et les composants de pagination sont réorganisés.
Les extracteurs basés sur des sélecteurs CSS — qu’il s’agisse d’Apify Actors, de workflows Octoparse ou de scripts Python personnalisés — sont structurellement fragiles sur Trustpilot. Ils marchent... jusqu’au moment où ils ne marchent plus. Et ce moment arrive souvent en quelques semaines, pas en quelques mois.
Ce que nous avons recherché dans les meilleurs extracteurs d'avis Trustpilot
Je n’ai pas évalué ces outils sur le critère générique « savent-ils extraire une page web ? ». Tous les outils de cette liste peuvent récupérer des données depuis une page HTML simple.
La vraie question : peuvent-ils gérer Trustpilot spécifiquement, avec toutes ses particularités, en 2026 ?
Voici ce qui comptait le plus :
| Critère | Pourquoi c'est important pour Trustpilot |
|---|---|
| Gestion du mur de connexion (page 10+) | La plupart des entreprises ont bien plus de 200 avis. Une limite de 10 pages signifie que tu perds la majorité des données historiques. |
| Méthode de contournement anti-bot | reCAPTCHA, blocage de session et filtrage CDN stoppent net les extracteurs naïfs. |
| Résilience des sélecteurs / maintenance | Les classes CSS générées cassent régulièrement les outils basés sur des sélecteurs. L’outil s’auto-répare-t-il ? |
| Gestion de la pagination | Les avis s’étendent sur des centaines de pages. Une extraction manuelle page par page n’est pas réaliste. |
| Sans code vs. besoin de code | Les marketeurs ont besoin d’un clic ; les développeurs veulent un contrôle total. |
| Tarification / offre gratuite | Les équipes qui surveillent le budget ont besoin d’une vision claire avant de s’engager. |
| Options d'export | Les utilisateurs métier ont besoin de Google Sheets, Airtable, Notion — pas seulement de JSON brut. |
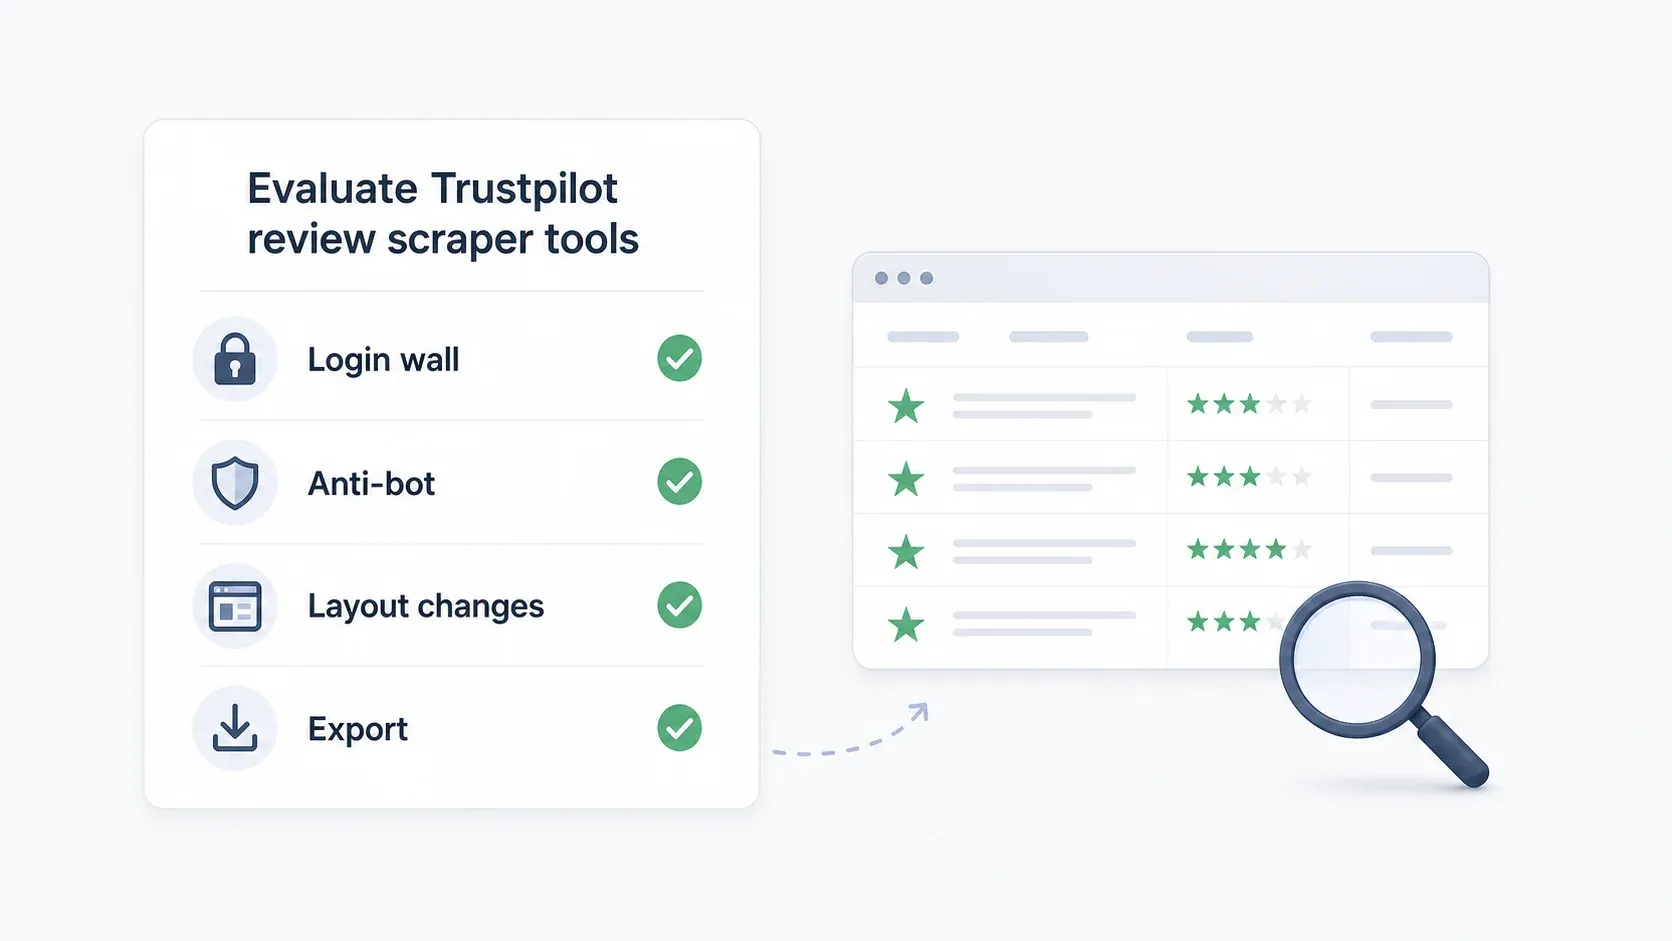
Le mur de connexion est le point décisif.
Si un outil ne peut pas dépasser la page 10 — ou au minimum offrir une solution claire pour l’accès authentifié — ce n’est pas un extracteur Trustpilot viable en 2026.
Les meilleurs extracteurs d'avis Trustpilot en un coup d'œil
La comparaison complète :
| Outil | Niveau technique | Gestion du mur de connexion | Approche anti-bot | Pagination | Offre gratuite | Options d'export |
|---|---|---|---|---|---|---|
| Thunderbit | Sans code | Mode navigateur (utilise votre session Chrome connectée) | L’extraction sémantique IA s’adapte aux changements de mise en page | Détection automatique, multi-pages | 6 pages gratuites/mois | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Dépend de l’Actor ; certains exigent une configuration des cookies pour les pages >10 | Rotation de proxies intégrée, spécifique à l’Actor | Paramétrable selon l’Actor | 5 $ de crédits plateforme / mois | JSON, CSV, Excel, XML, RSS |
| Octoparse | Sans code (visuel) | Configuration manuelle des cookies / session | Rotation d’IP, proxies résidentiels, résolution de CAPTCHA (payant) | Workflow clic / défilement | Offre gratuite + essai premium de 14 jours | CSV, Excel, JSON, HTML, XML, bases de données |
| Web Scraper | Sans code (sitemap) | Limité — leur propre guide documente une limite de 10 pages d’avis | Cloud + proxy sur les offres payantes | Paramétrable ; clic JavaScript recommandé | Extension Chrome gratuite | CSV, XLSX |
| ScraperAPI | Développeur (Python) | Gestion de session / cookies au niveau du code | Plus de 40 M de proxies résidentiels, rendu JS, gestion du CAPTCHA | Basé sur le code | Essai de 7 jours, 5 000 crédits API | Définis par le développeur (CSV, JSON, etc.) |
1. Thunderbit

Thunderbit est une extension Chrome boostée à l’IA, pensée pour les équipes métier qui veulent des données structurées depuis des sites web sans écrire de code. Pour Trustpilot, elle propose un modèle dédié à l'extraction d'avis qui récupère en un clic le nom de l’auteur, la note, le titre de l’avis, le texte, la date et la réponse de l’entreprise.
Je ne suis pas totalement neutre — je travaille ici — mais si nous avons conçu Thunderbit comme ça, c’est précisément parce que l’extraction sur Trustpilot est compliquée. Notre IA lit les pages de manière sémantique plutôt que de s’appuyer sur des sélecteurs CSS. Quand Trustpilot change ses noms de classes ou réorganise son DOM, Thunderbit s’adapte, parce qu’il cherche le sens des éléments de la page, et non leur adresse HTML exacte.
Essayez Thunderbit pour extraire Trustpilot
Comment Thunderbit gère le mur de connexion de la page 10
C’est là que le mode navigateur fait toute la différence. Thunderbit fonctionne dans ton navigateur Chrome — le même navigateur dans lequel tu es déjà connecté à Trustpilot. Quand tu passes en mode extraction dans le navigateur, l’extension lit les pages visibles dans ta session authentifiée. Pas de jonglage avec des proxies. Pas d’injection de cookies. Pas de pools de sessions Playwright.
Le flux de travail concret : connecte-toi à Trustpilot dans Chrome, ouvre la page d’avis qui t’intéresse, puis lance l’extension. En un clic, l’IA identifie les champs d’avis présents sur la page et lance l’extraction. Tu veux un autre découpage des données ? Décris-le, et l’IA s’adapte. La pagination se fait ensuite automatiquement — Thunderbit parcourt toutes les pages accessibles depuis ta session navigateur.
Pourquoi Thunderbit ne casse pas quand Trustpilot change
Notre page modèle Trustpilot met ce point en contraste : les extracteurs traditionnels cassent quand la mise en page évolue et qu’il faut mettre à jour les sélecteurs CSS. Thunderbit utilise une IA sémantique qui comprend le contenu sans dépendre de CSS spécifiques, gère le contenu dynamique et automatise la pagination.
Compare ça au code du tutoriel de ScraperAPI, qui parse à partir de classes comme styles_reviewCardInner__EwDq2. Ce sélecteur cassera à la prochaine mise à jour de Trustpilot. L’IA de Thunderbit demande « où se trouve le texte de l’avis sur cette page ? » plutôt que « que contient exactement cette div ? ».
Fonctionnalités clés pour l'extraction Trustpilot
- Champs détectés par l’IA : l’extension repère elle-même les champs d’avis (nom, note, date, titre, texte, réponse de l’entreprise) sans configuration manuelle — ou, si tu as un besoin précis, tu l’indiques et elle s’y conforme
- Workflow en un clic : un clic → le tableau final. C’est tout.
- Mode navigateur pour les pages nécessitant une connexion : fonctionne dans ta session Chrome authentifiée pour accéder aux pages 10+
- Pagination automatique : gère les ensembles d’avis multi-pages sans intervention manuelle
- Extraction de sous-pages : peut visiter les profils d’auteurs pour enrichir les données
- Extraction planifiée : mets en place un suivi hebdomadaire ou mensuel pour la veille réputationnelle
- Exports : Google Sheets, Airtable, Notion, CSV, JSON — tout est inclus gratuitement
Tarification
- Offre gratuite : 6 pages/mois, sans carte bancaire
- Système basé sur des crédits : 1 crédit = 1 ligne de sortie
- Offres payantes : 15 $/mois, ou environ 9 $/mois en facturation annuelle (page tarifaire)
Idéal pour : les équipes marketing, les équipes opérations et les utilisateurs métier qui ont besoin d’avis Trustpilot sans toucher au code — et qui ne veulent pas maintenir un extracteur qui casse toutes les quelques semaines.
2. Apify
Apify est une plateforme d’extraction cloud avec une place de marché d’« Actors » prêts à l’emploi — des modèles d’extraction créés par d’autres utilisateurs ou par l’équipe Apify. Pour Trustpilot, la boutique contient plusieurs Actors maintenus par la communauté, avec une fiabilité variable.
Le compromis avec Apify : c’est puissant, mais fragmenté. Certains Actors fonctionnent. D’autres sont obsolètes. D’autres exigent des cookies pour les pages 10+. Et les plaintes Reddit du type « aucun des acteurs de la boutique ne fonctionne » sont bien réelles — elles reflètent à quelle vitesse les changements de Trustpilot peuvent casser la logique propre à chaque Actor.
Actors Trustpilot et limites connues
L'Apify Store contient plusieurs Actors Trustpilot. Au moins l’un d’eux (du développeur « burbn ») indique explicitement qu’un cookie est nécessaire au-delà de la page 10. D’autres affichent des notes de 0,0, très peu d’utilisateurs ou des dates de modification très récentes — autant de signaux que la maintenance est en cours et que la fiabilité varie.
Les Actors obsolètes méritent aussi d’être mentionnés. L’un d’eux lisait directement le JSON __NEXT_DATA__ intégré par Trustpilot — une approche futée, plus rapide qu’un parsing du DOM, mais qui a tout de même cassé lorsque Trustpilot a modifié sa structure de données.
Gestion du mur de connexion et des protections anti-bot
- Mur de connexion : dépend entièrement de l’Actor choisi. Certains prennent en charge l’injection de cookies pour les pages 10+ ; d’autres non.
- Anti-bot : la plateforme Apify inclut la rotation de proxies et une infrastructure basée sur les compute units. Des proxies résidentiels sont disponibles à 8 $/Go sur les offres Free/Starter.
- Maintenance : lorsqu’un Actor casse, tu attends que son mainteneur le corrige, tu bascules vers un autre Actor ou tu fais développer un Actor privé sur mesure.
Tarification
- Offre gratuite : 5 $ de crédits d’utilisation prépayés par mois, sans carte bancaire
- Starter : 9 $/mois + facturation à l’usage
- Scale : 99 $/mois + facturation à l’usage
- Exports : JSON, CSV, Excel, XML, RSS (selon l’Actor)
Idéal pour : les utilisateurs à l’aise techniquement, capables d’évaluer plusieurs Actors, de configurer les cookies et de dépanner quand ça casse. Pas l’option idéale pour les équipes qui veulent une solution qu’on met en place puis qu’on oublie.
3. Octoparse
Octoparse est un extracteur sans code basé sur bureau, avec un constructeur visuel en clic-déclenchement. Il se situe entre la simplicité d’un clic de Thunderbit et le contrôle complet de ScraperAPI : tu profites d’une configuration visuelle sans code, mais tu dois quand même construire et maintenir un workflow.
Mettre en place une extraction Trustpilot dans Octoparse
Le workflow est simple, mais manuel :
- Colle l’URL de la page d’avis Trustpilot d’une entreprise
- Sélectionne visuellement les éléments d’avis (titre, contenu, note, date, nom de l’auteur)
- Définis une boucle de pagination via le bouton page suivante
- Configure les temps d’attente (2 à 5 secondes recommandées pour éviter reCAPTCHA)
- Lance l’extraction en local pour les petits volumes ou dans le cloud pour les tâches plus importantes
La prise en main prend 10 à 15 minutes pour quelqu’un qui connaît déjà l’outil. Le point de vigilance : comme Octoparse repose sur des sélecteurs visuels liés aux éléments du DOM, il faudra mettre à jour ton workflow à chaque changement de structure de page chez Trustpilot.
Gestion du mur de connexion et des protections anti-bot
- Mur de connexion : nécessite une connexion / configuration manuelle des cookies / session. Rien n’est géré automatiquement.
- Anti-bot : les offres payantes incluent la rotation d’IP, des proxies résidentiels (3 $/Go) et la résolution automatique des CAPTCHA (1 à 1,5 $ par millier).
- Maintenance : modérée. Attends-toi à reconstruire ou ajuster ton workflow quand Trustpilot met à jour son front-end.
Tarification
- Offre gratuite : gratuite à vie, 10 tâches, 1 appareil, extraction locale, jusqu’à 50 000 lignes/mois
- Standard : 69 $/mois (facturé annuellement)
- Professional : 149 $/mois
- Essai premium de 14 jours : inclut l’extraction cloud, la planification, l’API et les modèles
- Exports : Excel, CSV, JSON, HTML, XML ; bases de données et Google Sheets sur les niveaux supérieurs
Idéal pour : les utilisateurs qui veulent un contrôle visuel du workflow, qui ne sont pas dérangés par une configuration initiale, et qui acceptent de maintenir leurs workflows lorsque les pages changent. Bon choix pour les équipes qui ont besoin de plus de personnalisation qu’un outil en un clic, sans la complexité d’un script Python.
4. Web Scraper
Web Scraper est une extension Chrome et une plateforme cloud reposant sur une approche par sitemap. Son offre Trustpilot la plus solide est un modèle préconstruit pour les pages d’entreprises qui extrait des données au niveau de la société : nom, catégorie, adresse, note, nombre d’avis, TrustScore et URL du site.
Pour l’extraction d’avis à proprement parler, Web Scraper présente une limitation documentée qu’il faut signaler.
Modèle prêt à l'emploi vs configuration personnalisée
Le modèle de la place de marché fonctionne bien pour découvrir des entreprises — en extrayant les profils d’entreprises dans les catégories Trustpilot. Pour une extraction d’avis personnalisée, le Sitemap Wizard permet de construire un extracteur visuellement dans l’extension Chrome.
Le guide Web Scraper de mars 2026 recommande une pagination par clic JavaScript plutôt qu’une pagination basée sur l’URL, car Trustpilot peut réorganiser dynamiquement le contenu entre les pages, ce qui décale les résultats.
Gestion du mur de connexion et des protections anti-bot
C’est là qu’il faut être franc : le guide officiel de Web Scraper indique clairement que Trustpilot n’autorise que les 10 premières pages d’avis avant d’afficher une invite de connexion. Le guide documente cette limite comme une contrainte connue, sans proposer de contournement.
- Mur de connexion : gestion limitée. La limite de 10 pages d’avis est documentée dans leur propre guide.
- Anti-bot : les offres cloud incluent la prise en charge des proxies ; le guide recommande des délais de 2 à 5 secondes et une concurrence réduite.
- Pagination : configurable, mais en pratique limitée aux 10 premières pages pour l’accès non authentifié.
Tarification
- Extension Chrome gratuite : extraction locale, fonctionnalités limitées
- Project : 50 $/mois (5 000 crédits URL)
- Professional : 100 $/mois (20 000 crédits URL)
- Scale : à partir de 200 $/mois (crédits URL illimités sous conditions)
- Essai gratuit de 7 jours sur les offres cloud payantes
- Exports : CSV, XLSX
Idéal pour : les utilisateurs qui veulent un modèle prêt à l’emploi pour extraire les profils d’entreprises Trustpilot, ou qui n’ont besoin que des avis des 10 premières pages. Ce n’est pas le bon choix si tu as besoin de l’historique complet des avis pour des entreprises très notées.
5. ScraperAPI
ScraperAPI est une infrastructure d’extraction pour développeurs — pas un outil en clic, mais une couche de proxy et de rendu qui gère les protections anti-bot pendant que tu écris la logique d’analyse. Sa page solution Trustpilot met en avant le rendu JS, la gestion du CAPTCHA et plus de 40 M de proxies.
Si tu es développeur Python et que tu veux un contrôle total sur la logique d’extraction, ScraperAPI te fournit l’infrastructure.
Mais tu gardes aussi la maintenance.
Construire un extracteur Trustpilot personnalisé avec ScraperAPI
Le tutoriel de janvier 2026 de ScraperAPI montre un workflow Python + BeautifulSoup :
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
Le code final du tutoriel définit pages_to_scrape = 10 — ce qui reconnaît implicitement la limite publique de pages. Pour la page 10+, les développeurs doivent gérer eux-mêmes les sessions authentifiées, les cookies et les jetons.
Gestion du mur de connexion et des protections anti-bot
- Mur de connexion : gestion des sessions / cookies au niveau du code requise. ScraperAPI gère les proxies et le rendu ; tu gères la logique d’authentification.
- Anti-bot : pool de proxies résidentiels avec rotation automatique des IP, rendu JS via
render=true, gestion du CAPTCHA grâce à une rotation intelligente des proxies. Disponible sur toutes les offres. - Maintenance : lorsque Trustpilot change ses classes CSS (ce qu’il fait régulièrement), tu dois mettre à jour ton code d’analyse. Le sélecteur
styles_reviewCardInner__EwDq2du tutoriel est déjà une bombe à retardement.
Tarification
- Essai de 7 jours : 5 000 crédits API gratuits, sans carte bancaire
- Hobby : 49 $/mois (100 000 crédits API)
- Startup : 149 $/mois (1 000 000 de crédits)
- Business : 299 $/mois (3 000 000 de crédits)
- Exports : tout ce que ton code produit (généralement CSV, JSON, écritures en base de données)
Idéal pour : les développeurs qui veulent une personnalisation totale, qui peuvent maintenir leurs propres scripts de parsing et qui ont besoin d’un contrôle programmatique sur la gestion des sessions, la logique de pagination et la structure des données. Pas destiné aux utilisateurs non techniques.
Pourquoi les extracteurs Trustpilot cassent sans cesse (et comment choisir un outil qui tient)
C’est le facteur le plus sous-estimé dans le choix d’un extracteur Trustpilot. La vraie question n’est pas « est-ce que cet outil fonctionne aujourd’hui ? », mais « fonctionnera-t-il encore dans trois semaines ? »
Les extracteurs cassent sur Trustpilot pour quatre raisons récurrentes :
-
Changements de classes CSS générées. Les modules CSS de Next.js produisent des noms comme
styles_reviewCardInner__EwDq2. Ceux-ci changent à chaque déploiement front-end. Tout extracteur ciblant ces classes casse. -
Évolutions de la structure DOM. Trustpilot peut réorganiser sa hiérarchie HTML — imbriquer les cartes d’avis autrement, modifier les conteneurs, déplacer les métadonnées.
-
Modification des déclencheurs anti-bot. Les seuils reCAPTCHA évoluent. La rotation des jetons de session devient plus agressive. Les règles de filtrage CDN sont mises à jour.
-
Changements d’authentification / de session. Le mur de connexion de la page 10 a été introduit (ou appliqué plus strictement) fin 2025. D’autres restrictions d’accès peuvent apparaître à tout moment.
La différence architecturale fondamentale se situe entre l’extraction basée sur des sélecteurs et l’extraction sémantique :
-
Les outils basés sur des sélecteurs (Actors Apify, workflows Octoparse, scripts ScraperAPI, sitemaps Web Scraper) demandent : « Trouve l’élément à ce chemin CSS exact. » Quand le chemin change, ils échouent silencieusement ou renvoient des données vides.
-
Les outils sémantiques / IA (Thunderbit) demandent : « Trouve le texte de l’avis, la note et la date sur cette page. » L’IA interprète le contenu selon son sens, pas selon son adresse. Les changements de mise en page ne la cassent pas, parce que le sens, lui, n’a pas changé.
Ma recommandation :
- Tolérance zéro à la maintenance ? → basé sur l’IA (Thunderbit)
- Un peu de maintenance acceptable, besoin d’automatisation cloud ? → Apify (avec choix d’Actor et surveillance)
- Contrôle visuel, maintenance modérée ? → Octoparse
- Basé sur un modèle, périmètre limité ? → Web Scraper
- Contrôle total, tout gérer soi-même ? → ScraperAPI
Que faire des avis Trustpilot extraits
Extraire les avis n’est que la première étape. La question que je vois revenir sans cesse sur les forums : « J’ai les données — et maintenant ? »
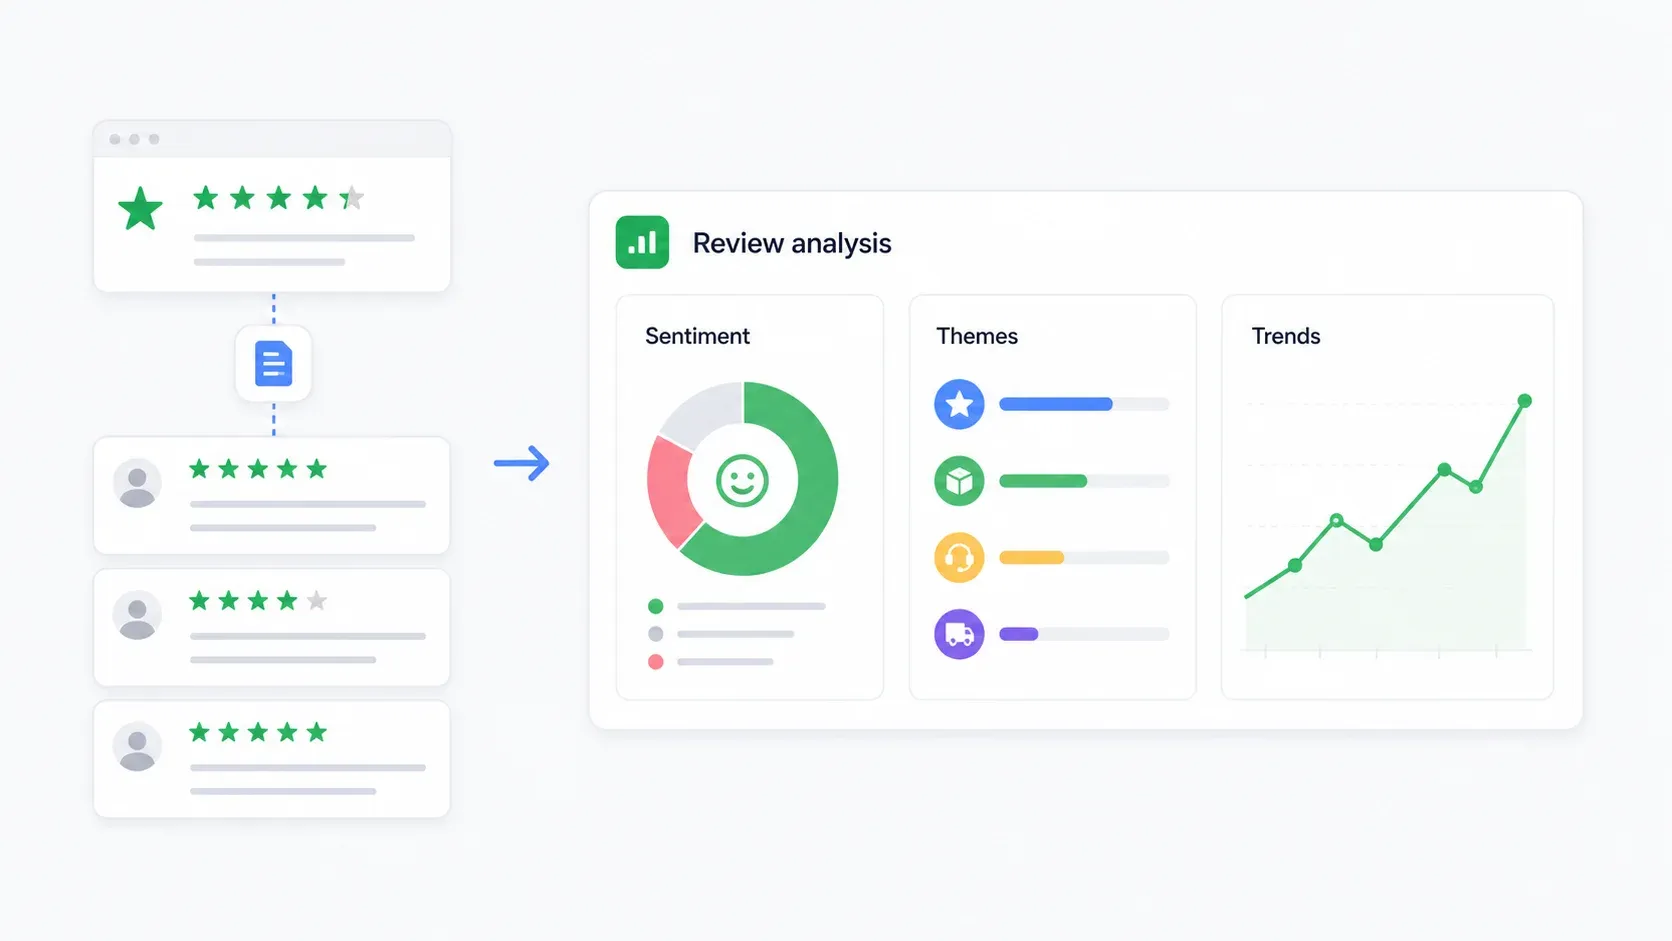
Analyse de sentiment
Le flux le plus simple : exporte les avis vers Google Sheets, puis utilise un outil IA (ChatGPT, Claude ou une fonction IA dans Sheets) pour classer chaque avis comme positif, neutre ou négatif. Ajoute des colonnes pour la catégorie de plainte, le niveau d’urgence et la priorité d’action recommandée.
Pour les jeux de données plus volumineux, importe le CSV dans ChatGPT et demande un résumé : « Classe ces avis par sentiment et identifie les 5 principaux thèmes de plainte avec des citations représentatives. »
Veille concurrentielle
Utilise l’extraction planifiée de Thunderbit pour récupérer les avis des concurrents chaque semaine ou chaque mois. Suis :
- L’évolution de la note moyenne dans le temps
- La part des avis 1 étoile et 2 étoiles
- Les variations du volume d’avis (reçoivent-ils plus ou moins d’avis ?)
- Les thèmes de plainte les plus fréquents
- Le taux et la rapidité de réponse de l’entreprise
Un simple tableau de bord Google Sheets avec des tableaux croisés dynamiques par note et par date te donne un flux d’intelligence concurrentielle qui se met à jour automatiquement.
Extraction de thèmes
Regroupe les avis par catégories récurrentes : livraison/expédition, service client, remboursements, qualité produit, facturation, ergonomie de l’application, prix/rapport qualité-prix et préoccupations liées à la fraude. Le résultat devrait être un tableau indiquant : thème, volume, note moyenne, citations représentatives et action recommandée pour l’entreprise.
C’est plus utile qu’un nuage de mots. Ça montre ce qui alimente vraiment la satisfaction ou l’insatisfaction.
Analyse multi-entreprises en volume
Pour des analyses au niveau d’un secteur, extrais des avis sur plusieurs entreprises d’une même catégorie Trustpilot. Compare les volumes d’avis, les notes, la distribution des étoiles et la fréquence des thèmes sur l’ensemble d’un segment de marché. Le modèle de listing d’entreprises de Web Scraper est utile pour découvrir des sociétés ; Thunderbit ou ScraperAPI peuvent gérer l’échantillonnage d’avis pour chacune d’elles.
Considérations juridiques et éthiques pour l'extraction sur Trustpilot
Je ne suis pas avocat, et ceci ne constitue pas un conseil juridique. Mais la réalité de la conformité compte ici.
Les Conditions d’utilisation de Trustpilot sont explicites. Elles interdisent aux utilisateurs d’accéder ou de collecter du contenu « par tout moyen autre que ceux fournis ou explicitement approuvés par Trustpilot », et mentionnent spécifiquement le text mining, le data mining et le web scraping sans autorisation expresse.
Le niveau de risque ressemble à ceci :
- Risque plus faible : exporter les avis de sa propre entreprise pour une analyse interne, notamment avec les outils business officiels de Trustpilot ou son API.
- Risque modéré : extraire des pages publiques de concurrents à faible volume pour des études de marché. Toujours soumis aux CGU et aux obligations de confidentialité / vie privée.
- Risque plus élevé : extraire du contenu derrière le mur d’authentification de la page 10+, contourner des contrôles techniques, redistribuer des données d’auteurs d’avis ou utiliser les avis extraits pour entraîner un modèle d’IA.
Considérations RGPD : les noms d’auteurs, liens de profil, texte des avis et données de localisation peuvent constituer des données personnelles au sens du droit européen de la vie privée. Les bonnes pratiques incluent de ne collecter que les champs nécessaires, de hacher les noms pour les analyses internes, de définir des durées de conservation et de ne pas republier à grande échelle le texte brut des avis.
Données publiques vs authentifiées : il existe une vraie distinction juridique et éthique entre extraire des pages visibles par tout le monde (les 10 premières pages d’avis) et extraire des données derrière un mur d’authentification. Les outils qui ne s’appuient que sur des données publiques présentent un risque de conformité inférieur à ceux qui nécessitent des identifiants de connexion.
Cela doit peser dans ton choix d’outil. Le mode navigateur de Thunderbit fonctionne avec les pages visibles dans ta propre session — il ne contourne pas l’authentification de manière autonome. ScraperAPI donne aux développeurs un contrôle total, mais aussi l’entière responsabilité de la légalité de la gestion des sessions.
Comment choisir le bon extracteur d'avis Trustpilot
Cadre de décision par persona :
- Marketeur non technique qui a besoin d’avis sans code ? → Thunderbit. Un clic, l’IA s’occupe du reste, export vers Sheets/Notion/Airtable.
- Utilisateur low-code à l’aise avec la configuration et le dépannage ? → Apify. Choisis un Actor, configure les cookies pour la page 10+, surveille les cassures.
- Constructeur visuel qui veut garder la main sur le workflow ? → Octoparse. Configuration par clic, mais maintenance à prévoir quand Trustpilot change.
- Besoin de données au niveau de l’entreprise ou seulement des avis des 10 premières pages ? → Web Scraper. Modèles préconstruits solides pour les profils d’entreprises.
- Développeur qui veut une personnalisation totale ? → ScraperAPI. À toi la logique de parsing, la gestion des sessions et la chaîne de données.
Si la tolérance à la maintenance est ton critère principal, le spectre va de Thunderbit (quasi zéro maintenance) à ScraperAPI (tu maintiens tout). Côté budget, chaque outil de cette liste propose un point d’entrée gratuit — commence par là avant de t’engager.
Conclusion
Les données d’avis Trustpilot sont vraiment précieuses pour l’intelligence concurrentielle, la veille réputationnelle et la compréhension client.
Mais en 2026, les extraire de façon fiable exige un outil capable de gérer le mur de connexion de la page 10, de s’adapter aux changements de DOM et de contourner les protections anti-bot sans intervention manuelle constante.
Pour la plupart des utilisateurs métier, Thunderbit est la solution la plus simple — un clic, détection de champs par IA, mode navigateur pour les pages authentifiées et aucune maintenance quand Trustpilot modifie son front-end. Tu peux l’essayer gratuitement avec 6 pages par mois et sans carte bancaire.
Pour les développeurs qui veulent un contrôle total, ScraperAPI fournit l’infrastructure. Pour tous les autres, Apify, Octoparse et Web Scraper répondent chacun à un besoin précis. L’essentiel est d’aligner l’outil avec ton aisance technique, ta tolérance à la maintenance et tes exigences de conformité.
Si tu veux voir comment Thunderbit gère Trustpilot en particulier, on a un pas-à-pas sur notre chaîne YouTube. Et pour aller plus loin sur le web scraping sans code ou ce qu'est réellement le web scraping, ces guides couvrent les bases.
FAQ
1. Peut-on extraire des avis Trustpilot au-delà de la page 10 ?
Oui, mais uniquement via un accès authentifié. Trustpilot bloque l’accès non connecté après les 10 premières pages d’avis. Le mode navigateur de Thunderbit fonctionne dans ta session Chrome connectée, donc il peut accéder aux pages que tu vois. ScraperAPI nécessite une gestion des sessions / cookies au niveau du code. Les Actors Apify demandent une configuration des cookies. Octoparse exige une configuration manuelle de la connexion / des cookies. La documentation de Web Scraper reconnaît elle-même la limite de 10 pages sans proposer de contournement intégré.
2. Est-il légal d'extraire des avis Trustpilot ?
Les Conditions d’utilisation de Trustpilot interdisent la collecte automatisée de données sans autorisation expresse. Le niveau de risque juridique varie selon la méthode et le cas d’usage : extraire ses propres avis publics présente moins de risques que contourner des murs d’authentification pour extraire ceux de concurrents. Le RGPD s’applique aux données des auteurs d’avis situés dans l’UE. Ceci n’est pas un avis juridique — consulte un conseil pour les projets d’extraction à grande échelle ou à usage commercial.
3. Quelles données peut-on extraire de Trustpilot ?
Les champs courants incluent : nom de l’auteur, note en étoiles, titre de l’avis, texte de l’avis, date de publication, date de l’expérience, statut d’achat vérifié, localisation de l’auteur, texte de la réponse de l’entreprise, nom de la société, TrustScore, nombre total d’avis, distribution des étoiles et URL de l’avis.
4. À quelle fréquence les extracteurs Trustpilot cassent-ils ?
Les outils basés sur des sélecteurs (Actors Apify, workflows Octoparse, scripts Python personnalisés) peuvent casser à chaque fois que Trustpilot modifie ses classes CSS ou sa structure DOM — ce qui peut arriver plusieurs fois par mois. Les outils IA-sémantiques comme Thunderbit s’adaptent automatiquement, car ils interprètent le sens de la page plutôt que de cibler des sélecteurs précis. En revanche, aucun outil n’est immunisé contre de gros changements de contrôle d’accès comme le mur de connexion de la page 10.
5. Peut-on extraire gratuitement des avis Trustpilot ?
Chaque outil de cette liste a une entrée gratuite : Thunderbit propose 6 pages gratuites par mois, ScraperAPI fournit 5 000 crédits d’essai sur 7 jours, Web Scraper dispose d’une extension Chrome gratuite pour un usage local, Octoparse a une offre gratuite à vie (10 tâches, 50 000 lignes/mois) et Apify inclut 5 $ de crédits gratuits par mois. Pour des tests ou des extractions à petite échelle, chacun fonctionne sans paiement.
Essayez Thunderbit pour extraire les avis Trustpilot Get Started Free
En savoir plus



