Raspador de Wikipedia para infoboxes, citas y secciones













Organiza artículos de Wikipedia para investigación
Mantén por separado los datos del artículo, los valores de la infobox, las citas y el contexto de cada sección.
Extrae datos de Wikipedia con un clic
Propone columnas para la página que abres y completa la captura en una sola ejecución. Puedes ajustar o renombrar los campos con lenguaje natural y volver a ejecutarlo si lo deseas.
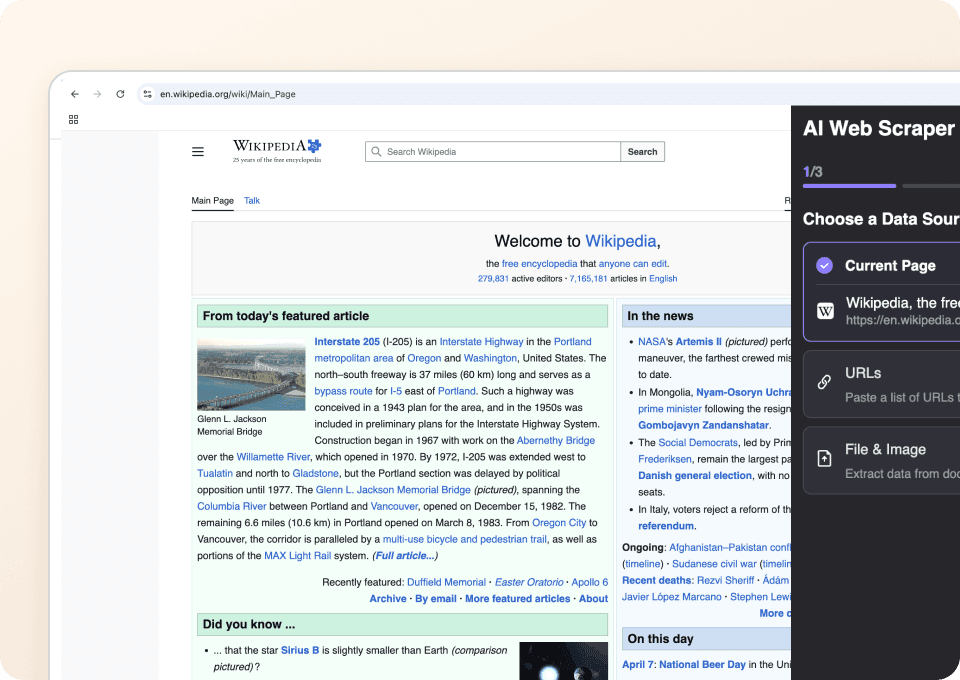
Trabaja con distintos tipos de páginas de Wikipedia
El agente lee etiquetas, encabezados y títulos de secciones visibles para asignar los valores en la página a la que puedes acceder. Si un campo no está presente, la columna queda vacía.
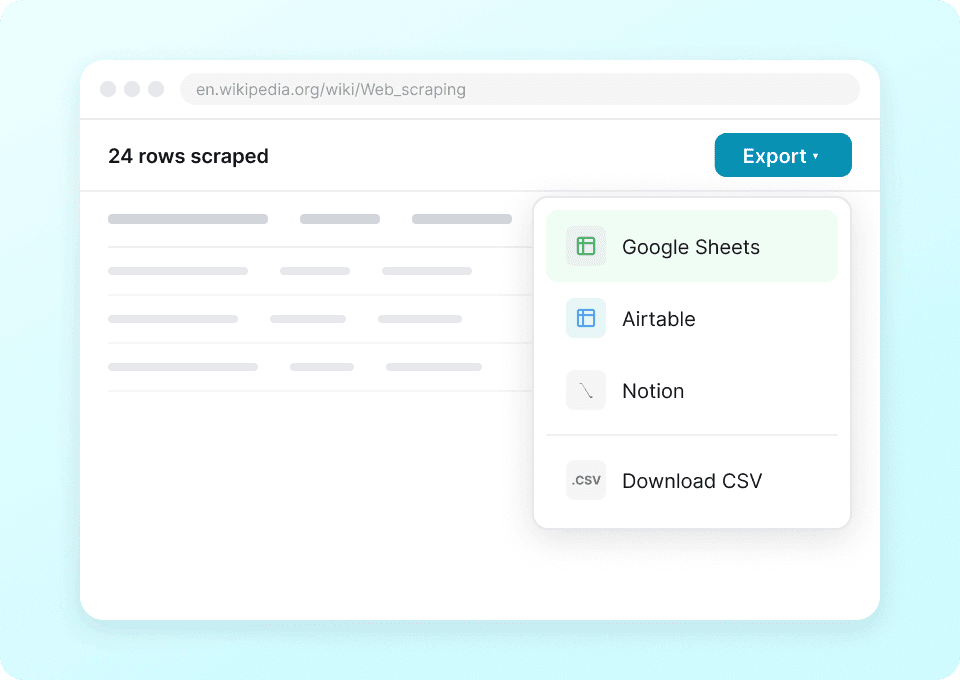
Exporta los datos de Wikipedia directamente
Continúa la investigación en Google Sheets, Excel, Airtable, Notion o en un CSV descargado.
Recopila datos de investigación de Wikipedia sin construir un raspador
Reduce el mantenimiento de selectores para la investigación en Wikipedia.
Configuración manual o basada en selectores
Tiempo dedicado a mantener reglasAgente de IA de Thunderbit
Sugerencias de campos y una sola ejecuciónColumnas para datos del artículo, infobox, citas y secciones
Las columnas solo aparecen cuando están visibles en la página a la que puedes acceder.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.
Preguntas sobre ejecuciones de investigación en Wikipedia
Respuestas rápidas para el Modo Agente en Wikipedia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Raspador de Flixster
El Raspador Web de Flixster de Thunderbit te permite extraer información de las listas de taquilla más populares y cines cercanos de Flixster. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de películas, recaudaciones, valoraciones, fechas de estreno, nombres y ubicaciones de cines, así como la cartelera disponible, ideal para análisis o investigación.
Saber más ->
Raspador de olympustaff.com
El Raspador Web de olympustaff.com de Thunderbit te permite extraer datos de listas de cómics y comentarios en olympustaff.com. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de cómics, autores, fechas de lanzamiento y opiniones de lectores, ya sea para análisis o investigación. Es la herramienta perfecta para marketers, investigadores y creadores de contenido que buscan datos estructurados de olympustaff.com.
Saber más ->
Raspador de Hatena
El Raspador Web de Hatena de Thunderbit te permite extraer datos de blogs y listas de temas de Hatena con sugerencias de campos impulsadas por IA. Recopila títulos de blogs, nombres de autores, fechas de publicación, resúmenes de contenido y temas en tendencia para investigación, marketing o análisis de contenido. Perfecto para profesionales de marketing, investigadores y creadores de contenido que buscan datos estructurados de Hatena.
Saber más ->
Raspador de namu.wiki
El Raspador Web de namu.wiki de Thunderbit te permite extraer información de namu.wiki, incluyendo páginas relevantes y debates recientes. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de páginas, enlaces, fechas de última edición, temas de discusión y nombres de participantes, ideal para investigación, creación de contenido o análisis de comunidades.
Saber más ->
Raspador de Música de NetEase
El Raspador Web de NetEase Music de Thunderbit te permite extraer información de los resultados de búsqueda y páginas de artistas en NetEase Music. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de canciones, nombres de artistas, detalles de álbumes, duraciones y enlaces de canciones para análisis o investigación. Perfecto para analistas musicales, profesionales del marketing y aficionados que buscan datos estructurados de NetEase Music.
Saber más ->
Raspador de QQ Music
El Raspador Web de QQ Music de Thunderbit te permite obtener datos de los resultados de búsqueda y listas de obras de artistas en QQ Music. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de canciones, nombres de artistas, detalles de álbumes, fechas de lanzamiento y mucho más, ideal para análisis o investigación. Perfecto para analistas musicales, profesionales del marketing y aficionados que buscan datos estructurados de QQ Music.
Saber más ->¿Listo para potenciar tu extracción de datos?
Únete a más de 200,000 profesionales que ya usan Thunderbit para automatizar sus flujos de web scraping.
La prueba gratuita ofrece créditos ilimitados para 8 páginas web.


