Raspador de Baidu para resultados de búsqueda y artículos













Convierte los resultados de Baidu en datos limpios y útiles
Mantén los resultados de búsqueda y los detalles de los artículos disponibles en una sola tabla clara.
Limpia los datos de Baidu mientras los recopilas
Thunderbit coloca los títulos, URLs, fragmentos, fechas y fuentes visibles en columnas claras. Si un resultado no muestra un campo, la celda se queda vacía.

Exporta la investigación de Baidu con un clic
Envía cada ejecución a una hoja de revisión de resultados de búsqueda. Las posiciones, fuentes, fechas y detalles de las páginas enlazadas quedan junto al resultado de Baidu correspondiente.
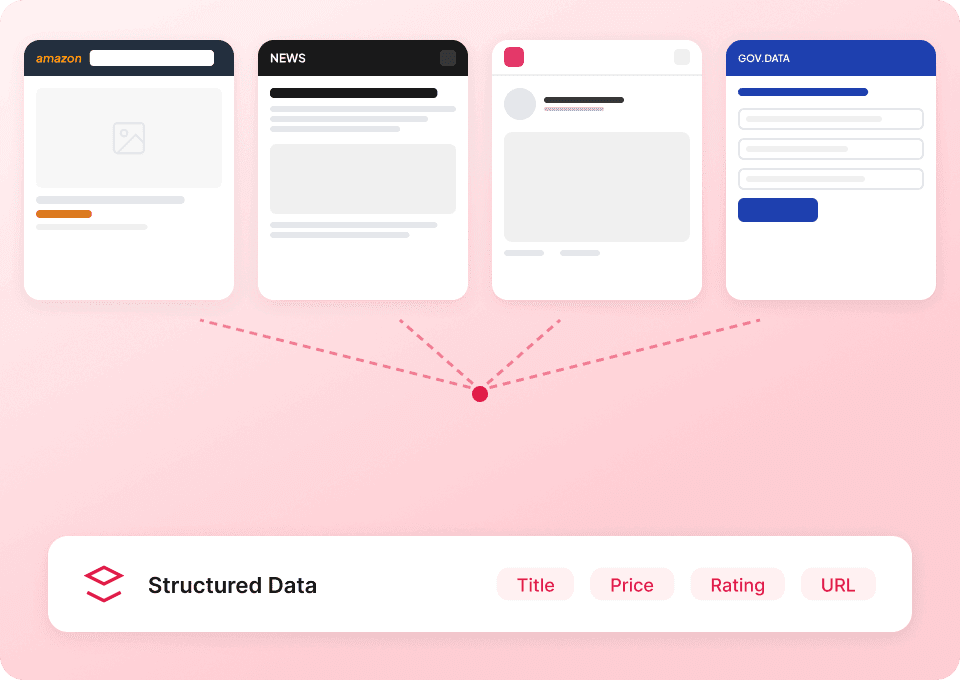
Usa el mismo flujo de trabajo en cualquier sitio
Thunderbit lee los campos por su significado, no por el diseño específico de Baidu. Usa el mismo enfoque en cualquier sitio público accesible cuando tu investigación necesite pasar a otra fuente.
Mantén el contexto de cada resultado de Baidu
Una lista de enlaces pierde contexto. Thunderbit conserva los datos visibles junto a cada resultado.
Enlaces copiados y notas dispersas
Los detalles del resultado quedan separadosInvestigación estructurada en Baidu
El contexto visible permanece con cada resultado¿Qué datos puedes extraer de Baidu?
Elige entre estos campos públicos y visibles. Los módulos de resultados y las páginas enlazadas no muestran todos los campos en յուրաքանչյուր consulta.
- Consulta de búsqueda
- Posición del resultado
- Título del resultado
- URL del resultado
- URL mostrada
- Fragmento del resultado
- Fecha del resultado
- Icono del sitio del resultado
- Frase de búsqueda relacionada
- Sugerencia ortográfica
- Sugerencia de pinyin
- Número de página de resultados
- Sitio de origen
- Dominio de origen
- Autor del artículo
- Fecha de publicación del artículo
- Resumen del artículo
- Nombre del documento
- Descripción del documento
- Ruta de navegación del documento
- Género del documento
- Formato de archivo del documento
- Número de páginas del documento
- Hora de subida del documento
- URL del documento
- Tipo de contenido del resultado
- Miniatura de imagen
- Miniatura de video
- Dirección de ubicación
- Módulo destacado de Baidu
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Preguntas sobre la recopilación de datos de búsqueda de Baidu
Los campos disponibles varían según la consulta, el tipo de resultado y la información que muestran las páginas enlazadas.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Raspador de Flixster
El Raspador Web de Flixster de Thunderbit te permite extraer información de las listas de taquilla más populares y cines cercanos de Flixster. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de películas, recaudaciones, valoraciones, fechas de estreno, nombres y ubicaciones de cines, así como la cartelera disponible, ideal para análisis o investigación.
Saber más ->
Raspador de olympustaff.com
El Raspador Web de olympustaff.com de Thunderbit te permite extraer datos de listas de cómics y comentarios en olympustaff.com. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de cómics, autores, fechas de lanzamiento y opiniones de lectores, ya sea para análisis o investigación. Es la herramienta perfecta para marketers, investigadores y creadores de contenido que buscan datos estructurados de olympustaff.com.
Saber más ->
Raspador de Hatena
El Raspador Web de Hatena de Thunderbit te permite extraer datos de blogs y listas de temas de Hatena con sugerencias de campos impulsadas por IA. Recopila títulos de blogs, nombres de autores, fechas de publicación, resúmenes de contenido y temas en tendencia para investigación, marketing o análisis de contenido. Perfecto para profesionales de marketing, investigadores y creadores de contenido que buscan datos estructurados de Hatena.
Saber más ->
Raspador de namu.wiki
El Raspador Web de namu.wiki de Thunderbit te permite extraer información de namu.wiki, incluyendo páginas relevantes y debates recientes. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de páginas, enlaces, fechas de última edición, temas de discusión y nombres de participantes, ideal para investigación, creación de contenido o análisis de comunidades.
Saber más ->
Raspador de Música de NetEase
El Raspador Web de NetEase Music de Thunderbit te permite extraer información de los resultados de búsqueda y páginas de artistas en NetEase Music. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de canciones, nombres de artistas, detalles de álbumes, duraciones y enlaces de canciones para análisis o investigación. Perfecto para analistas musicales, profesionales del marketing y aficionados que buscan datos estructurados de NetEase Music.
Saber más ->
Raspador de QQ Music
El Raspador Web de QQ Music de Thunderbit te permite obtener datos de los resultados de búsqueda y listas de obras de artistas en QQ Music. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de canciones, nombres de artistas, detalles de álbumes, fechas de lanzamiento y mucho más, ideal para análisis o investigación. Perfecto para analistas musicales, profesionales del marketing y aficionados que buscan datos estructurados de QQ Music.
Saber más ->¿Listo para potenciar tu extracción de datos?
Únete a más de 200,000 profesionales que ya usan Thunderbit para automatizar sus flujos de web scraping.
La prueba gratuita ofrece créditos ilimitados para 8 páginas web.



