Wikipedia-Scraper für Infoboxen, Zitate und Abschnitte










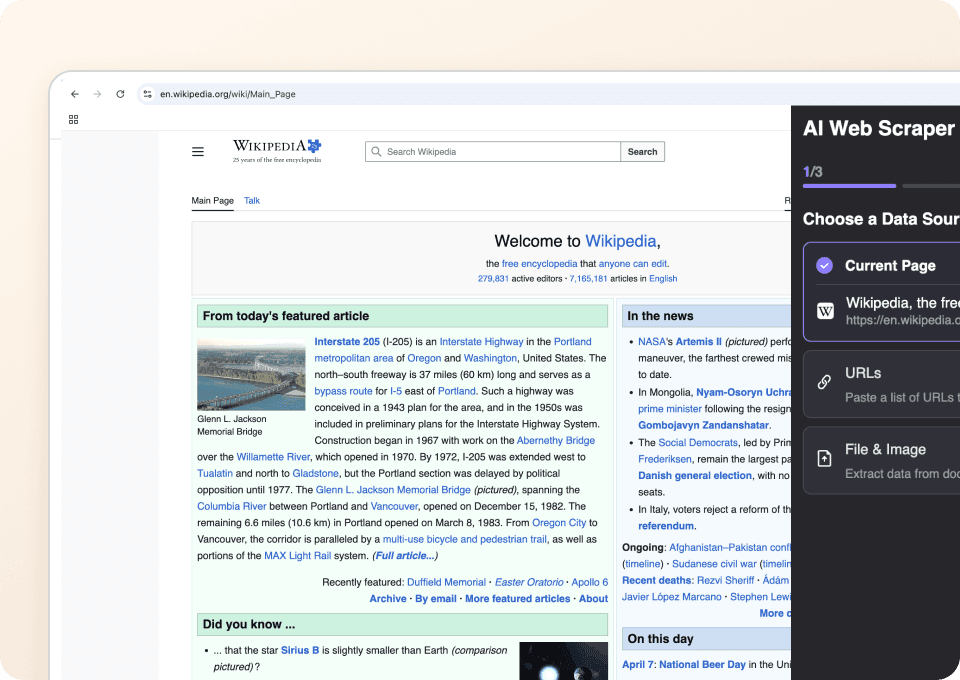
Wikipedia-Artikel für Recherchen strukturieren
Halten Sie Fakten zum Artikel, Infobox-Werte, Zitate und Abschnittskontext in getrennten Feldern fest.
Wikipedia-Daten mit nur einem Klick extrahieren
Für die geöffnete Seite werden passende Spalten vorgeschlagen und die Erfassung in einem Durchlauf abgeschlossen. Felder können Sie bei Bedarf in natürlicher Sprache anpassen oder umbenennen und danach erneut ausführen.
Mit unterschiedlichen Wikipedia-Seitentypen arbeiten
Der Agent liest sichtbare Bezeichnungen, Überschriften und Abschnittstitel, um die Werte auf der von Ihnen aufrufbaren Seite zuzuordnen. Fehlt ein Feld, bleibt die Spalte leer.
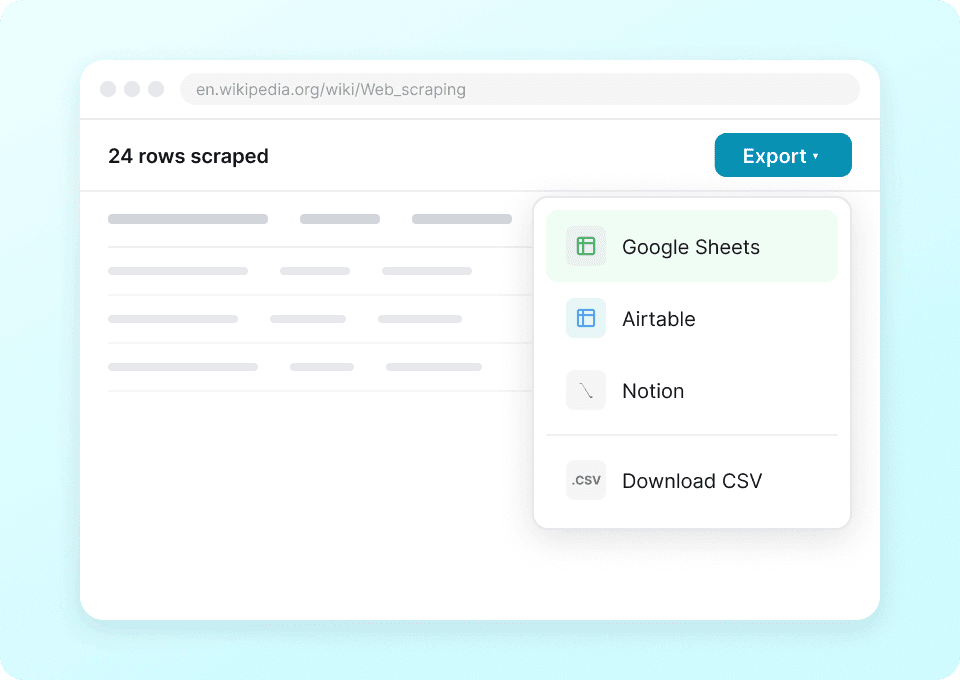
Wikipedia-Daten direkt exportieren
Führen Sie die Recherche in Google Sheets, Excel, Airtable, Notion oder einer heruntergeladenen CSV-Datei fort.
Wikipedia-Recherchedaten erfassen, ohne einen Scraper zu bauen
Weniger Aufwand für Selektoren bei Wikipedia-Recherchen.
Manuelles oder selektorbasiertes Setup
Zeit, die für die Pflege von Regeln verloren gehtThunderbit KI-Agent
Feldvorschläge und ein einzelner DurchlaufSpalten für Artikeldaten, Infobox, Zitate und Abschnitte
Spalten werden nur angezeigt, wenn sie auf der von Ihnen aufrufbaren Seite sichtbar sind.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.
Fragen zu Wikipedia-Rechercheläufen
Kurze Antworten zum Agent-Modus auf Wikipedia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Flixster-Scraper
Mit dem Thunderbit Flixster Web-Scraper können Sie Daten aus Flixsters Top-Box-Office-Listen und nahegelegenen Kinos extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Filmtitel, Einspielergebnisse, Bewertungen, Erscheinungsdaten, Kinonamen, Standorte und verfügbare Filme – ideal für Analysen oder Recherchen.
Mehr erfahren ->
olympustaff.com Scraper
Mit dem Thunderbit olympustaff.com Web-Scraper können Sie Daten aus Comics-Listen und Kommentaren auf olympustaff.com extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie schnell Comic-Titel, Autoren, Erscheinungsdaten und Leserfeedback – ideal für Analyse oder Recherche. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Daten von olympustaff.com benötigen.
Mehr erfahren ->
Hatena-Scraper
Mit dem Thunderbit Hatena Web-Scraper können Sie mühelos Daten aus Hatena-Blogs und Themenlisten extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Blogtitel, Autorennamen, Veröffentlichungsdaten, Inhaltszusammenfassungen und Trendthemen für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Hatena-Daten benötigen.
Mehr erfahren ->
namu.wiki Scraper
Mit dem Thunderbit namu.wiki Web-Scraper können Sie Daten von namu.wiki extrahieren – darunter relevante Seiten und neueste Diskussionen. Dank KI-gestützter Feldvorschläge sammeln Sie schnell und einfach Seitentitel, URLs, letzte Bearbeitungsdaten, Diskussionsthemen und Teilnehmernamen – ideal für Recherche, Content-Erstellung oder Community-Analysen.
Mehr erfahren ->
NetEase Music Scraper
Mit dem Thunderbit NetEase Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Künstlerseiten von NetEase Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albumdetails, Laufzeiten und Song-Links im Handumdrehen – perfekt für Analysen, Recherchen oder Musikliebhaber, die strukturierte NetEase Music Daten benötigen.
Mehr erfahren ->
QQ Music Scraper
Mit dem Thunderbit QQ Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Werkslisten von QQ Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albuminformationen, Veröffentlichungsdaten und vieles mehr im Handumdrehen – perfekt für Analysen oder Recherchen. Ideal für Musikexperten, Marketer und Musikliebhaber, die strukturierte Daten von QQ Music benötigen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.


