Pixiv-Scraper










Pixiv-Daten einfach scrapen
Extrahieren Sie Pixiv-Daten wie Illustrationstitel, Künstlernamen und Tags ohne manuelles Copy & Paste.
Pixiv-Daten in großem Umfang in einem Durchgang erfassen
Pixiv-Daten Seite für Seite manuell zu sammeln, wird schnell mühsam — vor allem, wenn Sie Dutzende oder Hunderte von Illustrationstiteln, Künstlernamen, Tags, Aufrufzahlen, Lesezeichenanzahlen und Upload-Daten brauchen. Mit Thunderbit können Sie eine Liste von URLs in einem Rutsch scrapen und so von wenigen Seiten zu einem großen Pixiv-Datensatz wechseln, ohne Zeit mit wiederkehrender Arbeit zu verlieren.
Vollständige Details von Pixiv-Unterseiten erfassen
Listenansichten auf Pixiv zeigen oft nur die Grundlagen, während die eigentlichen Details in jeder Illustration oder auf jeder Künstler-Unterseite liegen. Thunderbit besucht jede verlinkte Unterseite und holt das komplette Bild zurück — Illustrationsbeschreibungen, Tag-Listen, Serieninformationen, Aufrufzahlen und Lesezeichenanzahl — und liefert Ihnen so reichhaltigere, sauber strukturierte Daten.
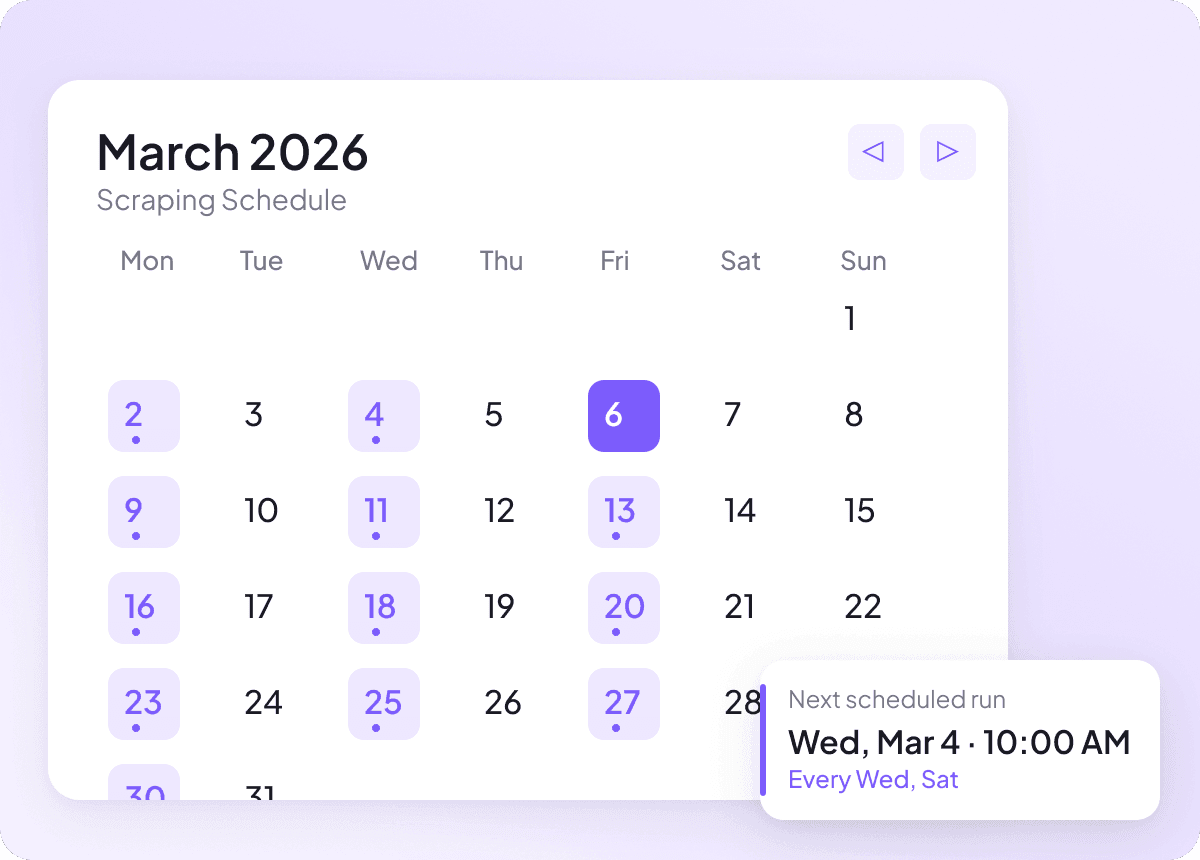
Pixiv-Daten automatisch aktuell halten
Pixiv-Inhalte ändern sich ständig, und wer manuell auf dem Laufenden bleiben will, muss dieselben Seiten immer wieder prüfen. Mit geplantem Scraping läuft Thunderbit automatisch und liefert Ihre Pixiv-Daten regelmäßig in Ihre Tabelle, sodass das Tracking von Illustrationen, Künstlern und Tags ohne Ihren Aufwand aktuell bleibt.
Worin unterscheidet sich Thunderbit von klassischen Pixiv-Scrapern?
Eine einfachere Möglichkeit, Pixiv ohne fragile Selektoren und aufwendige Nachbearbeitung zu scrapen.
Klassische Scraper
Der alte WegThunderbit AI
Der intelligentere AnsatzVerlass dich nicht nur auf unser Wort
Sieh dir an, was unsere Nutzer über Thunderbit sagen.
Häufig gestellte Fragen
Verwandt Anwendungsfälle
Entdecke weitere Anwendungsfälle für Thunderbits Web-Scraper.
Flixster-Scraper
Mit dem Thunderbit Flixster Web-Scraper können Sie Daten aus Flixsters Top-Box-Office-Listen und nahegelegenen Kinos extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Filmtitel, Einspielergebnisse, Bewertungen, Erscheinungsdaten, Kinonamen, Standorte und verfügbare Filme – ideal für Analysen oder Recherchen.
Mehr erfahren ->
olympustaff.com Scraper
Mit dem Thunderbit olympustaff.com Web-Scraper können Sie Daten aus Comics-Listen und Kommentaren auf olympustaff.com extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie schnell Comic-Titel, Autoren, Erscheinungsdaten und Leserfeedback – ideal für Analyse oder Recherche. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Daten von olympustaff.com benötigen.
Mehr erfahren ->
Hatena-Scraper
Mit dem Thunderbit Hatena Web-Scraper können Sie mühelos Daten aus Hatena-Blogs und Themenlisten extrahieren – dank KI-gestützter Feldvorschläge. Sammeln Sie Blogtitel, Autorennamen, Veröffentlichungsdaten, Inhaltszusammenfassungen und Trendthemen für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Hatena-Daten benötigen.
Mehr erfahren ->
namu.wiki Scraper
Mit dem Thunderbit namu.wiki Web-Scraper können Sie Daten von namu.wiki extrahieren – darunter relevante Seiten und neueste Diskussionen. Dank KI-gestützter Feldvorschläge sammeln Sie schnell und einfach Seitentitel, URLs, letzte Bearbeitungsdaten, Diskussionsthemen und Teilnehmernamen – ideal für Recherche, Content-Erstellung oder Community-Analysen.
Mehr erfahren ->
NetEase Music Scraper
Mit dem Thunderbit NetEase Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Künstlerseiten von NetEase Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albumdetails, Laufzeiten und Song-Links im Handumdrehen – perfekt für Analysen, Recherchen oder Musikliebhaber, die strukturierte NetEase Music Daten benötigen.
Mehr erfahren ->
QQ Music Scraper
Mit dem Thunderbit QQ Music Web-Scraper können Sie gezielt Daten aus den Suchergebnissen und Werkslisten von QQ Music erfassen. Dank KI-gestützter Feldvorschläge sammeln Sie Songtitel, Künstlernamen, Albuminformationen, Veröffentlichungsdaten und vieles mehr im Handumdrehen – perfekt für Analysen oder Recherchen. Ideal für Musikexperten, Marketer und Musikliebhaber, die strukturierte Daten von QQ Music benötigen.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.



