News-Scraper: Von Schlagzeilen zu vollständigen Artikeldetails










News-Schlagzeilen mit vollständigen Artikeln verknüpfen
Verwandeln Sie eine Schlagzeilen-Übersicht in Artikel-Datensätze mit Quellkontext.
Artikel öffnen für vollständige Details
Starten Sie bei einer Themen-, Kategorie- oder Ergebnisseite. Thunderbit kann jede verlinkte Story aufrufen und die dort angezeigte Autorenzeile, Veröffentlichungszeit, das Ressort, die Zusammenfassung und die Artikel-URL hinzufügen.
Eine Liste von Artikel-URLs verarbeiten
Fügen Sie die Links ein, die ein Redakteur oder Researcher ausgewählt hat. Jede erreichbare Story wird zu einer eigenen Zeile, sodass Quelle und Veröffentlichungsdetails der richtigen Schlagzeile zugeordnet bleiben.
Eine News-Übersicht aktualisieren
Planen Sie dieselben Quellseiten für einen späteren Lauf ein. Die neue Tabelle zeigt die Stories und Schlagzeilendetails, die zu diesem Zeitpunkt sichtbar sind.
Eine News-Übersicht erstellen, ohne einen Scraper zu bauen
Gehen Sie von Schlagzeilen zu Autor, Datum, Ressort und Quellenangaben in einer einzigen Tabelle.
Manuelle Listen oder Selektor-Tools
Mehr Einrichtung für jede QuelleThunderbit KI-Agent
News-Seite öffnen und loslegenArtikel- und Listenfelder im Geltungsbereich
Wird nur erfasst, wenn es in Ihrer Sitzung sichtbar ist.
- headline
- article_url
- outlet_name
- author_name
- author_profile_url
- byline
- publication_date
- publication_time
- updated_date
- updated_time
- section
- subsection
- tags
- summary
- lead_paragraph
- body_text_snippet
- dateline_location
- estimated_read_time
- image_url
- image_caption
- image_credit
- video_url
- video_title
- video_duration
- gallery_image_count
- comment_count
- share_count
- related_titles
- related_urls
- publisher_logo_url
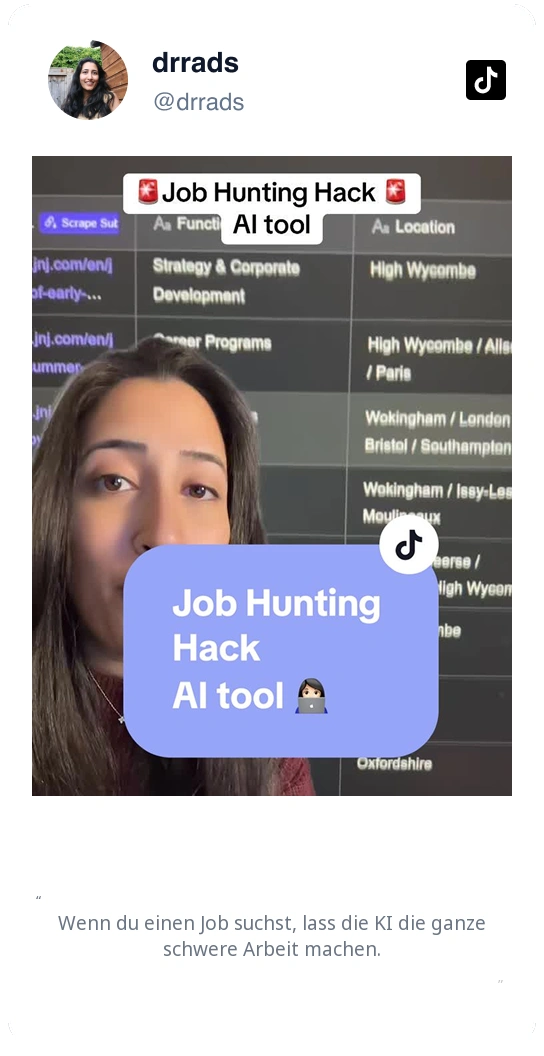
Watch news researchers build a usable watchlist
In user videos, news teams show how they match headlines with article details and check each row.
Fragen zum Wechsel von Schlagzeilen zu Kontext
Kurze Antworten für News-Listen und Artikel.
Continue from headlines to source research
Collect author pages, press releases, publication archives, or topic feeds that support the same news question.

4PDA-Scraper
Mit dem Thunderbit 4PDA Web-Scraper können Sie mithilfe von KI Daten aus 4PDA-Nachrichtenartikeln und Forenbeiträgen extrahieren. Sammeln Sie schnell Überschriften, Veröffentlichungsdaten, Autoren und Beitragsinhalte – ideal für Recherchen, Analysen oder das Monitoring technischer Diskussionen. Perfekt für Technikbegeisterte, Forschende und Marketer, die strukturierte 4PDA-Daten benötigen.
Mehr erfahren ->
Ptt-Scraper
Mit dem Thunderbit Ptt Web-Scraper können Sie mühelos Daten aus Ptt-Foren und Beiträgen extrahieren – dank KI-gestützter Felderkennung. Sammeln Sie Boardnamen, URLs, Beliebtheit, Beitragstitel, Autoren und Kommentare für Recherche, Marketing oder Inhaltsanalysen. Perfekt für Marketer, Forschende und Content Creators, die strukturierte Ptt-Daten benötigen.
Mehr erfahren ->
Pizza-Marktplatz-Scraper
Mit dem Thunderbit Pizza Marketplace Scraper können Sie Daten aus den Nachrichtenlisten und Anbieterverzeichnissen von Pizza Marketplace extrahieren. Dank KI-gestützter Feldvorschläge sammeln Sie im Handumdrehen Schlagzeilen, Veröffentlichungsdaten, Autoren, Anbieternamen, Standorte und Kontaktdaten – ideal für Recherche, Marketing oder Analysen.
Mehr erfahren ->
Failory Scraper
Mit dem Thunderbit Failory-Scraper können Sie strukturierte Daten aus dem Startup Cemetery und den News-Artikeln von Failory extrahieren. Dank KI-gestützter Feldvorschläge erfassen Sie Startup-Namen, Gründungsjahre, Scheitergründe, Artikeltitel, Autoren und vieles mehr – perfekt für Recherche und Analyse. Ideal für Gründer, Investoren und Forschende, die wertvolle Einblicke aus Failory gewinnen möchten.
Mehr erfahren ->
Investing.com Web-Scraper
Extrahiere Börsendaten – Symbole, Kurse, Volumen und Marktkapitalisierung – aus Investing.com mit nur 2 Klicks und exportiere sie direkt nach Google Sheets, Notion oder Excel. Öffne einfach eine beliebige Investing.com-Seite und lass die KI die Felder für dich erkennen.
Mehr erfahren ->
Substack-Webscraper
Extrahieren Sie Substack-Abonnentenzahlen, Artikeltitel und Beschreibungen von Publikationen in nur 2 Klicks — und exportieren Sie die Daten anschließend nach Excel, Google Sheets oder Notion. Ganz ohne Code; Thunderbits KI übernimmt die Strukturierung für Sie.
Mehr erfahren ->Bereit, deine Datenextraktion auf das nächste Level zu bringen?
Schließe dich über 200.000 Profis an, die Thunderbit bereits nutzen, um ihre Web-Scraping-Workflows zu automatisieren.
Die kostenlose Testversion bietet unbegrenzte Credits für 8 Webseiten.


