
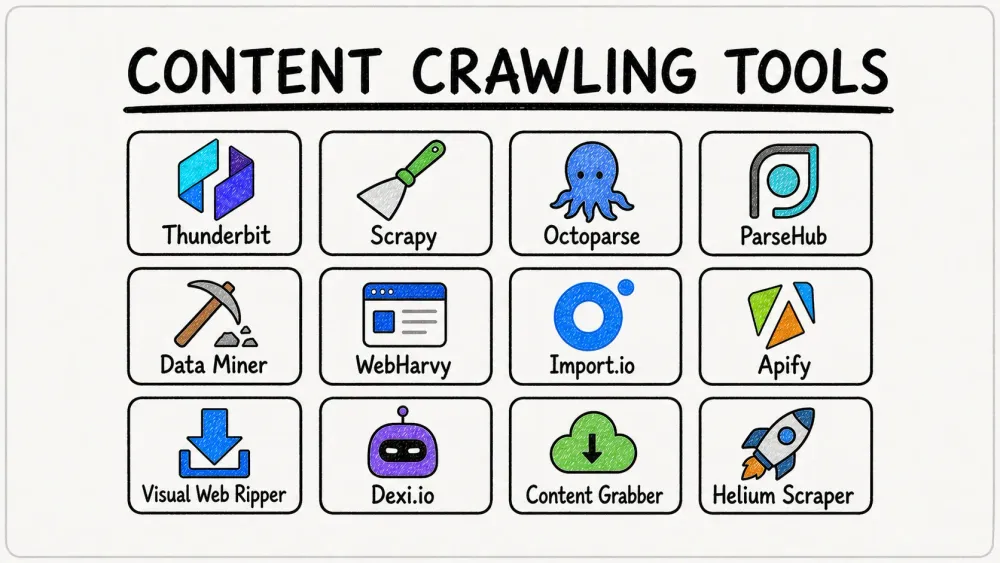
Das Web quillt über vor Daten – doch der Haken ist: Sie manuell zu sammeln ist ungefähr so spannend wie beim Trocknen von Farbe zuzusehen. Und ebenso wenig produktiv. Im Jahr 2026 schwimmen Unternehmen in mehr Webinhalten als je zuvor, denn das tägliche Web-Datenvolumen eines durchschnittlichen Unternehmens ist von 1,2 TB im Jahr 2020 auf 8 TB im Jahr 2025 gestiegen (Actowiz Solutions). Ob Sales, Marketing, E-Commerce oder Operations – schneller, strukturierter und präziser Web-Datenzugriff ist nicht nur „nice to have“, sondern betriebliche Notwendigkeit. Und mal ehrlich: Für endlose Copy-Paste-Marathons hat niemand Zeit.
KI nutzen, um Daten von jeder Website zu extrahieren Ein Klick genügt: Die KI liest die Seite, erkennt ihre Struktur und gibt eine saubere Tabelle zurück. Im Free-Tarif sind 6 Seiten pro Monat enthalten. Get Started Free
Genau deshalb sind Content-Crawling-Tools so beliebt geworden. Diese Tools – von KI-gestützten Chrome-Erweiterungen bis hin zu Enterprise-Plattformen – automatisieren den gesamten Prozess und verwandeln unübersichtliche Webseiten in saubere Tabellen, Datenbanken oder Echtzeit-Dashboards. Ich arbeite seit Jahren im SaaS- und Automatisierungsbereich, und ich kann aus Erfahrung sagen: Das richtige Tool spart nicht nur Zeit, sondern verändert, wie ein Team arbeitet. Werfen wir also einen Blick auf die 16 besten Content-Crawling-Tools für effizientes Web Scraping im Jahr 2026 – mit Fokus darauf, was jedes Tool besonders macht, für welche Anwendungsfälle es sich eignet und wie Sie die beste Lösung für Ihren Workflow finden.
Warum Unternehmen die besten Content-Crawling-Tools brauchen
Wenn Sie schon einmal versucht haben, eine Lead-Liste aufzubauen, Wettbewerberpreise zu überwachen oder Marktsignale manuell zu verfolgen, wissen Sie, wie schnell Datenerfassung zum Albtraum wird. Das ist langsam, fehleranfällig – und bis Sie fertig sind, sind Ihre Daten womöglich schon veraltet. Deshalb haben über 70 % der Unternehmen bis 2025 automatisierte Web-Extraktion eingeführt und den manuellen Aufwand um rund 60 % reduziert (Actowiz Solutions).
Content-Crawling-Tools automatisieren die Extraktion strukturierter Daten von Websites und ermöglichen unter anderem:
- frische Leads direkt ins CRM einzuspeisen (kein Copy-Paste mehr aus Verzeichnissen)
- Wettbewerberpreise und Lagerbestände in Echtzeit zu überwachen
- Bewertungen, News und Social-Media-Erwähnungen für Marketing-Insights zu bündeln
- eigene Datensätze für Research oder Analytics aufzubauen
- regelmäßige Datenabrufe zu planen für fortlaufende Reports
Und der ROI ist real: Unternehmen, die Web Scraping einsetzen, haben zwischen 2020 und 2025 gemeinsam mehr als 500 Millionen US-Dollar eingespart, bei Effizienzsteigerungen von 20–40 % (Actowiz Solutions). Kurz gesagt: Content-Crawling-Tools verschaffen Ihrem Team mehr Zeit für Strategie statt für Routinearbeit.
So haben wir die besten Content-Crawling-Tools ausgewählt
Nicht jeder Web-Scraper ist gleich. Bei der Zusammenstellung dieser Liste habe ich die Tools aus Sicht echter Business-Anwender bewertet – also für Sales-, Marketing-, Ops- und Research-Teams, die Ergebnisse brauchen und keine Kopfschmerzen. Darauf kam es besonders an:
- Benutzerfreundlichkeit: Können auch Nicht-Techniker schnell loslegen? Gibt es eine Point-and-Click-Oberfläche oder KI-Unterstützung?
- Automatisierung & Funktionen: Beherrscht das Tool Paginierung, Unterseiten, Zeitplanung und dynamische Inhalte? Läuft es in der Cloud für Geschwindigkeit und Skalierung?
- Datenexport & Integration: Lässt sich nach Excel, CSV, Google Sheets, Airtable, Notion exportieren oder per API anbinden?
- Skalierbarkeit: Taugt es für einmalige Aufgaben oder auch für große, laufende Projekte?
- Anpassbarkeit: Können Sie Extraktionslogik anpassen, benutzerdefinierte Felder hinzufügen oder schwierige Websites verarbeiten?
- Compliance & Datenschutz: Hilft das Tool dabei, GDPR, CCPA und Website-Nutzungsbedingungen einzuhalten?
- Support & Community: Gibt es Dokumentation, Support oder eine Nutzergemeinschaft zur Fehlersuche?
- Kosten: Gibt es einen Free-Tarif oder Testzugang? Passt die Preisgestaltung zu Ihrem Bedarf?
Und natürlich steht Thunderbit – das Tool, das mein Team und ich entwickelt haben – besonders im Fokus, weil ich wirklich glaube, dass es für Business-Anwender der einfachste Einstieg in KI-gestütztes Web Scraping ist.
Die 18 besten Content-Crawling-Tools für effizientes Web Scraping
Schauen wir uns die besten Lösungen an – von KI-gestützter Einfachheit über Entwickler-Tools bis hin zu allem dazwischen.
1. Thunderbit
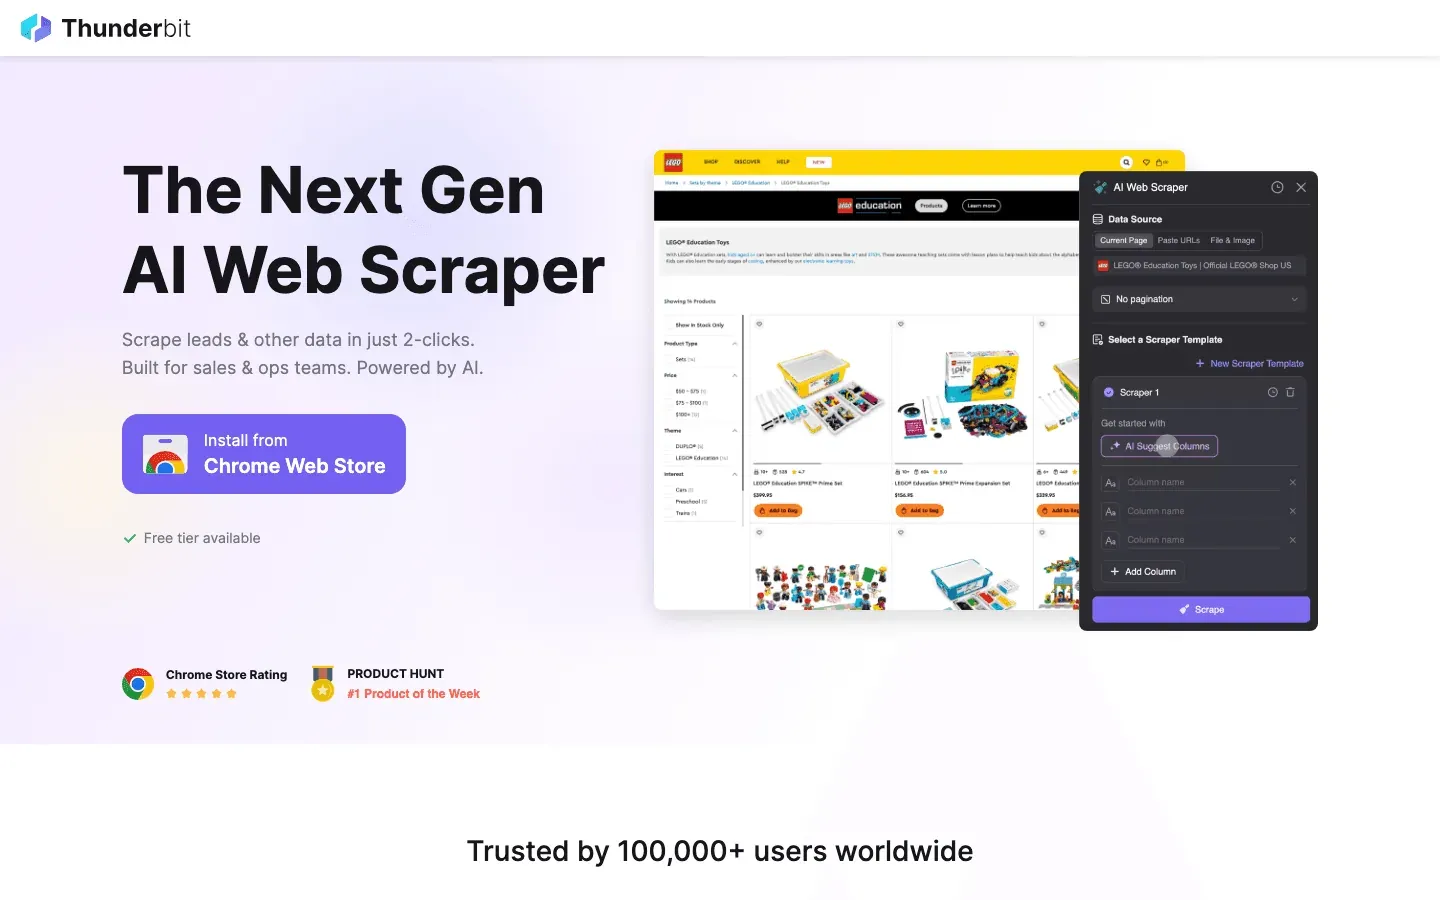 Thunderbit ist eine Chrome-Erweiterung für KI-Web-Scraping, entwickelt für Business-Anwender, die schnell Ergebnisse wollen. Das herausragende Feature ist One Click Extract: Öffnen Sie einfach eine Webseite, klicken Sie einmal, und die KI von Thunderbit liest die Seite, erkennt die relevanten Felder und richtet den Scraper für Sie ein. Kein Coding, kein Herumprobieren mit Selektoren – einfach klicken, extrahieren und exportieren.
- Unterseiten-Scraping: Thunderbit kann automatisch jede Unterseite aufrufen (z. B. Produkt- oder Profilseiten) und Ihre Daten anreichern – ideal für Lead-Generierung oder E-Commerce-Recherche.
- Paginierung & Vorlagen: Verarbeitet mehrseitige Listen und bietet sofort einsatzbereite Vorlagen für Websites wie Amazon, Zillow und Instagram.
- Kostenloser Datenexport: Export nach Excel, Google Sheets, Airtable, Notion, CSV oder JSON – ohne Bezahlschranke.
- AI Autofill: Automatisieren Sie Online-Formulare mit KI und gehen Sie über reines Scraping hinaus in Richtung Workflow-Automatisierung.
- Cloud- & Browser-Scraping: Wählen Sie schnelles Cloud-Scraping für öffentliche Seiten oder den Browser-Modus für eingeloggte Sitzungen.
- Preis: Kostenlos bis zu 6 Seiten (oder 10 mit Testphase), kostenpflichtige Pläne ab nur 15 $/Monat.
Thunderbit ist ideal für Sales-, Marketing- und Operations-Teams, die Datenerfassung ohne technische Hürden automatisieren möchten. Es ist das Tool, das ich mir vor Jahren gewünscht hätte – heute kann jeder in wenigen Minuten eine Lead-Liste aufbauen oder Wettbewerber beobachten.
Thunderbit AI Web Scraper kostenlos testen Kein Crawler zum Konfigurieren, keine Selektoren zu pflegen. Export nach Excel, Google Sheets, Airtable oder Notion ohne zusätzliche Kosten. Get Started Free
2. Scrapy
 Scrapy ist ein Open-Source-Kraftpaket für Entwickler. Das Python-Framework ermöglicht es Ihnen, eigene Spiders zu schreiben, um Daten im großen Stil zu crawlen und zu extrahieren. Scrapy ist auf Geschwindigkeit und Flexibilität ausgelegt und unterstützt asynchrones Crawling, individuelle Pipelines, Proxy-Rotation sowie die Integration mit Datenbanken oder APIs.
- Am besten geeignet für: Entwickler und Data Engineers, die große, komplexe oder wiederkehrende Scraping-Projekte umsetzen.
- Stärken: Volle Kontrolle, Erweiterbarkeit, riesige Community und praxiserprobte Zuverlässigkeit.
- Nachteile: Hohe Einstiegshürde für Nicht-Programmierer; keine visuelle Oberfläche.
Wenn Sie Python beherrschen und robuste, skalierbare Crawler bauen wollen, ist Scrapy der Goldstandard.
3. Octoparse
 Octoparse ist ein No-Code-Web-Scraper auf Cloud-Basis mit visueller Drag-and-drop-Oberfläche. Sie können per Klick Daten auswählen, Paginierung einrichten und sogar KI-gestützte Mustererkennung nutzen, um die Einrichtung zu beschleunigen.
- Vorgefertigte Vorlagen: Extrahieren Sie Daten von beliebten Seiten wie Amazon, Twitter und Google Maps in wenigen Minuten.
- Cloud-Scraping & Zeitplanung: Führen Sie Jobs auf den Servern von Octoparse aus, planen Sie wiederkehrende Aufgaben und bewältigen Sie große Projekte.
- Exportoptionen: CSV, Excel, JSON, API-Integration.
- Preis: Free-Tarif mit Einschränkungen; kostenpflichtige Pläne ab etwa 75 $/Monat.
Octoparse eignet sich besonders für Business Analysten und Nicht-Programmierer, die leistungsstarkes Scraping ohne Code suchen.
4. ParseHub
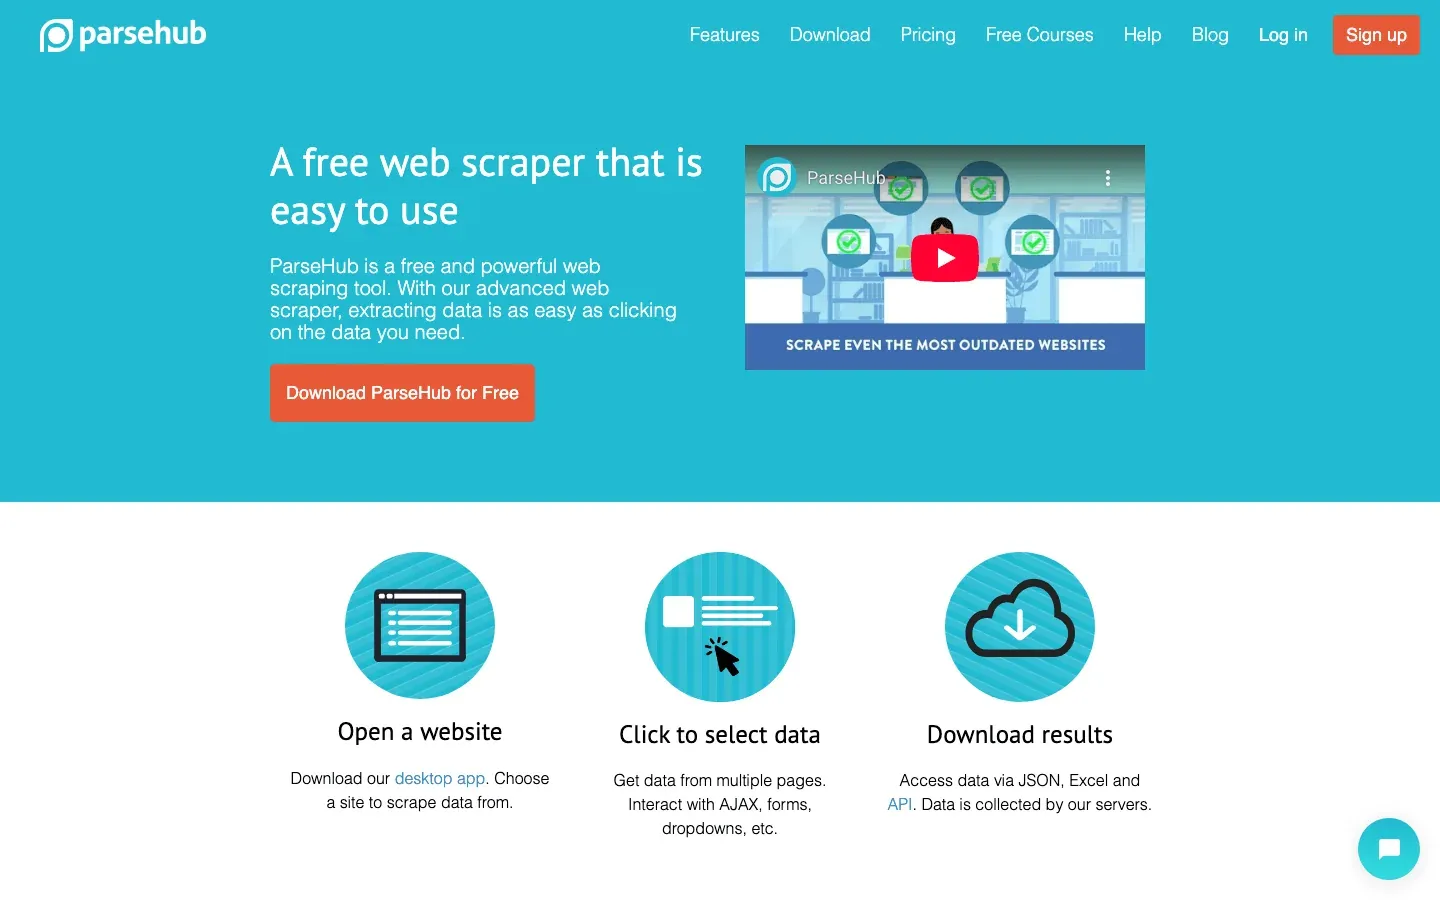 ParseHub ist ein visueller Web-Scraper, der besonders gut mit dynamischen Inhalten und komplexen Seitenstrukturen umgehen kann. Mit der Point-and-Click-Oberfläche erstellen Sie Workflows mit bedingter Logik, Schleifen und mehrstufiger Navigation.
- Dynamische Inhalte: Beherrscht Dropdowns, Infinite Scroll und interaktive Elemente.
- Cloud- & lokale Ausführung: Projekte können in der Cloud (kostenpflichtig) oder lokal für kleinere Jobs laufen.
- Export: CSV, Excel, JSON, API.
- Preis: Großzügiger Free-Tarif; kostenpflichtige Pläne ab 49 $/Monat.
ParseHub ist ideal für Nicht-Programmierer, die Flexibilität und Leistung für anspruchsvolle Websites brauchen.
5. Data Miner
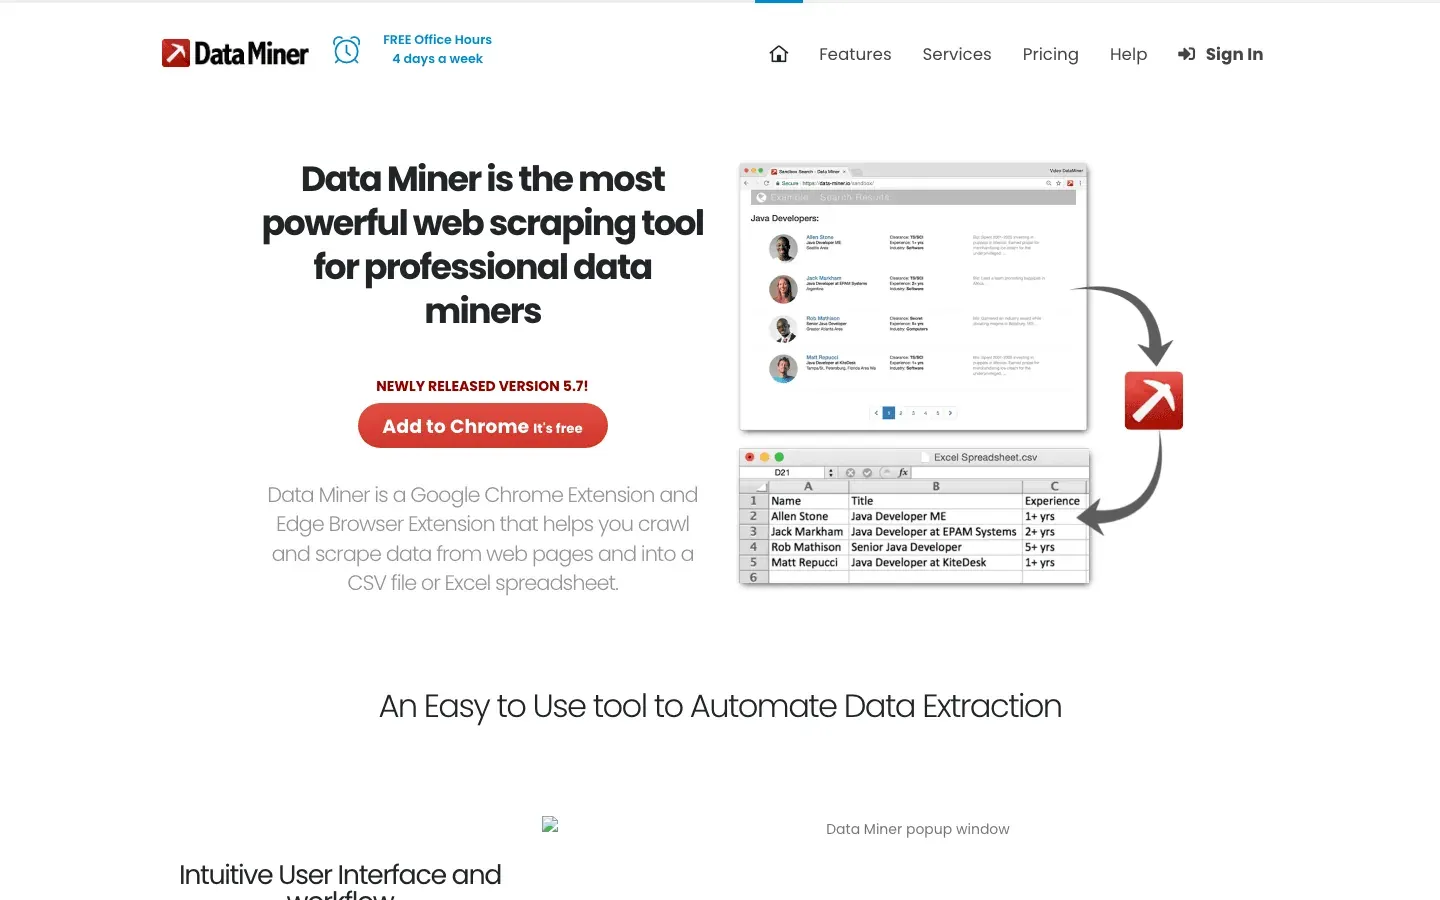 Data Miner ist eine Chrome-/Edge-Erweiterung für schnelles, vorlagenbasiertes Scraping. Mit über 50.000 öffentlichen Extraktionsrezepten für mehr als 15.000 Websites lässt sich eine Seite oft mit nur einem Klick auslesen.
- Google-Sheets-Integration: Übertragen Sie extrahierte Daten direkt in Sheets.
- Eigene Rezepte: Erstellen Sie Ihre eigene Extraktionslogik per Point-and-Click oder XPath.
- Paginierung & Automatisierung: Verarbeitet mehrseitige Scrapes und geplante Läufe.
- Preis: Free-Tarif; kostenpflichtige Pläne ab 19 $/Monat.
Perfekt für Analysten und Marketer, die schnell kleinere bis mittlere Datenmengen direkt im Browser erfassen möchten.
6. WebHarvy
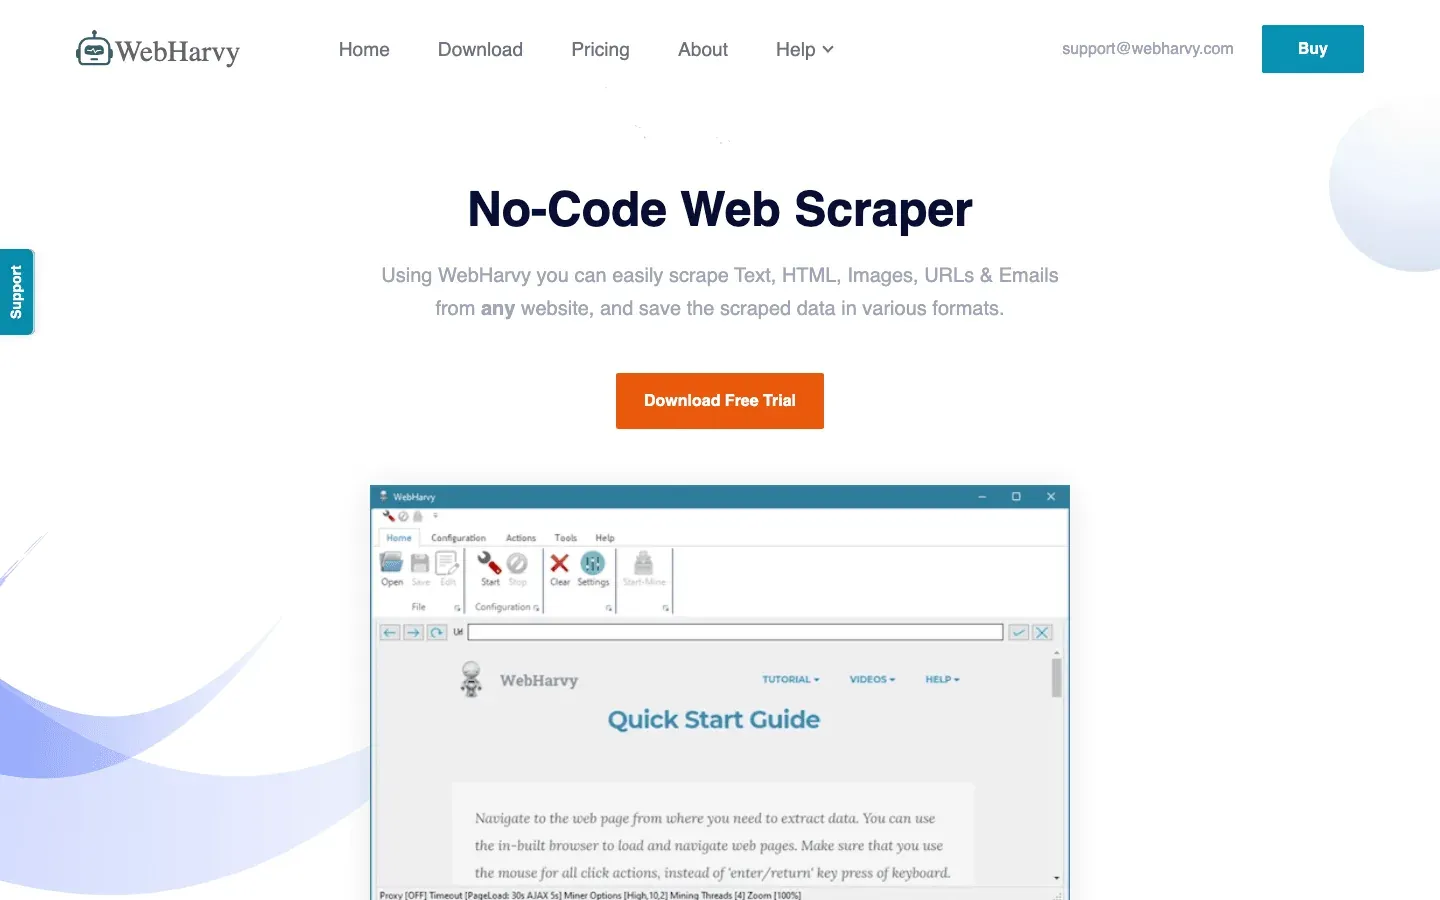 WebHarvy ist eine Windows-Desktop-App mit Point-and-Click-Oberfläche und automatischer Mustererkennung. Klicken Sie einfach auf ein Element, und WebHarvy markiert automatisch alle ähnlichen Elemente zur Extraktion.
- Unterstützt Bilder, Text und Paginierung: Extrahiert Produktfotos, E-Mails, URLs und mehr.
- Desktop-Zeitplanung: Scrapes direkt auf Ihrem PC planen.
- Einmalige Lizenz: Etwa 199 $ pro PC.
Gut geeignet für kleine Unternehmen, die ein einfaches Tool ohne Abo für gelegentliche Scraping-Aufgaben suchen.
7. Import.io
 Import.io ist eine Enterprise-Plattform auf Cloud-Basis für die Extraktion großer Datenmengen. Sie bietet KI-gestützte Datenbereinigung, Echtzeitüberwachung und starke Compliance-Funktionen.
- API-Integrationen: Liefert Daten direkt an Datenbanken, BI-Dashboards oder Anwendungen.
- Compliance: Mit Blick auf GDPR und CCPA entwickelt.
- Preis: Enterprise-Verträge; eher im höheren Preissegment.
Am besten für große Unternehmen geeignet, die zuverlässige, regelkonforme und skalierbare Web-Datenpipelines benötigen.
8. Apify
 Apify ist eine Cloud-Automatisierungsplattform und ein Marktplatz für Web-Scraping-„Actors“ (Bots). Verwenden Sie vorgefertigte Actors für gängige Websites oder erstellen Sie eigene in JavaScript oder Python.
- Marktplatz: Hunderte sofort nutzbare Scraper für Seiten wie LinkedIn, Amazon und andere.
- Zeitplanung & API: Führen Sie Actors aus, planen Sie sie und integrieren Sie sie per API.
- Preis: Free-Tarif; kostenpflichtige Nutzung ab 49 $/Monat.
Ideal für Entwickler und technisch versierte Teams, die Automatisierung, Flexibilität und community-getriebene Lösungen suchen.
9. Dexi.io
 Dexi.io ist eine cloudbasierte Plattform für gemeinsame Web-Datenprojekte. Sie bietet Workflow-Automatisierung, Zeitplanung und Teammanagement-Funktionen.
- Workflow-Automatisierung: Datenpipelines teamübergreifend erstellen und teilen.
- API & Export: Integration mit Datenbanken, Cloud-Speicher oder BI-Tools.
- Preis: Individuell; auf Teams und Unternehmen ausgerichtet.
Eine gute Wahl für Organisationen, die fortlaufende, kollaborative Datenprojekte managen.
10. Helium Scraper
 Helium Scraper ist ein Desktop-Tool, das visuelle Extraktion mit Skripting-Flexibilität kombiniert. Nutzen Sie Point-and-Click für die meisten Aufgaben oder wechseln Sie bei Bedarf zu benutzerdefiniertem JavaScript für komplexere Logik.
- Beherrscht dynamische Inhalte: Ideal für AJAX-lastige Websites.
- Datenbereinigung & Transformation: Integriertes Scripting für individuelle Workflows.
- Einmalige Lizenz: Rund 99 $.
Perfekt für Power-User, die Flexibilität ohne Abo möchten.
11. Web Scraper
 Web Scraper ist eine kostenlose Chrome-Erweiterung, die viele überhaupt erst an das Thema Web Scraping heranführt. Legen Sie eine Sitemap an, klicken Sie auf Elemente und exportieren Sie die Daten als CSV oder JSON.
- Mehrstufiges Crawling: Links folgen, Paginierung verarbeiten und verschachtelte Daten scrapen.
- Kostenlos lokal nutzbar: Eine kostenpflichtige Cloud-Version ist für Zeitplanung und größere Skalierung verfügbar.
Ideal für Einsteiger, Studierende oder alle, die eine schnelle, kostenlose Lösung für kleinere Aufgaben brauchen.
12. Mozenda
 Mozenda ist eine Enterprise-Cloud-Plattform mit Fokus auf Compliance, Skalierbarkeit und Managed Services. Über die Point-and-Click-Oberfläche erstellen Sie sogenannte „Agents“ zur Datenextraktion.
- Managed Services: Das Mozenda-Team kann Scraper für Sie entwickeln und betreuen.
- Compliance & Support: Starker Fokus auf GDPR, CCPA und Enterprise-Anforderungen.
- Preis: Ab etwa 500 $/Monat.
Am besten für große Unternehmen, die eine schlüsselfertige, skalierbare Web-Datenlösung mit starkem Support suchen.
13. SimpleIndex
 SimpleIndex ist ein Automatisierungstool für Dokumenten- und Web-Datenextraktion mit Schwerpunkt auf OCR und Indexierung.
- Screen-Scraping per OCR: Extrahiert Daten aus gescannten Dokumenten, PDFs oder sogar Webformularen auf dem Bildschirm.
- Integration: Ausgabe an Datenbanken und Dokumentenmanagementsysteme.
- Einmalige Lizenz: Einige hundert Dollar pro Arbeitsplatz.
Gut geeignet für Organisationen, die Dokumenten- und Web-Datenprozesse kombinieren.
14. Datastreamer (ehemals Spinn3r)
 Datastreamer (ehemals Spinn3r) ist eine Plattform für Echtzeit-Content-Crawling für Blogs, News und Social Media. Über die Firehose-API erhalten Sie einen fortlaufenden Strom neuer Inhalte aus Millionen von Quellen.
- Spam-Filter & Sprachverarbeitung: Liefert saubere, strukturierte Datenfeeds.
- API-Zugriff: Direkte Einbindung in Ihre Systeme.
- Abo-Preise: Nutzungsabhängig.
Ideal für Media Monitoring, News-Aggregation oder Research-Teams, die Echtzeit-Content-Ströme benötigen.
15. FMiner
 FMiner ist ein visueller Workflow-Builder für komplexe Web-Crawls. Mit der Drag-and-drop-Oberfläche können Sie mehrstufige, bedingte Scraping-Abläufe entwerfen.
- Python-Scripting: Benutzerdefinierten Code für fortgeschrittene Logik einfügen.
- Plattformübergreifend: Verfügbar für Windows und Mac.
- Einmalige Lizenz: Ab etwa 168 $.
Perfekt für Analysten oder Data Scientists, die anspruchsvolle Workflows visuell abbilden möchten.
16. G2 Webscraper
 G2 Webscraper – also die besonders hoch bewerteten Tools auf G2 – wird für seine Einfachheit und Effektivität gelobt. Nutzer lieben Tools, die kostenlos, leicht verständlich und extrem zeitsparend sind – wie die Web Scraper Chrome Extension oder Data Miner.
- Starke Nutzerbewertungen: Hohe Noten für Benutzerfreundlichkeit und Zuverlässigkeit.
- Schnelle Einrichtung: Kaum Lernaufwand für einfache bis mittlere Aufgaben.
Wenn Sie ein Tool suchen, das für unkompliziertes Scraping einfach funktioniert, sind die Favoriten auf G2 eine sichere Wahl.
Vergleichstabelle: Die besten Content-Crawling-Tools auf einen Blick
| Tool | Benutzerfreundlichkeit | Automatisierung & Funktionen | Exportformate | Compliance & Datenschutz | Preis | Am besten geeignet für |
|---|---|---|---|---|---|---|
| Thunderbit | ⭐⭐⭐⭐⭐ | KI-Felder, Unterseiten, Cloud | Excel, CSV, Sheets, Notion, Airtable, JSON | Nutzergeführt | Kostenlos, ab 15 $/Monat | Nicht-Techniker, Sales, Ops |
| Scrapy | ⭐ | Voller Code, async, Plugins | CSV, JSON, DB | Nutzerverwaltet | Kostenlos, Open Source | Entwickler, große Projekte |
| Octoparse | ⭐⭐⭐⭐ | Visuell, Vorlagen, Cloud | CSV, Excel, JSON, API | Nutzergeführt | Kostenlos, ab 75 $/Monat | Analysten, E-Commerce, No-Coder |
| ParseHub | ⭐⭐⭐⭐ | Visuell, dynamisch, Cloud | CSV, Excel, JSON, API | Nutzergeführt | Kostenlos, ab 49 $/Monat | Nicht-Techniker, komplexe Websites |
| Data Miner | ⭐⭐⭐⭐⭐ | Vorlagen, Browser, Sheets | CSV, Excel, Sheets | Nutzergeführt | Kostenlos, ab 19 $/Monat | Schnelle Browser-Jobs |
| WebHarvy | ⭐⭐⭐⭐⭐ | Visuell, Mustererkennung | Excel, CSV, XML, JSON | Nutzergeführt | 199 $ einmalig | Windows-Nutzer, kleine Unternehmen |
| Import.io | ⭐⭐⭐⭐ | KI, Cloud, Monitoring | CSV, API, DB | GDPR, CCPA | Enterprise | Große Organisationen, Compliance |
| Apify | ⭐⭐⭐ | Cloud, Marktplatz, API | JSON, API, Sheets | Nutzerverwaltet | Kostenlos, ab 49 $/Monat | Entwickler, Automatisierung, Integrationen |
| Dexi.io | ⭐⭐⭐ | Cloud, Team, Workflow | CSV, API, DB, Storage | Nutzergeführt | Individuell | Teams, laufende Projekte |
| Helium Scraper | ⭐⭐⭐ | Visuell + Scripting | CSV, DB | Nutzergeführt | 99 $ einmalig | Power-User, individuelle Logik |
| Web Scraper | ⭐⭐⭐⭐⭐ | Sitemap, Browser | CSV, JSON | Nutzergeführt | Kostenlos (lokal) | Einsteiger, kleine Aufgaben |
| Mozenda | ⭐⭐⭐ | Cloud, Managed, Compliance | CSV, API, DB | GDPR, CCPA | 500 $+/Monat | Enterprise, Managed Service |
| SimpleIndex | ⭐⭐⭐ | OCR, Web, Dokumente | DB, DMS | Nutzergeführt | 500 $ einmalig | Dokumente + Webdaten |
| Datastreamer | ⭐⭐ | Echtzeit, API | JSON, API | Nutzergeführt | Abo | Medien, News, Research |
| FMiner | ⭐⭐⭐ | Visueller Workflow, Python | CSV, DB | Nutzergeführt | 168 $ einmalig | Komplexe, visuelle Workflows |
| G2 Webscraper | ⭐⭐⭐⭐⭐ | Einfach, Browser | CSV, JSON | Nutzergeführt | Kostenlos/variabel | Einfachheit, schnelle Erfolge |
Zwei der hier früher aufgeführten Tools sind inzwischen nicht mehr enthalten. Visual Web Ripper wird von Sequentum seit 2018 nicht mehr gepflegt, und die Website von Content Grabber liefert inzwischen einen 404-Fehler, da die Produktlinie durch Sequentum Cloud ersetzt wurde. Prüfen Sie die aktuelle Verfügbarkeit, bevor Sie einen Workflow darauf aufbauen.
So wählen Sie das richtige Content-Crawling-Tool für Ihr Unternehmen aus
Das richtige Tool zu wählen bedeutet vor allem, Ihre Anforderungen mit den Stärken des Tools abzugleichen. Hier meine kurze Checkliste:
- Anwendungsfall definieren: Einmalig oder laufend? Kleine oder große Datenmengen? Öffentliche oder eingeloggte Daten?
- An Fähigkeiten anpassen: Nicht-Programmierer sollten mit Thunderbit, Octoparse, ParseHub oder WebHarvy starten. Entwickler können direkt mit Scrapy oder Apify einsteigen.
- Exportbedarf prüfen: Brauchen Sie Excel, Sheets oder API-Anbindung? Stellen Sie sicher, dass das Tool das unterstützt.
- Compliance bedenken: Wenn Sie in einer regulierten Branche arbeiten oder personenbezogene Daten scrapen, priorisieren Sie Tools mit Compliance-Funktionen (Import.io, Mozenda).
- Klein anfangen: Nutzen Sie Free-Tarife oder Testphasen, um mit echten Daten zu testen, bevor Sie sich festlegen.
- Vorausschauend denken: Werden Ihre Anforderungen wachsen? Wählen Sie ein Tool, mit dem Sie skalieren können.
Und denken Sie daran: Manchmal ist das einfachste Tool auch das beste. Überkomplizieren Sie nichts, wenn Sie nur schnell eine Tabelle brauchen.
Datenschutz und Compliance: Worauf Sie achten sollten
Web Scraping eröffnet viele Möglichkeiten – bringt aber auch Verantwortung mit sich. So bleiben Sie auf der sicheren Seite:
- robots.txt und Website-Richtlinien respektieren: Prüfen Sie immer, ob Scraping erlaubt ist, und halten Sie sich an die Vorgaben.
- Personenbezogene Daten nur mit legitimer Grundlage und Einwilligung scrapen: GDPR und CCPA sind kein Spaß.
- Server nicht überlasten: Nutzen Sie eingebaute Drosselung, Verzögerungen und Zeitplanung, um Blockierungen zu vermeiden und ein guter Internet-Bürger zu sein.
- Bei sensiblen Branchen Tools mit Compliance-Funktionen nutzen: Import.io und Mozenda sind mit Blick auf GDPR/CCPA entwickelt.
- Vorgehen dokumentieren: Halten Sie fest, was Sie scrapen und warum – besonders bei geschäftlichen oder regulierten Anwendungsfällen.
Ethisches Scraping ist nachhaltiges Scraping – und schützt Ihr Unternehmen vor Ärger.
Fazit: Stärken Sie Ihr Team mit dem richtigen Content-Crawling-Tool
Das Web ist die größte und chaotischste Datenbank Ihres Unternehmens – und mit dem richtigen Content-Crawling-Tool können Sie sie endlich nutzbar machen. Ob Lead-Listen, Wettbewerbsbeobachtung oder Echtzeit-Dashboards: Diese 18 Tools decken jedes Szenario, jedes Skill-Level und jedes Budget ab.
Wenn Sie den schnellsten Weg zu Ergebnissen suchen, ist Thunderbit meine Top-Empfehlung für Business-Anwender: KI-gestützt, No-Code und bereit, jede Website in wenigen Minuten in einen strukturierten Datensatz zu verwandeln. Aber egal, was Sie brauchen: Starten Sie mit einer kostenlosen Testphase, experimentieren Sie und finden Sie heraus, was am besten zu Ihrem Workflow passt.
Thunderbit Chrome-Erweiterung herunterladen Installieren, die gewünschte Seite öffnen, einmal klicken. Die Extraktoren für E-Mail, Telefonnummer und Bilder sind in jedem Plan kostenlos enthalten. Get Started Free
Bereit, die Copy-Paste-Mühsal hinter sich zu lassen? Laden Sie die Thunderbit Chrome-Erweiterung herunter und sehen Sie, wie einfach Webdaten sein können. Und wenn Sie tiefer ins Web Scraping einsteigen möchten, finden Sie im Thunderbit Blog weitere Guides, Tipps und Tutorials.
Thunderbit AI Web Scraper testen Get Started Free
FAQs
1. Was ist ein Content-Crawling-Tool und wie unterscheidet es sich von einem normalen Web-Scraper?
Ein Content-Crawling-Tool ist eine Art Web-Scraper, der darauf ausgelegt ist, strukturierte Daten von Websites automatisiert zu extrahieren. Zwar sammeln alle Web-Scraper Daten, doch Content-Crawling-Tools bieten oft zusätzliche Funktionen wie Zeitplanung, Navigation über Unterseiten, KI-gestützte Felderkennung und Integration in Geschäftsprozesse – dadurch sind sie für Business-Teams leistungsstärker und benutzerfreundlicher.
2. Welches Content-Crawling-Tool eignet sich am besten für technisch nicht versierte Nutzer?
Thunderbit, Octoparse, ParseHub, Data Miner und WebHarvy sind alle hervorragend für Nicht-Programmierer geeignet. Thunderbit sticht durch seine KI-gestützte Einfachheit und den sofortigen Export nach Excel, Sheets, Airtable oder Notion hervor.
3. Wie stelle ich sicher, dass mein Web Scraping legal und regelkonform ist?
Halten Sie sich immer an Website-Nutzungsbedingungen, robots.txt und Datenschutzgesetze wie GDPR und CCPA. Scrapen Sie personenbezogene Daten nur, wenn Sie eine legitime Grundlage und Einwilligung haben. Für sensible Branchen sollten Sie Tools mit integrierten Compliance-Funktionen wählen (z. B. Import.io, Mozenda).
4. Können diese Tools dynamische Websites mit JavaScript oder Infinite Scroll verarbeiten?
Ja – Tools wie Thunderbit, Octoparse, ParseHub, Apify und FMiner können dynamische Inhalte, Infinite Scroll und mehrstufige Navigation verarbeiten. Bei komplexen Websites ist teils zusätzliche Einrichtung oder Cloud-Ausführung erforderlich.
5. Worauf sollte ich bei der Auswahl eines Content-Crawling-Tools für mein Unternehmen achten?
Berücksichtigen Sie die technischen Fähigkeiten Ihres Teams, den Umfang Ihres Datenbedarfs, Export- und Integrationsanforderungen, Compliance-Aspekte und Ihr Budget. Starten Sie mit einem Free-Tarif oder einer Testphase und prüfen Sie das Tool anhand Ihres echten Anwendungsfalls, bevor Sie sich entscheiden.
Viel Erfolg beim Scraping – und mögen Ihre Daten stets frisch, strukturiert und einsatzbereit sein.
Mehr erfahren




