
Dein Glassdoor-Scraper lief 2022 noch tadellos und spuckt heute nur noch 403-Fehler aus? Damit bist du in bester Gesellschaft. In einschlägigen Foren liest man fast wöchentlich dieselbe ratlose Frage: „Weiß jemand, warum dieser Scraper plötzlich nicht mehr funktioniert?“
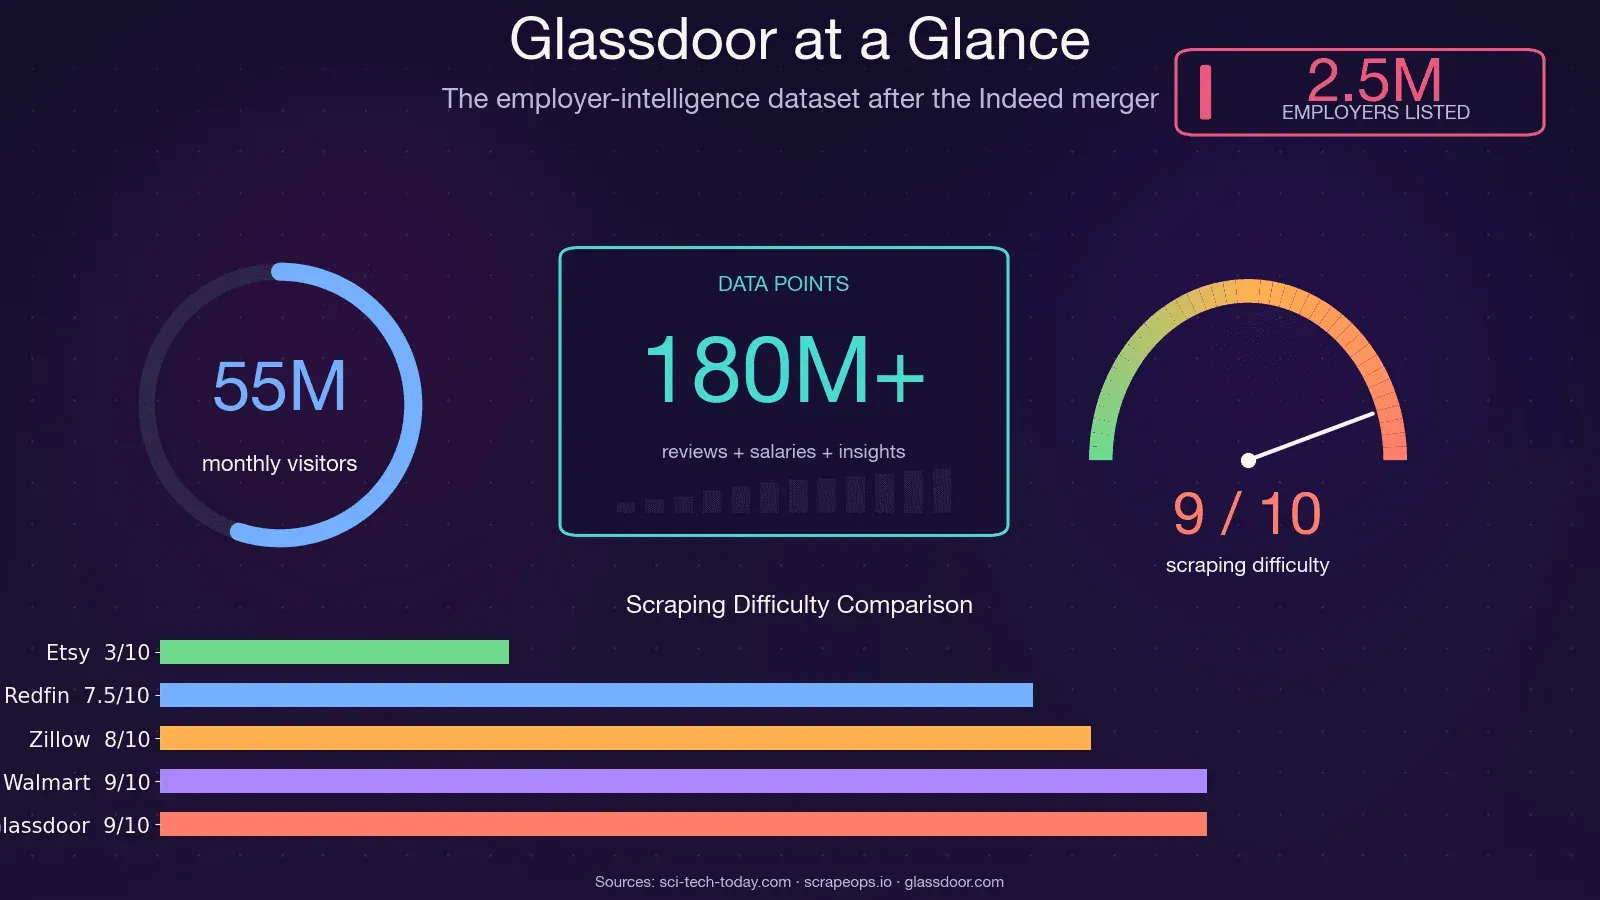
Der Grund ist schnell erklärt: Glassdoor ist nicht mehr dieselbe Plattform. Recruit Holdings hat den Dienst im Juli 2025 in Indeed integriert, 1.300 Mitarbeitende entlassen und den Anti-Bot-Schutz derart aufgerüstet, dass schlichte Selenium- oder requests-Skripte schon abgewiesen werden, bevor auch nur das erste Byte HTML über die Leitung geht. Seit Februar 2026 laufen sämtliche Glassdoor-Logins über Indeed Login — jedes Tutorial, das ein fest verdrahtetes Glassdoor-Login-Formular voraussetzt, ist damit schon an der Wurzel überholt. Trotzdem sitzt die Plattform nach wie vor auf über 180 Millionen kombinierten Bewertungen, Gehältern und Insights zu 2,5 Millionen Arbeitgebern. Für HR-Benchmarking, Wettbewerbsanalysen und Lead-Generierung im Vertrieb ist das Gold wert — sofern du überhaupt noch an die Daten kommst. Genau für diesen Stand nach all den Umbauten ist dieser Leitfaden gedacht. Er behandelt alle drei Glassdoor-Datentypen — Jobs, Bewertungen und Gehälter — an einer Stelle. Ich zeige dir den Python-Weg mit Code, der 2025 tatsächlich läuft, erkläre genau, woran du blockiert wirst und wie du das aushebelst, und für alle, die sich den technischen Teil sparen wollen, gibt es am Ende einen No-Code-Shortcut.
Warum Glassdoor 2025 mit Python scrapen?
Glassdoor ist weit mehr als eine Jobbörse. Es ist einer der ergiebigsten Datensätze für Arbeitgeber-Intelligence im Netz — rund ein Drittel der Fortune-500-Unternehmen greift darauf zu, und monatlich kommen etwa 55 Millionen eindeutige Besucher zusammen. Was auf diesen Seiten steht, fließt quer durch mehrere Teams in echte Geschäftsentscheidungen ein.
In der Praxis verwerten unterschiedliche Teams die Daten so:
| Anwendungsfall | Benötigter Datentyp | Wer profitiert |
|---|---|---|
| Gehaltsbenchmarking | Gehaltsverteilungen, Stichprobengrößen | HR, Total Rewards, Operations |
| Tracking der Personalaktivität von Wettbewerbern | Stellenanzeigen, Veröffentlichungsfrequenz | Vertrieb, Strategie, VC/Corp Dev |
| Monitoring der Arbeitgebermarke | Bewertungstexte, Rating-Trends, CEO-Zustimmungswerte | HR, Marketing, Kommunikation |
| Lead-Generierung (wachsende Unternehmen) | Stellenanzeigen + Unternehmensinfos | Vertriebsteams, SDRs |
| Markt- und Hochschulforschung | Alle drei | Analysten, Berater, Forschende |
Wie ernst Analysten diese Datenbasis inzwischen nehmen, zeigt eine Episode vom Oktober 2025: Während des US-Regierungsstillstands konnte das BLS keine Arbeitsmarktdaten veröffentlichen — also legte Glassdoors eigenes Economic Research Team kurzerhand einen alternativen Jobbericht auf Basis des eigenen Datensatzes vor.
Python bleibt für solche Aufgaben die erste Wahl, und zwar wegen des Ökosystems: Playwright für die Browser-Automatisierung, parsel und lxml fürs Parsen, curl_cffi gegen TLS-Fingerprinting und eine riesige Community, die funktionierende Ansätze teilt. An Python liegt es also nicht. Es liegt schlicht daran, dass Glassdoor heute deutlich schwerer zugänglich ist.
Glassdoor-Daten mit KI scrapen Get Started Free
Falls du eine No-Code-Alternative zum Extrahieren von Glassdoor-Daten suchst: Thunderbit holt dir Jobs, Bewertungen und Gehaltsseiten heraus, ohne dass du einen eigenen Python-Stack aufsetzen und am Leben halten musst.
Welche Glassdoor-Daten lassen sich überhaupt scrapen?
Die meisten Tutorials beschränken sich auf Stellenanzeigen. Am stärksten nachgefragt — gemessen an den Forum-Threads, GitHub-Issues und Reddit-Fragen, die ich über die Zeit verfolgt habe — sind aber ausgerechnet die beiden Datentypen, die fast niemand erklärt: Bewertungen und Gehälter. Hier die vollständige Übersicht, was sich in allen drei Kategorien herausholen lässt.
Stellenanzeigen
Der zugänglichste Datentyp. Auslesen kannst du u. a. Jobtitel, Firmenname, Standort, Gehaltsschätzung, Firmenbewertung, Veröffentlichungsdatum, Easy-Apply-Kennzeichnung und den Link zur Stelle. Stellenanzeigen sind teils sogar ohne Login zu haben — wobei Glassdoor nach ein paar Seiten gern eine Login-Einblendung dazwischenschiebt.
Unternehmensbewertungen
Hier wird es für die Analyse der Arbeitgebermarke richtig interessant. Extrahierbar sind unter anderem: Gesamtbewertung, Teilbewertungen (Work-Life-Balance, Kultur & Werte, Diversität & Inklusion, Karrierechancen, Vergütung & Benefits, obere Führungsebene), Pro-Text, Contra-Text, Jobtitel der bewertenden Person, Bewertungsdatum und Beschäftigungsstatus. Der vollständige Bewertungstext steckt hinter einem Login — frei sichtbar ist nur ein Ausschnitt, der komplette Pro-/Contra-Teil verlangt Authentifizierung.
Gehaltsdaten
Der am häufigsten gewünschte und zugleich nervigste Datentyp. Herausholen kannst du Jobtitel, Grundgehaltsspanne, Gesamtvergütungsspanne, Anzahl der Gehaltsmeldungen und Standort. Allerdings sind Gehaltsseiten komplett login-geschützt, und Glassdoor schaltet teilweise zusätzlich einen „beitragen, um freizuschalten“-Flow davor: Erst musst du dein eigenes Gehalt einreichen, dann siehst du die Daten der anderen. Funktionierenden Code dafür liefert kein konkurrierendes Tutorial — das holen wir hier nach.
Was Login erfordert und was nicht
Diese Tabelle erspart dir das frustrierende Ausprobieren, welche Seiten leer zurückkommen:
| Datentyp | Ohne Login verfügbar? | Hinweise |
|---|---|---|
| Titel und Basisinfos von Stellenanzeigen | Meist ja | Popup kann nach einigen Seiten erscheinen |
| Vollständige Stellenbeschreibungen | Teilweise | Oft nach 2–3 Ansichten gesperrt |
| Unternehmensbewertungen (voller Text) | Nein — Login erforderlich | Ausschnitt sichtbar, Volltext gesperrt |
| Gehaltsdaten | Nein — Login erforderlich | Eventuell zusätzlich „beitragen, um freizuschalten“ |
Warum dein alter Glassdoor-Scraper wahrscheinlich kaputt ist
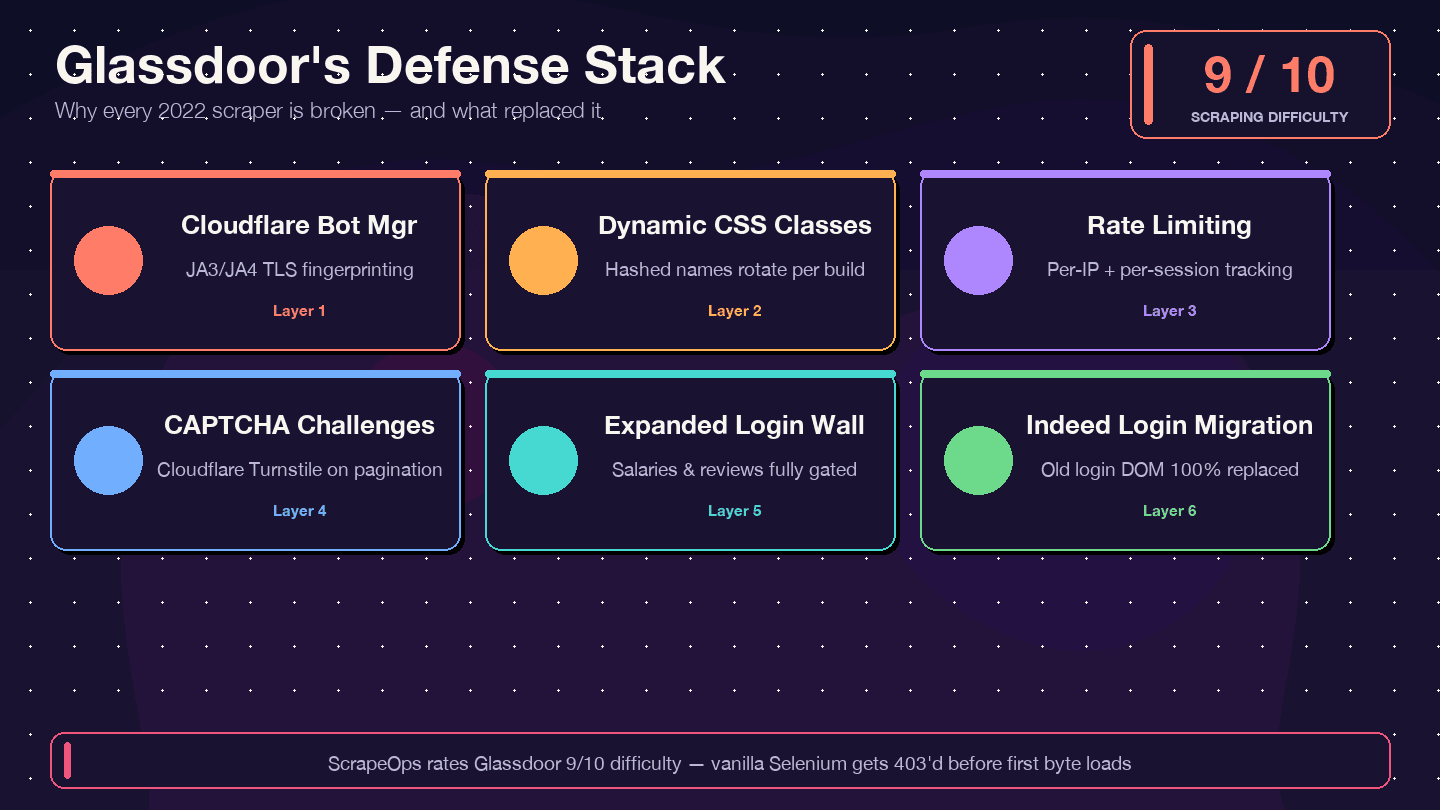
Sagen wir es geradeheraus: Wer Code aus einem Tutorial der Jahre 2021 bis 2023 kopiert, wird damit nicht weit kommen. Der am meisten gesternte alte Glassdoor-Selenium-Scraper auf GitHub (MatthewChatham/glassdoor-review-scraper, rund 1,4k Sterne) schleppt mehr als 12 offene, ungelöste Issues mit sich herum — darunter „Glassdoor new UI design“, „Cloudflare anti-bot protection“ und „NoSuchElementException“. Faktisch wird das Repo nicht mehr gepflegt. Apifys glassdoor-jobs-scraper Actor trägt das Label DEPRECATED. Und ScrapeOps stuft Glassdoor bei der allgemeinen Scraping-Schwierigkeit mit 9/10 ein, bei der Umgehung mit 8/10.
Das hat sich verschoben — und deshalb geht alter Code in die Knie:
| Schutzschicht | Was sich geändert hat | Auswirkung auf alte Scraper |
|---|---|---|
| Cloudflare Bot Management | Strengere JA3/JA4-Fingerprinting-Prüfungen seit 2024 | Einfache requests-/Selenium-Skripte werden sofort mit 403 blockiert |
| Dynamische CSS-Klassennamen | Klassennamen werden bei jedem Build neu generiert | Alte CSS-Selektoren aus Tutorials funktionieren still und leise nicht mehr |
| Rate-Limiting + Session-Tracking | Strengere Limits pro IP und Sitzung | Scraper werden nach weniger Seiten blockiert |
| CAPTCHA-Hürden (vermutlich Cloudflare Turnstile) | Häufiger, vor allem bei der Seitennavigation | Headless-Browser lösen Challenges aus |
| Erweiterte Login-Schranke | Mehr Seitentypen erfordern Authentifizierung | Gehalts- und Bewertungsseiten liefern leere Daten |
| Migration zu Indeed Login (Feb. 2026) | Glassdoor-Loginformular vollständig ersetzt | Jeder Code, der das alte Login-DOM anspricht, ist hinfällig |
Scrapflys Leitfaden von 2026 bringt es auf den Punkt: „Glassdoor is known for its high blocking rate, so if you get None values while running the Python code, it's likely you're getting blocked.“ Noch direkter formuliert es ein DEV.to-Beitrag von März 2026: „Simple HTTP requests with requests or httpx get blocked instantly.“
Genau gegen diese Schutzschichten sind die Gegenmaßnahmen gebaut, die ich dir zeige: Patchright (ein stealth-orientierter Playwright-Fork), data-test-Selektoren, rotierende Residential Proxies und authentifizierte persistente Sessions.
Glassdoor API vs. Python-Scraping: Zuerst den richtigen Ansatz wählen
In etlichen Foren kommt früher oder später die Frage: „Soll ich nicht einfach die Glassdoor API nehmen?“ — die ehrliche Antwort lautet: Das geht nicht.
Die alte Glassdoor Partner API nimmt keine neuen Anträge mehr an. Das Developer-Portal existiert formal zwar weiter, antwortet aber mit HTTP 403. Eine öffentliche Reviews-API hat es nie gegeben — MatthewChathams Scraper entstand ausdrücklich, „weil Glassdoor keine API für Bewertungen hat“. Und unter der Indeed Publisher API gibt es für Bewertungen oder Gehälter schlicht keinen Migrationspfad.
So sieht der ehrliche Vergleich aus:
| Faktor | Glassdoor Partner API v1 | Python-Scraping | Thunderbit (No-Code) |
|---|---|---|---|
| Zugriff | Für neue Anträge geschlossen | Offen (du setzt es selbst um) | Chrome-Erweiterung |
| Stellenanzeigen | Eingeschränkt/auslaufend | Mit Aufwand verfügbar | Verfügbar |
| Unternehmensbewertungen | Öffentlich nie vorhanden | Ja (Login nötig) | Ja (über Browser Mode) |
| Gehaltsdaten | Öffentlich nie vorhanden | Ja (Login nötig) | Ja |
| Rate Limits | Nicht dokumentiert | Du kontrollierst das Tempo | Credit-basiert |
| Einrichtungsaufwand | Keine neuen Apps registrierbar | Stunden bis Tage | Ca. 2 Minuten |
| Wartungsaufwand | Nicht anwendbar | Hoch (HTML-Änderungen brechen Code) | Gering (KI schlägt Felder neu vor) |
Wenn es dir um Bewertungen oder Gehaltsdaten geht — und das trifft auf die meisten zu, die bis hierher gelesen haben — bleiben dir realistisch nur zwei Wege: Python-Scraping oder ein No-Code-Tool.
Bevor du startest
- Schwierigkeit: Mittelstufe (du solltest dich mit Python und dem Terminal wohlfühlen)
- Zeitaufwand: ca. 30–60 Minuten für die komplette Einrichtung; danach etwa 10 Minuten pro Datentyp
- Was du brauchst:
- Python 3.10+ (empfohlen: 3.11 oder 3.12)
- Installierter Chrome-Browser
- Ein Glassdoor-Konto (kostenlos — nötig für Gehalts- und Bewertungsdaten)
- Rotierende Residential Proxies (für mehr als ein paar Seiten)
- Optional: Thunderbit Chrome Extension, wenn du den No-Code-Weg gehen willst
Tools und Bibliotheken für Glassdoor-Scraping mit Python in 2025
Die Tool-Landschaft hat sich deutlich verschoben. Folgendes hält gegen Glassdoors aktuelle Schutzmechanismen wirklich stand.
Warum Patchright die beste Wahl für Glassdoor ist
Patchright ist ein stealth-orientierter Playwright-Fork, der den Runtime.Enable-CDP-Leak schließt — also genau die technische Schwachstelle, an der Vanilla Playwright auf Cloudflare-geschützten Seiten auffliegt. Die API ist deckungsgleich mit Playwright: Wer Playwright beherrscht, beherrscht auch Patchright. Version 1.58.2 (März 2026) ist aktuell und wird aktiv weiterentwickelt.
Im Vergleich zu den Alternativen:
- Vanilla Playwright: Wird auf Glassdoors Login-Seite durch den Runtime.Enable-Leak enttarnt
- Selenium + undetected-chromedriver: Das letzte Release von undetected-chromedriver datiert auf Februar 2024 — also faktisch Legacy. Scrapflys Benchmark attestiert ihm, es sei „auf jeder getesteten Domain fehlgeschlagen“
- requests + BeautifulSoup: Rendert kein JavaScript und fliegt durch Cloudflares TLS-Fingerprinting sofort raus
- curl_cffi: Erste Wahl für den schnellen Pfad (10–20x schneller als ein Browser), sobald Seiten
__NEXT_DATA__schon im initialen HTML mitschicken — für Login oder Zwischen-Challenges aber ungeeignet
Unterstützende Bibliotheken
- parsel (1.11.0) oder lxml (6.0.4): Schnelles HTML-/XPath-Parsen
- csv oder pandas: Datenexport
- asyncio: Asynchrones Scraping für schnellere Pagination
Proxies: nur Residential
Glassdoors Cloudflare-Schicht geht ausgesprochen hart gegen Datacenter-ASNs vor. Residential Proxies senken die Blockrate angeblich von 20–30 % auf unter 5 %. Die Einstiegspreise bewegen sich grob bei 1,75 $/GB bei IPRoyal (Aktionspreis) oder 3,00 $/GB bei Decodo. Für den produktiven Einsatz solltest du je nach Volumen mit 3–8 $/GB rechnen.
Zufällige Verzögerungen zwischen den Requests (mindestens 3–8 Sekunden, bei längeren Läufen 5–15 Sekunden) sind unabhängig von der Proxy-Qualität Pflicht.
Schritt 1: Python-Umgebung einrichten
Leg den Projektordner an und installiere den empfohlenen Stack:
mkdir glassdoor-scraper && cd glassdoor-scraper
python3.11 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip

# Core stack
pip install patchright==1.58.2 parsel==1.11.0

# Browser-Binaries installieren
patchright install chromium

# Optional: schneller Pfad für __NEXT_DATA__-Extraktion
pip install "curl_cffi==0.15.0"
Jetzt sollte Patchright ein Chromium-Binary herunterladen. Schlägt patchright install chromium fehl, prüfe, ob genug Speicherplatz frei ist (ca. 300 MB) und ob deine Python-Version mindestens 3.10 ist.
Schritt 2: Patchright starten und zu Glassdoor navigieren
So sieht der grundlegende Start aus, der mit Glassdoors Cloudflare-Schicht funktioniert:
from patchright.sync_api import sync_playwright
import random, time

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=False,          # Headless ist weiterhin leichter erkennbar
        channel="chrome",        # echtes Chrome statt mitgeliefertem Chromium verwenden
    )
    context = browser.new_context(
        viewport={"width": 1440, "height": 900},
        locale="en-US",
        timezone_id="America/New_York",
        user_agent=(
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/134.0.0.0 Safari/537.36"
        ),
    )
    page = context.new_page()
    page.goto(
        "https://www.glassdoor.com/Job/new-york-data-engineer-jobs-"
        "SRCH_IL.0,8_IC1132348_KO9,22.htm"
    )

    # Login-Overlay ausblenden — der Inhalt ist trotzdem noch im DOM vorhanden
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)

    page.wait_for_selector("[data-test='jobListing']")
    print("Seite geladen — Stellenanzeigen sichtbar.")
Zwei Stellen sind hier entscheidend. Mit dem Flag channel="chrome" greift Patchright auf dein lokal installiertes Chrome-Binary zu statt auf das mitgelieferte Chromium — der Browser-Fingerprint wirkt damit deutlich glaubwürdiger. Der add_style_tag-Trick wiederum blendet Glassdoors Login-Modal (#HardsellOverlay) aus, ganz ohne Klick. Scrapfly bestätigt: „der gesamte Inhalt noch da ist, nur vom Overlay verdeckt wird“ — die Daten stecken also im HTML, egal ob das Modal sichtbar ist oder nicht.
Auf dem Bildschirm sollte jetzt ein Chrome-Fenster die Glassdoor-Jobsuche öffnen und die Jobkarten anzeigen, ohne dass das Login-Popup die Sicht versperrt.
Schritt 3: Glassdoor-Stellenanzeigen scrapen
Stabile Selektoren finden
Glassdoor würfelt CSS-Klassennamen bei jedem Build neu durch — der Selektor .jobCard_xyz123 aus einem 2023er-Tutorial liefert daher heute klammheimlich nichts mehr. Greif stattdessen zu den data-test-Attributen, die Glassdoor intern fürs QA nutzt und die über Deployments hinweg stabil bleiben.
Hier die Selektor-Referenz für die Felder in Stellenanzeigen:
| Feld | Selektor |
|---|---|
| Jobkarten-Container | [data-test="jobListing"] |
| Jobtitel | [data-test="job-title"] |
| Job-Link | a[data-test="job-link"] |
| Firmenname | [data-test="employer-name"] |
| Standort | [data-test="emp-location"] |
| Gehaltsspanne | [data-test="detailSalary"] |
| Firmenbewertung | [data-test="rating"] |
| Veröffentlichungsdatum | [data-test="job-age"] |
| Nächste Seite | [data-test="pagination-next"] |
Jobdaten extrahieren
from parsel import Selector
import csv, random, time

def scrape_jobs(page, max_pages=5):
    all_jobs = []

    for page_num in range(1, max_pages + 1):
        html = page.content()
        sel = Selector(text=html)
        cards = sel.css('[data-test="jobListing"]')

        if not cards:
            print(f"Seite {page_num}: Keine Karten gefunden — möglicher Block oder Selektorwechsel.")
            break

        for card in cards:
            job = {
                "title": card.css('[data-test="job-title"]::text').get("").strip(),
                "company": card.css('[data-test="employer-name"]::text').get("").strip(),
                "location": card.css('[data-test="emp-location"]::text').get("").strip(),
                "salary": card.css('[data-test="detailSalary"]::text').get("").strip(),
                "rating": card.css('[data-test="rating"]::text').get("").strip(),
                "link": card.css('a[data-test="job-link"]::attr(href)').get(""),
                "posted": card.css('[data-test="job-age"]::text').get("").strip(),
            }
            if job["link"] and not job["link"].startswith("http"):
                job["link"] = "https://www.glassdoor.com" + job["link"]
            all_jobs.append(job)

        print(f"Seite {page_num}: {len(cards)} Jobs extrahiert")

        # Pagination
        next_btn = page.query_selector('[data-test="pagination-next"]')
        if next_btn and page_num < max_pages:
            next_btn.click()
            time.sleep(random.uniform(3, 8))
            page.wait_for_selector("[data-test='jobListing']")
        else:
            break

    return all_jobs
Als CSV speichern
def save_to_csv(jobs, filename="glassdoor_jobs.csv"):
    if not jobs:
        print("Keine Jobs zum Speichern vorhanden.")
        return
    keys = jobs[0].keys()
    with open(filename, "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=keys)
        writer.writeheader()
        writer.writerows(jobs)
    print(f"{len(jobs)} Jobs in {filename} gespeichert")
Noch ein Wort zum Pagination-Limit: Glassdoor deckelt Suchergebnisse bei rund 30 Seiten, unabhängig davon, wie viele Treffer es insgesamt gibt. Brauchst du mehr Abdeckung, arbeite mit Filtern (Ort, Jobtyp, Gehaltsspanne) und schneidest jede Suche enger zu, statt gegen das Limit anzurennen.
In meinen Tests brauchte das Scrapen von 5 Seiten Stellenanzeigen (etwa 75 Jobs) samt zufälliger Verzögerungen rund 45 Sekunden. Von Hand wären das mindestens 20 Minuten Copy-Paste.
Schritt 4: Glassdoor-Unternehmensbewertungen scrapen
Das ist der Abschnitt, für den dir kein anderes Tutorial funktionierenden Code an die Hand gibt. In den Bewertungen steckt die eigentliche Arbeitgeber-Intelligenz — Sentiment-Analyse, Kultur-Signale, Warnsignale beim Management.
Zur Bewertungsseite navigieren
Bewertungs-URLs folgen dem Muster /Reviews/{Company}-Reviews-E{id}.htm. Die Employer-ID findest du, indem du ein Unternehmen auf Glassdoor suchst und einen Blick in die URL wirfst.
def navigate_to_reviews(page, company_reviews_url):
    page.goto(company_reviews_url)
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)
    page.wait_for_selector('[data-test="review"]', timeout=15000)
Der versteckte BFF-Endpunkt (der sauberste Weg)
Die wichtigste Erkenntnis aus meiner Recherche: Glassdoor-Bewertungen haben eine funktionierende interne JSON-API, die das HTML-Parsen komplett überspringt. Das Scrapfly-Scrapers-Repo dokumentiert diesen Endpunkt, und er arbeitet spürbar zuverlässiger als DOM-Scraping.
import json, re, requests

def get_review_ids(page):
    """Extrahiert employerId und dynamicProfileId aus dem HTML der Bewertungsseite."""
    html = page.content()
    sel = Selector(text=html)
    script_text = sel.xpath(
        "//script[contains(text(), 'profileId')]/text()"
    ).get("")
    employer_match = re.search(r'"employer"\s*:\s*(\{[^}]+\})', script_text)
    if employer_match:
        meta = json.loads(employer_match.group(1))
        return meta.get("id"), meta.get("profileId")
    return None, None

def fetch_reviews_bff(page, employer_id, profile_id, max_pages=5):
    """Ruft Glassdoors internen BFF-Endpunkt für strukturierte Bewertungsdaten auf."""
    all_reviews = []
    cookies = {c["name"]: c["value"] for c in page.context.cookies()}

    for pg in range(1, max_pages + 1):
        payload = {
            "applyDefaultCriteria": True,
            "employerId": employer_id,
            "dynamicProfileId": profile_id,
            "employmentStatuses": ["REGULAR", "PART_TIME"],
            "language": "eng",
            "onlyCurrentEmployees": False,
            "page": pg,
            "pageSize": 10,
            "sort": "DATE",
            "textSearch": "",
        }
        resp = requests.post(
            "https://www.glassdoor.com/bff/employer-profile-mono/employer-reviews",
            json=payload,
            cookies=cookies,
            headers={"Content-Type": "application/json"},
        )
        if resp.status_code != 200:
            print(f"BFF lieferte auf Seite {pg} Status {resp.status_code}")
            break

        data = resp.json()
        reviews = data.get("data", {}).get("employerReviews", {}).get("reviews", [])
        total_pages = data.get("data", {}).get("employerReviews", {}).get("numberOfPages", 1)

        for r in reviews:
            all_reviews.append({
                "title": r.get("summary", ""),
                "rating": r.get("ratingOverall"),
                "pros": r.get("pros", ""),
                "cons": r.get("cons", ""),
                "author_role": r.get("jobTitle", {}).get("text", ""),
                "date": r.get("reviewDateTime", ""),
                "recommend": r.get("isRecommend"),
            })

        print(f"Bewertungsseite {pg}/{total_pages}: {len(reviews)} Bewertungen erhalten")
        if pg >= total_pages:
            break
        time.sleep(random.uniform(3, 6))

    return all_reviews
Der BFF-Endpunkt gibt sauberes JSON mit allen Bewertungsfeldern aus — kein HTML-Parsen, keine zerbrochenen CSS-Selektoren. Voraussetzung sind Session-Cookies aus einem authentifizierten Playwright-Kontext (siehe Schritt 6 weiter unten), und du musst vorab die employerId sowie die dynamicProfileId aus dem HTML der Bewertungsseite herausziehen.
HTML-Fallback-Selektoren für Bewertungen
Sollte sich der BFF-Endpunkt ändern oder du lieber DOM-basiert arbeiten, hier die stabilen data-test-Selektoren:
| Feld | Selektor |
|---|---|
| Bewertungs-Container | [data-test="review"] |
| Überschrift | [data-test="review-title"] |
| Gesamtbewertung | [data-test="overall-rating"] |
| Pro | [data-test="pros"] |
| Contra | [data-test="cons"] |
| Datum | [data-test="review-date"] |
| Rolle der Autorin/des Autors | [data-test="author-jobTitle"] |
Schritt 5: Glassdoor-Gehälter scrapen
Gehaltsseiten sind komplett login-geschützt. Ohne eine authentifizierte Sitzung (Schritt 6) liefert dieser Code keine echten Daten zurück — das ist Voraussetzung, nicht Kür.
Zur Gehaltsseite navigieren
Gehalts-URLs folgen dem Muster /Salary/{Company}-Salaries-E{id}.htm, paginiert als _P{n}.htm.
def scrape_salaries(page, salary_url, max_pages=3):
    all_salaries = []

    for pg in range(1, max_pages + 1):
        url = salary_url if pg == 1 else salary_url.replace(".htm", f"_P{pg}.htm")
        page.goto(url)
        page.add_style_tag(content="""
            #HardsellOverlay { display: none !important; }
            body { overflow: auto !important; position: initial !important; }
        """)
        time.sleep(random.uniform(3, 7))

        html = page.content()
        sel = Selector(text=html)
        items = sel.css('[data-test="salary-item"]')

        if not items:
            print(f"Gehaltseite {pg}: Keine Einträge — mögliches Login-Gate oder Block.")
            break

        for item in items:
            salary = {
                "job_title": item.css('[class*="SalaryItem_jobTitle__"]::text').get("").strip(),
                "salary_range": item.css('[class*="SalaryItem_salaryRange__"]::text').get("").strip(),
                "count": item.css('[class*="SalaryItem_salaryCount__"]::text').get("").strip(),
            }
            all_salaries.append(salary)

        print(f"Gehaltseite {pg}: {len(items)} Einträge extrahiert")

    return all_salaries
Achte auf das Muster [class*="SalaryItem_jobTitle__"]. Glassdoors Gehaltsseite arbeitet mit CSS-Module-Hashes, etwa SalaryItem_jobTitle__XWGpT, wobei sich der Hash-Teil bei jedem Deploy ändert. Der Präfix bleibt konstant — der Hash nicht. Den vollständigen Klassennamen also auf keinen Fall hart verdrahten.
Schritt 6: Die Login-Schranke von Glassdoor überwinden
Das ist der entscheidende Schritt, um Gehaltsdaten und vollständige Bewertungstexte freizuschalten. Die Idee dahinter: Du loggst dich einmal manuell in einem sichtbaren Browser ein, sicherst den authentifizierten Sitzungszustand und greifst bei allen weiteren Läufen darauf zurück.
Deine authentifizierte Sitzung speichern
Dieses Skript läuft genau einmal. Es öffnet ein Chrome-Fenster, navigiert zur Glassdoor-Login-Seite (die inzwischen auf Indeed Login weiterleitet) und wartet, bis du dich von Hand anmeldest:
import asyncio
from pathlib import Path
from patchright.async_api import async_playwright

STATE_FILE = Path("glassdoor_state.json")

async def login_and_save():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=False, channel="chrome")
        context = await browser.new_context(
            viewport={"width": 1366, "height": 800},
            locale="en-US",
        )
        page = await context.new_page()
        await page.goto("https://www.glassdoor.com/profile/login_input.htm")
        print("Melde dich im Browserfenster an und drücke dann hier Enter...")
        input()
        await context.storage_state(path=str(STATE_FILE))
        print(f"Sitzung gespeichert unter {STATE_FILE}")
        await browser.close()

asyncio.run(login_and_save())
Sobald du eingeloggt bist und Enter gedrückt hast, schreibt Patchright sämtliche Cookies und den Local Storage in glassdoor_state.json. In dieser Datei liegen deine gdId, GSESSIONID, cf_clearance und die Auth-Tokens.
Sitzung für das Scraping wiederverwenden
Jeder weitere Scraping-Lauf lädt einfach den gespeicherten Zustand — manuelles Einloggen entfällt dann:
async def scrape_with_auth(target_url):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, channel="chrome")
        context = await browser.new_context(
            storage_state="glassdoor_state.json"
        )
        page = await context.new_page()
        await page.goto(target_url)
        await page.add_style_tag(
            content="#HardsellOverlay{display:none!important}"
        )
        await page.wait_for_load_state("networkidle")
        html = await page.content()
        await browser.close()
        return html
Die gespeicherte Sitzung hält bei aktiver Nutzung meist 20–30 Minuten, bevor Glassdoor erneut nachprüft. Für längere Läufe lohnt sich ein eingebauter Check: Liefert eine Seite, die eigentlich Daten enthalten müsste, null Ergebnisse, starte das Login-Skript noch einmal und erneuere den State.
Login-Popup erkennen und ausblenden
Auf nur teilweise geschützten Seiten (etwa Stellenanzeigen, deren Daten sichtbar sind, über die sich aber ein Overlay legt) zieht der CSS-Injection-Ansatz aus den vorherigen Schritten:
page.add_style_tag(content="""
    #HardsellOverlay, .LoginModal { display: none !important; }
    body { overflow: auto !important; position: initial !important; }
""")
Das greift allerdings nur, wenn das HTML die Daten bereits unter dem Overlay mitliefert. Bei vollständig serverseitig geschützten Seiten (Gehälter, tiefere Bewertungsseiten) führt kein Weg an der authentifizierten Sitzung aus Schritt 6 vorbei.
Tipps, damit dein Glassdoor-Scraper stabil läuft
Glassdoor schraubt oft am Frontend. So baust du Robustheit in deinen Scraper ein.
data-test-Attribute statt Klassennamen verwenden
Glassdoor würfelt CSS-Klassennamen durch, lässt die data-test-Attribute aber meist unangetastet. Nimm also immer [data-test="jobListing"] statt .jobCard_abc123. Fehlt ein data-test — wie bei den Gehaltsfeldern —, hilft der Präfix-Match-Ansatz: [class*="SalaryItem_jobTitle__"].
Proxies rotieren und Verzögerungen zufällig gestalten
Setz auf rotierende Residential Proxies — Datacenter-IPs werden fast augenblicklich geprüft. Streu zwischen den Seitenaufrufen zufällige Pausen von 3–8 Sekunden ein, bei längeren Läufen eher 5–15 Sekunden. Vermeide das Scrapen nach Möglichkeit während der US-Geschäftszeiten, wenn Cloudflares Verhaltensanalyse am wachsamsten ist.
Auf Brüche achten
Bau eine schlichte Prüfung ein: Liefert eine Seite, die Daten enthalten müsste, null extrahierte Datensätze, behandle das als Selektorproblem statt als leeres Ergebnis — und lass dich benachrichtigen. Ein kleiner wöchentlicher Testlauf deckt Brüche früh auf, denn Glassdoor rollt Frontend-Änderungen ohne Vorwarnung aus.
Den __NEXT_DATA__-Schnellpfad nutzen, wenn möglich
Glassdoor ist eine Next.js- und Apollo-GraphQL-App. Viele Seiten liefern ein <script id="__NEXT_DATA__">-Tag mit, das den kompletten GraphQL-Cache als JSON enthält. Das zu parsen ist erheblich robuster als DOM-Scraping und hebelt das Hardsell-Overlay komplett aus:
import json

def extract_next_data(html):
    sel = Selector(text=html)
    raw = sel.css("script#__NEXT_DATA__::text").get()
    if raw:
        return json.loads(raw)["props"]["pageProps"].get("apolloCache", {})
    return None
Heraus kommt der strukturierte Apollo-Cache mit allen Job-, Bewertungs- und Gehaltsfeldern — ganz ohne CSS-Selektoren. Robuster geht Extraktion kaum, denn es sind exakt dieselben Daten, die auch Glassdoors React-Frontend speisen.
Ohne Code: Glassdoor mit Thunderbit scrapen
Nicht jeder, der hier mitliest, ist Entwickler. HR-Teams, Recruiter, Sales-Ops-Analysten und Marktforscher brauchen Glassdoor-Daten genauso — sollten dafür aber nicht Playwright-Kontexte und Proxy-Rotation jonglieren müssen.
Thunderbit ist eine KI-gestützte Web-Scraper-Erweiterung für Chrome, die dieselben Job-, Bewertungs- und Gehaltsdaten ohne eine einzige Zeile Code herausholt. Ich gehöre zum Thunderbit-Team, deshalb lege ich das offen — der Grund, warum ich es hier nenne, ist aber ein anderer: Es löst die beiden hartnäckigsten Probleme beim Glassdoor-Scraping wirklich.
So funktioniert Thunderbit auf Glassdoor
Der Ablauf ist mit zwei Klicks erledigt:
- Öffne eine beliebige Glassdoor-Seite in Chrome (Jobsuche, Unternehmensbewertungen, Gehaltsseite)
- Klick in der Thunderbit-Seitenleiste auf KI-Felder vorschlagen — die KI liest den DOM der Seite und schlägt Spalten vor (Jobtitel, Unternehmen, Bewertung, Gehaltsspanne, Pro, Contra usw.)
- Klick auf Scrapen — die Daten landen ohne CSS-Selektoren oder Browser-Automatisierungscode in einer Tabelle
Thunderbit liefert ein fertiges Glassdoor Company Scraper Template mit, das pro Unternehmen in einem Lauf über 23 Felder erfasst. Für Stellenanzeigen, Bewertungen oder Gehälter funktioniert der allgemeine Workflow mit den KI-Feldvorschlägen auf jeder Glassdoor-URL.
Die Login-Schranke ohne Code umgehen
Das ist Thunderbits struktureller Trumpf bei Glassdoor. Der Browser Mode läuft in deiner eigenen Chrome-Sitzung — bist du in Chrome bei Glassdoor eingeloggt, übernimmt Thunderbit diese Cookies von selbst. Die Login-Schranke für Gehälter und Bewertungen, an der serverseitige Scraper scheitern, fällt damit weg. Kein Cookie-Management, keine persistenten Kontexte, kein Session-Code.
Unterseiten-Scraping zur Anreicherung
Starte mit einer Listenansicht (z. B. 30 Unternehmen aus einer Suche), lass Thunderbit die Zeilen erfassen und schalte dann Subpage Scraping hinzu, um jede Unternehmensseite mit Bewertungen oder Gehaltsinfos anzusteuern und die Tabelle um vollständige Beschreibungen, Bewertungstexte oder Gehaltsdetails zu ergänzen.
Export in Business-Tools
Anders als Python-Skripte, die CSV oder JSON ausspucken, exportiert Thunderbit direkt nach Google Sheets, Airtable, Notion oder Excel — in jedem Plan kostenlos. Besonders praktisch für Teams, die Daten gemeinsam auswerten und teilen müssen.
Python vs. Thunderbit: Wann du was nutzen solltest
| Situation | Empfohlener Ansatz |
|---|---|
| Wiederkehrende Datenpipeline bauen | Python + Patchright |
| Einmalige Recherche oder kleines Teamprojekt | Thunderbit |
| Programmgesteuerte Kontrolle über jedes Feld nötig | Python |
| Kein Entwickler, aber heute Glassdoor-Daten nötig | Thunderbit |
| 1.000+ Seiten in einem Lauf scrapen | Python + Proxies |
| 30 Unternehmen mit Anreicherung scrapen | Beides möglich — Thunderbit ist schneller eingerichtet |
Thunderbit startet kostenlos (6 Seiten/Monat); der Pro-Plan kostet 38 $/Monat für 3.000 Credits. Bei 1 Credit pro Ausgabezeile (2 Credits beim Subpage Scraping) reicht das für etwa 33 Läufe mit je 30 angereicherten Unternehmen pro Monat.
Thunderbit fürs Glassdoor-Scraping testen
Ist Glassdoor-Scraping legal?
Halten wir es kurz und sachlich. Glassdoors Nutzungsbedingungen untersagen automatisiertes Scraping unmissverständlich: „You may not use any robot, spider, scraper... to access the Services for any purpose without our express written permission.”
Die rechtliche Lage ist allerdings vielschichtiger als diese eine ToS-Klausel:
- Meta v. Bright Data (N.D. Cal., Jan. 2024): Das Gericht stellte fest, dass man AGB nicht zustimmen kann, ohne sich je eingeloggt zu haben — öffentliches Scraping ohne Login verstößt damit nicht dagegen
- hiQ Labs v. LinkedIn (9th Cir.): Der CFAA greift nicht beim automatisierten Sammeln öffentlich zugänglicher Daten — Fake-Accounts und Scraping im eingeloggten Zustand sind dagegen ein anderes Kapitel
- Van Buren v. United States (Supreme Court, 2021): Hat den Begriff „exceeds authorized access“ im CFAA enger gefasst
Daraus folgt praktisch: Wer öffentliche Stellenanzeigen ohne Login scrapt, bewegt sich auf vergleichsweise sicherem rechtlichem Boden. Wer mit eingeloggter Sitzung scrapt, hat bei der Anmeldung den AGB zugestimmt — und dort ist es ausdrücklich verboten. Das gilt für Python-Skripte und Thunderbits Browser Mode gleichermaßen.
Unabhängig davon solltest du dich an ein paar ethische Leitplanken halten:
- Deutlich langsamer arbeiten als ein Mensch beim Surfen
- Keine personenbezogenen Daten von Bewertenden scrapen oder weiterverkaufen
- robots.txt-Anweisungen respektieren
- Nur die Felder ziehen, die du wirklich brauchst
Fazit: Welche Methode passt zu dir?
Dieser Leitfaden hat alle drei Glassdoor-Datentypen behandelt — Jobs, Bewertungen und Gehälter — mit Code, der 2025 läuft und die Indeed-Login-Migration, das Cloudflare Bot Management sowie die rotierenden CSS-Module-Klassennamen berücksichtigt, an denen reihenweise ältere Tutorials gescheitert sind.
So entscheidest du dich:
| Deine Situation | Bester Weg |
|---|---|
| Entwickler baust eine Datenpipeline | Python + Patchright (folge der Schritt-für-Schritt-Anleitung oben) |
| Einmalige Recherche oder regelmäßige kleine Abrufe | Thunderbit (ohne Code, browserbasiert) |
| Du brauchst nur einfache Stellenanzeigen in kleinem Umfang | Prüfe zuerst, ob Glassdoor-API-Zugriff noch verfügbar ist (wahrscheinlich nicht) |
| Du brauchst ausdrücklich Gehalts- oder Bewertungsdaten | Du musst Python-Scraping oder Thunderbit nutzen — die API deckte das nie ab |
| Team ohne Entwickler, das gemeinsame Daten benötigt | Thunderbit → Export nach Google Sheets |
Glassdoors Schutzmechanismen werden sich weiterdrehen. Selektoren werden brechen. Neue Challenges werden auftauchen. Setz dir ein Lesezeichen auf diesen Leitfaden — und wenn du tiefer in Web-Scraping-Tools und -Techniken einsteigen willst, wirf einen Blick auf unsere Beiträge zu den besten automatisierten Web-Scraping-Tools, wie man mit Python Daten von einer Website scrapt und den besten Job-Scraping-Tools. Walkthroughs in Videoform findest du außerdem auf dem Thunderbit YouTube Channel.
Thunderbit für die Glassdoor-Datenextraktion testen Get Started Free
FAQs
1. Kann man Glassdoor ohne Login scrapen?
Ja, für die meisten Stellenanzeigen-Daten und die wichtigsten Unternehmensbewertungen. Nein, für vollständige Gehaltsaufstellungen oder den kompletten Bewertungstext über die ersten Seiten hinaus. Das #HardsellOverlay ist nur ein CSS-Modal — der darunterliegende HTML-Code enthält die Daten der ersten Seite weiterhin —, doch tiefere Inhalte sind serverseitig hinter Glassdoors „give-to-get“-Sperre verriegelt.
2. Welche Python-Bibliothek eignet sich 2025 am besten für Glassdoor-Scraping?
Patchright (ein stealth-orientierter Playwright-Fork) ist die Standardempfehlung. Es schließt den Runtime.Enable-CDP-Leak, den Vanilla Playwright hat und den Cloudflare gezielt abklopft. Für Listen-Seiten, die __NEXT_DATA__ schon im initialen HTML ausliefern, ist curl_cffi mit impersonate="chrome124" 10–20x schneller, kommt aber an login-geschützte Seiten nicht heran.
3. Wie vermeide ich Blockierungen beim Scrapen von Glassdoor?
Setz auf Patchright oder rebrowser-playwright (nicht Vanilla Playwright oder Selenium). Wechsle Residential Proxies — Datacenter-IPs werden sofort geprüft. Bau zufällige Pausen von 3–8 Sekunden zwischen den Seiten ein. Halte Cookies (gdId, cf_clearance, GSESSIONID) über Requests hinweg fest. Und rechne damit, dass die Sitzung nach 20–30 Minuten erneut geprüft wird.
4. Gibt es eine Glassdoor-API als Alternative zum Scraping?
Praktisch nein. Die alte Partner API ist für neue Anträge geschlossen, eine öffentliche Reviews-API gab es nie, und unter der Indeed Publisher API existiert kein Migrationspfad. Für Bewertungen und Gehaltsdaten bleibt nur Scraping oder ein No-Code-Tool wie Thunderbit.
5. Wie oft brechen Glassdoor-Scraper?
Häufig. Glassdoor rollt Frontend-Änderungen ohne Ankündigung aus, und die Hashes der CSS-Module-Klassennamen wechseln bei jedem Build. Am stabilsten extrahierst du über: (1) data-test-Selektoren, (2) den __NEXT_DATA__-JSON-Blob und (3) den internen BFF-Endpunkt für Bewertungen. Bau eine Null-Ergebnisse-Prüfung ein und lass wöchentlich einen kleinen Testlauf laufen, um Brüche früh zu bemerken.
Mehr erfahren



