
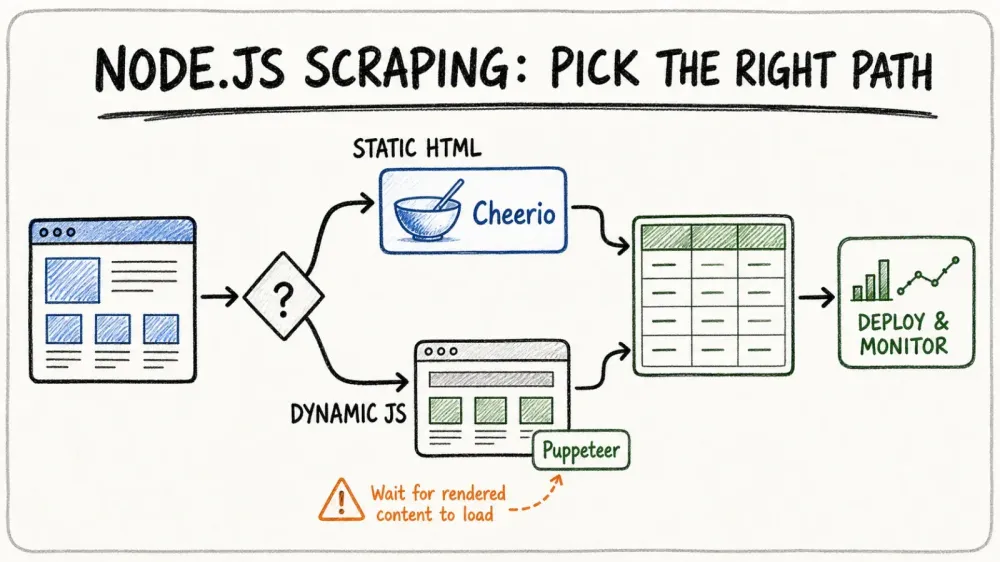
Das Web verlangt mehr denn je nach Daten, und 2026 führt Node.js die Bewegung für Teams an, die smarter statt härter scrapen wollen. Ob im Vertrieb, im E-Commerce oder einfach als Daten-Nerd wie ich – du hast vermutlich längst gemerkt, dass es beim Scraping nicht mehr nur darum geht, „an die Daten zu kommen“. Es geht darum, das schnell, in großem Umfang und ohne digitale Sperrung deiner IP zu schaffen. Die Nachfrage nimmt auch nicht ab: Öffentliche Webdaten sind still und leise zur Grundlage geworden, auf der moderne Teams alles Mögliche aufbauen – von Preisanalysen bis zu LLM-Trainingspipelines. Entsprechend sind die Einsätze und der Wettbewerb so hoch wie nie.
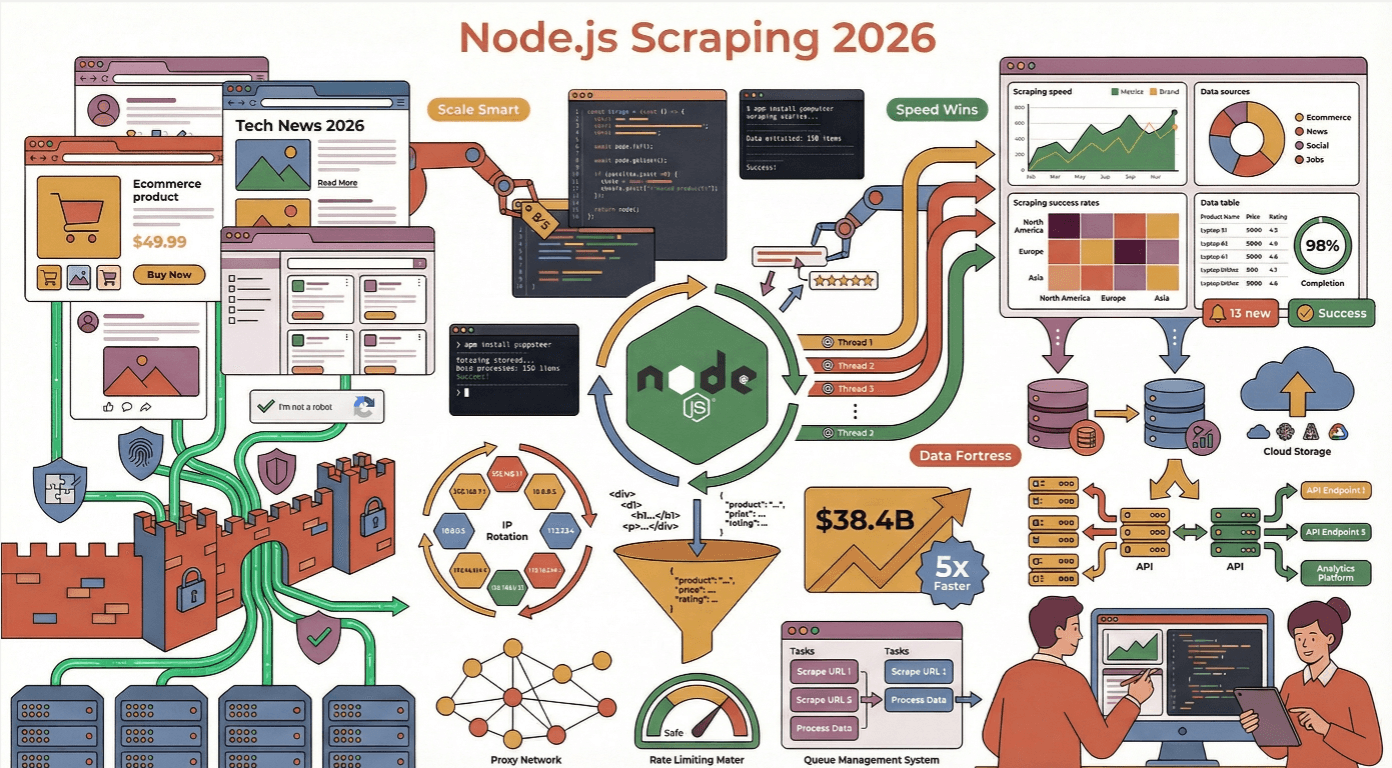
Der Haken dabei: Das moderne Web ist eine Festung aus dynamischen Inhalten, Anti-Bot-Fallen und ständig wechselnden Layouts. Ich habe mehr Scraper scheitern sehen, als ich zugeben möchte – meistens, weil Best Practices ignoriert oder die Raffinesse heutiger Anti-Scraping-Abwehr unterschätzt wurde. Deshalb schauen wir uns jetzt praxisnahe Best Practices für effizientes Web Scraping mit Node.js an – mit ein paar Geschichten, einer Portion Humor und vor allem vielen umsetzbaren Tipps.
Warum Node.js für effizientes Web Scraping?
Wenn du schon einmal versucht hast, Hunderte oder Tausende Seiten auf einmal zu scrapen, weißt du: Geschwindigkeit und Parallelität sind alles. Genau hier spielt Node.js seine Stärken aus. Sein asynchrones, nicht blockierendes I/O-Modell ist für extrem viele gleichzeitige Netzwerk-Requests gemacht – man kann es sich als den ultimativen Multitasker fürs Web vorstellen (Node.js Docs). Während andere Sprachen beim Warten auf einzelne Antworten ins Stocken geraten, dreht Node.js einfach weiter seine Event-Loop-Runden und jongliert die Requests wie ein aufgeputschter Zirkusartist.
Ich habe gesehen, wie Node.js Python und Java in Szenarien mit Echtzeit-Updates und großflächigem Datenabruf übertroffen hat – besonders dann, wenn die Zielseiten stark auf JavaScript setzen. Tatsächlich nutzen inzwischen ~40% der Entwickler Node.js für Backend- und Automatisierungsaufgaben, was es zur beliebtesten Webtechnologie der Welt macht.
Node.js im Vergleich zu anderen Web-Scraping-Frameworks
Lass uns kurz nerdig werden. So schlägt sich Node.js:
| Framework | Stärken | Schwächen | Beste Anwendungsfälle |
|---|---|---|---|
| Node.js | Asynchron, stark bei Parallelität, riesiges npm-Ökosystem, natives JS für dynamische Seiten | Kann speicherhungrig sein, Callback-Hölle (ohne async/await) | Echtzeit-Scraping, JS-lastige Seiten, skalierbare Microservices |
| Python | Viele Scraping-Bibliotheken (BeautifulSoup, Scrapy), einfache Syntax | Langsamer bei massiver Parallelität, hat Probleme mit JS-gerenderten Seiten | Statisches HTML, Research, Prototyping |
| Java | Starke Typisierung, robust für Enterprise | Viel Boilerplate, weniger flexibel für schnelle Skripte | Scraping im großen Maßstab, Enterprise-Umgebungen |
| Go | Schnell, effiziente Parallelität | Kleineres Ökosystem, steilere Lernkurve | Hochperformantes Scraping mit niedriger Latenz |
Für die meisten Business-User trifft Node.js genau den Sweet Spot: schnell, flexibel und optimal auf das moderne, von JavaScript geprägte Web abgestimmt (Thunderbit Blog).
Ein robustes Node.js-Web-Scraping-Setup aufbauen
Ein guter Scraper beginnt mit einem soliden Fundament. Das ist mein Standard-Setup:
- Projektstruktur: Halte alles modular. Nutze Ordner wie
/src,/libsund/config. Sensible Daten wie API-Keys oder Proxys gehören in Umgebungsvariablen mitdotenv(Thunderbit Guide). - HTTP-Client: Verwende axios, got oder node-fetch für Requests.
- HTML-Parsing: Cheerio für statisches HTML, Puppeteer oder Playwright für dynamische Inhalte.
- Hilfsbibliotheken: Nutze Lodash für Datenaufbereitung und validator.js oder Joi für Datenvalidierung.
- Testing & Linting: Mocha für Tests, ESLint für Codequalität (LogRocket).
Wichtige Node.js-Bibliotheken für Web Scraping
- HTTP-Clients (axios / got / eingebautes
fetch): Zum Senden von Requests. Wichtig vorab: Seit Node.js v18 kannst dufetchnativ nutzen, ohne etwas zu installieren, und mit Node.js v22 ist es als stabil markiert. Für neue Projekte auf einer aktuellen Node-Version brauchst du dasnode-fetch-Paket meistens gar nicht mehr – rufefetcheinfach direkt auf. Ich greife trotzdem oft zu axios, wenn ich Interceptors, automatische JSON-Verarbeitung und eine vertraute Promise-API über Node und Browser hinweg will. got nutze ich, wenn ich Retries, Streams oder HTTP/2 direkt eingebaut brauche. Wähle einfach das Tool, das zu deinem Stack passt; für ein schnelles Skript reicht nativesfetchvöllig aus. - Cheerio: Schneller HTML-Parser mit jQuery-ähnlicher Syntax. Perfekt für statische Seiten – das Parsen dauert etwa 0,5 Sekunden (Oxylabs).
- Playwright / Puppeteer: Headless-Browser-Automatisierung für dynamische, stark JavaScript-lastige Seiten. Langsamer (~4 Sekunden pro Seite), aber unverzichtbar für Inhalte, die erst nach dem Laden erscheinen (Bright Data). Wenn du 2026 neu startest, ist Playwright meist die Standardwahl – Cross-Browser direkt dabei (Chromium / Firefox / WebKit), mit integriertem Trace Viewer, und das Team hinter Puppeteer treibt es mittlerweile bei Microsoft voran. Puppeteer wird zwar weiterhin gepflegt, vor allem für Chrome-only-Workflows, aber die Release Notes drehen sich schon länger eher um Kompatibilität als um neue Funktionen.
- dotenv: Für Umgebungsvariablen.
- csv-writer/jsonfile: Zum Exportieren von Daten.
Häufige Stolperfallen beim Web Scraping mit Node.js vermeiden
Ich habe längst aufgehört zu zählen, wie oft Scraper blockiert, abgestürzt oder einfach nur chaotische Daten ausgespuckt haben. Darauf solltest du achten:
- robots.txt und Nutzungsbedingungen ignorieren: Vor dem Scraping immer prüfen. Verstöße können deine IP sperren – oder schlimmer noch, rechtliche Probleme verursachen (ScraperAPI).
- Server überlasten: Nicht mit Anfragen drauflosfeuern. Drossele deinen Scraper mit zufälligen Pausen (1–3 Sekunden), setze Concurrency-Limits und verhalte dich nicht wie ein hyperaktiver Roboter (ScrapeGraphAI).
- Fehler nicht behandeln: Requests immer mit try/catch absichern, HTTP-Fehler verarbeiten und Fehlversuche protokollieren. Temporäre Fehler mit exponentiellem Backoff erneut versuchen (ScrapeGraphAI).
- Request-Header vergessen: Nutze realistische User-Agent-Strings und rotiere sie. Ergänze Accept-Language, Referer und weitere Header, um echte Browser zu imitieren (ScrapeGraphAI).
Anti-Scraping-Mechanismen umgehen
Moderne Websites sind bis an die Zähne mit Anti-Bot-Technik bewaffnet. So umgehe ich die digitalen Minenfelder:
- Proxys/IPs rotieren: Nutze einen Proxy-Pool und wechsle IPs, um Sperren zu vermeiden (Medium).
- Header zufällig variieren: Wechsle User-Agent, Accept-Language und andere Header bei jedem Request.
- Stealth im Headless-Browser: Nutze Plugins wie
puppeteer-extra-plugin-stealth, um Automatisierungsspuren zu verschleiern. - Menschliches Verhalten simulieren: Füge zufällige Pausen, Mausbewegungen, Scrollen und sogar Tippfehler hinzu (ZenRows).
Menschliches Verhalten in Node.js-Scrapern simulieren
Hier wird’s spaßig – und etwas schräg. Statt sofort zu klicken und zu scrollen, lasse deinen Scraper so agieren:
- Zufällige Pausen zwischen Aktionen (
await page.waitForTimeout(randomDelay)) - Die Maus in kleinen, ungleichmäßigen Bewegungen verschieben (
page.mouse.move(x, y)) - Mit zufälligen Verzögerungen und gelegentlichen Tippfehlern schreiben (
page.type(selector, text, {delay: random(100,200)})) - Unregelmäßig scrollen, nicht einfach nur bis ganz unten
Diese Tricks können deine Erfolgsquote auf geschützten Seiten deutlich erhöhen (ScraperAPI).
Komplexe Datenextraktion mit Thunderbit vereinfachen
Daten von jeder Website mit KI extrahieren Spar dir den Boilerplate-Code: Thunderbits agentischer Web Scraper liest jede Seite aus und extrahiert Daten mit einem Klick – ganz ohne zu wartenden Node.js-Code. Get Started Free
Kommen wir zum Elefanten im Raum: Scraping ist kompliziert. Aber es muss nicht so sein. Deshalb haben wir Thunderbit gebaut.
Thunderbit ist eine agentische Web-Scraper-Chrome-Erweiterung, mit der du Daten von jeder Website in Klartext extrahieren kannst. Einfach auf „One Click Extract“ klicken, die KI erkennt automatisch die Inhalte der Seite, und dann auf „Scrape“ drücken. Das ist, als hätte man einen Junior-Entwickler, der nie schläft und nie nach einer Gehaltserhöhung fragt.
Noch besser: Thunderbit bietet eine API, sodass du es direkt in deine Node.js-Workflows einbinden kannst. Statt Tausende Zeilen Scraping-Code zu schreiben, übernimmt Thunderbit die schwere Arbeit – dynamische Inhalte, Unterseiten, Paginierung und mehr. Du holst dir einfach die strukturierten Daten als CSV, JSON oder direkt nach Google Sheets, Airtable oder Notion und machst mit deinem Tag weiter (Thunderbit Blog).
Thunderbit Chrome-Erweiterung kostenlos testen Installiere die kostenlose Chrome-Erweiterung und extrahiere strukturierte Daten mit einem Klick – oder rufe Thunderbits API direkt aus deiner Node.js-App auf. Get Started Free
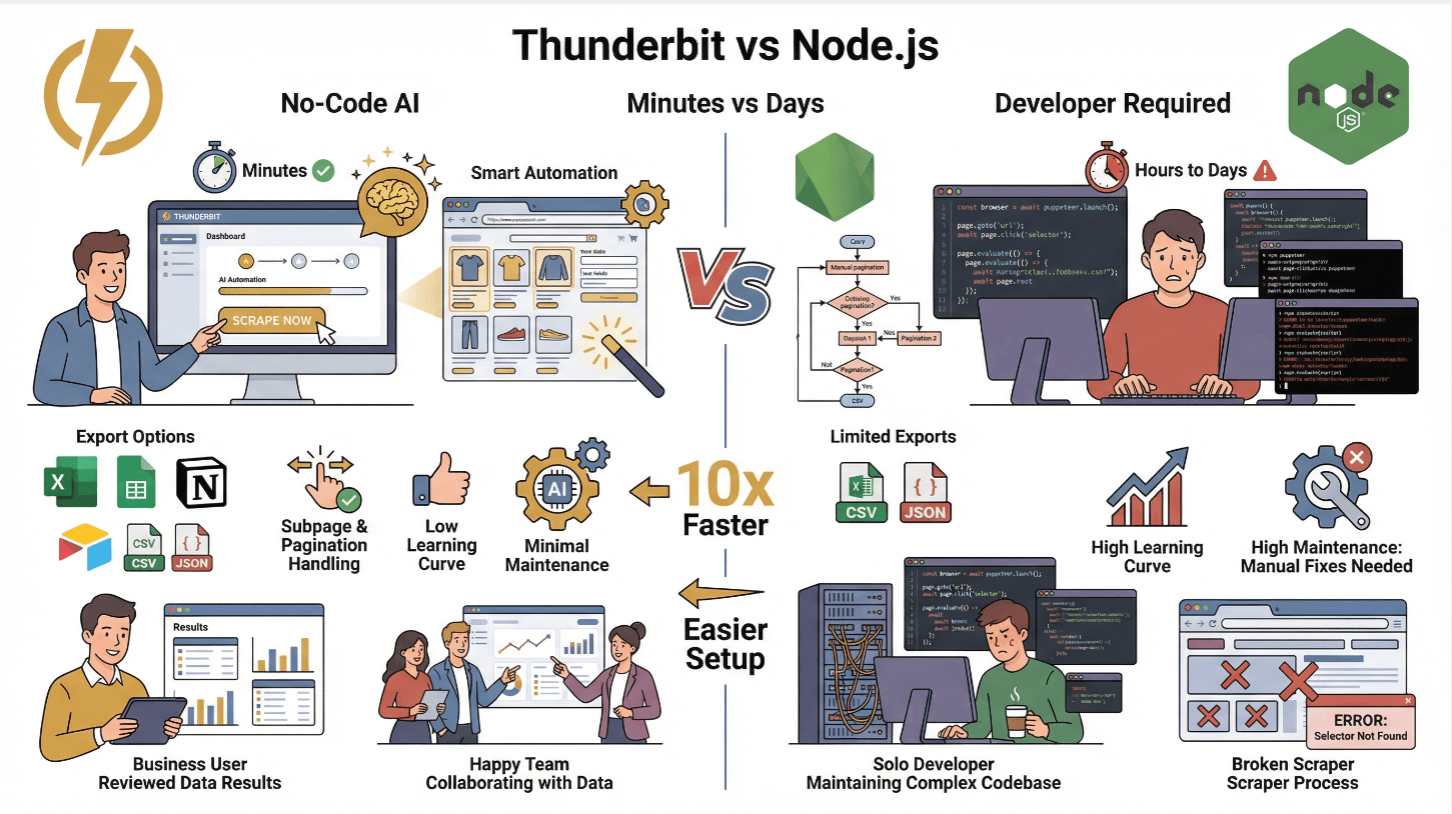
Thunderbit vs. traditionelles Node.js-Scraping
| Funktion | Thunderbit | Traditioneller Node.js-Scraper |
|---|---|---|
| Einrichtungszeit | Minuten (ohne Code) | Stunden bis Tage (Entwicklung, Tests) |
| Dynamische Inhalte | Ja (KI + Browser) | Ja (mit Puppeteer/Playwright) |
| Unterseiten & Paginierung | Mit 1 Klick | Manuelle Programmierung nötig |
| Datenexport | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (Custom Code) |
| Lernkurve | Niedrig (Business-User) | Hoch (Entwickler) |
| Wartung | Minimal (KI passt sich an) | Hoch (manuelle Fixes bei Website-Änderungen) |
Thunderbit ist ideal für nicht-technische Teams oder für alle, die sich die Fleißarbeit sparen und sich auf Erkenntnisse konzentrieren möchten. Fortgeschrittene Nutzer können Thunderbits API weiterhin nutzen, um Scraping im großen Maßstab zu automatisieren (Thunderbit Docs).
Cheerio und Puppeteer für dynamische Inhalte kombinieren
Das ist mein liebstes Power-Duo fürs Scraping mit Node.js. So funktioniert es:
- Puppeteer verwenden, um die Seite zu laden und JavaScript auszuführen (auf
networkidlewarten, damit wirklich alles geladen ist). - Das HTML abrufen mit
await page.content(). - Mit Cheerio parsen: Das HTML an Cheerio übergeben, um extrem schnell und im jQuery-Stil zu parsen und Daten zu extrahieren.
Dieser hybride Ansatz verbindet das Beste aus beiden Welten: Puppeteers Stärke bei dynamischen Inhalten und Cheerios Geschwindigkeit beim Parsen (Browserless).
Performance-Tipp: Wähle nur die Elemente aus, die du wirklich brauchst. Cheerio lädt das gesamte DOM in den Speicher, also vermeide zu breite Selektoren und cache Ergebnisse, wenn du dieselben Seiten wiederholt scrapen musst (Oxylabs).
HTML-Parsing und Datenextraktion optimieren
- Spezifische Selektoren verwenden: Vermeide
$('body *')– greife nur auf das zu, was du wirklich brauchst. - Große Seiten streamen: Bei massivem HTML solltest du Streaming oder eine Aufteilung des Jobs in Betracht ziehen.
- Gerendertes HTML cachen: Wenn du URLs erneut aufrufst, speichere das HTML zwischen, um doppelte Requests zu vermeiden.
- Daten validieren und bereinigen: Nutze Validator-Bibliotheken, damit deine Datenbank nicht mit Müll gefüllt wird (ScrapeGraphAI).
Skalierbares Deployment von Node.js-Web-Scrapern in der Cloud
Scraping im großen Stil? Dann ist jetzt Cloud-Native angesagt.
- Scraper in Docker packen: Erstelle eine
Dockerfile, kopiere deinen Code hinein, installiere Abhängigkeiten und definiere den Entry Point. - In die Cloud deployen: Nutze AWS EC2, Google Cloud Compute oder Azure-VMs für einfache Aufgaben. Für ernsthafte Skalierung eignen sich Kubernetes oder verwaltete Dienste wie AWS ECS/EKS, Google Cloud Run oder Azure Kubernetes Service (DigitalOcean).
- Mit Kubernetes orchestrieren: Mehrere Pods ausführen, automatisch je nach Bedarf skalieren und URLs über Load Balancer verteilen.
- Jobs planen: Cloud Scheduler wie CloudWatch Events oder Cloud Scheduler nutzen oder Cron-Jobs einrichten, um Scrapes regelmäßig zu starten.
In einem echten Beispiel führte die Skalierung von 5 auf 10 Kubernetes-Pods dazu, dass ein Scrape über 400 Seiten von Minuten auf unter eine Minute sank (DigitalOcean).
Scraping-Infrastruktur überwachen und automatisch skalieren
- Logging: Logs in CloudWatch, Stackdriver oder Datadog streamen. Alarme für Fehler oder Verlangsamungen einrichten.
- Health Checks: Prometheus und Grafana für Metriken wie gescrapte Seiten pro Minute, Fehlerraten und Pod-Zustand verwenden.
- Auto-Scaling: Kubernetes HPA (Horizontal Pod Autoscaler) einrichten, damit Pods je nach CPU oder Request-Anzahl skaliert werden.
Implementiere immer Retries mit exponentiellem Backoff, um Netzwerkprobleme oder temporäre Sperren abzufangen.
Best Practices für Datenspeicherung und Nachverarbeitung
Sobald die Daten extrahiert sind, müssen sie gespeichert und bereinigt werden:
- Kleine Jobs: Als CSV oder JSON exportieren oder in Google Sheets, Airtable oder Notion übertragen (Thunderbit macht das direkt out of the box).
- Große Jobs: Für strukturierte Daten SQL (MySQL/PostgreSQL) verwenden, oder NoSQL (MongoDB, DynamoDB) für halbstrukturierte oder sich ändernde Schemas (ScrapeHero).
- Cloud-Speicher: S3 oder Google Cloud Storage für Rohdateien und Backups.
- Datenbereinigung: Felder immer validieren, Formate normalisieren (Datum, Zahlen) und Dubletten entfernen. Nutze Schema-Validatoren, um die Datenqualität sicherzustellen (ScrapeGraphAI).
Bewahre sowohl die Rohdaten als auch die bereinigten Daten auf – man weiß nie, wann man sie erneut verarbeiten oder debuggen muss.
Fazit: Die wichtigsten Erkenntnisse für effizientes Web Scraping mit Node.js
Spar dir den Scraper-Code Sieh dir an, wie Thunderbits agentischer Web Scraper im Vergleich zum Schreiben und Warten eigener Scraping-Skripte abschneidet. Get Started Free
Zum Schluss die wichtigsten Punkte:
- Nutze die asynchrone Stärke von Node.js für massives, paralleles Scraping – besonders auf Seiten mit viel JavaScript.
- Kombiniere die richtigen Tools: axios/got für Requests, Cheerio für statisches HTML, Puppeteer für dynamische Inhalte und je nach Bedarf eine Mischung aus allem für Geschwindigkeit und Flexibilität.
- Vermeide Anti-Bot-Fallen: Proxys und Header rotieren, menschliches Verhalten simulieren und robots.txt respektieren.
- Mit Thunderbit vereinfachen: Für Business-User oder schnelles Prototyping ermöglicht Thunderbit das Extrahieren komplexer Daten mit KI und die Anbindung an deinen Node.js-Stack per API.
- Im großen Maßstab deployen: In Docker packen, mit Kubernetes orchestrieren und alles überwachen, damit es zuverlässig läuft.
- Daten speichern und bereinigen: Wähle die passende Speicherlösung für deinen Bedarf und validiere Daten immer vor der Nutzung.
Das Web wird nicht einfacher, aber mit diesen Best Practices bleiben deine Node.js-Scraper schnell, zuverlässig und der Anti-Bot-Aufrüstung immer einen Schritt voraus. Und wenn du irgendwann genug davon hast, um 2 Uhr morgens Selektoren zu debuggen, denk daran: Die KI von Thunderbit ist immer wach.
Du willst noch mehr lernen? Im Thunderbit Blog findest du weitere Deep Dives, oder teste die Thunderbit Chrome-Erweiterung, um zu sehen, wie einfach Scraping sein kann.
Mit Thunderbit Agentic Web Scraper scrapen Die Web Scraper API von Thunderbit ermöglicht es dir, Extraktionen direkt aus deinem eigenen Node.js-Code auszulösen – mit kostenlosem Einstiegstarif. Get Started Free
FAQs
1. Warum eignet sich Node.js 2025 besonders gut für Web Scraping?
Das asynchrone, ereignisgesteuerte Modell von Node.js kann Tausende gleichzeitige Requests verarbeiten und ist damit ideal für große Datenmengen oder Echtzeit-Updates. Das riesige npm-Ökosystem und der native JavaScript-Support passen perfekt zu modernen, JS-lastigen Websites (Node.js Docs).
2. Wie kann ich beim Scraping mit Node.js Blockierungen vermeiden?
Nutze rotierende Proxys, variiere Request-Header, drossele Anfragen mit zufälligen Pausen und simuliere menschliches Verhalten wie Mausbewegungen, Scrollen und Tippen mit Tools wie Puppeteer. Halte dich immer an robots.txt und die Nutzungsbedingungen der Website (Medium).
3. Wann sollte ich in meinem Node.js-Scraper Cheerio statt Puppeteer verwenden?
Nutze Cheerio für schnelles Parsen von statischem HTML, wenn die Daten bereits im Roh-HTML enthalten sind. Puppeteer eignet sich für Seiten, die Inhalte dynamisch mit JavaScript laden. Für beste Ergebnisse rendert Puppeteer die Seite, anschließend parst Cheerio das HTML (Bright Data).
4. Wie vereinfacht Thunderbit das Web Scraping mit Node.js?
Thunderbit extrahiert strukturierte Daten von jeder Website mithilfe von KI und natürlicher Sprache – ganz ohne Programmierung. Es verarbeitet dynamische Inhalte, Unterseiten und Paginierung und bietet eine API für die Integration in Node.js. Daten lassen sich direkt nach Excel, Google Sheets, Airtable oder Notion exportieren (Thunderbit Blog).
5. Wie skaliere und überwache ich Node.js-Scraper in der Cloud am besten?
Packe den Scraper in Docker, deploye ihn auf Kubernetes oder in verwalteten Cloud-Diensten und nutze Auto-Scaling, um Lastspitzen abzufangen. Überwache Logs und Metriken mit Tools wie CloudWatch oder Prometheus und richte Alarme für Fehler oder Verlangsamungen ein (DigitalOcean).
Bereit, dein Web Scraping aufs nächste Level zu bringen? Probiere Thunderbit aus – und möge dein Scraper schnell, unauffällig und der Anti-Bot-Logik immer einen Schritt voraus sein.
Agentischen Web Scraper testen Get Started Free
Mehr erfahren
- Wie man Node-Web-Scraping als Anfänger meistert: Eine Schritt-für-Schritt-Anleitung
- Wie man Website-Daten mit den besten Tools effizient scrapt
- Wie man eine Website effizient crawlt: Schritt-für-Schritt-Anleitung
- Wie man JavaScript-Crawling meistert: Ein Leitfaden für Anfänger
- Wie man Web Scraping für Preisvergleiche 2026 meistert




