
Das Web quillt über vor Daten – und 2026 sind Web-Scraping-Projekte zur stillen Grundlage für ziemlich alles geworden: Business Analytics, Trenderkennung, Forschungsdurchbrüche. Python-Web-Scraping hat sich vom Wochenend-Skript für Bastler zu einem festen Baustein in vielen Data Teams entwickelt. Die „mission-critical engine of innovation" lebt zwar eher in Pitch Decks als in echten Postmortems, aber viele Teams verlassen sich inzwischen darauf, und die Werkzeuge sind nachgezogen.
Egal, ob du Data Scientist, Entwickler:in oder schlicht neugierig bist: Die passende Projektidee – und das passende Werkzeug – kann Erkenntnisse ans Licht holen, die sonst im digitalen Datenwust verborgen bleiben. Mit KI-gestützten Lösungen wie Thunderbit sind selbst die kniffligsten Scraping-Aufgaben heute machbar, ganz ohne Doktortitel in Regex.
Thunderbit AI Web Scraper ausprobieren
Du willst deine Skills aufs nächste Level heben und etwas bauen, das wirklich etwas bewegt? Ich habe 32 kreative, fortgeschrittene und praxisnahe Python-Web-Scraping-Projektideen zusammengetragen – jeweils mit dem passenden Werkzeug (von BeautifulSoup über Scrapy bis Thunderbit), dazu Hinweise zu Komplexität, Automatisierung und konkretem Praxisnutzen.
Warum Python-Web-Scraping-Projekte für datengetriebene Innovation unverzichtbar sind
Was ist Data Scraping und wie funktioniert es 2026? Get Started Free
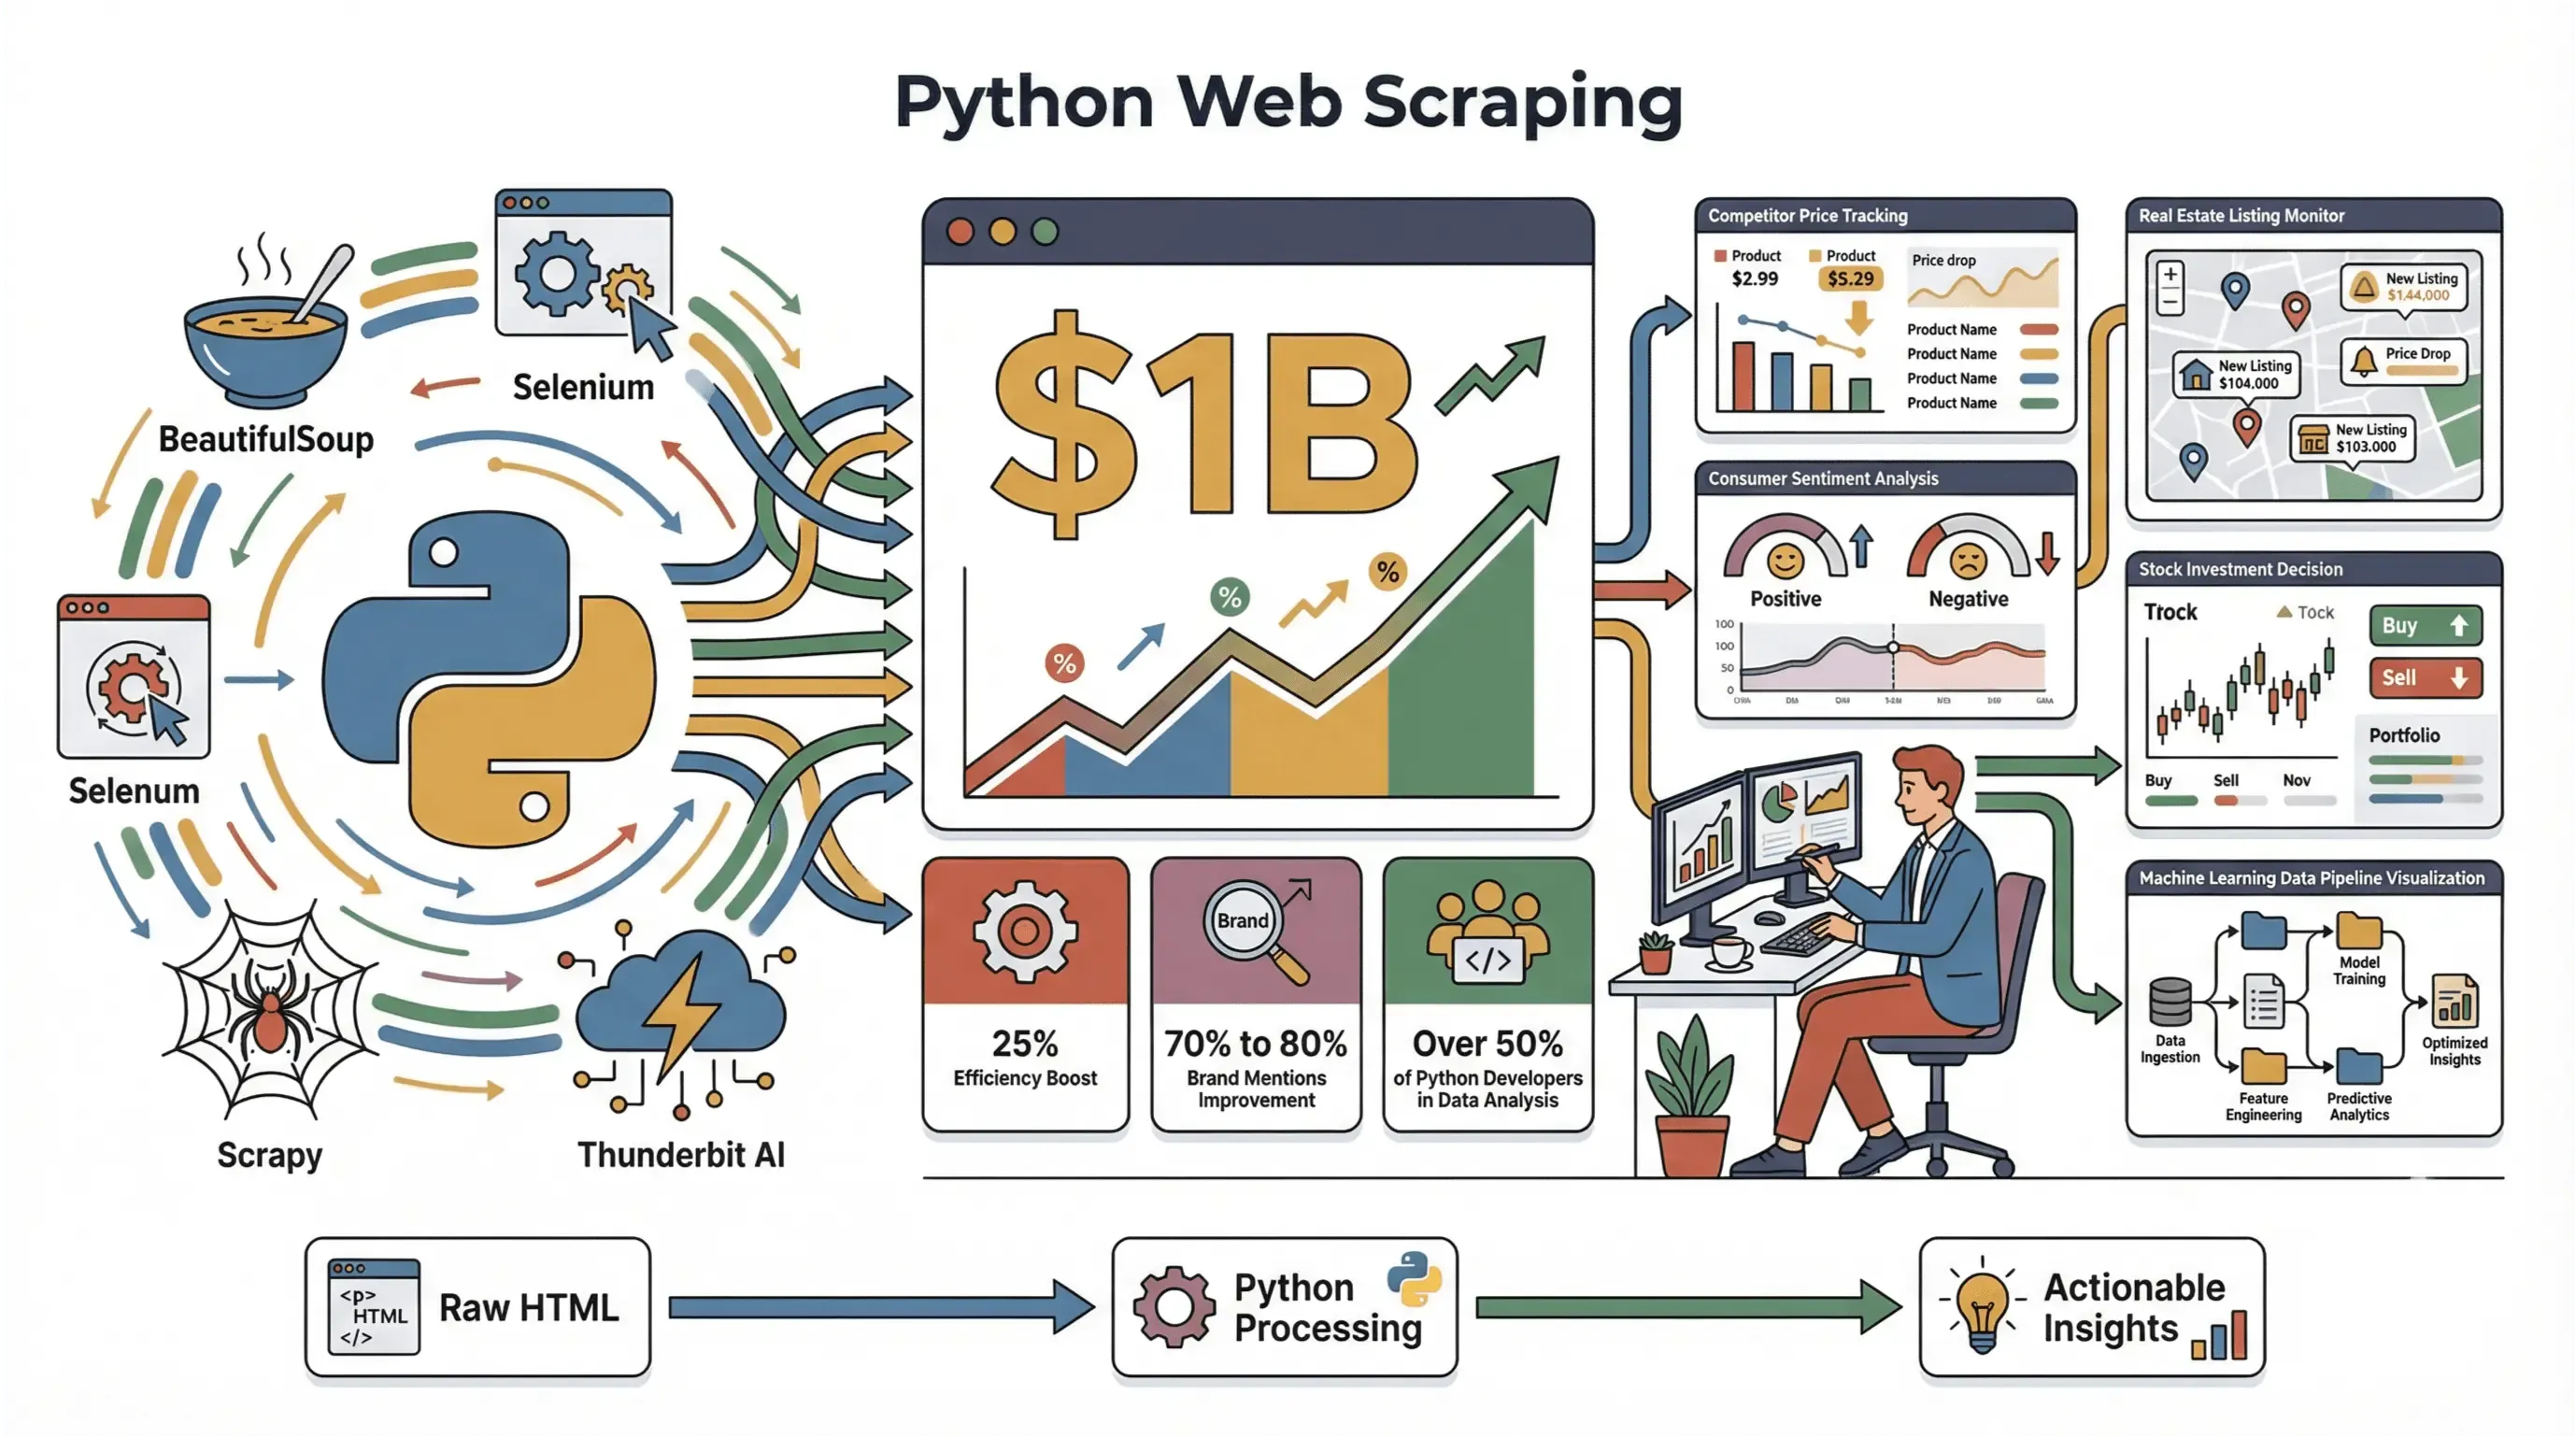
Web Scraping ist 2026 zu einer Branche im Wert von rund 1 Milliarde US-Dollar herangewachsen, Tendenz weiter steigend (PromptCloud). Unternehmen ziehen über Scraping-Pipelines Konkurrenzpreise, beobachten die kippende Verbraucherstimmung und automatisieren sogar Investmententscheidungen. Quant-Fonds und Research-Teams im Handel behandeln gescrapte Alt-Daten – Earnings-Call-Transkripte, Job-Feeds oder E-Commerce-Preise – längst als ganz normalen Input für ihre Modelle. Eine saubere, branchenweite Zahl dazu, wie stark das die Entscheidungsqualität verbessert hat, gibt es nicht (die kursierenden Werte sind dünn belegt), aber das Nachfragesignal ist eindeutig: In verwaltete Scraping-Services und Proxy-Netzwerke fließt viel Geld.
Python ist dafür die erste Wahl – und der Grund liegt auf der Hand. In der JetBrains-Umfrage State of Python 2025 gaben 51 % der Befragten an, an Datenexploration und -verarbeitung zu arbeiten – erstmals stellt dieser Bereich damit eine klare Mehrheit (JetBrains). Und das Python-Ökosystem mit BeautifulSoup, Selenium, Playwright, Scrapy und inzwischen KI-gestützten Werkzeugen wie Thunderbit verkürzt den Weg von rohem HTML zum nutzbaren Datensatz Jahr für Jahr ein Stück mehr.
Ob du Produktbewertungen für die Sentimentanalyse herausziehst, Immobilienangebote verfolgst oder einen maßgeschneiderten Datensatz für Machine Learning aufbaust: Python-Web-Scraping-Projekte bilden das Rückgrat moderner datengetriebener Innovation.
Wie du die richtige Web-Scraping-Projektidee auswählst
Bei dieser Fülle an Möglichkeiten: Wie findest du ein Projekt, das deine Zeit wert ist? Mein Raster dafür:
- Beim Ziel ansetzen: Welche Entscheidung oder welchen Prozess sollen die Daten stützen? Geht es um Competitive Intelligence, scrappst du Preise oder Produktlinien der Konkurrenz. Geht es um Kundeneinblicke, schaust du auf Bewertungen oder Social Media.
- Datenverfügbarkeit prüfen: Liegen die Daten öffentlich, hinter einem Login oder über eine API vor? Öffentliche, statische Seiten sind leichter; dynamische oder geschützte Seiten verlangen anspruchsvollere Werkzeuge.
- Werkzeug zur Aufgabe passend wählen: Für statische Seiten ist BeautifulSoup stark. Für dynamische Inhalte brauchst du womöglich Selenium oder Playwright. Bei komplexen oder gemischten Daten (etwa PDFs oder Bildern) sparen dir KI-gestützte Werkzeuge wie Thunderbit Stunden.
- Skalierbarkeit und Automatisierung mitdenken: Läuft das Projekt einmalig oder nach Zeitplan? Geplantes Scraping und ein einfacher Export (nach Google Sheets, Excel und so weiter) sind für laufende Projekte Pflicht.
Die besten Projekte balancieren Geschäftsnutzen und technische Machbarkeit. Und falls du kein Coding-Ass bist: kein Problem. KI-Tools wie Thunderbit öffnen fortgeschrittenes Scraping für alle.
Python-Web-Scraping-Tools im Vergleich: von BeautifulSoup bis Thunderbit
Diese Werkzeuge gehören in deinen Werkzeugkasten:
| Tool | Am besten geeignet für | Unterstützt JavaScript? | Skalierbarkeit | Benutzerfreundlichkeit | Wartung |
|---|---|---|---|---|---|
| BeautifulSoup | Statische Seiten, schnelle Aufgaben | Nein | Niedrig | Hoch | Manuell |
| Selenium | Dynamische, JS-lastige Seiten (Legacy) | Ja | Mittel | Mittel | Moderat |
| Playwright | Modernes dynamisches / SPA-Scraping | Ja (Auto-Wait) | Mittel-Hoch | Mittel | Niedrig-Moderate |
| Scrapy | Großangelegtes, strukturiertes Crawling | Nein (aber erweiterbar) | Hoch | Mittel | Moderat |
| Thunderbit | KI-gestützte, komplexe/ gemischte Daten | Ja | Hoch | Sehr hoch | Niedrig |
- BeautifulSoup ist ideal für kleine, statische Websites – denk an Blogs oder schlichte Verzeichnisse.
- Selenium spielt seine Stärke aus, sobald du mit dynamischen Inhalten, Logins oder Infinite Scroll interagieren musst – Community und Treiber-Support sind die breitesten unter allen Browser-Automation-Bibliotheken. Übernimmst du eine bestehende Codebasis, bleib also dabei.
- Playwright (über
playwright-python) wäre 2026 meine erste Wahl für ein neues Projekt. Der entscheidende praktische Unterschied ist das Auto-Waiting: Die API wartet, bis Elemente wirklich klickbar sind, statt dass du überalltime.sleep(3)streust und hoffst. Allein das räumt die häufigste Ursache für instabile Scraper aus dem Weg. Der Haken: kleinere Community als bei Selenium, und einige Enterprise- oder Legacy-Browser-Versionen deckt Playwright noch nicht ab. - Scrapy ist für industrielles Crawling und strukturierte Exporte gebaut, hat aber eine steilere Lernkurve. Es wird weiter aktiv gepflegt – Version 2.15 erschien im Januar 2026 und hat die Unterstützung für Python 3.9 gestrichen. Prüfe vor dem Upgrade also deine Runtime.
- Thunderbit bringt KI ins Spiel und übernimmt alles: vom Navigieren durch Unterseiten bis zum Extrahieren aus PDFs und Bildern – und schlägt sogar die besten Felder zum Scrapen vor. Für Projekte, bei denen Tempo, Robustheit und einfache Bedienung zählen, ist es meine erste Wahl.
Wenn du tiefer in die Tool-Auswahl einsteigen willst, hilft Thunderbits Leitfaden zu Web-Scraping-Tools weiter.
Komplexität der Projekte und Tool-Empfehlungen auf einen Blick
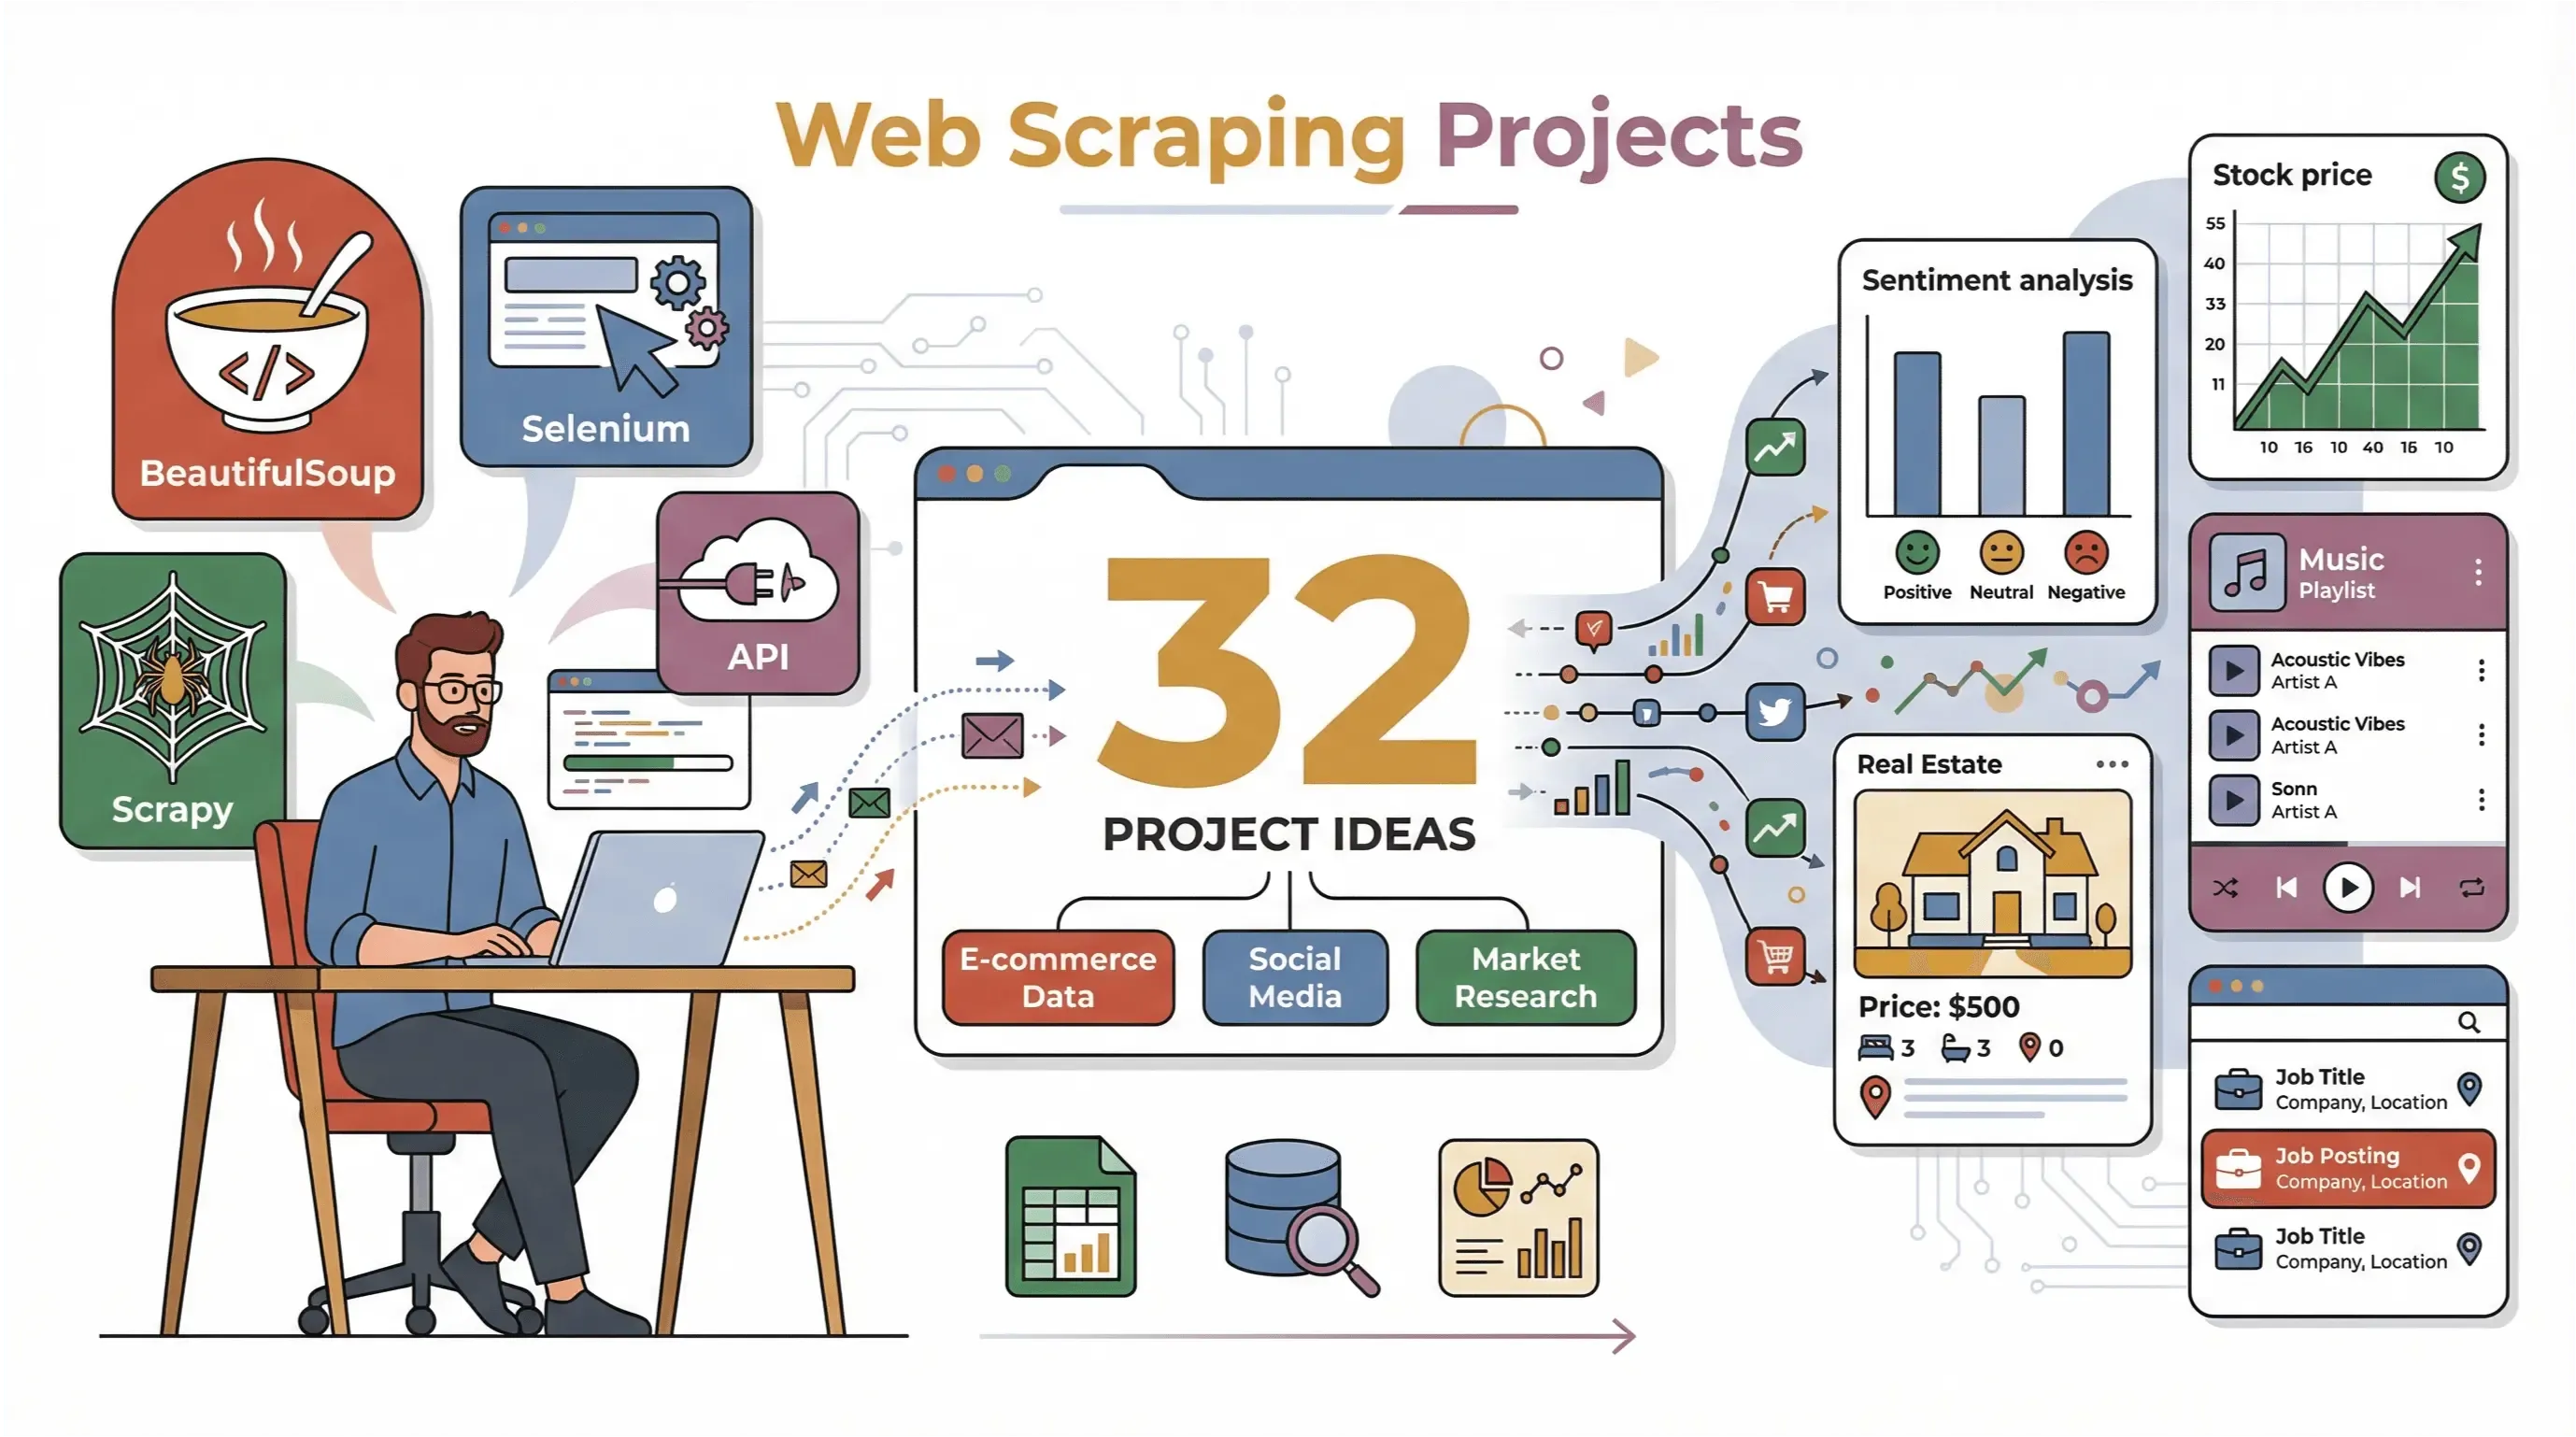 Hier eine schnelle Referenz, mit der du jede Projektidee dem passenden Werkzeug zuordnest und ihre Komplexität einschätzt:
| Projektidee | Empfohlenes Tool / empfohlene Tools | Komplexität | Wichtigstes Ergebnis |
|---|---|---|---|
| Amazon-Bewertungs-Sentimentanalyse | BeautifulSoup + NLP | Mittel | Bewertungen + Sentiment-Scores |
| Live-Scores im Esport | Selenium | Hoch | Echtzeit-Statistiken |
| Trendende Quora-Q&As | Selenium | Mittel-Hoch | Q&A-Datensatz |
| Spotify-Playlist-Daten | Spotify API | Niedrig | Playlist-Tracks, Metriken |
| Bewertungen von Reiseattraktionen | BeautifulSoup | Mittel | Bewertungen, Rezensionen, Standort-Mapping |
| Kinokassen-Trends | API oder BeautifulSoup | Niedrig-Mittel | Kinokassen-Zeitreihen |
| Twitter-Trends & Inhalte | Selenium/API | Mittel | Trendthemen, Sentiment |
| Zhihu Q&A | Selenium | Hoch | Chinesischer Q&A-Datensatz |
| Immobilien-Monitoring (Thunderbit) | Thunderbit | Niedrig-Mittel | Angebotsdaten, Preisentwicklungen |
| Bestseller-Analyse für E-Books | Selenium/API | Mittel | Rankings, Bewertungen |
| Preis-Tracking im E-Commerce | Scrapy + Proxys | Hoch | Preisverlauf, Alerts |
| Reddit-Subreddit-Analyse | Reddit API | Mittel | Themen-Hotspots, Engagement |
| Tracking von Börsendaten | yfinance/API | Niedrig | Historische Kurse, Indikatoren |
| Jobanzeigen (Scrapy) | Scrapy | Mittel | Stellenanzeigen, Gehaltsinfos |
| Google-Play-Bewertungen | API/Selenium | Mittel | Rezensionen, Bewertungen, NLP-Zusammenfassung |
| Aggregation von Konkurrenz-Blogposts | RSS + BeautifulSoup | Mittel | Content-Repository, Themencluster |
| Feedback zu Online-Kursen | Selenium/API | Mittel | Kursbewertungen, Feedback |
| Bereinigung von Unternehmensverzeichnissen | Scrapy + Python | Mittel | Saubere, deduplizierte Unternehmensliste |
| Podcast-Veröffentlichungen & Trends | API + NLP | Mittel | Trend-Podcasts, Episodendaten |
| Thunderbit-Dateiextraktion | Thunderbit | Niedrig | Strukturierte Daten aus PDFs/Bildern |
| Trends bei wissenschaftlichen Zitaten | API + Parsing | Mittel | Zitierzahlen, Trendlinien |
| Webspiel-Daten per OCR | Selenium + OCR | Hoch | Spielstatistiken aus Bildern |
| Analyse von Händlerbewertungen | Scrapy + NLP | Mittel-Hoch | Verbraucherbewertungsdatenbank, Zusammenfassung |
| Live-Nachrichten mit Selenium | Selenium + Zeitplanung | Mittel | Echtzeit-Schlagzeilen |
| Tracking von Modetrends | Scrapy + Bildanalyse | Mittel | Beliebte Styles, Trenddaten |
| Export von Konkurrenzprodukten (Thunderbit) | Thunderbit | Niedrig | Produktliste, wichtige Attribute |
| Analyse von Tumblr-Multimedia | API/Selenium | Mittel | Beiträge, Tags, Medienlinks |
| Bewertungen von Logistikunternehmen | BeautifulSoup + NLP | Mittel | Sentiment zu Servicebewertungen |
| Reichweitenstatistiken für Sportmarken | Social API + Scraping | Hoch | Regionale Reichweitenmetriken |
| YouTube-Produktkommentare | YouTube API + NLP | Mittel | Kommentar-Sentiment, Funktionsnennungen |
| Häufigkeit von E-Commerce-Aktionen | Scrapy | Mittel | Aktionskalender, Häufigkeitsanalyse |
| Mehrsprachige Serien-Daten | Scrapy + Übersetzungs-API | Hoch | Mehrsprachige Beschreibungen |
Jetzt geht's ans Eingemachte – 32 Projektideen, jeweils mit Kurzanleitung, Tool-Tipps und Insights auf Profi-Niveau.
1. Sentimentanalyse von Amazon-Produktbewertungen (BeautifulSoup)
Scrappe Amazon-Produktbewertungen und führe eine Sentimentanalyse durch, um herauszufinden, was Kund:innen wirklich denken. Zieh mit BeautifulSoup Rezensionstext, Sternebewertungen und Metadaten der Rezensent:innen heraus. Berücksichtige die Pagination, um einen belastbaren Datensatz zu sammeln, und wende anschließend Python-NLP-Bibliotheken wie VADER oder TextBlob an, um Sentiment zu bewerten und wiederkehrende Themen sichtbar zu machen. Für gute Ergebnisse solltest du deine Requests drosseln, um CAPTCHAs zu umgehen (Oxylabs).
2. Live-Scores und Statistiken im Esport (Selenium)
Du willst Live-Esport-Scores verfolgen? Nutze Selenium, um dynamische, per JavaScript gerenderte Scoreboards von Seiten wie ESL oder Liquipedia auszulesen. Mit Selenium automatisierst du Browser-Aktionen, handhabst Logins und ziehst Echtzeit-Statistiken zu Spielen wie League of Legends oder CS:GO. Profi-Tipp: Prüfe die Netzwerkaufrufe im Browser auf versteckte API-Endpunkte, um die Extraktion zu beschleunigen (YouTube).
3. Trendende Quora-Q&A-Daten scrapen
Sammle trendende Fragen und Antworten von Quora mit Selenium, um Infinite Scroll und Login-Anforderungen zu meistern. Zieh Fragetext, Antwortinhalt, Upvotes und Infos zu den Autor:innen heraus. Für tiefere Analysen klickst du „Mehr lesen"-Buttons an, um vollständige Antworten zu bekommen, und filterst Anzeigen oder gesponserte Inhalte heraus (ScraperAPI).
4. Spotify-Playlist-Daten mit Python sammeln
Nutze die Spotify Web API (mit der Bibliothek spotipy), um Playlist-Tracks, Metadaten und Audio-Features abzurufen. Analysiere Playlist-Trends, Track-Popularität und sogar Song-Merkmale wie Tempo oder Energie. Ideen für Visualisierungen: Genre-Aufschlüsselungen, Künstlernetzwerke oder die Umschlagrate von Tracks (Spotipy Docs).
5. Web Scraping für Bewertungen von Touristenattraktionen
Scrappe Bewertungen und Rezensionen von Touristenattraktionen auf Plattformen wie TripAdvisor mit BeautifulSoup. Zieh Namen der Attraktionen, Standorte, Durchschnittsbewertungen und Anzahl der Rezensionen heraus. Bereinige und geokodiere die Daten für Kartendarstellungen und analysiere danach Trends nach Stadt oder Saison (DataHen).
6. Kinokassen-Daten und Trendvisualisierung
Hol dir historische Kinokassendaten von Quellen wie Box Office Mojo über deren API oder mit BeautifulSoup. Visualisiere Trends mit Python-Bibliotheken wie Matplotlib oder Plotly – etwa Umsatz im Zeitverlauf, Genre-Aufschlüsselungen oder saisonale Ausschläge (Kaggle).
7. Twitter-Trendthemen und Nutzerinhalte analysieren
Beobachte Twitter-Trends über die API (falls du Zugriff hast) oder mit Tools wie snscrape und Selenium. Scrappe trendende Hashtags, sammle Tweets und analysiere Sentiment oder die Ko-Okkurrenz von Hashtags. Bei stark JS-lastigen Inhalten führt an Browser-Automatisierung kein Weg vorbei (Thunderbit Blog).
8. Interaktive Q&As von Zhihu scrapen
Scrappe die trendenden Fragen und Antworten von Zhihu mit Selenium (und Login-Cookies, falls nötig). Zieh Fragetext, Antwortinhalt, Upvotes und Nutzerengagement heraus. Für die Analyse chinesischer Texte greifst du zu Bibliotheken wie Jieba oder SnowNLP.
9. Echtzeit-Monitoring des Immobilienmarkts (Thunderbit)
Mit Thunderbit überwachst du Immobilienangebote und Preise mit wenigen Klicks. Nutze „AI Suggest Fields", um Immobiliendaten automatisch zu erkennen, setze Subpage Scraping für Detaildaten ein und richte geplante Scrapes für tägliche Updates ein. Exportiere alles nach Google Sheets oder Airtable – komplett ohne Code (Thunderbit Real Estate Guide).
Immobilienangebote mit Thunderbit scrapen
10. Analyse von Bestseller-Rankings auf E-Book-Plattformen
Scrappe Bestseller-Listen und Rezensionen von Amazon Kindle oder Goodreads mit Selenium oder per API. Verfolge Ranking-Veränderungen im Zeitverlauf, analysiere Genre-Trends und setze Rezensionen mit dem Verkaufsrang in Beziehung (Oxylabs).
11. E-Commerce-Preisschwankungen analysieren
Nutze Scrapy (mit Proxys), um Produktpreise auf E-Commerce-Seiten zu verfolgen. Sammle Daten nach Zeitplan, baue eine historische Preisdatenbank auf und richte Alerts für deutliche Preisrückgänge ein. Analysiere dynamische Preismuster und Strategien der Konkurrenz (Opensend).
12. Heat-Analyse von Diskussionsthemen in Reddit-Subreddits
Zieh Beiträge und Kommentare aus Subreddits über die Reddit API (PRAW). Analysiere Beitragsfrequenz, Upvotes und Kommentarvolumen, um heiße Themen und Engagement-Trends zu erkennen. Visualisiere die Ergebnisse mit Heatmaps oder Balkendiagrammen.
13. Historische Aktien- und Finanzindikatoren verfolgen
Hol dir Aktienkurse und Finanzindikatoren mit yfinance oder anderen Finanz-APIs. Baue Zeitreihendatensätze auf, zeichne Trends und setze sie mit Wirtschaftsindikatoren in Beziehung (AbstractAPI).
14. Jobanzeigen mit Scrapy scrapen
Nutze Scrapy, um Jobbörsen zu crawlen und Stellenbezeichnungen, Unternehmen, Standorte und Gehälter herauszuziehen. Behandle die Pagination und exportiere strukturierte Daten für Analysen – etwa Gehaltsverteilungen, Nachfrage nach Skills oder Hiring-Trends (Scrapy Docs).
15. Google-Play-App-Bewertungen und -Ratings skripten
Scrappe App-Bewertungen aus Google Play über die API oder mit Selenium. Zieh Rezensionstext, Bewertungen und Metadaten heraus und fasse das Nutzerfeedback samt Sentiment per NLP zusammen (SerpApi).
16. Tech-Blog-Inhalte der Konkurrenz aggregieren
Bündle Blogposts der Konkurrenz über RSS-Feeds und BeautifulSoup. Ordne die Inhalte, dedupliziere sie und nutze Topic Clustering, um Trends und Content-Lücken aufzuspüren.
17. Kursfeedback und Bewertungen von Online-Lernplattformen scrapen
Zieh Kursbewertungen und Feedback von Plattformen wie Coursera oder Udemy mit Selenium oder per API. Visualisiere Kursbeliebtheit, Zufriedenheit und wiederkehrende Feedback-Themen.
18. Unternehmensverzeichnisse und Gelbe-Seiten-Daten organisieren
Scrappe Unternehmenslisten aus Verzeichnissen wie den Gelben Seiten mit Scrapy. Normalisiere Adressen, dedupliziere Einträge und baue eine saubere Unternehmensdatenbank auf (Oxylabs).
19. Neueste Veröffentlichungen und beliebte Inhalte von Podcast-Plattformen sammeln
Nutze die iTunes- oder Spotify-API, um Podcast-Metadaten, Episodenveröffentlichungen und Popularitätsmetriken abzurufen. Analysiere aufkommende Themen und Veröffentlichungstrends.
20. Dateien zu Thunderbit hochladen für individuelle Datenextraktion
Lade PDFs oder Bilder in Thunderbit hoch und lass die KI-gestützte OCR strukturierte Daten extrahieren – ohne manuelle Eingabe oder Regex. Perfekt fürs Digitalisieren von Visitenkarten, Rechnungen oder Teilnehmerlisten (Thunderbit Docs).
21. Analyse von Zitattrends in der Wissenschaft
Scrappe Zitationsdaten aus wissenschaftlichen Datenbanken über APIs (etwa CrossRef). Analysiere Zitationszahlen im Zeitverlauf, um aufkommende Forschungstrends zu erkennen.
22. Web-Spiel-Daten per OCR extrahieren
Kombiniere Selenium und OCR-Bibliotheken (etwa pytesseract), um Statistiken aus bildbasierten Webspielen herauszuholen. Nützlich für Spiele, die Scores oder Daten als Bilder anzeigen.
23. Verbraucherbewertungen von Online-Händlern extrahieren und analysieren
Scrappe Verbraucherbewertungen von Online-Händlern mit Scrapy. Wende NLP für Sentiment-Scores an, fasse die wichtigsten Vor- und Nachteile der Produkte zusammen und vergleiche konkurrierende Produkte.
24. Live-Nachrichten-Schlagzeilen und Zusammenfassungen scrapen (Selenium)
Nutze Selenium, um Live-Schlagzeilen und Zusammenfassungen von dynamischen Nachrichtenseiten zu scrapen. Plane regelmäßige Scrapes für Echtzeit-Updates.
25. Trends und Styles auf Mode-Websites verfolgen
Scrappe Mode-Seiten mit Scrapy, um trendende Produkte und Styles zu erkennen. Optional setzt du Bildanalyse ein, um beliebte Farben oder Muster zu identifizieren.
26. Konkurrenz-Produktlisten mit Thunderbit exportieren
Mit Thunderbit exportierst du Produktlisten und Attribute der Konkurrenz in Minuten. Nutze KI-Feldvorschläge und Subpage Scraping für tiefe Daten und exportiere danach direkt in dein bevorzugtes Tabellen-Tool.
27. Multimedia-Inhalte von Tumblr analysieren
Scrappe Multimedia-Beiträge von Tumblr über die API oder Selenium. Analysiere Bilder, Videos und Tags auf Content-Trends.
28. Bewertungsdaten von Logistikunternehmen extrahieren
Scrappe Bewertungen und Ratings für Logistikunternehmen von Plattformen wie Trustpilot mit BeautifulSoup. Übersetze das Feedback per Textanalyse in operative Verbesserungen.
29. Regionale Reichweitenstatistiken für Sportmarken
Sammle und analysiere Sichtbarkeitsdaten für Sportmarken mithilfe von Social-Media-APIs und Web Scraping. Verfolge Erwähnungen, Einzelhandelspräsenz und regionale Trends.
30. Nutzererfahrungen aus YouTube-Produktkommentaren analysieren
Scrappe YouTube-Kommentare über die API und ziehe dann per NLP Sentiment und Funktionsnennungen rund um Produkterfahrungen heraus.
31. Häufigkeit und Verhältnis von E-Commerce-Aktionsevents verfolgen
Verfolge Promotion-Events auf E-Commerce-Plattformen mit Scrapy. Aggregiere die Eventdaten und visualisiere Trends im Zeitverlauf.
32. Serienbeschreibungen plattform- und sprachübergreifend scrapen
Baue mit Scrapy und Übersetzungs-APIs Skripte, um Serienbeschreibungen von mehreren Streaming-Plattformen in verschiedenen Sprachen zu sammeln und zu vereinheitlichen.
Auf einen Blick: Vergleichstabelle der Projekte
| # | Projektidee | Tool(s) | Komplexität | Wichtigstes Ergebnis |
|---|---|---|---|---|
| 1 | Amazon-Bewertungs-Sentimentanalyse | BeautifulSoup + NLP | Mittel | Bewertungen + Sentiment |
| 2 | Live-Scores im Esport | Selenium | Hoch | Echtzeit-Statistiken |
| 3 | Trendende Quora-Q&As | Selenium | Mittel-Hoch | Q&A-Datensatz |
| 4 | Spotify-Playlist-Daten | Spotify API | Niedrig | Playlist-Tracks, Metriken |
| 5 | Bewertungen von Reiseattraktionen | BeautifulSoup | Mittel | Bewertungen, Rezensionen, Mapping |
| 6 | Kinokassen-Trends | API/BeautifulSoup | Niedrig-Mittel | Kinokassen-Zeitreihe |
| 7 | Twitter-Trends & Inhalte | Selenium/API | Mittel | Trendthemen, Sentiment |
| 8 | Zhihu Q&A | Selenium | Hoch | Chinesischer Q&A-Datensatz |
| 9 | Immobilien-Monitoring (Thunderbit) | Thunderbit | Niedrig-Mittel | Angebotsdaten, Preisentwicklungen |
| 10 | Bestseller-Analyse für E-Books | Selenium/API | Mittel | Rankings, Bewertungen |
| 11 | Preis-Tracking im E-Commerce | Scrapy + Proxys | Hoch | Preisverlauf, Alerts |
| 12 | Reddit-Subreddit-Analyse | Reddit API | Mittel | Themen-Hotspots, Engagement |
| 13 | Tracking von Börsendaten | yfinance/API | Niedrig | Historische Kurse, Indikatoren |
| 14 | Jobanzeigen (Scrapy) | Scrapy | Mittel | Stellenanzeigen, Gehaltsinfos |
| 15 | Google-Play-Bewertungen | API/Selenium | Mittel | Rezensionen, Ratings, NLP-Zusammenfassung |
| 16 | Aggregation von Konkurrenz-Blogs | RSS + BeautifulSoup | Mittel | Content-Repository, Themencluster |
| 17 | Feedback zu Online-Kursen | Selenium/API | Mittel | Kursbewertungen, Feedback |
| 18 | Bereinigung von Unternehmensverzeichnissen | Scrapy + Python | Mittel | Saubere, deduplizierte Unternehmensliste |
| 19 | Podcast-Veröffentlichungen & Trends | API + NLP | Mittel | Trend-Podcasts, Episodendaten |
| 20 | Thunderbit-Dateiextraktion | Thunderbit | Niedrig | Strukturierte Daten aus PDFs/Bildern |
| 21 | Trends bei wissenschaftlichen Zitaten | API + Parsing | Mittel | Zitierzahlen, Trendlinien |
| 22 | Webspiel-Daten per OCR | Selenium + OCR | Hoch | Spielstatistiken aus Bildern |
| 23 | Analyse von Händlerbewertungen | Scrapy + NLP | Mittel-Hoch | Verbraucherbewertungsdatenbank, Zusammenfassung |
| 24 | Live-Nachrichten mit Selenium | Selenium + Zeitplanung | Mittel | Echtzeit-Schlagzeilen |
| 25 | Tracking von Modetrends | Scrapy + Bildanalyse | Mittel | Beliebte Styles, Trenddaten |
| 26 | Konkurrenz-Produktexport (Thunderbit) | Thunderbit | Niedrig | Produktliste, wichtige Attribute |
| 27 | Tumblr-Multimedia-Analyse | API/Selenium | Mittel | Beiträge, Tags, Medienlinks |
| 28 | Logistikunternehmen-Bewertungen | BeautifulSoup + NLP | Mittel | Sentiment zu Servicebewertungen |
| 29 | Reichweite von Sportmarken | Social API + Scraping | Hoch | Regionale Reichweitenmetriken |
| 30 | YouTube-Produktkommentare | YouTube API + NLP | Mittel | Kommentar-Sentiment, Funktionsnennungen |
| 31 | Häufigkeit von E-Commerce-Aktionen | Scrapy | Mittel | Aktionskalender, Häufigkeitsanalyse |
| 32 | Mehrsprachige Serien-Daten | Scrapy + Übersetzung | Hoch | Mehrsprachige Beschreibungen |
Fazit: Neue Möglichkeiten mit Python-Web-Scraping-Projekten erschließen
Web Scraping mit Python ist weit mehr als eine technische Fingerübung – es ist ein Sprungbrett für datengetriebene Durchbrüche. Ob du Dashboards baust, Machine-Learning-Modelle fütterst oder einfach deine Neugier stillst: Diese 32 Projektideen decken ein breites Spektrum an Anwendungen ab. Und mit Werkzeugen wie Thunderbit musst du kein Coding-Profi sein, um selbst die härtesten Scraping-Aufgaben anzupacken.
Such dir ein Projekt aus, richte deine Python-Umgebung ein und leg los. Im Web stecken die Daten, die deine nächste Analyse tragen.
Weitere praxisnahe Anleitungen findest du im Thunderbit Blog.
Thunderbit AI Web Scraper für dein nächstes Projekt ausprobieren Get Started Free
FAQs
1. Welches Python-Tool ist am besten für Web-Scraping-Projekte?
Das kommt auf dein Projekt an. Für statische Seiten ist BeautifulSoup einfach und wirkungsvoll. Für dynamische oder interaktive Seiten ist Selenium eine solide Wahl. Für groß angelegtes oder geplantes Scraping ist Scrapy ideal. Für KI-gestütztes No-Code-Scraping, inklusive PDFs und Bildern, ist Thunderbit eine Top-Wahl.
2. Wie vermeide ich es, beim Scrapen von Websites blockiert zu werden?
Nutze realistische User-Agents, baue Pausen zwischen Requests ein und halte dich an die robots.txt. Bei hochfrequenten oder sensiblen Seiten solltest du rotierende Proxys und Browser-Automatisierung in Betracht ziehen, um menschliches Verhalten nachzuahmen.
3. Kann ich Web Scraping für kommerzielle Projekte nutzen?
Ja, aber prüfe immer die Nutzungsbedingungen und rechtlichen Grenzen der Zielseite. Viele Seiten erlauben Scraping für private oder Forschungszwecke, während die kommerzielle Nutzung unter Umständen eine Genehmigung oder API-Zugang verlangt. Für personenbezogene Daten gilt in der EU zudem die DSGVO – sammle nur, was du wirklich brauchst, und gehe sauber damit um.
4. Wie vereinfacht Thunderbit komplexe Web-Scraping-Aufgaben?
Thunderbit setzt KI ein, um Felder automatisch zu erkennen, Unterseiten zu verarbeiten und Daten aus dynamischen Seiten, PDFs und Bildern zu extrahieren. Es versteht Eingaben in natürlicher Sprache und exportiert direkt nach Google Sheets, Excel, Airtable oder Notion – komplett ohne Programmierung.
5. Wie starte ich am besten mit Python-Web-Scraping-Projekten?
Such dir eine Projektidee, die dich packt, installiere die nötigen Bibliotheken (BeautifulSoup, Selenium, Scrapy oder Thunderbit) und fang klein an – scrappe zuerst eine einzige Seite und skaliere dann Schritt für Schritt. Experimentiere, iteriere und scheue dich nicht, KI-gestützte Werkzeuge einzusetzen, um deinen Workflow zu beschleunigen.
Damit hast du genug Material, um dein nächstes Scraping-Projekt zu starten.
Mehr erfahren
- Die 15 besten Web-Scraping-Projekte auf GitHub im Jahr 2025
- Scrapy Python Tutorial: Ein praxisnaher Leitfaden für Web Scraping
- Umfassender Leitfaden für Web Scraping in Python: Schritt für Schritt
- Python-Scraping meistern: Ein Best-Practice-Tutorial für 2025
- Wie man mit Python einen Web Scraper schreibt: von Anfang bis Ende



