
Letzten Monat fing die Stripe-Integration eines Freundes am Freitag um 23 Uhr plötzlich an, stillschweigend 503-Fehler zurückzugeben. Niemand merkte etwas bis Samstagmorgen – da lagen bereits über 200 wütende E-Mails im Support-Postfach von Kundinnen und Kunden, deren Checkouts fehlgeschlagen waren.
Solche Geschichten sind leider kein Einzelfall. Ein häufig zitierter Benchmark beziffert die durchschnittlichen Ausfallkosten auf 5.600 US-Dollar pro Minute, während schwere Ausfälle Millionen pro Stunde verursachen können. Die genaue Summe hängt von Traffic, Conversion-Rate, Bestellwert, SLA-Risiken und Wiederherstellungskosten ab – aber die Richtung ist eindeutig: Unüberwachte APIs sind ein Geschäftsrisiko, nicht bloß ein technisches Ärgernis. Und da Unternehmen inzwischen im Schnitt 131 Drittanbieter-APIs einsetzen und nur 16 % angeben, Drittanbieter-API-Risiken gut eindämmen zu können, ist Monitoring längst keine Option mehr. Mit diesem Leitfaden wollte ich etwas schaffen, das ich anderswo selten gesehen habe: Tools nach Ihrem Anwendungsfall sortieren, die Qualität von Alerts bewerten – nicht nur ihre bloße Existenz –, echte Preise für 2026 zeigen und messen, wie schnell man wirklich loslegen kann. Also nicht noch so eine namenlose Logo-Sammlung.
Noch etwas: Wenn Ihre API-Arbeit Webdaten sammelt, LLMs füttert, RAG-Systeme aufbaut, Wettbewerberseiten überwacht oder Preis- und Produktdaten von Websites extrahiert, sollte die „API-Tool“-Diskussion nicht beim Uptime-Monitoring aufhören. Sie brauchen auch eine verlässliche Möglichkeit, unstrukturierte Webseiten in strukturierte Daten zu verwandeln. Genau hier passt Thunderbit Open API in diesen Leitfaden: Es ist kein Uptime-Monitor, aber eine der schnellsten Möglichkeiten, Websites per API in sauberes Markdown oder schema-basiertes JSON zu überführen.
Was ist API-Monitoring – und warum sollte sich Ihr Team darum kümmern?
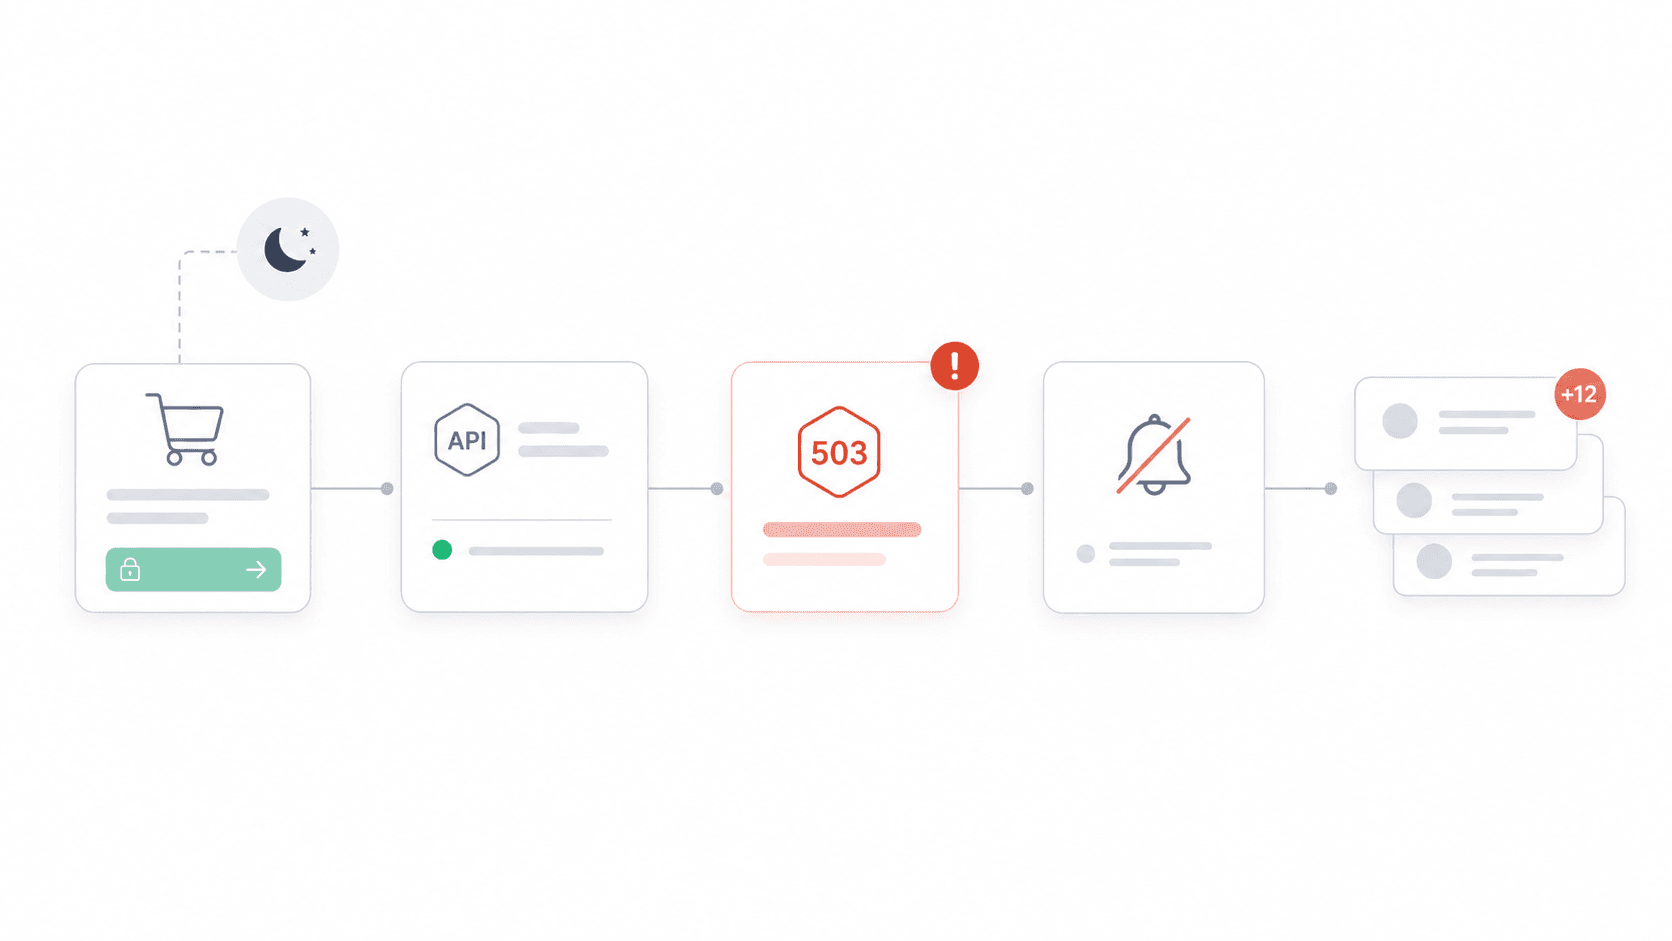
API-Monitoring bedeutet, fortlaufend zu prüfen, ob Ihre API-Endpunkte verfügbar und schnell sind und die richtigen Daten zurückgeben. Also nicht nur: „Ist der Server online?“ Gutes Monitoring validiert HTTP-Statuscodes, Response-Payloads, Latenz, SSL-Zertifikate, mehrstufige Abläufe wie Login → Suche → Checkout und sogar die Schema-Korrektheit.
Das ist etwas anderes als allgemeines Website-Monitoring, das nur testet, ob eine Seite lädt, und auch etwas anderes als APM (Application Performance Monitoring), das tiefer in Code-Traces, Datenbankabfragen und Laufzeitdetails eintaucht. API-Monitoring sitzt genau dazwischen: Es testet, was Nutzer, Partner und Integrationen tatsächlich erleben, wenn sie Ihre Endpunkte aufrufen.
Dazu kommt noch eine verwandte Kategorie, die man nicht vergessen sollte: Webdaten-APIs. Diese überwachen nicht die Gesundheit Ihrer eigenen API, sondern helfen Ihrem Produkt oder Workflow dabei, externe Webdaten zuverlässig zu erfassen. Thunderbit Open API kann zum Beispiel eine Webseite in sauberes Markdown verdichten, strukturierte Felder als JSON extrahieren und Batch-Jobs über viele URLs hinweg ausführen. Wenn Ihr „API“-Projekt von aktuellen Lieferantendaten, Produktseiten, öffentlichen Listings, Dokumentationsseiten oder Forschungsquellen abhängt, kann so eine Datenextraktions-API betrieblich genauso wichtig sein wie ein Uptime-Check.
Warum sollten sich Nicht-Entwickler dafür interessieren? Weil APIs 71 % des dynamischen Web-Traffics ausmachen und 62 % der API-Fachleute sagen, dass APIs direkt Umsatz erzeugen. Wenn ein Payment-Gateway, ein Auth-Dienst oder eine Shipping-API ausfällt, ist das kein abstraktes Infrastrukturproblem – sondern verlorener Umsatz, gebrochene Partnerverträge, mehr Support-Tickets und sinkendes Vertrauen. Produktmanagement, Vertrieb, Ops und Customer Success sind alle betroffen.
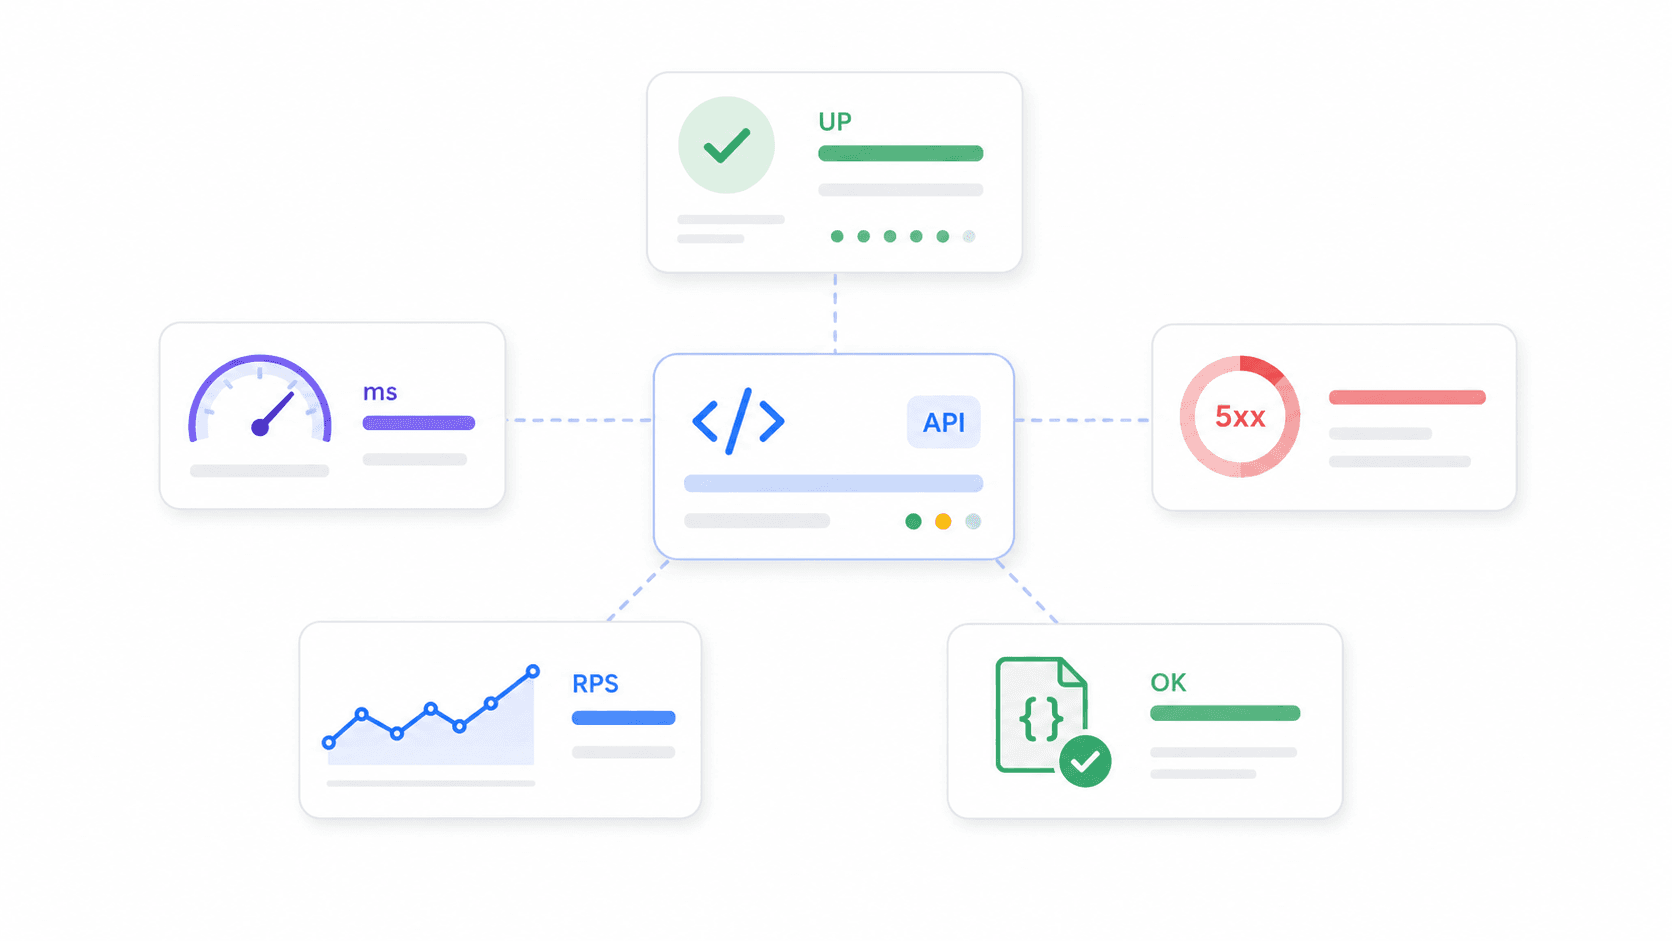
Wichtige Kennzahlen im Blick:
- Uptime-Prozent: Anteil der Zeit, in der ein Endpunkt verfügbar ist
- Antwortzeit / Latenz: Wie lange der Endpunkt für eine Antwort braucht (Durchschnitt, p95, p99)
- Fehlerrate: Anteil der Requests, die 5xx, Timeouts oder Assertion-Fehler zurückgeben
- Durchsatz: Requests pro Sekunde/Minute
- Korrektheit: Ob die API die erwarteten Daten liefert, nicht nur ein 200 OK
So haben wir die besten API-Monitoring-Tools für 2026 bewertet
Die meisten Artikel über die „besten API-Monitoring-Tools“ werfen einfach nur Herstellernamen und Features in einen Topf. Ich wollte die Auswahlkriterien bewusster angehen – auch, weil ich viel Zeit in Entwicklerforen verbracht habe und weil mir das Thunderbit-Team geholfen hat, Preise und Feature-Daten per Bulk-Extraktion von Herstellerseiten zu ziehen, um einen echten Vergleich aufzubauen (dazu später mehr).
Gewichtet haben wir Folgendes:
| Kriterium | Warum es wichtig ist |
|---|---|
| Einfaches Setup / Time-to-first-alert | Kleine Teams brauchen heute Abdeckung, nicht erst nach einem Plattformprojekt |
| Alert-Intelligenz & Rauschunterdrückung | Wenn Alerts rauschen, ignorieren Teams sie und verpassen echte Vorfälle |
| Großzügiger Free-Tier | Nebenprojekte und frühe Startups starten oft kostenlos |
| Transparente Preise | Observability-Rechnungen können durch Hosts, Seats, Logs, Synthetic Runs und Data Ingest schnell explodieren |
| Breite Integrationen | Alerts müssen dort landen, wo Teams ohnehin arbeiten (Slack, PagerDuty usw.) |
| Skalierbarkeit & Datentiefe | Reife Teams brauchen Traces, Logs, APM, RBAC, SSO und Aufbewahrung |
| Community- & Support-Qualität | Open-Source-Teams brauchen Release-Takt; Enterprise-Teams brauchen SLAs |
| Webdaten-Extraktionsfähigkeit | AI-Apps, RAG-Workflows und Marktforschung brauchen oft saubere externe Daten, nicht nur Uptime |
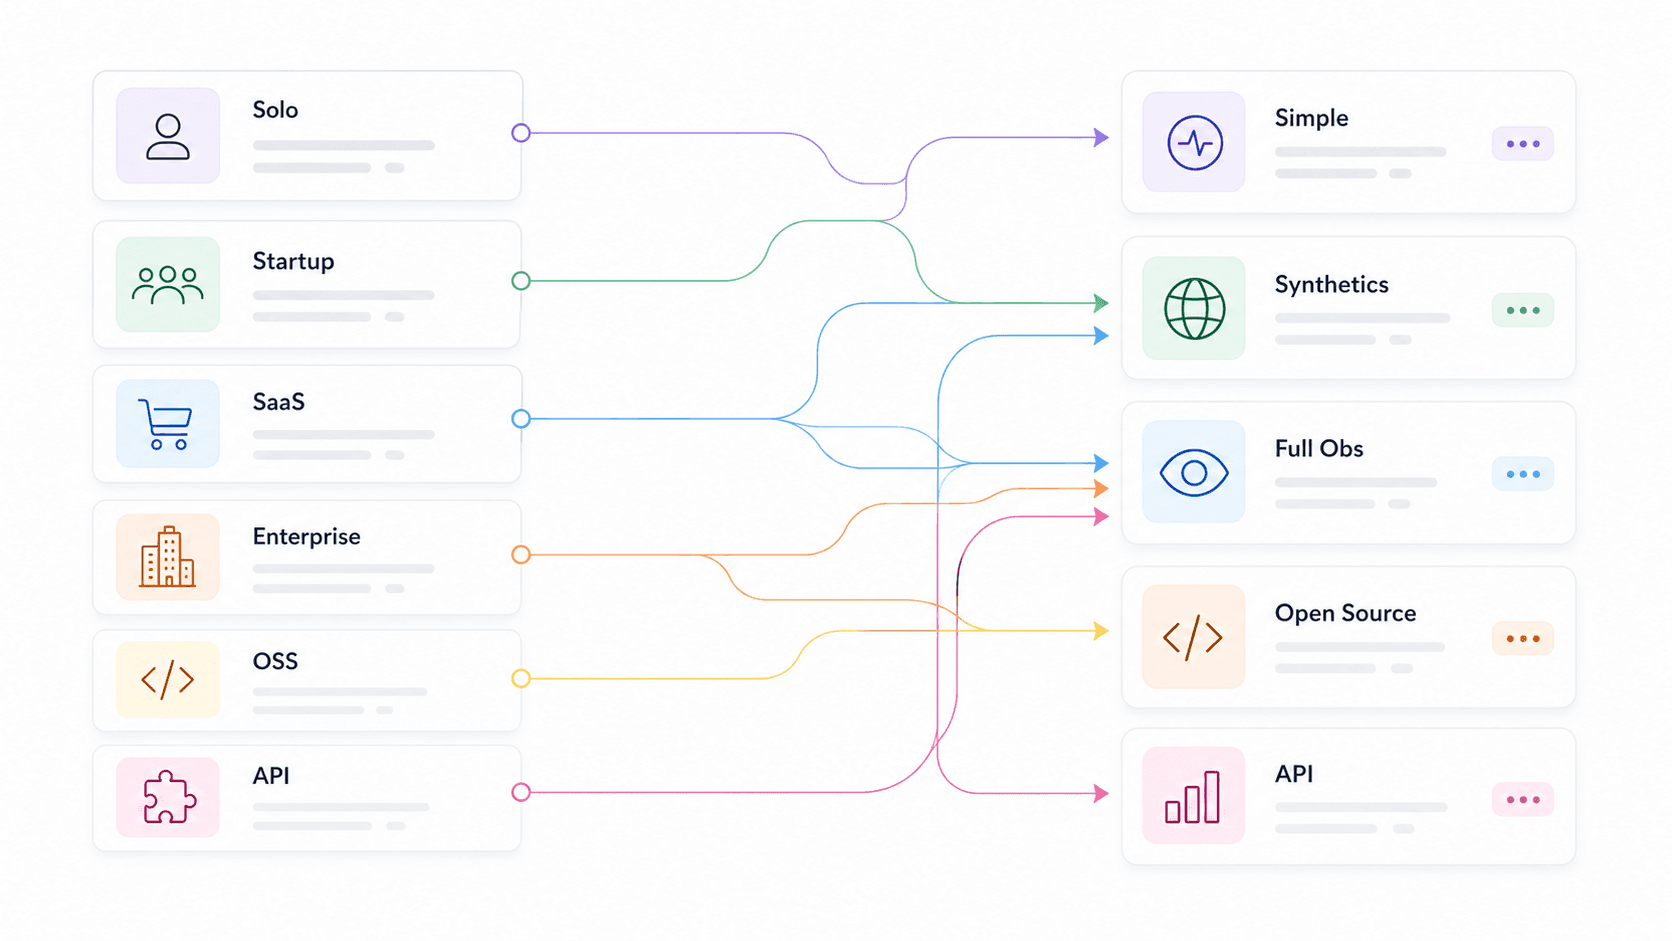
Wir haben Empfehlungen außerdem nach Use Case segmentiert – Solo-Dev, Startup, E-Commerce/SaaS, Enterprise, Open-Source-Purist, API-Produktteam und Webdaten-/AI-App-Team – damit Sie direkt zu Ihrem Kontext springen können, statt 14 Tool-Beschreibungen lesen und raten zu müssen, was überhaupt relevant ist. Grafanas Survey 2025 zeigt, dass 46 % Interoperabilität nannten und 35 % die einfache spätere Wechselmöglichkeit als Auswahlkriterien – ein klarer Beleg, dass das keine netten Extras sind.
Die besten API-Monitoring-Tools nach Use Case: Die Schnellwahl-Tabelle
Das ist die Abkürzung. Finden Sie Ihre Zeile und springen Sie dann unten zu den Tool-Abschnitten für die Details.
| Use Case | Empfohlene Tools | Wichtigster Unterschied |
|---|---|---|
| Webdaten-/AI-App-Teams | Thunderbit Open API, Moesif, Apitally | Websites in sauberes Markdown oder strukturiertes JSON für LLMs, RAG, Pricing- und Research-Workflows verwandeln |
| Solo-Dev / Nebenprojekt | UptimeRobot, Uptime Kuma, Gatus | Kostenlos oder self-hosted, minimale Konfiguration, schneller Start |
| Startup (5–15 Personen) | Checkly, Better Stack, Postman | Smarte Alerts, schneller Setup, bezahlbar, Statusseiten |
| E-Commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Business-Metriken, APM/Tracing, SDK-Tiefe, mehrstufige Synthetics |
| Enterprise / Multi-Cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed Tracing, Compliance, Hybrid-Umgebungen, RBAC/SSO |
| Open-Source-Puristen | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Volle Kontrolle, OTel-nativ, kein Vendor-Lock-in |
| API-Produktteams | Moesif, Apitally, New Relic | Nutzung pro Kunde, Endpunkt-Trends, Anomalie-Alerts |
Das größte Muster: Die am schnellsten einzurichtenden Tools sind oft analytisch schlanker, während tiefere Plattformen mehr Konfiguration und Kostenkontrolle verlangen. Das ist kein Fehler, sondern ein Trade-off, den man kennen sollte. Thunderbit spielt in einer etwas anderen Liga: Es ist am schnellsten, wenn es darum geht, Webseiten in API-taugliche Daten zu verwandeln, nicht Ingenieure bei Ausfällen anzupingen.
Thunderbit Open API: Am besten, wenn Webseiten in strukturierte API-Daten verwandelt werden sollen
Mit Thunderbit Open API loslegen Verdichte Seiten zu Markdown, extrahiere strukturiertes JSON und verarbeite URLs im Batch, ohne Scraping-Infrastruktur zu pflegen. Get Started Free
Thunderbit Open API ist die API, die ich an erster Stelle sehen würde, wenn ein Team beim Monitoring oder Research auf externe Webdaten angewiesen ist. Es ist kein klassisches Uptime-Monitoring-Tool wie Checkly oder UptimeRobot. Stattdessen verwandelt Thunderbit jede Webseite in saubere, strukturierte Daten, die Apps, Agenten, Dashboards und LLM-Pipelines wirklich nutzen können.
Die API hat drei Kern-Workflows. Distill wandelt eine Seite in sauberes, LLM-freundliches Markdown um. Extract nimmt ein Schema und liefert strukturierte JSON-Felder wie Produktname, Preis, Verfügbarkeit, Unternehmensgröße, Finanzierungsphase oder Bewertung. Batch erlaubt die asynchrone Verarbeitung von bis zu 100 URLs mit Webhooks – praktisch, wenn Sie Preisseiten, Wettbewerber-Kataloge, Lieferanten-Dokumentation, Nachrichtenquellen oder große Recherchen im Blick haben.
Warum gehört das in einen Leitfaden zu API-Tools? Weil Teams oft unterschätzen, wie viel Infrastruktur „hol einfach diese Seite“ eigentlich braucht. JavaScript-lastige Seiten brauchen Rendering. Manche Seiten brauchen Geo-Routing. HTML muss vor der Nutzung für ein LLM von Navigation, Anzeigen, Modals und Boilerplate befreit werden. Selektoren brechen, sobald sich ein Layout ändert. Proxy-Rotation, Anti-Bot-Handling, Retries, Queues und Ergebnisabfragen können aus einem kleinen Daten-Workflow ein Wartungsprojekt machen. Thunderbit nimmt einen großen Teil dieser Arbeit mit einer einzigen API ab.
Bestens geeignet für: AI-App-Builder, RAG-Teams, E-Commerce-Ops, Sales Ops, Growth-Teams, Marktforscher und Entwickler, die Webdaten per API brauchen, ohne einen Scraping-Stack aufbauen und betreuen zu müssen.
Preis: Kostenlos: 600 einmalige API-Units, darunter bis zu 600 Distill-Seiten oder 30 Extract-Seiten, mit 2 gleichzeitigen Requests. Starter ist bei jährlicher Abrechnung mit 16 $/Monat gelistet, inklusive 60.000 API-Units/Jahr und 30 gleichzeitigen Requests. Pro ist bei jährlicher Abrechnung mit 40 $/Monat gelistet, inklusive 600.000 API-Units/Jahr und 50 gleichzeitigen Requests.
Einrichtungszeit: ca. 5–15 Minuten, um einen API-Key zu erhalten und den ersten Distill- oder Extract-Request mit cURL, SDKs oder der Thunderbit CLI auszuführen.
Nachteile: Thunderbit ersetzt nicht Datadog, New Relic, Better Stack oder Checkly für Uptime-Checks, Incident-Eskalation, Traces, Logs oder On-Call-Routing. Verstehen Sie es als die API, mit der Sie Webdaten sammeln und strukturieren – inklusive Anbieterpreise, Dokus, Wettbewerberseiten, Produktlisten oder öffentlichen Datensätzen – nicht als System, das Ihren Bereitschaftsdienst aufweckt.
Datadog: Am besten für Full-Stack-Transparenz
Datadog ist das Tool, das ich immer wieder in Enterprise- und Mid-Market-SaaS-Stacks sehe – und das aus gutem Grund. Es ist nicht nur API-Monitoring, sondern eine vollwertige Observability-Plattform, die synthetische API-Tests, verteilte Traces, Logs, Infrastrukturmetriken und Real User Monitoring in einer Ansicht zusammenführt.
Für API-Monitoring unterstützt Datadog unter anderem HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC und mehrstufige API-Tests. Die Anomaly-Detection-Monitore lernen erwartete Muster und warnen bei Abweichungen statt bei statischen Grenzwerten – ein deutlicher Fortschritt gegenüber „Alarm, wenn Latenz > 500 ms“. Außerdem gibt es Forecast-Monitore, die vorhersagen, wann ein Metrikwert eine Schwelle überschreiten wird, sowie Composite-Monitore, die mehrere Bedingungen kombinieren.
Bestens geeignet für: E-Commerce-, SaaS- und Enterprise-Teams, die eine einheitliche Sicht auf APIs, Infrastruktur, Logs und Traces brauchen.
Preis: Free-Tier-Details variieren je nach Produkt. Infrastructure Pro startet bei 15 $/Host/Monat; API-Synthetic-Tests kosten 5 $ pro 10.000 Runs. Über 800 Integrationen.
Einrichtungszeit: ca. 15–30 Minuten für Agent-Installation plus einen einfachen Synthetic Test.
Nachteile: Kann im großen Maßstab teuer werden – „Bill Shock“ ist ein wiederkehrendes Thema auf Hacker News und Reddit. Die Vielzahl an SKUs (Hosts, Logs, Custom Metrics, Synthetics, Users) bedeutet, dass jemand die Rechnung im Blick behalten muss, nicht nur die Dashboards. Die Lernkurve ist für die volle Plattform real.
Checkly: Am besten für Developer-First Synthetic Checks
Checkly ist das Tool, das ich einem Startup-Engineering-Team geben würde, das API-Checks gern nah am Code hält. Die Kernidee lautet „Monitoring as Code“: API- und Browser-Checks programmatisch definieren, von globalen Standorten aus ausführen, in CI/CD-Pipelines integrieren und alles über Git verwalten.
Auch bei der Alert-Qualität punktet Checkly. Die Retry-Logik ist ausdrücklich als „erste Verteidigungslinie“ gegen False Positives positioniert – Sie können feste, lineare oder exponentielle Retries konfigurieren, Retries am selben oder an unterschiedlichen Standorten wählen und maximale Retry-Dauern festlegen, bevor ein Alert ausgelöst wird. Außerdem unterscheidet das System zwischen degradierten, fehlgeschlagenen und wiederhergestellten Zuständen, was das Alarmrauschen reduziert.
Bestens geeignet für: Startups und Dev-Teams, die programmierbare API-Checks, Playwright-basierte Browser-Checks, CI/CD-Integration und einen schnellen Start wollen.
Preis: Aktuelle öffentliche Daten nennen einen kostenlosen Plan mit 10 Uptime-Monitoren, 1.000 Browser-Checks und 10.000 API-Checks. Starter liegt bei etwa 24 $/Monat bei jährlicher Abrechnung – offizielle Preisseite prüfen vor dem Kauf.
Einrichtungszeit: ca. 10–20 Minuten für den ersten API-Check und einen Alert-Kanal.
Nachteile: Stark auf Synthetic Checks fokussiert. Kein Ersatz für tiefes APM, Log-Analytics oder Distributed Tracing. Wenn Sie einen API-Fehler mit einem Datenbank-Engpass korrelieren müssen, brauchen Sie zusätzlich ein anderes Tool.
UptimeRobot: Am besten für simples, bezahlbares Uptime-Tracking
UptimeRobot ist der Honda Civic unter den API-Monitoring-Tools. Es macht eine Sache gut: Sie legen einen HTTP-, Keyword-, Ping-, Port-, SSL- oder Heartbeat-Monitor an, wählen das Intervall und werden benachrichtigt, wenn etwas schiefgeht. Mehr nicht.
Bestens geeignet für: Solo-Dev, kleine Teams, Agenturen oder alle, die grundlegendes Uptime- und Latenz-Tracking ohne Komplexität brauchen.
Preis: Kostenlos: 50 Monitore, 5-Minuten-Intervalle. Paid Solo ab etwa 7 $/Monat bei jährlicher Abrechnung. Für den Free-Plan ist keine Kreditkarte nötig. Einrichtungszeit: ca. 2–5 Minuten – die schnellste Lösung in dieser Liste.
Nachteile: Begrenzte Alert-Intelligenz. Einfache Schwellenwerte, keine Anomalieerkennung, kein Distributed Tracing, keine tiefe Analyse. Wenn Sie wissen wollen, warum ein Endpunkt langsam ist – und nicht nur dass er langsam ist – bringt UptimeRobot Sie nicht ans Ziel.
Uptime Kuma: Das beste kostenlose, self-hosted API-Monitoring-Tool
Uptime Kuma ist der Liebling der Self-Hosting-Community, und die GitHub-Zahlen sprechen für sich: 86.637 Stars, 7.831 Forks, 1.060 Contributors sowie Release 2.3.2 per Mai 2026. Es steht unter MIT-Lizenz, unterstützt HTTP(s), Keyword, JSON Query, WebSocket, TCP, Ping, DNS, Push, Docker, mehrere Statusseiten und über 90 Benachrichtigungsdienste.
Bestens geeignet für: Solo-Dev und Teams, die volle Kontrolle, Privatsphäre und null laufende SaaS-Kosten wollen – sofern sie einen Server haben.
Preis: Kostenlos. Die echten Kosten sind VM/Container, Backups, Updates und dafür zu sorgen, dass der Monitor selbst verfügbar bleibt. Einrichtungszeit: ca. 5–15 Minuten mit Docker für einen Basis-Check; 15–30 Minuten mit Benachrichtigungen und einer sauberen Statusseite.
Nachteile: Sie übernehmen die Wartung selbst. Und hier der entscheidende Haken: Wenn Sie Uptime Kuma auf derselben Infrastruktur betreiben, die es überwacht, legt ein Cloud- oder DNS-Ausfall sowohl Ihre App als auch Ihren Monitor lahm. Also extern hosten oder mit einem SaaS-Check kombinieren.
Better Stack: Am besten für schnelle Incident Response
Better Stack – von Nutzern oft immer noch Better Uptime genannt – kombiniert Uptime-Monitoring mit Incident Management, On-Call-Planung, Eskalationsrichtlinien und Statusseiten in einer Plattform. Seine größte Stärke ist weniger Analytics als vielmehr ein Incident-Workflow rund um Monitoring.
Eskalationsrichtlinien legen fest, wer in welcher Reihenfolge und mit welchen Verzögerungen benachrichtigt wird, bis jemand bestätigt. Metadatenbasiertes Routing leitet Incidents nach Schweregrad oder Zuständigkeit weiter. Dazu kommen Integrationen mit Slack, Teams, Webhooks und Zapier.
Bestens geeignet für: Startups und mittelgroße Teams, die Monitoring + Incident Response + Statusseiten wollen, ohne drei Tools zusammenzubauen.
Preis: Free-Tier: 10 Monitore/Heartbeats, 1 Statusseite. Team ab etwa 29 $/Monat bei jährlicher Abrechnung. Einrichtungszeit: ca. 5–10 Minuten per GUI-Assistent.
Nachteile: Weniger Tiefe bei API-Payload-Analytics, Distributed Tracing oder Business-KPI-Analysen als Datadog, New Relic oder Moesif.
Prometheus + Grafana: Der beste Open-Source-Stack für API-Monitoring
Das ist die branchenübliche Open-Source-Kombination. Prometheus sammelt und speichert Time-Series-Metriken. Grafana (73.705 GitHub-Stars, 3.010 Contributors) liefert Dashboards und Alerts. Alertmanager übernimmt Routing, Gruppierung, Deduplizierung, Stummschaltung und Inhibition. Für Endpoint-Checks ergänzen Teams oft den Blackbox Exporter für HTTP, HTTPS, DNS, TCP, ICMP und gRPC-Probes.
Bestens geeignet für: Open-Source-Puristen, Kubernetes-/SRE-Teams und Organisationen, die bereits auf Prometheus-Metriken standardisiert haben.
Preis: Kostenlos self-hosted. Grafana Cloud hat einen Free-Tier (100k API-Test-Ausführungen/Monat) und nutzungsbasierte Paid-Pläne.
Einrichtungszeit: 1–4 Stunden für Blackbox + Prometheus + Grafana + Alertmanager in einer Basisversion. Für produktive HA-Setups und Alert-Tuning eher Tage.
Nachteile: PromQL, YAML, Relabeling, Dashboard-Design, Retention, Storage, HA und Alert-Tuning sind echte Betriebsarbeit. Der wiederkehrende Kompromiss lautet: weniger UI, mehr YAML. Dieser Stack ist für Teams, die ohnehin in Metriken denken und eine gemeinsame Steuerungsebene wollen – nicht für Teams, die bis zum Mittag Monitoring live haben möchten.
New Relic: Am besten für SaaS-Application-Performance
New Relic kombiniert APM, Infrastruktur-Monitoring, Logs, Distributed Tracing, synthetisches Monitoring, Alerts, Dashboards und KI-gestützte Incident-Analyse. Der Free-Tier – 100 GB/Monat Ingest und 1 Full-Platform-User – ist für kleine Teams wirklich großzügig.
Bei der Alert-Intelligenz glänzt New Relic vor allem in Sachen Alarmmüdigkeit. Die Incident-Intelligence umfasst Event-Korrelation, Anomalieerkennung, Predictive Alerts, Root-Cause-Analyse und Flapping-Unterdrückung. New Relic hat ein Beispiel veröffentlicht, wonach 97,2 % Flapping-Effektivität bedeutet, dass nur 28 auffällige Issues pro 1.000 Flapping-Incidents sichtbar werden – das ist eine konkrete Zahl zur Rauschreduktion.
Bestens geeignet für: SaaS-Teams und E-Commerce-Plattformen, die API-Monitoring eng mit App-Traces, Errors, Throughput und Nutzerwirkung verknüpfen wollen.
Preis: Kostenlos: 100 GB/Monat, 1 Full User. Paid basiert auf Nutzer- und datenabhängiger Preisgestaltung.
Einrichtungszeit: ca. 15–30 Minuten für Agent-Installation und geführtes Setup.
Nachteile: Die Preisstruktur kann im großen Maßstab komplex werden. Auch die Alert-Konfiguration hat eine Lernkurve – die Plattform ist stark, aber nicht sofort selbsterklärend.
Moesif: Am besten für API-Analytics und Business-Kennzahlen
Moesif ist kein klassischer Uptime-Monitor. Es geht um API-Analytics und Produktintelligenz: API-Nutzung nach Kunde, Endpunkt, Kohorte, Unternehmen, Region, SDK, Tarif und Verhalten zu verstehen. Wenn Ihre Frage eher lautet „Welcher Kunde ist betroffen?“ als „Ist der Endpunkt online?“, ist Moesif dafür gemacht.
Es unterstützt statische Schwellenwert-Alerts und dynamische Anomalie-Alerts für API-Metriken wie Traffic-Spitzen und -Einbrüche, Latenz und Verhaltensänderungen. Die dynamischen Alerts brauchen ein paar Tage Verhaltensdaten, um ein Modell aufzubauen, erkennen danach aber Veränderungen, die statische Regeln übersehen.
Bestens geeignet für: API-Produktteams, SaaS-Unternehmen und E-Commerce-Plattformen, die API-Performance mit Umsatz, Engagement und Retention verknüpfen wollen.
Preis: Kostenlos/Testversion verfügbar; Paid-Pläne skalieren mit dem API-Event-Volumen. Die konkreten Self-Service-Preise waren in meiner Recherche nicht vollständig auslesbar – bitte die aktuelle Seite prüfen.
Einrichtungszeit: ca. 20–45 Minuten (SDK-/Proxy-/Gateway-Integration ist tiefer als ein externer Ping).
Nachteile: Mehr Analytics als klassisches Uptime-Monitoring. Wahrscheinlich sollten Sie Moesif mit Checkly, UptimeRobot oder Datadog Synthetics für externe Verfügbarkeitsprüfungen kombinieren.
Splunk: Am besten für Enterprise-Log-Analyse und Compliance
Splunk ist das Tool, das Sie heranziehen, wenn Log-Aggregation, Suche, Korrelation, prüfbare Compliance und Hybrid-/Multi-Cloud-Support unverzichtbar sind. Splunk Observability Cloud deckt Infrastruktur, APM, Synthetics, Real User Monitoring, Logs und Incident Response ab. ITSI/Event Analytics kann auffällige Events zu Episoden bündeln und das Rauschen über Monitoring-Silos hinweg reduzieren.
Die eigenen Observability-Befunde von 2025 sind ernüchternd: 73 % der ITOps-/Engineering-Befragten berichteten von Ausfällen durch ignorierte oder unterdrückte Alerts, 59 % kämpften mit zu vielen unterschiedlichen Tools und 52 % mit False Alerts.
Bestens geeignet für: Enterprise- und Multi-Cloud-Teams mit strengen Anforderungen an Compliance, Sicherheit, Auditierbarkeit und Log-Suche.
Preis: Nutzungsbasiert und meist nur per Angebot. Kein einfacher Free-Tier für produktive Nutzung.
Einrichtungszeit: Cloud-Onboarding kann schneller sein, aber Enterprise-Rollouts dauern oft Tage bis Wochen.
Nachteile: Teuer im Maßstab. Komplex im Setup. Überdimensioniert für Solo-Dev und kleine Startups.
Postman: Am besten für Teams, die ohnehin APIs testen
Postman ist in erster Linie eine Plattform für API-Entwicklung und -Tests, aber das Monitoring-Produkt erlaubt es Teams, Postman-Collections zu planen und aus Cloud-Standorten auszuführen. Das stärkste Argument ist die Wiederverwendung: Wenn Ihr QA- oder Dev-Team bereits Collections mit Assertions hat, ist daraus ein Monitor zu machen der natürliche nächste Schritt.
Bestens geeignet für: Dev- und QA-Teams, die ohnehin Postman-Collections nutzen und geplante Checks ohne separates Synthetic-Tool wollen.
Preis: Free-Tier vorhanden. Monitoring-Mehrkosten bei 0,75 $ pro 1.000 Calls; Zusatzpaket mit 50.000 Calls für 20 $/Monat. Bitte die aktuelle Preisseite prüfen – die Paketstruktur ändert sich.
Einrichtungszeit: ca. 10 Minuten, wenn Collections bereits vorhanden sind.
Nachteile: Die Monitoring-Funktionen sind leichtergewichtig als bei spezialisierten Tools wie Checkly, Datadog oder New Relic. Die Alert-Optionen sind eher basic.
Weitere API-Monitoring-Tools, die einen Blick wert sind
Gatus: Leichtgewichtiges, self-hosted, konfigurationsgetriebenes Health-Dashboard. 10.906 GitHub-Stars, unterstützt HTTP, ICMP, TCP, DNS, Prometheus-freundliche Metriken und Uptime-Badges. Gut für Solo-Dev, die etwas Einfacheres als Prometheus wollen, aber YAML/Config-as-Code und Uptime Kumas UI vorziehen.
Apitally: Neueres Tool mit Fokus auf API-Traffic-Analytics und Qualitäts-Tracking für Startups. Verspricht Setup in unter 5 Minuten mit benutzerdefinierten Alerts über 14 Metriken. Gut für leichtgewichtiges API-Analytics, ohne eine vollständige Observability-Plattform einzuführen.
Sematext: Full-Stack-Monitoring mit Logs, Synthetics und Infrastruktur-Transparenz. Synthetics etwa 2 $ pro HTTP-Monitor, 7 $ pro Browser-Monitor, Mindestbetrag 5 $/Monat. Eine günstigere Alternative zu Datadog für Mid-Market-Teams.
Uptrace: OpenTelemetry-nativer Backend-Stack für APM, Tracing, Metriken und Logs. 4.198 GitHub-Stars. Kein reiner Uptime-Checker, aber ideal für Teams, die auf OTel standardisieren und ein Open-Source-freundliches Tracing-Backend wollen.
Build vs. Buy: Sollten Sie Ihr API-Monitoring selbst bauen?
„Soll ich einfach ein Script schreiben, das meine Endpunkte anpingt, oder lieber ein spezielles Tool nutzen?“
Diese Frage taucht in Entwicklerforen ständig auf. Ich habe genug Reddit-Threads gelesen, um das Muster klar zu sehen: Teams starten mit curl + cron, das läuft eine Weile ganz gut – und wechseln dann, sobald sie Dashboards, historische Daten, Multi-Region-Checks, zuverlässiges Alert-Routing oder teamübergreifende Sichtbarkeit brauchen.
Eine ehrliche Entscheidungs-Matrix:
| Faktor | Custom Script | Spezialisiertes Tool |
|---|---|---|
| Einrichtungszeit | 1–4 Stunden (basic); Tage (robust) | 5–30 Minuten |
| Wartung | Sie tragen sie für immer | Der Anbieter übernimmt Updates |
| Alert-Qualität | Einfach (up/down) | Intelligent (Latenztrends, Anomalien, Retries) |
| Kosten | Kostenlos (Ihre Zeit) | 0–500+ $/Monat |
| Dashboard | Selbst bauen | Vorgefertigt, anpassbar |
| Bestens, wenn… | ≤3 Endpunkte, dev-lastiges Team, Hobbyprojekt | 5+ Endpunkte, Ops-/Produktteam, Umsatz steht auf dem Spiel |
Die wichtigste Erkenntnis aus den Foren: Wer etwas Eigenes baut, bereut es oft, sobald Dashboards, historische Daten oder teamübergreifende Sichtbarkeit nötig werden. Dazu kommt das Meta-Problem – „Sie brauchen Monitoring für Ihr Monitoring“. Ein self-hosted Monitor, die Datenbank, Backups, Netzwerkpfade und der Alert-Anbieter selbst müssen ebenfalls zuverlässig sein.
Bauen Sie es selbst, wenn Sie 2 Endpunkte haben und gern basteln. Kaufen Sie es, wenn Sie ein Produkt ausliefern wollen.
Die gleiche Logik gilt für Webdatenextraktion. Sie können einen Scraper schreiben, Headless Browser betreiben, Proxies rotieren, Selektoren pflegen, HTML bereinigen und eine Queue bauen. Aber wenn das Ziel ist, Webdaten zuverlässig in ein API-Produkt, einen AI-Agenten oder einen Research-Workflow zu speisen, ist Thunderbit Open API meist schneller als eine eigene Scraping-Infrastruktur aufzusetzen.
Alert Fatigue: Warum Alert-Qualität wichtiger ist als Alert-Menge
Das ist wahrscheinlich das am meisten unterschätzte Kriterium bei der Auswahl eines API-Monitoring-Tools. Alert Fatigue entsteht, wenn Teams so viele verrauschte, doppelte oder unbrauchbare Alerts bekommen, dass sie irgendwann alle ignorieren – und dann echte Vorfälle verpassen.
Die Zahlen sind heftig. BigPandas Bericht 2025 ergab, dass eine Median-Organisation 2.350 Alerts pro Tag und 803.406 Alerts pro Jahr erzeugt. Die mediane Handlungsfähigkeit von Incidents lag nur bei 18 % – also waren weniger als einer von fünf alert-basierten Incidents tatsächlich handlungsrelevant. NeuBirds Umfrage 2026 zeigte, dass 77 % der On-Call-Teams mindestens 10 Alerts pro Tag erhalten und 80 % sagen, dass die Hälfte oder weniger davon verwertbar ist.
Das beste Monitoring-Tool ist das, dessen Alerts Sie wirklich vertrauen. So gehen die Tools mit Alert-Intelligenz um:
| Tool | Alert-Typ | Rauschreduzierung | Alert-Kanäle |
|---|---|---|---|
| Datadog | ML-Anomalie, Forecast, Composite | Historische Anomaliebänder, dynamische Baselines, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Threshold + Degradations-basiert | Retries vor dem Auslösen, Retries am selben/anderen Standort | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | KI-Issue-Gruppierung, Anomalie, Predictive | Event-Korrelation, Flapping-Unterdrückung, Root-Cause-Kontext | Slack, PagerDuty, Teams, Webhooks |
| Moesif | Verhaltensanomalie | Dynamische Modelle nach mehreren Tagen Verhalten | Slack, PagerDuty, E-Mail, SMS |
| Better Stack | Uptime/Incident/On-Call | Eskalationsrichtlinien, Routing nach Zuständigkeit, Verzögerungen | Slack, Teams, Webhooks, Zapier |
| Prometheus + Alertmanager | PromQL-Regel-Alerts | Gruppierung, Deduplizierung, Stummschaltung, Inhibition | E-Mail, PagerDuty, Opsgenie, Webhooks |
| Splunk | Events, Episoden, Service Health | ITSI Event Analytics, Episoden-Gruppierung, Ticketing | Splunk On-Call, ServiceNow, Webhooks |
| Thunderbit Open API | Keine Alerting-Plattform | Mit eigenem Scheduler, Workflow-Tool oder Monitoring-Stack verwenden | Webhooks für Batch-Jobs; Alerts extern gelöst |
Praktischer Rat: Starten Sie mit weniger, aber verlässlicheren Alerts. Nutzen Sie Retries vor dem Auslösen, Bestätigung aus mehreren Regionen, SLO-Burn-Rate-Alerts, Deduplizierung und Routing nach Zuständigkeit. Alarmieren Sie bei Nutzerimpact und geschäftskritischen Abläufen wie Checkout-Fehler, Auth-Fehler und Payment-5xx, nicht bei jedem internen Symptom.
Kostenfreie Tiers und Preise 2026: Was Sie wirklich zahlen
Preisseiten ändern sich. Free-Tiers verschieben sich. Versteckte Kosten wie Hosts, Seats, Logs, Synthetic Runs und Data Ingest können überraschen. Das ist genau der Abschnitt, den ich mir in jedem „best tools“-Artikel gewünscht hätte. Der Stand für 2026:
| Tool | Free-Tier | Paid ab | Kreditkarte nötig? | Bester Free-Use-Case |
|---|---|---|---|---|
| Thunderbit Open API | 600 einmalige API-Units | ca. 16 $/Monat jährlich | Nein | Webdatenextraktion für LLMs, RAG, Pricing und Research |
| Uptime Kuma | Unbegrenzt (self-hosted) | — | Nein | Vollständiges Monitoring, eigener Server |
| UptimeRobot | 50 Monitore, 5-Minuten-Intervalle | ca. 7 $/Monat | Nein | Einfache Uptime-Checks |
| Better Stack | 10 Monitore, 1 Statusseite | ca. 29 $/Monat | Nein | Startup-Uptime + Statusseite |
| Checkly | 10 Uptime, 10k API-Checks | ca. 24 $/Monat | Ja | Synthetic API-Checks |
| Postman | Kostenloses Konto + Monitoring-Kontingent | ca. 14 $/User/Monat | Nein | Vorhandene Collections weiterverwenden |
| Prometheus + Grafana | Unbegrenzt (self-hosted) | — | Nein | Metriken + Visualisierung |
| Grafana Cloud | 100k API-Testausführungen/Monat | 29 $/Monat Plattform + Nutzung | Prüfen | Managed-Synthetics-Testphase |
| New Relic | 100 GB/Monat, 1 Full User | Pro User + Daten | Bei manchen Plänen | APM + Basic Observability |
| Datadog | Trial/je nach Produkt variierend | 15 $/Host/Monat (Infra Pro) | Oft ja | Full-Stack-Evaluierung |
| Moesif | Free/Testversion verfügbar | Volumenbasiert | Prüfen | API-Analytics-Evaluierung |
| Splunk | Trials verfügbar | Angebotsbasiert | Vertriebsprozess | Enterprise-PoC |
| Gatus | Unbegrenzt (self-hosted) | — | Nein | YAML-gesteuertes Status-Dashboard |
| Apitally | Free/Testversion verfügbar | Prüfen | Prüfen | Leichtgewichtiges API-Analytics |
| Sematext | Trial/Free je nach Angebot | ca. 2 $/HTTP-Monitor | Prüfen | Günstigere Synthetics/Logs |
| Uptrace | Kostenlos self-hosted | Cloud-Tiers variieren | Prüfen | OTel-APM-Evaluierung |
Hinweis zu versteckten Kosten: Self-hosted Tools wie Uptime Kuma, Prometheus und Gatus sind lizenzseitig „kostenlos“, aber eine kleine VM, Backups, Wartungszeit und externes Failover können schnell zum echten Kostenblock werden. Bei Webdaten-APIs sind die versteckten Kosten oft andere: Headless-Browser, kaputte Selektoren, Proxy-Pools, Anti-Bot-Workarounds und HTML-Bereinigung.
Kleine-Team-Schätzung: Für 10 API-Endpunkte und 3 Teammitglieder ist der günstigste SaaS-Weg meist UptimeRobot Free oder ein günstiger Paid-Tarif, Better Stack Free/Team oder Checkly, falls das Ausführungsvolumen passt. Datadog und New Relic können für Evaluierungen erschwinglich sein, aber die tatsächliche Rechnung hängt von Hosts, Usern, Logs, Traces und der Menge der Synthetic Runs ab. Wenn Ihr Projekt Website-Daten per API braucht, reichen die kostenlosen API-Units von Thunderbit meist aus, um den Workflow vor einem Paid-Plan zu testen.
Scorecard zur Setup-Komplexität: Wie schnell kommen Sie zum ersten Alert?
Kein Konkurrenzartikel, den ich gefunden habe, bewertet Time-to-Value – also wie lange es von der Anmeldung bis zum ersten sinnvollen Alert dauert. Für kleinere Teams ist das oft wichtiger als die Breite der Features.
| Tool | Zeit bis zum ersten Alert | Benötigtes technisches Niveau | Konfigurationsansatz |
|---|---|---|---|
| Thunderbit Open API | ca. 5–15 Minuten | Niedrig–Mittel | API-Key, cURL/SDK/CLI |
| UptimeRobot | ca. 2–5 Minuten | Niedrig | GUI, per Klick hinzufügen |
| Better Stack | ca. 5–10 Minuten | Niedrig | GUI-Assistent |
| Checkly | ca. 10–20 Minuten | Niedrig–Mittel | Code oder GUI |
| Postman | ca. 10 Minuten (mit Collections) | Niedrig–Mittel | Collection-Planer |
| Uptime Kuma | ca. 5–30 Minuten | Mittel | Docker + GUI |
| Gatus | ca. 15–45 Minuten | Mittel | YAML + Docker |
| Datadog | ca. 15–30 Minuten | Mittel | Agent-Installation + GUI |
| New Relic | ca. 15–30 Minuten | Mittel | Agent + geführtes Setup |
| Moesif | ca. 20–45 Minuten | Mittel | SDK-/Proxy-Integration |
| Grafana Cloud Synthetics | ca. 15–45 Minuten | Mittel | GUI, Terraform optional |
| Prometheus + Grafana | 1–4 Stunden | Mittel–Hoch | YAML, PromQL |
| Uptrace | 30–90 Minuten | Mittel–Hoch | OTel-SDK-Integration |
| Splunk | Stunden bis Wochen | Hoch | Enterprise-Onboarding |
Wenn Monitoring bis heute Abend live sein muss, starten Sie in der oberen Hälfte der Tabelle. Wenn das Ziel eine belastbare Plattform-Observability ist, planen Sie dafür ein eigenes Projekt ein. Und wenn Ihr erstes Etappenziel lautet „diese 100 Webseiten sauber in eine App bringen“, fangen Sie lieber mit Thunderbit an, bevor Sie eine eigene Scraping-Infrastruktur bauen.
Die besten API-Monitoring-Tools im Vergleich: Der große Side-by-Side-Vergleich
Eine Tabelle zum schnellen Scannen, bevor Sie entscheiden:
| Tool | Best Use Case | Free-Tier | Alert-Intelligenz | Setup-Zeit | Hosting | Herausstechendes Merkmal |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Webdatenextraktion/API-Datenpipelines | 600 API-Units | Kein Alerting-Tool | 5–15 Min | Cloud | Seiten zu Markdown verdichten oder schema-basiertes JSON extrahieren |
| Datadog | Full-Stack Enterprise/SaaS | Trial/variiert | Anomalie, Forecast, KI | 15–30 Min | Cloud | Verknüpft Synthetics mit Logs/Traces/Infra |
| Checkly | Developer-first Synthetics | Großzügig, check-basiert | Retries, Degradation | 10–20 Min | Cloud | Monitoring as Code + Playwright |
| UptimeRobot | Einfache Uptime | 50 Monitore | Einfache Schwellenwerte | 2–5 Min | Cloud | Schnellster günstiger Basis-Monitor |
| Uptime Kuma | Kostenlos self-hosted | Unbegrenzt | Einfaches Status-/Threshold-Handling | 5–30 Min | Self-hosted | Saubere UI, keine SaaS-Gebühr |
| Better Stack | Incident Response/Statusseiten | 10 Monitore | Eskalationen, Routing | 5–10 Min | Cloud | Monitoring + On-Call + Statusseite |
| Prometheus + Grafana | Open-Source-Metrik-Stack | Unbegrenzt (self-hosted) | Alertmanager-Gruppierung | 1–4 Std | Self-hosted/Cloud | Tiefe des PromQL-Ökosystems |
| New Relic | SaaS APM + API-Checks | 100 GB/Monat, 1 User | KI-Gruppierung, Flapping-Unterdrückung | 15–30 Min | Cloud | Starkes APM + Synthetics zusammen |
| Moesif | API-Analytics/Business-Metriken | Free/Testversion | Verhaltensanomalien | 20–45 Min | Cloud | API-Verhalten pro Kunde analysieren |
| Splunk | Enterprise-Logs/Compliance | Trial | ITSI-Episoden, AIOps | Tage+ | Cloud/Self-managed | Enterprise-Logsuche und Governance |
| Postman | Teams, die schon APIs testen | Kostenloses Konto | Einfache Monitor-Alerts | 10 Min | Cloud | Wiederverwendung von API-Test-Collections |
Wie Thunderbit die Bewertung Ihrer API-Tools beschleunigen kann
Ganz offen: Thunderbit ist kein API-Monitoring-Tool, sondern ein agentischer Webscraper und Open API, der Webseiten in sauberes Markdown oder strukturiertes JSON verwandelt. Genau das macht es an einer anderen Stelle im Entscheidungsprozess nützlich: beim Sammeln von Anbieterpreisen, Planlimits, Feature-Versprechen, Doku-Details und Integrationslisten, bevor Sie sich für eine Plattform entscheiden.
Statt 10+ Preis-Seiten von Hand zu öffnen und Plan-Namen, Monitor-Limits, Prüfintervalle, Integrationen und Kreditkartenanforderungen in eine Tabelle zu kopieren, haben wir die Thunderbit Chrome Extension genutzt, um strukturierte Daten aus den Preis- und Feature-Seiten der einzelnen Tools zu extrahieren. Thunderbits KI liest jede Seite, schlägt Felder vor – Planname, Free-Tier-Details, Preis, unterstützte Integrationen – und strukturiert die Ausgabe direkt in eine exportierbare Tabelle.
Für Developer-Workflows bietet Thunderbit Open API denselben Ansatz programmatisch. Nutzen Sie Distill, wenn Sie sauberes Markdown für LLMs oder RAG brauchen. Nutzen Sie Extract, wenn Sie bestimmte Felder als JSON zurückgeben lassen wollen. Nutzen Sie Batch, wenn Sie eine Liste von Preis-Seiten, Dokumentations-URLs, Produktseiten oder Wettbewerberseiten verarbeiten und die Ergebnisse asynchron erhalten möchten.
Der Workflow:
- Öffnen Sie die Preisseite eines Anbieters (Datadog, Checkly, UptimeRobot usw.)
- Klicken Sie auf „One Click Extract“ – Thunderbits KI liest die Seite, erkennt ihre Struktur und füllt die Tabelle in einem Durchgang
- Nutzen Sie das Scraping von Unterseiten, um Preis-, Feature- und Doku-Seiten jedes Anbieters abzurufen
- Exportieren Sie nach Google Sheets, Excel, Airtable, Notion oder CSV
Für API-first-Teams ist der API-Workflow genauso direkt:
- Holen Sie sich einen kostenlosen API-Key von Thunderbit
- Rufen Sie den Distill-Endpunkt auf, um sauberes Markdown von jeder öffentlichen Seite zu erhalten
- Rufen Sie den Extract-Endpunkt mit Schema-Beschreibungen für strukturiertes JSON auf
- Nutzen Sie Batch-Endpunkte und Webhooks für größere URL-Listen
- Schicken Sie die Ausgabe in Ihre App, Tabelle, Ihr Warehouse, die Vector-DB oder den Monitoring-Workflow
Bei einem Vergleich von 10+ Anbietern kann das manuelle Kopieren leicht 2–3 Stunden dauern, wenn Preis-Unterseiten, Doku und Integrationen mitgerechnet werden. Thunderbit hat unseren ersten Extraktionsdurchlauf auf ungefähr 15–30 Minuten verkürzt; die restliche Zeit ging für Prüfung und Entscheidung drauf. Wenn Ihr Ops-, Procurement-, Research- oder AI-Produktteam unter Zeitdruck Tools bewertet, ist das ein praktischer Shortcut. Mehr dazu finden Sie in unserem Leitfaden Web Scraping ohne Code, unter Thunderbit API-Preise oder auf unserem YouTube-Kanal mit Walkthroughs.
Wie Sie das beste API-Monitoring-Tool für Ihr Team auswählen
Das „beste“ API-Monitoring-Tool hängt von Teamgröße, technischem Niveau, Budget und davon ab, wie ein Ausfall Ihr Produkt trifft.
Ein Solo-Dev braucht kein Splunk. Ein reguliertes Unternehmen sollte sich nicht auf ein Cron-Job-Script verlassen. Ein API-Produktteam braucht vielleicht eher Moesif-artige Kundenanalysen als einfache Uptime-Pings. Ein E-Commerce-Team sollte kritische Pfade wie Login, Suche, In den Warenkorb, Checkout und Zahlungsautorisierung priorisieren. Ein AI- oder Datenprodukt-Team braucht möglicherweise zuerst Thunderbit-ähnliche Webdatenextraktion, bevor es umfassende Observability benötigt.
Drei Prinzipien haben sich in meiner gesamten Recherche bestätigt:
- Tool an den Use Case anpassen. Die Schnellwahl-Tabelle ist genau dafür da – starte dort.
- Alert-Qualität vor Alert-Menge stellen. Wenn Ihr Team Alerts ignoriert, haben Sie kein Monitoring. Sie haben Rauschen.
- Setup-Geschwindigkeit nicht unterschätzen. Ein Monitor, der heute live geht und vertrauenswürdige Alerts sendet, ist besser als ein perfekter Plattformplan, der den Checkout noch einen Monat unüberwacht lässt.
Wenn Sie mehrere Tools gleichzeitig vergleichen und die Recherche beschleunigen wollen, probieren Sie Thunderbit aus, um Anbieterdaten gesammelt in eine einzige Tabelle zu extrahieren. Wenn Sie ein API-Produkt, eine RAG-Pipeline, einen AI-Agenten oder einen Market-Intelligence-Workflow bauen, der saubere Webdaten braucht, starten Sie mit Thunderbit Open API. Es wählt das Monitoring-Tool nicht für Sie aus – aber es bringt Sie schneller zur Entscheidung und kann Ihrem eigenen Produkt eine verlässliche Webdaten-Schicht geben.
FAQs zu den besten API-Monitoring-Tools
Was ist 2026 das beste kostenlose API-Monitoring-Tool?
Für einfache SaaS-Nutzung bietet UptimeRobot 50 kostenlose Monitore im 5-Minuten-Intervall, ohne Kreditkarte. Für self-hosted Kontrolle ist Uptime Kuma Open Source, unbegrenzt und hat eine saubere UI mit über 90 Benachrichtigungsdiensten. Für Teams mit tieferem Metrikbedarf und technischer Erfahrung ist Prometheus + Grafana + Alertmanager der beste Open-Source-Stack – allerdings dauert das Setup Stunden statt Minuten.
Wenn Ihr Ziel nicht Uptime-Monitoring, sondern Webdatenextraktion per API ist, bietet Thunderbit Open API einen Free-Tier mit 600 einmaligen API-Units. Das reicht, um Page-to-Markdown-Distillation oder schema-basierte JSON-Extraktion vor dem Skalieren zu testen.
Was ist der Unterschied zwischen API-Monitoring und APM?
API-Monitoring prüft Verfügbarkeit, Antwortzeit, Fehler und Korrektheit von außen – also so, wie Nutzer oder Integrationen es erleben. APM (Application Performance Monitoring) geht tiefer in die Anwendung hinein: Code-Traces, Datenbankabfragen, Laufzeitfehler, Queue-Latenz und Service-Abhängigkeiten. Tools wie Datadog und New Relic bieten beides; UptimeRobot und Uptime Kuma fokussieren sich auf externe Uptime-Checks.
Thunderbit Open API ist anders als beides: Es ist eine Webdatenextraktions-API. Sie hilft Ihnen, externe Websites in Markdown oder strukturiertes JSON zu verwandeln – nützlich für LLM-Apps, Research-Workflows, Pricing-Intelligence und Datenpipelines.
Wie oft sollte ich meine APIs überwachen?
Produktive, umsatzkritische APIs wie Checkout, Auth oder Payments sollten typischerweise jede Minute geprüft werden. Interne oder wenig frequentierte APIs können oft alle 5 Minuten überwacht werden. Aber Frequenz allein reicht nicht – nutze Retries, mehrere Regionen und aussagekräftige Assertions, damit jeder Check schnell und vertrauenswürdig ist. Ein 1-Minuten-Check mit vielen False Positives ist schlechter als ein 5-Minuten-Check, dem Sie vertrauen können.
Bei Webdaten-Extraktions-Workflows hängt die Frequenz davon ab, wie oft sich die Quelle ändert. Preisseiten brauchen möglicherweise tägliche oder wöchentliche Extraktion. Schnelllebige Bestands-, Reise- oder Marktplatzdaten brauchen stündliche oder noch häufigere Aktualisierung. Thunderbits Batch-API und Webhooks sind hilfreich, wenn Sie viele URLs nach Plan verarbeiten müssen.
Kann ich APIs überwachen, ohne Code zu schreiben?
Ja. UptimeRobot, Better Stack und Uptime Kuma lassen sich komplett über GUIs nutzen. Checkly unterstützt sowohl GUI- als auch Code-Setup. Postman arbeitet mit Collections. Prometheus/Grafana erfordert meist YAML und PromQL. Datadog und New Relic können mit geführtem Setup starten, werden aber mit tieferer Instrumentierung deutlich mächtiger.
Wenn Sie Website-Daten ohne Code extrahieren wollen, ist Thunderbits Chrome Extension der No-Code-Weg. Wenn Sie denselben Workflow aus einer Anwendung heraus automatisieren wollen, bietet Thunderbit Open API Entwicklern Distill-, Extract- und Batch-Endpunkte.
Wie reduziere ich Alert Fatigue beim API-Monitoring?
Wählen Sie Tools mit smarter Alerting-Logik: Anomalieerkennung (Datadog, New Relic), Retries vor dem Auslösen (Checkly), Verhaltensanomalien (Moesif) oder Gruppierung/Stummschaltung (Prometheus Alertmanager). Starten Sie mit weniger, aber verlässlicheren Alerts, die auf Nutzerimpact fokussieren. Nutzen Sie SLO-Burn-Rate-Alerts statt statischer Schwellenwerte, deduplizieren Sie systemübergreifend, routen Sie nach Zuständigkeit und messen Sie die Handlungsfähigkeit – wenn weniger als 20 % Ihrer Alerts zu echter Aktion führen, reduzieren Sie zuerst das Rauschen.
Thunderbit Open API für Webdatenextraktion testen Get Started Free
Mehr erfahren



