Snadný ESPN scraper













Získejte data z ESPN bez zbytečných komplikací
Thunderbit vám umožní snadno scrapovat sportovní data z ESPN během několika kliknutí.
ESPN vytěžíte na dvě kliknutí
Zapomeňte na kód i složité nastavování. S Thunderbit jednoduše zvýrazníte data, která potřebujete — jméno sportovce, skóre, datum zápasu, libovolnou statistiku — a za dvě kliknutí je získáte. Žádné CSS selektory, žádná složitá API. Prostě vyberete, kliknete a máte data z ESPN.
Čistá ESPN data okamžitě
Surová data z ESPN bývají nejednotná a těžko použitelná. Thunderbit je při scrapování automaticky čistí a strukturuje — statistiky sportovců, názvy týmů, stav zápasu — takže výstup je připravený k analýze nebo reportingu hned po dokončení extrakce. Ruční úpravy nejsou potřeba.
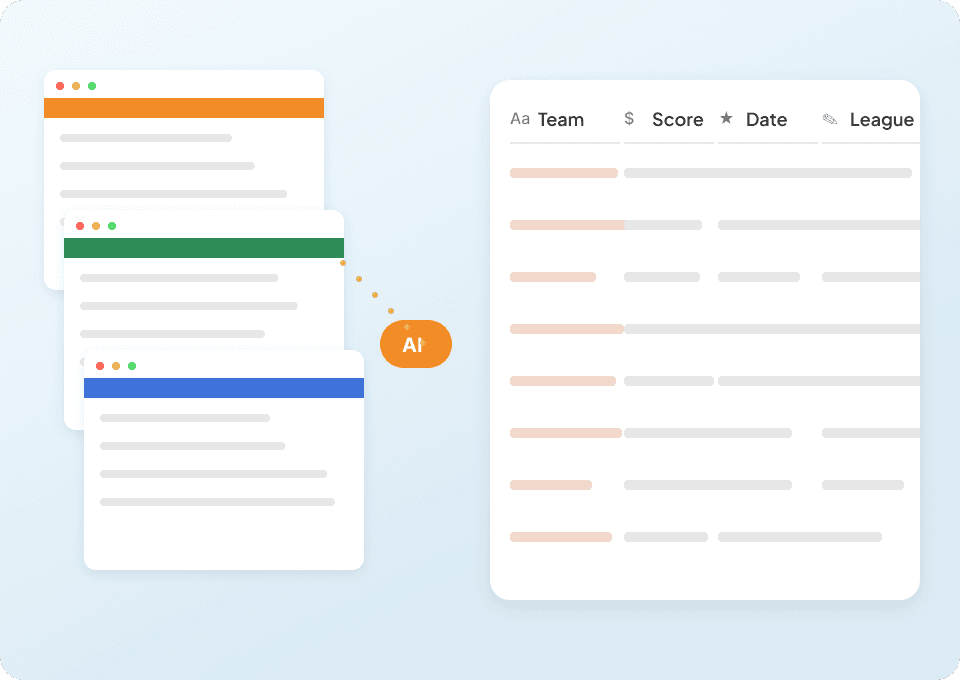
Scrape více ESPN stránek najednou
Scrapovat ESPN stránku po stránce zbytečně bere hodiny, které nemáte. Thunderbit automaticky navštěvuje a vytěžuje data ze stovek ESPN stránek v jednom běhu a sleduje odkazy na týmové stránky, profily hráčů nebo detailní rozbory jednotlivých zápasů. Zadáte jen počáteční URL adresy a Thunderbit se postará o zbytek.
V čem se Thunderbit liší od tradičních ESPN scraperů?
Získejte sportovní data bez námahy, i když ESPN bez varování změní rozložení.
Tradiční scrapery
Starý způsob práceThunderbit AI
Chytřejší přístup
Často kladené otázky
Související případy použití
Prozkoumej další případy použití web scraperu Thunderbit.

Investing.com scraper
Získejte akciová data — symboly, ceny, objem a tržní kapitalizaci — z Investing.com během 2 kliknutí a poté je exportujte přímo do Google Sheets, Notion nebo Excelu. Otevřete libovolnou stránku Investing.com a nechte AI, aby za vás rozpoznala potřebná pole.
Zjistit více ->
PubMed Scraper
PubMed Scraper od Thunderbit vám s pomocí AI pomůže extrahovat strukturovaná data z výsledků vyhledávání i stránek článků na PubMedu. Získáte trendy lékařský výzkum, důkazy z klinických studií, abstrakty, autory, afiliace, data publikace i odkazy a vše pak můžete exportovat do Excelu, Google Sheets, Airtable nebo Notion.
Zjistit více ->
Substack scraper
Získejte počet odběratelů na Substacku, názvy článků a popisy publikací na 2 kliknutí — a poté vše exportujte do Excelu, Google Sheets nebo Notion. Není potřeba žádný kód; o strukturování se postará AI od Thunderbit.
Zjistit více ->
Extraktor článků pro text, autory a data
Shromažďujte titulky, jména autorů, data, shrnutí, hlavní text, odkazy i média z veřejných článkových stránek. Udržte údaje o každém článku pohromadě v jednom přehledném řádku, i když zpravodajské weby používají odlišná rozložení.
Zjistit více ->
News Scraper: Propojte titulky s podrobnostmi celého článku
Získejte titulky z tématických, sekčních nebo vyhledávacích stránek a pak otevřete odkazy na články, abyste načetli viditelné údaje o autorovi, datu vydání, souhrnu, sekci a zdrojové URL. Před spuštěním jednoduše řekněte Thunderbit, které detaily článku jsou pro vás důležité.
Zjistit více ->Připraven zrychlit extrakci dat?
Přidej se k více než 200 000 profesionálům, kteří už Thunderbit používají k automatizaci svých web scraping workflow.
Zkušební verze zdarma nabízí neomezené kredity pro 8 webových stránek.



