PubMed Scraper od Thunderbit vám s pomocí AI pomůže proměnit stránky PubMedu v přehledné a strukturované datové sady. Můžete vytáhnout trendy lékařský výzkum, důkazy z klinických studií, abstrakty, autory, afiliace, data publikace, PMID i odkazy na články a následně data exportovat do Excelu, Google Sheets, Airtable nebo Notion. Stačí otevřít PubMed v Chromu, nechat AI navrhnout nejlepší sloupce a spustit scraping.
🧬 Co je PubMed Scraper
PubMed Scraper je AI Web Scraper vytvořený pro PubMed | US National Library of Medicine. S Thunderbit (AI web scraperem jako rozšířením do Chrome) můžete otevřít libovolnou výsledkovou stránku na PubMedu, kliknout na AI Suggest Columns a potom na Scrape a získat strukturovaná data bez psaní kódu.
🔎 Co můžete na PubMedu scrapovat
PubMed obsahuje spoustu cenných biomedicínských metadat, ale ne vždy jsou připravená k analýze. AI Web Scraper od Thunderbitu (https://thunderbit.com/) vám pomůže data z výsledků PubMedu sesbírat, uspořádat a doplnit o podrobnosti na úrovni článku pomocí Subpage Scraping (otevření jednotlivých článků a doplnění polí jako abstrakt, afiliace, DOI a další).
Níže najdete dva běžné workflow, která zvládnete během několika minut.
📈 Scrape PubMed Trending Medical Research Monitoring
Tento postup využijete pro sledování toho, co právě trenduje v lékařském výzkumu na stránce PubMed Trending. Hodí se pro průběžný monitoring, interní přehledy, sledování publikací konkurence nebo pro napojení na pipeline pro literární rešerši.
Ukázková cílová stránka: PubMed Trending
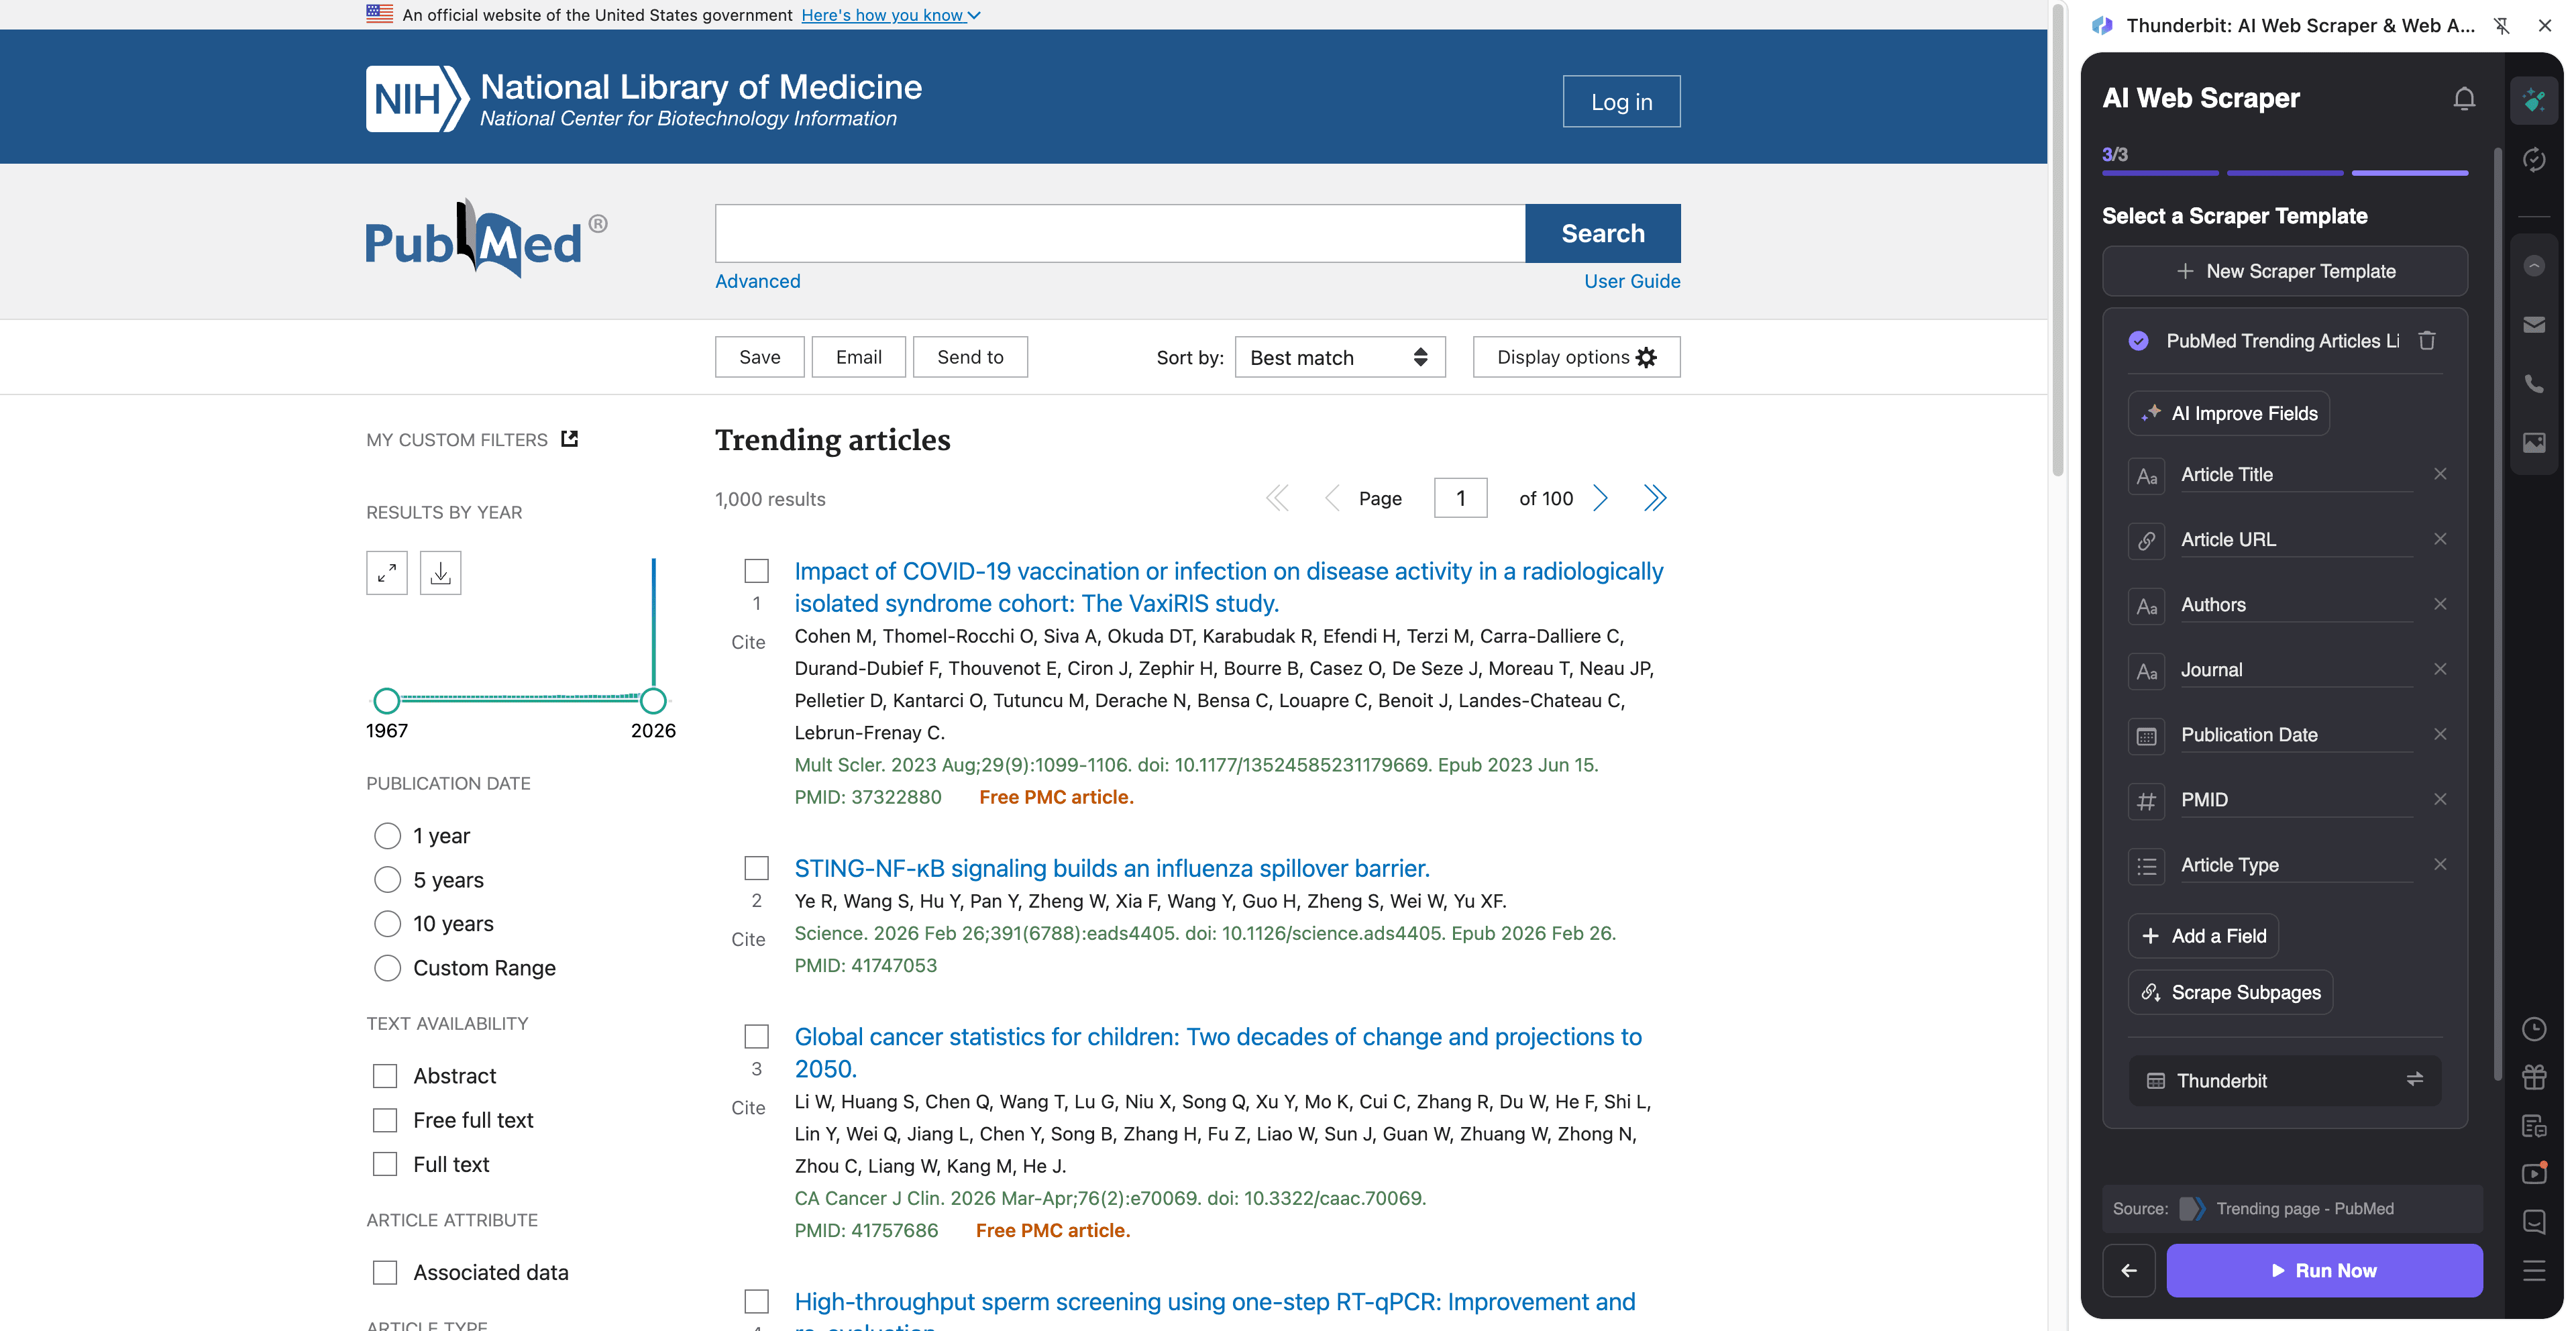
Kroky:
- Stáhněte si Thunderbit Chrome Extension a zaregistrujte si účet.
- Přejděte na cílovou stránku, například: PubMed Trending.
- Klikněte na AI Suggest Columns a nechte AI doporučit nejlepší názvy sloupců i datové typy.
- Klikněte na Scrape pro získání dat a poté je exportujte do Excelu, Google Sheets, Airtable nebo Notion.
Názvy sloupců
| Sloupec | Popis |
|---|---|
| 🧾 Název článku | Název trendujícího článku na PubMedu. |
| 🔗 URL článku | Přímý odkaz na záznam v PubMedu. |
| 🆔 PMID | Identifikátor PubMedu pro daný záznam (užitečný jako stabilní klíč). |
| 🏛️ Časopis | Název časopisu, ve kterém byl článek publikován. |
| 📅 Datum publikace | Datum publikace zobrazené v seznamu. |
| ✍️ Autoři | Řetězec autorů zobrazený na kartě výsledku. |
| 🧪 Typ článku | Typ publikace, pokud je k dispozici (např. Review, Clinical Trial). |
| 🏷️ Klíčová slova / témata | Viditelné štítky témat nebo klíčová slova v seznamu (pokud jsou uvedena). |
| 📝 Ukázka / shrnutí | Krátký úryvek zobrazený v seznamu (pokud je k dispozici). |
| 🧷 DOI | DOI, pokud je dostupné (často se nejlépe získá přes subpage scraping). |
| 🧑🔬 Afiliace | Afiliace autorů (obvykle se extrahují přes subpage scraping). |
| 📄 Abstrakt | Text abstraktu (obvykle se extrahuje přes subpage scraping). |
🧫 Scrape PubMed Clinical Trial Evidence Extraction
Tento postup použijete pro získání důkazů souvisejících s klinickými studiemi z výsledků vyhledávání na PubMedu a následné doplnění každého řádku po otevření stránky článku o abstrakt, signály klinické studie a metadata potřebná pro revizi.
Ukázková cílová stránka: Clinical trial search results
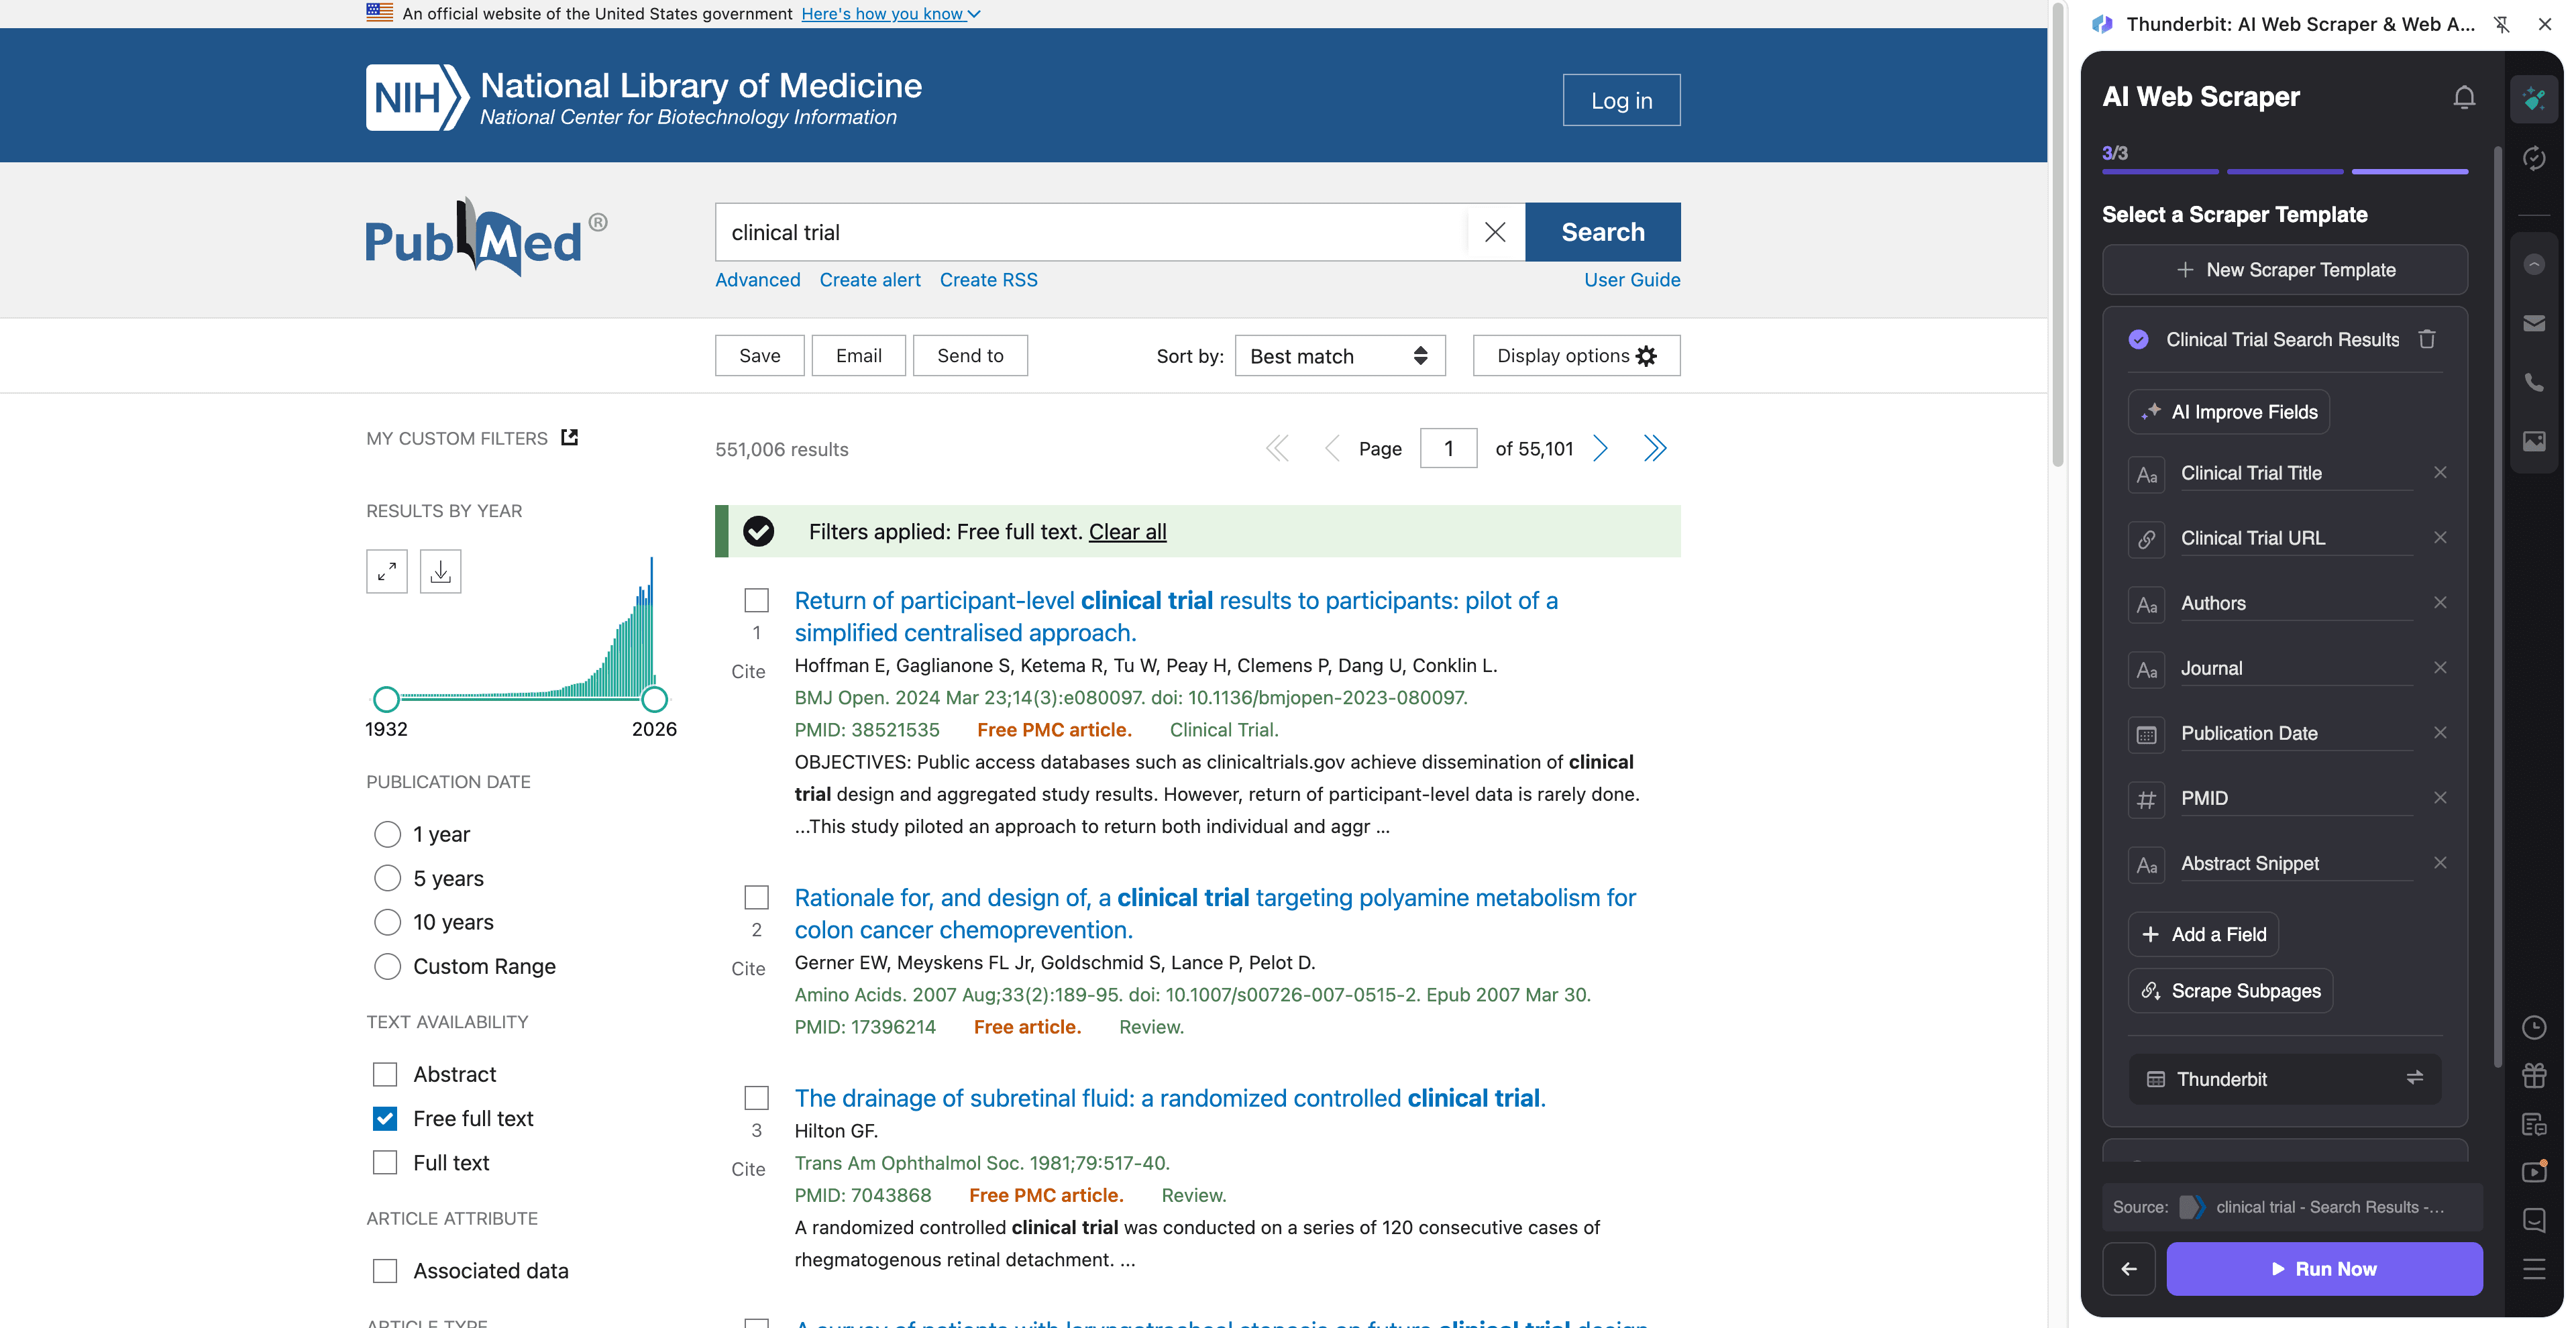
Kroky:
- Stáhněte si Thunderbit Chrome Extension a zaregistrujte si účet.
- Přejděte na cílovou stránku, například: Clinical trial search results.
- Klikněte na AI Suggest Columns a nechte vygenerovat doporučená pole (můžete je přejmenovat nebo přidat vlastní).
- Klikněte na Scrape pro sběr výsledků a poté použijte Scrape Subpages, abyste každý řádek doplnili o abstrakt, afiliace, DOI a další údaje.
Názvy sloupců
| Sloupec | Popis |
|---|---|
| 🧾 Název | Název článku z výsledků vyhledávání. |
| 🔗 PubMed URL | Odkaz na stránku článku na PubMedu pro rozšíření o subpage data. |
| 🆔 PMID | Identifikátor PubMedu pro deduplikaci a reference. |
| 🧑⚕️ Autoři | Autoři uvedení ve výpisu výsledku. |
| 🏛️ Časopis | Název časopisu a citační informace zobrazené ve výsledcích. |
| 📅 Datum | Datum publikace (nebo datum ePub), které je v seznamu uvedeno. |
| 🧪 Typ publikace | Signály jako Clinical Trial, Randomized Controlled Trial, Meta-Analysis (často přehlednější až na stránce článku). |
| 🧾 Abstrakt | Plný text abstraktu (nejlépe přes subpage scraping). |
| 🧬 MeSH termíny | Medical Subject Headings, pokud jsou dostupné (často na stránce článku). |
| 🧷 DOI | DOI pro odkazování na stránky vydavatele a nástroje pro správu citací. |
| 🏥 Afiliace | Afiliace autorů pro analýzu institucí (subpage scraping). |
| 🌍 Země / instituce | Parsováno z afiliací pomocí Field AI Prompts (volitelné). |
| 🔍 Klíčová slova klinické studie | AI štítky jako „randomized“, „double-blind“, „placebo“ (volitelné přes Field AI Prompt). |
| 📎 Odkazy na plný text | Odkazy na vydavatele nebo volně dostupný plný text, pokud jsou k dispozici. |
🎯 Proč používat PubMed Tool
Scraping PubMedu je hlavně o rychlosti, konzistenci a o tom, aby byla výzkumná data skutečně použitelná v pracovním procesu. Místo kopírování citací jednu po druhé si můžete vytvořit strukturovanou databázi, ve které lze snadno filtrovat, značkovat a sdílet.
Nejčastější důvody, proč týmy scrapují PubMed:
- Medical affairs a pharma týmy: Sledují nové publikace v dané terapeutické oblasti, monitorují konkurenční studie a vytvářejí důkazové tabulky pro interní revize.
- Biotech a klinické operace: Shromažďují publikace ke klinickým studiím, mapují instituce a řešitele studií a udržují živou bibliografii.
- Marketing a obsahové týmy ve zdravotnictví: Identifikují trendy, prestižní časopisy a nově se objevující klíčová slova pro plánování obsahu.
- Akademičtí výzkumníci a knihovníci: Vytvářejí datové sady pro literární rešerše, deduplikují podle PMID a exportují do tabulek pro screening.
- Datové týmy: Připravují strukturované podklady pro následnou analytiku, dashboardy nebo interní znalostní báze.
Thunderbit je obzvlášť užitečný ve chvíli, kdy nestačí jen seznam výsledků. Pomocí Subpage Scraping můžete ve velkém získat abstrakty, afiliace, DOI, MeSH termíny i odkazy na plné texty.
🧩 Jak používat rozšíření do Chrome pro PubMed
- Nainstalujte si Thunderbit Chrome Extension: Získejte ji v Chrome Web Store a vytvořte si účet.
- Otevřete stránku PubMedu: Otevřete PubMed, stránku Trending jako Trending nebo dotaz jako clinical trial results.
- Zapněte AI-Powered Scraper: Klikněte na AI Suggest Columns, nechte vygenerovat pole, upravte datové typy (text/date/url) a přidejte volitelné Field AI Prompts (pro označování, formátování nebo extrakci signálů klinických studií).
- Spusťte scraping a export: Klikněte na Scrape. Pokud potřebujete abstrakty/afiliace/MeSH, spusťte Scrape Subpages pro doplnění každého řádku a poté exportujte do Excelu, Google Sheets, Airtable nebo Notion.
Užitečné čtení, pokud stavíte opakovatelný workflow:
- How to Scrape Any Website Using AI
- What Is Data Scraping and How to Do It in 2025
- How to Scrape Website Data into Excel using AI
- What Is List Crawling and How to Do It Using AI
💳 Ceny pro PubMed
Thunderbit používá jednoduchý kreditní systém:
- 1 kredit = 1 výstupní řádek ve vaší výsledkové tabulce (například jeden záznam z PubMedu).
- Export dat je zdarma: stáhněte CSV/JSON nebo pošlete data do Excelu, Google Sheets, Airtable nebo Notion.
Můžete začít s:
- Free tier: scrapujte 6 stránek měsíčně (na Free je limit založený na stránkách).
- Free trial: scrapujte 10 stránek zdarma, což je ideální pro otestování trendových stránek PubMedu i několika stránek s výsledky klinických studií.
Pokud scrapujete pravidelně (týdenní monitoring, aktualizace důkazů nebo rozsáhlé dotazy), placené plány vám dají více kreditů. Roční plán bývá cenově výhodnější, protože zahrnuje slevu oproti měsíčnímu placení.
Možnosti si můžete prohlédnout na Thunderbit Pricing.
❓ FAQ
-
Co je AI Powered PubMed Scraper?
AI Powered PubMed Scraper je workflow v Thunderbitu, které extrahuje strukturovaná data z výsledků vyhledávání i stránek článků na PubMedu. Pomocí AI můžete navrhnout sloupce, scrapovat seznamy a rozšířit každý řádek otevřením detailu článku pro abstrakty, afiliace, DOI a další údaje. -
Co je Thunderbit?
Thunderbit je AI web scraper jako rozšíření do Chrome určený pro firemní a výzkumné workflow, kde potřebujete strukturovaná data z webů. Pomáhá rychle extrahovat, značkovat a exportovat data bez nutnosti vytvářet nebo udržovat scrapingové skripty. -
Lze scrapovat PubMed Trending stránky i běžné výsledky vyhledávání?
Ano. Můžete scrapovat stránku PubMed Trending, standardní klíčová slova i filtrované výsledkové stránky (například dotazy zaměřené na klinické studie). AI v Thunderbitu se přizpůsobuje různým rozložením tím, že čte stránku a navrhuje pole. -
Umí Thunderbit extrahovat abstrakty, afiliace a MeSH termíny?
Ano, a právě tady nejvíc pomáhá Subpage Scraping. Nejprve můžete scrapovat seznam výsledků a poté nechat Thunderbit otevřít každou stránku záznamu na PubMedu a vytáhnout text abstraktu, afiliace, MeSH termíny, DOI i další metadata do stejné tabulky. -
Jak funguje stránkování a infinite scroll na PubMedu?
Thunderbit podporuje scraping přes stránkování, včetně navigace typu „další stránka“. Pokud PubMed změní způsob načítání výsledků, AI extrakce je odolnější než pevně dané selektory, protože při každém spuštění znovu načítá strukturu stránky. -
Do jakých formátů lze data z PubMedu exportovat?
Můžete exportovat do CSV nebo JSON, případně poslat datovou sadu do Excelu, Google Sheets, Airtable nebo Notion. To se hodí pro screening, evidence tabulky, dashboardy i sdílení s kolegy. -
Kolik záznamů z PubMedu mohu scrapovat zdarma?
Ve Free tieru můžete scrapovat 6 stránek měsíčně, což často stačí pro menší monitoring. V rámci free trialu můžete zdarma scrapovat 10 stránek a ověřit si nastavení sloupců i strategii doplňování přes subpages. -
Mohu si upravit sloupce podle konkrétních potřeb evidence extraction?
Ano. Můžete přejmenovat sloupce, nastavit datové typy (text/date/url) a přidat Field AI Prompts pro extrakci nebo označení informací, jako jsou klíčová slova designu studie, populace, intervence, komparátor, výstupy nebo země z afiliací. Díky tomu se dostanete od prostého scrapingu ke strukturované přípravě důkazů. -
Je v pořádku scrapovat PubMed?
PubMed je veřejný zdroj a mnoho týmů sbírá bibliografická metadata pro výzkum a analýzu. Přesto je potřeba dodržovat platné zákony, respektovat podmínky webu a používat odpovědné scrapingové postupy, zejména při velkých a častých úlohách.
📚 Další informace
- Získejte rozšíření: Thunderbit Chrome Extension Download Page
- Projděte si návody na Thunderbit Blog
- Naučte se základy: What Is Data Scraping and How to Do It in 2025
- Vytvářejte list workflow: What Is List Crawling and How to Do It Using AI
- Exportujte do tabulek: How to Scrape Website Data into Excel using AI
- Pokud v research ops scrapujete i PDF: How to Scrape Data from PDF using AI