Extraktor článků pro text, autory a data













Sbírejte data z článků napříč měnícími se rozloženími
Čtěte pole podle významu, plánujte opakované běhy a používejte stejný postup na veřejných webech.
Přizpůsobení při změně rozložení článků
Thunderbit čte viditelné titulky, byline, data, shrnutí i text článku podle významu. Když zpravodajský web změní rozvržení, workflow je méně závislý na pevných pozicích prvků.
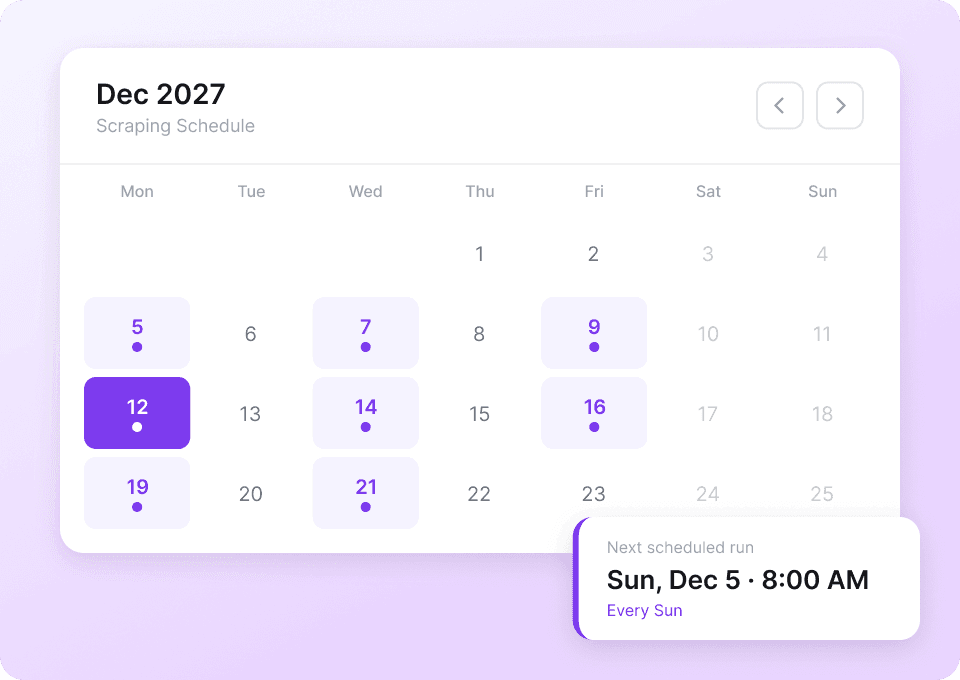
Spouštějte sběr článků podle plánu
Nastavte opakované spuštění pro veřejnou zpravodajskou, blogovou nebo sekční stránku, ke které se vracíte. Thunderbit může získat nejnovější viditelné články a poslat nové řádky do vybraného souboru nebo aplikace.
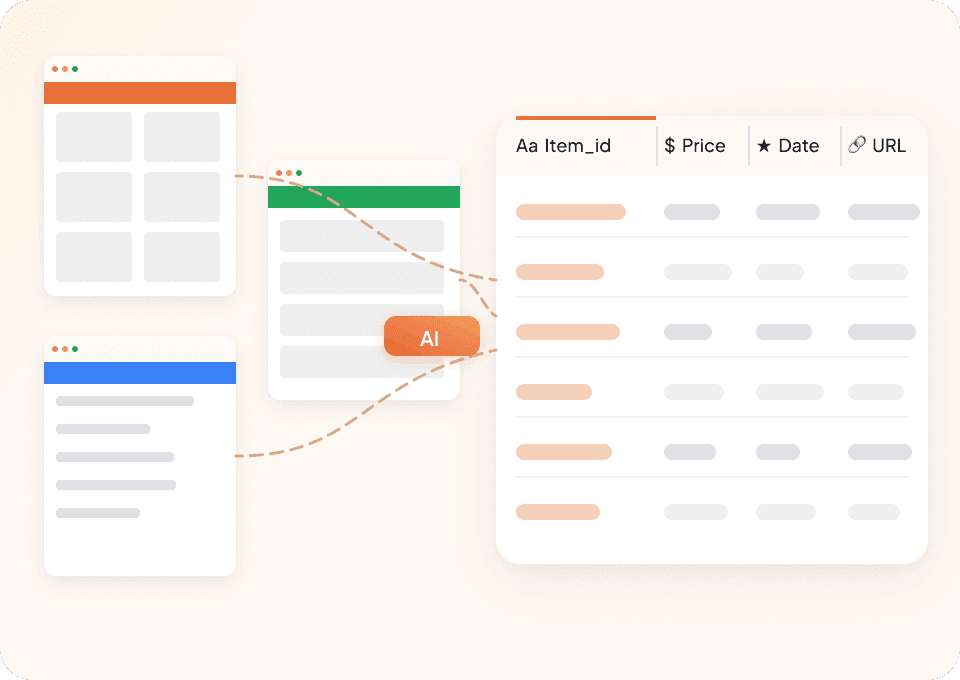
Použijte jeden workflow pro libovolný veřejný web
Stejný postup funguje na jakémkoli veřejném webu s články. Stačí pojmenovat pole, která potřebujete, a Thunderbit je vloží do stejných sloupců u každé stránky.
Jeden workflow pro články napříč různými rozloženími stránek
Pevné selektory sledují pozice. Thunderbit AI vyhledává pole článku, která jste pojmenovali.
Mapa selektorů pro každého vydavatele
Každý design stránky vyžaduje samostatnou údržbuPole článku uspořádaná Thunderbitem
Požadovaný záznam zůstává konzistentníJaká data lze z článku extrahovat?
Vyberte si z 30 viditelných polí pro obsah, autora, vydavatele, datum, odkazy, témata, média a metadata stránky.
- Titulek
- Alternativní titulek
- Hlavní text článku
- Shrnutí článku
- Jméno autora
- URL autora
- Organizace autora
- Název vydavatele
- URL vydavatele
- Datum publikování
- Datum úpravy
- Sekce článku
- Klíčová slova
- Počet slov
- Jazyk
- Kanonická URL
- URL hlavního entity
- URL obrázku
- Popisek obrázku
- Zdroj obrázku
- URL videa
- URL audia
- Místo a datum
- Témata o
- Zmínky
- Odkazy na citace
- URL licence
- Odkazy na související články
- Název stránky
- Meta popis
Hear editors and research teams discuss article data
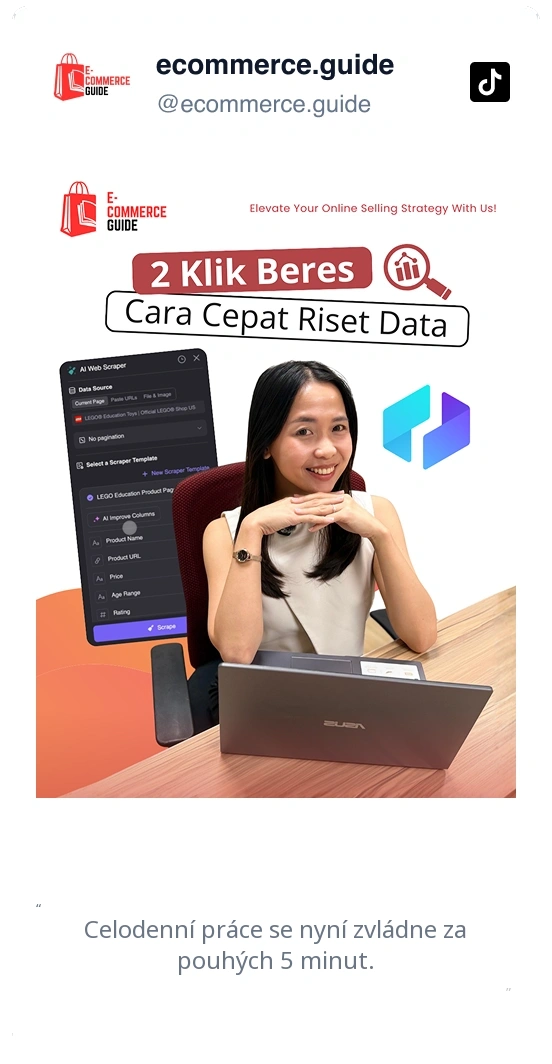
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.

Dotazy ke sběru veřejných článků
Zpravodajské weby používají různá rozložení i prvky stránky, takže výsledná pole závisí na konkrétní zachycené stránce.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Investing.com scraper
Získejte akciová data — symboly, ceny, objem a tržní kapitalizaci — z Investing.com během 2 kliknutí a poté je exportujte přímo do Google Sheets, Notion nebo Excelu. Otevřete libovolnou stránku Investing.com a nechte AI, aby za vás rozpoznala potřebná pole.
Zjistit více ->
Snadný ESPN scraper
S Thunderbit AI vytěžíte jména sportovců, termíny zápasů a výsledky z ESPN během 2 kliknutí — bez kódu a bez nastavování. Data exportujete přímo do Excelu, Google Sheets nebo Notion a můžete je hned využít.
Zjistit více ->
PubMed Scraper
PubMed Scraper od Thunderbit vám s pomocí AI pomůže extrahovat strukturovaná data z výsledků vyhledávání i stránek článků na PubMedu. Získáte trendy lékařský výzkum, důkazy z klinických studií, abstrakty, autory, afiliace, data publikace i odkazy a vše pak můžete exportovat do Excelu, Google Sheets, Airtable nebo Notion.
Zjistit více ->
Substack scraper
Získejte počet odběratelů na Substacku, názvy článků a popisy publikací na 2 kliknutí — a poté vše exportujte do Excelu, Google Sheets nebo Notion. Není potřeba žádný kód; o strukturování se postará AI od Thunderbit.
Zjistit více ->
News Scraper: Propojte titulky s podrobnostmi celého článku
Získejte titulky z tématických, sekčních nebo vyhledávacích stránek a pak otevřete odkazy na články, abyste načetli viditelné údaje o autorovi, datu vydání, souhrnu, sekci a zdrojové URL. Před spuštěním jednoduše řekněte Thunderbit, které detaily článku jsou pro vás důležité.
Zjistit více ->Připraven zrychlit extrakci dat?
Přidej se k více než 200 000 profesionálům, kteří už Thunderbit používají k automatizaci svých web scraping workflow.
Zkušební verze zdarma nabízí neomezené kredity pro 8 webových stránek.



