
Někde kolem padesátého kopírování názvu pracovní pozice z Indeed do tabulky jsem začal přemýšlet o svých kariérních rozhodnutích. Pokud jste se někdy pokusili programově vytáhnout strukturovaná data z Indeed, pointu už znáte: chyba 403 není chyba — je to součást obranného systému Indeed.
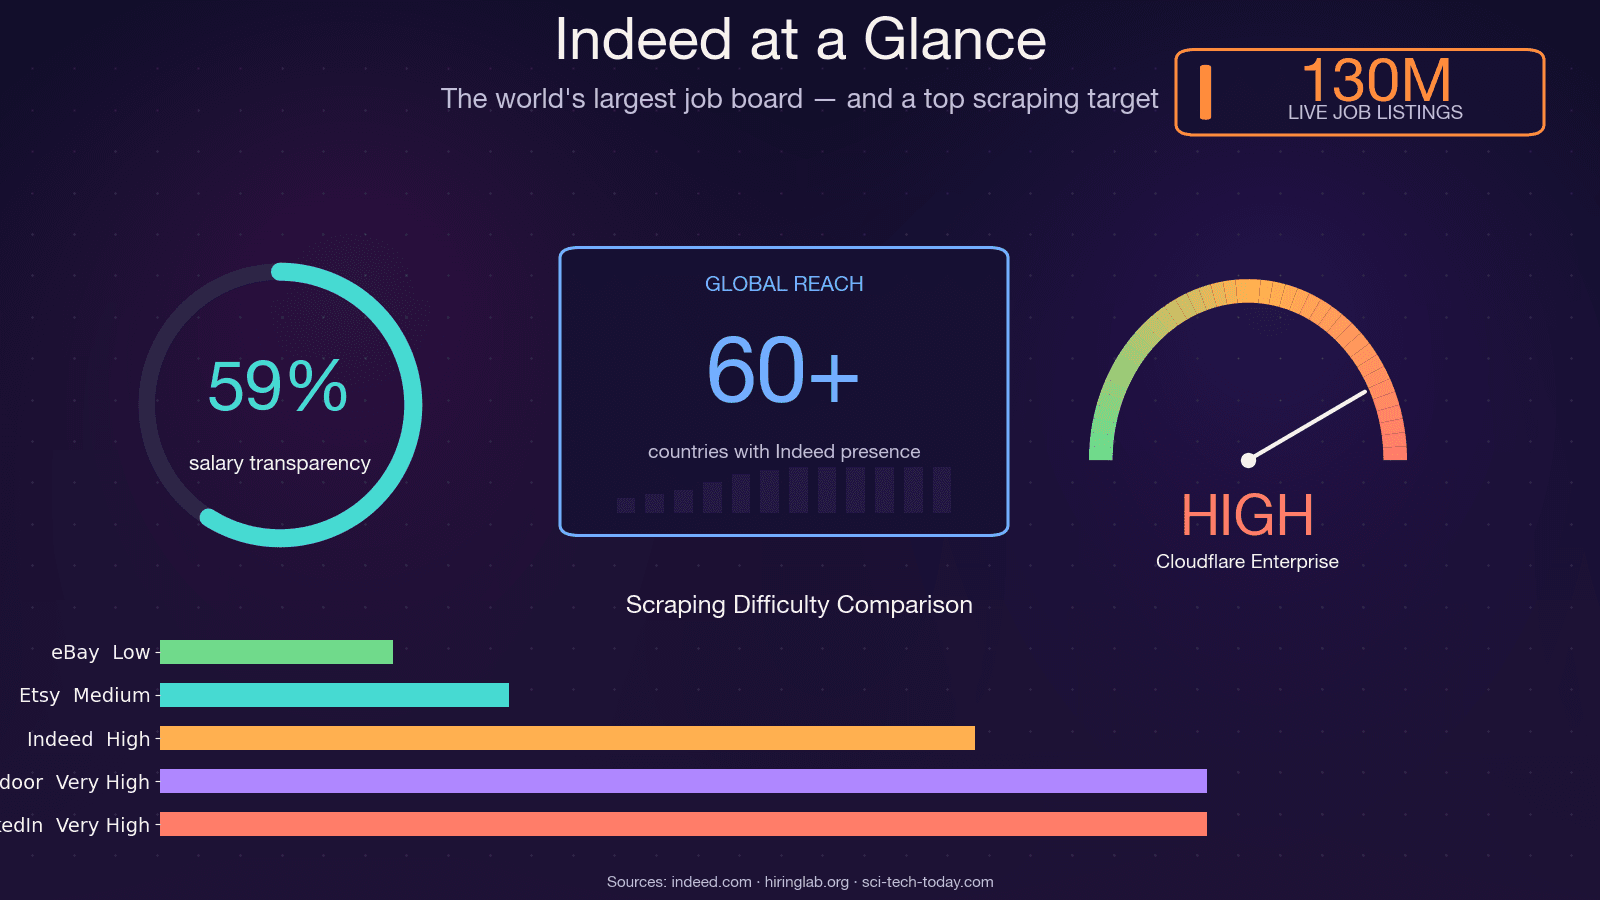
Indeed je největší pracovní portál na světě, s přibližně 350 miliony unikátních návštěvníků měsíčně, 130 miliony pracovních nabídek v daný okamžik a působností ve více než 60 zemích. To z něj dělá jeden z nejbohatších zdrojů dat o trhu práce na planetě — a zároveň jeden z nejtěžších cílů pro scraping. Open-source scraper JobFunnel (tisíce hvězdiček na GitHubu) byl dokonce v prosinci 2025 uzavřen jeho správcem po letech prohrávání závodu s anti-bot ochranou. Slova správce mluví za vše: „Všichni uživatelé dokážou vyextrahovat část nabídek, ale velmi rychle narazí na captcha a scraping selže, takže nezískají žádné nabídky.“ Další přispěvatel uvedl, že CAPTCHA dostal už při prvním požadavku. Takže ano — tohle není triviální cíl. V tomhle průvodci projdu všechny praktické způsoby, jak scrapovat Indeed pomocí Pythonu, ukážu vám, jak skutečně projít 403 nástrahami, a — pro ty, kdo radši přeskočí celé ladění — předvedu i no-code alternativu s Thunderbit.
Co znamená scrapovat Indeed pomocí Pythonu?
Web scraping je v jádru automatizované získávání strukturovaných dat z webových stránek. Když mluvíme o scrapování Indeed pomocí Pythonu, myslíme tím napsání skriptu, který navštíví výsledky hledání a detail pracovní nabídky na Indeed, přečte podkladové HTML (nebo vložená data) a vytáhne pole jako název pozice, firma, lokalita, mzda a popis do použitelného formátu — CSV, databáze nebo Google Sheets.
Typické Python knihovny jsou Requests (pro HTTP volání), BeautifulSoup (pro parsování HTML) a Selenium nebo Playwright (pro automatizaci prohlížeče). Jenže Indeed není jednoduchý statický web. Je to hybrid: serverem renderované HTML s vloženým JSON stavovým blobem a před Cloudflare Bot Management. To znamená, že scraper musí zvládnout JavaScriptem generovaný obsah, rotující názvy CSS tříd a agresivní anti-bot ochranu — a to ještě předtím, než rozparsujete jediný název pozice.
V roce 2026 navíc neexistuje žádné oficiální bezplatné read-only API pro Indeed. Staré Publisher Jobs API bylo kolem roku 2020 zrušeno a to, co zůstalo, je jen pro zaměstnavatele (Job Sync, Sponsored Jobs). Takže scraping nebo placený poskytovatel dat jsou v praxi jediné reálné možnosti.
Proč scrapovat data z Indeed?
Obchodní důvod je jednoduchý: ruční procházení tisíců nabídek je nepraktické a data uvnitř nich mají skutečnou hodnotu.
| Případ použití | Kdo z toho těží | Příklad |
|---|---|---|
| Generování leadů | Obchodní a recruiting týmy | Vytvoření seznamů firem, které nabírají, včetně kontaktních údajů |
| Průzkum trhu práce | Analytici, HR týmy | Identifikace trendových dovedností a mzdových benchmarků podle regionu |
| Konkurenční intelligence | Zaměstnavatelé, personální agentury | Sledování náborových vzorců konkurence a nabízených mezd |
| Automatizace osobního hledání práce | Uchazeči o zaměstnání | Agregace nabídek odpovídajících vašim kritériím napříč lokalitami |
| Tréninková data pro ML modely | Datoví vědci | Tvorba modelů pro predikci mezd z historických dat o nabídkách |
Vlastní výzkum Indeed Hiring Lab potvrzuje, že data o inzerovaných pozicích velmi úzce sledují statistiky BLS JOLTS a mohou sloužit jako téměř reálný indikátor stavu amerického trhu práce. Hedge fondy používají tempo publikování nabídek jako alternativní datový signál. HR týmy porovnávají odměňování pomocí vyextrahovaných mzdových rozsahů. A náboráři si z firem, které aktivně nabírají, sestavují seznamy potenciálních klientů.
Jedna praktická poznámka: mzdová data na Indeed se zlepšují, ale pořád nejsou úplná. K polovině roku 2025 obsahuje zhruba 59 % amerických inzerátů informaci o mzdě, ale jen asi 22 % uvádí přesnou částku — zbytek jsou rozpětí. Jakákoli mzdová analýza postavená na datech z Indeed by s tím měla počítat.
Jak zvolit metodu scrapování Indeed pomocí Pythonu
Neexistuje jediný „správný“ způsob, jak Indeed scrapovat. Nejlepší přístup závisí na vaší úrovni, množství dat a ochotě udržovat řešení. Otestoval jsem všechny čtyři hlavní přístupy a takto vypadají v porovnání:
| Kritérium | BS4 + Requests | Selenium | Skrytý JSON (window.mosaic) | No-code (Thunderbit) |
|---|---|---|---|---|
| Obtížnost | Začátečník | Středně pokročilý | Středně pokročilý až pokročilý | Žádná (2 kliknutí) |
| Rychlost | Rychlá | Pomalá (renderování v prohlížeči) | Rychlá | Rychlá (cloudové scrapování) |
| Obsah renderovaný JavaScriptem | Ne | Ano | Ano (vložená data) | Ano |
| Odolnost proti anti-botu | Nízká | Střední (detekovatelné) | Středně vysoká | Vysoká (řešeno automaticky) |
| Údržba při změnách HTML | Vysoká (selektory se lámou) | Vysoká | Střední (JSON struktura je stabilnější) | Žádná (AI se přizpůsobí) |
| Nejvhodnější pro | Rychlé prototypy | Dynamické stránky, obsah za přihlášením | Hromadná strukturovaná data | Neprogramátory, rychlé výsledky |
Tento průvodce prochází každou metodou. Pokud jste Python vývojář, zaměřte se na části BS4, skrytý JSON a Selenium. Pokud neprogramujete (nebo vás už nebaví ladit 403), přeskočte rovnou na sekci o Thunderbit.
Než začnete
- Obtížnost: Začátečník až středně pokročilý (Python sekce); žádná (sekce Thunderbit)
- Potřebný čas: přibližně 20–60 minut na nastavení Pythonu a první scraping; asi 2 minuty s Thunderbit
- Co budete potřebovat: Python 3.9+, editor kódu, prohlížeč Chrome a (pro no-code cestu) Thunderbit Chrome Extension
Nastavení Python prostředí pro scraping Indeed
Než napíšete jakýkoli scrapingový kód, připravte si prostředí.
Nainstalujte potřebné knihovny
Vytvořte virtuální prostředí a nainstalujte balíčky, které budete potřebovat:
python -m venv indeed_env
source indeed_env/bin/activate  # Na Windows: indeed_env\Scripts\activate

# Pro přístup přes HTTP + parsování
pip install requests beautifulsoup4 lxml httpx

# Pro přístup přes skrytý JSON (doporučeno)
pip install curl_cffi parsel tenacity

# Pro automatizaci prohlížeče
pip install selenium
Pár poznámek:
curl_cffije v roce 2026 výchozí volba pro scraping webů chráněných Cloudflare. Napodobuje skutečné TLS otisky prohlížeče, což běžnérequestsahttpxnedokážou. Více o tom v sekci o anti-botu.- Selenium 4.6+ obsahuje Selenium Manager, takže už nemusíte ručně stahovat ChromeDriver — binárku prohlížeče spravuje automaticky.
- Jako backend parseru pro BeautifulSoup použijte
lxml. Je zhruba 1,5× rychlejší než standardníhtml.parser.
Vytvořte strukturu projektu
Udržte to jednoduché:
indeed_scraper/
├── scraper.py
├── requirements.txt
└── output/
Všechny ukázky kódu níže vycházejí ze souboru scraper.py.
Jak scrapovat Indeed pomocí Pythonu a BeautifulSoup
Toto je přátelský přístup pro začátečníky: použijete requests pro stažení stránky a BeautifulSoup pro parsování HTML. Nastavuje se nejrychleji, ale na Indeed je také nejkřehčí.
Krok 1: Sestavte URL pro vyhledávání na Indeed
URL vyhledávání na Indeed má předvídatelnou strukturu:
https://www.indeed.com/jobs?q=<query>&l=<location>&start=<offset>
Například hledání „data analyst“ v „Austin, TX“ od první stránky:
from urllib.parse import urlencode

params = {
    "q": "data analyst",
    "l": "Austin, TX",
    "start": 0,
}
url = f"https://www.indeed.com/jobs?{urlencode(params)}"
print(url)
# https://www.indeed.com/jobs?q=data+analyst&l=Austin%2C+TX&start=0
Indeed stránkuje po deseti výsledcích a má pevný strop 1 000 výsledků (start <= 990). Jakýkoli offset nad 990 vrátí tiše stejnou stránku.
Krok 2: Odešlete HTTP požadavek se správnými hlavičkami
Indeed okamžitě blokuje požadavky s výchozími Python user-agent řetězci. Potřebujete realistické hlavičky:
import requests

headers = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
        "(KHTML, like Gecko) Chrome/145.0.0.0 Safari/537.36"
    ),
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Referer": "https://www.indeed.com/",
}

response = requests.get(url, headers=headers, timeout=30)
print(response.status_code)
Když dostanete 200, prozatím jste uvnitř. Pokud dostanete 403, Cloudflare vás odhalil. (Jak to přežít, k tomu se dostaneme níže.)
Krok 3: Rozparsujte nabídky práce z HTML
Použijte BeautifulSoup k výběru prvků pracovních karet. Zaměřte se na atributy data-testid — jsou stabilnější než náhodně generované názvy CSS tříd na Indeed:
from bs4 import BeautifulSoup

soup = BeautifulSoup(response.text, "lxml")
cards = soup.find_all("div", attrs={"data-testid": "slider_item"})

jobs = []
for card in cards:
    title_el = card.find("h2", class_="jobTitle")
    title = title_el.get_text(strip=True) if title_el else None
    company = card.find(attrs={"data-testid": "company-name"})
    location = card.find(attrs={"data-testid": "text-location"})
    link = title_el.find("a")["href"] if title_el and title_el.find("a") else None

    jobs.append({
        "title": title,
        "company": company.get_text(strip=True) if company else None,
        "location": location.get_text(strip=True) if location else None,
        "url": f"https://www.indeed.com{link}" if link else None,
    })

print(f"Nalezeno {len(jobs)} nabídek")
Krok 4: Ošetřete stránkování
Procházejte stránky navyšováním parametru start:
import time, random

all_jobs = []
for page in range(0, 50, 10):  # Prvních 5 stránek
    params["start"] = page
    url = f"https://www.indeed.com/jobs?{urlencode(params)}"
    response = requests.get(url, headers=headers, timeout=30)
    # ... parsování jako výše ...
    all_jobs.extend(jobs)
    time.sleep(random.uniform(3, 6))
Omezení tohoto přístupu
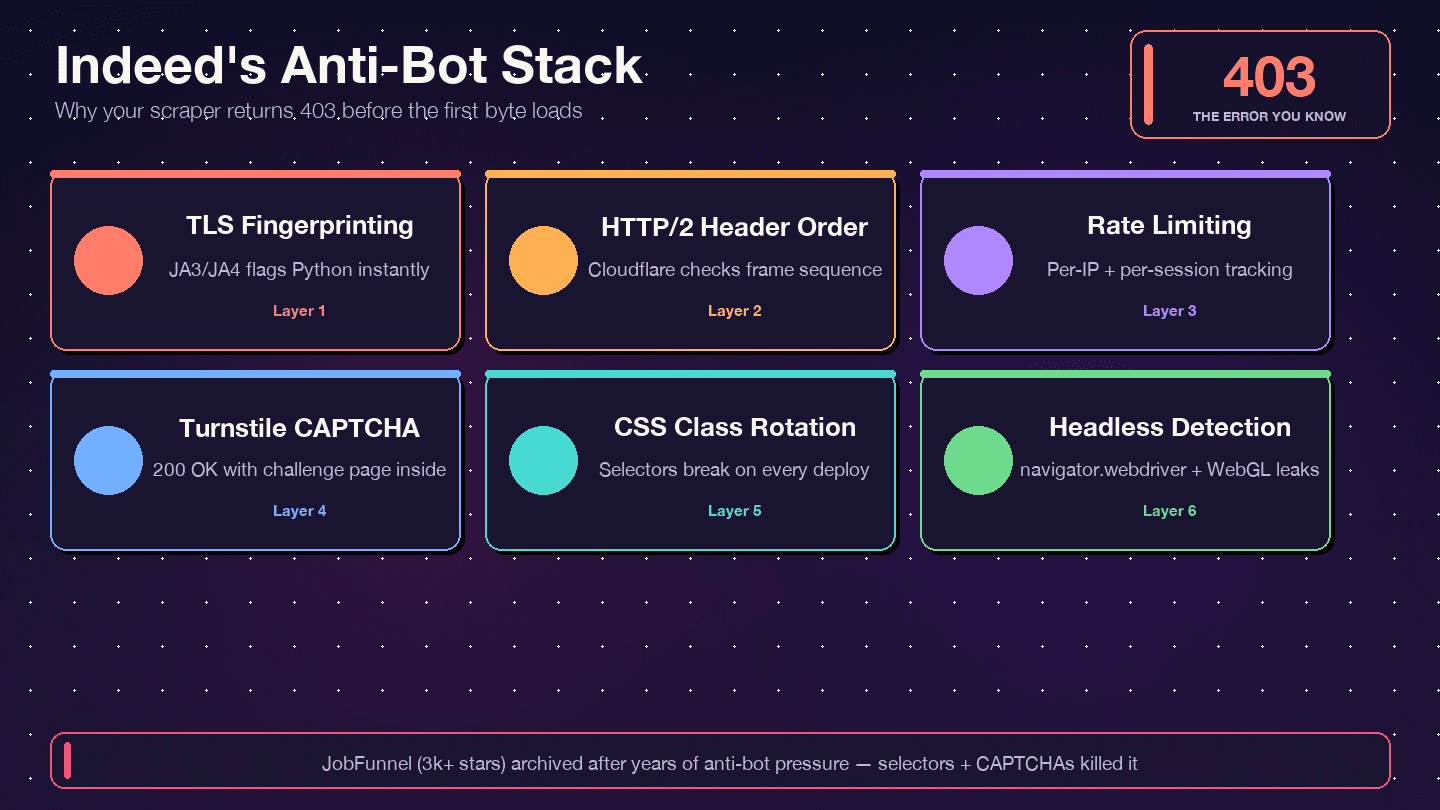
Budu upřímný: BS4 + Requests je pro Indeed v roce 2026 nejslabší metoda. Běžné requests používá TLS knihovnu ze standardní knihovny Pythonu, která vytváří JA3 otisk, podle něhož Cloudflare okamžitě pozná, že to „není prohlížeč“. Navíc nepodporuje HTTP/2, které Indeed používá. Pravděpodobně budete zablokováni po několika stránkách. A CSS selektory? Indeed často rotuje názvy tříd jako css-1m4cuuf a jobsearch-JobComponent-embeddedBody-1n0gh5s velmi často — takže každý selektor na nich je tikající časovaná bomba.
Používejte tuto metodu pro rychlé prototypování na jedné stránce. Pro cokoli ve větším měřítku použijte přístup se skrytým JSON.
Jak scrapovat Indeed pomocí Pythonu a skrytých JSON dat
Tohle je metoda, kterou doporučuji většině Python vývojářů. Místo parsování křehkých HTML prvků vytáhnete strukturovaná data z JavaScriptové proměnné vložené ve zdrojovém kódu stránky Indeed: window.mosaic.providerData["mosaic-provider-jobcards"].
Každé pole, které vás zajímá — název pozice, firma, lokalita, mzda, klíč nabídky, datum zveřejnění, příznak remote — je už v tom JSON blobu. Není potřeba spouštět JavaScript. Schéma je stabilní nejméně od roku 2023, takže je mnohem odolnější než DOM selektory.
Krok 1: Načtěte HTML stránky
Použijte curl_cffi místo requests — napodobuje skutečné TLS otisky prohlížeče, což je klíčové pro přežití Cloudflare:
from curl_cffi import requests as cffi_requests

response = cffi_requests.get(
    "https://www.indeed.com/jobs?q=python+developer&l=Remote&start=0",
    impersonate="chrome124",
    headers={
        "Accept-Language": "en-US,en;q=0.9",
        "Referer": "https://www.indeed.com/",
    },
    timeout=30,
)
print(response.status_code, len(response.text))
Proč curl_cffi? Je to Python binding nad curl-impersonate, který reprodukuje přesné TLS ClientHello, HTTP/2 SETTINGS frame i pořadí hlaviček skutečných prohlížečů. Je to v podstatě jediný aktivně udržovaný Python HTTP klient, který jedním voláním obchází jak JA3/JA4, tak Akamai H2 fingerprint. Mezi podporované profily patří chrome120, chrome124, chrome131, Safari i varianty Edge.
Krok 2: Vytáhněte JSON pomocí regulárního výrazu
JSON blob je vložený v tagu <script>. Vytáhněte ho pomocí regexu:
import re, json

MOSAIC_RE = re.compile(
    r'window\.mosaic\.providerData\["mosaic-provider-jobcards"\]=(\{.+?\});',
    re.DOTALL,
)

match = MOSAIC_RE.search(response.text)
if match:
    data = json.loads(match.group(1))
    results = data["metaData"]["mosaicProviderJobCardsModel"]["results"]
    print(f"Ve skrytém JSON nalezeno {len(results)} nabídek")
else:
    print("Skrytý JSON nenalezen — možný blok nebo změna stránky")
Krok 3: Rozparsujte pole z JSONu
Každá položka v results obsahuje víc dat, než je vidět na stránce:
jobs = []
for job in results:
    jobs.append({
        "jobkey": job["jobkey"],
        "title": job["title"],
        "company": job.get("company"),
        "location": job.get("formattedLocation"),
        "remote": job.get("remoteLocation"),
        "salary": (job.get("salarySnippet") or {}).get("text"),
        "posted": job.get("formattedRelativeTime"),
        "job_type": job.get("jobTypes"),
        "easy_apply": job.get("indeedApplyEnabled"),
        "url": f"https://www.indeed.com/viewjob?jk={job['jobkey']}",
    })
JSON často obsahuje odhady mezd, taxonomické atributy (štítky dovedností) a hodnocení firmy, které nejsou vždy vidět v renderovaném HTML.
Krok 4: Scraping více stránek
Použijte tierSummaries v JSONu k pochopení celkového počtu výsledků a pak procházejte stránky:
import time, random

all_jobs = []
for start in range(0, 50, 10):  # Prvních 5 stránek
    url = f"https://www.indeed.com/jobs?q=python+developer&l=Remote&start={start}&sort=date"
    response = cffi_requests.get(
        url,
        impersonate="chrome124",
        headers={"Accept-Language": "en-US,en;q=0.9", "Referer": "https://www.indeed.com/"},
        timeout=30,
    )
    match = MOSAIC_RE.search(response.text)
    if match:
        data = json.loads(match.group(1))
        results = data["metaData"]["mosaicProviderJobCardsModel"]["results"]
        all_jobs.extend([{
            "jobkey": j["jobkey"],
            "title": j["title"],
            "company": j.get("company"),
            "location": j.get("formattedLocation"),
            "salary": (j.get("salarySnippet") or {}).get("text"),
            "url": f"https://www.indeed.com/viewjob?jk={j['jobkey']}",
        } for j in results])
    time.sleep(random.uniform(3, 7))

print(f"Celkem vyextrahováno {len(all_jobs)} nabídek")
Proč je skrytý JSON odolnější
Struktura window.mosaic.providerData se mění méně často než názvy CSS tříd. Získáte čistá, strukturovaná data bez parsování nepořádného HTML. I tak ale stále potřebujete anti-bot mitigaci (hlavičky, prodlevy, proxy) — k tomu se dostaneme hned.
Jak scrapovat Indeed pomocí Pythonu a Selenium
Selenium je přístup přes automatizaci prohlížeče. Hodí se, když potřebujete s webem interagovat — klikat do panelu s detaily pozice, pracovat s obsahem za přihlášením nebo získávat dynamicky načítané popisy, které nejsou v úvodním HTML.
Kdy použít Selenium místo HTTP klienta
- Indeed načítá část obsahu dynamicky (úplné popisy pozic v pravém panelu)
- Potřebujete scrapovat stránky vyžadující session state nebo přihlášení
- Děláte menší scraping, kde rychlost není kritická
Rychlý průchod
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.chrome.options import Options
import time

options = Options()
options.add_argument("--disable-blink-features=AutomationControlled")
# options.add_argument("--headless=new")  # Headless je snadněji detekovatelný — používejte opatrně

driver = webdriver.Chrome(options=options)
driver.get("https://www.indeed.com/jobs?q=data+engineer&l=New+York")
time.sleep(3)

cards = driver.find_elements(By.CSS_SELECTOR, "[data-testid='slider_item']")
for card in cards:
    try:
        title = card.find_element(By.CSS_SELECTOR, "h2.jobTitle").text
        company = card.find_element(By.CSS_SELECTOR, "[data-testid='company-name']").text
        location = card.find_element(By.CSS_SELECTOR, "[data-testid='text-location']").text
        print(f"{title} | {company} | {location}")
    except Exception:
        continue

driver.quit()
Omezení
Selenium je pomalé — každá stránka vyžaduje plné vykreslení prohlížeče. Headless Chrome je detekovatelný anti-botovým systémem Indeed (Cloudflare kontroluje navigator.webdriver, řetězce s vendor WebGL, počet pluginů a další signály). Ani undetected-chromedriver jen oddaluje odhalení; nebrání mu navždy. A stejně jako u BS4 se vám selektory rozbijí, jakmile Indeed aktualizuje UI.
Pro většinu použití vám skrytý JSON dá stejná data rychleji a s menší údržbou. Selenium si nechte pro okrajové případy, kdy skutečně potřebujete prohlížeč.
Jak se vyhnout chybám 403 při scrapování Indeed pomocí Pythonu
Tohle je část, na které záleží nejvíc. Pokud jste sem přišli z frustrovaného googlení, jste na správném místě.
Proč vás Indeed blokuje
Indeed používá Cloudflare Bot Management plus Cloudflare Turnstile — ne DataDome, ne PerimeterX. Potvrzují to i response hlavičky: server: cloudflare, cf-ray a cookie __cf_bm pro správu botů. Cloudflare kontroluje váš TLS otisk (JA3/JA4), pořadí hlaviček HTTP/2, vzorce požadavků i signály chování prohlížeče. Pokud cokoli působí nelidsky, dostanete 403, 429, 503 nebo — nejzáludnější případ — 200 OK, ale místo dat uvidíte stránku s výzvou Turnstile.
Rotujte User-Agent a hlavičky požadavků
Jeden statický User-Agent je nejrychlejší cesta k blokaci. Rotujte z poolu aktuálních, realistických řetězců. Důležité: minor verze Chrome jsou po User-Agent Reduction zafixované na 0.0.0 — nevymýšlejte neexistující minor verze, anti-boty je okamžitě odhalí.
import random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/145.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/145.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/145.0.0.0 Safari/537.36 Edg/145.0.3800.97",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:128.0) Gecko/20100101 Firefox/128.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 "
    "(KHTML, like Gecko) Version/17.4 Safari/605.1.15",
]

headers = {
    "User-Agent": random.choice(USER_AGENTS),
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br, zstd",
    "Referer": "https://www.indeed.com/",
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "same-origin",
}
Také se ujistěte, že vaše Client Hints sec-ch-ua odpovídají verzi UA. sec-ch-ua: "Chrome";v="131" vedle User-Agentu, který tvrdí Chrome 145, je okamžitá červená vlajka.
Přidejte náhodné prodlevy mezi požadavky
Pevné intervaly jsou odhalitelné podle vzorců. Použijte náhodný jitter:
import time, random

# Mezi jednotlivými požadavky
time.sleep(random.uniform(3, 6))

# Při opakování po zablokování
def backoff_sleep(attempt):
    base = 4
    sleep_time = base * (2 ** attempt) + random.uniform(0, 2)
    time.sleep(min(sleep_time, 60))
Konsenzus z ScrapeOps a WebScraping.AI je 3–6 sekund mezi požadavky na IP adresu, s tvrdým stropem kolem 100 požadavků na IP během jedné session před rotací.
Použijte rotaci proxy
To je zdaleka největší faktor úspěchu. Datacentrové proxy z rozsahů AWS/GCP dosahují proti Cloudflare Enterprise zhruba 5–15% úspěšnosti — na Indeed prakticky nepoužitelné. Rezidenční proxy plus správný TLS fingerprinting zvyšují úspěšnost na 80–95 %.
PROXIES = [
    "http://user:pass@us.residential.example:7777",
    "http://user:pass@us.residential.example:7778",
    "http://user:pass@us.residential.example:7779",
]

proxy = random.choice(PROXIES)
response = cffi_requests.get(
    url,
    impersonate="chrome124",
    headers=headers,
    proxies={"https": proxy},
    timeout=30,
)
Ceny rezidenčních proxy v roce 2026 se pohybují zhruba od $4 do $8,50 za GB podle poskytovatele a závazku. Pro Indeed začněte s malým poolem a podle potřeby škálujte.
Zpracujte status kódy 403, 429 a 503 s rozvahou
Neopakujte požadavky naslepo. Různé status kódy znamenají různé věci:
def fetch_with_retry(url, proxy_pool, max_retries=5):
    for attempt in range(max_retries):
        proxy = random.choice(proxy_pool)
        headers["User-Agent"] = random.choice(USER_AGENTS)
        try:
            r = cffi_requests.get(
                url,
                impersonate=random.choice(["chrome124", "chrome120", "edge101"]),
                headers=headers,
                proxies={"https": proxy},
                timeout=30,
            )
            # Zkontrolujte zákeřný případ „200 s výzvou“
            if r.status_code == 200 and "cf-turnstile" not in r.text and "Just a moment" not in r.text:
                return r

            if r.status_code == 403:
                print(f"403 — zablokováno. Rotuji proxy, pokus {attempt + 1}")
            elif r.status_code == 429:
                print(f"429 — omezení rychlosti. Zpomalujeme.")
            elif r.status_code == 503:
                print(f"503 — server přetížený nebo JS výzva.")

            backoff_sleep(attempt)
        except Exception as e:
            print(f"Chyba požadavku: {e}")
            backoff_sleep(attempt)

    raise RuntimeError(f"Neúspěch po {max_retries} pokusech: {url}")
Případ 200 s výzvou je nejtěžší. Vždy kontrolujte tělo odpovědi na značky cf-turnstile nebo Just a moment, než začnete považovat 200 za úspěch.
Snazší alternativa: nechte anti-bot řešit Thunderbit
Pro uživatele, kteří nechtějí stavět a udržovat proxy pooly, rotaci hlaviček a impersonaci TLS fingerprintu, cloudové scrapování od Thunderbitu automaticky řeší CAPTCHY, rotaci proxy i anti-bot ochranu. Žádné nastavování proxy, žádná konfigurace curl_cffi, žádné knihovny na řešení CAPTCHA. Je to cesta nejmenšího odporu, když prostě potřebujete data.
Proč se váš scraper na Indeed pořád rozbíjí (a jak to opravit)
403 zeď je akutní bolest. Chronická bolest je údržba — scrapery, které dnes fungují, se příští týden rozbijí a potichu vracejí prázdná data nebo zastaralé výsledky.
Jak Indeed rozbíjí vaše selektory
Indeed agresivně rotuje názvy CSS tříd. Průvodce od Bright Data výslovně varuje, že třídy jako css-1m4cuuf a css-1rqpxry „se zdají být náhodně generované — pravděpodobně při buildu“. A/B testování znamená, že různé session vidí různé rozvržení stránky. A restrukturalizace DOM probíhá bez upozornění.
Příběh JobFunnel je poučný. Jeden přispěvatel uvedl: „CaptchaBuster úspěšně mitigoval captcha, a důvodem, proč stránka stále nešla scrapovat, byly zastaralé selektory BeautifulSoup.“ Scraper nebyl blokovaný — parsoval špatné elementy.
Strategie: Upřednostněte skrytý JSON před parsováním DOM
Blob window.mosaic.providerData má stabilní schéma nejméně od roku 2023. Cesta metaData.mosaicProviderJobCardsModel.results[] je v roce 2026 stále kanonická. DOM selektory se lámou měsíčně. Extrakce JSON se rozbije maximálně jednou za rok, pokud vůbec.
Strategie: Používejte datové atributy místo názvů tříd
Když už musíte pracovat s DOM, cílujte funkční atributy:
| Selektor | Účel |
|---|---|
[data-testid="slider_item"] | Kontejner každé pracovní nabídky |
[data-testid="job-title"] nebo h2.jobTitle > a | Odkaz s názvem pozice |
[data-testid="company-name"] | Název zaměstnavatele |
[data-testid="text-location"] | Text lokality |
data-jk="<jobkey>" na každé kartě | Nejstabilnější hook — beze změny od roku 2019 |
Přidejte asertace pro odhalení zastaralých selektorů
Nikdy nenechte scraper běžet potichu s nulovým počtem výsledků. Po každém načtení přidejte kontrolu:
results = parse_hidden_json(html)
assert len(results) > 0, (
    f"Indeed vrátil prázdnou množinu výsledků na start={start} — "
    "možný blok, CAPTCHA nebo drift selektorů. "
    f"Prvních 500 znaků odpovědi: {html[:500]}"
)
Při selhání logujte prvních 500–2000 znaků surové odpovědi. Okamžitě tak poznáte, zda šlo o výzvu Turnstile, přihlašovací bariéru nebo změnu schématu. Spouštějte denní smoke test na úrovni CI proti fixnímu dotazu (např. q=python&l=remote), který ověřuje nenulový počet výsledků.
AI alternativa: scrapery, které se nerozbijí
AI v Thunderbitu čte strukturu stránky pokaždé znovu — nespoléhá na natvrdo zapsané selektory ani regex vzory. Když Indeed změní HTML, Thunderbit se přizpůsobí automaticky. To přímo řeší údržbovou zátěž, kterou uživatelé na fórech neustále zmiňují jako svůj největší problém. Pokud jste někdy ráno našli na Slacku zprávu „scraper zase vrací prázdné řádky“, víte, jakou hodnotu má to nemusit opravovat.
Scrapujte Indeed bez psaní Pythonu: no-code alternativa
Každý konkurenční průvodce předpokládá, že budete psát Python kód. Ale data z fór říkají něco jiného. Uživatelé píšou věci jako „je to prostě strašně těžké s neustálými bugy a chybami“ a někteří navrhují najmout někoho na Fiverru jen proto, aby ta data získali. Pokud to zní jako vy, tahle část je vaše nouzová cesta.
Jak scrapovat Indeed s Thunderbit (krok za krokem)
Krok 1: Nainstalujte Thunderbit Chrome Extension z Chrome Web Store. Začátek je zdarma.
Krok 2: Otevřete v prohlížeči stránku s výsledky hledání na Indeed — například https://www.indeed.com/jobs?q=data+analyst&l=Austin%2C+TX.
Krok 3: Klikněte na ikonu Thunderbitu v panelu nástrojů prohlížeče a pak na „AI Suggest Fields.“ AI v Thunderbitu projde stránku a automaticky rozpozná sloupce jako název pozice, firma, lokalita, mzda, URL nabídky a datum zveřejnění. Navržená pole můžete zkontrolovat a upravit — odstranit sloupce, které nepotřebujete, nebo přidat vlastní tak, že popíšete, co chcete, běžnou angličtinou.
Krok 4: Klikněte na „Scrape.“ Thunderbit vytáhne data ze stránky a zobrazí je ve strukturované tabulce. Měli byste vidět řádky pracovních nabídek s poli, která jste si nastavili.
Obohaťte data pomocí scrapování podstránek
Po scrapování seznamu klikněte na „Scrape Subpages“ a Thunderbit navštíví každou jednotlivou stránku s detailem nabídky. Vytáhne celý popis práce, kvalifikace, benefity a odkazy na přihlášení — bez dalšího nastavování. Je to ekvivalent napsání druhého Python scraperu, který navštíví každou URL /viewjob?jk=<jobkey>, jen na jedno kliknutí.
Automatické stránkování
Thunderbit automaticky zvládne klikací stránkování na Indeed. Nemusíte ručně skládát URL s offsetem ani psát smyčky pro stránkování. Prostě prokliká stránky a výsledky agreguje.
Export do vašich oblíbených nástrojů
Exportujte vyextrahovaná data do CSV, Excelu, Google Sheets, Airtable nebo Notion — zcela zdarma. Není potřeba psát kód csv.writer() ani pandas.to_csv().
Kdy použít Python a kdy Thunderbit
| Scénář | Nejlepší nástroj |
|---|---|
| Vlastní datové pipeline, plánovaná automatizace přes cron/Airflow | Python |
| Integrace do většího codebase | Python |
| Vysoce customizovaná logika parsování | Python |
| Jednorázový výzkum nebo tržní analýza | Thunderbit |
| Data potřebují i netechnické členy týmu | Thunderbit |
| Chci data hned, bez ladění 403 | Thunderbit |
| Obohacení podstránek bez nastavování | Thunderbit |
Srovnání času: nastavení Pythonu + ladění anti-botu = hodiny až dny (zvlášť poprvé). Thunderbit = méně než 2 minuty pro stejná data. Neříkám, že Python je špatně — říkám, že záleží na tom, co potřebujete.
Je scrapování Indeed legální? Co byste měli vědět
Žádný z nejlépe hodnocených průvodců scrapováním Indeed neřeší legalitu, což je překvapivé vzhledem k tomu, jak často se ve fórech objevuje otázka „Je scraping Indeed legální?“ Tohle není právní rada, ale tady je přehled situace.
Podmínky používání Indeed
Podmínky Indeed (indeed.com/legal) neobsahují plošný zákaz scrapování. Jediný explicitní zákaz automatizace je v sekci A.3.5, která zakazuje „používání jakékoli automatizace, skriptování nebo botů k automatizaci procesu Indeed Apply.“ To je úzce zaměřené na flow Apply, nikoli na pasivní čtení veřejných nabídek. Hlavním nástrojem vynucení je technická ochrana — výzvy Cloudflare, blokace IP a device fingerprinting — ne soudní spor.
Relevantní právní precedent
Nejčastěji citovaný americký případ je hiQ Labs v. LinkedIn. 9. odvolací soud v dubnu 2022 rozhodl, že scraping veřejně dostupných dat „pravděpodobně neporušuje CFAA“ (Computer Fraud and Abuse Act). hiQ však později bylo shledáno odpovědným za porušení smlouvy, protože jeho zaměstnanci vytvořili falešné profily na LinkedIn a odsouhlasili podmínky služby.
Nedávnější případ Meta v. Bright Data (N.D. Cal., leden 2024) přinesl ještě jasnější závěr. Soudce Chen rozhodl, že podmínky Facebooku a Instagramu „nezakazují scraping veřejných dat po odhlášení“. Meta zbývající nároky následující měsíc dobrovolně stáhla.
robots.txt na Indeed
robots.txt na Indeed obecně zakazuje /jobs/ a /job/ pro výchozí User-agent: *, ale výslovně povoluje Googlebotu a Bingbotu přístup k /viewjob? — tedy ke stránkám s detailem jednotlivých nabídek. Crawlery pro trénování AI (GPTBot, CCBot, anthropic-ai) jsou silně omezené. robots.txt v USA není právně závazný, ale jeho respektování je dobrá praxe a důkaz dobré víry.
Praktická doporučení pro zodpovědné scrapování
- Scrapujte pouze veřejně dostupná data — nikdy se nepřihlašujte, nikdy nevytvářejte falešné účty
- Respektujte limity: 1 požadavek každé 3–6 sekund na IP, jen nízkou paralelizaci
- Nepublikujte vyextrahovaná data jako vlastní pracovní portál
- Používejte data pro osobní nebo interní výzkum, ne pro komerční další prodej bez povolení
- Odstraňujte nebo hashujte PII, které nepotřebujete; nastavte si horní limit pro uchovávání osobních dat
- Pokud pracujete ve velkém měřítku nebo v EU/UK, poraďte se s právníkem — na scraped osobní data se vztahují povinnosti transparentnosti podle článku 14 GDPR
Rizikové spektrum: automatizace osobního hledání práce je na nižším konci. Velkoobjemový komerční prodej dat z Indeed je na konci vysokém.
Závěr a hlavní poznatky
Scraping Indeed pomocí Pythonu je možný, ale není to víkendový projekt, který jednou nastavíte a zapomenete na něj. Ochrana Cloudflare, rotující selektory a agresivní anti-bot opatření znamenají, že k tomu musíte přistoupit se správnými nástroji a očekáváními.
Co si z toho odnést:
- Indeed je nejbohatší zdroj dat o trhu práce na webu — 350 milionů návštěvníků měsíčně, 130 milionů nabídek — ale proti scraperům bojuje tvrdě.
- Extrakce skrytého JSON (
window.mosaic.providerData) je nejodolnější Python přístup. Schéma je stabilní roky, zatímco CSS selektory se lámou každý měsíc. curl_cffis impersonací prohlížeče je v roce 2026 výchozí HTTP klient pro weby chráněné Cloudflare. Běžnérequestsahttpxjsou blokované už na úrovni TLS fingerprintu.- Vždy používejte rotující hlavičky, náhodné prodlevy a rezidenční proxy, abyste se vyhnuli chybám 403. Datacentrové proxy jsou proti Cloudflare Enterprise téměř k ničemu.
- Přidejte kontrolní aserce, abyste okamžitě poznali, když se selektory rozbijí nebo když místo dat dostáváte stránku s výzvou.
- Pro netechnické uživatele nebo kohokoli, kdo chce výsledky rychle, nabízí Thunderbit no-code, AI-driven cestu, která se automaticky přizpůsobuje změnám webu — bez proxy, bez ladění, bez údržby.
Pokud chcete zkusit no-code variantu, Thunderbit nabízí bezplatný tarif, takže si ho můžete na Indeed vyzkoušet bez závazků. A pokud půjdete cestou Pythonu, ukázky kódu výše jsou dobrý start — jen nezapomeňte brát odolnost proti anti-botu jako prvotní požadavek, ne jako dodatečnou myšlenku.
Více o přístupech a nástrojích pro web scraping najdete v našich návodech na jak scrapovat web pomocí Pythonu, nejlepší automatizované nástroje pro web scraping a web scraping bez blokování. Můžete se také podívat na tutoriály na Thunderbit YouTube kanálu.
Vyzkoušejte Thunderbit a scrapujte data z Indeed rychleji Get Started Free
Časté dotazy
Jaké Python knihovny jsou pro scraping Indeed nejlepší?
Pro HTTP požadavky je v roce 2026 nejsilnější volbou curl_cffi — napodobuje skutečné TLS otisky prohlížeče, což je zásadní pro obcházení Cloudflare. httpx s HTTP/2 je slušná záloha pro méně chráněné cíle. Pro parsování HTML zůstává standardem BeautifulSoup4 s lxml. Pro automatizaci prohlížeče fungují Playwright (s playwright-stealth) nebo undetected-chromedriver, i když oba jsou stále snáze detekovatelné. Přístup se skrytým JSON pomocí regexu (window.mosaic.providerData) navíc úplně eliminuje potřebu těžkého parsování.
Proč mi při scrapování Indeed pořád padá chyba 403?
Indeed používá Cloudflare Bot Management, který kontroluje TLS fingerprint (JA3/JA4), pořadí HTTP/2 hlaviček, vzorce požadavků i chování prohlížeče. Pokud používáte obyčejné requests, váš TLS fingerprint vás hned prozradí jako Python skript — 403 přijde ještě dřív, než se vůbec přečtou hlavičky. Oprava: přejděte na curl_cffi s impersonací prohlížeče, rotujte realistické User-Agent řetězce, přidávejte náhodné prodlevy (3–6 sekund) a používejte rezidenční proxy. Zkontrolujte také případ „200 s výzvou Turnstile“ — v těle odpovědi hledejte značky cf-turnstile.
Dá se Indeed scrapovat bez kódování?
Ano. Nástroje jako Thunderbit vám umožní vytáhnout nabídky z Indeed na pár kliknutí — nainstalujete Chrome extension, otevřete stránku s výsledky na Indeed, kliknete na „AI Suggest Fields“ a pak na „Scrape“. AI v Thunderbitu automaticky rozpozná pole jako název pozice, firma, lokalita a mzda. Zvládne stránkování, obohacení podstránek (plné popisy pozic) i anti-bot ochranu automaticky. Export do CSV, Google Sheets, Airtable nebo Notion je zdarma.
Jak často Indeed mění HTML strukturu?
Indeed pravidelně rotuje názvy CSS tříd (např. css-1m4cuuf, náhodně generované hashované řetězce) a bez upozornění přestavuje DOM prvky. A/B testování znamená, že různí uživatelé mohou současně vidět různá rozložení. Přístup se skrytým JSON (window.mosaic.providerData) je výrazně stabilnější — schéma je konzistentní nejméně od roku 2023. Když už musíte použít DOM selektory, cílujte atributy data-testid a data-jk (job key) místo CSS tříd.
Je legální scrapovat Indeed?
Scraping veřejně přístupných stránek Indeed bez přihlášení pravděpodobně v USA nezakládá odpovědnost podle CFAA, soudě podle rozhodnutí 9. obvodu v případu hiQ v. LinkedIn (2022) a rozhodnutí Meta v. Bright Data (2024). Podmínky Indeed zakazují konkrétně automatizaci procesu Apply, ne pasivní čtení veřejných nabídek. Přesto scrapeujte zodpovědně: nepřihlašujte se, nevytvářejte falešné účty, respektujte limity rychlosti, nepřepisujte data jako vlastní pracovní portál a zacházejte opatrně s osobními údaji (jména recruiterů, e-maily) podle GDPR/CCPA. Pro komerční provoz ve větším měřítku se poraďte s právníkem.
Více informací



