
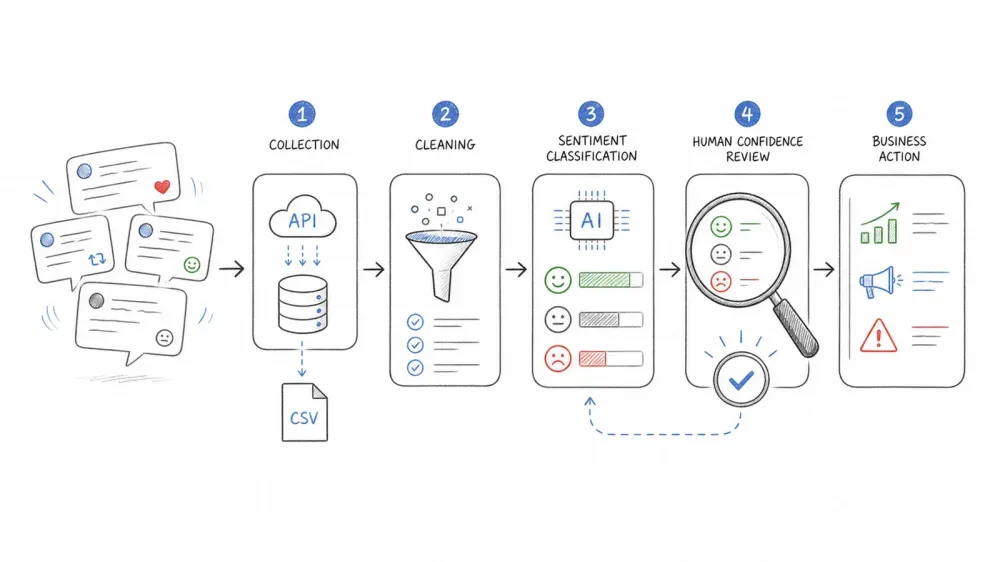
Otevřeš tabulku se 300 surovými příspěvky a problém je jasný hned na první pohled: kopírovat, vkládat, číst, mžourat, hádat, opakovat — a stejně možná nepoznáš, jestli lidé spuštění produktu milovali, nebo nenáviděli.
Právě proto existuje sentiment analýza. Jenže je tu háček: většina návodů na tohle téma uvízla v roce 2022. Počítají s bezplatným přístupem k API, který už neexistuje, doporučují modely, které si neporadí se sarkasmem ani emoji, a přeskakují kroky předzpracování, které ve skutečnosti rozhodují o tom, jestli tvoje výsledky vůbec něco znamenají. Věnoval jsem hodně času světu SaaS a automatizace (včetně tvorby Thunderbit) a viděl jsem, jak se sentiment analýza dramaticky proměnila. Upřímná, aktualizovaná cesta dnes zahrnuje Python i no-code workflow, s metodami sběru dat a modely, které odpovídají realitě roku 2026.
Co je Twitter sentiment analýza?
Twitter sentiment analýza je proces, který automaticky klasifikuje příspěvky na X jako pozitivní, negativní nebo neutrální podle jejich textu, emoji a kontextu. Představ si to jako naučit stroj číst tweet a odpovědět na otázku: „Je ten člověk spokojený, nespokojený, nebo něco mezi tím?“
Sentiment analýza se ale liší od obecného social listeningu. Social listening sleduje, o čem lidé mluví — témata, trendy, objem. Sentiment analýza je nadstavba, která to boduje a klasifikuje: říká ti, jak se lidé cítí ohledně toho, o čem mluví. Tenhle koncept má kořeny v počítačové lingvistice a výzkumu opinion mining už desítky let, ale do běžného byznysového nástroje se dostal až v posledních letech.
Existuje několik běžných úrovní klasifikace:
- Binární: pozitivní nebo negativní (nejjednodušší, ale ztrácí nuance)
- Ternární: pozitivní, neutrální nebo negativní (nejčastější výchozí varianta)
- Jemně odstupňovaná: od velmi pozitivní po velmi negativní (užitečné pro výzkum a detailní sledování značky)
A existují i související, ale odlišné úlohy — například rozpoznání emocí (naštvaný, smutný, radostný), detekce postoje (pro nebo proti tvrzení), sentiment podle aspektu (jak se někdo cítí ohledně ceny vs. kvality) a detekce sarkasmu/ironie. TweetEval benchmark tyto úlohy odděluje, a to z dobrého důvodu: jedno sentiment skóre nedokáže odpovědět na každou byznysovou otázku. Pokud sleduješ uvedení produktu na trh, nejspíš chceš sentiment podle aspektu („miluju foťák, nesnáším baterii“). Pokud monitoruješ krizovou situaci, chceš emoce a objem, ne jen polaritu.
Proč je Twitter sentiment analýza pro váš byznys důležitá
X je postavené na komunikaci v reálném čase, takže reakce na uvedení produktu, živé události nebo aktuální zprávy se mohou nahrnout během chvilky. Pro firmy je právě ta rychlost klíčová. Sentiment analýza promění příval nestrukturovaného textu na strukturovaná data, která může tým číst a využít při rozhodování.
Nejčastější scénáře použití vypadají takto:
| Použití | Tým | Přínos pro byznys |
|---|---|---|
| Sledování reputace značky | PR, marketing | Zachytit negativní výkyvy dřív, než se stanou virálními |
| Zpětná vazba ke spuštění produktu | Produkt, marketing | V reálném čase zjistit, co funguje a co ne |
| Srovnání s konkurencí | Strategie, marketing | Porovnat vnímání značky s konkurenty ve stejném časovém okně |
| Detekce krize | PR, provoz | Spustit lidskou kontrolu při náhlém nárůstu negativních reakcí |
| Výkon kampaní | Marketing | Měřit změnu sentimentu podle kreativy, kanálu nebo času |
| Nálada trhu / akcií | Finance, výzkum | Sledovat veřejnou náladu kolem výsledků, událostí nebo politiky |
| Politický a veřejnopolitický výzkum | Výzkum, veřejná správa | Ve velkém měřítku vyhodnocovat veřejné mínění k problémům |
Abych to uvedl do kontextu: X ve svém souhrnu Super Bowlu 2026 uvedlo 16 milionů příspěvků od 4 milionů autorů, 5 miliard zobrazení a 605 milionů videopřehrání kolem jediné události — přičemž polovina konverzace probíhala v reálném čase. To je přesně ten rozsah, kdy je manuální čtení nemožné a automatizované bodování sentimentu se stává nutností.
A nejde jen o objem. Vlastní metodika BrandRanx od X kombinuje objem, zapojení a sentiment — což potvrzuje, že sentiment je nejsilnější, když se používá spolu s dalšími signály, ne izolovaně.
Pointa je jednoduchá: pokud tvoje rozhodnutí stojí na veřejném vnímání — produktu, značky, kampaně nebo krize — sentiment analýza z dat X je jeden z nejrychlejších dostupných zpětnovazebních cyklů.
Realita X API v roce 2026: Jak dnes skutečně získat data z tweetů
Tady se většina návodů rozpadá. Pokud jsi někdy následoval průvodce založený na Tweepy, vložil kód a narazil na paywall nebo nejasnou chybu, nejsi sám. Staré tarify Free / Basic / Pro už neexistují. X API je teď zpoplatněné podle použití s předplacenými kredity, s cenou za jednotlivé endpointy a sledováním využití v reálném čase.
Upřímné srovnání všech současných metod sběru dat:
| Metoda | Cena (2026) | Objem | Úroveň dovedností | Poznámky |
|---|---|---|---|---|
| X API v2 (pay-per-use) | $0.005 za přečtený Post | Až 2M přečtení Postů / měsíc (self-serve) | Střední (Python) | Oficiální, reprodukovatelné, v souladu s pravidly |
| Full-Archive Search | $0.005 za vrácený Post; $0.010 za full-archive count request | Až do března 2006 | Střední–pokročilá | Dostupné pro pay-per-use i Enterprise |
| Filtered Stream | Přečtení Postů se účtuje při doručení | V reálném čase, průběžně | Střední–pokročilá | Nejlepší pro živý sběr |
| Předpřipravené datasety (Kaggle, Sentiment140) | $0 | Statické, jen historická data | Začátečník | Skvělé na učení, ne na živou analýzu |
| snscrape, Twint, Twikit atd. | $0 | Nespolehlivé / často nefunkční | Pokročilá | snscrape nefunguje pro vyhledávání na X od roku 2023; Twint je archivovaný; Twikit používá neoficiální metody |
| Váš vlastní archiv X | $0 | Jen vaše vlastní příspěvky | Začátečník | Užitečné pro osobní analýzu |
Je dobré vědět pár věcí:
- Staré tarify Free/Basic/Pro už neexistují. Nepoužívej žádný návod, který je uvádí jako aktuální.
- snscrape je pro X mrtvý. Jeho správce v roce 2024 potvrdil, že vyhledávací scraping na Twitteru/X už nefunguje. Twint je archivovaný. Twikit používá neoficiální scraping a cookies — aktivita neznamená oprávnění.
- Podmínky X zakazují scraping přes prohlížeč bez předchozího písemného souhlasu. To znamená, že Selenium, Playwright ani rozšíření do prohlížeče nejsou pro přístup k X API compliant náhradou.
X API v2: Co skutečně dostanete
Standardní přečtení Postu stojí $0.005 za vrácený Post. Čtení uživatele stojí $0.010 za kus. Takže 10 000 jedinečných přečtení Postů vyjde zhruba na $50, ještě před dalšími náklady na zdroje. Self-serve limit je 2 miliony přečtení Postů měsíčně. Ceny se mohou měnit — vždy zkontroluj Developer Console.
Pro sentiment práci budeš potřebovat víc než jen id a text. Užitečné minimum schématu zahrnuje created_at, lang, author_id, conversation_id, referenced_tweets, entities, context_annotations a public_metrics. Ukládej surovou odpověď i neměnný záznam o dotazu, endpointu, časovém okně v UTC a stránkovacích tokenech. Bez toho nebude tvůj korpus reprodukovatelný.
Ještě jedna komplikace: migrace search indexu z 4. května 2026 změnila pozorovaný korpus. Vyhledávání přes REST podle klíčových slov už nevrací reposty, zatímco Filtered Stream zůstává beze změny. Pokud porovnáváš výsledky před a po tomhle datu, možná počítáš jiné populace.
Předpřipravené datasety: Dobré na učení, ne na živou analýzu
Sentiment140 (1,6 milionu tweetů, vzdáleně supervidované štítky) a různé Kaggle datasety jsou zdarma a skvělé pro výuku i benchmarkování. Ale Sentiment140 bylo nasbíráno v roce 2009. Sentimentová podmnožina TweetEval používá data ze SemEval 2013–2016. Nemohou prokázat, že tvůj model funguje na jazyce, slangu nebo událostech z roku 2026.
Poznámka k Thunderbit a datům z X
Chci být tady naprosto otevřený, protože jsme vytvořili Thunderbit: Thunderbit je AI nástroj pro web scraping a automatizaci, který funguje na mnoha kompatibilních webech. Ale aktuální podmínky X zakazují scraping přes prohlížeč bez souhlasu. Nebudu tedy Thunderbit prezentovat jako způsob, jak obejít náklady nebo přístupová omezení X API — to by bylo zavádějící. Pro data z X použij oficiální API, autorizovaného poskytovatele nebo vlastní archiv účtu. Kde Thunderbit zapadá do sentiment workflow, je až následné zpracování: strukturování, označování a export dat, která jsi už legálně získal. K tomu se ještě vrátíme.
Výběr správného sentiment modelu: VADER vs. TextBlob vs. RoBERTa
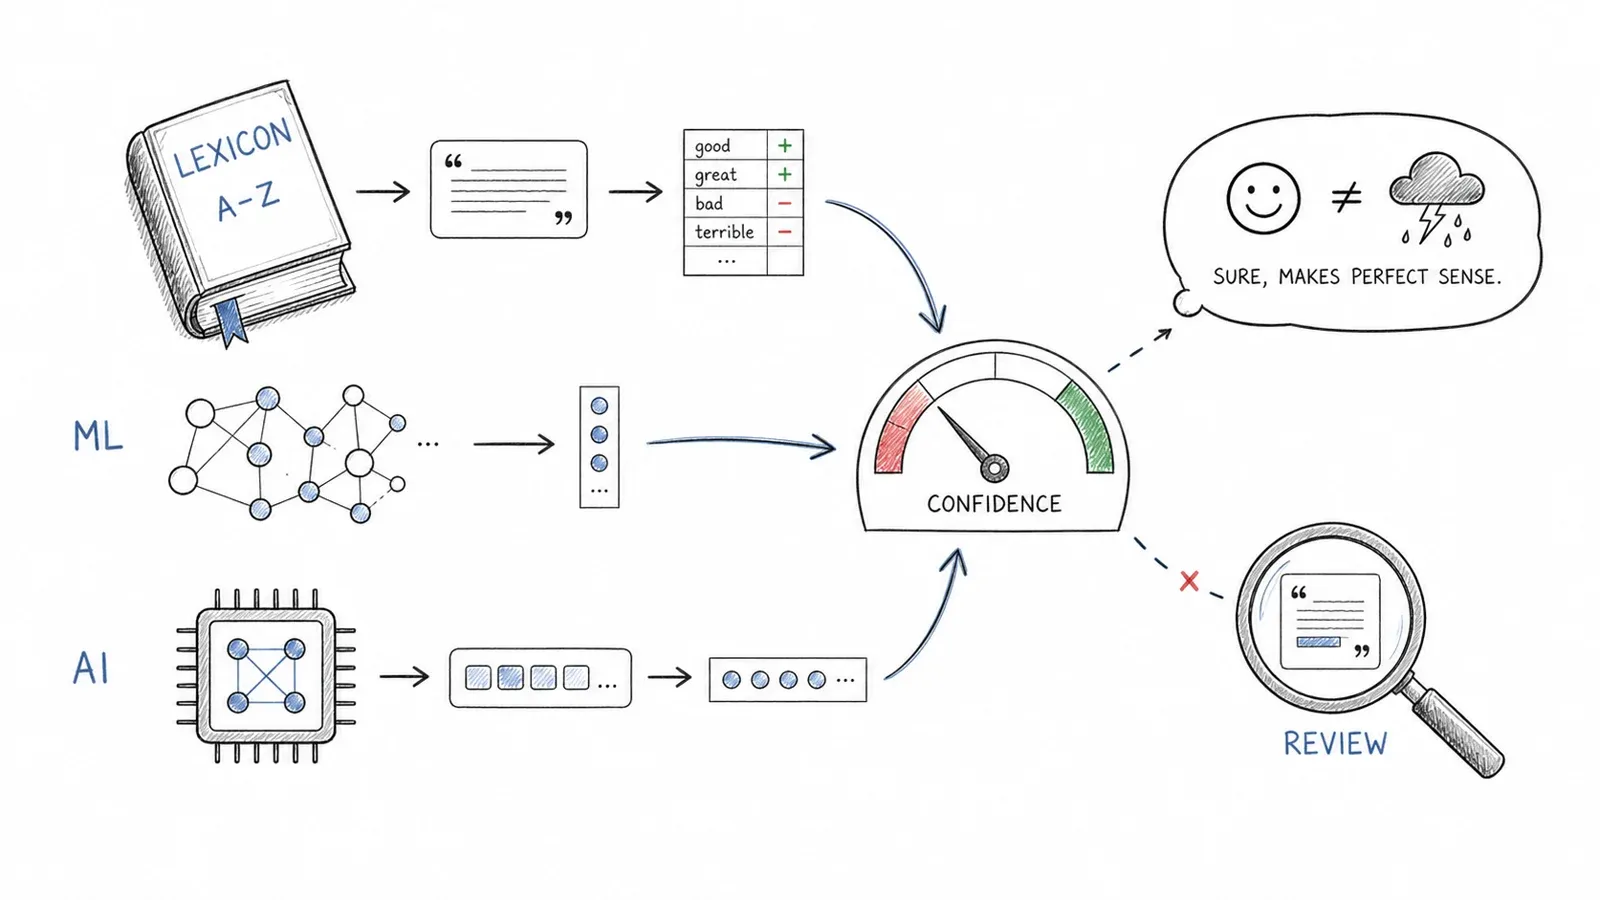
Na výběru modelu záleží víc, než většina návodů přiznává. A největší mezera ve srovnávacích průvodcích je ta, že téměř žádný z nich nepracuje s transformer modely doladěnými na tweetech — přitom právě tam dnes leží některé z nejsilnějších praktických baseline modelů.
Následuje přímé srovnání. Záměrně neuvádím univerzální F1 skóre, protože výsledky se liší podle datasetu, splitu, definice labelů, časového období i metriky. Místo toho popisuji relativní výkon a odkazuji na benchmarky, kde si to můžeš ověřit.
| Model / knihovna | Přístup | Zvládá sarkasmus? | Zvládá slang/emoji? | Relativní přesnost na tweetech | Složitost nasazení |
|---|---|---|---|---|---|
| VADER (NLTK) | Pravidlový lexikon | Slabě | Částečně emoji | Nejnižší | Velmi nízká |
| TextBlob | Na patternu založený | Slabě | Ne | Nižší | Velmi nízká |
| Naive Bayes / Logistic Regression (TF-IDF) | Klasické ML | Ne | Ne | Střední | Střední |
| CardiffNLP RoBERTa | Transformer (doladěný na tweetech) | Lepší (ne perfektní) | Ano | Nejvyšší z těchto možností | Střední (HuggingFace pipeline) |
VADER: Rychlý a jednoduchý, ale omezený
VADER je lexikonový přístup založený na pravidlech, vytvořený pro sociální text. Je rychlý, interpretovatelný, nepotřebuje trénovací data a zvládá některé emoji a emotikony. Bere v úvahu negaci, zesilovače, interpunkci a velká písmena. Pro rychlou základní verzi nebo když záleží na výpočetním výkonu a transparentnosti, je VADER užitečný. Kde selhává: sarkasmus, slang, kontextově závislý význam a cokoli, co vyžaduje pochopení víc než jednotlivých slov. Jeho výchozí prahy compound skóre (≥0.05 = pozitivní, ≤-0.05 = negativní) jsou jen defaulty, ne univerzální business prahy — uprav je podle vlastního validačního setu.
TextBlob: Ještě jednodušší, ale ještě omezenější
TextBlob je malá vzdělávací baseline. Jeho výchozí PatternAnalyzer nebyl trénován na tweetovém textu. Je užitečný pro úplně první NLP experiment, ale ne pro produkční analýzu tweetů.
Klasické ML: Naive Bayes, Logistic Regression, SVM
Pipeline typu slova a znaky TF-IDF s logistickou regresí nebo LinearSVC zůstává cennou supervised baseline. Je levná, interpretovatelná a často odhalí, jestli transformer přinese dostatečnou přidanou hodnotu, aby ospravedlnil svou složitost. Klíčové pravidlo: vectorizer fituj až po rozdělení na train/validation, jinak dojde k úniku slovní zásoby a IDF informací.
Tyto modely překonávají pravidlové přístupy na velkých označených datasetech, ale pořád přehlížejí kontext, sarkasmus a slang.
CardiffNLP RoBERTa: Standard roku 2026 pro sentiment tweetů
cardiffnlp/twitter-roberta-base-sentiment-latest je udržovaný model zaměřený na tweety a v roce 2026 dává velmi silnou baseline. Byl předtrénovaný na velkém korpusu tweetů a doladěný na sentiment, takže emoji, slang i neformální jazyk zvládá výrazně lépe než pravidlové nebo klasické ML přístupy.
Tady je minimální ukázka pro HuggingFace:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)
scores = classifier("@user Love waiting three hours for support 😒 http")
print(scores)
Několik upozornění:
- Výstup je skóre modelu, ne kalibrovaná byznysová pravděpodobnost. Kalibruj ho nebo přidej práh pro odmítnutí na aktuálním označeném vzorku.
- Kontextové modely obvykle překonávají pravidlové systémy u mnoha tweetových úloh, ale sarkasmus, smíšené cíle, chybějící kontext vlákna, dialekty a kódovaný jazyk zůstávají strukturálními zdroji chyb. Neslibuj, že jakýkoli model „rozumí sarkasmu“ — přesnější je říct, že ho zvládá lépe, ne dokonale.
- Alternativy zahrnují BERTweet, TimeLMs a vícejazyčné Twitter-XLM-R modely podle jazyka a úlohy.
Takže, je Twitter sentiment analýza opravdu přesná? Ano — pokud model, předzpracování, definice labelů i evaluační vzorek odpovídají úloze. Obecný VADER skript z návodu z roku 2019 je jen baseline, ne důkaz produkční kvality.
Skutečný pipeline pro předzpracování tweetů (ne jen text.lower())
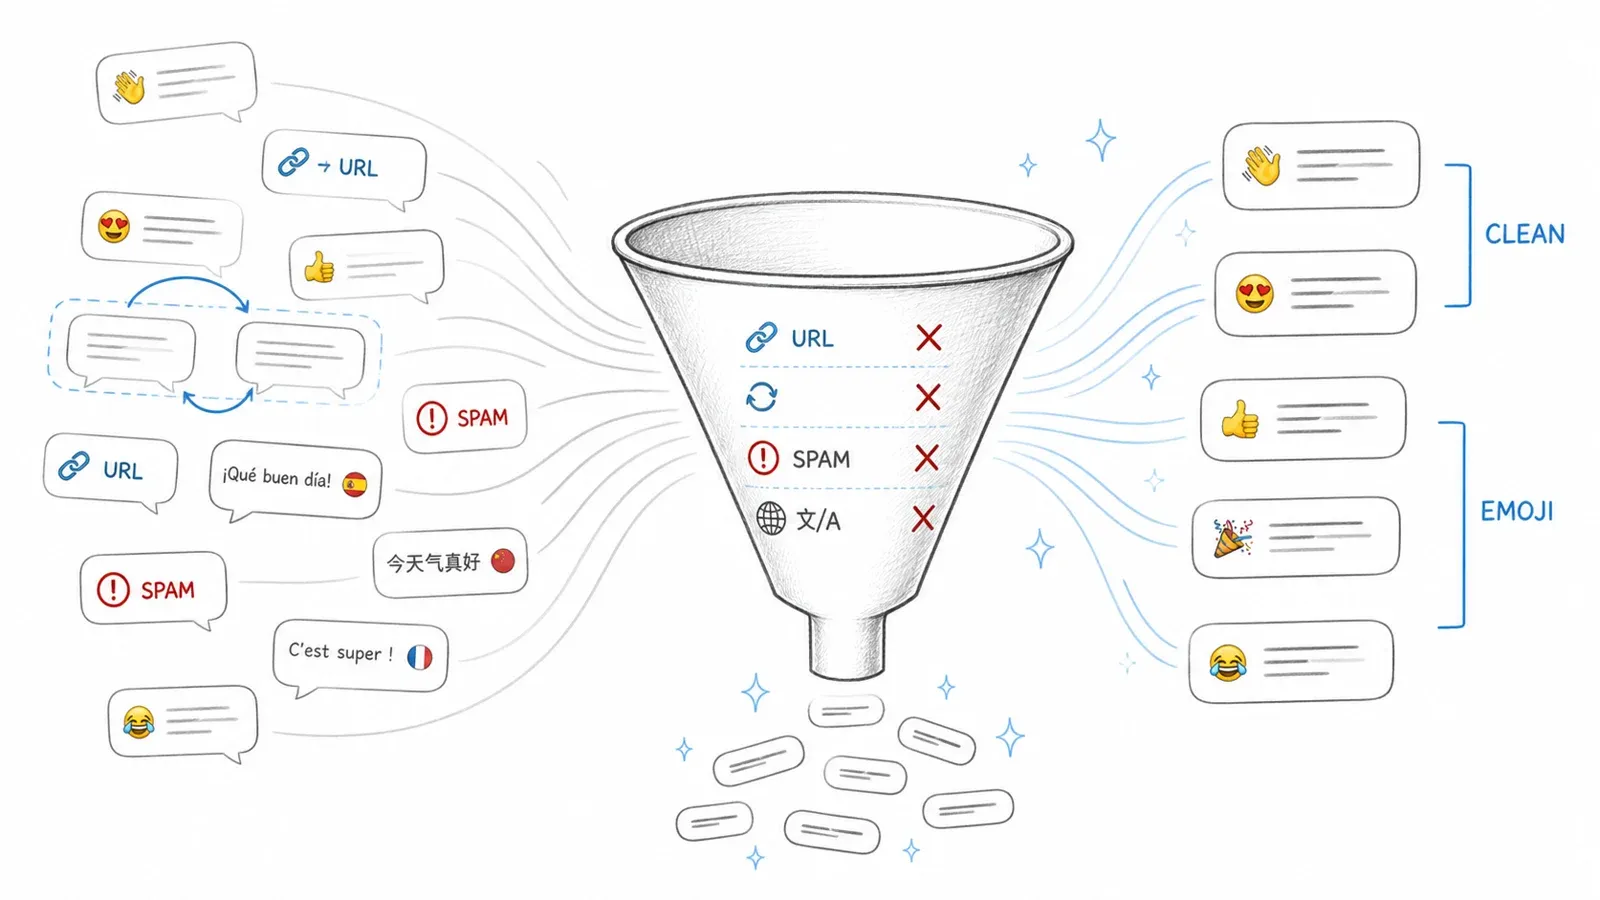
Když do sentiment modelu pošleš surové URL, @zmínky a HTML entity, i slušný model může vyplivnout nesmysly. Většina návodů (včetně těch nejlépe hodnocených) jen převede text na malá písmena a pak ho pošle do modelu. Tím se tiše sabotuje přesnost — zvlášť u klasického ML, kde může kvalita předzpracování rozhodovat stejně moc jako výběr modelu.
Co čistit (a proč na tom záleží)
| Prvek | Co udělat | Proč |
|---|---|---|
| URL | Nahradit zástupným symbolem jako http | URL jsou pro sentiment šum; odstranění okolního textu může zničit kontext |
| @zmínky | Nahradit handle za @user | Zachová strukturu a odstraní únik identity autora |
| Emoji/emotikony | Zachovat pro moderní tokenizéry; u sparse modelů otestovat převod na text | Emoji nesou silný sentimentový signál — mazat je znamená zahazovat data |
| Hashtagy | Zachovat token; volitelně přidat i rozdělenou verzi (např. #ClimateChangeIsReal → Climate Change Is Real) | Hashtagy často obsahují samotný názor |
| Negace | Zachovat not, no, never, zkratky a kontrastní slova | Obecné seznamy stop slov je často odstraní a tím převrátí sentiment |
| Velká/malá písmena a interpunkce | Zachovat pro VADER a kompatibilní modely | VADER používá velká písmena a interpunkci jako rysy |
| Prefix RT | Odstranit značku RT | Je to metadata, ne sentiment |
| Reposty/duplicity | Zachytit přesné i téměř identické duplicity před splitováním | Duplicity v train i test části způsobují leakage |
Před a po: Co předzpracování vlastně udělá s tweetem
Tady je konkrétní příklad:
| Fáze | Text |
|---|---|
| Surový tweet | RT @BrandX: Wow, #CustomerServiceFail 😡😡 https://t.co/abc123 I've been waiting 3 hrs ngl this is awful |
| Po odstranění URL | RT @BrandX: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Po normalizaci zmínky | RT @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Po odstranění RT | @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Po segmentaci hashtagu | @user: Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| Po převodu emoji na text (pro sparse modely) | @user: Wow, #CustomerServiceFail Customer Service Fail angry_face angry_face http I've been waiting 3 hrs ngl this is awful |
| Finální verze (pro CardiffNLP RoBERTa) | @user Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
Všimni si, že u transformeru jako CardiffNLP RoBERTa chceš emoji, interpunkci i velikost písmen zachovat — model byl trénovaný na textu, který takhle vypadá. U TF-IDF modelu bys naopak mohl provést demojizaci, převod na malá písmena a lemmatizaci.
Python kód pro předzpracování ke zkopírování
Čistá, modulární funkce pro preprocessing kompatibilní s transformery:
import html
import re
import unicodedata

URL_RE = re.compile(r"https?://\S+|www\.\S+", re.I)
MENTION_RE = re.compile(r"(?<!\w)@[A-Za-z0-9_]+")

def normalize_social_text(text: str) -> str:
    """Normalizuje tweet pro sentiment modely založené na transformerech."""
    text = html.unescape(text)
    text = unicodedata.normalize("NFC", text)
    text = URL_RE.sub("http", text)
    text = MENTION_RE.sub("@user", text)
    text = re.sub(r"\bRT\b", "", text)
    return " ".join(text.split())
Pro klasické ML pipeline bys to rozšířil o převod na malá písmena, převod emoji na text (pomocí knihovny emoji nebo demoji), segmentaci hashtagů (např. s wordninja nebo ekphrasis), normalizaci slangu, odstranění stop slov a lemmatizaci (např. přes spaCy nebo NLTK). Hlavní princip: přizpůsob preprocessing modelu. BERTweet například používá vlastní dokumentovanou normalizační konvenci — nenuť každý model do jediné pipeline.
Krok za krokem: Twitter sentiment analýza v Pythonu
Toto je kompletní workflow, které propojuje všechno výše uvedené. Můžeš jím projít od začátku do konce.
Než začneš:
- Obtížnost: Střední (předpokládá se základní znalost Pythonu)
- Čas potřebný: ~30–60 minut pro celý pipeline; ~10 minut pro rychlou transformer cestu
- Co budeš potřebovat: Python 3.8+, bezplatný Google Colab nebo lokální prostředí,
pandas,transformers,scikit-learn,matplotlib,seaborna volitelněwordcloud
Krok 1: Nasbírej tweetová data
Pro tenhle návod použiju dataset Sentiment140 (zdarma, 1,6 milionu tweetů, dostupný na Kaggle). Je skvělý pro učení a benchmarkování, i když je historický.
Pokud chceš živá data, použij placenou verzi X API v2 podle využití. Standardní přečtení Postu stojí $0.005. Pro 10 000 Postů je to zhruba $50.
Načtení datasetu:
import pandas as pd

columns = ["target", "id", "date", "flag", "user", "text"]
df = pd.read_csv(
    "training.1600000.processed.noemoticon.csv",
    encoding="latin-1",
    names=columns,
)
# Štítky: Sentiment140 používá 0 = negativní, 4 = pozitivní
df["label"] = df["target"].map({0: "negative", 4: "positive"})
print(df[["text", "label"]].head())
Měl bys vidět DataFrame se surovým textem tweetů a sloupcem štítků.
Krok 2: Vyčisti a předzpracuj tweety
Použij funkci preprocessing z předchozí sekce:
df["clean_text"] = df["text"].apply(normalize_social_text)
print(df[["text", "clean_text"]].head())
Zkontroluj pár řádků a ověř si, že URL jsou nahrazeny, zmínky normalizovány a prefixy RT odstraněny.
Krok 3: Vyber model a klasifikuj sentiment
Cesta A: Klasické ML s TF-IDF + logistická regrese
To je cesta „pochopit základy“. Rozděl data, fitni vectorizer jen na trénovací část a natrénuj klasifikátor logistické regrese:
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X_train, X_test, y_train, y_test = train_test_split(
    df["clean_text"], df["label"], test_size=0.2, random_state=42
)
vectorizer = TfidfVectorizer(max_features=50000, ngram_range=(1, 2))
X_train_tfidf = vectorizer.fit_transform(X_train)
X_test_tfidf = vectorizer.transform(X_test)

clf = LogisticRegression(max_iter=1000)
clf.fit(X_train_tfidf, y_train)
y_pred = clf.predict(X_test_tfidf)
print(classification_report(y_test, y_pred))
Měl bys vidět klasifikační report s precision, recall a F1 pro každou třídu. Na Sentiment140 logistická regrese s TF-IDF obvykle funguje slušně — ale pamatuj, že dataset je z roku 2009 a používá distant supervision (emotikony jako labely), takže tato čísla neber jako produkční benchmark.
Cesta B: CardiffNLP RoBERTa přes HuggingFace
Pro nejlepší přesnost na tweetovém textu použij předtrénovaný transformer:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)

sample_tweets = [
    "@user Love waiting three hours for support 😒 http",
    "@user This new update is absolutely fantastic, best one yet!",
    "@user The event was okay, nothing special.",
]
for tweet in sample_tweets:
    result = classifier(tweet)
    print(f"Tweet: {tweet}\nScores: {result}\n")
Uvidíš seznam skóre labelů (negativní, neutrální, pozitivní) pro každý tweet. Sarkastický tweet („Love waiting three hours...“) by měl získat vyšší negativní skóre než by předpověděl pravidlový model — i když ani tady není žádný model dokonalý.
Krok 4: Vyhodnoť výsledky
Teď vytvoř heatmapu confusion matrix pro cestu klasického ML:
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred, labels=["negative", "positive"])
sns.heatmap(cm, annot=True, fmt="d", xticklabels=["negative", "positive"],
            yticklabels=["negative", "positive"], cmap="Blues")
plt.xlabel("Predicted")
plt.ylabel("Actual")
plt.title("Confusion Matrix: Logistic Regression on Sentiment140")
plt.show()
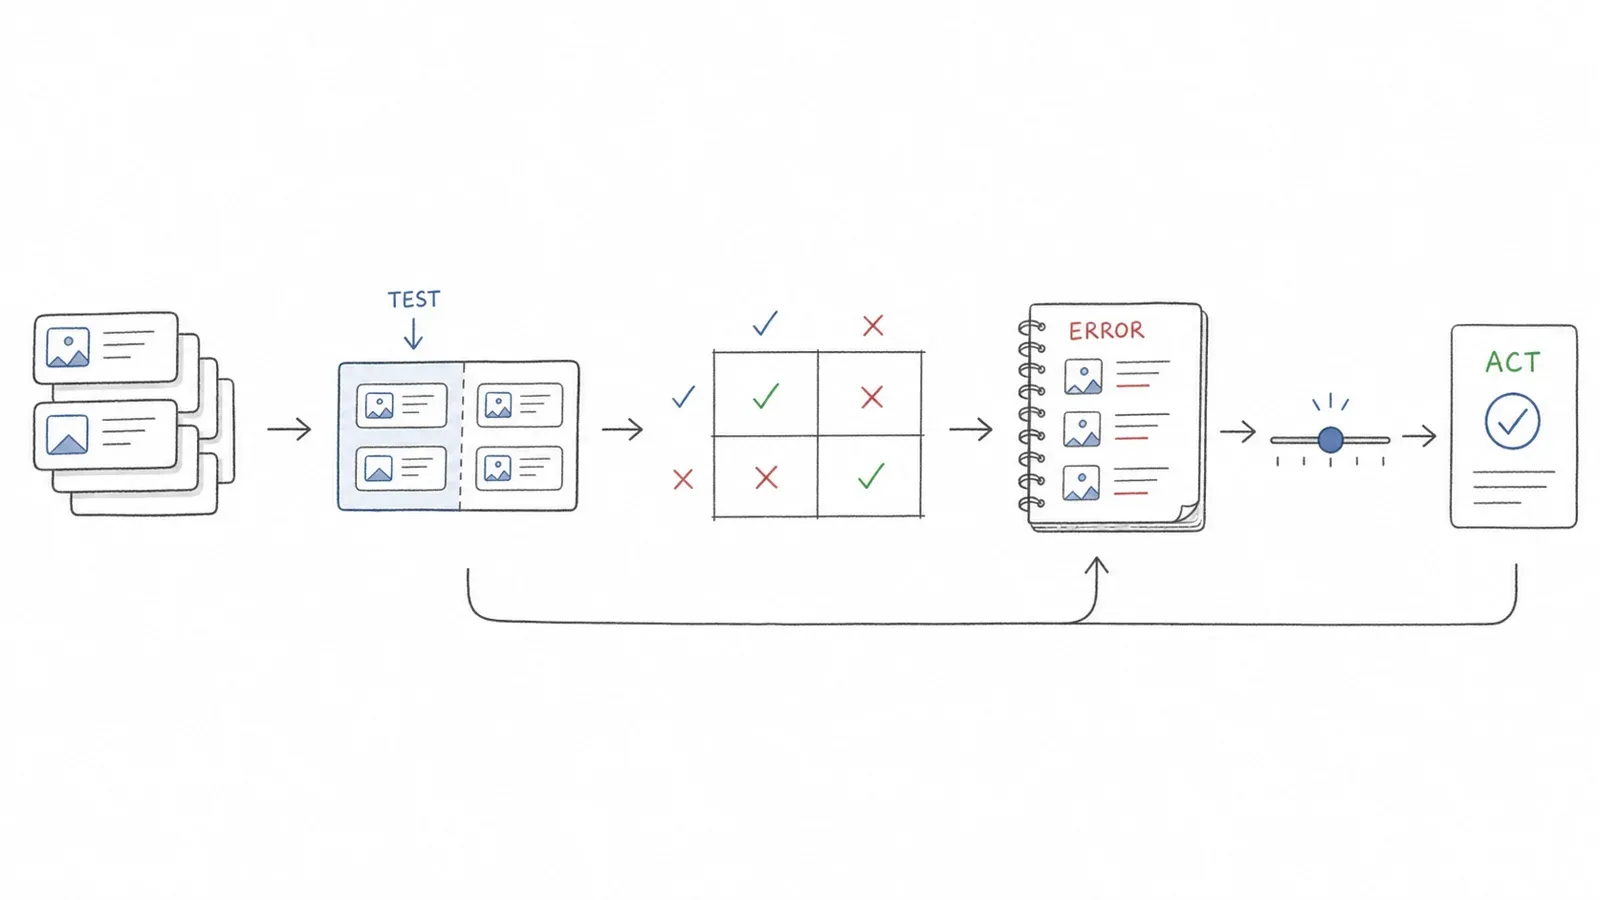
U transformer cesty ručně označ malý aktuální vzorek (50–100 tweetů), spusť model a porovnej. Uveď macro F1, precision a recall pro jednotlivé třídy i confusion matrix. Pokud to děláš pro reálný projekt, zkontroluj také kalibraci a nastav práh pro odmítnutí u nejednoznačných případů.
Krok 5: Otestuj okrajové případy
Zkus několik tweetů, které testují sarkasmus, emoji a slang:
edge_cases = [
    "Oh great, another update that breaks everything 🙄",
    "ngl this product slaps 🔥🔥🔥",
    "The camera is amazing but the battery life is trash",
    "Just got my order. It's... fine. I guess.",
]
for tweet in edge_cases:
    clean = normalize_social_text(tweet)
    result = classifier(clean)
    print(f"Tweet: {tweet}\nScores: {result}\n")
Sleduj, kde má model pravdu a kde selhává. Tweety se smíšeným cílem („kamera je skvělá, ale baterie je mizerná“) jsou známou výzvou — sentiment podle aspektu je samostatná úloha.
Twitter sentiment analýza bez psaní kódu
Ne každý chce psát Python, a to je v pořádku. Pokud jsi marketér, brand manažer nebo vedoucí provozu a potřebuješ sentiment insighty bez sahání na kód, tady je tvoje cesta.
Jedno upřímné upozornění: no-code nástroje vyměňují možnost přizpůsobení za rychlost. Jsou ideální pro rychlé sledování značky, ne pro výzkumně přesnou analýzu nebo trénování vlastního modelu.
Přehled no-code možností
| Nástroj | Nejlepší pro | Vestavěný sentiment? | Cenové rozpětí |
|---|---|---|---|
| AWS Comprehend | Analýza textu v podnikové škále | Ano | Platba podle použití |
| Brandwatch / Sprinklr | Kompletní sada pro social listening | Ano | Enterprise ceny |
| Google Sheets + NLP doplňky | Rychlá lehká analýza | Přes doplněk | Zdarma–nízké |
| Thunderbit + tabulka | Strukturování a označování dat z kompatibilních stránek | AI Field Prompt pro orientační štítky | K dispozici free tier |
No-code workflow: Sbírej data, klasifikuj v tabulce
Praktický postup pro někoho, kdo už má tweetová data (získaná přes oficiální X API, autorizovaného poskytovatele nebo vlastní archiv):
- Exportuj tweetová data do tabulky. Pokud jsi použil X API, exportuj JSON do CSV nebo použij nástroj jako Thunderbit pro strukturování a export dat z kompatibilních stránek, kde máš oprávnění k automatizaci.
- Otevři je v Google Sheets. Vlož nebo naimportuj text tweetů do sloupce.
- Použij sentiment klasifikátor. Využij Google Sheets NLP doplněk (zkontroluj aktuální možnosti v marketplace) nebo službu jako AWS Comprehend. Některé doplňky umí klasifikovat sentiment přímo ve vzorci buňky.
- Zkontroluj a vizualizuj. Pomocí vestavěných grafů v Google Sheets vytvoř sloupcový graf distribuce sentimentu nebo časovou řadu sentimentu.
Thunderbit AI Field Prompt může také při extrakci přidat sentimentový štítek na základě promptu na kompatibilních stránkách — užitečné pro průzkumný monitoring. U auditovaných nebo vysoce citlivých rozhodnutí ale vždy validuj vzorek a použij zdokumentovaný model.
Kdy použít no-code a kdy Python
| Scénář | Doporučený postup |
|---|---|
| Rychlá kontrola značky, malý objem | No-code (tabulka + doplněk) |
| Týmový dashboard, týdenní reporting | No-code nebo low-code |
| Analýza ve velkém měřítku, vlastní modely | Python |
| Akademický výzkum, reprodukovatelnost | Python |
| Monitoring v reálném čase ve velkém | Python + API + plánovaný pipeline |
Vizualizace výsledků Twitter sentiment analýzy
Většina návodů skončí u classification reportu. Pokud ale chceš výsledky sdílet s týmem nebo podle nich rozhodovat, potřebuješ vizualizace.
Sloupcový graf distribuce sentimentu
Nejzákladnější, ale univerzálně užitečný výstup:
import matplotlib.pyplot as plt
import seaborn as sns

sentiment_counts = df["label"].value_counts()
sns.barplot(x=sentiment_counts.index, y=sentiment_counts.values, palette="coolwarm")
plt.xlabel("Sentiment")
plt.ylabel("Počet tweetů")
plt.title("Distribuce sentimentu")
plt.show()
Word cloud podle sentimentové třídy
Oddělené word cloudy pro pozitivní a negativní tweety ukážou, co lidé skutečně říkají:
from wordcloud import WordCloud

for sentiment in ["positive", "negative"]:
    text = " ".join(df[df["label"] == sentiment]["clean_text"])
    wc = WordCloud(width=800, height=400, background_color="white").generate(text)
    plt.figure(figsize=(10, 5))
    plt.imshow(wc, interpolation="bilinear")
    plt.axis("off")
    plt.title(f"Word Cloud: {sentiment.capitalize()} Tweety")
    plt.show()
Sentiment v čase: graf, který nikdo jiný neukáže
Tohle je vizualizace, která promění surová data v příběh. Pokud máš časové značky, můžeš sledovat, jak se sentiment mění během události, spuštění produktu nebo krize:
df["date"] = pd.to_datetime(df["date"])
df["day"] = df["date"].dt.date
sentiment_map = {"positive": 1, "neutral": 0, "negative": -1}
df["score"] = df["label"].map(sentiment_map)
daily = df.groupby("day")["score"].mean()

plt.figure(figsize=(12, 5))
daily.plot()
plt.xlabel("Datum")
plt.ylabel("Průměrné sentimentové skóre")
plt.title("Sentiment v čase")
plt.axhline(0, color="gray", linestyle="--")
plt.show()
Náhlý pokles v den spuštění? To je signál, že se máš podívat na negativní tweety a zjistit, co se pokazilo.
Heatmapa confusion matrix
Už byla ukázána ve výše uvedeném kroku vyhodnocení. Důležité je sledovat, kde model plete pozitivní s negativním (nebo naopak). Právě ty tweety stojí za manuální přečtení.
Pro ty, kdo nekódují: grafy v Google Sheets nebo Notion
Pokud jsi exportoval sentimentem označená data do tabulky, můžeš graf distribuce i trendů vytvářet přímo v Google Sheets, Notion nebo v jakémkoli BI nástroji. Python není nutný.
Časté chyby v Twitter sentiment analýze (a jak se jim vyhnout)
V reálných sentiment workflow se pořád opakují stejné chyby.
Sarkasmus a ironie
Největší zabiják přesnosti. „Love waiting three hours for support 😒“ vypadá pro pravidlový model pozitivně. Transformer modely jsou lepší, ale sarkasmus zůstává strukturálně obtížný — zejména když příspěvek nemá kontext (vlákno, historii autora, událost). U vysoce citlivých případů kombinuj výstup modelu s lidskou kontrolou.
Slepá místa u emoji a slangu
Pokud tvoje preprocessing emoji smaže místo toho, aby je převedl na text (u sparse modelů) nebo je zachoval (u transformerů), zahazuješ některé z nejsilnějších sentimentových signálů v datech. Totéž platí pro slang — „ngl this slaps“ je pozitivní, ale model trénovaný na formální angličtině to nemusí poznat.
Zastaralé API návody a nefunkční scrapery
Pokud návod používá Tweepy s API v1.1, je zastaralý. Pokud doporučuje snscrape, pro vyhledávání na X to nefunguje od roku 2023. Vždy kontroluj datum a verzi API u každého návodu, kterým se řídíš.
Přeučení na jediném datasetu
Sentiment140 je skvělý na trénink, ale je z roku 2009. Audity 20 sociálně-mediálních datasetů z EMNLP 2024 zjistily, že odstranění duplicit snížilo F1 u 14 z 19 testovaných datasetů a změnilo pořadí modelů u 17 z 19. Používej časově oddělené splitování, oddělené eventy a ideálně i oddělené autory. Otestuj model na čerstvých tweetech, abys zjistil, jestli generalizuje.
Zacházení se sentiment skóre jako s pravdou
Skóre modelu není kalibrovaná pravděpodobnost. Nespouštěj automatické reakce ani veřejně viditelná rozhodnutí jen na základě sentiment štítku. U rozhodnutí, která se dotýkají jednotlivců nebo krizové komunikace, vždy vyžaduj lidskou kontrolu.
Soukromí, pravidla platformy a odpovědné používání
Tahleta sekce není volitelná.
X Developer Policy klade důraz na soukromí, kontrolu uživatelem, mazání obsahu a omezení párování mimo X. Praktická pravidla:
- Shromažďuj jen nezbytná pole.
- Agreguj výsledky místo zveřejňování surových handleů.
- Uchovávej Post ID a čas získání kvůli souladu.
- Odstraň nebo aktualizuj uložený obsah po smazání, změně ochrany nebo oprávněné žádosti.
- Neodvozuj citlivé vlastnosti jednotlivců.
- Nespojuj sentiment skóre s identitami v CRM bez oprávněného základu a souhlasu.
- Netrénuj ani nedolaďuj foundation model na X Content tam, kde to zakazují restricted-use rules.
- Dokumentuj velikost vzorku, klíčová slova dotazu, časové okno, jazykové filtry a vyloučení.
- Nikdy neautomatizuj veřejnou odpověď jen ze sentiment skóre.
Sentiment analýza je silný nástroj, ale nese i skutečnou odpovědnost. Zacházej s ní podle toho.
Závěr a klíčové poznatky
Twitter sentiment analýza v roce 2026 funguje — ale jen pokud svůj přístup sladíš s aktuální realitou. Starý recept (bezplatné API, jen lowercase preprocessing, VADER nebo Naive Bayes, žádné vyhodnocení) je nefunkční. Co skutečně funguje:
- Získej data povolenou cestou. Použij X API v2 (pay-per-use), autorizovaného poskytovatele nebo transparentní dataset. Nespoléhej na nefunkční scrapery ani obcházení přes prohlížeč.
- Předzpracuj data podle modelu, ne jen na efekt. U transformerů zachovej emoji, negaci a velikost písmen. Normalizuj URL a zmínky. Přizpůsob pipeline trénovacím datům modelu.
- Porovnej levnou baseline s transformerem zaměřeným na tweety. TF-IDF + logistická regrese je pořád skvělá kontrola zdravého rozumu. CardiffNLP RoBERTa je dnešní silná výchozí volba pro sentiment tweetů.
- Vyhodnocuj poctivě. Uveď macro F1, metriky pro jednotlivé třídy a confusion matrix. Použij aktuální, ručně označený vzorek. Nastav práh pro odmítnutí u nejednoznačných případů.
- Vizualizuj kvůli rozhodování, ne jen pro parádu. Graf sentimentu v čase a word cloudy vyprávějí příběh, který classification report nedokáže.
- Nech v procesu lidi. Žádný model není dokonalý v sarkasmu, smíšených cílech ani kontextově závislém významu. U vysoce důležitých případů kombinuj výstup modelu s lidskou kontrolou.
Pokud začínáš, vezmi si zdarma dataset, otevři Google Colab a spusť HuggingFace pipeline. Funkční sentiment skóre budeš mít za méně než deset minut. Pokud chceš pro další části workflow bez kódu získávat a strukturovat webová data, Thunderbit ti může pomoci na kompatibilních stránkách, kde máš oprávnění k automatizaci.
A pokud to stavíš do portfolia nebo na pracovní pohovor: přidání porovnání transformerů, skutečného preprocessing pipeline a grafu sentimentu v čase tvůj projekt okamžitě odliší od běžného bootcampového standardu.
Další informace
- Jak zvládnout automatizované získávání dat s Thunderbit
- 6 nejlepších scraperů pro Twitter (x.com) v roce 2026
- Jak scrapovat tweety z Twitteru pomocí Pythonu v roce 2025
- Jak využít AI scraping na Twitteru pro lepší datové insighty
- Statistiky Twitteru (X) 2026: uživatelé, demografie a reklama
Časté dotazy
Je Twitter sentiment analýza přesná?
Záleží na modelu a na tom, jak ho vyhodnotíš. Pravidlové nástroje jako VADER mají na tweetových datech nižší výkon. Transformer modely jako CardiffNLP RoBERTa jsou výrazně lepší — ale přesná skóre se liší podle datasetu, splitu, definice labelů a metriky. Důležitá je také kvalita předzpracování. Vždy vyhodnocuj na aktuálním, ručně označeném vzorku, ne podle jediné benchmark hodnoty.
Můžu dělat Twitter sentiment analýzu zdarma?
Ano. Použij bezplatný dataset (Sentiment140 na Kaggle), bezplatné Python prostředí (Google Colab) a předtrénovaný HuggingFace model. Pro živá data si X účtuje $0.005 za přečtení Postu, takže menší sběr dat je cenově dostupný. Thunderbit nabízí free tier pro strukturování dat na kompatibilních stránkách.
Jaká je nejlepší Python knihovna pro Twitter sentiment analýzu?
Pro rychlý prototyp: VADER přes NLTK. Pro nejlepší přesnost na tweetech: knihovna HuggingFace transformers s modelem RoBERTa od CardiffNLP. Pro klasické ML baseline: scikit-learn s TF-IDF. Správná volba závisí na objemu, požadované přesnosti a výpočetním rozpočtu.
Jak mám v Twitter sentiment analýze řešit sarkasmus?
Transformer modely zvládají sarkasmus lépe než pravidlové nebo klasické ML modely, protože pracují s kontextem, ne jen s jednotlivými slovy. Ale žádný model není v sarkasmu dokonalý — výzkum ukazuje, že i lidské anotátory se na sarkastickém záměru neshodnou. U kritických použití kombinuj výstup modelu s lidskou kontrolou a zvaž použití datasetů zaměřených na sarkasmus pro evaluaci.
Mohu analyzovat sentiment na Twitteru bez programování?
Ano. Získej data povolenou cestou (X API, autorizovaný provider nebo vlastní archiv), exportuj je do Google Sheets a použij no-code sentiment klasifikátor přes NLP doplněk do Sheets nebo službu jako AWS Comprehend. Thunderbit může také při strukturním zpracování dat na kompatibilních stránkách přidat sentiment štítky na základě promptu. Více o no-code datových workflow najdeš v našem průvodci AI nástroji pro Google Sheets.



