
Keywords
web crawleři pro začátečníky, no-code web scraping, nástroje pro web crawling
Content
Web je rok od roku složitější a propast mezi „potřebuji tahle data“ a „vím, jak je získat“ zůstává nepříjemně široká. Pro začátečníka bývá první otázka jednoduchá: Musím se vážně učit Python jen proto, abych z webu stáhl ceny produktů?
Naštěstí ne. Jenže navazující otázka — který nástroj mám tedy použít? — už bývá výrazně zamotanější. Existují desktopové no-code aplikace, rozšíření do prohlížeče, Python frameworky, Go knihovny, SEO spideri, spravovaná API i open-source projekty, které hranice mezi tím vším stírají. Deset výrazných možností dostupných v roce 2026 vyniká hlavně v tom, co začátečníky opravdu zajímá: kolik programování je potřeba, jak rychle se dostanete k použitelným datům, zda nástroj zvládá weby s JavaScriptem, co dostanete zdarma a pro jaký konkrétní případ použití se skutečně hodí. Ať už jste nikdy nenapsali ani řádek kódu, nebo jste juniorní vývojář a hledáte svůj první crawler framework, tady najdete dobrý start.
Jak jsme vybírali nejlepší web crawlery pro začátečníky
„Začátečník“ neznamená „ne-technický“. Znamená to kohokoli, kdo ještě nikdy nepostavil workflow pro web crawling — včetně lidí, kteří umí napsat základní Python nebo JavaScript, ale nikdy neřešili frontu URL nebo soubor robots.txt.
Každý nástroj jsme hodnotili podle šesti kritérií, která přesně odpovídají otázkám, jež si začátečníci skutečně pokládají na fórech:
- Nutnost programování — žádné, základní Python/JS, nebo středně pokročilé a výš
- Náročnost nastavení — čas od instalace po první použitelná data
- Renderování JavaScriptu — zvládá SPA a stránky s dynamicky načítaným obsahem?
- Velkorysost free verze — co dostanete, než zaplatíte cokoliv
- Výstupní formáty — CSV, JSON, Excel, Google Sheets atd.
- Nejlepší použití — konkrétní scénář, ve kterém nástroj začátečníkovi opravdu pomůže
Seznam pokrývá tři úrovně dovedností: no-code (bez programování), středně pokročilé (základní Python nebo JavaScript) a pokročilý začátečník (Go nebo hlubší znalost frameworku). Snažil jsem se být upřímný v tom, kde který nástroj opravdu vyniká a kde naopak naráží na limity — protože zvolit špatný crawler vzhledem k úrovni vašich dovedností je jeden z nejrychlejších způsobů, jak promarnit celé odpoledne.
Vyberte si prvního web crawlera: rychlý rozhodovací diagram
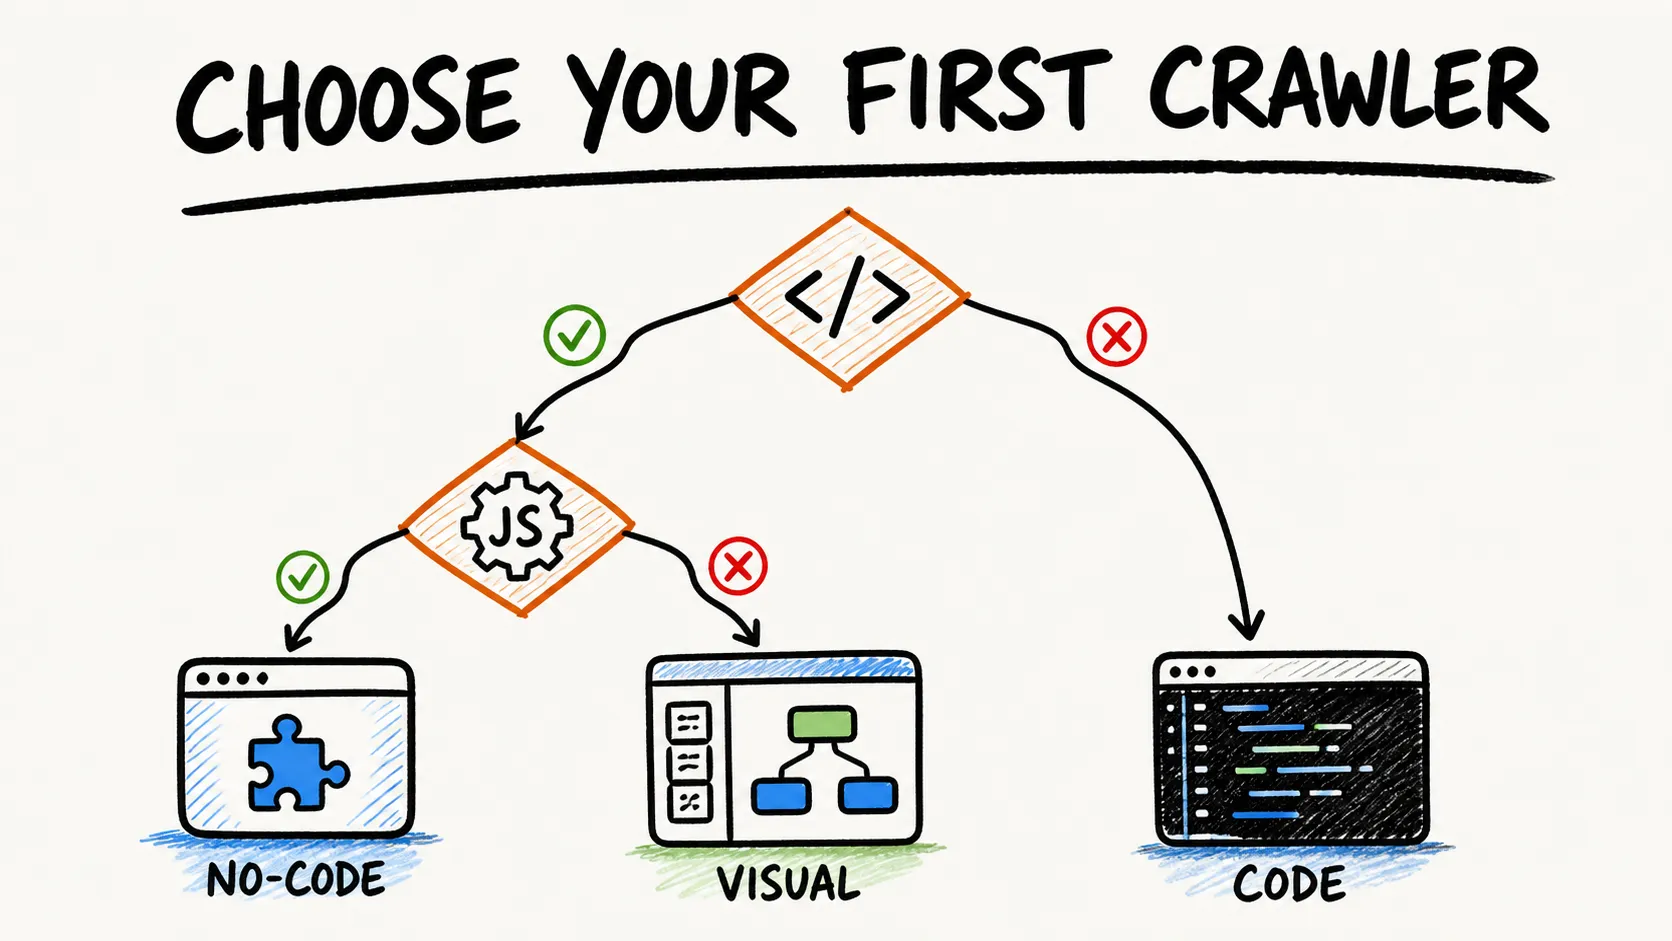
Než projdete deset recenzí nástrojů, odpovězte si na tři otázky. Jejich kombinace vás nasměruje k jednomu nebo dvěma vhodným nástrojům.
Otázka 1: Jaká je vaše úroveň pohodlí s kódem?
- Žádná → Přejděte na otázku 2a
- Základní Python → Přejděte na otázku 2b
- JavaScript/TypeScript → Přejděte na otázku 2c
- Go → Colly
Otázka 2a (bez kódu): Co je vaším hlavním cílem?
- Obecné získávání dat (informace o produktech, seznamy leadů, research) → Thunderbit nebo Octoparse
- Složitější vícekrokové flow (přihlášení, rozbalovací nabídky, infinite scroll) → ParseHub nebo Octoparse
- SEO audit → Screaming Frog
Otázka 2b (Python): Co je vaším hlavním cílem?
- AI/LLM pipeline (RAG, trénování chatbotů) → Crawl4AI nebo Firecrawl
- Velkoobjemový strukturovaný crawling převážně statických webů → Scrapy
- Automatizace prohlížeče na webech s JavaScriptem → Playwright (ale počítejte s tím, že si vlastní crawl logiku budete stavět sami)
Otázka 2c (JavaScript/TypeScript): Co je vaším hlavním cílem?
- Moderní crawling SPA s ochranou proti blokování → Crawlee
- Složitá práce v prohlížeči (přihlášení, klikání, screenshoty) → Playwright
- Čistý markdown pro AI zpracování → Firecrawl (přes API/SDK)
Filtr podle rozpočtu: Pokud potřebujete software za 0 Kč a můžete provozovat vše sami, open-source nástroje zde (Scrapy, Crawlee, Crawl4AI, Playwright a Colly) nemají žádný limit stránek daný dodavatelem, i když pořád platí náklady na výpočetní výkon, šířku pásma, úložiště, údržbu a limity cílového webu. Pokud si nemůžete vše hostovat sami, Octoparse, ParseHub, Thunderbit, Firecrawl a Screaming Frog nabízejí bezplatnou variantu s různými omezeními.
Jen tenhle diagram vám může ušetřit hodiny přepínání mezi záložkami. Uložte si ho.
Nejlepší web crawlery pro začátečníky na první pohled
Tady je kompletní srovnávací tabulka. „Coding Required“ říká, jaký jazyk budete potřebovat, pokud vůbec nějaký. „JS Rendering“ ukazuje, zda nástroj zvládne stránky, které načítají obsah přes JavaScript. „Free Tier“ shrnuje, co dostanete za 0 Kč. Podrobné recenze následují níže.
| Nástroj | Úroveň | Nutnost programování | JS Rendering | Free tier | Nejlepší pro |
|---|---|---|---|---|---|
| Octoparse | Začátečník | Žádné | ✅ Vestavěné | Free plán: 10 úloh, jen lokálně, 10K řádků/export | Klikací scraping strukturovaných webů |
| ParseHub | Začátečník | Žádné | ✅ Vestavěné | 5 veřejných projektů, 200 stránek/spuštění, uchování 14 dní | Složité vícestránkové flow bez kódu |
| Thunderbit | Začátečník | Žádné | ✅ Přes prohlížeč | Free tier (ověřte aktuální limity) | AI asistované získávání dat ze stránky, kterou právě máte otevřenou |
| Crawl4AI | Středně pokročilý | Python | ✅ Chromium | Open source (self-hosted) | Crawling připravený pro LLM a RAG pipeline |
| Firecrawl | Středně pokročilý | API/SDK | ✅ Spravované | 1,000 kreditů/měsíc (cloud) | Čistý markdown výstup pro AI zpracování |
| Scrapy | Středně pokročilý | Python | ⚠️ Vyžaduje plugin | Open source (BSD) | Velkoobjemové, vysoce přizpůsobitelné HTTP crawl projekty |
| Crawlee | Středně pokročilý | JS/TS nebo Python | ✅ Přes Playwright | Open source (Apache) | Moderní JS crawling s ochranou proti blokování |
| Playwright | Středně pokročilý | Python/JS/Java/.NET | ✅ Nativně | Open source (Apache) | Automatizace prohlížeče + interakce s weby s hodně JavaScriptem |
| Screaming Frog | Začátečník | Žádné | ✅ (jen placeně) | 500 URL/crawl (navždy zdarma) | SEO audit a technická analýza webu |
| Colly | Pokročilý začátečník | Go | ⚠️ Bez vestavby | Open source (Apache) | Rychlý, lehký paralelní HTTP crawling |
Teď k podrobnému rozboru.
1. Octoparse

Octoparse je desktopový no-code nástroj pro tvorbu úloh s možností placeného cloudového spuštění. Vložíte URL, necháte Auto-detect najít opakující se datová pole a navigační vzory, zkontrolujete náhled a pak úlohu spustíte lokálně. Vizuální editor workflow podporuje smyčky, větvení, stránkování, infinite scroll, AJAX, formuláře i rozbalovací nabídky — i když dynamické flow někdy vyžadují ruční doladění časování.
Klíčové funkce:
- Auto-detect pro datová pole a navigaci mezi stránkami
- Vestavěné renderování JavaScriptu přes interní prohlížeč
- Stovky hotových šablon pro běžné weby
- Upravitelné workflow s vlastními smyčkami, větvením a selektory
- Export do Excelu, CSV, HTML, JSON, XML, Google Sheets a databází (podle plánu)
Cena: Omezený free tier podporuje lokální spuštění. Cloudové běhy, plánování, rotace IP a přístup přes API vyžadují placený plán. Před závazným rozhodnutím si ověřte aktuální cenu, protože limity plánů se mění.
Nejlepší pro: Začátečníky, kteří chtějí opakovaně získávat strukturovaná data z e-commerce webů, adresářů nebo seznamových stránek — bez programování. Méně vhodné, pokud potřebujete pohodlí rozšíření do prohlížeče nebo výstupy připravené přímo pro LLM.
2. ParseHub
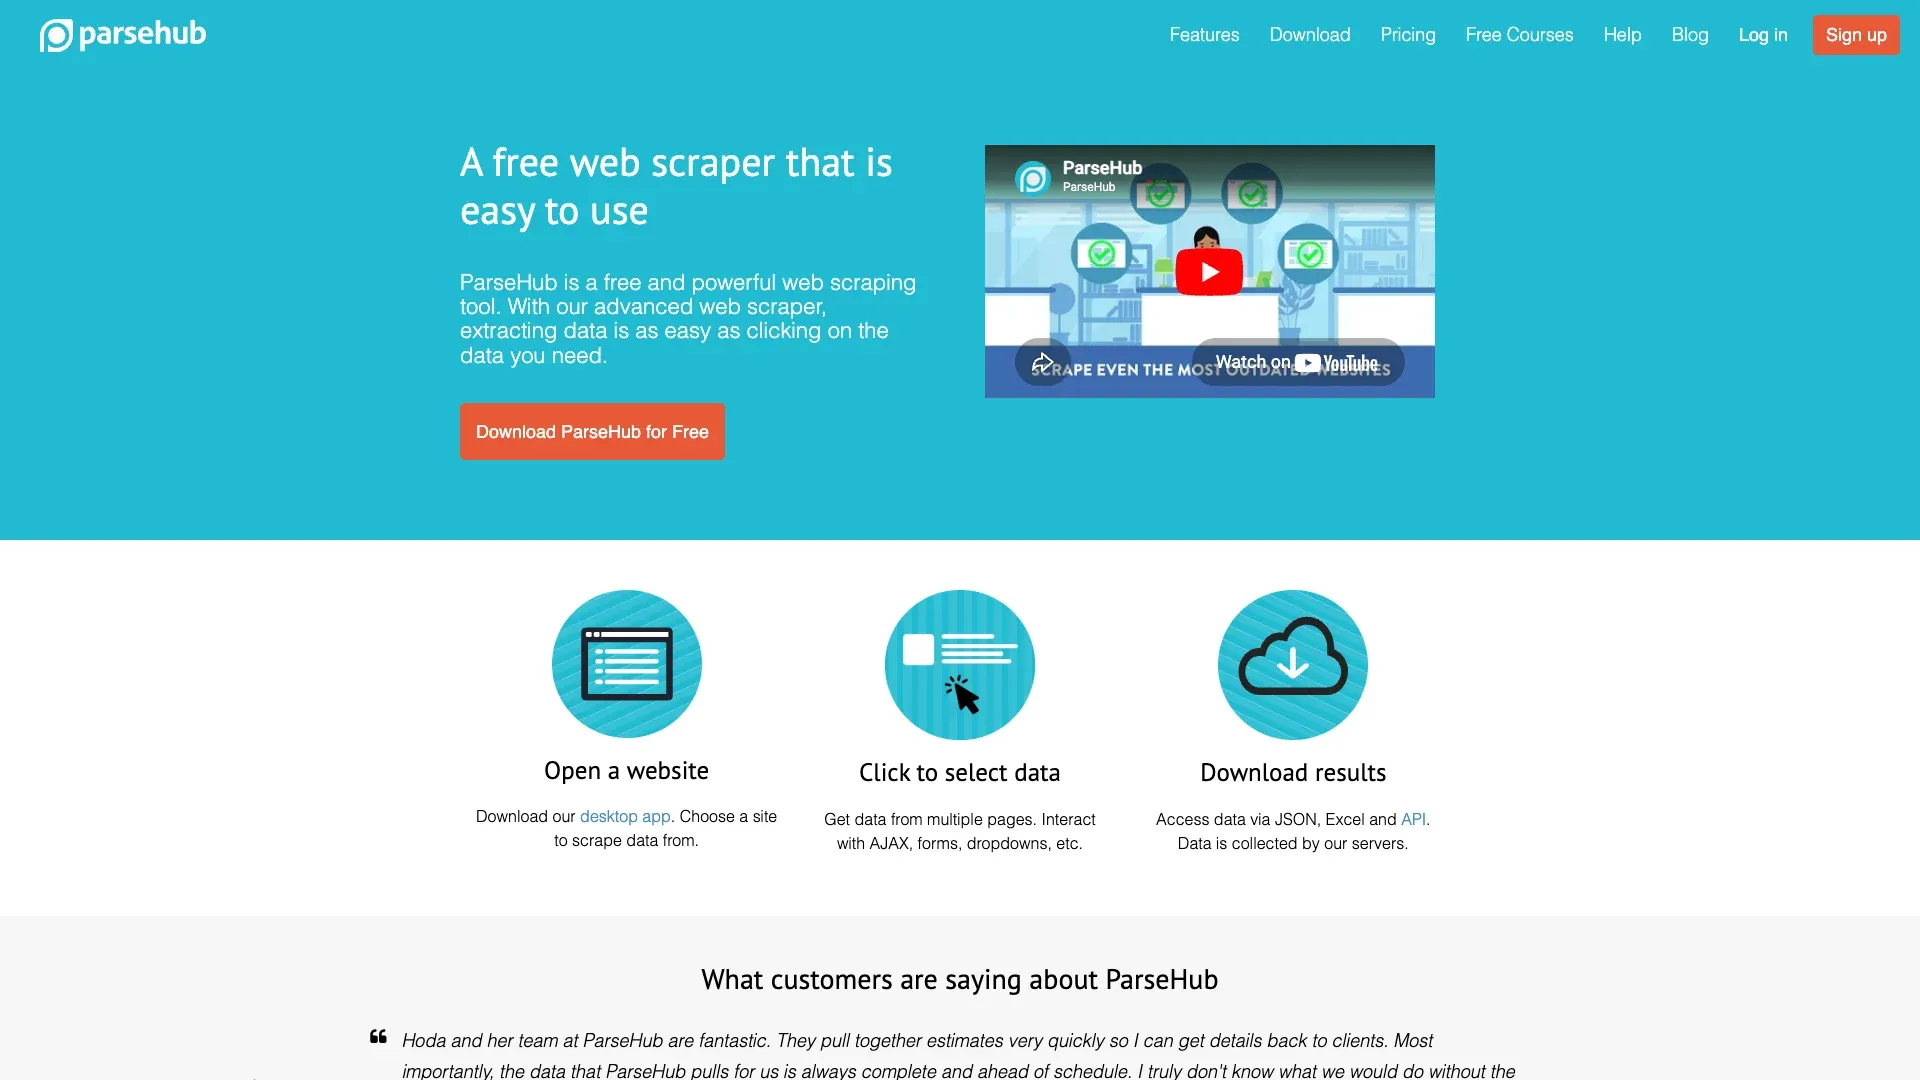
ParseHub je vizuální extraktor ke stažení pro Windows, macOS a Linux (přes AppImage). Jeho rozhraní s komandovým stromem modeluje výběry, kliknutí, zadávání do formulářů, scrollování a šablony stránek. Podporuje AJAX/JavaScript, rozbalovací nabídky, záložky, popupy, stránkování, přihlašovací formuláře a infinite scroll.
Klíčové funkce:
- Vizuální strom příkazů pro vícekrokové extrakční flow
- Zvládá AJAX, JavaScript, dropdowny, záložky a infinite scroll
- Desktopová aplikace pro Windows, macOS i Linux
- Přístup přes API pro programové získávání dat
- Export do CSV a JSON
Cena: K dispozici jsou bezplatné i placené plány. Zpoplatněná „stránka“ může být URL nebo dynamické načtení obsahu spuštěné kliknutím či scrollováním, takže povolený počet stránek nemusí vždy odpovídat stejnému počtu URL. Před výběrem plánu si ověřte aktuální limity projektů, spuštění a uchování dat.
Bezpečnostní upozornění k soukromí: Do cizího crawleru nevkládejte produkční přihlašovací údaje, dokud si neověříte, jak nástroj ukládá přihlašovací vstupy a projektová data. Pro testování používejte omezený testovací účet.
Nejlepší pro: Začátečníky, kteří potřebují scraping dynamických, vícekrokových webů (složitá navigace, rozbalovací nabídky nebo načítání na základě scrollování) bez psaní kódu.
ParseHub vs. Octoparse: klíčové rozdíly
Oba nástroje jsou no-code desktopová řešení, která zvládají JavaScript. ParseHub díky modelu komandového stromu nabízí explicitnější kontrolu nad vícekrokovými flow — to se hodí u složitější navigace, ale pro jednoduché úkoly je vstupní práh vyšší. Auto-detect v Octoparse je rychlejší pro přímočaré strukturované weby a free plán nabízí štědřejší limity exportu. Pokud je cílový web hlavně o tabulkách a seznamech, začněte s Octoparse. Pokud potřebujete modelovat sérii kliknutí, vyplňování formulářů a podmíněnou navigaci, může být přístup ParseHub srozumitelnější.
3. Thunderbit

Thunderbit je agentický web scrapingový doplněk do prohlížeče pro Chrome a Edge, vytvořený pro netechnické firemní uživatele, kteří chtějí získat data ze stránky, kterou už mají otevřenou. (Plné odhalení: pracuji v Thunderbit, takže budu otevřený jak ohledně předností, tak omezení.)
Klíčové funkce:
- One Click Extract automaticky detekuje sloupce podle obsahu stránky
- AI prompty na úrovni jednotlivých polí pro kategorizaci, překlad, formátování a normalizaci při extrakci
- Export do Excel/CSV, Google Sheets, Airtable a Notion
- Browser Mode pracuje s vykreslenou relací uživatele a na kompatibilních stránkách zvládá obsah načítaný přes JavaScript
- Bez nutnosti instalace dalšího softwaru kromě rozšíření do prohlížeče
Cena: Free tier aktuálně zahrnuje 6 stránek za měsíc s maximálně 30 kredity na stránku. Starter ($15/měsíc nebo $9/měsíc při roční fakturaci) přidává stránkování, scraping podstránek, hromadný scraping, enrichment, předpřipravené scrapery a plánování. Aktuální ceny najdete zde.
Omezení, která stojí za zmínku: Thunderbit je orientovaný na stránku a její schéma, ne na plnohodnotný crawler pro objevování celých domén. Stránkování a scraping podstránek jsou ve Free verzi nedostupné, patří do Starteru. AI navržená pole je třeba před spuštěním vždy zkontrolovat — návrhy jsou dobré, ale ne neomylné.
Nejlepší pro: Týmy sales, operations a research, které potřebují strukturovaná data ze stránky otevřené v prohlížeči, a chtějí pomoc AI, aby nemusely ručně nastavovat pole. Pokud hledáte rychlý způsob, jak vytáhnout tabulku, seznam nebo sadu záznamů z kompatibilní stránky a exportovat je do tabulky, tohle je podle mě nejrychlejší cesta.
Více o tom, jak AI asistovaná extrakce funguje v praxi, najdete v našem průvodci AI web scrapingem.
Vynechte kód a začněte na jedno kliknutí Agentický web scraper Thunderbit přečte libovolnou stránku a sám vybere pole, takže nepotřebujete kód — ideální první crawler pro začátečníky. Get Started Free
4. Crawl4AI
Crawl4AI je open-source Python crawler orientovaný na prohlížeč, navržený pro čistý výstup do LLM workflow. Umí vracet surové i očištěné HTML, více variant Markdownu, strukturovaný extrahovaný obsah, odkazy, média, tabulky, screenshoty, PDF i MHTML.
Klíčové funkce:
- AsyncWebCrawler s Chromium/Playwright pod kapotou
- Více výstupních formátů optimalizovaných pro RAG pipeline a agentní workflow
- Adaptivní crawling, který vyhodnocuje pokrytí, konzistenci a saturaci, aby upřednostnil relevantní odkazy a skončil, když je informací dost
- Volitelná LLM extrakce přes lokální providery (Ollama) nebo cloudová API
- Licence Apache-2.0 s dalším požadavkem na uvedení autorství
Cena: Plně open source — bez poplatku za stránku. Infrastrukturou se staráte sami a případně platíte za LLM inference (lokální nebo cloudovou).
Omezení: Vyžaduje znalost Python async a závislosti na prohlížeči. Kvalita extrakce závisí na použitých LLM, pokud nějaké používáte. Adaptivní crawler upřednostňuje relevantní odkazy podle signálů o dostatku informací — natrvalo se neučí ani „sám neopravuje“ CSS selektory.
Nejlepší pro: Středně pokročilé uživatele Pythonu, kteří staví AI datové pipeline a chtějí plnou kontrolu bez vendor poplatků za každý request.
5. Firecrawl
Firecrawl je spravované API pro webová data (se SDK pro Python a Node.js) a také self-hosted kódová základna s licencí AGPL. Cloudová služba zpracuje JavaScript a vrací Markdown, shrnutí, HTML, odkazy, obrázky, screenshoty, JSON i sledování změn.
Klíčové funkce:
- Endpoint
/crawls filtry cest, hloubkou objevování, sitemapami, limity, prodlevami a řízením paralelismu - Automatické renderování JavaScriptu v managed cloudu
- Více výstupních formátů včetně čistého Markdownu
- Endpoint
/mappro rychlé zjištění struktury webu - Browser/Interact a beta agentní cesty pro vícekrokovou interakci (oddělené od základního crawl)
Cena: Cloud Free nabízí 1,000 kreditů měsíčně se dvěma souběžnými requesty a nízkými rate limity. Placené tarify fungují na kreditech a konkurenci — aktuální čísla ověřte na stránce s cenami. Self-hosting přesouvá infrastrukturu i údržbu na vás a nezahrnuje všechny funkce spravovaného cloudu.
Omezení: Základní /crawl prochází URL rekurzivně přes odkazy a sitemapu, ale negarantuje libovolné click-based stránkování. Náklady v kreditech se liší podle typu operace. Funkce self-hosted a cloud se liší.
Nejlepší pro: Středně pokročilé uživatele, kteří chtějí dostat obsah webu do LLM, chatbotů nebo knowledge base a dávají přednost spravované službě před vlastním provozem browser stacku.
Firecrawl vs. Crawl4AI: co je lepší pro AI pipeline?
Firecrawl vyniká spravovanou konverzí do Markdownu a čistým API — pošlete URL a dostanete strukturovaný výstup. Crawl4AI naopak září tam, kde chcete provozovat vše lokálně a plně ovládat prohlížeč i volitelné LLM. Pokud chcete minimum provozní režie, cloud Firecrawl je jednodušší cesta. Pokud chcete plný self-hosting bez poplatku za stránku a vyhovuje vám Python async, Crawl4AI vám dá větší kontrolu.
6. Scrapy
Scrapy je dlouhodobě zavedený Python framework pro crawling a scraping s licencí BSD, postavený na async enginu Twisted. Nabízí plánování requestů, následování odkazů, deduplikaci, middleware, opakované pokusy, throttling, pipeline a exporty feedů do JSON, JSON Lines, CSV, XML, pickle a marshal.
Klíčové funkce:
- Asynchronní zpracování requestů vhodné pro velké, pečlivě ohraničené crawly
- Rozsáhlý ekosystém middleware (proxy, retries, throttling, vlastní hlavičky)
- Strukturovaná pipeline architektura pro čištění a ukládání dat
- Obrovská komunita, dokumentace a rozšíření třetích stran
- Plně open source (licence BSD)
Omezení: Nemá nativní renderování JavaScriptu. Oficiální doporučení pro dynamický obsah radí, pokud je to možné, najít původní datový zdroj nebo záměrně integrovat browser/render komponentu (např. scrapy-playwright). Architektura — spideři, middleware, item pipelines, settings — má reálnou učební křivku.
Cena: Zdarma. Hostujete si ho sami.
Nejlepší pro: Středně pokročilé uživatele Pythonu, kteří potřebují ve velkém crawlvat hlavně statické nebo serverově renderované weby.
Začínáme se Scrapy: anotovaný rychlý start
Tady je minimální cesta od instalace k prvním datům:
pip install scrapy
scrapy startproject beginner_crawl
cd beginner_crawl
scrapy genspider example example.com
Otevřete beginner_crawl/spiders/example.py a upravte ho:
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    allowed_domains = ["example.com"]       # Zůstaňte jen na této doméně
    start_urls = ["https://example.com"]    # Úvodní URL

    custom_settings = {
        "ROBOTSTXT_OBEY": True,            # Respektujte robots.txt
        "DOWNLOAD_DELAY": 2,               # Počkejte 2 sekundy mezi requesty
        "CLOSESPIDER_PAGECOUNT": 10,       # Zastavte po 10 stránkách (bezpečnostní limit)
        "USER_AGENT": "Beginner-Crawl-Bot (+https://yoursite.com/bot-info)",
    }

    def parse(self, response):
        yield {
            "title": response.css("title::text").get(),
            "url": response.url,
        }
        # Následujte odkazy na stránce (uvnitř allowed_domains)
        for link in response.css("a::attr(href)").getall():
            yield response.follow(link, callback=self.parse)
Spusťte ho:
scrapy crawl example -o output.json
Než budete škálovat, otestujte selektory nejdřív přes scrapy shell "https://example.com". Doba nastavení závisí na vašich zkušenostech s Pythonem — pokud teprve začínáte s virtuálními prostředími a terminálem, nečekejte hotovo za deset minut.
7. Crawlee
Crawlee je crawler knihovna s licencí Apache pro JavaScript/TypeScript a Python, kterou spravuje Apify. Nabízí jak čistě HTTP třídy (např. CheerioCrawler), tak browser crawlery přes Playwright/Puppeteer, request queue, datasety, správu session, opakované pokusy a limity.
Klíčové funkce:
- Zvolte projektově HTTP-first (CheerioCrawler), nebo plný browser (PlaywrightCrawler)
- Vestavěná fronta requestů, deduplikace a ukládání datasetů
- Správa session, browser fingerprintů, retry a hranice požadavků
- TypeScript-first s použitelnou podporou Pythonu
- Oficiální quickstart doporučuje HTTP-first, pokud jsou data přímo v HTML
Cena: Zdarma. Open source, self-hosted.
Omezení: Vyžaduje znalost JavaScriptu/TypeScriptu nebo Pythonu. Méně komunitní dokumentace než Scrapy. Anti-blocking funkce neznamenají oprávnění ani záruku přístupu — snižují riziko detekce, ale nečiní neoprávněné crawlingování přípustným.
Nejlepší pro: Středně pokročilé JavaScript vývojáře, kteří potřebují crawlvat moderní SPA a weby renderované v prohlížeči s vestavěnou správou fronty a ochranou proti blokování.
Crawlee quickstart: od instalace k prvním datům
npx crawlee create my-crawler
cd my-crawler
V průvodci nastavením vyberte šablonu Playwright.
Upravte handler v src/routes.ts podle toho, co chcete získat, a pak spusťte:
npm start
Výsledky se uloží jako JSON v lokálním dataset adresáři. Než budete škálovat, přidejte maxRequestsPerCrawl, omezení hloubky, pravidla pro stejnou doménu a rozumný limit paralelismu.
8. Playwright
Playwright je Microsoftem vyvíjený browser automation framework s licencí Apache, který podporuje Python, Node.js, Java i .NET. Ovládá skutečné prohlížeče Chromium, Firefox a WebKit — což z něj dělá skvělou volbu pro stránky s JavaScriptem, přihlašovací flow nebo složitými interakcemi.
Klíčové funkce:
- Nativní renderování v reálném prohlížeči napříč třemi enginy
- Zvládá SPA, přihlášení, klikání, vyplňování formulářů, stahování souborů, screenshoty i PDF
- Podpora více jazyků (Python, JS/TS, Java, .NET)
- Výborná dokumentace a aktivní vývoj
- Záchyt síťové komunikace a mocking requestů
Co Playwright není: Kompletní crawler. Nemá nativní frontu URL, deduplikaci, politeness policy, model retry ani export feedů. Tyto části si musíte postavit sami — nebo Playwright propojit s frameworkem typu Crawlee, který je poskytne.
Cena: Zdarma. Open source.
Nejlepší pro: Středně pokročilé vývojáře, kteří potřebují automatizovat práci s prohlížečem na webech s velkým množstvím JavaScriptu nebo s ochranou přihlášením a zároveň jsou ochotni si kolem toho postavit vlastní crawl logiku.
9. Screaming Frog
Screaming Frog SEO Spider je desktopový nástroj pro technický SEO crawling pro Windows, macOS a Linux. Není to obecný nástroj pro extrakci dat — je to crawler, ke kterému se sahá při SEO auditu, hledání nefunkčních odkazů, redirect chainů, duplicitního obsahu, chybějících metadat a stovek dalších technických SEO problémů.
Klíčové funkce:
- Crawl až 500 URL zdarma (trvale, ne zkušebně)
- Odhaluje nefunkční odkazy, redirect chainy, duplicitní obsah, chybějící metadata
- Podrobné záložky pro title stránky, meta description, nadpisy, obrázky a další
- Placená verze přidává renderování JavaScriptu, ukládání crawlů, vlastní extrakci, integraci s GA/GSC a AI integrace (OpenAI, Gemini, Anthropic, Ollama)
Cena: Free verze je navždy zdarma do 500 URL/crawl, ale bez renderování JavaScriptu, pokročilé konfigurace, vlastní extrakce a integrací. Licence stojí £199 / $279 / €245 na uživatele a rok.
Omezení: Pro ne-SEO uživatele má strmou učební křivku. Spotřebovává lokální zdroje zařízení (u velkých webů hlavně paměť). Nemá měsíční tarif. Není určen pro obecnou extrakci dat — je to auditní nástroj.
Nejlepší pro: Začátečníky zaměřené na SEO audit a technickou analýzu webu. Pokud chcete vytáhnout produktová data nebo budovat seznamy leadů, sáhněte jinam.
10. Colly
Colly je Go framework pro HTTP crawling/scraping s licencí Apache, callbackovým API, řízením paralelismu, sessions/cookies, frontami, cache a vyměnitelnými úložišti.
Klíčové funkce:
- Rychlý paralelní HTTP crawling s nízkou spotřebou zdrojů
- Čisté API založené na callbackách
- Vestavěná práce s cookies/session a cache
- Rate limiting na úrovni domény přes LimitRule
- Současná instalace:
go get github.com/gocolly/colly/v2
Důležité varování pro začátečníky: Aktuální zdroj Colly nastavuje IgnoreRobotsTxt = true jako výchozí. Musíte jej výslovně přepnout na false a nakonfigurovat LimitRule s odpovídající prodlevou a paralelismem. Bez toho bude Colly robots.txt ignorovat a může snadno přetížit cílový server.
Cena: Zdarma. Open source.
Omezení: Vyžaduje znalost programování v Go. Nemá vestavěný renderer JavaScriptu ani univerzální exportní mechanismus — výstup si serializujete sami. Menší komunita než u Python nástrojů.
Nejlepší pro: Pokročilé začátečníky, kteří umí Go a potřebují rychlý, lehký HTTP crawler pro statické weby nebo API — pokud si explicitně nastaví robots a rate limity.
Porovnání free tierů: co skutečně dostanete, než zaplatíte
Tohle je tabulka pro začátečníky, kteří řeší rozpočet. Každý nástroj níže spadá do jedné ze dvou kategorií: freemium produkty (omezené, ale bez vlastní infrastruktury) a open-source nástroje (neomezený počet stránek, ale hostujete vše sami).
Freemium / desktop free plány
| Nástroj | Free limit | Omezení projektu/úlohy | Omezení exportu | Časově omezené? | Hlavní uzamčené funkce |
|---|---|---|---|---|---|
| Octoparse | Neomezené stránky/crawl | 10 úloh | 10K řádků/export; 50K řádků/měsíc | Ne (trvale) | Cloud, plánování, rotace IP, API |
| ParseHub | 200 stránek/spuštění | 5 veřejných projektů | CSV/JSON | Ne (trvale) | Projekty/data mohou být veřejné; uchování 14 dní |
| Thunderbit | 6 stránek/měsíc | N/A | Excel/CSV, Sheets, Airtable, Notion | Ne (trvale) | Stránkování, podstránky, bulk, plánování patří do Starteru |
| Firecrawl | 1,000 kreditů/měsíc | N/A | Všechny formáty | Ne (trvale) | 2 souběžné requesty; nízké rate limity |
| Screaming Frog | 500 URL/crawl | Neomezený počet spuštění | Omezený export | Ne (trvale) | Renderování JS, ukládání crawlů, vlastní extrakce, integrace |
Open-source nástroje (self-hosted)
| Nástroj | Limit stránek | Licence | Za co platíte |
|---|---|---|---|
| Scrapy | Žádný | BSD | Výpočetní výkon, šířka pásma, úložiště, volitelná integrace prohlížeče |
| Crawlee | Žádný | Apache | Výpočetní výkon, šířka pásma, procesy prohlížeče |
| Crawl4AI | Žádný | Apache-2.0 + uvedení autorství | Výpočetní výkon, procesy prohlížeče, volitelně LLM inference |
| Playwright | Žádný | Apache | Výpočetní výkon, procesy prohlížeče (vyšší CPU/paměť) |
| Colly | Žádný | Apache | Výpočetní výkon, šířka pásma |
Pokud je váš softwarový rozpočet nulový a umíte programovat, open-source nástroje vás zbaví vendor limitu na počet stránek, ale infrastruktura, limity cílových webů a provozní náklady pořád zůstávají. Kód neumíte? Octoparse, ParseHub a Thunderbit nabízejí bezplatnou cestu — jen si hlídejte limity a podmínky soukromí.
Vašich prvních 10 minut: rychlé starty pro 3 úrovně dovedností
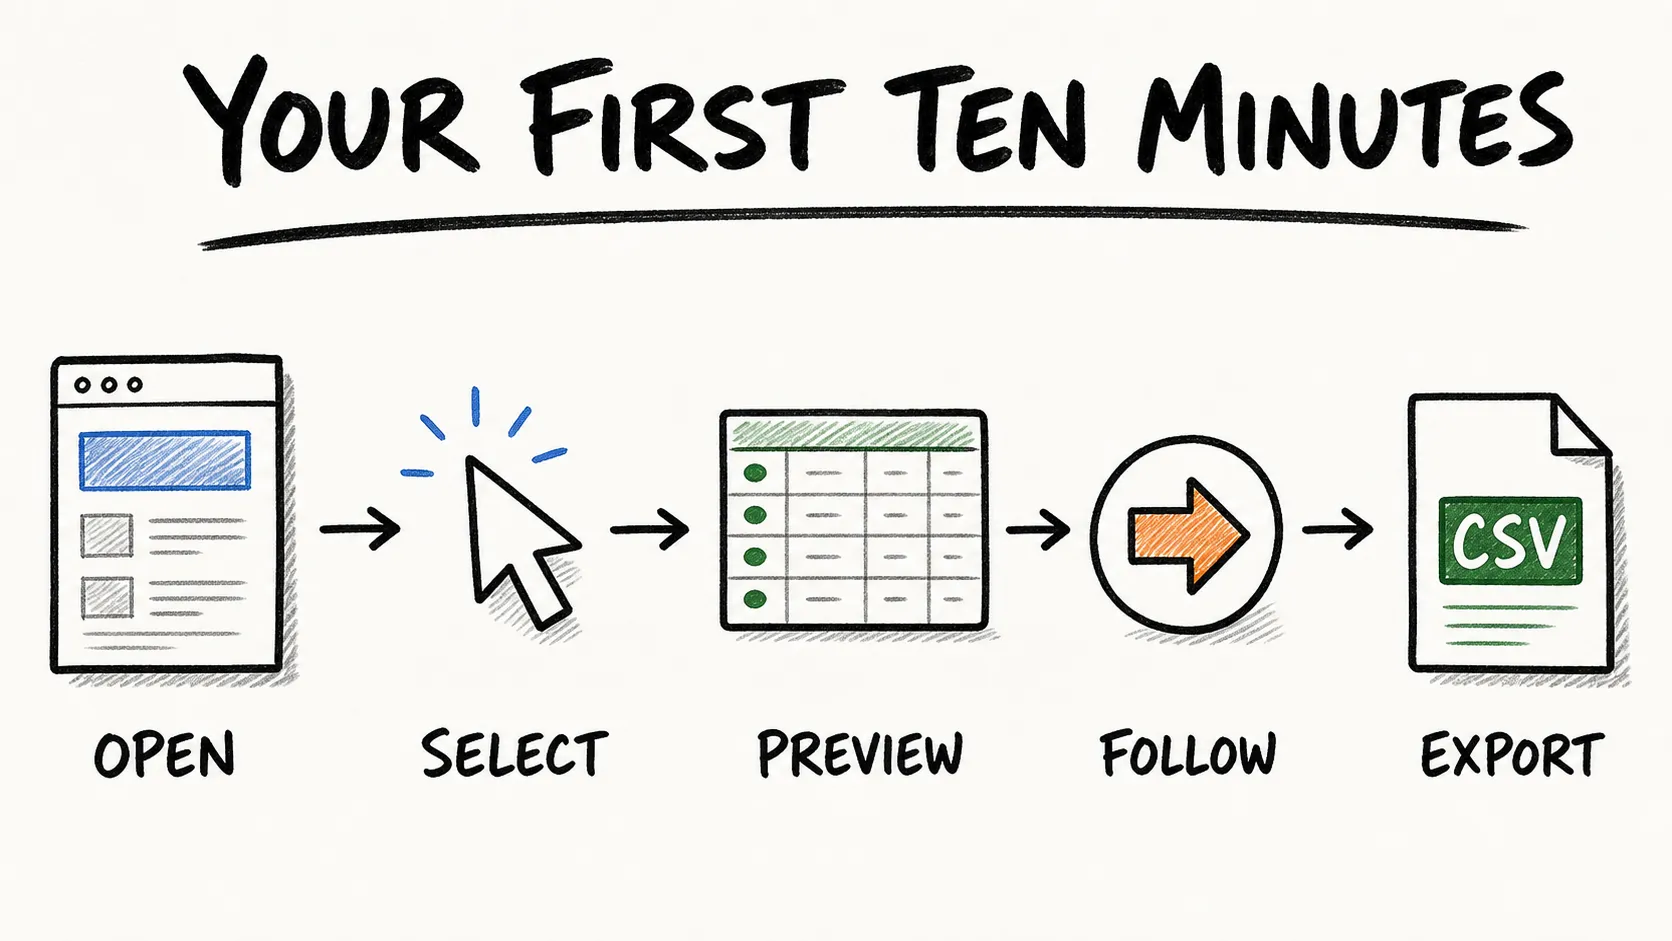
Teorie je fajn. Praxe je lepší. Tady je cesta od nuly k prvnímu exportu dat ve třech reprezentativních nástrojích — jednom pro každou úroveň.
No-code cesta: začínáme s Thunderbit
- Nainstalujte rozšíření Thunderbit do prohlížeče
- Otevřete cílovou stránku (například produktový výpis, adresář nebo stránku s výsledky vyhledávání)
- Klikněte na ikonu Thunderbit a zvolte One Click Extract — AI přečte stránku, pochopí její strukturu, rozhodne, která pole vytáhnout, a všechno získá v jednom kroku
- Zkontrolujte výsledky v rozšíření — přejmenujte, smažte nebo přidejte sloupce a případně upravte cokoliv přes Field AI Prompts — a pak exportujte do Excelu, Google Sheets, Airtable nebo Notion
Na kompatibilní stránce je to spíš krátké nastavení než programátorský projekt.
Podrobnější postup najdete v našem průvodci extrakcí dat z webových stránek pomocí Thunderbit.
Python cesta pro začátečníka: začínáme se Scrapy
Viz anotovaný rychlý start výše v části o Scrapy. Hlavní příkazy jsou pip install scrapy, scrapy startproject, úprava spideru s ROBOTSTXT_OBEY = True a DOWNLOAD_DELAY, a pak scrapy crawl example -o output.json. Než začnete škálovat, testujte selektory v scrapy shell. Doba závisí na vaší zkušenosti s Pythonem a nastavením prostředí.
JavaScript cesta: začínáme s Crawlee
Viz rychlý start u Crawlee výše. Spusťte npx crawlee create my-crawler, vyberte šablonu Playwright, upravte handler a pak npm start. Výsledky se uloží jako JSON do lokálního dataset adresáře. Před škálováním přidejte maxRequestsPerCrawl a omezení domény.
Pro delší průvodce orientovaný na Python, který ukazuje, jak crawler projekt celé dohromady funguje, je tento kurz užitečným doplňkem:
Vyzkoušejte zdarma, bez platební karty Free plán pokrývá 6 stránek měsíčně, takže si můžete data nejdřív vyzkoušet vyextrahovat, než se rozhodnete pro placený nástroj. Get Started Free
5 chyb začátečníků, které zničí první crawl (a jak se jim vyhnout)
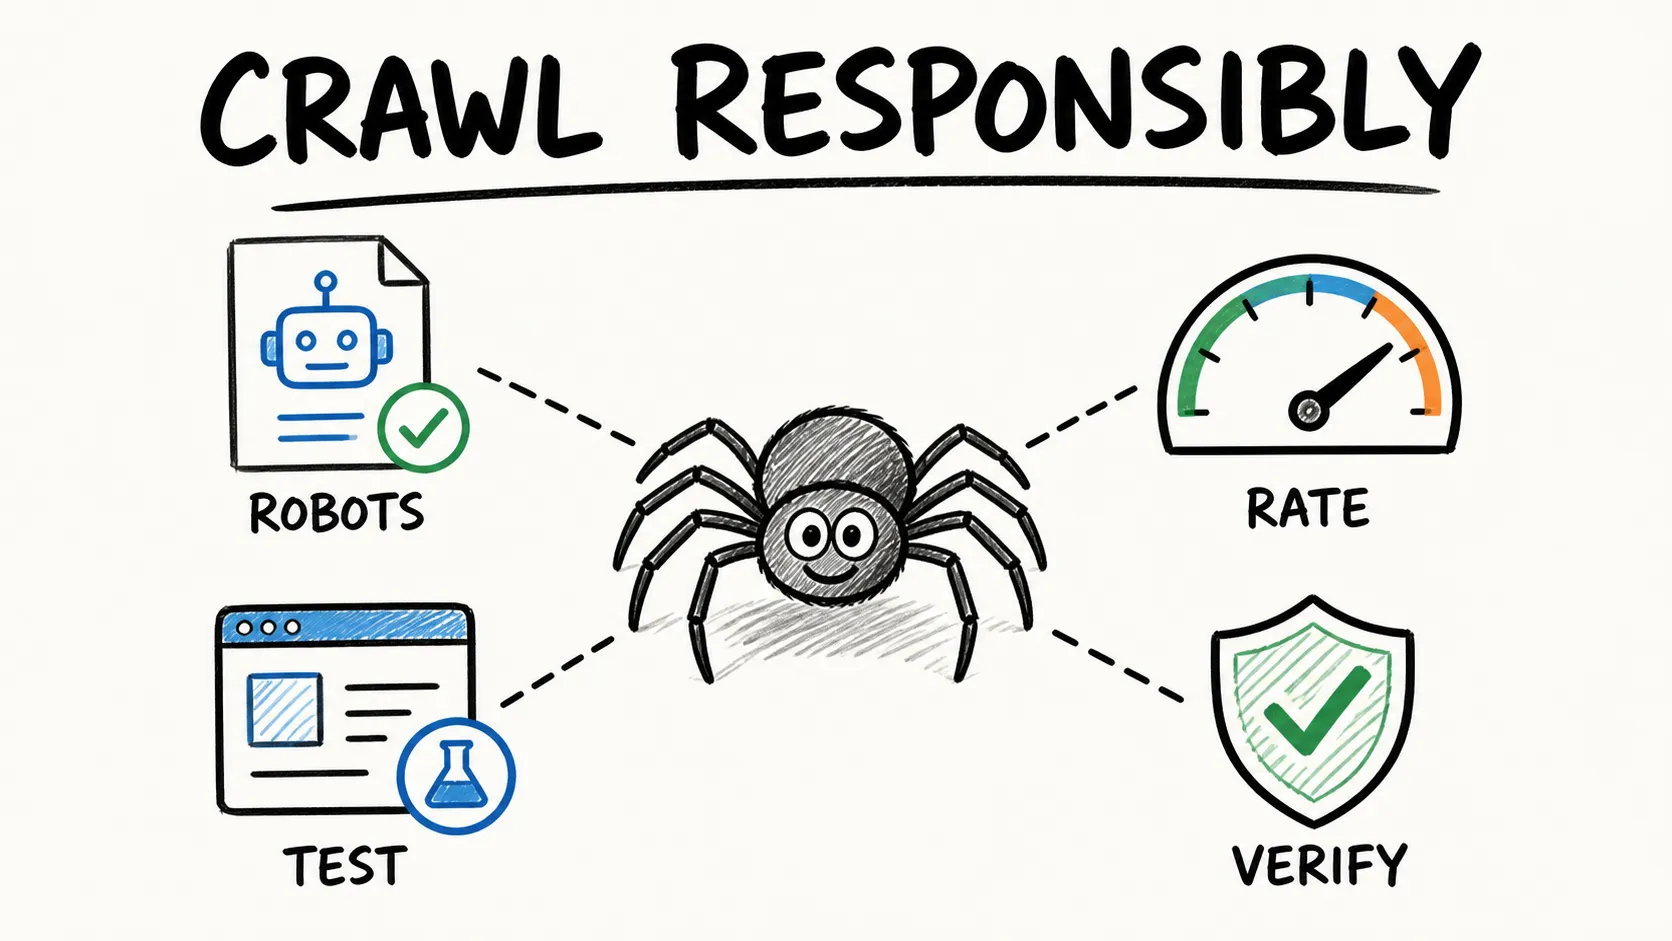
Tohle se ve fórech objevuje pořád dokola a žádný top článek tomu nevěnuje samostatnou sekci.
Chyba 1: Použití HTTP-only crawleru na webu renderovaném přes JavaScript
Problém: mnoho moderních webů načítá data přes JavaScript až po prvním HTML response. Jednoduchý HTTP request vrátí jen prázdnou „skořápku“ stránky s prázdnými <div> tagy — bez dat.
Řešení: Než vyberete nástroj, otevřete cílovou stránku, klikněte pravým tlačítkem a zobrazte zdrojový kód. Pokud potřebná data nejsou v čistém HTML, potřebujete nástroj s browser renderingem: Playwright, PlaywrightCrawler v Crawlee, nebo no-code nástroj jako Thunderbit či Octoparse, který vykresluje v prohlížeči. Ale nepoužívejte prohlížeč automaticky, když stačí HTTP — přidává to náklady i složitost.
Chyba 2: Ignorování robots.txt a pravidel Crawl-Delay
Problém: robots.txt je standard, který říká, jaké cesty může daný crawler token navštěvovat. Ignorování pravidel webu pro crawling může vést k blokování, provozním škodám i compliance riziku.
Řešení: Před crawlováním vždy zkontrolujte yoursite.com/robots.txt a ověřte skutečný výchozí stav vybraného nástroje. Výchozí nastavení se liší: například Colly inicializuje IgnoreRobotsTxt = true a vyžaduje explicitní konfiguraci. Upozornění: robots.txt je signál pro řízení crawlů, ne právní oprávnění. Povolená cesta není licence pro sběr nebo opětovné použití dat pro jakýkoliv účel.
Chyba 3: Příliš mnoho requestů bez rate limitu
Problém: střílení stovek requestů za sekundu může zahltit cílový server, nechat vás zablokovat IP a obecně je to špatná praxe.
Řešení: Nastavte rozumnou prodlevu. Ve Scrapy použijte DOWNLOAD_DELAY = 2 a nízké CONCURRENT_REQUESTS_PER_DOMAIN. V Colly nastavte LimitRule s prodlevou a paralelismem. Cloudové/no-code nástroje to obvykle řeší automaticky, ale ověřte si jejich nastavení. Začněte s jedním souběžným requestem na doménu a přidávejte až tehdy, když to chování webu i podmínky dovolují.
Chyba 4: Volba enterprise-scale nástroje pro malý projekt
Problém: nastavit distribuovaný Scrapy cluster s rotací proxy a message queue kvůli 500stránkovému projektu je jako půjčit si kamion na nákup.
Řešení: Vraťte se k rozhodovacímu diagramu. Slaďte složitost nástroje s velikostí projektu. Pro malé jednorázové extrakce je téměř vždy správná volba rozšíření do prohlížeče nebo jednoduchý skript.
Chyba 5: Neukládat a neověřovat výstupní data
Problém: začátečníci často exportují data bez kontroly a později zjistí, že polovina řádků je prázdná, duplicitní nebo poškozená.
Řešení: Vždy zkontrolujte prvních 10–20 řádků před plným během. Hledejte prázdná pole, problémy s kódováním (mojibake), duplicitní řádky a nečekané hodnoty. Ještě před startem si definujte očekávané schéma — jaké sloupce mají existovat, jaký mají mít typ a která pole jsou povinná. Úspěšné spuštění crawlu ještě neznamená přesná data.
Co znamená „LLM-ready output“ a proč je to důležité, i když neděláte AI
„LLM-ready“ je v roce 2026 všude v marketingu crawlerů. Většina vysvětlení předpokládá, že už víte, co je vektorová databáze. Tady je to řečeno jednoduše.
LLM-ready output je čistý, strukturovaný text, který AI model jako GPT nebo Claude dokáže přijmout bez ručního čištění. Představte si rozdíl mezi dokonale uspořádanou tabulkou a hromadou vytištěných webových stránek, na kterých zůstaly reklamy, navigace a cookie lišty.
Proč by vás to mělo zajímat i tehdy, když nestavíte chatbot? Protože nástroje navržené pro LLM-ready výstupy obvykle produkují čistší a použitelnější data pro všechny. Méně post-processingu, méně zbytečných sloupců, méně problémů s kódováním. Čistá data jsou čistá data, ať je čte člověk nebo stroj.
Které nástroje v tomto seznamu umí nativně LLM-ready výstup?
- Firecrawl → čistý Markdown, shrnutí, strukturované JSON
- Crawl4AI → více variant Markdownu, strukturované chunky, tabulky
- Thunderbit → AI navržená strukturovaná pole s normalizací přes prompty
Tady je jednoduché srovnání před a po. Syrové HTML z produktové stránky může vypadat takto:
<div class="product-card">
  <span class="price">$29.99</span>
  <h2 class="title">Wireless Mouse</h2>
  <p class="desc">Ergonomic design, 2.4GHz...</p>
  <a href="/buy" class="btn">Add to Cart</a>
</div>
LLM-ready Markdown výstup z Firecrawl:
## Wireless Mouse
- **Price:** $29.99
- **Description:** Ergonomic design, 2.4GHz
Strukturovaný výstup z Thunderbit:
| Název produktu | Cena | Popis |
|---|---|---|
| Wireless Mouse | $29.99 | Ergonomic design, 2.4GHz |
Obojí je okamžitě použitelné — žádné parsování HTML, žádné odstraňování reklam, žádné ruční mapování sloupců. Více o tom, jak AI-powered extrakce porovnává s tradičním scrapingem, najdete v našem přehledu nejlepších AI web scraperů.
Zodpovědné web crawling: rychlé tipy k etice a souladu s pravidly
Etika a compliance při web crawlování jsou příliš důležité na to, aby se přeskočily:
- Před crawlováním každého webu zkontrolujte robots.txt. Je to standardní signál pro řízení crawlu (RFC 9309), ale není to právní oprávnění ani bezpečnostní hranice.
- Respektujte rate limity a hlavičku Retry-After. Při odpovědích 429 a 503 zpomalte nebo se zastavte.
- Používejte jen veřejně dostupná nebo autorizovaná data. Pokud vám vyhovuje oficiální API nebo export, preferujte je.
- Zkontrolujte podmínky použití webu. Veřejná dostupnost neznamená univerzální licenci ke sběru nebo opětovnému použití dat.
- Myslete na osobní údaje. Minimalizujte sběr, nastavte pravidla uchování a mazání a u citlivých případů si nechte udělat kvalifikované posouzení. GDPR a podobné předpisy platí bez ohledu na to, jaký nástroj použijete.
Mnoho nástrojů nabízí nastavení, které podporují zodpovědný crawl, ale konfigurace nepřenáší odpovědnost z operátora na software. Pro hlubší pohled na samotný proces se podívejte na naše vysvětlení co je web scraping.
S jakým web crawlerem začít?
Rychlé shrnutí podle úrovně dovedností:
- Bez kódu: Thunderbit pro AI asistovanou extrakci ze stránky, Octoparse pro vizuální tvorbu workflow, ParseHub pro složitá vícekroková flow, Screaming Frog pro SEO audity
- Středně pokročilý Python: Scrapy pro velké HTTP crawly, Crawl4AI pro LLM pipeline
- Středně pokročilý JavaScript: Crawlee pro moderní SPA crawling, Playwright pro složitou automatizaci prohlížeče
- Go: Colly pro rychlý HTTP crawling (s explicitním nastavením robots a rate limitů)
- Spravované API: Firecrawl pro čistý Markdown výstup bez self-hostingu
Nejlepší crawler je ten, který odpovídá vašim datům, oprávněním, úrovni dovedností a provozním limitům. Začněte jednoduše, ověřte malý běh a přidávejte složitost jen tehdy, když to projekt opravdu vyžaduje. Pokud chcete vyzkoušet AI asistovanou extrakci, rozšíření Thunderbit do prohlížeče nabízí no-code cestu z kompatibilní stránky přímo do tabulky.
Zjistit více
- AI Web Scraping
- Web scraping bez programování
- Co je web scraping
- Alternativy k Instant Data Scraper
- Scraping LinkedIn
Vyzkoušejte agentický web scraper Thunderbit Get Started Free
Často kladené otázky
1. Co je web crawler a jak se liší od web scrapera?
Crawler objevuje a stahuje stránky — prochází odkazy, spravuje frontu URL, řeší deduplikaci a limity hloubky. Scraper z těchto stránek vytahuje konkrétní strukturovaná data — parsuje HTML, vybírá pole a ukládá záznamy. Většina moderních nástrojů dnes dělá obojí do určité míry a pojmy se často používají zaměnitelně, ale rozdíl je důležitý při výběru nástroje: některé (například Playwright) skvěle renderují stránky, ale nemají crawl infrastrukturu, zatímco jiné (například Scrapy) dodají celý crawl pipeline, ale pro JavaScript render potřebují plugin.
2. Který web crawler je nejlepší pro někoho bez programátorských dovedností?
Thunderbit, Octoparse a ParseHub jsou nejlepší no-code volby pro obecnou extrakci dat. Thunderbit využívá AI k návrhu polí a funguje jako rozšíření do prohlížeče; Octoparse nabízí vizuální builder workflow s Auto-detect; ParseHub vyniká u složitých vícekrokových flow. Pro čistě SEO případy zvládne free verze Screaming Frog crawl až 500 URL bez programování.
3. Jsou web crawlery zdarma?
Jsou tu dvě kategorie. Plně open-source nástroje (Scrapy, Crawlee, Crawl4AI, Playwright, Colly) nemají poplatek za stránku, ale infrastrukturu hostujete a platíte za výpočetní výkon, šířku pásma a úložiště. Freemium nástroje (Octoparse, ParseHub, Thunderbit, Firecrawl, Screaming Frog) nabízejí free tier s různými limity na stránky, projekty, exporty nebo funkce. Podrobnosti najdete v tabulce free tierů výše.
4. Zvládnou web crawlery weby s těžkým JavaScriptem?
Ano, ale ne všechny. Nástroje s vestavěným renderováním v prohlížeči — Playwright, Crawlee (PlaywrightCrawler), Octoparse, ParseHub, Crawl4AI a Thunderbit (v Browser Mode) — zvládnou obsah načítaný přes JavaScript. Scrapy a Colly jsou HTTP-first a pro render JavaScriptu potřebují samostatnou integraci prohlížeče. Screaming Frog podporuje renderování JavaScriptu jen v placené verzi. Vždy si nejdřív ověřte, zda cílová stránka browser skutečně potřebuje, třeba tím, že se podíváte do zdrojového HTML.
5. Je web crawling legální?
Neexistuje univerzální odpověď ano/ne. Právní posouzení závisí na datech, způsobu přístupu, zamýšleném použití, podmínkách webu, smlouvách, pravidlech duševního vlastnictví, povinnostech ochrany soukromí, jako je GDPR, a na konkrétní jurisdikci. robots.txt je signál pro řízení crawlu, ne právní oprávnění, a veřejná dostupnost není automatická licence. U konkrétních situací — zejména těch, které zahrnují osobní údaje, chráněný obsah, autentizaci nebo komerční znovupoužití — se obraťte na kvalifikovaného právního odborníka.




