
Podle reportu State of Open Source 2025 zvýšilo nebo aspoň zachovalo používání open source 96 % organizací — a hlavní důvod pořád zůstává „nulová cena licence“. Jenže je tu jedna věc, kterou ti nikdo neřekne, když si stáhneš scraper z GitHubu: „open source“ a „bezpečné pro komerční použití“ nejsou totéž.
Letos jsem prošel klasiky jako Scrapy, Playwright, Puppeteer i novější AI-nativní crawlery jako Crawl4AI a ScrapeGraphAI. A věc, která je pro byznysové rozhodnutí opravdu zásadní, se v běžných žebříčcích „nejlepších scraperů“ skoro nikdy neobjevuje: typ licence. Většina seznamů řadí podle počtu hvězdiček na GitHubu. Já řadím podle toho, co se stane ve chvíli, kdy se právní tým zeptá: „Počkejte, je to AGPL?“ Tenhle seznam proto řadí 12 nástrojů nejdřív podle toho, jak se hodí do dané kategorie (parsers, browser automation, AI-native scrapery, crawl frameworky, no-code rozšíření), a až potom podle licence, protože přesně takhle se tahle rozhodnutí v praxi dělají.
Proč je typ licence první filtr u každého open source web scrapera
„Open source“ neznamená „můžeš si s tím dělat, co chceš“. Definice open source výslovně zakazuje diskriminaci vůči komerčnímu použití — takže každý nástroj v tomhle seznamu můžeš použít i v byznysu. Ale jak ho smíš použít a jaké povinnosti ti vzniknou v okamžiku nasazení, to záleží čistě na konkrétní licenci.
Permisivní licence — MIT, BSD-3-Clause, Apache-2.0 — ti dovolí skoro cokoli, pokud necháš připojené upozornění o autorských právech. Apache-2.0 jde ještě dál díky výslovnému patentovému oprávnění, což je přesně ten typ licence, který právníci obvykle preferují nejvíc. Žádná z těchto tří licencí nevyžaduje, abys zveřejnil vlastní zdrojový kód.
Copyleft licence jsou jiná liga. AGPL-3.0 je ta, na které lidi často ztroskotají, a právě pod ní běží self-hosted jádro Firecrawl (SDK jsou MIT, ale samotný scraping engine je AGPL). Podle sekce 13 AGPL-3.0 musíš, pokud upravíš pokrytý program a umožníš uživatelům pracovat s jeho upravenou verzí přes síť, nabídnout jim i odpovídající zdrojový kód. Neznamená to, jak se někdy píše na fórech, že „celé SaaS se tím automaticky stane open source“ — jde konkrétně o povinnost vztahující se na upravený pokrytý program nabízený pro vzdálenou interakci. I tak je to ale reálná právní otázka, kterou je potřeba řešit s právníkem, ne podle vlákna na Stack Overflow, než na tom postavíš uzavřený komerční produkt.
A pak je tu mlhavější kategorie „open-core“. Web Scraper, rozšíření do Chromu, má na GitHubu historický repozitář pod LGPL-3.0 — ale poslední commit v tom repu je z roku 2017 a neexistuje žádné ověřené propojení mezi tím starým zdrojem a rozšířením, které je dnes v Chrome Web Storu (verze 1.111.13 v době psaní). Upřímné shrnutí: lokální rozšíření je zdarma, ale cloudová vrstva se schedulingem a rotací proxy je samostatný proprietární produkt. Označovat celé řešení za „open source“ tedy dost zastírá, kde přesně leží hranice.
Jak jsme porovnali těchto 12 nejlepších open source web scraperů
Každý nástroj jsem hodnotil podle sedmi os: typ licence a míra tření pro komerční použití, jazyk/runtime, nativní podpora renderování JavaScriptu (oproti nutnosti doplnit plugin), náročnost na naučení, skryté náklady na výpočetní výkon nebo proxy, signály zdraví komunity (otevřené issues, cadence releasů, poslední commit) a nejvhodnější use case.
Seznam je rozdělen podle kategorií — statické parsers, frameworky pro browser automation, AI-native scrapery, crawl frameworky a nakonec jedno no-code rozšíření do prohlížeče — místo aby byl seřazen čistě podle počtu hvězdiček. To je záměr. Beautiful Soup a Scrapy řeší úplně odlišné problémy, i když jsou oba extrémně populární; řadit je na stejnou osu nikomu s výběrem nástroje moc nepomůže.
| Kritérium | Co jsem kontroloval |
|---|---|
| Licence a vhodnost pro komerční použití | Přesná licence repozitáře, požadavky na uvedení autorství, copyleft síťové klauzule |
| Runtime a vhodnost pro tým | Python, Node/TypeScript, Java nebo více jazyků |
| Renderování JS | Nativní podpora v prohlížeči vs. kombinace s pluginem vs. žádná |
| Rozsah frameworku | Jen parser, driver prohlížeče, kompletní crawl pipeline nebo spravovaný produkt |
| Zdraví komunity | Hvězdičky na GitHubu, datum posledního releasu, otevřené issues, poslední push |
| Skryté náklady | Paměť prohlížeče, potřeba proxy, závislost na model API, náročnost údržby |
| Nejlepší fit | Konkrétní shoda s týmem nebo úkolem, podložená zdokumentovanými možnostmi nebo issues |
Jeden upřímný dovětek k datům o komunitě: Beautiful Soup se primárně vyvíjí na Launchpadu, ne na GitHubu, takže počet hvězdiček na GitHubu (neoficiální mirror se 223 hvězdičkami, poslední změna v roce 2022) není s ostatními 10 nástroji přímo srovnatelný. Níže to výslovně uvádím, místo abych předstíral, že to bez problémů zapadá do stejné tabulky.
Nejlepší open source parsovací knihovna pro statické weby: BeautifulSoup
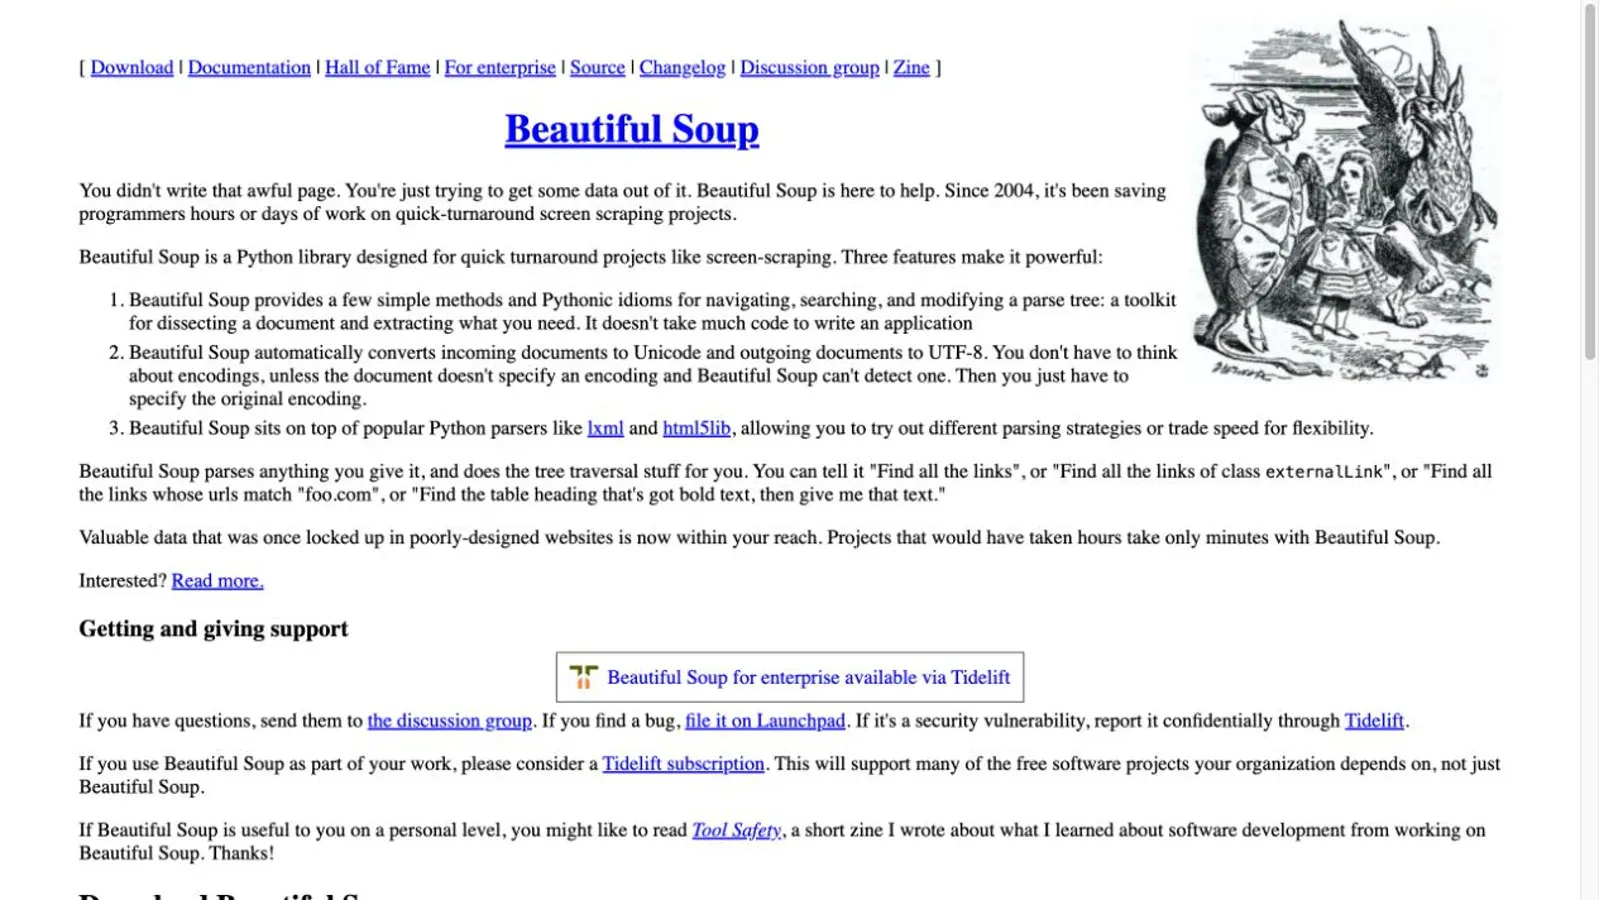
BeautifulSoup je Python knihovna pro procházení a vyhledávání v HTML/XML parse tree. Nestahuje stránky, nespouští JavaScript ani neřídí crawl fronty — vezme jen markup, který už máš, a umožní ti z něj data pohodlně vytáhnout přes přívětivé API. Právě tahle úzká specializace je její hlavní výhoda: sáhneš po ní ve chvíli, kdy už HTML máš a jen z něj potřebuješ dostat data.
- Licence: MIT — permisivní, bez povinností nad rámec ponechání upozornění
- Náročnost na naučení: opravdu vhodné pro začátečníky; objektový model je shovívavý
- Renderování JS: nativně žádné — je potřeba ji spojit s nástrojem, který nejdřív stáhne vyrenderované HTML
- Známé omezení: oficiální dokumentace připouští, že „nikdy nebude tak rychlá jako parsers pod ní“, a různé backendy parserů (lxml vs. html5lib vs. html.parser) mohou u rozbitého HTML vytvořit výrazně odlišné stromy
Nejlepší pro: rychlé interní skripty a jednorázové extrakce ze statického nebo už předem staženého HTML — ne pro škálování ani weby výrazně závislé na JavaScriptu.
Nejlepší open source framework pro browser automation pro legacy testování napříč prohlížeči: Selenium
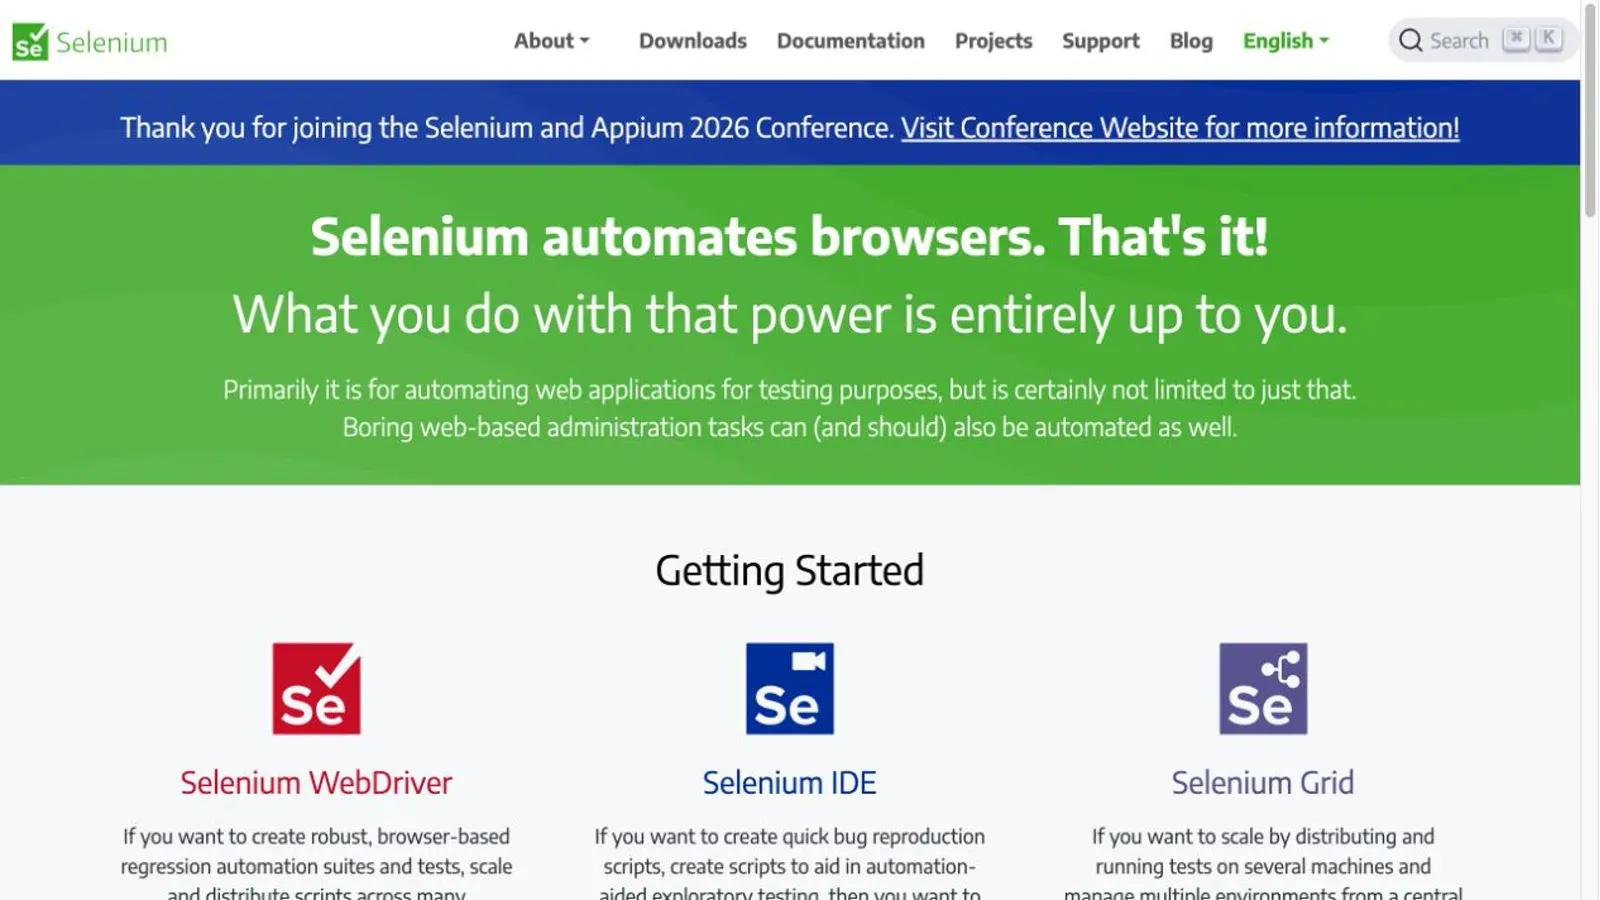
Selenium je nejstarší jméno v tomhle seznamu. Původně vzniklo pro testování prohlížečů a od té doby ho pro scraping používá půlka světa. Jeho hlavní předností není rychlost, ale záběr. Oficiální Selenium 4 bindingy pokrývají Java, Python, C#, Ruby i JavaScript a přes standard W3C WebDriver ovládají Chrome, Edge, Firefox i Safari.
- Licence: Apache-2.0
- Zdraví na GitHubu: 34 366 hvězdiček, 98 otevřených issues, 12 stabilních releasů za poslední rok (nejnovější: 4.47.0)
- Renderování JS: nativně, přes skutečný prohlížeč
- Zdokumentované tření: vlastní dokumentace Selenium upozorňuje, že synchronizace je „jedna z nejčastějších výzev“ — načtení dokumentu neznamená, že jsou připravené i prvky doplněné JavaScriptem, a dynamický refresh DOM vyvolá
StaleElementReferenceException
Nejlepší pro: týmy, které potřebují podporu více prohlížečů nebo více jazyků, nebo už Selenium používají pro QA a chtějí stejný skillset využít i pro scraping.
Nejlepší open source framework pro browser automation pro moderní weby náročné na JS: Playwright
Playwright, spravovaný Microsoftem, je moderní odpověď na větu „Selenium je pomalé a neohrabané“. Nativně automatizuje Chromium, Firefox a WebKit a používá kontrolu akceschopnosti, která před interakcí automaticky čeká, až jsou prvky opravdu připravené — viditelné, stabilní a povolené. Jen tahle vlastnost eliminuje spoustu ručního boilerplate typu WebDriverWait, který si uživatelé Selenium často píšou sami.
Důležitý detail, který se ztrácí v každém diskuzním vlákně „Scrapy vs. Playwright vs. Selenium“: Scrapy samo o sobě JavaScript vůbec nerenderuje. Potřebuje samostatný plugin — scrapy-playwright — který se přidává navrch, aby vůbec zvládl browser rendering. Playwright a Puppeteer renderují nativně, protože renderování je přímo jejich produkt.
- Licence: Apache-2.0
- Zdraví na GitHubu: 94 443 hvězdiček, 15 stabilních releasů za poslední rok (nejnovější: 1.62.1)
- Skrytý náklad: samotné binárky prohlížečů mají zhruba 281 MB pro Chromium, 187 MB pro Firefox a 180 MB pro WebKit — a breaking change ve verzi 1.38 zastavil automatické stahování prohlížečů, takže při nasazení v Dockeru je důležité připínat verze
Nejlepší pro: týmy, které scrapují React/Vue SPA a potřebují spolehlivé chování napříč prohlížeči bez ručního psaní wait logiky.
Nejlepší open source nástroj pro browser automation pro projekty zaměřené na Chrome: Puppeteer
Puppeteer, automatizační knihovna od Googlu, je od základu orientovaná na Chrome — hluboká integrace s Chrome DevTools Protocol, vestavěné generování screenshotů/PDF a všechno ostatní. Je ale fér opravit jednu zastaralou představu: aktuální Puppeteer oficiálně podporuje i stabilní Firefox, takže označení „jen pro Chrome“ už úplně neplatí, i když Chrome zůstává hlavním use casem.
- Licence: Apache-2.0
- Zdraví na GitHubu: 95 458 hvězdiček, 249 otevřených issues — výrazně víc než u Playwrightu, což je dobré vzít v úvahu při hodnocení odezvy týmu
- Realita anti-bot ochrany: issue Puppeteer #7006 popisuje úplně běžnou navigaci, kterou zastaví Cloudflare challenge — samotné vyrenderování stránky tě před anti-bot systémy neschová, tečka
Nejlepší pro: Node.js týmy standardizované na Chrome, obzvlášť když vedle scraping potřebují i generování PDF a screenshotů.
Nejlepší open source AI-native scraper pro LLM a RAG pipeline: Crawl4AI
Crawl4AI stojí interně na Playwrightu a je navržený tak, aby místo surového HTML vracel čistý Markdown pro LLM a RAG pipeline. Podporuje režim „clean Markdown“ i „Fit Markdown“ optimalizovaný pro context windows a navíc nabízí i volitelnou LLM extrakci, pokud ji chceš — CSS/XPath a BM25 filtrování fungují i bez jakéhokoli model API.
Jeden detail stojí za přesné upozornění: GitHub repozitář označuje licenci jako Apache-2.0, ale skutečný licenční soubor přidává povinný požadavek na uvedení autorství při veřejném použití a distribuci. To není čisté Apache-2.0 — je to Apache-2.0 plus podmínka specifická pro projekt, a přesně ten licenční soubor je potřeba číst, ne jen badge v postranním panelu GitHubu.
- Zdraví na GitHubu: 77 959 hvězdiček, nejnovější release v0.9.2 (červenec 2026)
- Požadavky na zdroje: průvodce self-hostingem doporučuje mít pro kontejner alespoň 4 GB RAM
- Zdokumentovaná nestabilita: changelog k v0.9.0 zaznamenal breaking changes v defaultním nastavení autentizace Docker serveru a přesun modulů — jde o nástroj, který se pořád rychle vyvíjí, takže verze připínej
Nejlepší pro: Python týmy, které posílají čerstvá webová data do LLM agentů nebo RAG pipeline a zvládnou vlastní browser infrastrukturu.
Nejlepší open source AI-native scraper pro self-hosted nasazení (s licenčním háčkem): Firecrawl
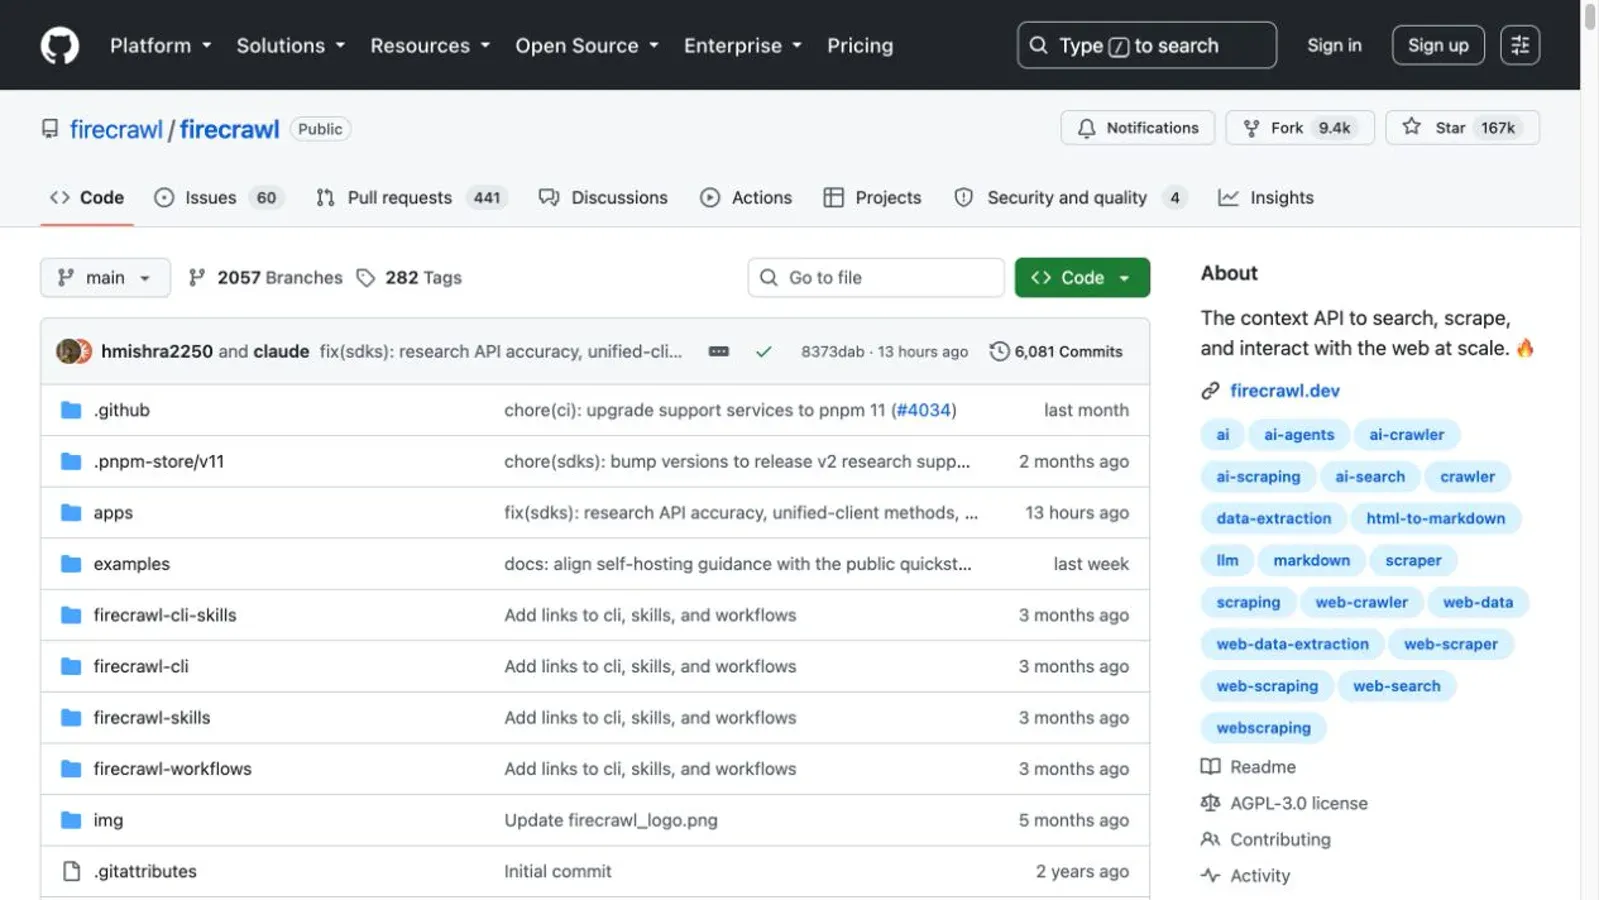
Self-hosted jádro Firecrawl je přesně místo, kde se licenční otázka AGPL stává praktickou. Jde o API-first crawler, který vrací Markdown, HTML, screenshoty i strukturovaná data — opravdu schopný nástroj postavený na Fetch a Playwrightu. Ale ta „vyleštěná“ část, kterou si lidi s Firecrawl spojují — spravované anti-bot řešení, rotace proxy, stealth vrstva Fire-engine — patří Firecrawl Cloud, ne self-hosted repozitáři. Oficiální self-host dokumentace Firecrawl přímo uvádí, že Fire-engine a pokročilé anti-bot chování nejsou součástí defaultního self-hosted stacku a že screenshoty/page actions to vyžadují.
- Licence: hlavně AGPL-3.0-or-later pro jádro, MIT pro SDK
- Zdraví na GitHubu: 166 527 hvězdiček — opravdu obrovské číslo v této kategorii
- Realita nasazení: self-hosting znamená rozjet Redis, RabbitMQ, PostgreSQL a volitelně i FoundationDB — nejde o jeden kontejner, ale o vícekomponentní provoz
Nejlepší pro: interní nástroje nebo open source projekty, kterým nevadí povinnost nabídnout zdrojový kód podle AGPL. Než na self-hosted jádru postavíš uzavřený komerční produkt, dvakrát si to rozmysli a nech to projít právní kontrolou.
Nejlepší open source AI-native scraper pro extrakci v přirozeném jazyce: ScrapeGraphAI
ScrapeGraphAI ti umožní popsat, co chceš, běžným jazykem místo psaní selektorů — jde o grafově postavenou pipeline, kde mapování polí obstarávají LLM volání. Knihovna s MIT licencí používá tvoji vlastní infrastrukturu: tvůj LLM API klíč (nebo lokální model Ollama, pokud nechceš platit za tokeny) a tvoji vlastní nakonfigurovanou instanci Playwrightu.
Právě tady je dobré nahlas pojmenovat háček: „open source“ tady neznamená „nulové průběžné náklady“. Každá extrakce spotřebuje tokeny u modelu, který připojíš. A prompt-driven extrakce má specifický problém, který selector-based nástroje nemají: jedno otevřené issue popisuje případ, kdy pipeline projde všemi kroky úspěšně, ale vrátí prázdná / NA pole i pro data, která byla na stránce viditelně přítomná — tichý fail, který deterministické CSS/XPath typicky neprodukují.
- Licence: MIT
- Zdraví na GitHubu: 29 447 hvězdiček, nejnovější stabilní verze v2.1.6
Nejlepší pro: nepravidelné, jednorázové extrakční úlohy, kde flexibilita promptů stojí za cenu modelu i za dodatečnou validaci.
Nejlepší open source AI-native scraper pro lehkou extrakci bez modelu: AutoScraper
AutoScraper úplně obchází LLM. Zadáš URL a ukázkovou hodnotu, kterou chceš vytáhnout; nástroj odvodí strukturální pravidla z konkrétní stránky a použije je znovu na podobných stránkách. Žádný model API klíč, žádný token účet — jen requests a BeautifulSoup uvnitř.
Pozor na nálepku „opuštěný“, kterou mu některá fóra dávají. Není přesná: v polovině roku 2025 tam proběhly reálné commity a poslední push do repozitáře je z července 2026. Ale balíček, který by si člověk skutečně nainstaloval přes pip install, je pořád verze v1.1.14 z roku 2022. Přesnější popis je tedy „pomalejší cadence balených releasů“ — ne „mrtvý projekt“.
- Licence: MIT
- Zdraví na GitHubu: 7 844 hvězdiček
- Tvrdé omezení: žádné nativní renderování JS — volá
requests.get()a parsuje to HTML, které se vrátí, nic víc
Nejlepší pro: malé, opakované extrakční úlohy na strukturálně stabilních statických stránkách, kde nevadí občasný retraining po redesignu.
Nejlepší open source crawl framework pro rozsáhlé Python projekty: Scrapy
Scrapy je produkčně připravený Python crawl framework — engine, scheduler, downloader, item pipelines, všechno. Pokud je Beautiful Soup skalpel, Scrapy je celé operační sálové zázemí: asynchronní síťová komunikace, řízení concurrency na úrovni domén, AutoThrottle a exportéry, které zapisují přímo do CSV, JSON, JSON Lines, XML nebo do cloudového úložiště.
Nuance, kterou jsem zmínil výš, je tady potřeba zopakovat, protože je to největší zdroj zmatku u Scrapy: Scrapy nemá nativní renderování JavaScriptu. Vlastní dokumentace Scrapy doporučuje nejdřív najít a reprodukovat samotný datový request — protože to bývá rychlejší a úplnější než renderovat celý prohlížeč — a scrapy-playwright si nechává pro případy, kdy je prohlížeč opravdu nevyhnutelný.
- Licence: BSD-3-Clause
- Zdraví na GitHubu: 63 830 hvězdiček, 304 otevřených issues, 9 stabilních releasů za poslední rok (nejnovější: 2.17.0)
- Mezera v rate-limitingu: otevřený návrh na vylepšení upozorňuje, že AutoThrottle ladí podle latence, ne podle HTTP 429 — backoff citlivý na odpověď si stále musíš dopracovat sám
Nejlepší pro: rozsáhlý crawling statických webů, kde záleží víc na strukturovaných pipeline a flexibilním exportu než na renderování JS.
Nejlepší open source crawl framework pro produkční nasazení v Node.js: Crawlee
Crawlee od týmu Apify je nejbližší Node/TypeScript ekvivalent Scrapy — jen s tím rozdílem, že renderování JavaScriptu není přidané dodatečně, ale je od začátku součástí crawler tříd postavených na Playwrightu a Puppeteeru, nad společnou vrstvou fronty, úložiště a rotace proxy.
- Licence: Apache-2.0
- Zdraví na GitHubu: 25 364 hvězdiček, 8 stabilních releasů za poslední rok (nejnovější: 3.18.1)
- Chytrý detail:
AutoscaledPooldynamicky upravuje concurrency podle aktuální zátěže CPU, paměti a event loop — a dokumentace výslovně varuje, že příliš vysoké minimum concurrency může celý crawl shodit
Nejlepší pro: Node.js/TypeScript týmy, které chtějí produkčně připravenou správu front i renderování JS bez skládání ekvivalentu Scrapy z více částí sami.
Nejlepší open source crawl framework pro enterprise Java indexaci: Apache Nutch
Apache Nutch je v tomhle seznamu trochu výjimka — Java crawler navržený pro indexaci webu ve velkém měřítku, typicky jako zdroj pro Solr, Elasticsearch nebo OpenSearch. Není to nástroj, který bys použil na tahání cen produktů od konkurence; je to nástroj, po kterém sáhnou týmy enterprise search ve chvíli, kdy staví crawl vrstvu pod vyhledávací index.
- Licence: Apache-2.0
- Zdraví na GitHubu: jen 3 276 hvězdiček, ale poslední push je z srpna 2026 — nízký počet hvězdiček odráží specializovaný výklenek, ne zanedbání
- Práce s JS: vyžaduje samostatný plugin
protocol-selenium; JIRA ticket dokumentuje selhání HTTPS proxy právě v této pluginové cestě
Nejlepší pro: týmy, které už provozují Java/Hadoop infrastrukturu a potřebují webovou indexaci na enterprise úrovni, ne ad-hoc extrakci dat.
Nejlepší open source no-code rozšíření do prohlížeče: Web Scraper
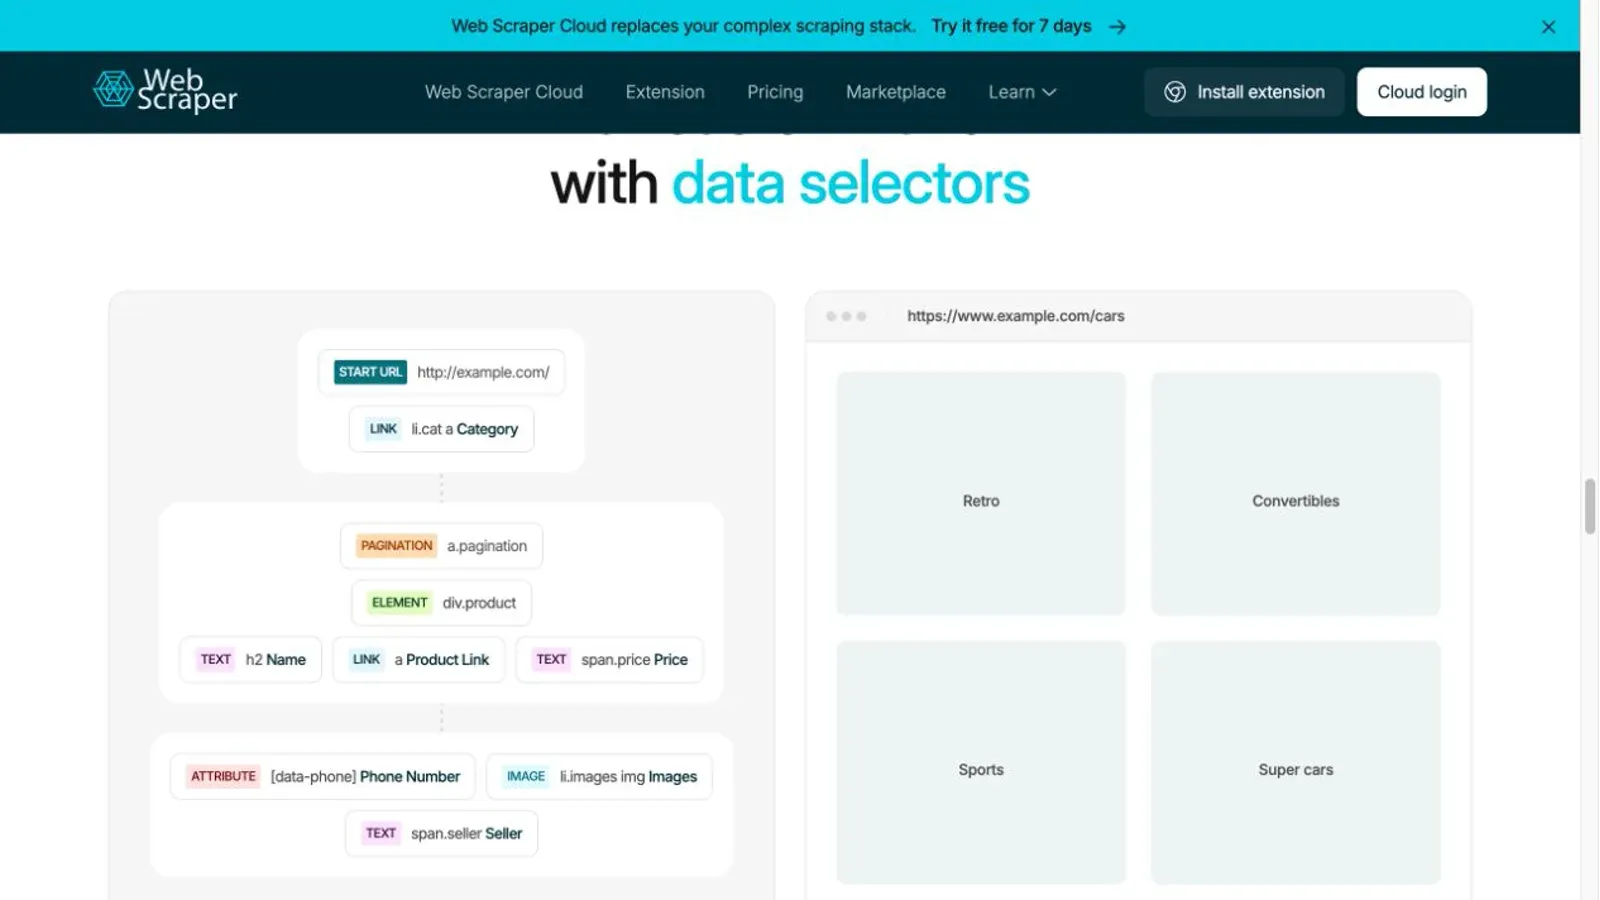
Web Scraper je varianta typu point-and-click — tvůrce sitemap a stromu selektorů, který běží uvnitř Chrome DevTools. Zvládá stránkování, klikání na tlačítka, scrollování nekonečně načítaných stránek a export do CSV/XLSX, a to všechno bez jediné řádky kódu.
Právě tady je split open-core důležitější než téměř kdekoliv jinde v tomhle seznamu. Lokální extrakce je opravdu zdarma. Ale plánované automatizace, cloudové běhy, API přístup i správa proxy jsou za Web Scraper Cloud, samostatným placeným produktem. A jak už bylo řečeno, veřejně dostupný repozitář pod LGPL-3.0 neviděl commit od roku 2017 — takže „open source“ tady ber jako popis historického původu lokálního rozšíření, ne jako záruku toho, co běží v dnešní verzi z Chrome Web Storu.
Nejlepší pro: jednotlivce nebo malé týmy, které dělají občasné lokální extrakce, nechtějí psát kód a nepotřebují škálování.
Statické parsers vs. headless prohlížeče: jak vybrat správný nástroj pro weby náročné na JS
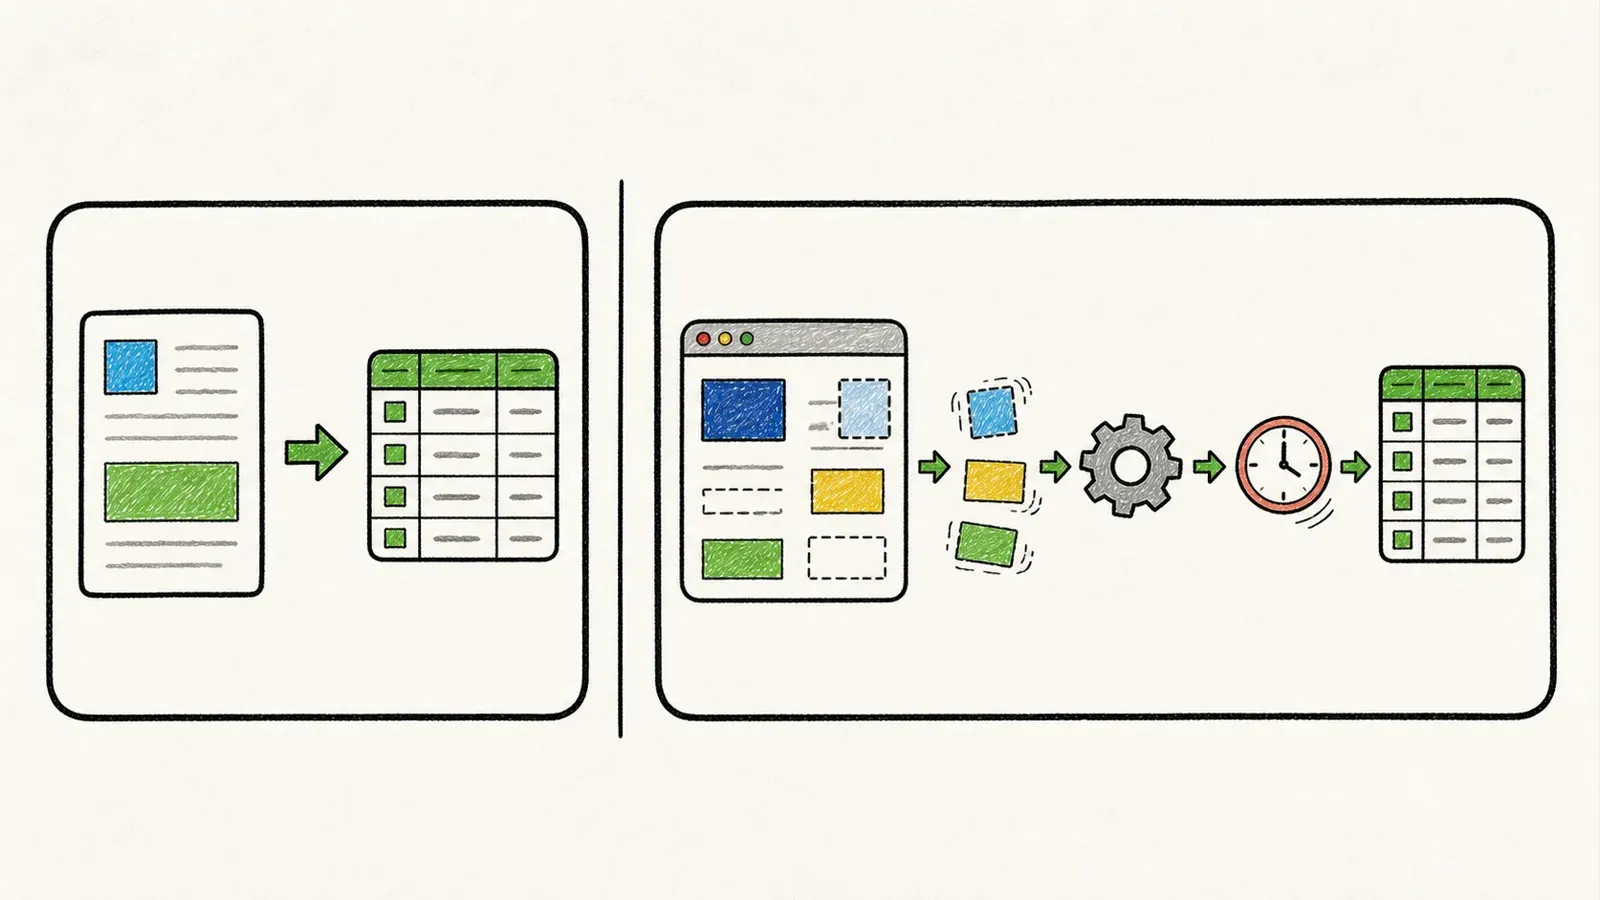
Tady je statistika, která to pomáhá zasadit do kontextu: 98,9 % webů používá JavaScript jako klientský jazyk. Jenže tenhle údaj se pořád mylně cituje jako „98,9 % webů potřebuje k scrapingu headless prohlížeč“ — a to není to, co říká. Měří přítomnost JavaScriptu, ne to, jestli jsou tvoje konkrétní data v úvodním HTML, nebo se objeví až po spuštění skriptů.
A právě to je skutečný rozhodovací bod. Dvanáct nástrojů si rozděl do dvou poctivých skupin:
Statické parsers — BeautifulSoup, AutoScraper — jsou rychlé, levné a úplně slepé ke všemu, co se renderuje na klientovi. Pokud jsou data v úvodní HTML odpovědi nebo v JSON endpointu, který si umíš zavolat přímo, vyhrávají tyhle nástroje vždycky na rychlost a jednoduchost.
Frameworky s headless prohlížečem — Playwright, Puppeteer, Selenium, browser crawlery v Crawlee — skutečně spouštějí JavaScript, a tím pádem stojí reálný výpočetní výkon. Data HTTP Archive za rok 2024 uvádějí mediánovou velikost JavaScript payloadu na mobilu 558 KB a 22 samostatných JS requestů — to je zátěž, kterou musí headless browser zpracovat při každém načtení stránky, zatímco statický parser si prostě vezme surové HTML.
A Scrapy je zvláštní prostřední pozice, kterou je dobré ještě jednou připomenout: není to ani jedno. Je to plnohodnotný crawl framework bez nativního renderingu, který potřebuje scrapy-playwright, pokud vůbec potřebuješ JS.
Skryté náklady na „zdarma“: proxy, výpočetní výkon a hodiny údržby
Licenční poplatek ve výši nula dolarů je jen jedna položka v celkových nákladech, ne celý příběh. Skutečný model nákladů bych rozdělil do několika konkrétních částí:
Výpočetní výkon. Provoz headless prohlížečů ve velkém znamená platit za browser-sekundy, ne jen za čas serveru. Ceník AWS Fargate uvádí zhruba $0.000011244 za vCPU-sekundu a $0.000001235 za GB-sekundu pro Linux/x86 — vynásob to počtem souběžných instancí Playwrightu a náklady rostou rychleji, než většina lidí čeká.
Proxy. Veřejné sazby Bright Data uvádějí residential proxy od zhruba $5/GB a datacentrové proxy od $0.9/IP — a „bandwidth“ v těchto modelech zahrnuje jak request, tak response payloady, ne jen data, která stahuješ. Tohle bývá položka, která týmy zaskočí: obejití rate limitů a blokací není zdarma, ale pravidelná položka v infrastrukturním rozpočtu.
Údržba. Každý statický parser a každý nástroj založený na strukturálních pravidlech je zranitelný vůči redesignům webu, které rozbijí tvoje selektory. I příklad v README u AutoScraper potřeboval po změně cílového webu aktualizaci ceny. To je ta kategorie „skrytých nákladů na compute/proxy“, kterou žádná nulová cenovka licence nezmiňuje — hodiny práce vývojářů strávené opravami rozbité extrakce poté, co tým cílového webu nasadí redesign.
Pro týmy, které na to narážejí pořád — neustálé rozbíjení selektorů, správa účtů u proxy, DevOps režie, která nikdy nekončí — self-hosted open source stack není automaticky levnější volba, když započítáš i čas inženýrů. Chrome rozšíření od Thunderbit Chrome extension jde pro netechnické uživatele jinou cestou: otevřeš autorizovanou stránku, klikneš na One Click Extract a nástroj stránku analyzuje a sám zjistí, co má vytáhnout — bez selektorů a bez udržovacích skriptů pokaždé, když se změní layout. Není to náhrada za Scrapy v měřítku crawl frameworku, ale je to rozumný další krok pro business uživatele, který si dosud ručně udržoval křehkou sadu pravidel v AutoScraperu.
Rozhodovací rámec: jak sladit správný nástroj s omezeními vašeho týmu
Většina srovnání skončí u „nejlepší pro X use case“. To je ale jen jedna proměnná. V praxi týmy současně řeší minimálně čtyři: potřeba renderování JS × jazyk týmu × požadovaný výstup × licenční omezení.
| Situace týmu | Nejvhodnější nástroj(e) | Proč |
|---|---|---|
| Python, statické HTML, rychlý skript | BeautifulSoup, AutoScraper | Není potřeba JS, MIT licence, minimum nastavení |
| Python, velký strukturovaný crawl | Scrapy | BSD-3-Clause, vestavěné pipeline, scrapy-playwright jen když je JS opravdu nutný |
| Node/TypeScript, produkční crawl s JS | Crawlee | Apache-2.0, nativní podpora prohlížeče zabudovaná do queue systému |
| Více jazyků, široká matice prohlížečů | Selenium | Apache-2.0, nejširší pokrytí jazyků i prohlížečů |
| Moderní automatizace SPA, cross-browser | Playwright | Apache-2.0, nativní rendering, auto-wait vestavěný |
| Automatizace zaměřená na Chrome se screenshoty/PDF | Puppeteer | Apache-2.0, hluboká integrace s CDP |
| Markdown pipeline pro LLM/RAG | Crawl4AI | Apache-2.0 + klauzule o uvedení autorství; ověř si s právníkem, jestli ti dodatečná podmínka vyhovuje |
| Prompt-driven, nepravidelná extrakce | ScrapeGraphAI | MIT, ale počítej s náklady na tokeny LLM |
| Self-hosted crawler podobný API, tolerantní k AGPL | Firecrawl | AGPL-3.0-or-later; před budováním closed-source SaaS na tomhle základu si nech dát právní souhlas |
| Enterprise Java/Hadoop indexace | Apache Nutch | Apache-2.0, navržený pro vyhledávací infrastrukturu |
| No-code, občasné použití, netechnický uživatel | Web Scraper extension | Zdarma lokálně; než předpokládáš plnou transparentnost, pochop split open-core modelu |
Srovnání všech 12 open source web scraperů vedle sebe
| Nástroj | Jazyk | Licence | Bezpečné pro komerční použití? | Renderování JS | Náročnost naučení | Nejlepší pro |
|---|---|---|---|---|---|---|
| BeautifulSoup | Python | MIT | ✅ Ano | Žádné (vyžaduje spojení s jiným nástrojem) | Nízká | Parsování statického HTML |
| Selenium | Vícejazyčné | Apache-2.0 | ✅ Ano | Nativní | Střední | Testování a scraping napříč více prohlížeči/jazyky |
| Playwright | JS/TS/Python/Java/.NET | Apache-2.0 | ✅ Ano | Nativní | Střední | Moderní weby náročné na JS |
| Puppeteer | Node.js/TS | Apache-2.0 | ✅ Ano | Nativní | Střední | Automatizace zaměřená na Chrome |
| Crawl4AI | Python | Apache-2.0 + klauzule o uvedení autorství | ⚠️ Zkontroluj klauzuli | Nativní (přes Playwright) | Střední | Markdown pipeline pro LLM/RAG |
| Firecrawl (self-hosted) | TypeScript | AGPL-3.0-or-later (core) | ⚠️ Podmíněně | Nativní (přes Playwright) | Vysoká (více služeb) | Self-hosted AI crawling, tolerance k AGPL |
| ScrapeGraphAI | Python | MIT | ✅ Ano | Nativní (přes Playwright) | Střední | Extrakce v přirozeném jazyce |
| AutoScraper | Python | MIT | ✅ Ano | Žádné | Nízká | Lehká opakovaná práce na statických stránkách |
| Scrapy | Python | BSD-3-Clause | ✅ Ano | Potřebuje doplnit | Vysoká | Velké crawl projekty statických webů |
| Crawlee | Node.js/TS | Apache-2.0 | ✅ Ano | Nativní | Střední | Produkční crawlery v Node.js |
| Apache Nutch | Java | Apache-2.0 | ✅ Ano | Potřebuje plugin | Vysoká | Enterprise vyhledávací indexace |
| Web Scraper (extension) | N/A (no-code) | Open-core | ⚠️ Záleží na tarifu | Nativní (v běžícím prohlížeči) | Nízká | Příležitostné použití bez programování |
Závěr: který open source web scraper byste měli použít?
Neexistuje jediný „nejlepší“ nástroj — správná volba závisí na licenčních omezeních, jazyku tvého týmu a na tom, jestli jsou data ve statickém HTML, nebo schovaná za JavaScriptovou zdí. Scrapy vyhrává pro velké Python crawl projekty nad statickými weby. Playwright nebo Crawlee vyhrávají ve chvíli, kdy je renderování JS nepodkročitelné. Crawl4AI dává smysl, pokud krmíš LLM pipeline, s tím, že jeho licenční soubor obsahuje navíc klauzuli o uvedení autorství, kterou si stojí za to rychle přečíst. Self-hosted jádro Firecrawl je výkonné, ale přináší AGPL debatu, jejíž součástí by měl být tvůj právní tým.
A pokud ti údržba selektorů a správa proxy bere víc hodin než samotné scrapování, bývá to signál, že je čas podívat se na no-code alternativu jako Thunderbit místo toho, abys na self-hosted OSS stack vrstvil další a další vrstvu.
FAQ o open source nástrojích na web scraping
Je legální používat open source web scrape nástroje pro firemní sběr dat?
Obecně platí, že scrapování veřejně dostupných dat nese menší riziko než scrapování za přihlášením nebo paywallem, ale neznamená to automaticky, že je ve všech případech legální. Vždy zkontroluj podmínky použití cílového webu a soubor robots.txt — i když je dobré vědět, že robots.txt je požadavek, ne autorizační mechanismus, takže jeho respektování je dobrá praxe, ale samo o sobě nedává právní svolení. Uplatňují se i zákony na ochranu osobních údajů, jako je GDPR, bez ohledu na to, zda jsou data veřejně viditelná. Nejde o právní radu — pro cokoli nad rámec příležitostného, nízkoobjemového použití se poraď s právníkem.
Znamená „open source“, že je nástroj zdarma i pro komerční použití?
Ano, v tom smyslu, že Open Source Definition zakazuje licencím diskriminovat komerční použití. Ale „komerčně použitelné“ a „bez povinností“ jsou dvě různé věci — AGPL-3.0 (použitá u self-hosted jádra Firecrawl) komerční použití dovoluje, ale zároveň vyžaduje, abys nabídl odpovídající zdrojový kód pro upravené verze poskytované přes síť. MIT, BSD a Apache-2.0 takový požadavek nemají.
Jaký je rozdíl mezi open source scraperem a no-code scraping nástrojem?
Open source scrapery jako Scrapy, Playwright nebo BeautifulSoup vyžadují, abys psal kód, spravoval infrastrukturu a sám řešil logiku crawlů, proxy i exporty. No-code nástroje jako Chrome rozšíření Web Scraper nebo browser extension od Thunderbit řeší detekci polí a extrakci přes vizuální rozhraní nebo AI analýzu stránky, takže obětuješ část flexibility výměnou za mnohem nižší vstupní bariéru.
Který open source web scraper je nejlepší pro netechnické uživatele?
Téměř každý nástroj v tomhle seznamu — Scrapy, Playwright, Puppeteer, Crawlee a další — počítá s tím, že umíš programovat. Pro netechnické uživatele nabízí Chrome rozšíření Web Scraper point-and-click nastavení, i když plánování a cloud funkce jsou až v placené verzi. Praktický start je ale agentní no-code nástroj jako browser extension od Thunderbit, pokud chceš automatickou detekci polí bez sahání na selektory.
Proč Scrapy potřebuje na renderování JavaScriptu samostatný plugin?
Scrapy bylo navrženo jako HTTP-first framework — posílá requesty a parsuje HTML, které se vrátí, aniž by spouštělo klientské skripty. Díky tomu je rychlé a lehké pro crawling statických webů, ale zároveň to znamená, že obsah vyrenderovaný JavaScriptem v odpovědi, kterou Scrapy dostane, prostě není. scrapy-playwright tuhle mezeru překlene tím, že konkrétní requesty směruje přes skutečnou instanci Playwrightu, když je rendering nevyhnutelný.
Zjistěte více
- 15 nejlepších projektů na GitHubu pro web scraping v roce 2026 a nejlepší no-code alternativa
- Crawl4AI spouští skutečný prohlížeč, aby vytvořil Markdown — a ne, tvoje selektory to samo neopraví
- Prošel jsem Playwright a Puppeteer stejnými scraping testy
- Top 10 no-code web scraperů pro automatizovaná řešení
- Je web scraping nelegální? Právní dopady a co znamenají v praxi



