
Někde v redakci vyjde nový článek každých pár sekund, konkurence vypustí tiskovou zprávu o půlnoci a regulatorní podání, které opravdu potřebujete vidět, skončí na čtvrté straně webu nějakého úřadu. Nikdo nemá čas hlídat desítky otevřených záložek v prohlížeči. Právě proto se z pojmu „news scraper“ stal samostatný produktový segment — a také proto jsou většinou nákupní průvodci k němu dost k ničemu.
Při rešerši jsem narážel pořád na stejný problém: většina přehledů typu „nejlepší news scraper“ si vybere jednu cestu a drží se jí. Jeden článek hodnotí jen no-code SaaS nástroje. Jiný zase pokrývá jen Python knihovny, jako by každý čtenář na světě uměl napsat Scrapy spidera. Ani jeden přístup nepomůže člověku, který zjišťuje, jestli potřebuje rozšíření do prohlížeče, API klíč, nebo víkend s pip install. Proto tenhle seznam rozděluje všech deset nástrojů do tří kategorií — no-code/agentické, spravované API a kódovací knihovna — a nechává vás vybrat podle skutečné úrovně znalostí a počtu zdrojů, které potřebujete sledovat, ne podle toho, kdo zaplatil za první místo.
Co dělá nejlepší news scraper v roce 2026?
Tady opravdu záleží na šesti věcech a podle nich posuzuji každý nástroj níže:
- Vhodnost pro kategorii — jde o nástroj na pár kliknutí, spravované API, které řeší infrastrukturu, nebo kódovací knihovnu, se kterou si vše stavíte sami?
- Snadnost použití pro neprogramátory — tohle se neustále objevuje ve fórech u dotazů na „web data scraper, který zvládne i neprogramátor“, a nejde o žádný okrajový problém.
- Schopnost škálování — zvládne 20, 100 nebo 1 000 news zdrojů bez toho, aby někdo musel pro každý ručně přepisovat pravidla?
- Upřímné zacházení s anti-bot ochranou a renderováním JS — ne marketingové sliby typu „zaručeně obejde“, ale to, co se skutečně stane, když web nasadí JavaScript, CAPTCHA nebo paywall.
- Cenový model — předplatné, kredity nebo platba za požadavek, a jestli ekonomika dává smysl pro objem typický pro news monitoring.
- Možnosti exportu — CSV, JSON, Sheets, Airtable, webhook, cokoli, co dostane data tam, kam mají jít.
Pokud nástroj v use case sledování zpráv nesplní většinu z toho, nezáleží na tom, jak hezky vypadá jeho GitHub hvězdičkování.
No-code vs API vs kód: do které cesty se news scraper hodí právě vám?
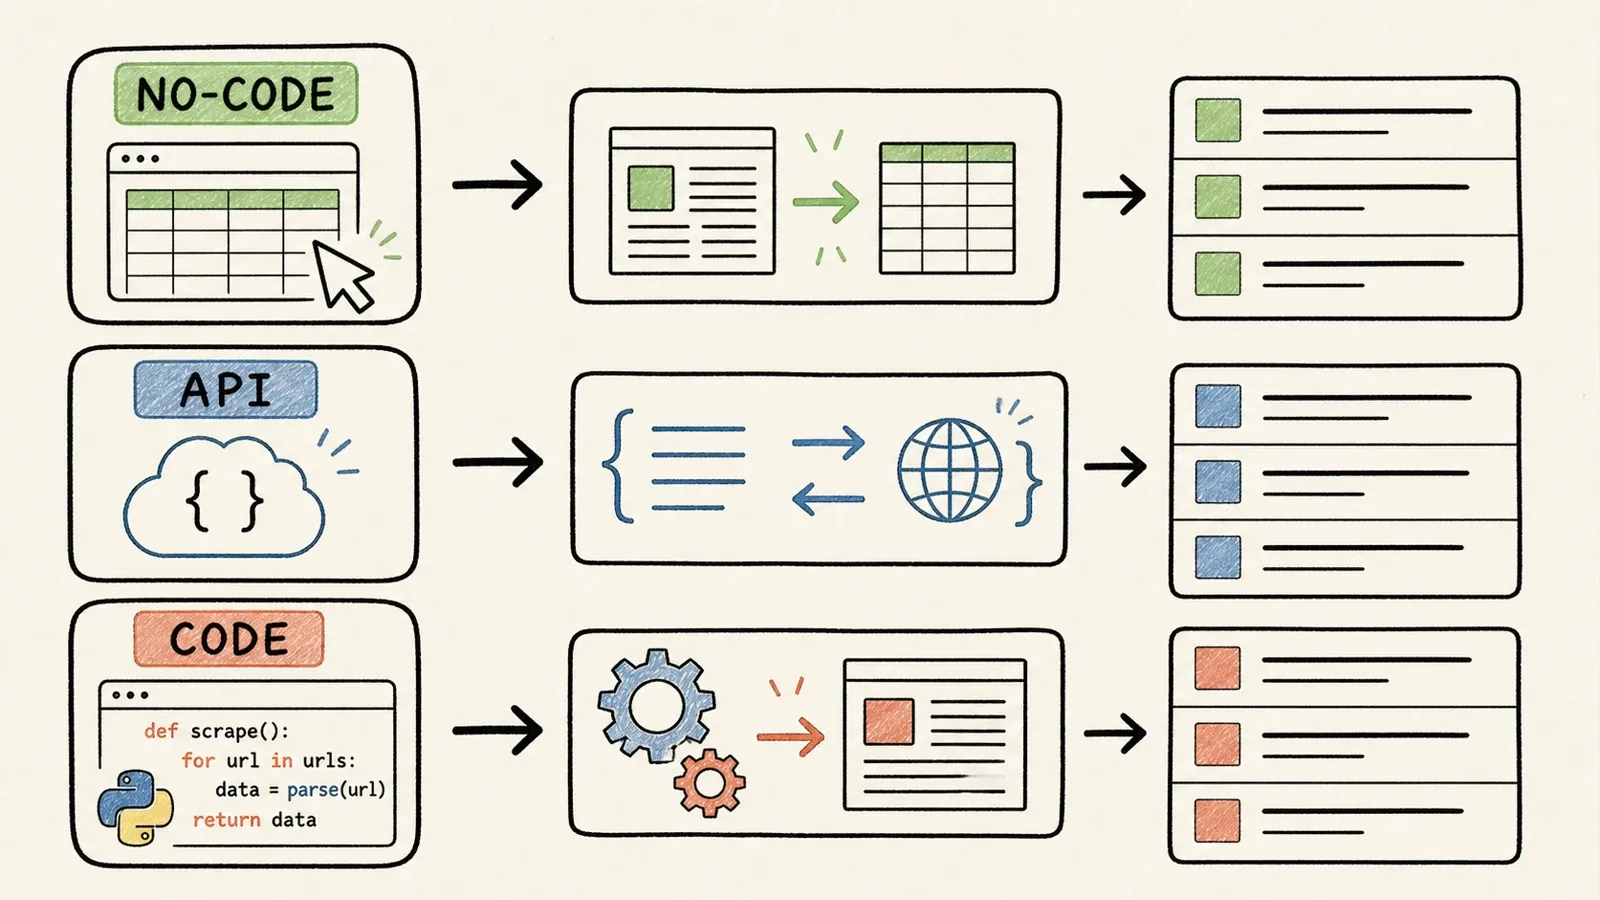
Většina žebříčků „top 10“ hází tyhle tři kategorie do jednoho pytle, jako by soutěžily o stejnou práci. Nesoutěží.
No-code/agentické nástroje jsou pro byznys uživatele — obchod, operations, research, marketing — kteří potřebují tabulku titulků a odkazů, aniž by sáhli na jediný řádek kódu. Spravovaná API jsou pro vývojáře, kteří nechtějí sami provozovat proxy infrastrukturu nebo headless browsery; pošlou URL, dostanou HTML nebo JSON a zbytek pipeline postaví nad tím. Knihovny a frameworky pro kódování jsou pro inženýry, kteří chtějí naprostou kontrolu nad crawlingem, parsingem, retry logikou a vším ostatním — za cenu toho, že si sami nesou celou údržbu.
Thunderbit je dobrý příklad toho, jak vypadá no-code cesta v praxi. Thunderbit Chrome extension funguje přes workflow One Click Extract — kliknete, nástroj si stránku přečte a zjistí, co na ní je, a pak zobrazí Run Now. Když kliknete, extrakce začne hned. Když nic neuděláte, začne sama po pár sekundách. Není potřeba psát selektory ani nejdřív definovat schéma. Je to přímá odpověď na stížnost „scraper pro neprogramátory“, kterou člověk vidí na fórech pořád dokola — i když, jako u každého nástroje na tomto seznamu, funguje jen na stránkách, ke kterým máte oprávněný přístup, a není to nástroj na obcházení paywallů.
Pokud vás zajímá širší pohled na to, kam se tahle kategorie posunula, mrkněte na naše vlastní rozebrání AI web scrapingu a na to, co „no-code“ vlastně znamená, když se scraper tak označuje.
Nejdřív zkontrolujte tohle: Neexistuje už RSS feed nebo News API?
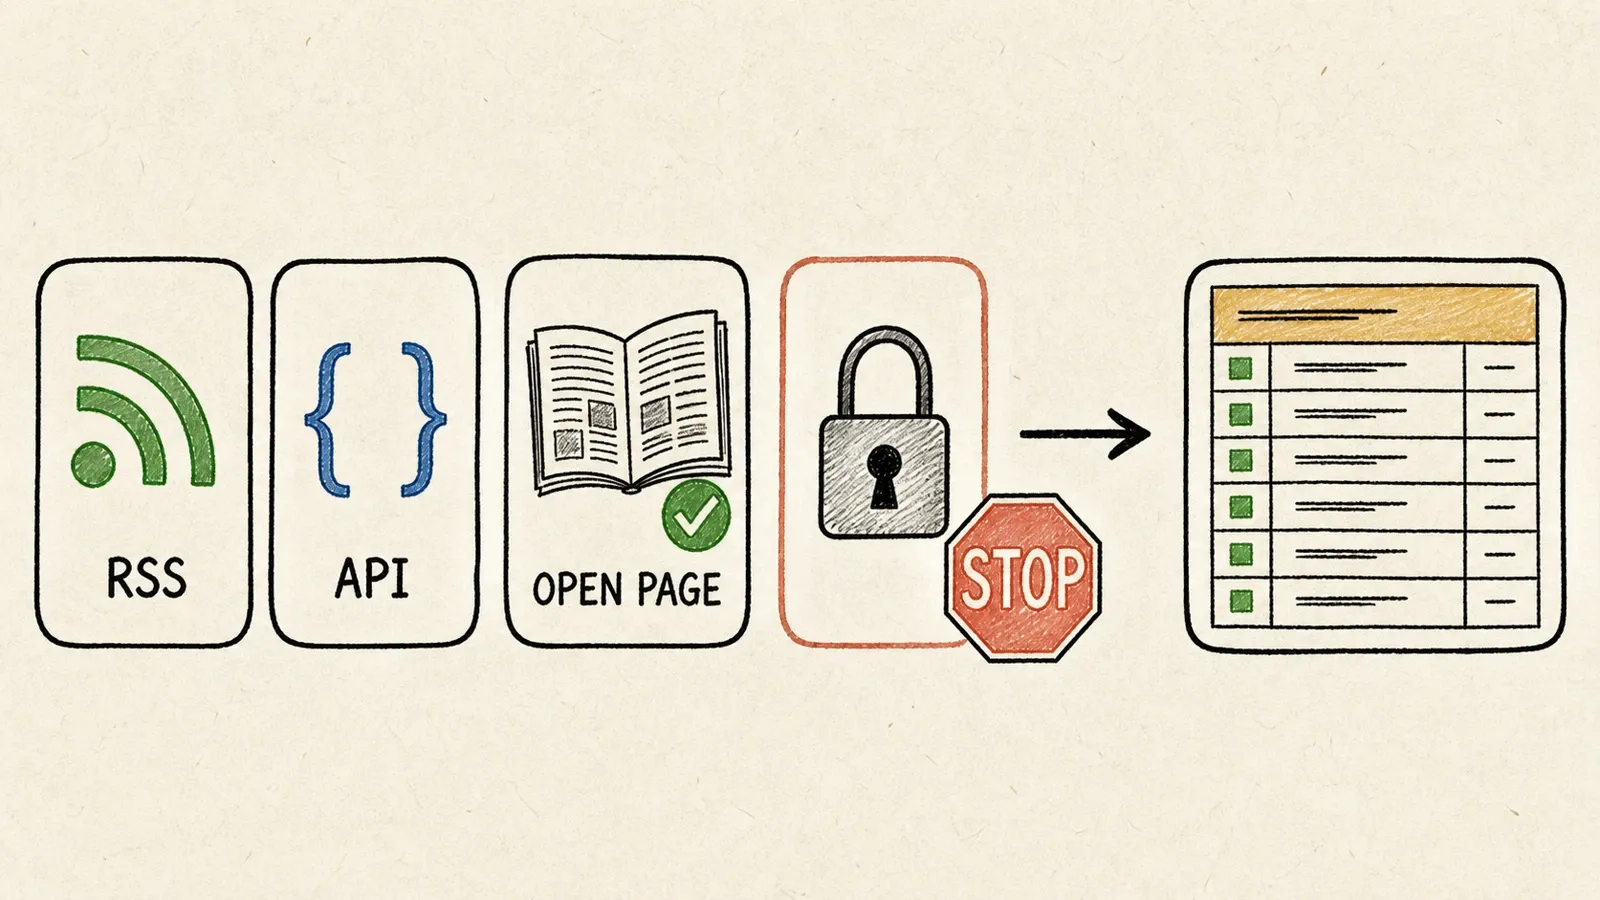
Než cokoli postavíte nebo zaplatíte, ověřte si, jestli vám vydavatel data už nenabízí zdarma. Zní to samozřejmě. Lidé to ale pořád vynechávají.
Většina zpravodajských webů stále podporuje RSS nebo Atom feedy, které lze najít přes standardní tagy <link rel="alternate"> definované v WHATWG HTML specifikaci — a samotná specifikace RSS 2.0 je už tak stará, že by v mnoha zemích mohla legálně pít alkohol. sitemap.xml vydavatele, podle protokolu Sitemaps, vám také může dát přehledný seznam URL článků, aniž byste se dotkli jediného navigačního menu.
Kromě jednotlivých vydavatelů existuje i pár agregátorů:
- NewsAPI — komerční API pro agregaci zpráv s bezplatnou vývojářskou úrovní a placenými produkčními tarify; než na tom postavíte něco v produkci, zkontrolujte si podmínky pro free tier.
- GDELT — obrovský, bezplatný, první stranou poskytovaný globální dataset zpráv a událostí s DOC 2.0 API. Je opravdu užitečný pro vyhledávání a trendovou analýzu, ale projekt sám uvádí doporučení k rate limiting, takže ho neberte jako nekonečný had.
Scraping je pořád správná volba, když zdroj nemá feed, feed nevrací pole, která potřebujete (třeba celý text článku), nebo sledujete tolik zdrojů, že potřebujete jednu sjednocenou pipeline místo deseti různých formátů. Jen to nejdřív zkontrolujte. Je to nejlevnějších deset minut, které na tomhle projektu strávíte.
Nejlepší news scrapery na první pohled
Cenové jednotky tady nejsou přímo srovnatelné — kredity, „úspěšné požadavky“, compute units a fixní předplatné měří různé věci. Před závazkem si vždy ověřte aktuální čísla.
| Nástroj | Kategorie | Pro koho je nejlepší | Zpracování JS / anti-bot | Je potřeba kódování | Cenový model |
|---|---|---|---|---|---|
| Thunderbit | No-code / agentický | Pro neprogramátory, kteří potřebují rychlou extrakci z otevřených news stránek | Funguje na kompatibilních, autorizovaných stránkách; bez záruky na tvrdé paywally | Ne | Free tier + placené tarify na kredity, aktuální ceny zde |
| Octoparse | Vizuální no-code scraper | Klikací workflow s šablonami | Vestavěný prohlížeč, ruční nastavení AJAX | Ne až málo | Free tier + předplatné |
| Apify | Actor platforma | Pro vývojáře, kteří chtějí předpřipravené i vlastní scrapery ve větším měřítku | Záleží na konkrétním Actoru | Málo až středně | Free usage credit + předplatné |
| Bright Data | Spravované API/proxy | Podnikové scraping potřeby napříč regiony | Web Unlocker + samostatné Browser API | Středně | Platba podle využití + objemové tarify |
| ScraperAPI | Spravované API | Jednoduché API volání pro HTML / JS rendering | Volitelné renderování, rotace proxy | Málo (API call) | Předplatné na kredity |
| Oxylabs | Spravované API/proxy | Vysoký objem enterprise proxy potřeb | Renderování + instrukce pro browser | Středně | Ceny podle výsledků |
| Crawlbase | Spravované API | Weby náročné na JS, extrakce zaměřená na články | Renderování JS tokenem + proxy | Málo (API call) | Free allowance + dynamické ceny podle domény |
| Scrapy | Kódovací framework | Python crawlery s vysokou mírou kontroly | Ruční řešení (potřebuje middleware / browser integraci) | Vysoká | Zdarma, open-source |
| Beautiful Soup | Knihovna pro parsing | Lehké zpracování HTML pro statické stránky | Žádné (spolu s Requests) | Vysoká | Zdarma, open-source |
| Selenium | Knihovna pro automatizaci browseru | Stránky renderované přes JS nebo chráněné přihlášením | Skutečné spuštění prohlížeče; bez obcházení CAPTCHA | Vysoká | Zdarma, open-source |
1. Thunderbit: nejlepší no-code news scraper pro neprogramátory

Thunderbit je browserový, agentický nástroj pro extrakci dat navržený pro business uživatele — sales, research a ops týmy — ne pro vývojáře hledající vlastní pipeline. Workflow je záměrně co nejjednodušší: kliknete na One Click Extract, necháte nástroj stránku přečíst a pak stisknete Run Now (nebo ani nemusíte — po pár sekundách se to rozjede samo).
Klíčové funkce:
- Před spuštěním extrakce není potřeba žádný selektor, schema ani mapování polí
- Podpora stránkování a obohacování přes podstránky na kompatibilních stránkách, užitečná pro pattern z kategorií na články
- Export do Excelu, Google Sheets, Airtable nebo Notion
- Samostatné Open API pro týmy, které časem přerostou browser workflow
Cenově je k dispozici free tier a placené tarify na kredity — aktuální ceník zkontrolujte zde, protože limity kreditů a stránky v plánu se časem mění. Samostatné API má úplně vlastní cenovou strukturu, takže nepočítejte s tím, že kredity z rozšíření a jednotky API jsou zaměnitelné.
Nejlepší pro: výzkumníka nebo analytika, který dnes potřebuje čistou tabulku news dat, ne řízenou ingestní pipeline za šest týdnů.
Výhody a nevýhody
Výhody: bez programování, rychlé nasazení, přizpůsobí se rozložení stránky bez ručního přepisování selektorů, exportuje přímo do nástrojů, které tým už používá.
Nevýhody: není určený pro vývojáře, kteří chtějí detailní kontrolu nad requesty nebo vlastní crawl logiku. Stejně jako každý nástroj na tomto seznamu narazí na tvrdé paywally a stránky chráněné CAPTCHA — žádné kouzelné obejití neexistuje a ani by nemělo. Pro týmy, které to porovnávají s čistě ručními postupy, naše téma web scraping bez programování rozebírá trade-offy podrobněji.
2. Octoparse: nejlepší vizuální news scraper na klikání

Octoparse dává neprogramátorům vizuální plátno pro tvorbu scraping workflow — kliknutí, smyčky, pravidla stránkování a čekací podmínky — ve vestavěném browseru. Z hlediska ruční kontroly je o úroveň výš než agentické nástroje a z hlediska složitosti o úroveň níž než kódovací frameworky.
Klíčové funkce:
- Vestavěný browser spouští JavaScript a zvládá obsah načítaný přes AJAX, i když načasování často vyžaduje ruční konfiguraci
- Knihovna šablon obsahuje kategorii News & Media a dedikovanou šablonu pro CNN
- Lokální běhy pro testování a cloud scheduling pro opakované úlohy
- Free tier podporuje lokální použití až do 50 000 exportovaných řádků měsíčně u způsobilých vlastních úloh
Nevýhodou je údržba: protože workflow zakóduje konkrétní kliknutí a selektory, redesign vydavatele může rozbít smyčku nebo pole stejně jako ručně napsané Scrapy pravidlo. Ceník začíná free lokální úrovní, Standard je za 83 USD/měsíc (nebo 69 USD/měsíc při roční platbě) se třemi souběžnými cloud procesy a Pro je za 299 USD/měsíc (nebo 249 USD/měsíc ročně) s 20 souběžnými cloud procesy.
Nejlepší pro: neprogramátory, kteří chtějí víc explicitní kontroly nad interakcí se stránkou než nabízí plně automatický nástroj, a nevadí jim občasná údržba šablon.
3. Apify: nejlepší actor-based scraping platforma pro vývojáře

Apify funguje na tzv. Actors — zabalených, hostovaných scraping programech s definovanými vstupy a výstupy. Některé spravuje přímo Apify, jiné komunita a další si můžete vytvořit sami. Není to tedy jeden produkt, ale spíš marketplace, což má své výhody i nevýhody.
Klíčové funkce:
- Udržovaný Website Content Crawler vytváří čistý text/Markdown výstup vhodný pro search nebo LLM pipeline
- Existují komunitní Actors pro Google News, ale spolehlivost i cena se liší podle autora — před použitím si vždy zkontrolujte konkrétní Actor
- Plánování, webhooky a API triggery pro opakované úlohy
- Export datasetů do JSON, CSV, XML, Excelu, HTML, RSS a JSONL
Ceník začíná zdarma s 5 USD měsíčního usage kreditu, poté Starter za 29 USD/měsíc, Scale za 199 USD a Business za 999 USD — k tomu se přidávají náklady podle využití i ceny jednotlivých Actorů. Celkový účet závisí hlavně na tom, které Actors používáte a zda pod kapotou běží plnohodnotný browser.
Nejlepší pro: technické týmy, které jsou ochotné posuzovat a vyměňovat komponenty místo nákupu jednoho pevně daného endpointu.
4. Bright Data: nejlepší enterprise proxy infrastruktura pro news scraping
Bright Data je lepší chápat jako stack než jako jeden produkt. Discovery datasety řeší vyhledávání, Web Unlocker obstarává získávání veřejných stránek s routováním a řízením přístupu a Browser API poskytuje vzdálený browser pro JavaScriptem těžké stránky. Není tu žádné univerzální „News Scraper API“ — skládáte jednotlivé části dohromady.
Klíčové funkce:
- Široké geo-targetingové možnosti pro regionální vydání
- Oddělené nástroje pro retrieval a plný browser, takže náklady zvyšujete jen tam, kde je to nutné
- API a webhook doručování pro integraci do pipeline
Ceny Web Unlockeru zahrnují 5 000 bezplatných požadavků měsíčně, poté platbu podle využití za 1,50 USD za 1 000 úspěšných požadavků (tarif 499 USD/měsíc to snižuje na 1,30 USD/1 000 a obsahuje 383 000 požadavků). Browser API se účtuje podle bandwidth — od 8 USD/GB při platbě podle využití. Je dobré vědět, že Bright Data ve svých podmínkách definuje „successful“ podle statusu odpovědi, ne podle validity článku, takže s rozpočtem počítejte opatrně.
Nejlepší pro: enterprise týmy, které už mají vlastní logiku pro extrakci a validaci a potřebují pod ní hlavně robustní routing infrastrukturu.
5. ScraperAPI: nejlepší jednoduché API pro škálování news požadavků
ScraperAPI je v této skupině nejpřímočařejší spravované fetch API. Pošlete URL, dostanete HTML, text nebo Markdown, a volitelně i JavaScript rendering a geografické směrování.
Klíčové funkce:
render=truespouští headless Chrome pro stránky renderované na klientovi- Pro některé cíle existují vestavěné parsers (například výsledky Google News), ale neexistuje univerzální parser pro články všech vydavatelů
- DataPipeline podporuje naplánované low-code úlohy až s 10 000 URL na běh
- Batch requests zvládají až 50 000 URL asynchronně
Ceník začíná zdarma s 1 000 kredity, poté Hobby za 49 USD/měsíc (100 000 kreditů, 20 souběžných požadavků, pouze US/EU) a postupně roste až na Business za 299 USD/měsíc (3 miliony kreditů, globální routing). Důležité upozornění: cena kreditů se liší podle typu požadavku — standardní stránka stojí 1 kredit, JavaScript rendering 10 a premium-plus-render požadavek 25. Hromada neúspěšných 404 může nenápadně sežrat měsíční limit.
Nejlepší pro: vývojáře, kteří chtějí náhradu za přímé HTTP requesty bez nutnosti sami spravovat proxy nebo browser infrastrukturu.
6. Oxylabs: nejlepší vysokokapacitní enterprise proxy služba
Oxylabs nabízí v této sadě jednu z nejširších pracovních ploch: univerzální získávání URL, volitelné renderování, browser instructions pro klikání a čekání, custom parsing a vestavěný scheduler s cron syntaxí.
Klíčové funkce:
- Univerzální cíl pro libovolné veřejné URL a navíc dedikovaný parser pro vyhledávání Google News
- Podrobné response codes, které rozlišují plný úspěch od částečného nebo chybějícího obsahu — mnohem užitečnější než prostý HTTP status
- Cloud doručování do S3, GCS a dalších objektových úložišť
- Vlastní scheduler výslovně varuje, že netestované plány mohou rychle nafouknout náklady, což je u cenové stránky až překvapivě upřímné
Ceník nabízí free trial (až 2 000 výsledků), Micro za 49 USD/měsíc, Starter za 99 USD/měsíc a Business za 999 USD/měsíc, přičemž cena za výsledek klesá s objemem. Jeden háček: Oxylabs v současnosti účtuje i odpovědi 4xx jako zpoplatněné „úspěšné“ výsledky, takže i stránka, která nic užitečného nevrátí, vás může něco stát.
Nejlepší pro: enterprise týmy, které potřebují geo-flexibilní, vysoce průchodné získávání dat a nevadí jim složitější API povrch.
7. Crawlbase: nejlepší API pro parsování news webů s těžkým JS
Crawlbase se víc než většina spravovaných API na tomto seznamu zaměřuje na výstup vhodný pro články. Jeho Crawling API nabízí normální token pro statický obsah a JavaScript token pro plné renderování v browseru, plus režim pro čitelnost.
Klíčové funkce:
md_readability=truevrací Markdown, který odstraňuje běžnou navigaci, sidebary a reklamní šum, ale snaží se zachovat hlavní článek- Generic Extractor pro extrakci obsahu, titulku a metadat bez ohledu na web
- Ovládání klikacích selektorů, scrollování a čekání u interaktivních JS stránek
- Enterprise Crawler přidává asynchronní frontu s retry logikou až na 48 hodin — hodí se pro backfill, méně pro breaking news alerty
Ceník zahrnuje až 20 000 bezplatných požadavků, poté cena závisí na složitosti cílové domény, ne na jedné fixní sazbě — než nastavíte rozpočet, ověřte si kalkulaci na reálných news zdrojích. Přímá async podpora je v dokumentaci aktuálně uvedena jen pro LinkedIn, pokud ji jinde nepovolí podpora, takže nepočítejte s tím, že platí univerzálně pro libovolné vydavatelské domény.
Nejlepší pro: týmy, které chtějí renderovaný, na články zaměřený výstup bez stavby vlastního readability parseru od nuly.
8. Scrapy: nejlepší kódovací framework pro vlastní news crawlery
Scrapy je v tomto seznamu nejsilnější volba pro inženýry, kteří chtějí skutečně vlastnit crawler. Je to Python framework, aktuálně ve verzi 2.17.0, který nativně řeší plánování requestů, deduplikaci, retry, cookies i pipeline.
Klíčové funkce:
- CSS a XPath selektory přes Parsel pro přesnou extrakci
- AutoThrottle a omezení concurrency podle domény pro šetrné crawlery
- Middleware hooky pro proxy, hlavičky a vlastní retry logiku
- Vlastní průvodce dynamickým obsahem doporučuje nejdřív hledat vložené JSON nebo strukturovaná data a teprve pak sahat po plné browser integraci
Cena: zdarma, open-source, bez poplatku za request. Skutečné náklady jsou v computingu, nasazení a něčím, co někdo musí držet na pohotovosti. Běžné Scrapy requesty nespouštějí JavaScript, takže weby závislé na JS potřebují doplněk jako scrapy-playwright — a stojí za zmínku, že Scrapy samo ve své dokumentaci varuje před řízením headless browseru přímo uvnitř spidera, protože to může obejít middleware a deduplikaci.
Nejlepší pro: engineering týmy, které staví dlouhodobý, vícedoménový crawler, který chtějí samy vlastnit a udržovat.
9. Beautiful Soup: nejlepší lehká knihovna pro statické news stránky
Beautiful Soup je parser, ne crawler — rozdíl, který se v mnoha přehledech „nejlepší scraper“ úplně zplošťuje. Vezme HTML nebo XML, které už jiný nástroj stáhl, a vytvoří z něj strom, ve kterém lze procházet. Na PyPI je aktuálně ve verzi 4.15.0.
Klíčové funkce:
- Podpora více parserů (
html.parser,lxml,html5lib) s různým poměrem rychlosti a tolerantnosti podle oficiální dokumentace - Podpora CSS selektorů přes Soup Sieve pro známou syntaxi
- Obvykle se páruje s Requests knihovnou pro samotné HTTP stažení
- Výborné pro parsing vloženého JSON-LD nebo Open Graph metadat, která už jsou v počátečním HTML stránky
Cena: zdarma, open-source. Nenabízí ale žádné síťové funkce, retry, rotaci proxy ani vykonávání JavaScriptu — to není jeho úkol. Je to správný nástroj ve chvíli, kdy tým už má oprávněně stažené markup a jen z něj potřebuje vytáhnout strukturovaná pole.
Nejlepší pro: inženýry, kteří staví menší až střední pipeline, kde stahování řeší jiná komponenta.
10. Selenium: nejlepší browserová automatizace pro JS renderované nebo přihlášením chráněné news
Selenium ovládá skutečné prohlížeče, a proto je správnou volbou ve chvíli, kdy obsah existuje až po spuštění JavaScriptu nebo když úloha vyžaduje autorizovanou přihlášenou relaci. Aktuální verze je 4.47.0.
Klíčové funkce:
- Selenium Manager automaticky vyhledává a ukládá kompatibilní browser drivery, čímž snižuje tření při setupu
- Explicit wait strategie navázané na stav stránky místo pevných prodlev, což je na moderních news webech, které po načtení dál injektují obsah, hodně důležité
- Podpora headless Chrome přes
--headless=newpro serverové běhy - Může fungovat v autorizované přihlášené relaci, pokud to podmínky vydavatele dovolují
Cena: zdarma, open-source — ale výpočetní výkon browseru, kontejnery a údržba driverů jsou reálné provozní náklady a provoz jednoho browser instance na jeden článek je špatná architektura pro cokoli nad malou výjimkovou frontou. Vlastní testovací doporučení Selenium výslovně odrazuje od automatizace CAPTCHA, což je až osvěžující upřímnost u nástroje, o kterém si většina lidí myslí, že prorazí cokoli silou.
Nejlepší pro: úzkou eskalační vrstvu pro stránky závislé na JS nebo autorizované relace — ne výchozí transport pro stovky běžných článků.
Škálování na 100–1 000+ news zdrojů: proč fixní selektory selhávají
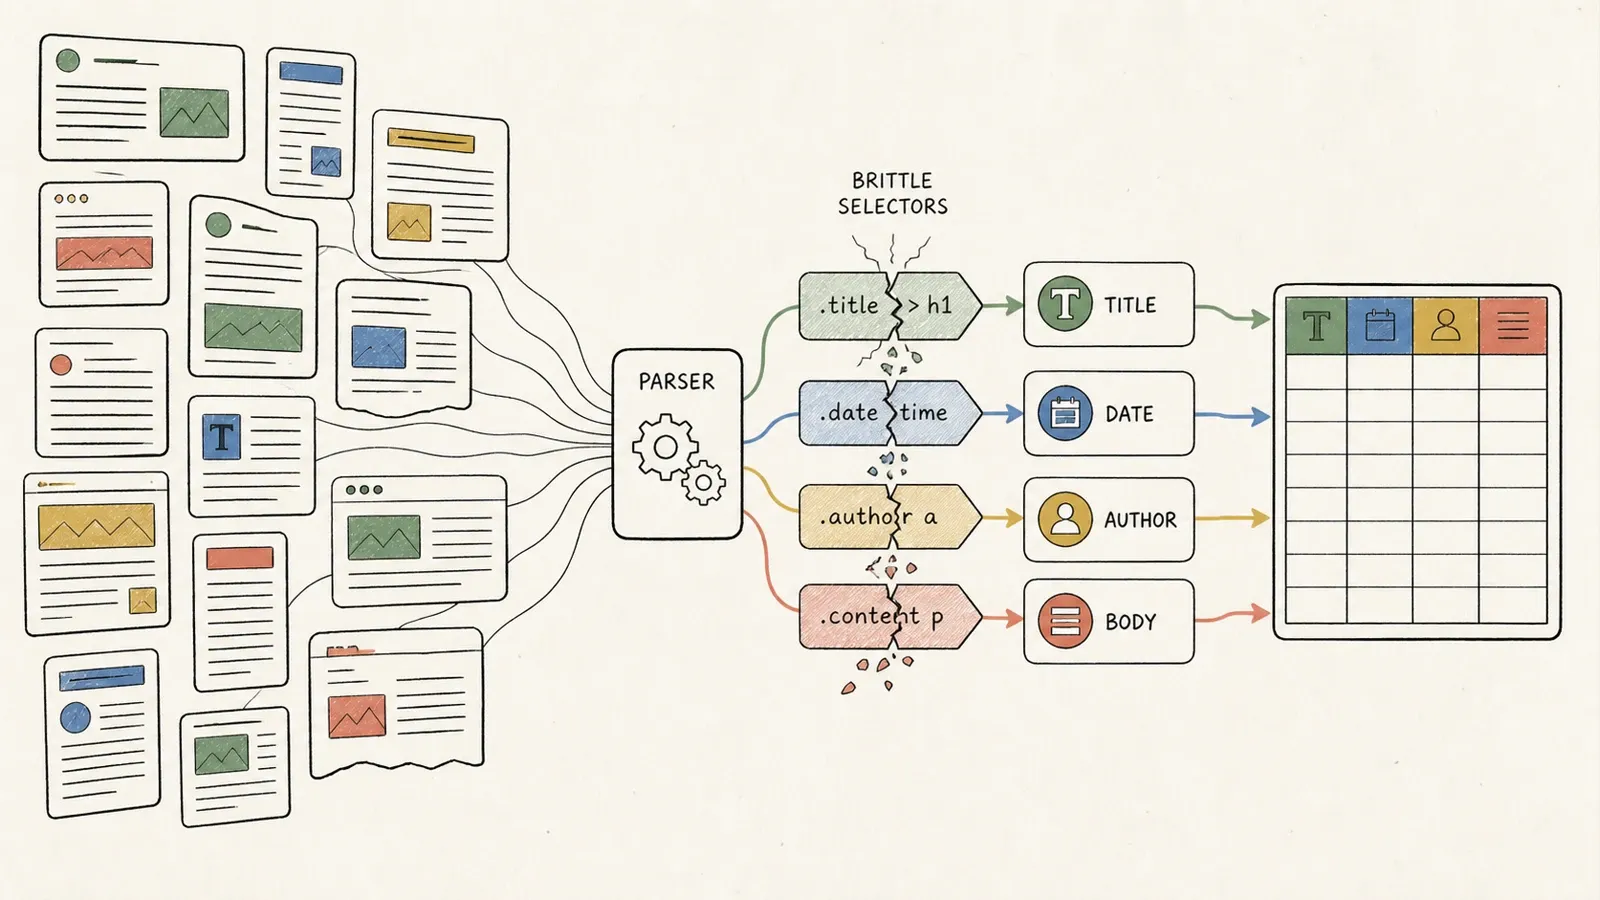
CSS a XPath pravidla v sobě nesou jednu předpokládanou pravdu: „titulek je v téhle třídě“. Ten předpoklad platí do chvíle, než vydavatel udělá redesign, spustí A/B test layoutu nebo přejde na jiný CMS — a pak pravidlo tiše selže, nebo hůř, vrátí špatná data bez varování. Scraper může hlásit úspěch, ale místo hlavního článku stáhne teaser na související články, nebo místo původního data publikace vrátí datum poslední aktualizace. To je mnohem nebezpečnější selhání než prázdný výsledek, protože si ho nikdo nevšimne, dokud na špatných datech nepadne rozhodnutí.
Nástroje založené na statických selektorech — Scrapy, Beautiful Soup, no-code platformy se šablonami — tenhle problém dědí. AI-driven nebo agentické rozpoznávání polí, jaké používá Thunderbit a podobné nástroje, snižuje závislost na přesných názvech tříd tím, že při každém běhu znovu analyzuje strukturu stránky místo spoléhání na napevno napsané pravidlo. To je při škálování skutečná výhoda. Není to ale bezúdržbová garance — jde o nahrazení deterministického rozhodování pravděpodobnostním, což jeden typ chyby mění za jiný.
V reálném měřítku (100 až 1 000+ zdrojů) není řešení v tom vybrat jeden kouzelný nástroj. Je to postavit registry zdrojů: které weby mají feedy, které vyžadují HTML scraping, jaká pole očekáváte, jaké jsou limity pro jednotlivé domény a jaký bude karanténní postup pro cokoli, co vrátí challenge page místo článku. Feedy první, strukturovaná metadata druhá, obecná nebo AI extrakce třetí, zdrojem specifická pravidla jen pro nejcennější výjimky a browser rendering jen tam, kde je skutečně potřeba. Samotná dokumentace Scrapy k dynamickému obsahu říká v podstatě totéž — nejdřív zkontrolujte strukturovaná data a teprve pak sahajte po browseru.
Anti-bot ochrana a renderování JS: co jednotlivé přístupy umí — a neumí
Marketing v téhle oblasti často hází dohromady pět úplně různých problémů do jednoho: client-side rendering, interakční stavy (kliknutí, scroll, consent bannery), omezení provozu, požadavky na přihlášení a licenční práva na obsah. Jen první dva jsou skutečně problémy renderování. Zbytek s JavaScriptem nesouvisí.
Tady je upřímné rozdělení podle nástrojů: rotace proxy (Bright Data, Oxylabs) mění routing a může snížit tření s rate limitingem, ale nevytváří oprávnění tam, kde žádné není. Spravované renderování (Crawlbase, ScraperAPI) spouští JavaScript, takže se objeví obsah renderovaný na klientovi, ale renderovaná stránka stále může vrátit přihlášení nebo prompt k předplatnému — renderování jen zpřístupní problém, ne že by ho obešlo. Automatizace headless browseru (Selenium) umí řídit skutečné interakce, ale i vlastní dokumentace Selenium říká natvrdo, že není určené k obcházení CAPTCHA. Stejně funguje i renderování a práce s přístupem v Thunderbit — jen na kompatibilních, autorizovaných stránkách, bez předstírání, že prorazí tvrdý paywall typu velkých předplatitelských médií.
Žádný z deseti nástrojů v tomto článku nezaručuje přístup přes CAPTCHA, login wall ani paywall. Kdo tvrdí opak, prodává něco, co neexistuje. Když stále narážíte na zeď, správný krok je najít oficiální feed, API nebo licenční dohodu — ne eskalovat scrapingové taktiky.
Je legální scrapovat news obsah? Autorské právo a podmínky služby
Tohle není právní rada a výsledky se opravdu liší podle jurisdikce i způsobu použití — ale pár hranic je dobré znát, než na něčem začnete pracovat.
Fakta nejsou chráněná autorským právem; výraz obvykle ano. Circular 33 U.S. Copyright Office a 17 U.S.C. §102 to vymezují jasně. Fakt uvedený v článku není chráněný jen proto, že ho vydavatel zveřejnil jako první — ale jeho skutečné znění, struktura a fotografie obvykle chráněné jsou. Pro news scraping je to zásadní rozdíl, protože news obsah (na rozdíl od otevřeného datasetu nebo firemního katalogu) je téměř vždy chráněný ve své vyjádřené formě.
Fair use je test z více faktorů, ne limit slov, podle 17 U.S.C. §107. Shrnutí Copyright Office k případu Associated Press v. Meltwater je tady užitečné varování: komerční služba pro monitoring zpráv, která kopírovala úryvky článků, nebyla na základě těchto konkrétních faktů považována za fair use. To není obecné pravidlo proti monitoringu — je to připomínka, že „jen to indexujeme“ automaticky nevyhrává.
Na straně přístupu jsou rozsudek devátého okruhu hiQ Labs v. LinkedIn a rozhodnutí Nejvyššího soudu Van Buren, která zúžila, jak daleko sahá Computer Fraud and Abuse Act — ale ani jedno nedává obecné oprávnění ignorovat podmínky služby vydavatele nebo obcházet technická přístupová omezení. A robots.txt, standardizovaný v RFC 9309, je výslovně popsaný jako protokol, ne bezpečnostní mechanismus — respektovat ho je dobrá praxe, ale není to ani právní zelená na obou stranách.
Praktický postup: soustřeďte se na veřejně dostupná data, znovu nepublikujte celý text článků, zachovejte atribuci zdroje a kanonické odkazy, a než začnete scrapovat cokoli za paywallem nebo stavět produkt, který ve velkém redistribuuje celé články, zapojte právníka.
Který news scraper si máte vybrat?
Pokud nejste technický člověk a potřebujete mít tabulku titulků už zítra, začněte
Learn More




