
Jedna stránka s výsledky Google Shopping může skrývat sponzorované pozice mezi organickými výsledky, u zboží bez skladové dostupnosti úplně vynechat cenu a stejný produkt duplikovat u pěti různých prodejců. Posledních pár týdnů jsem rozebíral devět nástrojů, které tvrdí, že tenhle chaos přetaví do čistých, použitelných dat — a upřímná odpověď je, že „nejlepší“ záleží čistě na tom, jestli jste vývojář, který staví datový pipeline, nebo marketér, který chce do pátku dostat čísla do tabulky.
Tohle rozdělení je vidět všude i při průzkumu. Na r/learnpython a r/node si lidé předávají poznatky o Puppeteeru, Playwrightu a rotaci proxy. Na r/PPC zase hledají něco ve stylu „prostě mi dejte data, na kód se nechci ani podívat“. Místo abych těchto devět nástrojů seřadil podle abecedy nebo každému nadělil nálepku „nejlepší celkově“ podle toho, kdo má nejpůsobivější homepage, ohodnotil jsem je podle šesti konkrétních kritérií a seřadil podle workflow — nejdřív spravovaná SERP API, potom proxy a scraping infrastruktura, pak vývojářská actor platforma a nakonec no-code nástroj v prohlížeči.
Co dělá z Google Shopping Scraperu „ten nejlepší“? Naše hodnoticí kritéria
Většina seznamových článků si slovo „nejlepší“ pořádně nafoukne, tak tady je přesně to, co tím myslím v tomto článku. Všech devět nástrojů jsem hodnotil podle stejných šesti faktorů, místo abych opakoval marketingová tvrzení jednotlivých vendorů:
- Pokrytí dat — vrací dokumentované schéma spolehlivě cenu, prodejce, hodnocení, počet recenzí, dopravu a skutečné rozlišení mezi sponzorovanými a organickými výsledky?
- Podpora locale/geo — dokáže cílit na konkrétní zemi, jazyk nebo zařízení, nebo jste vydaní na milost tomu, kam se náhodně přeloží IP adresa proxy?
- Složitost nastavení — je to API klíč a GET request, nebo fronta s callbacky, nebo dvoukrokový workflow navázaný na tokeny, nebo stránka, na kterou jen kliknete?
- Údržbová náročnost — kdo řeší, když Google změní HTML strukturu nebo zobrazí CAPTCHA: vy, nebo vendor?
- Cesta exportu/integrace — JSON export, nebo přímé napojení do Sheets, Airtable či datového skladu?
- Cenová transparentnost — zveřejňuje vendor skutečnou cenu za jednotku, ze které si to spočítáte, nebo musíte „kontaktovat obchod“, abyste zjistili, co co stojí?
Jednu věc tady dělat nebudu: vymýšlet úspěšnost, rychlost nebo přesnost v procentech. Nikdo z tohoto seznamu neprovedl nezávislý benchmark proti ostatním a tvrzení vendorů o „99,9% úspěšnosti“ nebo „bleskové rychlosti“ jsou reklamní text, ne měření. Co naopak dostanete, je to, co skutečně prokazuje dokumentace jednotlivých vendorů — a ukazuje se, že to je víc než dost.
Vývojáři chtějí kód, marketéři chtějí nulový kód
Pokud se pohybujete kolem scrapingových fór, už tenhle rozdíl znáte. Přesto stojí za to ho pojmenovat, protože vysvětluje pořadí v tomhle seznamu. Vývojáři, kteří staví datový pipeline, chtějí API klíč, předvídatelné JSON, jasné parametry pro locale a schéma, které mohou dál validovat a normalizovat. To jsou ti, kdo se ptají na rotaci proxy a vykreslování v headless prohlížeči.
Lidé z marketingu a PPC chtějí něco blíž „ukázat na stránku a dostat tabulku“. Nechtějí udržovat Puppeteer skript pokaždé, když Google potřetí během čtvrtletí upraví shopping layout (a ono se to stane — Google mění shopping markup dost často na to, aby o tom i API vendři vydávali changelogy).
Tento seznam tedy postupuje od poskytovatelů spravovaných SERP API (SerpApi, Serper, SearchAPI, DataForSEO) — strukturované JSON, žádná práce s proxy, ale pořád vyžadují kód — přes proxy a scraping infrastrukturu (Bright Data, Oxylabs), která dává víc kontroly za cenu složitějšího nastavení, pak přes plně přizpůsobitelnou vývojářskou actor platformu (Apify) a končí u Thunderbit, no-code agentického browserového nástroje pro lidi, kteří opravdu nechtějí psát ani udržovat scrapingový kód.
Přehled 9 nejlepších Google Shopping Scraperů
| Nástroj | Model získávání dat | Složitost nastavení | Podpora locale | Nejvhodnější pro | Údržbová náročnost |
|---|---|---|---|---|---|
| SerpApi | Spravované Shopping API | Nízká (API klíč) | Silná (location, gl, hl, device) | Datoví inženýři, SEO nástroje | Na straně vendora |
| Serper | Obecné SERP API, Shopping jako jeden typ výsledku | Nízká | Střední (země/jazyk v dokumentaci) | Vývojáři citliví na cenu | Na straně vendora |
| SearchAPI | Spravované Shopping + Product Offers API | Nízká až střední (pro offers dvoukrokově) | Střední | Týmy porovnávající nabídky/prodejce | Na straně vendora |
| DataForSEO | Task-based Merchant API | Střední (queue/callback) | Silná | Hromadné/plánované pipeline | Na straně vendora |
| Bright Data | Dataset + Scraper API + SERP API | Střední (dle rozhraní) | Velmi silná | Firemní datové týmy | Sdílená |
| Oxylabs | Dvoukrokové search + product-detail API | Střední (navazování tokenů) | Velmi silná | Firemní datové týmy | Sdílená |
| Scrapingdog | Vyhrazený Shopping endpoint | Nízká až střední | Střední | Vývojáři s ohledem na rozpočet | Na straně vendora |
| Apify | Actor/developer platforma | Střední až vysoká | Záleží na actorovi | Stavitelé vlastních pipeline | Uživatel spravuje |
| Thunderbit | Agentické no-code získávání v prohlížeči | Velmi nízká (One Click Extract) | Záleží na cílové stránce | Marketéři/PPC, neprogramátoři | Nízká, závislá na stránce |
(Před nasazením si na aktuální dokumentaci každého vendora ověřte aktuální ceny, kreditové limity a pokrytí locale — mění se to rychle a několik z těchto nástrojů už v roce 2026 vydalo breaking changes.)
1. SerpApi — Spravované, bohaté na funkce a explicitně cache-aware
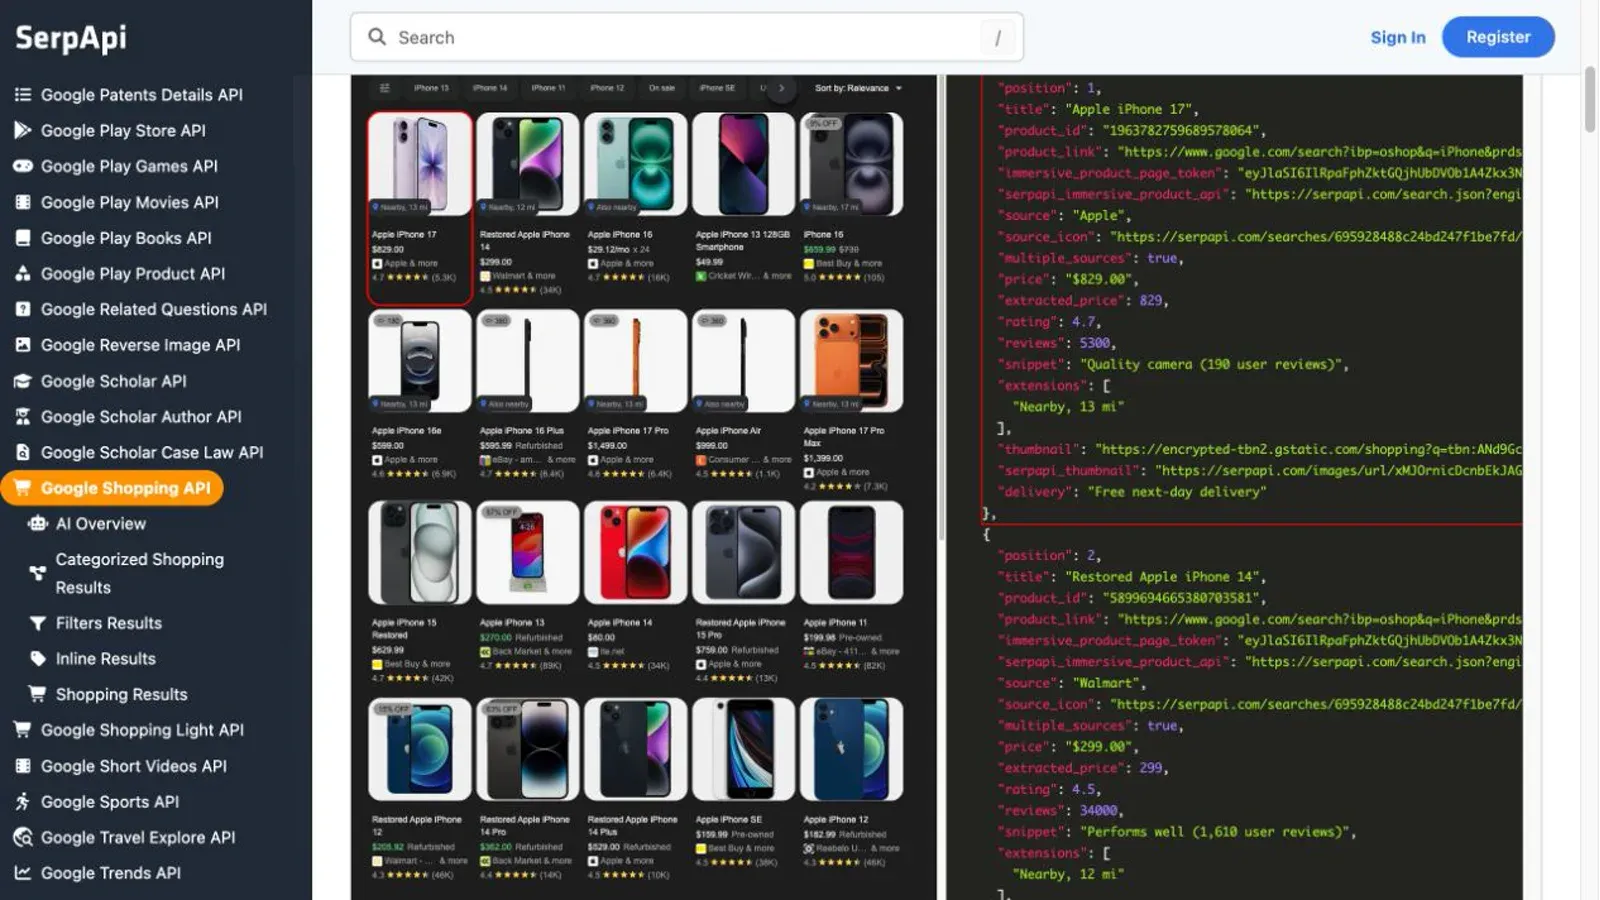
SerpApi provozuje dedikovaný Google Shopping engine (engine=google_shopping), který vezme váš dotaz a vrátí strukturované shopping_results — pozici, název, ID produktu, cenu plus extrahovanou číselnou cenu, původní/na splátky, dopravu, stav, hodnocení, recenze a obrázky. To je opravdu silné schéma a SerpApi navíc samostatně dokumentuje sponzorované Shopping výsledky přes Google Ads Shopping schema, takže sponzorované pozice najdete — jen ne jako jedno spolehlivé pole sponsored: true/false přímo v odpovědi z dedikovaného Shopping endpointu.
SerpApi odlišuje to, že otevřeně popisuje věci, na které vás jinde nechají narazit až později. Cílení podle lokace podporuje standardní městskou location nebo přesné uule, plus samostatné parametry gl (země), hl (jazyk) a device (desktop, tablet, mobile). A přímo uvádí, že identické dotazy mohou být ve výchozím nastavení cachované až hodinu — cache hity jsou zdarma, no_cache=true vynutí čerstvé stažení. To je typ informace, kterou většina vendorů schovává nebo přeskakuje.
Ceny (ověřeno 2026-08-13) jsou veřejné a měsíční: Free tier s 250 searchi, Starter za $25 za 1 000 až po Big Data za $275 za 30 000. Do kvóty se počítají jen úspěšné searche — cachované a neúspěšné požadavky ji neubírají. Důležité: Google na začátku roku 2026 podal na SerpApi žalobu kvůli metodám získávání dat; SerpApi toto označení zpochybňuje a tvrdí, že přistupuje k veřejným, neautentizovaným výsledkům. Je to živá právní situace, ne verdikt, takže to berte jako rizikový faktor, který je potřeba sledovat, ne jako důvod nástroj rovnou odmítnout.
Nejlepší pro: vývojáře, kteří chtějí nejbohatší dokumentované Shopping schéma a co nejjasnější kontrolu nad cache a locale.
2. Serper — Rychlý, cenově příznivý a s nejčistším tvrzením o čerstvosti dat
Serper se profiluje jako obecné Google SERP API, kde je Shopping vedle Search, Images, News, Maps a dalších typů výsledků. Pokud už taháte běžné výsledky vyhledávání a Shopping data chcete jen přidat, je to mnohem méně frikční než stavět dalšího specializovaného vendora.
Veřejný příklad pro Shopping vrací název, zdroj, přímý odkaz na obchod, formátovanou cenu, dopravu, rating, počet hodnocení, počet nabídek, product ID a pozici — pro základní monitoring produktových karet velmi solidní, i když veřejná dokumentace neukazuje stejnou hloubku detailů o nabídkách prodejců nebo cenových promo polích jako SearchAPI či Oxylabs. Největší prodejní argument Serperu je jeho slib čerstvosti: uvádí, že každý request jde na Google živě a nic se necachuje, takže odpadá rozhodování kolem cache, které musí řešit uživatelé SerpApi (za cenu toho, že platíte za každý opakovaný dotaz, ať je cachovaný nebo ne).
Ceny fungují na předplacených kreditových balíčcích místo předplatného — 2 500 free queries na start, pak $50 za 50 000 kreditů a při vyšších objemech klesá cena až na $0,30 za 1 000, s platností kreditů šest měsíců. Cenová stránka také říká něco příjemně upřímného: jednotlivé requesty mohou trvat 2–4 sekundy „when it must retry the request to Google“, což je reálný latency tail, se kterým je potřeba počítat, ne benchmark, kvůli kterému panikařit.
Nejlepší pro: týmy, které už integrují širší SERP API a chtějí Shopping jako bonus, ne jako samostatný produkt.
3. SearchAPI — Silné detailní údaje na úrovni nabídek, ale s jedním dokumentačním háčkem
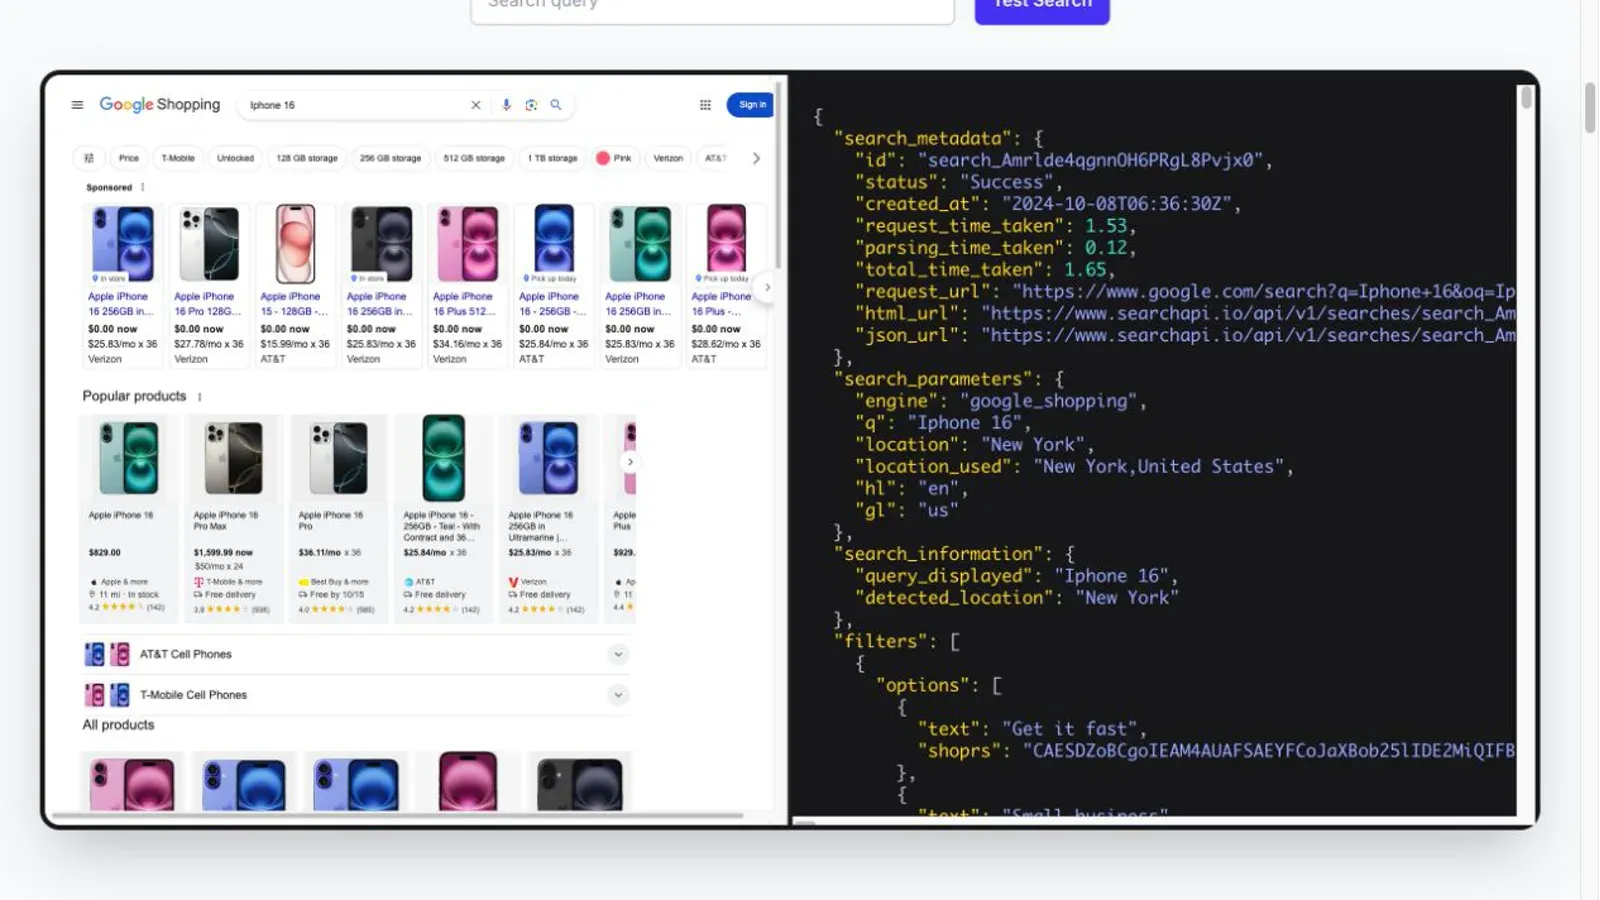
SearchAPI používá dvoukrokový workflow, který je opravdu užitečný, pokud potřebujete porovnávat ceny na úrovni jednotlivých prodejců. Shopping endpoint vrací obvyklá pole karty plus product_token — a ten odemyká samostatné Product Offers API, které vrací pole offers s merchant linkem, cenou, cenou dopravy, celkovou cenou, skladovou dostupností a platebními metodami podle jednotlivých prodejců. Pokud je váš use case „ukaž mi, za kolik se přesně tento produkt prodává u různých sellerů“, je to v tomhle seznamu nejpřímější cesta.
Je tu ale jeden reálný problém, který stojí za upozornění: k 15. květnu 2026 si kvůli změnám Googlu SearchAPI vynutilo čerstvý product_token pro každý request — starší parametry product_id/prds teď vrací prostou chybu 400. Pokud integrujete podle starších ukázek kódu nebo návodů, rozbije se to tiše, dokud si toho nevšimnete.
SearchAPI také výslovně upozorňuje, že filtrování v přirozeném jazyce přímo v dotazu (například „under $30“ nebo „used“) je jen nápověda, ne striktní filtr — Google může i tak vrátit výsledky mimo něj, když je shoda vzácná. Striktní cestou jsou kódované filtry shoprs. A je tu ještě jeden nevyřešený dokumentační rozpor, který stojí za zmínku: SearchAPI endpoint prodává jako „real-time“, ale v jeho vlastním datovém zpracovatelském ujednání stojí, že kvůli výkonu výsledky cachuje. Veřejně není zdokumentované žádné TTL, takže pokud vám na rychle se měnících cenách záleží, otestujte to opakovanými dotazy, než na předpokladu čerstvosti postavíte celý pipeline.
Ceny (ověřeno 2026-08-13) začínají na $40/měsíc za Developer tier za $4 na 1 000 searchů a při vyšších objemech klesají, s dokumentovaným měsíčním limitem 20 % vašich měsíčních kreditů za hodinu.
Nejlepší pro: týmy dělající srovnání na úrovni sellerů a nabídek, které zvládnou dvourequestový workflow a samy si otestují čerstvost dat.
4. DataForSEO — Merchant a Shopping data ve velkém, přes frontu
DataForSEO je v téhle skupině opravdu výjimka, protože nejde o live request/response API — je to task-based fronta. Pošlete task s klíčovým slovem, lokací a jazykem, dostanete zpět ID tasku a buď pollingem čekáte na výsledek, nebo nastavíte callback URL. Standardní retrieval; pro core Shopping endpointy tu žádný live režim není, ať už obecný marketing říká cokoli.
To je důležité, protože to mění úvahu o složitosti nastavení. Není to vyloženě těžké, ale je to jiný mentální model než „volej API a dostaneš JSON zpět“ — spravujete stav tasku a dokumentace DataForSEO přímo říká, že callback server, který neodpoví do 10 sekund, přesune task do fronty „Tasks Ready“, kterou pak musíte ručně pollingovat.
Kde si zaslouží místo v seznamu, je hromadný průzkum: endpoint Products vrací rank, doménu, název, cenu, starou cenu, rating a počet hlasů, s explicitními identifikátory typů výsledků, které odlišují google_shopping_sponsored_carousel od google_shopping_paid a organických výsledků — opravdu jedno z nejjasnějších rozlišení sponzorované vs. organické v celém seznamu. Výslovně také uvádí, že product_id je dynamické a může být null, a že personalizované faktory hodnocení (historie uživatele, preference lokace) jsou z výsledků záměrně vyloučeny — užitečná dávka upřímnosti, kterou většina vendorů vynechává.
Ceny se účtují podle bloků výsledků (40 pro Products, 10 pro Sellers/Reviews) při standardní rychlosti fronty až 45 minut, nebo přes prioritní frontu až do jedné minuty za dvojnásobnou cenu. Nové účty dostávají $1 trial credit bez expirace.
Nejlepší pro: týmy, které zvládají frontové, task-based workflow a potřebují velké objemy merchant/product dat podle plánu.
5. Bright Data — Tři produkty s jedním štítkem
Tady musím zpomalit, protože Bright Data ve skutečnosti nabízí tři různé způsoby, jak získat Google Shopping data, a ty fungují úplně jinak. Je tu předsbíraný dataset (marketingově uváděný jako více než 7,4 miliardy záznamů, doručovaný jako JSON/CSV/Parquet do vašeho cloud warehouse podle plánu), Google Scraper API s vyhrazenými Shopping scraper IDs, které běží synchronně nebo asynchronně, a SERP API, které načítá živé Shopping URL a výsledky parsuje v reálném čase. Brát to jako jeden produkt je přesně místo, kde se spousta srovnávacích článků začíná motat — já to tady dělat nebudu.
Ukázková data datasetu sama ukazují hodnoty null pro product ID, description, rating i počet recenzí u některých záznamů — dobrý důkaz z první ruky, že „strukturovaný dataset“ neznamená „každé pole je vždy vyplněné“. SERP API navíc samostatně dokumentuje Product Listing Ads jako vlastní typ výsledku (top_pla, bottom_pla, jackpot_pla) s názvem, cenou, obchodem a pořadím — opravdu užitečné rozlišení sponsored-vs-organic, pokud pracujete konkrétně se SERP API, ne s datasetem.
Asynchronní úlohy přes Scraper API mohou vrátit celkové „success“, zatímco jednotlivé vstupy v dávce selžou — dokumentace výslovně říká, že je třeba kontrolovat pole errors a retryovat je jednotlivě, což je údržbový detail, se kterým je dobré počítat, pokud spouštíte velké dávky.
Ceny (ověřeno 2026-08-13) se dramaticky liší podle rozhraní: dataset ukazoval $250 za 100 000 jednorázových záznamů, SERP API uvádělo 5 000 free měsíčních requestů a pay-as-you-go za $1,50/1 000, a dedikované Shopping Scraper API mělo zvlášť svůj vlastní free tier i sazbu. Nepředpokládejte, že jsou tyto ceny zaměnitelné — ověřte konkrétní produktovou stránku, kterou skutečně používáte.
Nejlepší pro: enterprise týmy, které chtějí jednu platformu pokrývající jak připravené datasety, tak živý API přístup, a jsou ochotné nacenit každé rozhraní zvlášť.
6. Oxylabs — Nejpřehlednější dvoukrokový řetězec pro search a detail produktu
Oxylabs rozděluje Shopping na dva vyhrazené cíle: google_shopping_search pro výsledky na úrovni listingů a google_shopping_product pro detailní data jednotlivých produktů, propojené product tokenem. Search response jasně odděluje pla (paid listing ads) od organic produktů — pravděpodobně nejpřehlednější dokumentované rozlišení sponsored/organic v celém seznamu — zatímco product endpoint přidává nabídky podle prodejců s číselnou cenou, stavem, daní, celkovou cenou a dopravou.
Háček, a je to skutečný háček: tenhle tokenový workflow funguje jen tehdy, když váš search request používá zároveň render: "html" i parse: true. Vynechte některý z nich a nedostanete product token, takže celý krok s detailem produktu se rozpadne. Oxylabs také výslovně varuje, že search i product request musí používat identické hodnoty lokalizace — když se geo_location mezi oběma voláními neshoduje, výsledky produktu mohou být neúplné nebo chybné. A pokud chcete rozbalit panel „More stores“ pro další nabídky prodejců, musíte mít zapnuté i renderování, což zvyšuje náklady.
Jeden detail, který se snadno přehlédne: FAQ k cenám Oxylabs definuje „successful“ (a tedy zpoplatněné) requesty tak, že zahrnují jak 2xx, tak 4xx odpovědi. Pokud je váš request špatně vytvořený, může vám být stejně naúčtován.
Product reviews jsou dokumentované pouze pro US locale a locale/language a locale/results-language jsou skutečně oddělené ovládací prvky — nastavení jednoho automaticky nenastaví druhé.
Nejlepší pro: technické týmy, které potřebují jak data na úrovni pořadí výsledků, tak detail nabídek jednotlivých sellerů, a zvládnou navázání tokenů i konzistenci locale jako součást setupu.
7. Scrapingdog — Jednoduchý endpoint, ale veřejných detailů je málo
Scrapingdog nabízí jeden vyhrazený Google Shopping endpoint, který bere API klíč a dotaz a vrací JSON s názvem, cenou a extrahovanou číselnou cenou, starou cenou, ratingem, recenzemi, zdrojem/prodejcem, dopravou a pozicí. Stránka také uvádí filtrování podle ceny, značky, země a jazyka a samostatnou kategorii odpovědí „ads“ pro sledování sponzorovaných listingů — přesné schéma ads a přesné názvy parametrů pro filtrování locale ale na veřejné stránce nejsou plně zdokumentované, takže si vyhraďte čas na testování proti vašemu konkrétnímu use case, než kolem toho postavíte automatizaci.
Tohle je jediný záznam v seznamu, kde se výpočet kreditových nákladů z veřejné dokumentace prostě nesčítá: cenová stránka Scrapingdogu ukazuje měsíční alokace kreditů (LITE za $40/měsíc za 200 000 kreditů, STANDARD za $90/měsíc za 1 000 000), ale jasně neuvádí, kolik kreditů stojí jeden Google Shopping request. Nepředpokládejte, že je to 1:1 s příklady jejich obecného search API — ověřte si to přímo u vendora, než budete počítat skutečnou cenu za query.
Stejně jako většina zdejších vendorů, i Scrapingdog marketingově uvádí vestavěné rotující rezidenční proxy a automatické řešení CAPTCHA jako něco, co spravuje vendor. Berte to jako popis hranice údržby, ne jako důkaz zaručeného přístupu.
Nejlepší pro: vývojáře s omezeným rozpočtem, kteří chtějí úzký, dedikovaný endpoint a jsou ochotni si před závazkem přímo ověřit cenu kreditů.
8. Apify — Nehodnoťte marketplace, ale konkrétního Actora
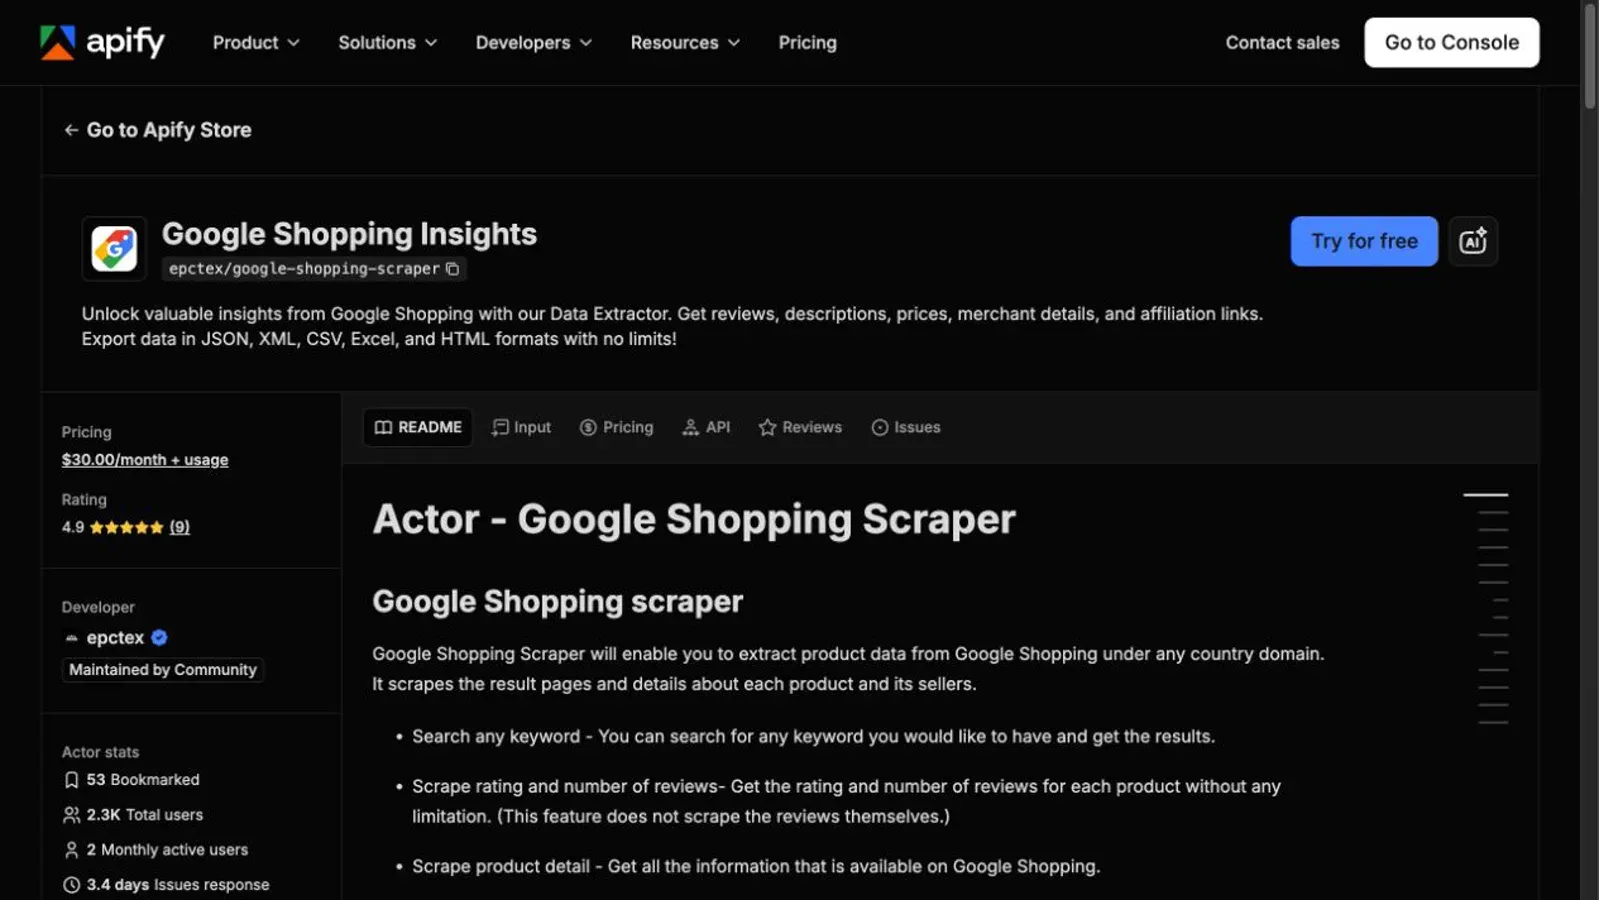
Musím být úplně otevřený: Apify není jeden Google Shopping scraper — je to marketplace nezávisle spravovaných „Actors“ a ten, na který jsem se podíval podrobněji (Google Shopping Insights, vydaný vývojářem epctex a označený jako „Maintained by Community“), se chová velmi jinak než vendorové nástroje výše. Apify dodává runtime, proxy infrastrukturu a nástroje pro dataset/export. Skutečná logika extrakce Shopping dat — i její údržba — patří epctexu, ne Apify samotnému.
Tohle rozlišení je důležité, protože ukázkový oficiální výstup tohohle konkrétního Actora má null hodnotu ceny. Ne „někdy“, ne „u zboží bez skladu“ — přímo v dokumentovaném ukázkovém záznamu je price: null a withoutDiscountPrice: null spolu s vyplněným názvem produktu, merchantem a ratingem. Je to poctivě ten nejsilnější důkaz z první ruky v celém přehledu, že cenu nelze brát jako samozřejmost, a pochází přímo z dokumentace nástroje.
Dostanete konfigurovatelné vstupy — includeSponsoredResults, includeComparisonPrices pro porovnání cen napříč prodejci, cílení podle country code, maxItemsPerQuery — a povinnou proxy konfiguraci (vaši nebo Apifyho). Výsledky se exportují jako JSON, XML, CSV nebo Excel přes systém Datasetů v Apify. V listing Store, který jsem kontroloval, bylo zhruba 2 300 celkových uživatelů, ale jen 2 měsíčně aktivní uživatelé v daném okamžiku — hodnota, kterou stojí za to si všimnout, protože „community maintained“ funguje obousměrně: flexibilní, ale jen tak spolehlivé, jak aktivně ho lidé skutečně používají a hlásí v něm problémy.
Nejlepší pro: vývojáře, kteří dokážou posoudit aktivitu údržby konkrétního Actora a zkontrolovat jeho skutečné output schéma před závazkem — ne pro kohokoli, kdo čeká, že značka Apify sama garantuje konzistentní chování.
9. Thunderbit — No-code sběr dat pro marketéry
Thunderbit představuje druhý konec tohohle seznamu: workflow v prohlížeči bez kódu pro lidi, kteří chtějí viditelnou stránku, kterou právě vidí, proměnit ve strukturovanou tabulku, místo aby integrovali Google Shopping API. To z něj dělá přirozenou volbu pro marketéry, PPC specialisty a menší ecommerce týmy, které dělají ad hoc kontroly, ne backend pipeline s vysokým objemem.
Získáte extrakci na straně prohlížeče: otevřete stránku s výsledky Shopping, která vás zajímá, nechte Thunderbit jedním klikem přečíst vykreslenou stránku a vyexportujte pole přímo do Excelu, Google Sheets, Airtable nebo Notion. Existuje tu reálné upozornění, ale patří Shoppingu, ne jednomu konkrétnímu nástroji — protože extrakce běží proti stránce před vámi, výsledek přebírá lokaci, jazyk a session daného prohlížeče. Tato nastavení si připněte, než budete tento týdenní výstup porovnávat s minulým. To je stejný problém s reliabilitou polí, který řeší další část, a platí pro každou možnost v tomhle seznamu.
Nejlepší pro: netechnické týmy, které dávají přednost viditelné, kontrolované browserové extrakci před developerem spravovaným JSON pipeline — a které stahují konkrétní Shopping stránky na vyžádání, ne běží objemný multi-geo crawl.
Jakým datům můžete skutečně věřit? Problém spolehlivosti polí
Tohle je část, kterou většina srovnávacích článků o Google Shopping úplně přeskočí, a přitom je to ta nejdůležitější věc, kterou musíte pochopit před jakoukoli automatizací: ne každé pole se objeví u každého výsledku a zacházet s „chybějící“ hodnotou jako s nulou tiše zkazí data.
| Pole | Spolehlivost | Háček |
|---|---|---|
| Název | Vysoká | Před párováním produktů mezi zdroji normalizujte varianty/balíčky |
| Product ID | Podmíněná | DataForSEO výslovně uvádí, že je dynamické a někdy null |
| Cena | Podmíněná | Vlastní oficiální příklad Apify ukazuje null cenu i u plně vyplněného záznamu |
| Seller/merchant | Obvykle přítomný | Více prodejců znamená, že jeden produkt může mít několik samostatných nabídek |
| Rating / počet recenzí | Podmíněná | Nové nebo nehodnocené produkty to mohou prostě vynechat — nepřevádějte to na nulu |
| Doprava / doručení | Nekonzistentní | Může záviset na destinaci, skladových zásobách prodejce a session |
| Sponsored flag | Závisí na nástroji | Oxylabs jasně odděluje pla od organic; několik dalších dovoluje sponzorované výsledky zahrnout/vyloučit, ale nedává spolehlivý štítek po jednotlivých řádcích |
Praktické pravidlo: než automatizujete jakýkoli workflow, vytáhněte skutečný vzorek s vašimi reálnými klíčovými slovy a podívejte se, co je skutečně null, duplikované nebo chybějící — ne co by tam podle dokumentace mělo být.
Oficiální Google Merchant Center vs. Google Shopping Scraper: Co vlastně potřebujete?
Tohle je otázka, kterou si ecommerce týmy kladou ještě předtím, než začnou porovnávat vendory, a stojí za přímou odpověď: pokud spravujete vlastní produktové listingy, ceny nebo Shopping reklamy, je to úkol pro oficiální nástroje Google Merchant Center — ne pro třetí stranu typu scraper. Scrapingové nástroje v tomhle seznamu slouží k pozorování cizích listingů: konkurenční ceny, viditelnost na trhu, průzkum kategorií, monitoring sponzorovaných pozic. Nezaměňujte to. Aktuální oficiální dokumentaci Google si ověřte přímo, protože názvy a rozsah first-party API se čas od času mění a přestavují.
Jak tyto nástroje zvládají Google anti-bot obranu
Rád to zarámuji jako otázku správy a governance, ne jako návod „jak porazit Google“, protože to je poctivý způsob, jak se na to dívat. Několik vendrů v tomhle seznamu — SerpApi, SearchAPI, Bright Data, Oxylabs, Scrapingdog — veřejně uvádí, že rotaci proxy, browser rendering a zvládání CAPTCHA řeší na své straně. To je reálná hranice údržby, které se dá přikládat hodnota: znamená to, že nejste ti, kdo ve 2 ráno debugují zablokovanou IP. Není to a nikdy by se to nemělo chápat jako záruka trvalého nebo univerzálního přístupu.
Ani u plně spravovaného vendora nezmizí potřeba řízení limitů a výdajů, klasifikace chyb, retry logiky a monitoringu toho, kdy Google něco změní (což se podle changelogů, které jsem našel u SearchAPI i Oxylabs, děje poměrně pravidelně). Bright Data explicitně dokumentuje částečné selhání batchí; DataForSEO dokumentuje chování při timeoutu callbacku; Oxylabs dokumentuje selhání neplatného tokenu. Nic z toho nejsou instrukce k obcházení čehokoli — je to poctivé vymezení, kdo zodpovídá za který failure mode.
Jak vybrat nejlepší Google Shopping Scraper pro váš tým
Postupujte takhle:
- Určete svou personu. Jste vývojář, který staví pipeline, nebo člověk z marketingu/ops, který chce výsledky bez zásahu do kódu?
- Definujte, jaká pole skutečně potřebujete. Data na úrovni pořadí výsledků jsou něco jiného než detail cen na úrovni merchant/offer — právě v tomhle SearchAPI a Oxylabs obhajují své místo.
- Buďte upřímní ohledně kapacity na údržbu. Mapa API a error handling, konfigurace Actora a proxy setup, nebo kontrolovaná browserová extrakce — vyberte si to, co váš tým dokáže dlouhodobě udržet.
- Otestujte chování locale a zařízení na reálných dotazech dřív, než se zavážete k vendoru, protože veřejná dokumentace se nemusí vždy shodovat s živým chováním.
- Ověřte, že exportní cesta sedí na váš existující stack — JSON do datového skladu je úplně jiný level práce než tabulka, kterou může marketér otevřít přímo.
Závěr: Který Google Shopping Scraper byste měli použít?
Neexistuje jeden univerzálně „nejlepší“ nástroj, a pokud vám to někdo v listicle tvrdí, buďte skeptičtí. Pokud jste vývojář a stavíte datový pipeline a chcete nejbohatší dokumentované schéma s jasnou kontrolou cache a locale, začněte u SerpApi. Pokud je vaším skutečným cílem srovnávání cen na úrovni nabídek jednotlivých prodejců, SearchAPI nebo tokenový workflow Oxylabs vás tam dostane přímočařeji. Pokud děláte hromadný, plánovaný výzkum a zvládnete task queue, DataForSEO škáluje dobře. Pokud chcete jednu enterprise platformu, která pokryje jak připravené datasety, tak živé dotazy, Bright Data pokrývá nejširší oblast — jen nacenit je potřeba každé rozhraní zvlášť.
A pokud jste z PPC nebo marketingového týmu a nechcete se dotýkat API klíče, browserová kategorie zastoupená Thunderbit je přímá odpověď na „jen potřebuju data, ne programovací projekt“. Jen si jasně ujasněte, kterou cestu volíte: browserový workflow je stavěný pro stránky, které si sami otevřete a zkontrolujete, zatímco API dokumentace a CLI Thunderbitu jsou samostatné vývojářské cesty. Vyberte si to, co odpovídá tomu, jak váš tým doopravdy pracuje.
Ať už vyberete cokoli, stáhněte si nejdřív reálný vzorek. Každý vendor v tomhle seznamu dokumentuje alespoň jedno pole, které není vždy přítomné — zkontrolujte si to, než na tom postavíte cokoli dalšího.
FAQ
Je legální scrapovat data z Google Shopping? Tohle není otázka, na kterou bych mohl dát kategorickou odpověď, a neměl by to dělat ani žádný seznamový článek. Veřejně viditelná data a tvrzení vendora o souladu s pravidly neznamenají automaticky, že je každý use case legální. Než něco postavíte, zkontrolujte aktuální podmínky služby Googlu, pro svou jurisdikci si ověřte příslušné právo a ujistěte se, že je váš způsob sběru dat oprávněný. Berte to jako situaci typu „ověřte si to s vlastním právníkem“, ne něco, co vyřeší blogový článek.
Jaký je rozdíl mezi SERP API a Google Shopping scraperem? SERP nebo Shopping API přijímá strukturované parametry requestu a vrací vám parsované JSON — vendor se stará o většinu infrastruktury pro získání dat. Browserový scraper (například Thunderbit) extrahuje data ze stránky, kterou máte vy nebo uživatel skutečně otevřenou. Datasetové produkty (například část nabídky Bright Data) doručují předem nasbírané záznamy podle plánu místo živých requestů. Účelově se překrývají, ale výrazně se liší v čerstvosti dat, kontrole locale i v tom, kolik toho skutečně musíte spravovat.
Potřebuji k scrapování Google Shopping programátorské dovednosti? Ne vždy. Celý smysl Thunderbitu je právě v no-code workflow na kliknutí. Apify lze technicky provozovat i přes webové UI bez psaní kódu, ale skutečné přizpůsobení už vyžaduje určitou technickou zdatnost. Každý API-based nástroj v tomhle seznamu — SerpApi, Serper, SearchAPI, DataForSEO, Bright Data, Oxylabs, Scrapingdog — vyžaduje alespoň základní vývojářské dovednosti: autentizaci, práci s parametry a kontrolu chyb.
Jak často se data z Google Shopping mění? Častěji, než si spousta lidí myslí, ale neexistuje univerzální pravidlo „aktualizuje se to každých X hodin“, na které byste se mohli spolehnout. Ceny, skladová dostupnost, sponzorované pozice i pořadí výsledků se mohou měnit podle session, locale i denní doby. Několik vendorů v tomhle seznamu nabízí živý/real-time režim právě proto, že cachovaná data v téhle kategorii rychle zastarávají. Pokud vaše rozhodnutí závisí na aktuální ceně, spusťte dotaz znovu místo spoléhání na výsledek ze včerejška.
Zjistit více




