
Minulý měsíc se Stripe integrace jednoho mého známého tiše začala vracet s chybami 503 ve 23:00 v pátek večer. Nikdo si toho nevšiml až do sobotního rána — a mezitím už měla podpora ve schránce přes 200 naštvaných e-mailů od zákazníků, kterým neprošly platby.
Ten příběh není nijak výjimečný. Široce citovaný benchmark uvádí průměrné náklady výpadku na 5 600 dolarů za minutu, zatímco zásadní incidenty mohou dosahovat milionů za hodinu. Skutečná částka závisí na návštěvnosti, konverzním poměru, hodnotě objednávky, expozici vůči SLA a nákladech na obnovu — ale směr je jasný: API bez monitoringu je byznysové riziko, ne jen technická nepříjemnost. A když organizace dnes provozují v průměru 131 API třetích stran a jen 16 % uvádí vysokou schopnost tato rizika zmírňovat, monitoring už prostě není volitelný. Cílem tohoto průvodce je udělat něco, co jsem jinde moc neviděl: seřadit nástroje podle vašeho use case, hodnotit kvalitu alertů, ne jen jejich existenci, ukázat reálné ceny pro rok 2026 a změřit, jak rychle je skutečně zprovozníte. Ne další suchý seznam log s názvy.
Ještě jedna věc: pokud vaše práce s API zahrnuje sběr webových dat, feedování LLM, tvorbu RAG systémů, monitoring konkurenčních stránek nebo extrakci cen a produktových dat z webů, rozhovor o „API nástrojích“ by neměl končit u uptime monitoringu. Potřebujete také spolehlivý způsob, jak převést neuspořádané webové stránky na strukturovaná data. Právě tam do tohoto přehledu zapadá Thunderbit Open API: není to nástroj na hlídání dostupnosti, ale je to jeden z nejrychlejších způsobů, jak přes API dostat weby do čistého Markdownu nebo JSONu podle schématu.
Co je monitoring API (a proč by měl váš tým řešit)?
Monitoring API znamená průběžně kontrolovat, že vaše endpointy jsou dostupné, rychlé a vracejí správná data. Nejen „je server nahoře?“ — dobrý monitor ověřuje HTTP status kódy, obsah odpovědi, latenci, SSL certifikáty, vícekrokové workflow (třeba login → vyhledávání → checkout) a dokonce i správnost schématu.
Je to něco jiného než obecný monitoring webu, který řeší, jestli se stránka načte, a také něco jiného než APM (Application Performance Monitoring), které jde do hloubky na úrovni kódu, databázových dotazů a interních běhových metrik. Monitoring API stojí na hraně: testuje to, co skutečně zažívají vaši uživatelé, partneři a integrace, když endpoint zavolají.
Stojí za zmínku i související kategorie: web data API. Ta neslouží k tomu, aby hlídala stav vašeho vlastního API; pomáhají produktu nebo workflow spolehlivě získávat externí webová data. Například Thunderbit Open API umí převést webovou stránku na čistý Markdown, vytáhnout strukturovaná pole jako JSON a zpracovávat dávky napříč mnoha URL. Pokud váš „API“ projekt závisí na čerstvých datech od dodavatelů, produktových stránkách, veřejných seznamech, dokumentaci nebo výzkumných zdrojích, může být takové API pro extrakci dat stejně důležité jako samotné kontroly dostupnosti.
Proč by to měly řešit i ne-technické týmy? Protože API tvoří 71 % dynamického webového provozu a 62 % odborníků na API říká, že API přímo generují příjem. Když selže platební brána, autentizační služba nebo shipping API, není to abstraktní problém infrastruktury — znamená to ztrátu tržeb, porušené smlouvy s partnery, nárůst ticketů na podpoře a oslabenou důvěru. Produktoví manažeři, obchod, operations i customer success v tom všichni jedou spolu.
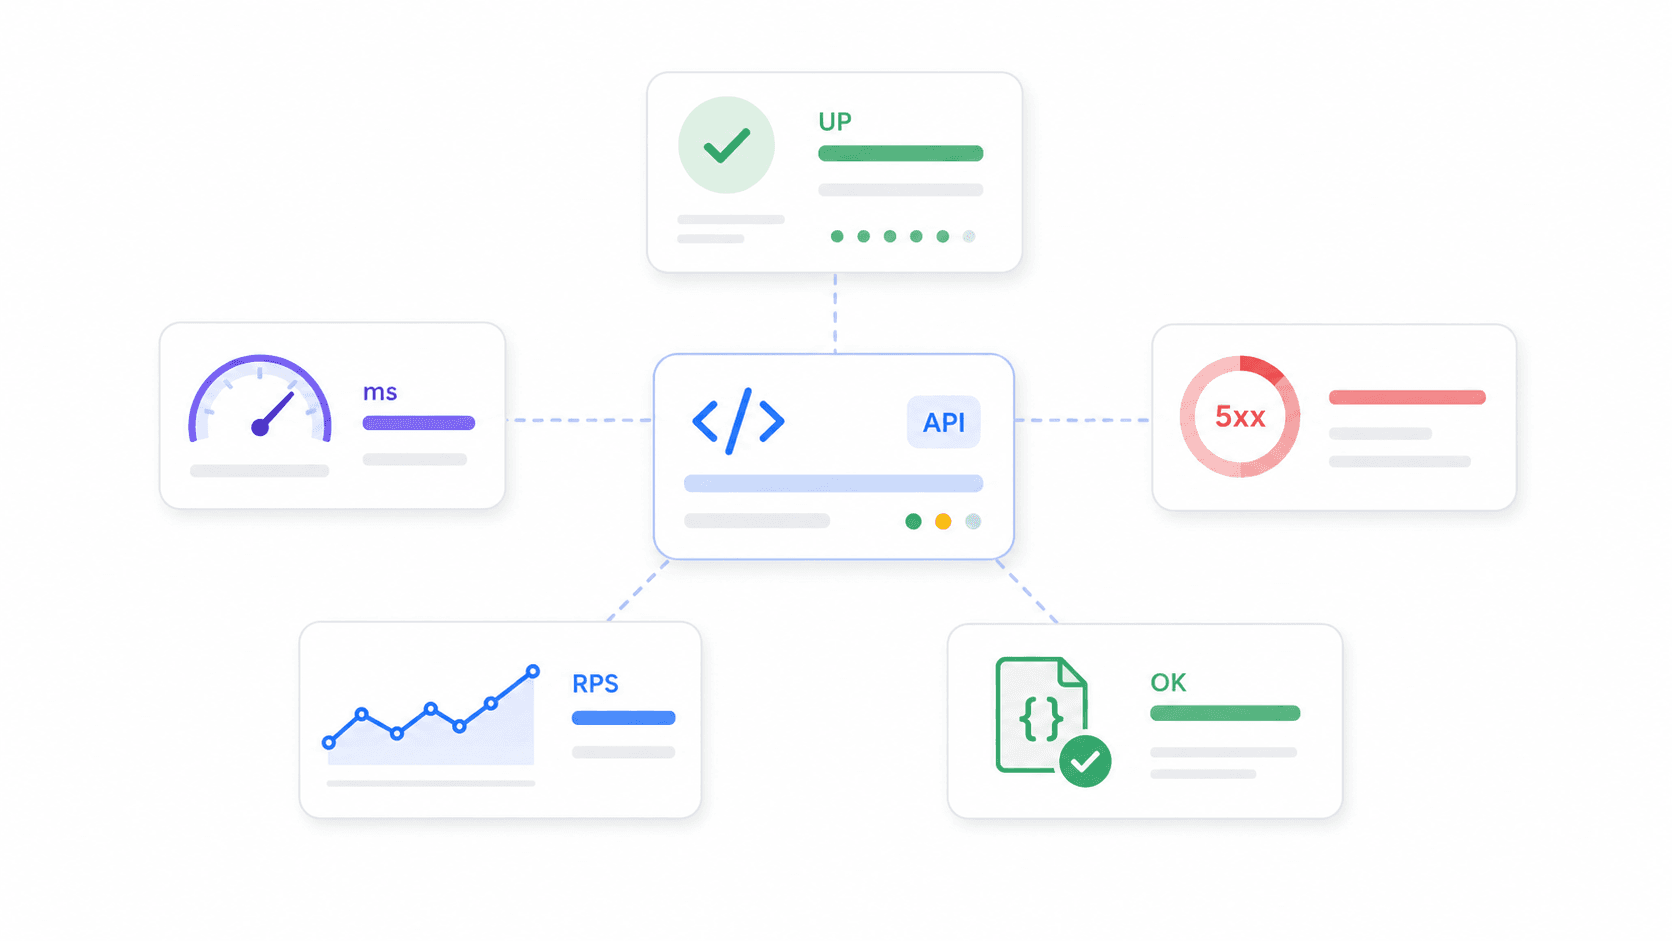
Klíčové metriky, které sledovat:
- Dostupnost: podíl času, kdy je endpoint dostupný
- Doba odezvy / latence: jak dlouho endpoint odpovídá (průměr, p95, p99)
- Chybovost: podíl požadavků s 5xx, timeoutem nebo selháním validace
- Průchodnost: počet požadavků za sekundu/minutu
- Správnost: zda API vrací očekávaná data, nejen status 200 OK
Jak jsme hodnotili nejlepší nástroje pro monitoring API v roce 2026
Většina článků o „nejlepších nástrojích pro monitoring API“ jen naskládá názvy vendorů a pár funkcí vedle sebe. Chtěl jsem k výběru přistoupit systematičtěji — částečně proto, že jsem strávil hodně času čtením vývojářských fór, a částečně proto, že mi tým Thunderbit pomohl hromadně vytáhnout ceny a funkce z webů dodavatelů a vytvořit skutečné srovnání (k tomu workflow se dostanu za chvíli).
Zohlednili jsme toto:
| Kritérium | Proč je důležité |
|---|---|
| Snadnost nastavení / čas do prvního alertu | Malé týmy potřebují pokrytí dnes, ne až po projektu platformy |
| Inteligence alertů a omezení šumu | Když jsou alerty hlučné, týmy je ignorují a skutečné incidenty jim utečou |
| Velkorysost free tarifu | Side projekty a rané startupy často začínají zdarma |
| Transparentnost cen | Účty za observabilitu mohou narůst kvůli hostům, seatům, logům, syntetickým běhům a ingestu dat |
| Šíře integrací | Alerty musí končit tam, kde tým už pracuje (Slack, PagerDuty atd.) |
| Škálovatelnost a hloubka dat | Zralejší týmy potřebují trace, logy, APM, RBAC, SSO a retenci |
| Kvalita komunity a podpory | Open-source týmy potřebují frekvenci releasů; enterprise týmy SLA |
| Schopnost extrakce webových dat | AI aplikace, RAG workflow a nástroje pro průzkum trhu často potřebují čistá externí data, ne jen uptime endpointu |
Doporučení jsme také rozdělili podle use case — sólo vývojář, startup, e‑commerce/SaaS, enterprise, open-source purista, tým vyvíjející API produkt a tým pro web data / AI aplikace — takže můžete přeskočit rovnou na svůj kontext místo toho, abyste četli 14 shrnutí a hádali, co se vás týká. Průzkum Grafany z roku 2025 ukázal, že 46 % respondentů uvádí interoperabilitu a 35 % možnost snadného budoucího přechodu jako kritéria výběru, což potvrzuje, že to nejsou jen pěkné bonusy.
Nejlepší nástroje pro monitoring API podle use case: rychlá orientační tabulka
Tohle je zkratka. Najděte svůj řádek a pak si dole otevřete detail nástroje.
| Use case | Doporučené nástroje | Hlavní odlišnost |
|---|---|---|
| Týmy pro web data / AI aplikace | Thunderbit Open API, Moesif, Apitally | Promění weby na čistý Markdown nebo strukturovaný JSON pro LLM, RAG, ceny a výzkumné workflow |
| Sólo vývojář / side project | UptimeRobot, Uptime Kuma, Gatus | Zdarma nebo self-hosted, minimum konfigurace, rychlé zprovoznění |
| Startup (tým 5–15 lidí) | Checkly, Better Stack, Postman | Chytré alerty, rychlé nasazení, dostupná cena, status pages |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Business metriky, APM/trace, hloubka SDK, vícekrokové syntetické testy |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, compliance, hybridní provoz, RBAC/SSO |
| Open-source puristé | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Plná kontrola, nativní OTel, žádný vendor lock-in |
| Týmy s API produktem | Moesif, Apitally, New Relic | Využití po zákazníkovi, trendy endpointů, anomální alerty |
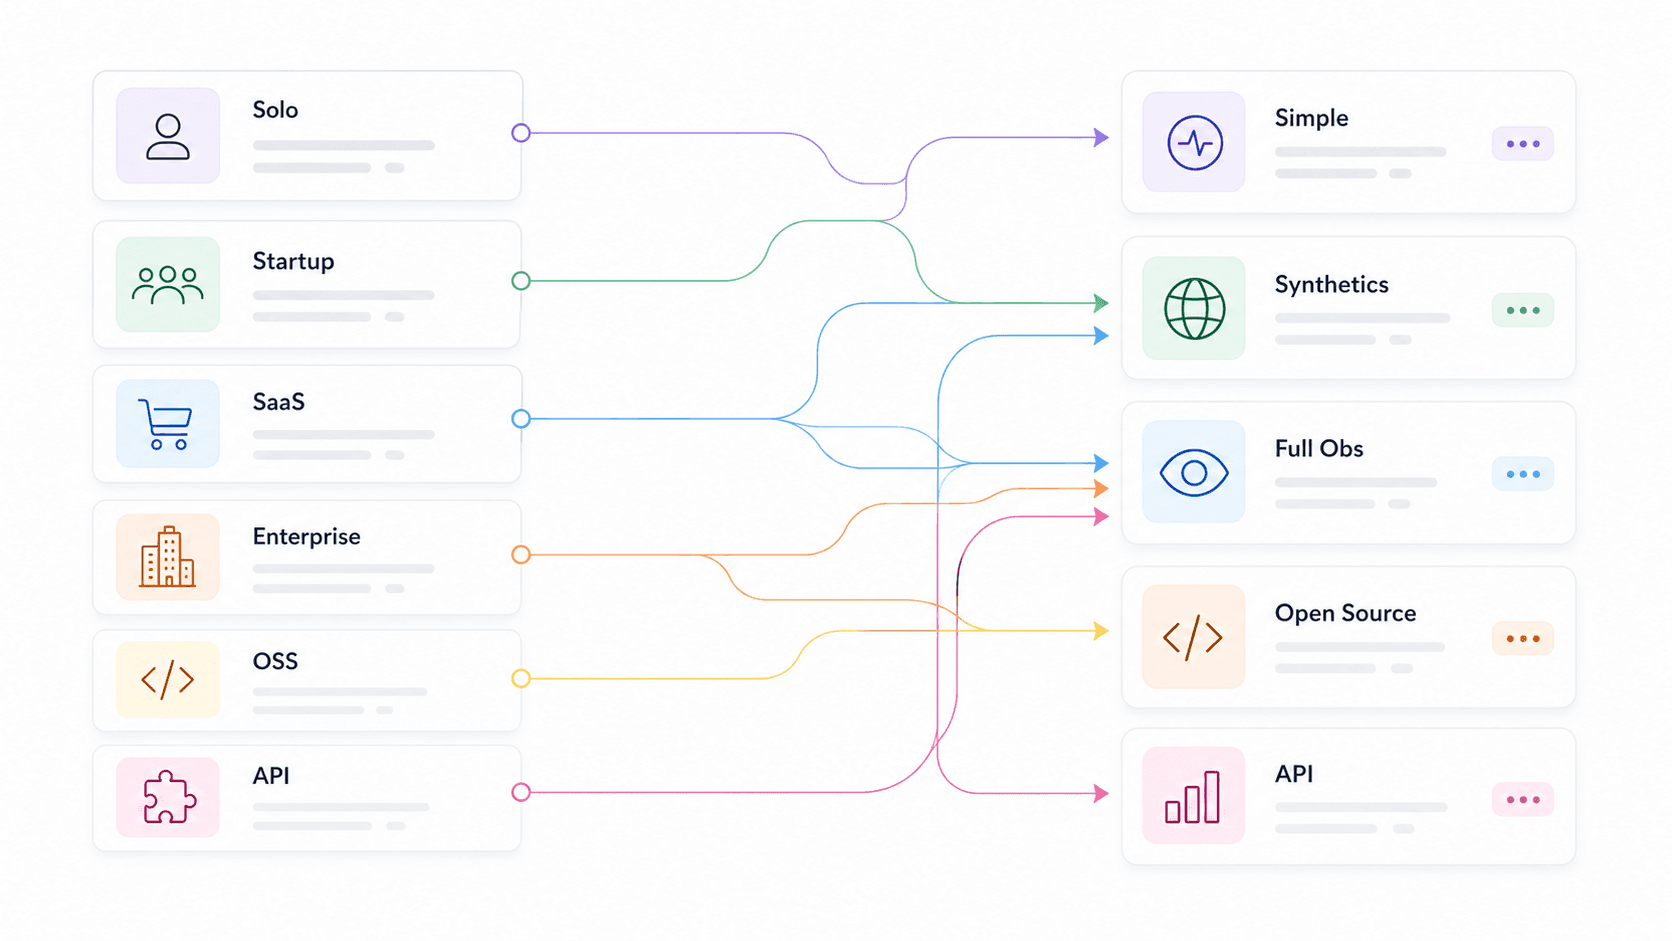
Největší vzorec: nástroje, které se nasazují nejrychleji, mívají slabší analytiku, zatímco nejhlubší platformy vyžadují více konfigurace a disciplíny v nákladech. Není to chyba — je to tradeoff, který je potřeba znát. Thunderbit hraje v trochu jiné lize: nejrychlejší je ve chvíli, kdy potřebujete převést webové stránky na data připravená pro API, ne když chcete budit inženýry kvůli výpadku.
Thunderbit Open API: nejlepší pro převod webů na strukturovaná API data
Začněte stavět s Thunderbit Open API Převádějte stránky na Markdown, extrahujte strukturovaný JSON a dávkově zpracovávejte URL bez údržby scrapingové infrastruktury. Get Started Free
Thunderbit Open API je API, které bych dal na první místo u týmů, jejichž monitoring nebo výzkumné workflow závisí na externích webových datech. Není to klasický nástroj na monitoring dostupnosti jako Checkly nebo UptimeRobot. Thunderbit místo toho převádí jakoukoli webovou stránku na čistá, strukturovaná data, která vaše aplikace, agenti, dashboardy a LLM pipeline skutečně využijí.
API má tři hlavní workflow. Distill převádí stránku na čistý Markdown připravený pro LLM. Extract vezme schéma a vrátí strukturovaná JSON pole, jako je název produktu, cena, dostupnost, velikost firmy, fáze financování nebo hodnocení recenzí. Batch umožní zpracovat až 100 URL asynchronně přes webhooky, což je užitečné při monitoringu cenových stránek, katalogů konkurence, dokumentace dodavatelů, zpravodajských zdrojů nebo rozsáhlých výzkumných seznamů.
Důvod, proč do průvodce API nástroji patří, je ten, že týmy často podceňují, kolik infrastruktury vyžaduje „prostě vytáhni data z téhle stránky“. Weby s těžkým JavaScriptem potřebují renderování. Některé stránky vyžadují geo-routing. HTML je potřeba zbavit navigace, reklam, modálů a boilerplate textu, aby bylo pro LLM použitelné. Selectory se rozbíjejí, když se změní layout. Rotace proxy, anti-bot ochrany, retry mechaniky, fronty a polling výsledků mohou z malého datového workflow udělat údržbový projekt. Thunderbit velkou část této práce absorbuje za jedno API.
Vhodné pro: tvůrce AI aplikací, RAG týmy, e‑commerce operations, sales ops, growth týmy, market researchery a vývojáře, kteří potřebují data z webu přes API, ale nechtějí stavět a hlídat scraping stack.
Cena: Zdarma: 600 jednorázových API jednotek, včetně až 600 stránek pro Distill nebo 30 stránek pro Extract, se 2 souběžnými požadavky. Starter je uveden na 16 USD/měsíc při ročním účtování za 60 000 API jednotek ročně a 30 souběžných požadavků. Pro je uveden na 40 USD/měsíc při ročním účtování za 600 000 API jednotek ročně a 50 souběžných požadavků.
Rychlost nasazení: přibližně 5–15 minut na získání API klíče a první request Distill nebo Extract přes cURL, SDK nebo Thunderbit CLI.
Nevýhody: Thunderbit nenahradí Datadog, New Relic, Better Stack ani Checkly pro hlídání dostupnosti, incident eskalaci, trace, logy nebo on-call routing. Berte ho jako API na sběr a strukturování webových dat — včetně cen vendorů, dokumentace, konkurenčních stránek, produktových listingů nebo veřejných datasetů — ne jako systém, který budí vašeho on-call inženýra.
Datadog: nejlepší pro full-stack přehlednost
Datadog je nástroj, který vídám v enterprise a středně velkých SaaS stackách pořád dokola, a není divu. Není to jen monitoring API — je to kompletní observability platforma, která propojuje syntetické API testy s distributed tracingem, logy, metrikami infrastruktury a monitoringem reálných uživatelů v jednom pohledu.
Pro API monitoring konkrétně Datadog podporuje HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC a vícekrokové API testy. Jeho monitory anomálií se učí očekávané vzorce a upozorní na odchylky místo statických prahů — což je výrazně lepší než „alertni, když latence překročí 500 ms“. Nabízí také forecast monitory, které předpovídají, kdy metrika překročí limit, a composite monitory kombinující více podmínek.
Vhodné pro: e‑commerce, SaaS a enterprise týmy, které chtějí jeden přehled nad API, infrastrukturou, logy a trace.
Cena: detaily free tarifu se liší podle produktu. Infrastructure Pro začíná na 15 USD/host/měsíc; API syntetické testy stojí 5 USD za 10 000 běhů. Více než 800 integrací.
Rychlost nasazení: přibližně 15–30 minut na instalaci agenta a základní syntetický test.
Nevýhody: ve větším měřítku může být drahý — „bill shock“ je časté téma na Hacker News a Redditu. Obrovské množství položek v ceníku (hosty, logy, custom metrics, synthetics, uživatelé) znamená, že někdo musí hlídat účet, nejen dashboardy. Křivka učení je u celé platformy reálná.
Checkly: nejlepší pro syntetické testy přátelské vývojářům
Checkly je nástroj, který bych dal startupovému engineering týmu, pokud chce mít API testy blízko kódu. Jeho hlavní myšlenka je „monitoring jako kód“: API a browser checky definujete programově, spouštíte je z globálních lokací, integrujete do CI/CD a spravujete přes Git.
Silná je tady kvalita alertování. Retry logika je přímo prezentovaná jako „první linie obrany“ proti false positive — můžete nastavit pevné, lineární nebo exponenciální retry, retry ze stejné nebo jiné lokace a maximální dobu retry před vyvoláním alertu. Rozlišuje také mezi degraded, failed a recovered stavy, což pomáhá omezit hlučné výjezdy.
Vhodné pro: startupy a vývojářské týmy, které chtějí programovatelné API checky, browser checky postavené na Playwrightu, integraci s CI/CD a rychlé nasazení.
Cena: poslední veřejná data uvádí free plán s 10 uptime monitory, 1 000 browser checky a 10 000 API checky. Starter je zhruba 24 USD/měsíc při ročním účtování — před nákupem si ověřte oficiální ceník.
Rychlost nasazení: přibližně 10–20 minut na první API check a alertovací kanál.
Nevýhody: zaměřuje se na syntetické testy. Není náhradou za hluboké APM, analytiku logů nebo distributed tracing. Pokud potřebujete propojit výpadek API s bottleneckem v databázi, budete vedle něj potřebovat ještě jiný nástroj.
UptimeRobot: nejlepší pro jednoduché a dostupné hlídání dostupnosti
UptimeRobot je Honda Civic mezi nástroji na monitoring API. Dělá jednu věc dobře: založíte HTTP, keyword, ping, port, SSL nebo heartbeat monitor, zvolíte interval a dostanete alert, když něco spadne. Hotovo.
Vhodné pro: sólo vývojáře, malé týmy, agentury nebo kohokoli, kdo potřebuje základní hlídání dostupnosti a latence bez složitostí.
Cena: Zdarma: 50 monitorů, intervaly 5 minut. Placený Solo plán začíná kolem 7 USD/měsíc při ročním účtování. Pro free tarif není potřeba platební karta. Rychlost nasazení: přibližně 2–5 minut — nejrychlejší v tomto seznamu.
Nevýhody: omezená inteligence alertů. Jen základní prahové alerty, bez detekce anomálií, bez distributed tracingu, bez hlubší analytiky. Pokud potřebujete vědět proč je endpoint pomalý, a ne jen že je pomalý, UptimeRobot vás tam nedostane.
Uptime Kuma: nejlepší zdarma self-hosted nástroj pro monitoring API
Uptime Kuma je miláček self-hosting komunity a čísla na GitHubu to potvrzují: 86 637 hvězdiček, 7 831 forků, 1 060 přispěvatelů a k květnu 2026 verze 2.3.2. Je pod licencí MIT, podporuje HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, více status pages a více než 90 notifikačních služeb.
Vhodné pro: sólo vývojáře a týmy, které chtějí plnou kontrolu, soukromí a nulové průběžné SaaS náklady — pokud mají server.
Cena: zdarma. Skutečné náklady tvoří VM/kontejner, zálohy, aktualizace a zajištění, že samotný monitor běží. Rychlost nasazení: přibližně 5–15 minut s Dockerem pro základní check; 15–30 minut s notifikacemi a doladěním status page.
Nevýhody: údržba je na vás. A tady je zásadní háček: pokud Uptime Kuma hostujete na stejné infrastruktuře, kterou monitoruje, cloudový nebo DNS výpadek shodí jak aplikaci, tak monitor. Hostujte ho externě nebo ho doplňte SaaS checkem.
Better Stack: nejlepší pro rychlou reakci na incidenty
Better Stack (uživatelé mu často pořád říkají Better Uptime) spojuje monitoring dostupnosti, incident management, on-call plánování, eskalační politiku a status pages v jedné platformě. Síla není tolik v analytice, ale v incident workflow kolem monitoringu.
Eskalační politiky určují, kdo je alertovaný, v jakém pořadí a s jakými prodlevami, dokud incident někdo nepotvrdí. Routing podle metadat posílá incidenty podle závažnosti nebo ownershipu. Integrace zahrnují Slack, Teams, webhooky a Zapier.
Vhodné pro: startupy a středně velké týmy, které chtějí monitoring + incident response + status pages bez skládání tří samostatných nástrojů.
Cena: Free tarif: 10 monitorů/heartbeatů, 1 status page. Team plán je kolem 29 USD/měsíc při ročním účtování. Rychlost nasazení: přibližně 5–10 minut přes GUI průvodce.
Nevýhody: menší hloubka v analytice API payloadů, distributed tracingu nebo business KPI analýze oproti Datadogu, New Relic nebo Moesif.
Prometheus + Grafana: nejlepší open-source stack pro monitoring API
Tohle je průmyslový open-source standard. Prometheus sbírá a ukládá časové řady metrik. Grafana (73 705 hvězdiček na GitHubu, 3 010 přispěvatelů) zajišťuje dashboardy a alerting. Alertmanager řeší routing, grouping, deduplikaci, umlčování a inhibici. Pro kontrolu endpointů API si týmy přidávají Blackbox Exporter pro HTTP, HTTPS, DNS, TCP, ICMP a gRPC probing.
Vhodné pro: open-source puristy, Kubernetes/SRE týmy a organizace, které už standardizovaly metriky v Prometheu.
Cena: zdarma při self-hostingu. Grafana Cloud má free tarif (100 tisíc API test běhů měsíčně) a placené plány podle využití.
Rychlost nasazení: 1–4 hodiny pro základní Blackbox + Prometheus + Grafana + Alertmanager. Na produkční HA a doladění alertů klidně dny.
Nevýhody: PromQL, YAML, relabeling, návrh dashboardů, retence, storage, HA a ladění alertů jsou skutečná provozní práce. Opakující se tradeoff je „méně UI, více YAML“. Tohle je stack pro týmy, které už přemýšlejí v metrikách a chtějí jeden control plane — ne pro týmy, které chtějí monitoring hotový do oběda.
New Relic: nejlepší pro výkon SaaS aplikací
New Relic spojuje APM, monitoring infrastruktury, logy, distributed tracing, syntetický monitoring, alerty, dashboardy a AI-asistovanou analýzu incidentů. Jeho free tarif — 100 GB ingestu dat měsíčně a 1 plnohodnotný uživatel — je pro malé týmy opravdu štědrý.
U alertů New Relic exceluje v otázce alert fatigue. Jeho incident intelligence zahrnuje korelaci událostí, detekci anomálií, prediktivní alerty, root-cause analýzu a potlačení flappingu. New Relic zveřejnil příklad, kde 97,2% účinnost potlačení flappingu znamená jen 28 zobrazených problémů na 1 000 flapping incidentů — to je konkrétní číslo snížení šumu.
Vhodné pro: SaaS týmy a e‑commerce platformy, které chtějí monitoring API pevně propojený s trace na úrovni aplikace, chybami, průchodností a dopadem na uživatele.
Cena: zdarma: 100 GB/měsíc, 1 plný uživatel. Placené verze používají cenotvorbu podle uživatele a objemu dat.
Rychlost nasazení: přibližně 15–30 minut na instalaci agenta a guided setup.
Nevýhody: cena může být ve větším měřítku složitá. Konfigurace alertů má křivku učení — platforma je výkonná, ale ne úplně intuitivní na první pohled.
Moesif: nejlepší pro API analytiku a byznysové metriky
Moesif není klasický uptime monitor. Je to API analytika a produktová intelligence: chápat využívání API podle zákazníka, endpointu, kohorty, firmy, geografie, SDK, plánu a chování. Pokud se ptáte „kterého zákazníka to zasáhlo?“, a ne „je endpoint nahoře?“, přesně na to je Moesif postavený.
Podporuje statické threshold alerty i dynamické anomální alerty pro API metriky jako skoky/poklesy provozu, latence a změny chování. Dynamické alerty potřebují pár dní dat, aby si vytvořily model, ale jakmile se naučí, zachytí změny, které statická pravidla minou.
Vhodné pro: týmy s API produktem, SaaS firmy a e‑commerce platformy, které potřebují propojit výkon API s příjmy, engagementem a retencí.
Cena: k dispozici je free/trial; placené plány rostou podle objemu API eventů. Přesné částky v self-service režimu se mi nepodařilo z webu kompletně vytěžit — ověřte aktuální stránku.
Rychlost nasazení: přibližně 20–45 minut (SDK/proxy/gateway integrace je hlubší než externí ping).
Nevýhody: více zaměřené na analytiku než na klasický uptime monitoring. Pravděpodobně budete chtít Moesif spárovat s Checkly, UptimeRobot nebo Datadog synthetics pro externí kontroly dostupnosti.
Splunk: nejlepší pro enterprise analýzu logů a compliance
Splunk je nástroj, po kterém sáhnete, když jsou agregace logů, vyhledávání, korelace, auditovatelnost připravená na compliance a hybridní / multi-cloud podpora nevyjednatelné. Splunk Observability Cloud pokrývá infrastrukturu, APM, synthetics, monitoring reálných uživatelů, logy i incident response. ITSI/Event Analytics umí seskupovat významné události do epizod a snižovat šum napříč monitoringovými ostrůvky.
Vlastní observability research pro rok 2025 je střízlivé čtení: 73 % respondentů z ITOps/inženýringu uvedlo výpadky kvůli ignorovaným nebo potlačeným alertům, 59 % bojovalo s příliš mnoha různými nástroji a 52 % mělo problém s falešnými alerty.
Vhodné pro: enterprise a multi-cloud týmy s přísnými požadavky na compliance, security, audit a vyhledávání v logách.
Cena: podle využití a obvykle přes nabídku. Žádný jednoduchý free tarif pro produkci.
Rychlost nasazení: cloud onboarding může být rychlejší, ale enterprise nasazení často trvá dny až týdny.
Nevýhody: drahé ve velkém. Složitá konfigurace. Přestřel pro sólové vývojáře a malé startupy.
Postman: nejlepší pro týmy, které už API testují
Postman je primárně platforma pro vývoj a testování API, ale jeho monitoring produkt umožňuje týmům plánovat Postman collection a spouštět je z cloudových lokalit. Nejsilnější argument je znovupoužití: pokud už QA nebo dev tým má collection s assertiony, převést je na monitory je přirozený další krok.
Vhodné pro: dev a QA týmy, které už Postman collection používají a chtějí plánované checky bez koupě samostatného syntetického nástroje.
Cena: existuje free tarif. Překročení monitoringu stojí 0,75 USD za 1 000 volání; balíček 50 000 volání vyjde na 20 USD/měsíc. Ověřte aktuální stránku plánů — balení plánů se u Postmanu mění.
Rychlost nasazení: přibližně 10 minut, pokud už collection existují.
Nevýhody: monitoring je méně vyspělý než u specializovaných nástrojů jako Checkly, Datadog nebo New Relic. Alert možnosti jsou základní.
Další nástroje pro monitoring API, které stojí za pozornost
Gatus: lehký, self-hosted, config-driven health dashboard. 10 906 hvězdiček na GitHubu, podporuje HTTP, ICMP, TCP, DNS, metriky přátelské k Prometheu a uptime badge. Skvělý pro sólo vývojáře, kteří chtějí něco jednoduššího než Prometheus, ale preferují YAML/config-as-code před UI Uptime Kuma.
Apitally: novější nástroj zaměřený na analytiku API provozu a tracking kvality pro startupy. Tvrdí nastavení do 5 minut a vlastní alerty napříč 14 metrikami. Dobrá volba pro lehkou API analytiku bez přijetí celé observability platformy.
Sematext: full-stack monitoring s logy, synthetics a přehledem infrastruktury. Synthetics přibližně od 2 USD za HTTP monitor, 7 USD za browser monitor a minimum 5 USD/měsíc. Cenově dostupnější alternativa k Datadogu pro středně velké týmy.
Uptrace: OpenTelemetry-native backend pro APM, tracing, metriky a logy. 4 198 hvězdiček na GitHubu. Není to čistě uptime checker, ale je ideální pro týmy standardizované na OTel, které chtějí open-source friendly tracing backend.
Vlastní řešení vs. nákup: má smysl si monitoring API postavit sám?
„Neměl bych si prostě napsat skript, co pinguje endpointy, místo koupě nástroje?“
Tahle otázka padá ve vývojářských fórech pořád. Přečetl jsem dost Reddit vláken na to, abych viděl vzorec jasně: týmy začnou s curl + cron, chvíli to funguje a pak přejdou na specializovaný nástroj, jakmile potřebují dashboardy, historická data, víc regionů, spolehlivé směrování alertů nebo přehled napříč týmy.
Upřímná rozhodovací matice:
| Faktor | Vlastní skript | Specializovaný nástroj |
|---|---|---|
| Čas nastavení | 1–4 hodiny (základ); dny (robustní) | 5–30 minut |
| Údržba | Navždy je to vaše starost | Aktualizace řeší poskytovatel |
| Kvalita alertů | Základní (nahoru/dolů) | Chytrá (trend latence, anomálie, retry) |
| Cena | Zdarma (vaše časové náklady) | 0–500+ USD/měsíc |
| Dashboard | Postavit od nuly | Hotový, přizpůsobitelný |
| Nejlepší když… | ≤3 endpointy, silně vývojářský tým, hobby projekt | 5+ endpointů, ops/product tým, v sázce jsou příjmy |
Klíčový poznatek z fór: lidé, kteří si vše staví sami, toho často litují ve chvíli, kdy potřebují dashboardy, historická data nebo přehled napříč týmy. A je tu ještě meta-problém — „potřebujete monitoring na váš monitoring“. I self-hosted monitor, databáze, zálohy, síťová cesta a poskytovatel alertů musí být spolehliví.
Stavte si to sami, pokud máte 2 endpointy a baví vás bastlení. Kupte si nástroj, pokud máte produkt, který potřebujete dodávat.
Stejná logika platí i pro extrakci webových dat. Můžete si napsat scraper, provozovat headless browsery, rotovat proxy, udržovat selectory, čistit HTML a stavět frontu. Ale pokud je cílem spolehlivě napájet webová data do API produktu, AI agenta nebo výzkumného workflow, je použití Thunderbit Open API obvykle rychlejší než stavět scraping infrastrukturu od nuly.
Alert fatigue: proč kvalita alertů poráží jejich množství
Tohle je možná nejpodceňovanější kritérium při výběru nástroje na monitoring API. Alert fatigue nastává ve chvíli, kdy tým dostává tolik hlučných, duplicitních nebo neakčních alertů, že je začne ignorovat všechny — a pak mu utečou skutečné incidenty.
Čísla jsou dost výmluvná. Zpráva BigPanda za rok 2025 zjistila, že mediánová organizace generovala 2 350 alertů denně a 803 406 alertů ročně. Mediánová akčnost incidentů byla jen 18 % — tedy méně než jeden z pěti alertem vyvolaných incidentů byl skutečně použitelný. Průzkum NeuBird z roku 2026 ukázal, že 77 % on-call týmů dostane alespoň 10 alertů denně a 80 % říká, že polovina nebo méně z nich je akční.
Nejlepší monitoring je ten, jehož alertům skutečně věříte. Srovnání, jak si nástroje stojí v inteligenci alertů:
| Nástroj | Typ alertu | Metoda omezení šumu | Alert kanály |
|---|---|---|---|
| Datadog | ML anomálie, forecast, composite | Historické anomální pásmo, dynamické baseline, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Prahový + podle degradace | Retry před vyvoláním, retry ze stejné / jiné lokace | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI grouping incidentů, anomálie, predikce | Korelace událostí, potlačení flappingu, kontext root-cause | Slack, PagerDuty, Teams, webhooks |
| Moesif | Behaviorální anomálie | Dynamické modely po několika dnech chování | Slack, PagerDuty, e-mail, SMS |
| Better Stack | Uptime / incident / on-call | Eskalační politiky, routing podle ownershipu, prodlevy | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Alerty z PromQL pravidel | Grouping, deduplikace, umlčování, inhibice | E-mail, PagerDuty, Opsgenie, webhooks |
| Splunk | Události, epizody, zdraví služby | ITSI Event Analytics, grouping epizod, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Není alerting platforma | Používejte s vlastním schedulerem, workflow nástrojem nebo monitoring stackem | Webhooky pro batch joby; alerty řešeny externě |
Praktická rada: Začněte s menším počtem alertů, ale s vyšší důvěrou v ně. Používejte retry před vyvoláním alertu, potvrzení z více regionů, SLO burn-rate alerty, deduplikaci a routing podle ownershipu. Alertujte na dopad na uživatele a byznysově kritické flow (selhání checkoutu, auth, payment 5xx), ne na každý interní symptom.
Free tarify a ceny v roce 2026: co skutečně zaplatíte
Ceníky se mění. Free tarify se posouvají. Skryté náklady (hosty, seaty, logy, syntetické běhy, ingest dat) umí překvapit. Tohle je část, kterou bych chtěl vidět v každém článku o „nejlepších nástrojích“. Snapshot pro rok 2026:
| Nástroj | Free tarif | Cena od | Je potřeba karta? | Nejlepší free use case |
|---|---|---|---|---|
| Thunderbit Open API | 600 jednorázových API jednotek | ~16 USD/měsíc ročně | Ne | Extrace webových dat pro LLM, RAG, ceny a výzkum |
| Uptime Kuma | Neomezeně (self-host) | — | Ne | Kompletní monitoring, vlastní server |
| UptimeRobot | 50 monitorů, interval 5 minut | ~7 USD/měsíc | Ne | Základní uptime checky |
| Better Stack | 10 monitorů, 1 status page | ~29 USD/měsíc | Ne | Startup uptime + status page |
| Checkly | 10 uptime, 10k API checků | ~24 USD/měsíc | Ano | Syntetické API testy |
| Postman | Free účet + limit pro monitoring | ~14 USD/uživatel/měsíc | Ne | Znovupoužití existujících collection |
| Prometheus + Grafana | Neomezeně (self-host) | — | Ne | Metriky + vizualizace |
| Grafana Cloud | 100k spuštění API testů/měsíc | 29 USD/měsíc platforma + usage | Ověřte | Spravovaný synthetics trial |
| New Relic | 100 GB/měsíc, 1 plný uživatel | Cena dle uživatele + dat | U některých plánů | APM + základní observabilita |
| Datadog | Trial / dle produktu | 15 USD/host/měsíc (Infra Pro) | Často ano | Vyhodnocení full-stack |
| Moesif | Free/trial dostupný | Podle objemu | Ověřte | Hodnocení API analytiky |
| Splunk | Trial dostupný | Individuální nabídka | Prodejní proces | Enterprise proof of concept |
| Gatus | Neomezeně (self-host) | — | Ne | YAML řízený status dashboard |
| Apitally | Free/trial dostupný | Ověřte | Ověřte | Lehká API analytika |
| Sematext | Trial/free se liší | ~2 USD/HTTP monitor | Ověřte | Levnější synthetics/logy |
| Uptrace | Free self-hosted | Cloud tarify se liší | Ověřte | Vyhodnocení OTel APM |
Poznámka ke skrytým nákladům: Self-hosted nástroje (Uptime Kuma, Prometheus, Gatus) jsou „zdarma“ z hlediska licence, ale malý VM, zálohy, čas na údržbu a externí failover se mohou snadno stát skutečným nákladem. U web data API je skrytý náklad jiný: údržba headless browserů, rozbitých selectorů, poolů proxy, anti-bot workaroundů a čištění HTML.
Odhad pro malý tým: Pro 10 API endpointů a 3 členy týmu je nejlevnější SaaS cesta často UptimeRobot free nebo low paid, Better Stack free/Team, nebo Checkly, pokud objem běhů vyhovuje. Datadog a New Relic mohou být při evaluaci cenově dostupné, ale skutečný účet závisí na hostech, uživatelích, logách, trace a objemu syntetických běhů. Pokud váš projekt potřebuje webová data jako API, free API jednotky Thunderbitu vám bohatě stačí na otestování workflow před přechodem na placený plán.
Skóre složitosti nasazení: jak rychle dostanete první alert
Žádný srovnávací článek, který jsem našel, nehodnotí time-to-value — tedy jak dlouho od registrace trvá, než dostanete první smysluplný alert. Pro menší týmy je to důležitější než hloubka funkcí.
| Nástroj | Čas do prvního alertu | Potřebná technická zručnost | Způsob konfigurace |
|---|---|---|---|
| Thunderbit Open API | ~5–15 minut | Nízká–střední | API klíč, cURL/SDK/CLI |
| UptimeRobot | ~2–5 minut | Nízká | GUI, kliknout a přidat |
| Better Stack | ~5–10 minut | Nízká | GUI průvodce |
| Checkly | ~10–20 minut | Nízká–střední | Kód nebo GUI |
| Postman | ~10 minut (s collection) | Nízká–střední | Scheduler collection |
| Uptime Kuma | ~5–30 minut | Střední | Docker + GUI |
| Gatus | ~15–45 minut | Střední | YAML + Docker |
| Datadog | ~15–30 minut | Střední | Instalace agenta + GUI |
| New Relic | ~15–30 minut | Střední | Agent + guided setup |
| Moesif | ~20–45 minut | Střední | Integrace SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 minut | Střední | GUI, volitelně Terraform |
| Prometheus + Grafana | 1–4 hodiny | Střední–vysoká | YAML, PromQL |
| Uptrace | 30–90 minut | Střední–vysoká | Integrace OTel SDK |
| Splunk | Hodiny až týdny | Vysoká | Enterprise onboarding |
Pokud má monitoring běžet do konce dne, začněte v horní polovině tabulky. Pokud je cílem dlouhodobá platformní observabilita, naplánujte na spodní polovinu samostatný projekt. A pokud je vaše první meta „dostat z těchto 100 webových stránek čistá data do aplikace“, začněte s Thunderbit místo toho, abyste stavěli vlastní scraping infrastrukturu.
Srovnání nejlepších nástrojů pro monitoring API: kompletní side-by-side
Jedna tabulka na rychlé projití před rozhodnutím:
| Nástroj | Nejlepší use case | Free tarif | Inteligence alertů | Čas nasazení | Hosting | Výrazná funkce |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Extrace webových dat / API datové pipeline | 600 API jednotek | Není alerting nástroj | 5–15 min | Cloud | Převede stránky na Markdown nebo JSON podle schématu |
| Datadog | Enterprise / SaaS full-stack | Trial / dle produktu | Anomálie, forecast, AI | 15–30 min | Cloud | Koreluje synthetics s logy/trace/infrastrukturou |
| Checkly | Dev-first synthetics | Velkorysý podle počtu checků | Retry, degradace | 10–20 min | Cloud | Monitoring jako kód + Playwright |
| UptimeRobot | Jednoduchá dostupnost | 50 monitorů | Základní prahy | 2–5 min | Cloud | Nejrychlejší levný základní monitor |
| Uptime Kuma | Free self-hosted | Neomezeně | Základní status/práh | 5–30 min | Self-hosted | Čisté UI, žádný SaaS poplatek |
| Better Stack | Incident response / status pages | 10 monitorů | Eskalace, routing | 5–10 min | Cloud | Monitoring + on-call + status page |
| Prometheus + Grafana | Open-source metrický stack | Neomezeně (self-host) | Grouping přes Alertmanager | 1–4 hod | Self-hosted/cloud | Hloubka ekosystému PromQL |
| New Relic | SaaS APM + API checky | 100 GB/měsíc, 1 uživatel | AI grouping, potlačení flappingu | 15–30 min | Cloud | Silné APM + synthetics dohromady |
| Moesif | API analytika / business metriky | Free/trial | Behaviorální anomálie | 20–45 min | Cloud | Analytika chování API po zákaznících |
| Splunk | Enterprise logy / compliance | Trial | ITSI epizody, AIOps | Dny+ | Cloud/self-managed | Enterprise vyhledávání v logách a governance |
| Postman | Týmy, které už API testují | Free účet | Základní monitor alerty | 10 min | Cloud | Znovupoužití API test collection |
Jak Thunderbit může zrychlit vyhodnocování API nástrojů
Plná otevřenost: Thunderbit není nástroj na monitoring API — je to agentic web scraper a Open API pro převod webových stránek na čistý Markdown nebo strukturovaný JSON. To ho ale dělá užitečným v jiné části rozhodovacího procesu: při sběru cen vendorů, limitů tarifů, funkcí, detailů dokumentace a seznamů integrací ještě před tím, než si platformu vyberete.
Místo toho, abychom ručně otevírali 10+ cenových stránek vendorů a kopírovali názvy plánů, limity monitorů, intervaly, integrace a požadavky na platební kartu do spreadsheetu, použili jsme Thunderbit Chrome Extension k extrakci strukturovaných dat z cenových a funkcionalitních stránek jednotlivých nástrojů. Thunderbitova AI si každou stránku přečte, navrhne pole — název plánu, detaily free tarifu, cenu, podporované integrace — a výstup rovnou strukturuje do exportovatelné tabulky.
Pro vývojářské workflow dává Thunderbit Open API stejnou možnost programově. Použijte Distill, když chcete čistý Markdown pro LLM nebo RAG. Použijte Extract, když potřebujete konkrétní pole ve formátu JSON. Použijte Batch, když potřebujete zpracovat seznam cenových stránek, URL dokumentace, produktových stránek nebo konkurenčních webů a dostat výsledky asynchronně.
Workflow:
- Otevřete cenovou stránku vendora (Datadog, Checkly, UptimeRobot atd.)
- Klikněte na „One Click Extract“ — Thunderbit AI přečte stránku, pochopí její strukturu a jedním průchodem vyplní tabulku
- Použijte scraping podstránek pro každou cenovou stránku, features a docs
- Exportujte do Google Sheets, Excelu, Airtable, Notion nebo CSV
Pro API-first týmy je API workflow stejně přímý:
- Získejte zdarma API klíč od Thunderbitu
- Zavolejte endpoint Distill pro čistý Markdown z jakékoli veřejné stránky
- Zavolejte endpoint Extract se schématem pro strukturovaný JSON
- Použijte Batch endpointy a webhooky pro větší seznamy URL
- Pošlete výstup do aplikace, spreadsheetu, datového skladu, vektorové databáze nebo monitoring workflow
Při srovnání 10+ vendorů může ruční copy-paste snadno zabrat 2–3 hodiny, když započítáte podstránky s cenami, dokumentací a integracemi. Thunderbit zkrátil náš první průchod na zhruba 15–30 minut a zbytek času padl na ověření a rozhodnutí. Pokud váš tým v operations, procurementu, researchi nebo AI produktu vyhodnocuje nástroje pod časovým tlakem, je to praktická zkratka. Více o tomto typu workflow najdete v našem průvodci web scraping bez programování, podívejte se na Thunderbit API pricing nebo na náš YouTube kanál, kde najdete návody.
Jak vybrat nejlepší nástroj pro monitoring API pro váš tým
„Nejlepší“ nástroj na monitoring API závisí na velikosti týmu, technické hloubce, rozpočtu a na tom, jak vypadá selhání vašeho produktu.
Sólo vývojář nepotřebuje Splunk. Regulovaný enterprise by se neměl spoléhat na cron job. Tým s API produktem může potřebovat spíš zákaznickou analytiku ve stylu Moesif než běžné uptime pingy. E‑commerce tým by měl prioritizovat kritické cesty jako login, search, add-to-cart, checkout a autorizaci platby. AI nebo datový produkt možná potřebuje nejdřív web data extraction ve stylu Thunderbitu a až potom plnou observabilitu.
Tři principy, které se v celém výzkumu opakovaly:
- Přizpůsobte nástroj use case. Rychlá orientační tabulka je tam z dobrého důvodu — začněte tam.
- Upřednostněte kvalitu alertů před jejich množstvím. Když tým alerty ignoruje, monitoring nemáte. Máte šum.
- Nepodceňujte rychlost nasazení. Monitor, který běží dnes a posílá důvěryhodné alerty, je lepší než dokonalý plán platformy, kvůli kterému bude checkout další měsíc bez monitoringu.
Pokud porovnáváte více nástrojů najednou a chcete výzkum urychlit, zkuste Thunderbit na hromadnou extrakci dat vendorů do jedné tabulky. Pokud stavíte API produkt, RAG pipeline, AI agenta nebo workflow pro market intelligence a potřebujete čistá webová data, začněte s Thunderbit Open API. Nevybere za vás monitoring tool — ale dostane vás rychleji k rozhodnutí a vašemu vlastnímu produktu může dodat spolehlivou vrstvu pro web data.
FAQ o nejlepších nástrojích pro monitoring API
Jaký je nejlepší free nástroj pro monitoring API v roce 2026?
Pro jednoduchost v SaaS prostředí nabízí UptimeRobot 50 free monitorů s intervalem 5 minut a bez potřeby platební karty. Pro self-hosted kontrolu je Uptime Kuma open-source, neomezený a má čisté UI s více než 90 notifikačními službami. Pro týmy, které chtějí hloubku metrik a už mají technické schopnosti, je nejlepší open-source stack Prometheus + Grafana + Alertmanager — i když nastavení trvá hodiny, ne minuty.
Pokud vaším cílem není monitoring dostupnosti, ale extrakce webových dat přes API, Thunderbit Open API má free tarif s 600 jednorázovými API jednotkami, což stačí na otestování převodu stránky na Markdown nebo extrakce JSON podle schématu, než budete škálovat.
Jaký je rozdíl mezi monitoringem API a APM?
Monitoring API kontroluje dostupnost endpointu, dobu odezvy, chyby a správnost zvenku — simuluje, co zažívá uživatel nebo integrace. APM (Application Performance Monitoring) jde hlouběji dovnitř aplikace: trace na úrovni kódu, databázové dotazy, runtime chyby, latenci front a závislosti služeb. Nástroje jako Datadog a New Relic nabízejí obojí; UptimeRobot a Uptime Kuma se soustředí na externí checky dostupnosti.
Thunderbit Open API je jiné než obojí: je to API pro extrakci webových dat. Pomáhá převádět externí weby na Markdown nebo strukturovaný JSON, což je užitečné pro LLM aplikace, výzkumná workflow, cenovou inteligenci a datové pipeline.
Jak často bych měl monitorovat API?
Produkční revenue-critical API (checkout, auth, payments) by se obvykle měla kontrolovat každou 1 minutu. Interní nebo méně vytížená API lze často kontrolovat každých 5 minut. Ale samotná frekvence nestačí — používejte retry, více regionů a smysluplné asserty, aby byl každý check rychlý i důvěryhodný. Jednominutový check, který vyvolává falešné poplachy, je horší než pětiminutový check, kterému věříte.
U workflow pro web data extraction záleží frekvence na tom, jak rychle se zdroj mění. Cenové stránky mohou potřebovat denní nebo týdenní extrakci. Rychle se měnící data o zásobách, cestování nebo tržištích mohou vyžadovat hodinovou či ještě častější obnovu. Batch API a webhooky Thunderbitu jsou užitečné, když potřebujete na schedulu zpracovat mnoho URL.
Můžu monitorovat API bez programování?
Ano. UptimeRobot, Better Stack a Uptime Kuma lze používat čistě přes GUI. Checkly podporuje GUI i nastavení přes kód. Postman používá rozhraní založené na collection. Prometheus/Grafana obvykle vyžadují YAML a PromQL. Datadog a New Relic lze začít přes guided setup, ale při hlubší instrumentaci jsou výrazně silnější.
Pokud chcete extrahovat webová data bez programování, Chrome Extension Thunderbitu je no-code cesta. Pokud chcete ten samý workflow automatizovat z aplikace, Thunderbit Open API dává vývojářům endpointy Distill, Extract a Batch.
Jak snížit alert fatigue u monitoringu API?
Vyberte nástroje s chytrým alertováním: detekcí anomálií (Datadog, New Relic), retry před vyvoláním (Checkly), behaviorálními anomáliemi (Moesif) nebo groupingem/umlčováním (Prometheus Alertmanager). Začněte s menším počtem alertů s vyšší důvěrou, které míří na dopad na uživatele. Používejte SLO burn-rate alerty místo statických prahů, deduplikujte napříč službami, směrujte podle ownershipu a měřte akčnost — pokud méně než 20 % alertů vede ke skutečné akci, nejdřív snižte šum.
Vyzkoušejte Thunderbit Open API pro extrakci webových dat Get Started Free
Další informace



