
يعرض GitHub الآن أكثر من 2,300 مستودع لأداة استخراج بيانات Reddit. يبدو وكأنه بوفيه مفتوح. لكن المفاجأة: نحو 28% فقط منها تُظهر أي نشاط صيانة خلال الأشهر الاثني عشر الماضية. قضيت الأسابيع الأخيرة أتعمق في هذه المستودعات، وأختبر نقاط النهاية، وأقرأ قوائم المشكلات، وأقارن ذلك بتحديثات سياسة Reddit نفسها. الهدف: أن أوفر عليك استنساخ مستودع، والتعثر مع OAuth، ثم تكتشف عند منتصف الليل أن كل شيء توقف بصمت في 2024. مشهد GitHub الخاص بأدوات استخراج بيانات Reddit في 2026 هو مقبرة للنوايا الحسنة، ممزوجة بعدد قليل من الأدوات المفيدة فعلًا. هذا الدليل يشرح ما يزال يعمل، وما تعطل، ومتى تتخلى عن الكود بالكامل، وكيف تبقى على الجانب الصحيح من تطبيق Reddit الصارم المتزايد. وإذا كنت تبحث عن طريق مختصر، فـThunderbit هو خيار بلا كود بنيناه لهذا النوع من المشكلات بالضبط — لكنني سأكون صريحًا أيضًا بشأن الحالات التي تظل فيها الحلول المعتمدة على الكود أكثر منطقية.
ما هو مستودع GitHub لأداة استخراج بيانات Reddit؟ ولماذا تعطّل كثير منها؟
مستودع "reddit scraper github" هو عادة مشروع مفتوح المصدر بلغة Python (وأحيانًا JavaScript) يتيح أتمتة جلب المنشورات أو التعليقات أو بيانات المستخدمين أو الوسائط من Reddit. ويمكن تصنيفها عمومًا إلى أربع فئات:
- مغلفات واجهة برمجة التطبيقات مثل PRAW: تستخدم واجهة Reddit الرسمية، وتتطلب OAuth، وتلتزم بقواعد Reddit.
- أدوات قائمة على Pushshift/PSAW: كانت تستخدم أرشيف Pushshift الضخم للوصول إلى البيانات التاريخية من Reddit.
- أدوات تعتمد على نقطة نهاية
.jsonالعامة: تضيف.jsonإلى عناوين Reddit أو تصل إلى نقاط نهاية عامة دون مصادقة. - أدوات تعتمد على المتصفح: تستخدم Playwright أو Selenium أو إضافات المتصفح لتحميل صفحات Reddit واستخراج المحتوى المعروض.
لماذا تعطلت كل هذه الأدوات؟ لثلاثة أسباب.
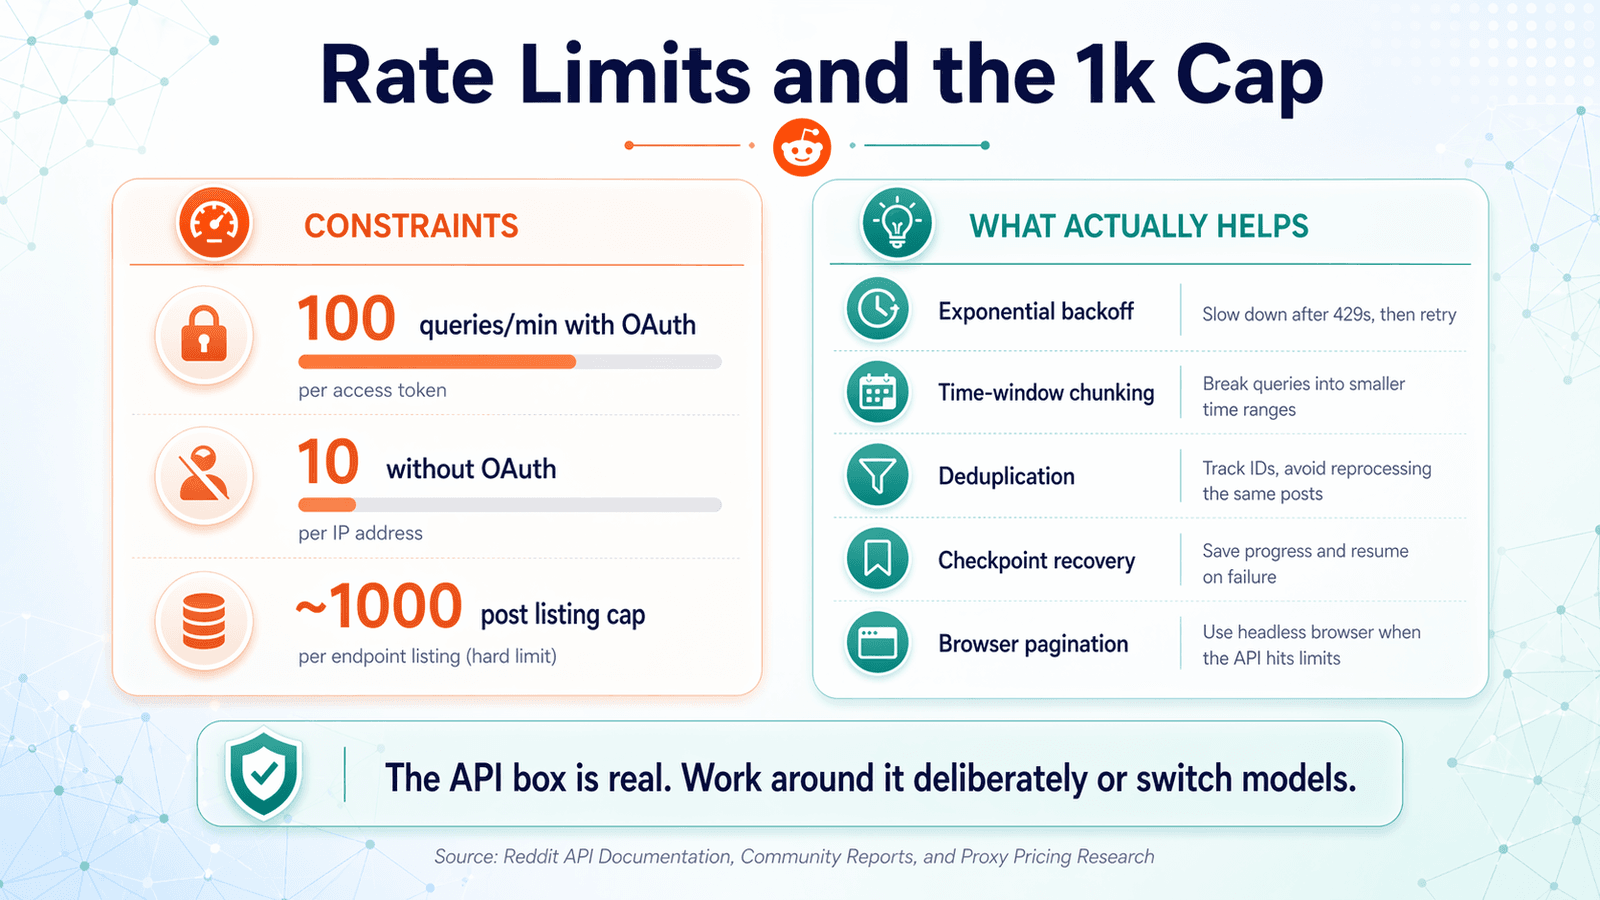
- إعادة هيكلة تسعير واجهة Reddit البرمجية في منتصف 2023. انخفضت حدود الاستخدام المجاني إلى 100 طلب في الدقيقة مع OAuth و10 فقط بدونه. أما الاستخدام التجاري الأعلى فأصبح يكلف 0.24 دولار لكل 1,000 استدعاء لواجهة برمجة التطبيقات. بُنيت كثير من المستودعات على عالم كانت فيه واجهة API شبه غير محدودة — وهذا العالم انتهى.
- سُحب الوصول العام إلى Pushshift. كان Pushshift العمود الفقري لأبحاث Reddit التاريخية. وبمجرد أن قيّدته Reddit، فقدت حصة كبيرة من مستودعات "الأداة التاريخية" مصدرها الرئيسي للبيانات. ما تزال بعض ملفات README توحي بأن هذه الأدوات تعمل، لكن الاعتماد الأساسي لم يعد متاحًا للمستخدمين العاديين.
- شدّدت Reddit السياسة وفرضتها. تحديث robots.txt في 2024، وسياسة المحتوى العام في 2025، وسياسة البناء المسؤول في مارس 2026 — كلها إشارات إلى أن Reddit لم تعد تتعامل مع الاستخراج الجماعي على أنه ضجيج خلفي غير ضار. وقد قدمت حتى شكاوى ضد Anthropic وSerpApi بسبب الوصول غير المصرح به إلى البيانات.
الخلاصة: ابحث عن "reddit scraper github" وستحصل على مئات النتائج. لكن تواريخ آخر commit وعدد المشكلات المفتوحة تحكي قصة مختلفة تمامًا.
فحص حالة Reddit Scraper على GitHub في 2026: ما الذي ما يزال يعمل؟
كثير من المقالات المنافسة كُتبت في 2023 أو 2024 ولم تُحدّث بعد ذلك. ويصطدم مستخدمو المنتديات باستمرار بأخطاء في مستودعات كانت تعمل قبل عام — وصرخة أحد المستخدمين: "Keep running into Reddit API limitation error :\ Any ideas how I can get past this?" تلخص تجربة Reddit scraper في 2026 على نحو شبه كامل.
أجريت تدقيقًا حديثًا للحالة، وتم التحقق منه حتى أبريل 2026. وإليك ما وجدته.
PRAW: المغلف الرسمي لـ Python
الحالة: ✅ ما يزال يعمل، مع بعض التحفظات.
يبقى PRAW (Python Reddit API Wrapper) أكثر أساس مفتوح المصدر موثوقًا لاستخراج بيانات Reddit. وهو ما يزال يُصان بنشاط — 4,099 نجمة، وآخر دفع في 20 أبريل 2026، و6 مشكلات مفتوحة فقط، كما أن PyPI يدرج praw 7.8.1 (صدر في أكتوبر 2024).
نقاط القوة: رسمي، موثق جيدًا، ويخفف تعقيد معظم تفاصيل واجهة Reddit البرمجية.
قيود 2026:
- متطلبات OAuth أكثر صرامة. تحتاج إلى تطبيق Reddit مسجل مع وصف حالة استخدام معتمد.
- حدود معدل أقل منذ 2024 (100 طلب/دقيقة مع OAuth، و10 بدونه).
- لا يزال حد الـ ~1,000 منشور في القوائم قائمًا. تؤكد نقاشات المجتمع في r/redditdev وStack Overflow: لا توجد طريقة لاسترجاع أكثر من 1,000 منشور لكل نقطة نهاية من نقاط القائمة.
PRAW هو الخيار الأكثر أمانًا إذا استطعت الالتزام بإطار واجهة API.
لكنه لم يعد أداة استخراج جماعي حرة الشكل.
إذا أردت شرحًا عمليًا لمسار واجهة API الرسمية، فهذه الدورة تناسب هذا القسم جيدًا:
Pushshift / PSAW: الأرشيف الذي انطفأ
الحالة: ❌ انتهى الوصول العام.
كان PSAW هو المغلف البرمجي المفضل لـ Pushshift، الذي كان في السابق أسهل طريق إلى البيانات التاريخية من Reddit. وفي 2026، أصبح المستودع مؤرشفًا، ويقول README حرفيًا: "THIS REPOSITORY IS STALE"، كما تتضمن المشكلات المفتوحة الحديثة عبارات مثل "Pushshift.io UNABLE to connect" و"The code not working. Possibly due to pushshift api."
قد يظل الوصول الأكاديمي متاحًا عبر قنوات محددة، لكن بالنسبة لأي شخص يبحث اليوم عن "reddit scraper github"، لم يعد Pushshift/PSAW خيارًا قابلًا للاستخدام. إذا كنت تحتاج إلى بيانات Reddit التاريخية العميقة، فستحتاج إلى البحث في مسارات الوصول الأكاديمي المعتمدة أو المسارات المرخّصة.
snscrape (وحدة Reddit): جزئي وغير موثوق
الحالة: ⚠️ جزئي — يتعطل أحيانًا، وغير مُصان إلى حد كبير.
يملك snscrape 5,337 نجمة، لكن آخر دفع كان في 15 نوفمبر 2023. وما يزال README يذكر أن استخراج Reddit مدعوم "عبر Pushshift". وتتضمن المشكلات المفتوحة المرتبطة بـ Reddit عبارات مثل "Error reddit scraping" و"Reddit scraper returns no submissions before 2022-11-03"، دون وجود نشاط إصلاح ذي معنى مؤخرًا.
قد ينجح في بعض البيئات مع عمليات سحب صغيرة ومرة واحدة، لكنه ليس موثوقًا للإنتاج أو للاستخراج المتكرر. تعامل معه كخيار قديم.
Playwright وأدوات نقطة نهاية .json: التحايل الذي ينجح أحيانًا
الحالة: ✅ يعمل، لكنه هش.
الفكرة هنا بسيطة: استخدم متصفحًا بلا واجهة مثل Playwright أو Puppeteer لتحميل صفحات Reddit واستخراج المحتوى المعروض، أو أضف .json إلى روابط Reddit للحصول على بيانات منظمة دون واجهة API الرسمية.
نقاط القوة: لا تحتاج إلى مفتاح API، ويمكنه تجاوز حد الـ 1,000 منشور، ويمنحك الوصول إلى المحتوى المعروض.
نقاط الضعف: قد يتعطل عند تغيير Reddit لتصميم الواجهة الأمامية أو بنية JSON، وقد يفعّل إجراءات مكافحة البوت، كما يتطلب إعدادًا تقنيًا أكثر. وفي اختباري هذا الشهر، أعادت الطلبات المباشرة إلى نقاط نهاية Reddit العامة بصيغة .json استجابات 403. هذا لا يعني أن كل بيئة ستُحظر، لكنه يعني أن اختصار .json لم يعد شيئًا ينبغي أن تفترض أنه "سيعمل ببساطة".
مستودعات مثل yars صريحة بشكل منعش في هذا الشأن: يحذّر README المستخدمين من "Use with rotating proxies, or Reddit might gift you with an IP ban." وهذا يلخص قصة أبريل 2026 في جملة واحدة تقريبًا.
إذا كنت تقيّم مسار التحايل عبر أتمتة المتصفح، فهذه الدورة حول Playwright تعد مكمّلًا قويًا للقسم أدناه:
Thunderbit: استخراج عبر المتصفح مدعوم بالذكاء الاصطناعي (بلا كود، بلا مفتاح API)
الحالة: ✅ يعمل — ويتكيف تلقائيًا مع تغييرات الصفحة.
يتبع Thunderbit نهجًا مختلفًا جذريًا. إنه إضافة Chrome تستخدم الذكاء الاصطناعي لقراءة صفحات Reddit، واقتراح حقول البيانات (عنوان المنشور، الكاتب، الأصوات الإيجابية، الطابع الزمني، الرابط، إلخ)، واستخراج البيانات المنظمة في نقرات اثنتين. لا إعداد OAuth، ولا تسجيل لمفتاح API، ولا بيئة Python، ولا إدارة للاعتمادات. يقرأ الذكاء الاصطناعي الصفحة من جديد في كل مرة، لذلك عندما يغيّر Reddit تصميمه، يتكيف Thunderbit تلقائيًا بدلًا من أن يتعطل بصمت.
تصدير مجاني إلى CSV أو Google Sheets أو Airtable أو Notion. يدعم التصفح الصفحي واستخراج الصفحات الفرعية أيضًا (مثل استخراج قائمة subreddit ثم زيارة كل منشور لجلب التعليقات). ولمن يريد بيانات Reddit دون صيانة مستودع GitHub، فهذا هو المسار الأقل مقاومة.
(إفصاح كامل: نحن بنينا Thunderbit، لذلك لدي تحيز واضح — لكنني سأكون صريحًا بشأن المواضع التي تظل فيها الحلول المعتمدة على الكود أكثر منطقية لاحقًا في هذا المقال.)
جدول ملخص الحالة جنبًا إلى جنب
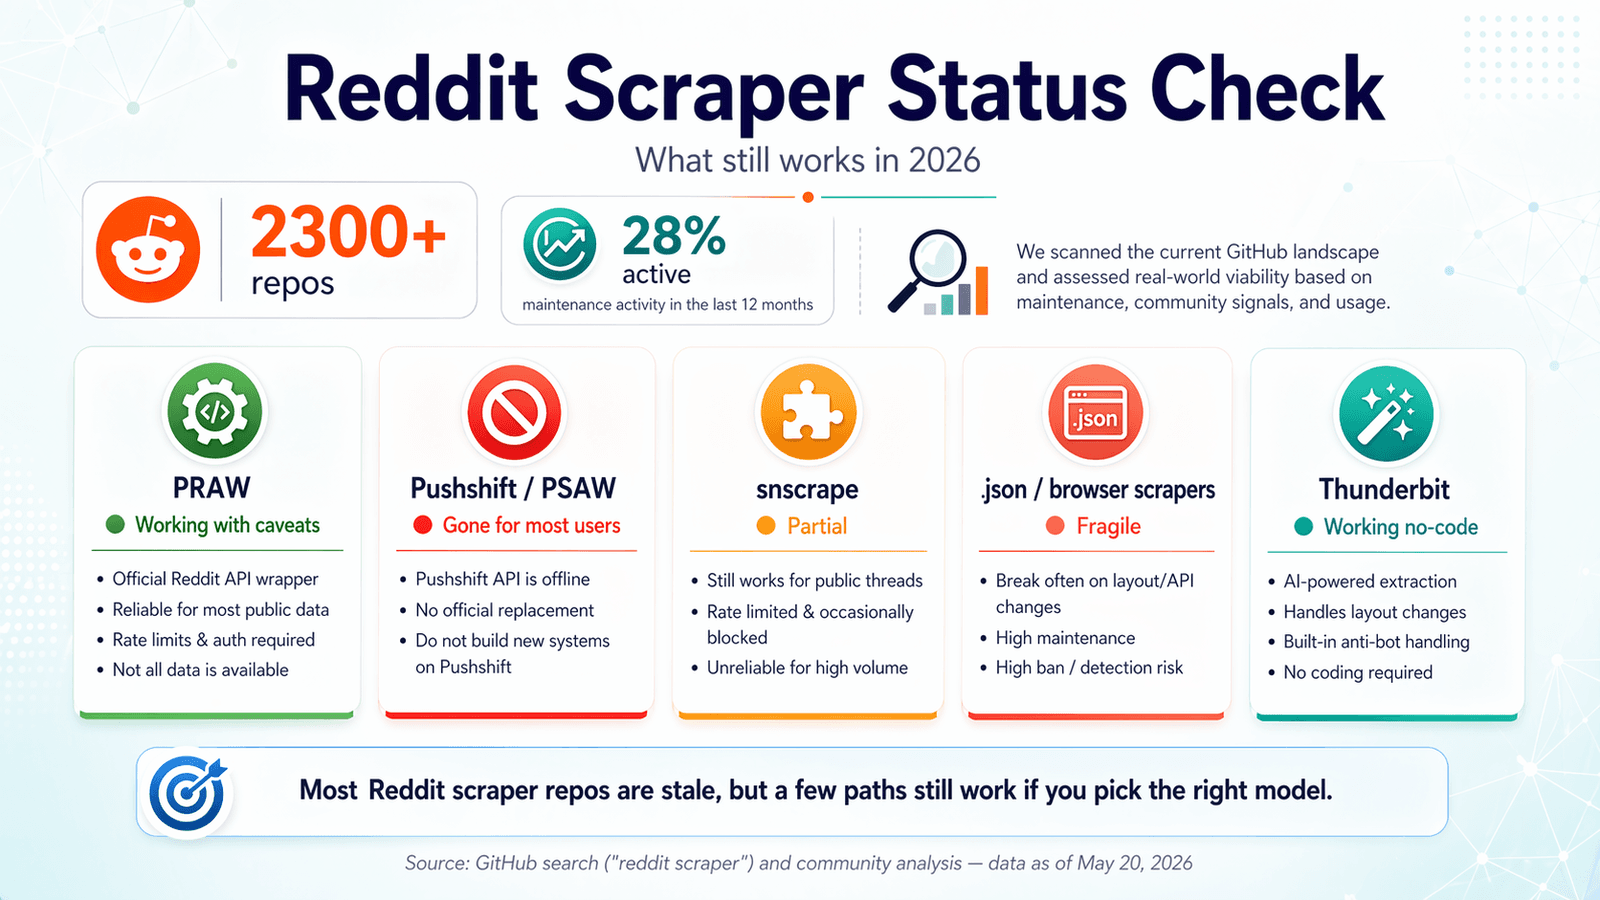
| الأداة / الفئة | هل ما تزال تعمل (أبريل 2026)؟ | هل يتطلب مفتاح API؟ | ملاحظات |
|---|---|---|---|
| PRAW | ✅ نعم، مع تحفظات | نعم (OAuth) | أفضل أساس مفتوح المصدر من حيث الصيانة. محدود بقيود المعدل وحدّ 1,000 منشور. |
| Pushshift / PSAW | ❌ لا (لأغلب المستخدمين) | غير متاح | انتهى الوصول العام. المستودع مؤرشف. |
| snscrape (وحدة Reddit) | ⚠️ جزئي / غير موثوق | لا | ما يزال يذكر Reddit "عبر Pushshift". توقفت الصيانة منذ 2023. |
أدوات .json / نقطة النهاية العامة | ⚠️ جزئي | لا | قد تعمل، لكن الطلبات المباشرة تُحظر أكثر فأكثر. تعتمد على البروكسي. |
| Playwright / أدوات المتصفح | ✅ نعم، لكنها هشة | عادة لا | أكثر بديل عملي DIY بلا API. ما تزال تغييرات الصفحة ومكافحة البوت مهمة. |
| Thunderbit | ✅ نعم | لا | سير عمل بالذكاء الاصطناعي/المتصفح. بلا OAuth، بلا محددات CSS. الأنسب لغير المطورين. |
حدود المعدل، وحد الـ 1,000 منشور، وما الذي يساعد فعلًا
هذه هي أكبر نقطة ألم لأي شخص يستخدم مشروع reddit scraper github. امتلأت نقاشات المنتديات بالإحباط: "tired of runs dying halfway through because of rate limits"، و"Why am I only getting around 1,000 items?". والقيود الأساسية اثنان: حدود معدل واجهة Reddit البرمجية (الطلبات في الدقيقة) وحد القوائم البالغ نحو 1,000 منشور (إذ تعيد الواجهة فقط أحدث نحو 1,000 منشور لكل نقطة نهاية من نقاط القائمة).
أفضل ممارسات إدارة حدود المعدل
الحد الحالي العام في Reddit: 100 طلب في الدقيقة مع OAuth، و10 بدون. إليك كيفية التعامل مع ذلك عمليًا:
- التراجع الأسي. إذا تلقيت استجابة تحدٍّ من الحد، انتظر ثم أعد المحاولة بعد تأخير أطول في كل مرة (1 ثانية، 2، 4، 8...). لا تواصل ضرب نقطة النهاية بلا توقف.
- اقرأ ترويسات
X-Ratelimit-Remaining. تتضمن استجابات واجهة Reddit البرمجية ترويسات تخبرك بعدد الطلبات المتبقية ومتى تُعاد تهيئة النافذة. اضبط إيقاع طلباتك بناءً على هذه القيم لا على التخمين. - تدوير User-Agent. تقترح بعض المستودعات ذلك لتجنب الاكتشاف. قد يساعد، لكن استخدمه بأخلاقية — لا تستخدمه لتجاوز الحظر الذي استحققته.
- سجّل كل شيء. أضف تسجيلًا لاستجابات API، وترويسات حد المعدل، والأخطاء. عندما يتعطل المستخرج عند الثانية صباحًا، تكون السجلات أفضل صديق لك.
كسر سقف الـ 1,000 منشور
أكثر الحلول الموثوقة لتجاوز حد القوائم البالغ نحو 1,000 عنصر في API هو التقطيع إلى نوافذ زمنية:
- استعلم عن شريحة زمنية واحدة باستخدام معاملات الطابع الزمني
beforeوafter. - حرّك النافذة إلى الأمام (أو إلى الخلف).
- كرر العملية.
- أزل التكرار بالاعتماد على معرف المنشور.
هذا ليس أنيقًا، لكنه أكثر صدقًا من التظاهر بأن حلقة طلب واحدة يمكنها جلب تاريخ غير محدود من نقطة نهاية قائمة. وللحصول على بيانات تاريخية فعلًا، ستحتاج إلى وصول أكاديمي معتمد أو مسار مرخّص — فـPushshift لم يعد الإجابة الافتراضية.
أما الاستخراج عبر المتصفح (Playwright أو Thunderbit) فيتجاوز هذا الحد بالكامل لأنه يستخرج ما يتم عرضه على الصفحة، لا ما تعيده الواجهة. تتيح لك ميزة التصفح الصفحي في Thunderbit التنقل بين الصفحات وجمع البيانات عبر أي عدد تحتاجه من الصفحات.
إزالة التكرار واستعادة الأخطاء
معظم مستودعات reddit scraper github لا تتعامل مع إزالة التكرار أو استعادة الأخطاء بشكل افتراضي. ويشتكي المستخدمون صراحة من أن "none had deduping, rate limit avoidance after errors, checking if files are already downloaded". إليك ما ينبغي فعله:
- إزالة التكرار: أنشئ تجزئة لكل معرف منشور (أو المعرف + المحتوى). خزّن التجزئات التي شوهدت في قاعدة SQLite بسيطة أو حتى ملف مسطح. قبل الإدراج، تحقق مما إذا كانت التجزئة موجودة بالفعل. وهذا مهم خصوصًا عند تقطيع النوافذ الزمنية أو إعادة تشغيل المهام الفاشلة.
- استعادة الأخطاء: احفظ التقدم في ملف نقطة تفتيش بعد كل N سجل. إذا فشلت العملية، أعد البدء من آخر نقطة تفتيش بدلًا من البداية. هذا يحوّل مهمة تستغرق 3 ساعات وتتعطل في الساعة الثانية إلى مهمة قابلة للاستئناف خلال ساعة واحدة.
كيف تتعامل المقاربات المختلفة مع هذه القيود
| النهج | التعامل مع حد المعدل | أكثر من 1,000 منشور؟ | إزالة تكرار تلقائية؟ | استعادة الأخطاء؟ |
|---|---|---|---|---|
| PRAW (خام) | يدوي (انتظار/إعادة محاولة) | ❌ (حد API) | ❌ | ❌ |
| PRAW + التقطيع الزمني | يدوي | ✅ (حل بديل) | ❌ | ❌ (إلا إذا أضفته) |
استخراج .json عبر Playwright | غير منطبق (لا API) | ✅ | ❌ | ❌ |
| Thunderbit (استخراج عبر المتصفح) | مدمج (إيقاع بالذكاء الاصطناعي) | ✅ (تصفح صفحي) | غير منطبق (مراجعة بصرية) | مدمج |
متى لا يكون مستودع GitHub لأداة استخراج Reddit هو الحل: مسار بلا كود
تفترض معظم مقالات reddit scraper github أنك تجيد Python. لكن كثيرًا من الباحثين عن حلول استخراج Reddit هم مسوقون، أو مندوبي مبيعات، أو باحثون، أو مؤسسو شركات ناشئة لا يكتبون Python يوميًا. وبالنسبة لهذه الفئة، يضيف مستودع GitHub تكاليف مخفية:
- إعداد بيانات اعتماد OAuth وتطبيق مطوّر Reddit
- إدارة البيئات الافتراضية في Python وتعارض الاعتمادات
- تصحيح رسائل الخطأ الغامضة عندما تتغير البنية الداخلية لـ PRAW
- التعامل مع إلغاء مفتاح API إذا قررت Reddit أن حالة استخدامك غير معتمدة
- صيانة السكربت كلما غيّرت Reddit شيئًا
هذه ليست افتراضات نظرية. فمستودع bulk-downloader-for-reddit يملك 2,563 نجمة و107 مشكلات مفتوحة. وتتضمن التقارير الحديثة عبارات مثل "Struggling to install" و"PRAW module error" و"Exception not allowing to even authenticate."
استخدم مستودع GitHub إذا...
- كنت تحتاج إلى منطق استخراج مخصص (مثل اجتياز شجرة تعليقات محددة أو دمج مخصص مع خط معالجة NLP).
- أردت الدمج ضمن خط معالجة بيانات Python موجود.
- احتجت إلى استخراج على نطاق ضخم جدًا مع تخزين مخصص (قاعدة بيانات، مستودع بيانات).
- كنت مرتاحًا لصيانة الكود والتعامل مع التغييرات الكاسرة.
استخدم أداة بلا كود إذا...
- كنت تحتاج بيانات Reddit بسرعة — خلال دقائق، لا ساعات من الإعداد.
- لا تريد إدارة مفاتيح API أو تطبيقات OAuth أو بيئات Python.
- تريد التصدير مباشرة إلى الجداول أو Notion أو Airtable للاستخدام الفوري.
- تريد أن تتكيف الأداة تلقائيًا عندما يتغير تصميم Reddit.
Thunderbit يقع بوضوح في معسكر بلا كود. يمكن للمستخدمين استخراج منشورات Reddit والتعليقات وبيانات المستخدمين في نقرات اثنتين مع حقول مقترحة بالذكاء الاصطناعي، والتصدير مجانًا إلى CSV أو Google Sheets أو Airtable أو Notion، والتعامل مع التصفح الصفحي دون كتابة أي كود. أما كونه يستخرج عبر المتصفح فيعني عدم الحاجة إلى إعداد OAuth أو التسجيل لمفتاح API.
شرح سريع: استخراج Reddit باستخدام Thunderbit (خطوة بخطوة)
- ثبّت إضافة Thunderbit Chrome.
- انتقل إلى صفحة Reddit التي تريد استخراجها (subreddit، نتائج البحث، ملف المستخدم).
- انقر على "اقتراح الحقول بالذكاء الاصطناعي". يقرأ Thunderbit الصفحة ويقترح الأعمدة — عنوان المنشور، الكاتب، الأصوات الإيجابية، الطابع الزمني، الرابط، إلخ.
- عدّل الحقول إذا لزم الأمر، ثم انقر على "استخراج".
- راجع جدول البيانات. ويمكنك اختياريًا النقر على "استخراج الصفحات الفرعية" لزيارة كل منشور وجلب التعليقات أو التفاصيل الإضافية.
- صدّر إلى الوجهة التي تفضلها: Google Sheets أو Excel أو Airtable أو Notion أو CSV أو JSON.
دقيقتان. صفر أسطر من الكود. وإذا أردت رؤيته عمليًا، فاطّلع على قناة Thunderbit على YouTube.
طابق أداة استخراج Reddit مع المهمة: مصفوفة قرار حسب حالة الاستخدام
تنظم معظم مقالات reddit scraper github الأدوات حسب الأداة. وهذا ترتيب معكوس.
ابدأ من هدفك ثم ارجع إلى الأداة المناسبة.
توليد العملاء المحتملين وتنقيب نقاط الألم
ما تحتاجه: منشورات + تعليقات مع تصفية بالكلمات المفتاحية، ووسم/تصنيف بالذكاء الاصطناعي، وتصدير بصيغ جاهزة للـ CRM.
أفضل نهج: أداة بلا كود مع إثراء بالذكاء الاصطناعي.
الأداة الموصى بها: Thunderbit (وسم بالذكاء الاصطناعي + تصدير إلى Google Sheets أو Airtable للاستيراد إلى CRM).
مثال على سير العمل: استخرج منشورات من subreddit تتحدث عن نقطة ألم محددة. استخدم Field AI Prompt في Thunderbit لتصنيف المشاعر أو وسم الموضوعات. صدّر إلى Airtable أو Google Sheet لفريق المبيعات.
أبحاث السوق والتحقق من الأفكار
ما تحتاجه: عناوين منشورات عالية الحجم + الدرجات، وبيانات اتجاهات على مستوى subreddit.
أفضل نهج: PRAW مع التقطيع الزمني للحجم، أو Thunderbit للاستخراج السريع.
مثال: استخراج r/SaaS أو r/startups للموضوعات الرائجة وأنماط الأصوات الإيجابية خلال الأيام التسعين الماضية.
أرشفة الصور والوسائط
ما تحتاجه: روابط الوسائط، إزالة التكرار، وتشغيل مجدول.
أفضل نهج: مستودع GitHub متخصص (مثل bulk-downloader-for-reddit) + مهمة cron.
ملاحظة: إزالة التكرار مهمة هنا — فالصور نفسها تُنشر عبر عدة subreddits بشكل شائع.
البحث الأكاديمي والبيانات التاريخية
ما تحتاجه: بيانات تاريخية، أشجار تعليقات كاملة، ومجموعات بيانات كبيرة.
أفضل نهج: وصول أكاديمي معتمد أو مسار بيانات مرخّص. لم يعد Pushshift إجابة عامة لكل شيء.
فحص الواقع: هذه أصعب حالة استخدام في 2026 بسبب قيود Pushshift وتشديد سياسات بيانات Reddit.
مراقبة المنافسين والاستخراج المجدول
ما تحتاجه: استخراج متكرر على فترات محددة، واكتشاف التغيرات.
أفضل نهج: Scheduled Scraper من Thunderbit (صف زمن الفاصل الزمني بإنجليزية بسيطة، أدخل الروابط، ثم انقر Schedule) أو cron + سكربت للمستخدمين المعتمدين على الكود.
جدول مصفوفة قرار حالة الاستخدام
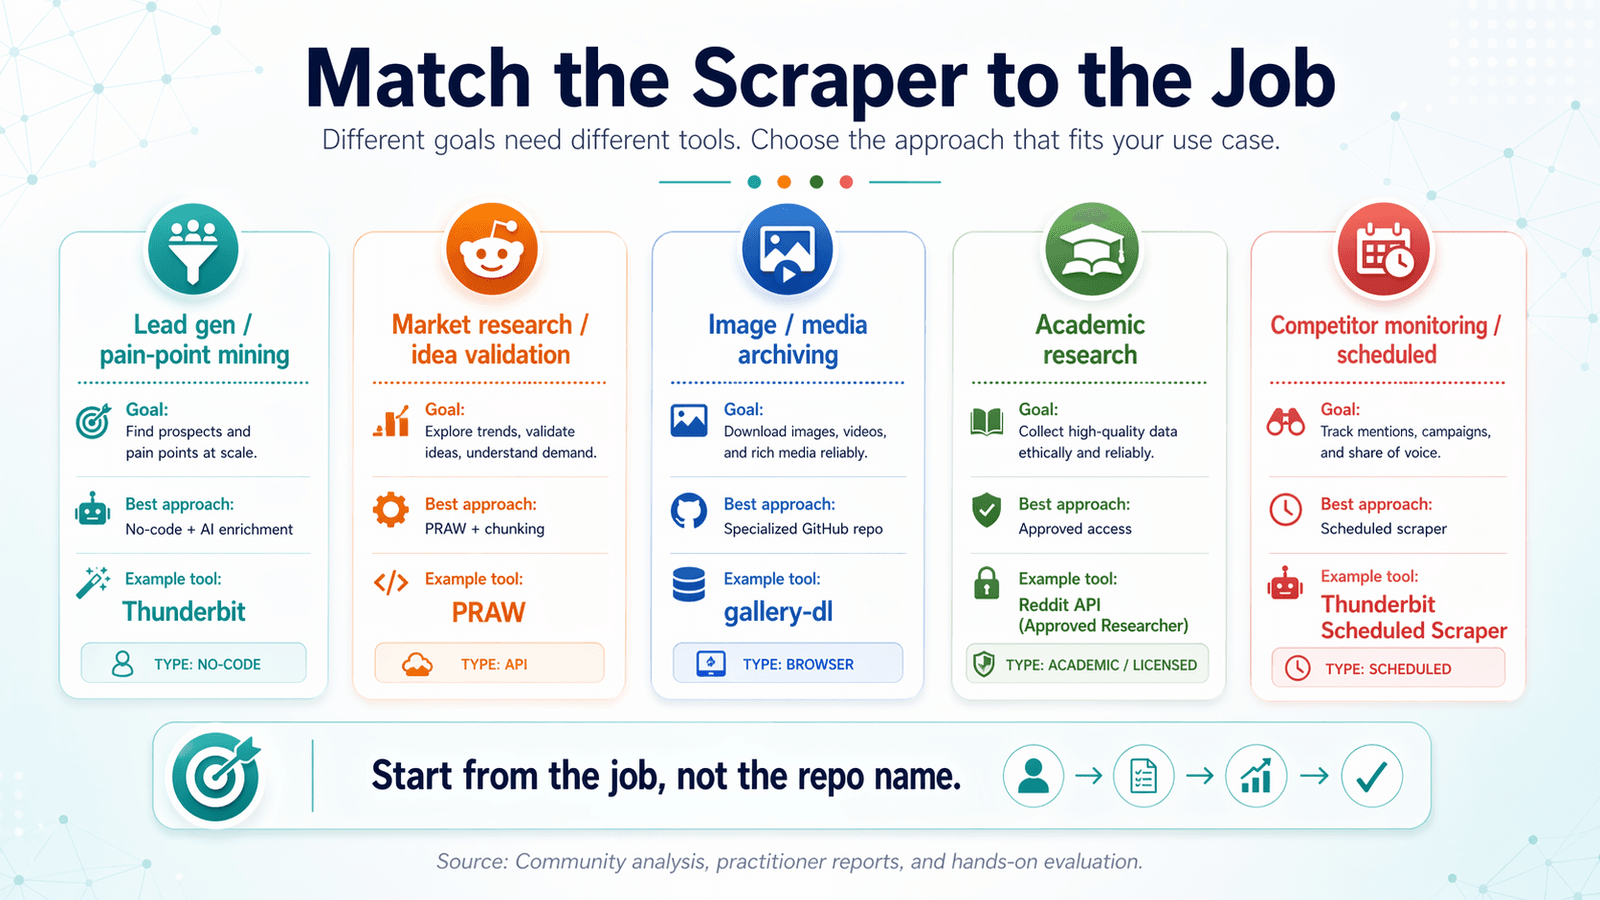
| حالة الاستخدام | ما تحتاجه | أفضل نهج | الأداة المثال |
|---|---|---|---|
| توليد العملاء المحتملين / تنقيب نقاط الألم | منشورات + تعليقات، تصفية بالكلمات المفتاحية، وسم بالذكاء الاصطناعي | أداة بلا كود + إثراء بالذكاء الاصطناعي | Thunderbit |
| أبحاث السوق / التحقق من الأفكار | عناوين منشورات عالية الحجم + الدرجات، بيانات subreddit | PRAW + التقطيع الزمني أو Thunderbit | PRAW أو Thunderbit |
| أرشفة الصور/الوسائط | روابط الوسائط، إزالة التكرار، تشغيل مجدول | مستودع GitHub متخصص + cron | bulk-downloader-for-reddit |
| البحث الأكاديمي | بيانات تاريخية، أشجار تعليقات كاملة | وصول أكاديمي معتمد أو Playwright | Pushshift academic API (إذا كان متاحًا) |
| مراقبة المنافسين / المجدول | استخراج متكرر، اكتشاف التغييرات | أداة استخراج مجدولة | Thunderbit Scheduled Scraper أو cron + سكربت |
كيف تقيم أي مستودع GitHub لأداة استخراج Reddit قبل أن تلتزم به
قبل أن تستنسخ أي مستودع وتبدأ في تصحيح الأخطاء، أجرِ هذا الفحص الصحي السريع خلال 5 دقائق. سيوفر عليك ساعات.
فحص صحة المستودع خلال 5 دقائق
- تاريخ آخر commit. إذا مرّ أكثر من 6 أشهر، فتقدم بحذر. تتغير واجهة Reddit البرمجية كثيرًا.
- نسبة المشكلات المفتوحة إلى المغلقة. عدد كبير من المشكلات غير المجاب عنها علامة حمراء. تحقق مما إذا كانت المشكلات الحديثة تذكر فشل المصادقة أو 403 أو انقطاعات Pushshift.
- ملف LICENSE. تحقق من وجوده. عدم وجود ترخيص = غموض قانوني (المزيد عن ذلك أدناه).
- الاعتمادات. هل المكتبات المطلوبة محدثة؟ هل يستخدم حزمًا مهجورة؟ ملف
requirements.txtمليء بإصدارات 2022 المثبتة هو إشارة تحذير. - جودة README. هل يشرح الإعداد بوضوح؟ هل توجد أمثلة استخدام؟ التوثيق الضعيف يعني وقت تصحيح أخطاء أطول بالنسبة لك.
- النجوم مقابل النسخ مقابل النشاط الحديث. قد يعني عدد نجوم كبير مع نشاط حديث منخفض أن المشروع كان شائعًا ثم تُرك. قارن النجوم بتاريخ
pushed_at.
مثال سريع: يملك PSAW 364 نجمة — يبدو مقنعًا للوهلة الأولى. لكن المستودع مؤرشف ويقول README: "THIS REPOSITORY IS STALE."
النجوم وحدها لا تحكي القصة.
نصائح للحصول على أقصى استفادة من إعداد Reddit Scraper على GitHub
إذا قررتَ بالفعل السير في طريق الكود، فإليك كيف توفر على نفسك الصداع.
استخدم دائمًا بيئة افتراضية
تُبقي البيئة الافتراضية اعتمادات المستخرج معزولة حتى لا تتعارض مع مشاريع Python الأخرى. أمر واحد: python -m venv venv ثم فعّلها قبل تثبيت أي شيء. هذه نظافة أساسية، لكنني رأيت ما يكفي من مشكلات GitHub بعنوان "module not found" لأعرف أن الأمر يستحق التكرار.
خزّن بيانات الاعتماد بأمان
لا تضع أبدًا client ID أو السر الخاص بـ Reddit مباشرة داخل السكربت. استخدم متغيرات البيئة أو ملف .env، وأضف .env إلى .gitignore. وإذا دفعت بيانات اعتماد بالخطأ إلى GitHub، فقم بتدويرها فورًا — فالبوتات تمسح مفاتيح API المكشوفة.
سجّل كل شيء
أضف تسجيلًا لاستجابات API، وترويسات حد المعدل، والأخطاء. عندما يتعطل شيء ما، فإن السجلات هي الفرق بين "أعرف بالضبط ما حدث" و"لا أعرف لماذا توقف".
جدول وأتمتة بعقلانية
إذا كنت تشغّل استخراجًا متكررًا، فاستخدم cron على Linux/Mac أو Task Scheduler على Windows — لكن راقب الأعطال. مهمة cron تفشل بصمت لمدة أسبوعين أسوأ من عدم وجود أتمتة أصلًا.
بديل: يتيح لك Scheduled Scraper من Thunderbit وصف الفاصل الزمني بإنجليزية بسيطة، دون الحاجة إلى صيغة cron.
أفضل الممارسات القانونية والأخلاقية لاستخراج بيانات Reddit
هذا ليس تنبيهًا عابرًا. فقد فرضت Reddit شروطها بقوة منذ تغييرات 2023 في API، ويترتب على استخراج البيانات الشخصية مخاطر قانونية حقيقية.
إليك ما يهم فعلاً.
شروط خدمة Reddit: ماذا تقول فعليًا؟
يحظر اتفاق المستخدم الخاص بـReddit، والمراجع حتى 31 مارس 2026، صراحةً الوصول إلى البيانات من الخدمات أو البحث فيها أو جمعها بوسائل آلية ما لم يسمح بذلك في الشروط أو باتفاق منفصل. وتضيف شروط Data API وشروط المطورين تفاصيل إضافية: قد تراقب Reddit استخدام المطورين وتراجعه، وتغيّر الوصول أو توقفه، وتحظر الوصول نهائيًا عند الاستخدام المفرط أو المسيء. والاستخدام التجاري يتطلب عمومًا موافقة صريحة.
وتذهب سياسة البناء المسؤول في مارس 2026 أبعد من ذلك: يلزم الحصول على موافقة قبل الوصول إلى بيانات Reddit عبر API، ويُحظر تحقيق الدخل غير المعتمد واستخدامات الذكاء الاصطناعي/تنقيب البيانات، وقد تشمل إجراءات التنفيذ إلغاء الرموز، وتعليق التطبيقات أو الحسابات، وتعليق الروبوتات أو النطاقات المرتبطة.
الامتثال لـ robots.txt
يأتي robots.txt الحالي الخاص بـ Reddit مقيدًا على نحو غير معتاد:
User-agent: *
Disallow: /
وهذا يعني منعًا شاملًا لجميع برامج المستخدم الآلية. كما يشير أيضًا إلى سياسة المحتوى العام. وهذا أقوى بكثير من أنماط robots.txt المتساهلة التي يفترضها بعض المطورين من أعراف الويب القديمة.
أفضل ممارسة: تحقق دائمًا من robots.txt قبل الاستخراج، حتى إن كانت أداتك لا تفرض ذلك تلقائيًا.
البيانات الشخصية والخصوصية (GDPR/CCPA)
إذا كنت تستخرج أسماء المستخدمين أو تاريخ المنشورات أو أي معلومات شخصية قابلة للتعريف، فقد ينطبق GDPR في الاتحاد الأوروبي وCCPA في كاليفورنيا. أفضل ممارسة: قم بإخفاء هوية البيانات الشخصية أو تجميعها قبل التخزين. لا تبنِ ملفات شخصية لمستخدمين أفراد دون أساس قانوني.
ترخيص مستودع GitHub: تحقق قبل أن تبني
تستخدم كثير من مستودعات reddit scraper github تراخيص MIT أو Apache (تراخيص متساهلة)، لكن بعضها لا يحتوي على ملف ترخيص إطلاقًا — ما يعني قانونيًا "جميع الحقوق محفوظة". قبل عمل fork أو التعديل أو البناء على أي مستودع، تحقق دائمًا من ملف LICENSE. عدم وجود ترخيص = غموض قانوني، بغض النظر عن عدد النجوم.
التنفيذ الحقيقي في 2025–2026
لم تتوقف قصة تطبيق Reddit عند 2023. فقد رفعت Reddit شكوى ضد Anthropic في 2025 تزعم فيها استخراج/استخدام محتوى Reddit دون إذن، كما اتجهت أيضًا إلى Reddit v. SerpApi في أواخر 2025. هذه إشارات إلى أن Reddit مستعدة للمضي في التنفيذ القانوني، لا الاكتفاء بالحظر التقني.
اختيار نهج Reddit Scraper GitHub المناسب في 2026
لقد تغيّر مشهد reddit scraper github جذريًا منذ 2023. معظم المستودعات قديمة. حدود المعدل وحد الـ 1k منشور قيود حقيقية. Pushshift لم يعد متاحًا للمستخدمين العاديين. وحزمة سياسات Reddit أصبحت أكثر وضوحًا وأكثر تطبيقًا من أي وقت مضى.
الخلاصة السريعة:
- PRAW ما يزال الأساس المفتوح المصدر الأكثر موثوقية إذا كنت تقبل حدود API الخاصة بـ Reddit وتريد بناء منطق مخصص.
- Pushshift/PSAW لم يعد إجابة عامة.
- وحدة Reddit في snscrape قديمة وغير موثوقة.
- أدوات
.jsonونقاط النهاية العامة هشة وغالبًا ما تُحظر في 2026. - الأدوات المعتمدة على المتصفح — سواء مستودعات Playwright أو الخيارات بلا كود مثل Thunderbit — هي المسار الأكثر عملية لكثير من المستخدمين، خصوصًا غير المطورين.
ابدأ من حالة الاستخدام، لا من الأداة. وأجرِ فحص صحة المستودع خلال 5 دقائق قبل الالتزام بأي مشروع GitHub.
وإذا كنت تفضّل تجاوز الإعداد والبدء في استخراج Reddit خلال دقائق، فـجرّب Thunderbit.
جرّب Thunderbit لاستخراج Reddit Get Started Free
الأسئلة الشائعة
ما أفضل أدوات استخراج Reddit مفتوحة المصدر على GitHub في 2026؟
يبقى PRAW أكثر مغلف API موثوقية، مع صيانة نشطة وتوثيق جيد. أما URS فهو أداة CLI موثوقة ومُصانة مبنية على PRAW. وتعمل الأدوات المبنية على Playwright للاستخراج من دون API، كما أن وحدة Reddit في snscrape تعمل جزئيًا لكنها غير مُصانة إلى حد كبير. تحقّق دائمًا من تاريخ آخر commit والمشكلات المفتوحة قبل استخدام أي مستودع — فمعظم أكثر من 2,300 مستودع لاستخراج Reddit على GitHub أصبحت قديمة.
هل استخراج Reddit قانوني؟
يقع استخراج البيانات المتاحة علنًا في منطقة قانونية رمادية، لكن شروط Reddit نفسها صارمة. فـاتفاق المستخدم، وشروط Data API، وسياسة المحتوى العام، وسياسة البناء المسؤول، وrobots.txt كلها تقف ضد الاستخراج الجماعي غير المصرح به. وقد يتطلب إعادة توزيع البيانات المستخرجة تجاريًا إذنًا صريحًا من Reddit. وإذا كنت تستخرج بيانات شخصية، فقد ينطبق أيضًا GDPR وCCPA.
كيف أتجاوز حدود معدل API في Reddit؟
استخدم التراجع الأسي، وراقب ترويسات X-Ratelimit-Remaining، وفكّر في التقطيع إلى نوافذ زمنية للعمل ضمن الحدود. أما الاستخراج عبر المتصفح (Playwright أو Thunderbit) فيتجاوز حدود API لأنه يستخرج الصفحات المعروضة، لكنه يأتي مع اعتبارات أخرى (سرعة تحميل الصفحة، إجراءات مكافحة البوت). لا توجد حيلة سحرية لإزالة حدود المعدل بالكامل — فهي تُفرض من جهة الخادم.
هل يمكنني استخراج Reddit دون مفتاح API؟
نعم. لا تتطلب الأدوات المبنية على Playwright ولا حيلة عنوان .json مفاتيح API. كما أن Thunderbit لا يحتاج إلى مفتاح API لأنه يستخرج عبر المتصفح. لكن المفاضلات موجودة: نقاط نهاية .json تُحظر بشكل متزايد (وتعيد 403 في كثير من البيئات حتى أبريل 2026)، والاستخراج عبر المتصفح أبطأ وأكثر استهلاكًا للموارد من استدعاءات API.
ماذا حدث لـ Pushshift في استخراج Reddit؟
أزيل الوصول العام إلى API الخاص بـ Pushshift بعد تغييرات ترخيص بيانات Reddit التي بدأت في 2023. ومغلف PSAW مؤرشف وقديم. قد يوجد وصول أكاديمي محدود عبر قنوات معتمدة محددة، لكن بالنسبة لمعظم المستخدمين الذين يبحثون اليوم عن "reddit scraper github"، لم يعد Pushshift خيارًا قابلًا للاستخدام. إذا كنت تحتاج إلى بيانات Reddit التاريخية العميقة، فابحث في المسارات الأكاديمية أو المرخّصة المعتمدة من Reddit.
اعرف المزيد




