
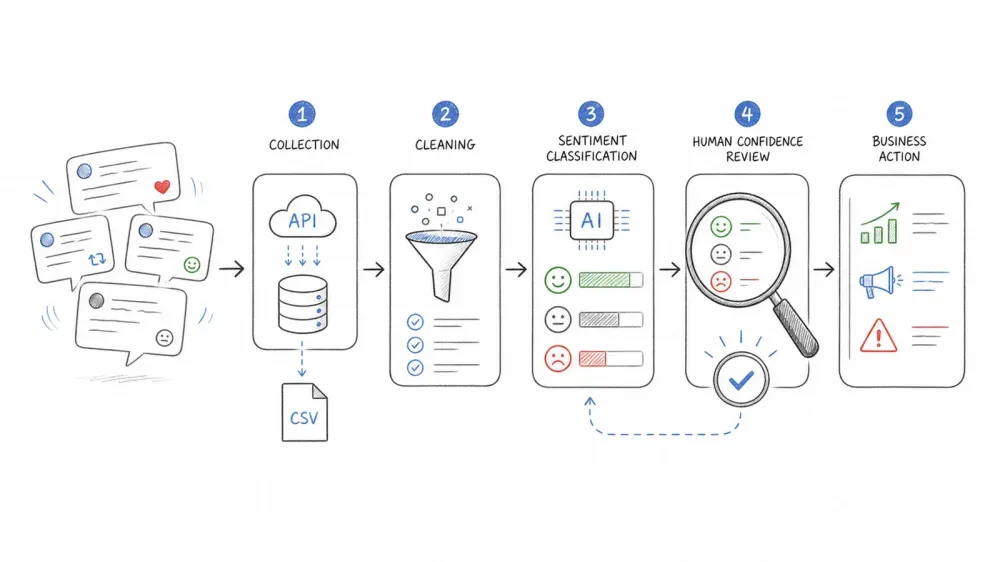
افتح جدول بيانات فيه 300 منشور خام، وستبان المشكلة فورًا: نسخ، لصق، قراءة، تدقيق، تخمين، إعادة... ومع ذلك قد تظل لا تعرف في النهاية هل الناس أحبّوا الإطلاق الذي تتابعه أم كرهوه.
وهذا هو سبب وجود تحليل المشاعر. لكن المشكلة هنا أن أغلب الشروحات عن هذا الموضوع ما زالت عالقة في 2022. فهي تفترض وجود API مجاني لم يعد موجودًا، وتقترح نماذج تتعثر أمام السخرية والرموز التعبيرية، وتهمل خطوات المعالجة المسبقة التي تحدد فعليًا هل النتائج لها معنى أم لا. لقد قضيت وقتًا طويلًا في عالم SaaS والأتمتة (بما في ذلك بناء Thunderbit)، وشاهدت مجال تحليل المشاعر يتغير بشكل كبير. والطريق الصادق والمحدّث يغطي كلًا من Python ومسارات العمل بدون كود، مع أساليب جمع بيانات ونماذج تعكس واقع 2026.
ما هو تحليل مشاعر Twitter؟
تحليل مشاعر Twitter هو عملية تصنيف منشورات X تلقائيًا إلى إيجابية أو سلبية أو حيادية بناءً على النص والرموز التعبيرية والسياق. ويمكنك اعتباره تدريبًا لآلة على قراءة تغريدة والإجابة عن سؤال: "هل هذا الشخص سعيد أم غير سعيد أم في المنتصف؟"
لكن تحليل المشاعر يختلف عن الاستماع الاجتماعي العام. فالاستماع الاجتماعي يركز على متابعة ما يتحدث عنه الناس—المواضيع، الاتجاهات، والحجم. أما تحليل المشاعر فهو طبقة التقييم والتصنيف فوق ذلك: إذ يوضح كيف يشعر الناس تجاه ما يقولونه. هذا المفهوم يعود إلى اللسانيات الحاسوبية وأبحاث التنقيب عن الآراء قبل عقود، لكنه لم يتحول إلى أداة أعمال رئيسية إلا خلال السنوات القليلة الماضية.
هناك عدة مستويات شائعة للتصنيف:
- ثنائي: إيجابي أو سلبي (الأبسط، لكنه يفوّت كثيرًا من التفاصيل)
- ثلاثي: إيجابي، محايد، أو سلبي (الخيار الافتراضي الأكثر شيوعًا)
- دقيق التدرج: إيجابي جدًا ← سلبي جدًا (مفيد للأبحاث وتتبع العلامة التجارية بشكل أعمق)
وهناك مهام مرتبطة لكنها مختلفة—مثل اكتشاف العاطفة (غاضب، حزين، سعيد)، واكتشاف الموقف (مع أو ضد فكرة ما)، وتحليل المشاعر على مستوى الجانب (كيف يشعر الشخص تجاه السعر مقابل الجودة)، واكتشاف السخرية/التهكم. ويعامل TweetEval benchmark هذه المهام كمهام منفصلة، ولسبب وجيه: فدرجة مشاعر واحدة لا تستطيع الإجابة عن كل سؤال تجاري. إذا كنت تتابع إطلاق منتج، فغالبًا تحتاج إلى تحليل على مستوى الجانب ("أحب الكاميرا، أكره البطارية"). وإذا كنت تراقب أزمة، فأنت بحاجة إلى العاطفة والحجم، وليس مجرد الإيجابية أو السلبية.
لماذا يهم تحليل مشاعر Twitter لنشاطك التجاري؟
تم بناء X حول الحوار اللحظي، لذلك يمكن أن تتراكم ردود الفعل على الإطلاقات والأحداث المباشرة والأخبار العاجلة بسرعة كبيرة. بالنسبة للشركات، هذه السرعة هي جوهر الفائدة. يحوّل تحليل المشاعر سيل النصوص غير المنظمة إلى بيانات منظمة يمكن للفريق مراجعتها واتخاذ إجراء بشأنها.
وتنقسم حالات الاستخدام الأكثر شيوعًا كالتالي:
| حالة الاستخدام | الفريق | النتيجة التجارية |
|---|---|---|
| مراقبة سمعة العلامة التجارية | العلاقات العامة، التسويق | التقاط الارتفاعات السلبية قبل انتشارها |
| تقييم إطلاق منتج | المنتج، التسويق | معرفة ما الذي يعمل وما الذي لا يعمل، في الوقت الحقيقي |
| المقارنة التنافسية | الاستراتيجية، التسويق | مقارنة إدراك العلامة التجارية بالمنافسين ضمن نفس الفترات |
| اكتشاف الأزمات | العلاقات العامة، العمليات | تفعيل المراجعة البشرية عند ارتفاع الحجم السلبي |
| أداء الحملات | التسويق | قياس تغيّر المشاعر حسب الإبداع أو القناة أو الوقت |
| مشاعر السوق/الأسهم | المالية، البحث | متابعة المزاج العام حول الأرباح أو الأحداث أو السياسات |
| البحث السياسي والسياسات العامة | البحث، الحكومة | قياس الرأي العام حول القضايا على نطاق واسع |
ولجعل ذلك ملموسًا: أبلغ تقرير X الخاص بـ Super Bowl 2026 عن 16 مليون منشور من 4 ملايين كاتب، و5 مليارات ظهور، و605 ملايين مشاهدة فيديو حول حدث واحد فقط—مع حدوث نصف الحوار في الوقت الحقيقي. هذا هو مستوى الحجم الذي يجعل القراءة اليدوية مستحيلة ويصبح فيه التصنيف الآلي للمشاعر أمرًا أساسيًا.
ولا يتعلق الأمر بالحجم فقط. منهجية BrandRanx الخاصة بـ X تمزج بين الحجم والتفاعل والمشاعر—وهذا يوضح أن تحليل المشاعر يكون أقوى عندما يقترن بإشارات أخرى، لا عندما يُستخدم وحده.
الخلاصة: إذا كان فريقك يتخذ قرارات بناءً على الرأي العام—سواء كان ذلك متعلقًا بالمنتج أو العلامة التجارية أو الحملة أو الأزمة—فإن تحليل المشاعر لبيانات X يعد واحدًا من أسرع حلقات التغذية الراجعة المتاحة.
واقع X API في 2026: كيف تحصل فعليًا على بيانات التغريدات؟
هنا تنهار معظم الشروحات. إذا كنت قد اتبعت يومًا دليلًا يعتمد على Tweepy، وألصقت الكود، ثم اصطدمت بحاجز دفع أو رسالة خطأ غامضة، فأنت لست وحدك. لقد اختفت مستويات الاشتراك القديمة Free / Basic / Pro. أصبح X API الآن بنظام الدفع حسب الاستخدام مع أرصدة مسبقة الدفع، مع تكلفة لكل نقطة نهاية، وتتبع فعلي للاستخدام في الوقت الحقيقي.
مقارنة صادقة لكل طرق جمع البيانات المتاحة حاليًا:
| الطريقة | التكلفة (2026) | الحجم | مستوى المهارة | ملاحظات |
|---|---|---|---|---|
| X API v2 (الدفع حسب الاستخدام) | 0.005 دولار/قراءة منشور | حتى 2 مليون قراءة منشور/شهر (خدمة ذاتية) | متوسط (Python) | رسمي، قابل لإعادة الإنتاج، ومتوافق |
| البحث في الأرشيف الكامل | 0.005 دولار لكل منشور مُعاد؛ 0.010 دولار لكل طلب عدّ في الأرشيف الكامل | حتى مارس 2006 | متوسط–متقدم | متاح للدفع حسب الاستخدام وللخطط المؤسسية |
| البث المفلتر | تُحسب قراءات المنشور عند التسليم | فوري ومتصّل | متوسط–متقدم | الأفضل للجمع المباشر |
| مجموعات بيانات جاهزة (Kaggle, Sentiment140) | 0 دولار | ثابتة وتاريخية فقط | مبتدئ | ممتازة للتعلّم، وليست للتحليل المباشر |
| snscrape وTwint وTwikit وغيرها | 0 دولار | غير موثوقة / تتعطل كثيرًا | متقدم | snscrape لم يعد يعمل مع بحث X منذ 2023؛ Twint مؤرشف؛ Twikit يستخدم طرقًا غير رسمية |
| أرشيف X الخاص بك | 0 دولار | منشوراتك فقط | مبتدئ | مفيد للتحليل الشخصي |
هناك بعض الأمور التي يجب معرفتها:
- اختفت مستويات Free/Basic/Pro القديمة. لا تعتمد على أي دليل يذكرها على أنها الحالية.
- snscrape لم يعد مناسبًا لـ X. أكد المطوّر في 2024 أن استخراج نتائج بحث Twitter لم يعد يعمل. Twint مؤرشف. Twikit يستخدم استخراجًا غير رسمي وملفات تعريف ارتباط—والنشاط لا يعني الإذن.
- شروط X تحظر استخراج البيانات عبر المتصفح دون موافقة خطية مسبقة. وهذا يعني أن Selenium وPlaywright وملحقات المتصفح ليست بدائل متوافقة للوصول إلى API على X.
X API v2: ماذا تحصل عليه فعليًا
تكلفة قراءة منشور قياسي هي 0.005 دولار لكل منشور مُعاد. وقراءات المستخدم تكلف 0.010 دولار لكل منها. لذا فإن 10,000 قراءة منشور فريدة تكلف حوالي 50 دولارًا قبل أي تكاليف أخرى. والحد الذاتي هو 2 مليون قراءة منشور شهريًا. وقد تتغير الأسعار—تحقق دائمًا من Developer Console.
ولأعمال تحليل المشاعر، ستحتاج إلى أكثر من مجرد id وtext. ويشمل المخطط الأدنى المفيد created_at وlang وauthor_id وconversation_id وreferenced_tweets وentities وcontext_annotations وpublic_metrics. احفظ الاستجابة الخام وسجلًا ثابتًا لطلبك والنقطة النهائية وفترة UTC ورموز الترحيل. من دون ذلك، لن تكون مجموعتك قابلة لإعادة الإنتاج.
هناك تفصيلة أخرى: ترحيل 4 مايو 2026 لفهرس البحث غيّر المجموعة المرصودة. لم يعد بحث REST بالكلمات المفتاحية يعرض إعادة النشر، بينما ظل Filtered Stream كما هو. إذا كنت تقارن نتائج ما قبل هذا التاريخ وما بعده، فقد تكون تعدّ مجموعات سكانية مختلفة.
مجموعات البيانات الجاهزة: جيدة للتعلم، وليست للتحليل المباشر
Sentiment140 (1.6 مليون تغريدة، جرى وسمها باستخدام الإشراف البعيد) ومجموعات Kaggle المختلفة مجانية وممتازة للتعلّم والقياس المرجعي. لكن Sentiment140 جُمعت في 2009. أما قسم المشاعر في TweetEval فيستخدم بيانات SemEval من 2013–2016. وهذه لا يمكنها إثبات أن نموذجك يعمل على لغة 2026 أو عاميتها أو أحداثها.
ملاحظة حول Thunderbit وبيانات X
أريد أن أكون صريحًا هنا، لأننا بنينا Thunderbit: Thunderbit هو أداة ذكاء اصطناعي لاستخراج البيانات وأتمتة الويب تعمل على العديد من المواقع المتوافقة. لكن شروط X الحالية تمنع استخراج البيانات عبر المتصفح دون موافقة. لذلك لن أقدمه كطريقة لتجاوز تكلفة X API أو ضوابط الوصول—فهذا سيكون مضللًا. بالنسبة لبيانات X، استخدم الـ API الرسمي أو مزودًا معتمدًا أو أرشيف حسابك الخاص. أما المكان الذي يناسب فيه Thunderbit ضمن سير عمل تحليل المشاعر فهو في المراحل اللاحقة: تنظيم البيانات التي جمعتها بالفعل عبر مسار مسموح، ووضع تسميات لها، وتصديرها. وسأشرح ذلك لاحقًا.
اختيار نموذج المشاعر المناسب: VADER أم TextBlob أم RoBERTa؟
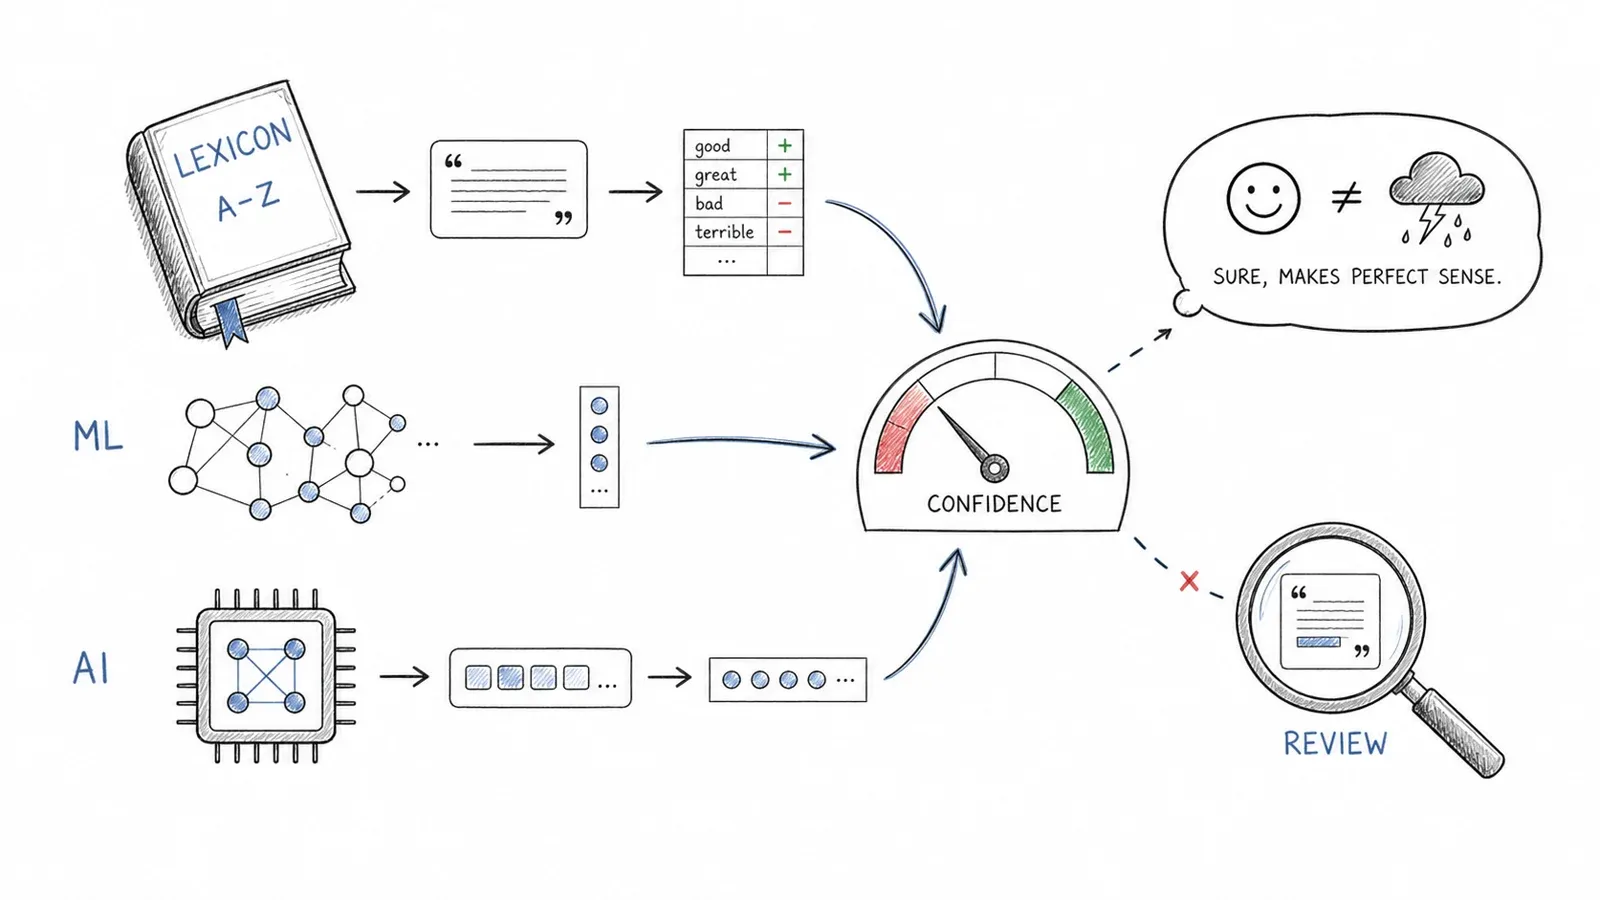
اختيار النموذج أهم مما تذكره معظم الشروحات. والفجوة الأكبر في الأدلة المنافسة هي أن معظمها لا يغطي النماذج المعتمدة على المحولات والمدرّبة بدقة على التغريدات—وهنا توجد بعض أقوى الأسس العملية الآن.
فيما يلي مقارنة مباشرة. لن أضع أرقام F1 عالمية في هذا الجدول عمدًا، لأن النتائج تختلف حسب المجموعة والتقسيم وتعريف الوسم والفترة الزمنية والمقياس. بدلًا من ذلك، سأصف الأداء النسبي وأشير إلى المراجع التي يمكنك من خلالها التحقق.
| النموذج / المكتبة | النهج | هل يتعامل مع السخرية؟ | هل يتعامل مع العامية/الرموز التعبيرية؟ | الدقة النسبية على التغريدات | تعقيد الإعداد |
|---|---|---|---|---|---|
| VADER (NLTK) | قاموس قائم على القواعد | ضعيف | دعم جزئي للرموز التعبيرية | الأدنى | منخفض جدًا |
| TextBlob | قائم على الأنماط | ضعيف | لا | أقل | منخفض جدًا |
| Naive Bayes / Logistic Regression (TF-IDF) | تعلم آلي كلاسيكي | لا | لا | متوسط | متوسط |
| CardiffNLP RoBERTa | محول (مضبوط على التغريدات) | أفضل (ليس مثاليًا) | نعم | الأعلى بين هذه الخيارات | متوسط (HuggingFace pipeline) |
VADER: سريع وبسيط، لكنه محدود
VADER هو أسلوب يعتمد على قاموس وقواعد صُمم للنصوص الاجتماعية. إنه سريع، وسهل التفسير، ولا يحتاج إلى بيانات تدريب، ويتعامل مع بعض الرموز التعبيرية والوجوه النصية. كما يأخذ في الحسبان النفي، والمعدلات الدلالية، وعلامات الترقيم، وحروف العظمة. إذا كنت تريد خط أساس سريعًا أو كنت تهتم بالوضوح وقلة الموارد الحاسوبية، فـ VADER مفيد. لكنه يضعف أمام السخرية، واللغة العامية، والمعنى المعتمد على السياق، وأي شيء يحتاج فهمًا يتجاوز الكلمات الفردية. وحدود الدرجة المركبة الافتراضية فيه (≥0.05 = إيجابي، ≤-0.05 = سلبي) هي إعدادات افتراضية وليست حدودًا تجارية عامة—لذا اضبطها على مجموعة التحقق الخاصة بك.
TextBlob: أبسط، لكنه أكثر محدودية
TextBlob هو خط أساس تعليمي صغير. محلله الافتراضي PatternAnalyzer لم يُدرّب على نصوص شبيهة بالتغريدات. وهو مفيد لأول تجربة في NLP، لكنه ليس مناسبًا لتحليل التغريدات في بيئة إنتاج.
التعلم الآلي الكلاسيكي: Naive Bayes وLogistic Regression وSVM
يبقى خط أنابيب TF-IDF للكلمات والأحرف مع logistic regression أو LinearSVC أساسًا قويًا للتعلم الخاضع للإشراف. فهو رخيص، وسهل التفسير، وغالبًا ما يكشف ما إذا كان المحول يضيف قيمة كافية لتبرير تعقيده. والقاعدة الأساسية: درّب المتجه فقط بعد تقسيم التدريب/التحقق لتجنب تسرب المفردات وIDF.
تتفوق هذه النماذج على الأساليب القائمة على القواعد في مجموعات البيانات المعلّمة الكبيرة، لكنها ما تزال تفوّت السياق والسخرية واللغة العامية.
CardiffNLP RoBERTa: معيار 2026 لمشاعر التغريدات
cardiffnlp/twitter-roberta-base-sentiment-latest هو نموذج ثلاثي الفئات تتم صيانته باستمرار وموجّه للتغريدات، ويُعد خط أساس قويًا وواقعيًا لعام 2026. لقد جرى تدريبه مسبقًا على corpus كبير من التغريدات ثم ضبطه بدقة للمشاعر، لذلك يتعامل مع الرموز التعبيرية واللغة العامية واللغة غير الرسمية أفضل بكثير من النهج القائمة على القواعد أو التعلم الآلي الكلاسيكي.
إليك مقطع HuggingFace بسيط لتشغيله:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)
scores = classifier("@user Love waiting three hours for support 😒 http")
print(scores)
بعض الملاحظات:
- الناتج هو درجة من النموذج، وليس احتمالًا تجاريًا مضبوطًا. اضبطه أو أضف عتبة امتناع على عينة موسومة حديثًا.
- النماذج السياقية عادةً تتفوق على الأنظمة القائمة على القواعد في كثير من مهام التغريدات، لكن السخرية وتعدد الأهداف داخل المنشور وسياق السلسلة المفقود واللهجات واللغة المرمّزة تبقى مصادر خطأ بنيوية. لا تعد بأن أي نموذج "يفهم السخرية"—الأدق أن تقول إنه يتعامل معها أفضل، لا بشكل مثالي.
- تشمل البدائل BERTweet وTimeLMs ونماذج Twitter-XLM-R متعددة اللغات، حسب اللغة والمهمة.
فهل يمكن أن يكون تحليل مشاعر Twitter دقيقًا بالفعل؟ نعم—عندما يتوافق النموذج والمعالجة المسبقة وتعريف الوسم وعينة التقييم كلها مع المهمة. أما سكربت VADER عام من درس 2019 فهو خط أساس، وليس دليلًا على جودة الإنتاج.
خط معالجة حقيقي لتغريدات Twitter (وليس مجرد text.lower())
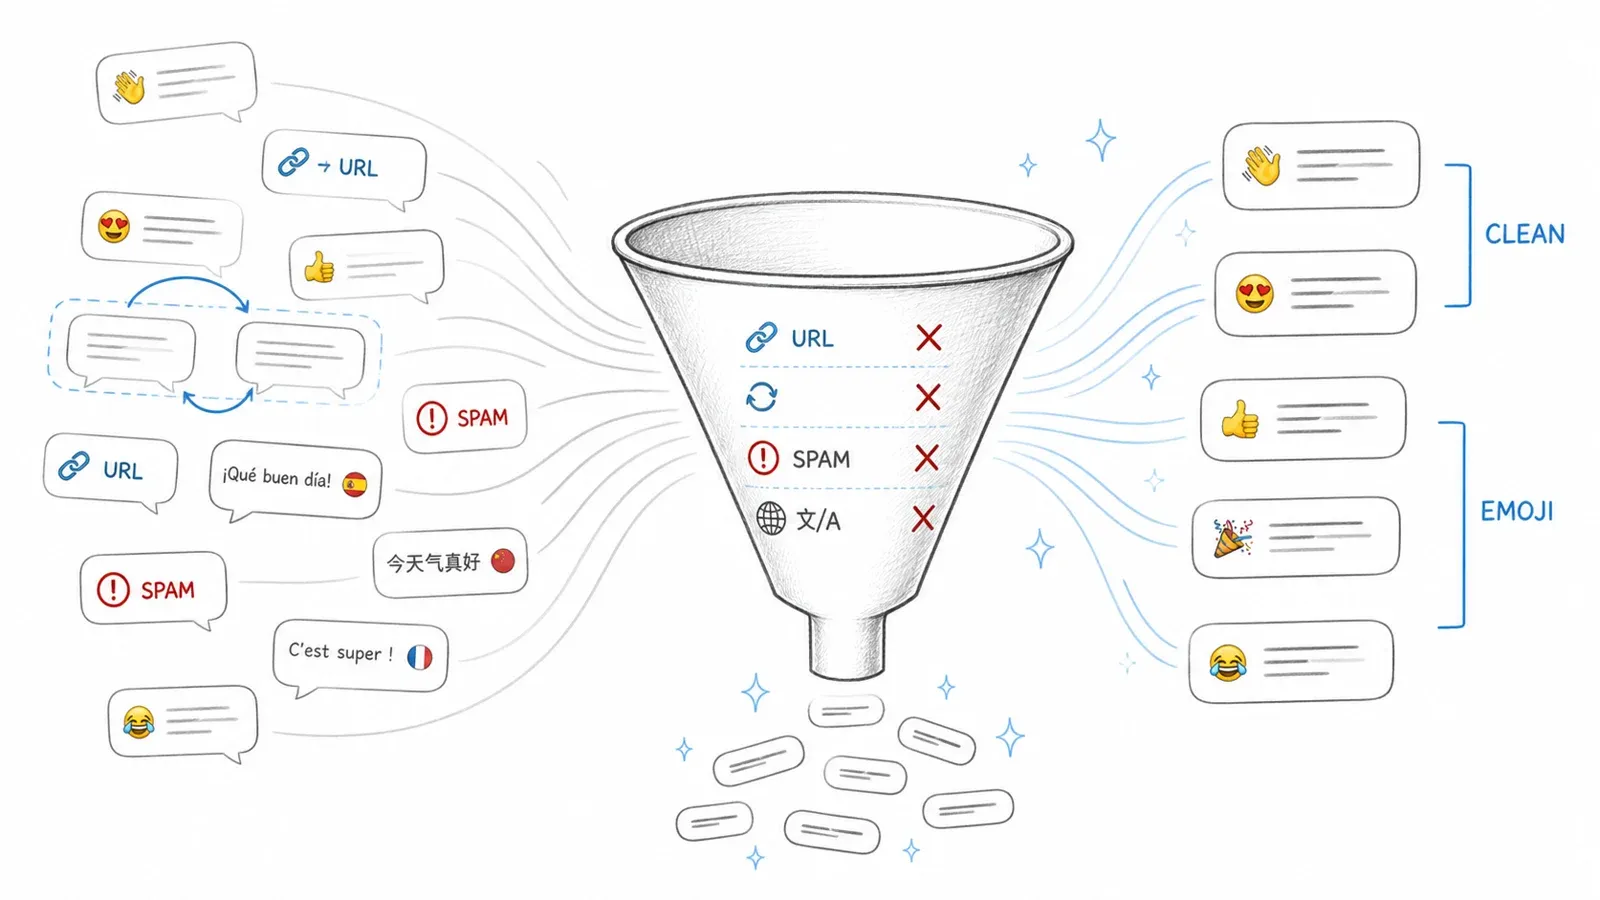
إذا أرسلت إلى نموذج المشاعر روابط خامًا و@mentions وكيانات HTML، حتى النموذج الجيد قد يعطيك نتائج ضعيفة. معظم الشروحات (بما فيها الأعلى ترتيبًا) لا تفعل سوى تحويل النص إلى أحرف صغيرة قبل إدخاله إلى النموذج. وهذا ينسف الدقة بصمت—خصوصًا في التعلم الآلي الكلاسيكي، حيث قد تكون جودة المعالجة المسبقة بنفس أهمية اختيار النموذج.
ماذا تنظّف؟ ولماذا يهم ذلك؟
| العنصر | ما الذي يجب فعله | لماذا |
|---|---|---|
| الروابط | استبدلها بعلامة مكان مثل http | الروابط ضوضاء بالنسبة للمشاعر؛ أما حذف النص المحيط فقد يكسّر السياق |
| @mentions | استبدل المقابض بـ @user | يحافظ على البنية ويزيل تسرب هوية الكاتب |
| الرموز التعبيرية/الوجوه النصية | احتفظ بها مع المحللات الحديثة؛ واختبر النص المحوّل إلى وصف نصي للنماذج النادرة | الرموز التعبيرية تحمل إشارة مشاعر قوية—وحذفها يعني رمي البيانات |
| الوسوم | احتفظ بالوسم؛ ويمكنك إضافة نسخة مفصولة (مثل #ClimateChangeIsReal → Climate Change Is Real) | غالبًا ما تتضمن الوسوم الرأي نفسه |
| النفي | احتفظ بـ not وno وnever والاختصارات وكلمات التباين | قوائم الكلمات الشائعة غالبًا تحذفها، فتقلب المعنى |
| الأحرف الكبيرة/الترقيم | احتفظ بها لـ VADER والنماذج المتوافقة | يستخدم VADER الأحرف الكبيرة والترقيم كميزات |
| بادئة RT | احذف علامة RT | هذه بيانات وصفية وليست مشاعر |
| إعادة النشر/النسخ المكررة | اكتشف النسخ المطابقة والقريبة قبل التقسيم | التكرارات بين التدريب والاختبار تسبب تسربًا |
قبل وبعد: ماذا تفعل المعالجة المسبقة فعلًا بالتغريدة
إليك مثالًا واضحًا:
| المرحلة | النص |
|---|---|
| التغريدة الخام | RT @BrandX: Wow, #CustomerServiceFail 😡😡 https://t.co/abc123 I've been waiting 3 hrs ngl this is awful |
| بعد إزالة الرابط | RT @BrandX: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| بعد توحيد الإشارة | RT @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| بعد إزالة RT | @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| بعد تفكيك الوسم | @user: Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| بعد تحويل الرموز التعبيرية إلى نص (للنماذج النادرة) | @user: Wow, #CustomerServiceFail Customer Service Fail angry_face angry_face http I've been waiting 3 hrs ngl this is awful |
| النهائي (لـ CardiffNLP RoBERTa) | @user Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
لاحظ أنه مع محول مثل CardiffNLP RoBERTa، تُبقي الرموز التعبيرية وعلامات الترقيم والأحرف الكبيرة—لأن النموذج دُرّب على نص يشبه هذا. أما مع نموذج TF-IDF، فقد ترغب في تحويل الرموز إلى نص، وخفض الأحرف، وإرجاع الكلمات إلى أصلها.
كود Python جاهز للنسخ واللصق للمعالجة المسبقة
دالة نظيفة وواضحة ومتعددة الاستخدامات لمعالجة متوافقة مع النماذج المعتمدة على المحولات:
import html
import re
import unicodedata

URL_RE = re.compile(r"https?://\S+|www\.\S+", re.I)
MENTION_RE = re.compile(r"(?<!\w)@[A-Za-z0-9_]+")

def normalize_social_text(text: str) -> str:
    """توحيد نص التغريدة لاستخدامه مع نماذج المشاعر القائمة على المحولات."""
    text = html.unescape(text)
    text = unicodedata.normalize("NFC", text)
    text = URL_RE.sub("http", text)
    text = MENTION_RE.sub("@user", text)
    text = re.sub(r"\bRT\b", "", text)
    return " ".join(text.split())
أما في خطوط التعلم الآلي الكلاسيكي، فستوسّع هذه الدالة بإضافة خفض الأحرف، وتحويل الرموز التعبيرية إلى نص (باستخدام مكتبة emoji أو demoji)، وتفكيك الوسوم (باستخدام wordninja أو ekphrasis)، وتوحيد العامية، وإزالة الكلمات الشائعة، وإرجاع الكلمات إلى جذورها (عبر spaCy أو NLTK). والمبدأ الأساسي هنا: طابق المعالجة المسبقة مع النموذج. فمثلًا، BERTweet يستخدم اتفاقية تطبيع موثقة خاصة به—لا تُجبر كل نموذج على المرور من خط أنابيب واحد.
خطوة بخطوة: تحليل مشاعر Twitter باستخدام Python
هذا هو سير العمل الكامل الذي يربط كل ما سبق. يمكنك اتباعه من البداية إلى النهاية.
قبل أن تبدأ:
- مستوى الصعوبة: متوسط (يفترض وجود معرفة بسيطة بـ Python)
- الوقت المطلوب: حوالي 30–60 دقيقة للسير الكامل؛ وحوالي 10 دقائق لمسار المحول السريع
- ما ستحتاجه: Python 3.8+، وبيئة Google Colab مجانية أو بيئة محلية، و
pandasوtransformersوscikit-learnوmatplotlibوseaborn، واختياريًاwordcloud
الخطوة 1: جمع بيانات التغريدات
سأستخدم مجموعة بيانات Sentiment140 في هذا الدرس (مجانية، 1.6 مليون تغريدة، ومتاحة على Kaggle). وهي ممتازة للتعلّم والقياس المرجعي، رغم أنها تاريخية.
إذا كنت تريد بيانات مباشرة، فاستخدم X API v2 بنظام الدفع حسب الاستخدام. وتكلفة قراءة منشور قياسي هي 0.005 دولار. و10,000 منشور تعني حوالي 50 دولارًا.
تحميل البيانات:
import pandas as pd

columns = ["target", "id", "date", "flag", "user", "text"]
df = pd.read_csv(
    "training.1600000.processed.noemoticon.csv",
    encoding="latin-1",
    names=columns,
)
# التصنيفات: يستخدم Sentiment140 القيمة 0 = سلبي، 4 = إيجابي
df["label"] = df["target"].map({0: "negative", 4: "positive"})
print(df[["text", "label"]].head())
يجب أن ترى DataFrame يحتوي على نص التغريدة الخام وعمودًا للتصنيف.
الخطوة 2: تنظيف التغريدات ومعالجتها مسبقًا
طبّق دالة المعالجة المسبقة من القسم السابق:
df["clean_text"] = df["text"].apply(normalize_social_text)
print(df[["text", "clean_text"]].head())
افحص بعض الصفوف للتأكد من استبدال الروابط، وتوحيد الإشارات، وإزالة بادئات RT.
الخطوة 3: اختر النموذج وصنّف المشاعر
المسار A: تعلم آلي كلاسيكي باستخدام TF-IDF + Logistic Regression
هذا هو مسار "فهم الأساسيات". قسّم بياناتك، ودرب المتجه على مجموعة التدريب فقط، ثم درّب مصنف Logistic Regression:
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X_train, X_test, y_train, y_test = train_test_split(
    df["clean_text"], df["label"], test_size=0.2, random_state=42
)
vectorizer = TfidfVectorizer(max_features=50000, ngram_range=(1, 2))
X_train_tfidf = vectorizer.fit_transform(X_train)
X_test_tfidf = vectorizer.transform(X_test)

clf = LogisticRegression(max_iter=1000)
clf.fit(X_train_tfidf, y_train)
y_pred = clf.predict(X_test_tfidf)
print(classification_report(y_test, y_pred))
سترى تقرير تصنيف يتضمن precision وrecall وF1 لكل فئة. على Sentiment140، يؤدي Logistic Regression مع TF-IDF أداءً محترمًا عادةً—لكن تذكّر أن هذه المجموعة تعود إلى 2009 وتعتمد على الإشراف البعيد (الوجوه النصية كوسوم)، لذا لا تتعامل مع هذه الأرقام كمعيار إنتاجي.
المسار B: CardiffNLP RoBERTa عبر HuggingFace
للحصول على أفضل دقة على نصوص التغريدات، استخدم المحول المدرّب مسبقًا:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)

sample_tweets = [
    "@user Love waiting three hours for support 😒 http",
    "@user This new update is absolutely fantastic, best one yet!",
    "@user The event was okay, nothing special.",
]
for tweet in sample_tweets:
    result = classifier(tweet)
    print(f"Tweet: {tweet}\nScores: {result}\n")
سترى قائمة بدرجات الفئات (سلبي، محايد، إيجابي) لكل تغريدة. يجب أن تحصل التغريدة الساخرة ("Love waiting three hours...") على درجة سلبية أعلى مما يتوقعه نموذج قائم على القواعد—مع أن أي نموذج ليس مثاليًا هنا.
الخطوة 4: قيّم نتائجك
الآن أنشئ خريطة حرارية لمصفوفة الالتباس لمسار التعلم الآلي الكلاسيكي:
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred, labels=["negative", "positive"])
sns.heatmap(cm, annot=True, fmt="d", xticklabels=["negative", "positive"],
            yticklabels=["negative", "positive"], cmap="Blues")
plt.xlabel("Predicted")
plt.ylabel("Actual")
plt.title("Confusion Matrix: Logistic Regression on Sentiment140")
plt.show()
في مسار المحول، وسم عينة صغيرة حديثة يدويًا (50–100 تغريدة)، وشغّل النموذج، ثم قارن. اعرض macro F1، والدقة والاستدعاء لكل فئة، ومصفوفة الالتباس. وإذا كان هذا لمشروع حقيقي، فتحقق أيضًا من المعايرة وحدد عتبة امتناع للحالات الملتبسة.
الخطوة 5: اختبر الحالات الحدّية
جرّب بعض التغريدات التي تختبر السخرية والرموز التعبيرية واللغة العامية:
edge_cases = [
    "Oh great, another update that breaks everything 🙄",
    "ngl this product slaps 🔥🔥🔥",
    "The camera is amazing but the battery life is trash",
    "Just got my order. It's... fine. I guess.",
]
for tweet in edge_cases:
    clean = normalize_social_text(tweet)
    result = classifier(clean)
    print(f"Tweet: {tweet}\nScores: {result}\n")
انظر أين يصيب النموذج وأين يتعثر. التغريدات متعددة الأهداف ("الكاميرا رائعة لكن البطارية سيئة") تمثل تحديًا معروفًا—والتحليل على مستوى الجانب هو مهمة منفصلة.
تحليل مشاعر Twitter بدون كتابة كود
ليس كل شخص يريد كتابة Python، وهذا طبيعي. إذا كنت مسوقًا أو مدير علامة تجارية أو قائد عمليات وتحتاج إلى رؤى مشاعر دون لمس الكود، فإليك المسار المناسب.
لكن هناك ملاحظة صريحة: أدوات no-code تتبادل التخصيص مقابل السرعة. وهي مثالية لمراقبة العلامة التجارية بسرعة، وليست مناسبة لتحليل بمستوى بحثي أو لتدريب نماذج مخصصة.
خيارات No-Code باختصار
| الأداة | الأفضل لـ | هل تحتوي على تحليل مشاعر مدمج؟ | نطاق السعر |
|---|---|---|---|
| AWS Comprehend | تحليل نصوص على مستوى المؤسسات | نعم | الدفع حسب الاستخدام |
| Brandwatch / Sprinklr | حزمة استماع اجتماعي كاملة | نعم | تسعير مؤسسي |
| Google Sheets + إضافات NLP | تحليل خفيف وسريع | عبر إضافة | مجاني–منخفض |
| Thunderbit + جدول بيانات | تنظيم البيانات ووضع تسميات عليها من الصفحات المتوافقة | AI Field Prompt لتسميات استكشافية | تتوفر خطة مجانية |
سير عمل No-Code: اجمع البيانات ثم صنّفها في جدول بيانات
سير عمل عملي لمن لديه بيانات تغريدات (تم جمعها عبر X API الرسمي أو مزود معتمد أو أرشيفه الخاص):
- صدّر بيانات التغريدات إلى جدول بيانات. إذا استخدمت X API، فصدّر JSON إلى CSV أو استخدم أداة مثل Thunderbit لتنظيم البيانات وتصديرها من الصفحات المتوافقة التي لديك إذن بأتمتتها.
- افتحها في Google Sheets. الصق نص التغريدات أو استورده في عمود.
- طبّق مصنف مشاعر. استخدم إضافة NLP لـ Google Sheets (تحقق من متجر الإضافات لمعرفة الخيارات الحالية) أو خدمة مثل AWS Comprehend. بعض الإضافات تسمح بتصنيف المشاعر مباشرة داخل صيغة خلية.
- راجع النتائج وصوّرها. استخدم أدوات الرسم المدمجة في Google Sheets لإنشاء مخطط أعمدة لتوزيع المشاعر أو مخطط خطي لتغير المشاعر مع الزمن.
يمكن لـ Thunderbit أيضًا إضافة وسم مشاعر قائم على prompt أثناء الاستخراج على الصفحات المتوافقة—وهو مفيد للمراقبة الاستكشافية. لكن في القرارات المدققة أو عالية المخاطر، تحقق من عينة واستخدم نموذجًا موثقًا.
متى تستخدم No-Code ومتى تستخدم Python؟
| السيناريو | المسار الموصى به |
|---|---|
| فحص سريع للعلامة التجارية، حجم صغير | No-code (جدول بيانات + إضافة) |
| لوحة فريق، تقرير أسبوعي | No-code أو Low-code |
| تحليل واسع النطاق، نماذج مخصصة | Python |
| بحث أكاديمي، قابلية إعادة الإنتاج | Python |
| مراقبة لحظية على نطاق واسع | Python + API + مسار مجدول |
تصور نتائج مشاعر Twitter
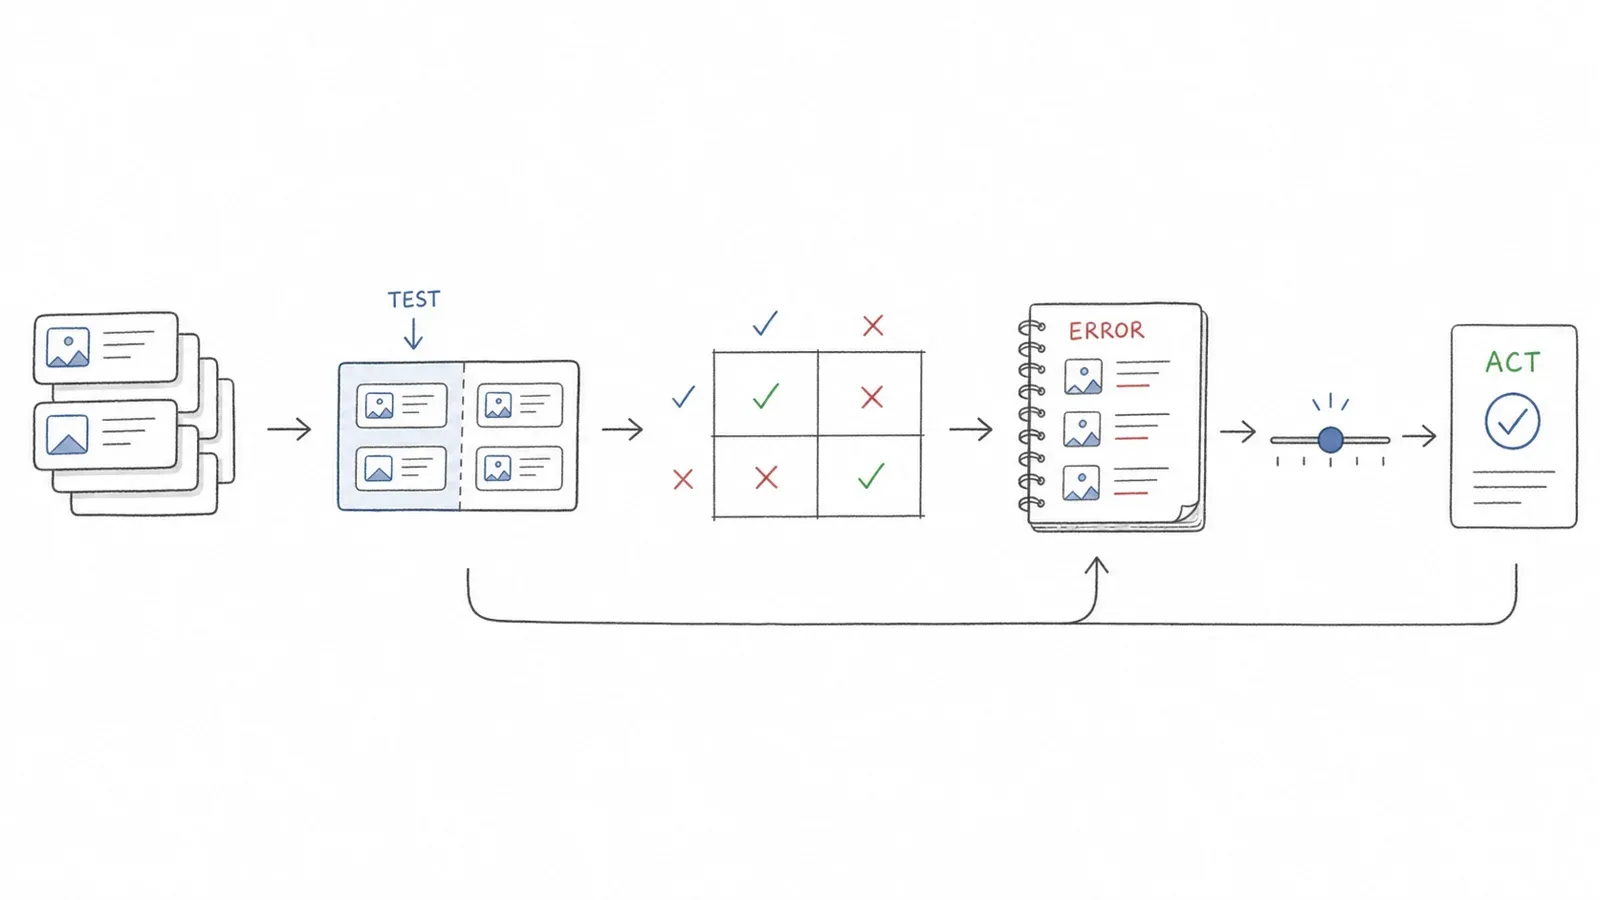
تتوقف معظم الشروحات عند تقرير التصنيف. لكن إذا أردت إيصال النتائج إلى فريق أو اتخاذ قرار، فأنت بحاجة إلى مرئيات.
مخطط أعمدة لتوزيع المشاعر
أبسط مخرج لكنه الأكثر فائدة على نطاق واسع:
import matplotlib.pyplot as plt
import seaborn as sns

sentiment_counts = df["label"].value_counts()
sns.barplot(x=sentiment_counts.index, y=sentiment_counts.values, palette="coolwarm")
plt.xlabel("Sentiment")
plt.ylabel("Tweet Count")
plt.title("Sentiment Distribution")
plt.show()
سحابة كلمات حسب فئة المشاعر
سحابة كلمات منفصلة للتغريدات الإيجابية والسلبية تكشف ما الذي يقوله الناس فعليًا:
from wordcloud import WordCloud

for sentiment in ["positive", "negative"]:
    text = " ".join(df[df["label"] == sentiment]["clean_text"])
    wc = WordCloud(width=800, height=400, background_color="white").generate(text)
    plt.figure(figsize=(10, 5))
    plt.imshow(wc, interpolation="bilinear")
    plt.axis("off")
    plt.title(f"Word Cloud: {sentiment.capitalize()} Tweets")
    plt.show()
المشاعر عبر الزمن: الرسم الذي لا يريك إياه أحد غيرك
هذا هو التصور الذي يحوّل البيانات الخام إلى قصة. إذا كانت لديك طوابع زمنية، يمكنك تتبع كيف تتغير المشاعر أثناء حدث أو إطلاق أو أزمة:
df["date"] = pd.to_datetime(df["date"])
df["day"] = df["date"].dt.date
sentiment_map = {"positive": 1, "neutral": 0, "negative": -1}
df["score"] = df["label"].map(sentiment_map)
daily = df.groupby("day")["score"].mean()

plt.figure(figsize=(12, 5))
daily.plot()
plt.xlabel("Date")
plt.ylabel("Average Sentiment Score")
plt.title("Sentiment Over Time")
plt.axhline(0, color="gray", linestyle="--")
plt.show()
هبوط مفاجئ يوم الإطلاق؟ هذه هي الإشارة التي تدفعك للتعمق في التغريدات السلبية ومعرفة ما الذي حدث.
خريطة حرارية لمصفوفة الالتباس
تم عرضها بالفعل في خطوة التقييم أعلاه. النقطة الأساسية: انظر إلى الأماكن التي يخلط فيها النموذج بين الإيجابي والسلبي (أو العكس). هذه هي التغريدات التي تستحق القراءة اليدوية.
لغير المبرمجين: الرسم في Google Sheets أو Notion
إذا كنت قد صدّرت بياناتك الموسومة بالمشاعر إلى جدول بيانات، فيمكنك رسم توزيع المشاعر والاتجاهات مباشرة في Google Sheets أو Notion أو أي أداة BI. لا حاجة إلى Python.
الأخطاء الشائعة في تحليل مشاعر Twitter وكيف تتجنبها
في سير العمل الواقعي لتحليل المشاعر، تتكرر الأخطاء نفسها باستمرار.
السخرية والتهكم
أكبر عدو للدقة. "Love waiting three hours for support 😒" يبدو إيجابيًا للنظام القائم على القواعد. النماذج المعتمدة على المحولات أفضل، لكن السخرية لا تزال صعبة بنيويًا—خصوصًا عندما يفتقد المنشور للسياق (السلسلة، تاريخ الكاتب، الحدث). لحالات الاستخدام الحساسة، اجمع بين مخرجات النموذج وفحوصات بشرية عشوائية.
نقاط العمى في الرموز التعبيرية واللغة العامية
إذا كانت المعالجة المسبقة لديك تحذف الرموز التعبيرية بدلًا من تحويلها إلى نص (للنماذج النادرة) أو الاحتفاظ بها (للمحولات)، فأنت تتخلى عن بعض أقوى إشارات المشاعر في البيانات. والأمر نفسه بالنسبة للعامية—"ngl this slaps" إيجابي، لكن نموذجًا درّب على الإنجليزية الرسمية لن يعرف ذلك.
شروحات API قديمة وكاشطات معطلة
إذا كان الدليل يستخدم Tweepy مع API v1.1، فهو قديم. وإذا أوصى بـ snscrape، فهذا لم يعد يعمل مع بحث X منذ 2023. تحقق دائمًا من تاريخ الدليل وإصدار الـ API.
فرط التكيّف مع مجموعة بيانات واحدة
Sentiment140 ممتازة للتدريب، لكنها تعود إلى 2009. أظهر تدقيق EMNLP 2024 في 20 مجموعة بيانات لوسائل التواصل الاجتماعي أن إزالة التكرارات خفّضت F1 في 14 من أصل 19 مجموعة مختبرة، وغيّرت ترتيب النماذج في 17 من أصل 19. استخدم تقسيمات زمنية، ومفصولة بالأحداث، ويفضل أن تكون مفصولة بالمؤلفين. واختبر نموذجك على تغريدات حديثة لترى إن كان يعمم.
التعامل مع درجات المشاعر على أنها الحقيقة المطلقة
درجة النموذج ليست احتمالًا مضبوطًا. لا تُفعّل استجابات آلية أو قرارات مواجهة للجمهور اعتمادًا على وسم مشاعر فقط. يجب دائمًا أن تكون هناك مراجعة بشرية للقرارات التي تؤثر في الأفراد أو في الاستجابة للأزمات.
الخصوصية وسياسات المنصة والاستخدام المسؤول
هذا القسم ليس اختياريًا.
تؤكد سياسة المطور الخاصة بـ X على الخصوصية، وتحكم المستخدم، وحذف المحتوى، والقيود على المطابقة خارج X. والقواعد العملية هي:
- اجمع فقط الحقول الضرورية.
- جمّع النتائج بدلًا من نشر المقابض الخام.
- احتفظ بمعرّفات المنشورات وأوقات الاسترجاع للامتثال.
- أزل أو حدّث المحتوى المخزن بعد الحذف أو تغيّر الحماية أو عند وجود طلبات مؤهلة.
- لا تستنتج سمات حساسة عن الأفراد.
- لا تربط درجات المشاعر بهويات CRM دون أساس وإذن مسموح بهما.
- لا تدرّب أو تضبط نموذجًا أساسيًا على محتوى X حيث يُحظر ذلك بموجب قواعد الاستخدام المقيد.
- وثّق حجم العينة، وعبارات الاستعلام، والإطار الزمني، ومرشحات اللغة، والاستثناءات.
- لا تُؤتمت ردًا عامًا اعتمادًا فقط على درجة مشاعر.
تحليل المشاعر أداة قوية، لكنه يأتي مع مسؤوليات حقيقية. تعامل معه على هذا الأساس.
الخلاصة وأهم النقاط
تحليل مشاعر Twitter يعمل في 2026—لكن فقط إذا حدّثت نهجك ليتناسب مع الواقع الحالي. الوصفة القديمة (API مجاني، معالجة مسبقة قائمة فقط على خفض الأحرف، VADER أو Naive Bayes، بلا تقييم) لم تعد صالحة. ما الذي يعمل فعلًا:
- احصل على بياناتك عبر مسار مسموح. استخدم X API v2 (الدفع حسب الاستخدام)، أو مزودًا معتمدًا، أو مجموعة بيانات شفافة. لا تعتمد على كاشطات معطلة أو حلول التفاف عبر المتصفح.
- عالج البيانات بما يناسب النموذج، لا للعرض فقط. احتفظ بالرموز التعبيرية والنفي والأحرف الكبيرة مع المحولات. وطبّع الروابط والإشارات. طابق خط الأنابيب مع بيانات تدريب النموذج.
- قارن خط أساس منخفض التكلفة مع محول مخصص للتغريدات. يبقى TF-IDF + logistic regression فحصًا ممتازًا للسلامة. أما CardiffNLP RoBERTa فهو الخيار القوي الافتراضي حاليًا لمشاعر التغريدات.
- قيّم بصدق. اعرض macro F1 ومقاييس كل فئة ومصفوفة الالتباس. استخدم عينة حديثة موسومة يدويًا. ضع عتبة امتناع للحالات الملتبسة.
- صوّر من أجل القرار، لا من أجل الزينة فقط. رسوم المشاعر عبر الزمن وسحابات الكلمات تحكي قصة لا يستطيع تقرير التصنيف سردها.
- أبقِ البشر في الحلقة. لا يوجد نموذج مثالي في السخرية أو تعدد الأهداف أو المعنى المعتمد على السياق. لحالات الاستخدام الحساسة، اجمع بين مخرجات النموذج والمراجعة البشرية.
إذا كنت بدأت للتو، فاحصل على مجموعة بيانات مجانية، وافتح Google Colab، وشغّل HuggingFace pipeline. ستحصل على درجات مشاعر تعمل خلال أقل من عشر دقائق. وإذا كنت تريد جمع بيانات الويب وتنظيمها بدون كود لأجزاء أخرى من سير عملك، فيمكن لـ Thunderbit المساعدة على الصفحات المتوافقة التي لديك إذن بأتمتتها.
وإذا كنت تبني هذا لمعرض أعمال أو لمقابلة وظيفية: فإن إضافة مقارنة بين محول ونموذج آخر، وخط معالجة مسبقة حقيقي، ومخطط للمشاعر عبر الزمن سيجعل مشروعك يبرز فورًا عن النسخة المعتادة في معسكرات التدريب.
اعرف المزيد
- How to Master Automated Data Scraping Using Thunderbit
- 6 Best Twitter (x.com) Scrapers in 2026
- How to Scrape Tweets from Twitter Using Python in 2025
- How to Use Twitter AI Scraping for Enhanced Data Insights
- Twitter (X) Statistics 2026: Users, Demographics & Ads
الأسئلة الشائعة
هل تحليل مشاعر Twitter دقيق؟
يعتمد ذلك على النموذج وكيفية التقييم. الأدوات القائمة على القواعد مثل VADER تؤدي أداءً منخفضًا نسبيًا على بيانات التغريدات. أما النماذج المعتمدة على المحولات مثل CardiffNLP RoBERTa فتؤدي أفضل بكثير—لكن الدرجات الدقيقة تختلف حسب المجموعة والتقسيم وتعريف الوسم والمقياس. كما أن جودة المعالجة المسبقة مهمة. قيّم دائمًا على عينة حديثة موسومة يدويًا بدلًا من الثقة في رقم واحد من benchmark.
هل يمكنني إجراء تحليل مشاعر Twitter مجانًا؟
نعم. استخدم مجموعة بيانات مجانية (Sentiment140 على Kaggle)، وبيئة Python مجانية (Google Colab)، ونموذج HuggingFace مدرب مسبقًا. أما البيانات المباشرة، فيفرض X API رسومًا قدرها 0.005 دولار لكل قراءة منشور، لذا فالجمع على نطاق صغير ميسور. وتوفّر Thunderbit خطة مجانية لتنظيم البيانات على الصفحات المتوافقة.
ما أفضل مكتبة Python لتحليل مشاعر Twitter؟
للبدء السريع: VADER عبر NLTK. ولأفضل دقة على التغريدات: مكتبة HuggingFace transformers مع نموذج CardiffNLP RoBERTa. ولأسس التعلم الآلي الكلاسيكي: scikit-learn مع TF-IDF. ويعتمد الاختيار الصحيح على حجم البيانات، واحتياجك للدقة، وميزانية الحوسبة.
كيف أتعامل مع السخرية في تحليل مشاعر Twitter؟
النماذج المعتمدة على المحولات تتعامل مع السخرية أفضل من النماذج القائمة على القواعد أو التعلم الآلي الكلاسيكي لأنها تعالج السياق، لا الكلمات الفردية فقط. لكن لا يوجد نموذج مثالي في السخرية—وتُظهر الأبحاث أن حتى المقيّمين البشريين يختلفون حول النية الساخرة. في حالات الاستخدام الحرجة، اجمع بين مخرجات النموذج والمراجعة البشرية، وفكر في استخدام مجموعات بيانات مخصصة للسخرية للتقييم.
هل يمكنني تحليل مشاعر Twitter بدون برمجة؟
نعم. اجمع بياناتك عبر مسار مسموح (X API أو مزود معتمد أو أرشيفك الخاص)، وصدّرها إلى Google Sheets، ثم طبّق مصنف مشاعر بدون كود عبر إضافة NLP للـ Sheets أو خدمة مثل AWS Comprehend. ويمكن لـ Thunderbit أيضًا إضافة تسميات مشاعر قائمة على prompt أثناء تنظيم البيانات على الصفحات المتوافقة. ولمزيد من المعلومات حول تدفقات العمل بدون كود، راجع دليلنا عن أدوات الذكاء الاصطناعي لـ Google Sheets.



