
تنمو شبكة الإنترنت اليوم بوتيرة أسرع من أي وقت مضى، وإذا كنت تعمل في مجال الأعمال أو التقنية، أو كنت مجرد مهووس بالبيانات مثلي، فلا بد أنك لاحظت الأمر: الذهب الحقيقي موجود في البيانات التي تستطيع جمعها، لا في البيانات التي تراها فقط. في هذه الأيام، تتسابق الشركات لأتمتة جمع بيانات الويب، ومن المتوقع أن يصل حجم سوق تجريف الويب عالميًا إلى 2 مليار دولار بحلول 2030. وإليك معلومة طريفة: أكثر من 65% من المؤسسات باتت تستخدم زواحف الويب أو أدوات التجريف لتغذية أنظمة الذكاء الاصطناعي والتحليلات وسير عمل الأعمال لديها.
إذًا، كيف تدخل أنت إلى هذا الميدان؟ بالنسبة لمعظم الناس، الإجابة هي Python. فهي اللغة المفضّلة لبناء زواحف المواقع: بسيطة، وقوية، ومليئة بالمكتبات التي تجعل الزحف والتجريف أمرًا في غاية السهولة. في هذا الدليل، سأشرح لك ما هو زاحف الموقع، ولماذا تُعد Python الخيار الأول، وكيف تبني زاحفك الخاص خطوة بخطوة، وكيف يمكن لأدوات مثل Thunderbit أن تجعل العملية كلها أسهل بكثير (خصوصًا إذا كنت تفضّل النقر على كتابة الأكواد). سواء كنت مطوّرًا، أو مسوّقًا يعتمد على البيانات، أو مجرد شخص يريد أتمتة المهام المملة، ستجد هنا ما ينقل تعاملك مع بيانات الويب إلى مستوى آخر.
ما هو زاحف الموقع؟ (ولماذا يجب أن يهمّك؟)
لنبسّط الأمر: زاحف الموقع هو برنامج يتصفّح الويب تلقائيًا، فيزور الصفحات، ويتتبّع الروابط، و(اختياريًا) يجمع البيانات في طريقه. تخيّله كمتصفّح ويب خارق: لا ينام أبدًا، ولا يشعر بالملل، ولا يغلق التبويب الخطأ عن طريق الخطأ. الزواحف هي العمود الفقري لمحركات البحث (مثل Googlebot)، لكن الشركات تستخدمها أيضًا في كل شيء، من مراقبة الأسعار إلى أبحاث السوق.
لكن مهلًا، ما الفرق بين الزحف والتجريف؟ الزحف يتعلق بـاكتشاف الصفحات والتنقّل بينها (مثل رسم خريطة لمدينة)، أما التجريف فيتعلق بـاستخراج بيانات محددة من تلك الصفحات (مثل جمع كل قوائم طعام المطاعم في المدينة). عمليًا، معظم المشاريع تفعل الاثنين معًا: تزحف للعثور على الصفحات، وتجرّف للحصول على البيانات التي تحتاجها (Baeldung).
استخدامات واقعية للزواحف في الأعمال:
- توليد العملاء المحتملين: جمع بيانات التواصل تلقائيًا من الأدلة أو وسائل التواصل الاجتماعي.
- مراقبة الأسعار: تتبّع أسعار المنافسين ومخزونهم عبر آلاف المنتجات.
- مراقبة المحتوى: تلقّي تنبيهات عند ذكر علامتك التجارية في الأخبار أو المدونات أو المنتديات.
- تدقيق السيو (SEO): فحص موقعك بحثًا عن الروابط المكسورة أو البيانات الوصفية الناقصة.
- أبحاث السوق: تجميع إعلانات العقارات أو الوظائف أو مراجعات المنتجات لتحليلها.
إذا سبق أن تمنّيت لو تستطيع استنساخ نفسك لمواكبة أبحاث الويب، فالزاحف هو أفضل بديل متاح.
لماذا تهمّ زواحف المواقع في أتمتة الأعمال
لنتحدث بشكل عملي. لماذا تستثمر الشركات في الزواحف وأدوات التجريف؟ لأن العائد على الاستثمار ضخم. إليك نظرة سريعة على كيفية استخدام الفرق المختلفة للزواحف، وما الذي تجنيه من ذلك:
| حالة الاستخدام | الفائدة الرئيسية | من يستخدمها |
|---|---|---|
| توليد العملاء المحتملين | أتمتة بناء قوائم العملاء المحتملين وتوفير ساعات من العمل | المبيعات، التوظيف |
| تتبّع الأسعار | رؤى فورية عن المنافسين وتسعير ديناميكي | التجارة الإلكترونية، فرق المنتج |
| مراقبة المحتوى | حماية العلامة التجارية ورصد الاتجاهات | التسويق، العلاقات العامة |
| تدقيق السيو للموقع | صحة الموقع وتحسين الترتيب | السيو، مديرو المواقع |
| أبحاث السوق | مجموعات بيانات محدّثة وواسعة النطاق للتحليل | المحللون، فرق البحث |
وجدت إحدى دراسات الحالة أن أتمتة مهمة جمع بيانات أسبوعية (تجريف 5 إلى 7 مواقع) وفّرت على موظف واحد أكثر من 50 ساعة سنويًا؛ اضرب ذلك في عدد أفراد الفريق، وستفهم لماذا «لا تتخيّل الشركات العودة إلى الوراء» بمجرد أن تبدأ باستخدام الزواحف.
Python: الخيار الأول لبناء زاحف مواقع
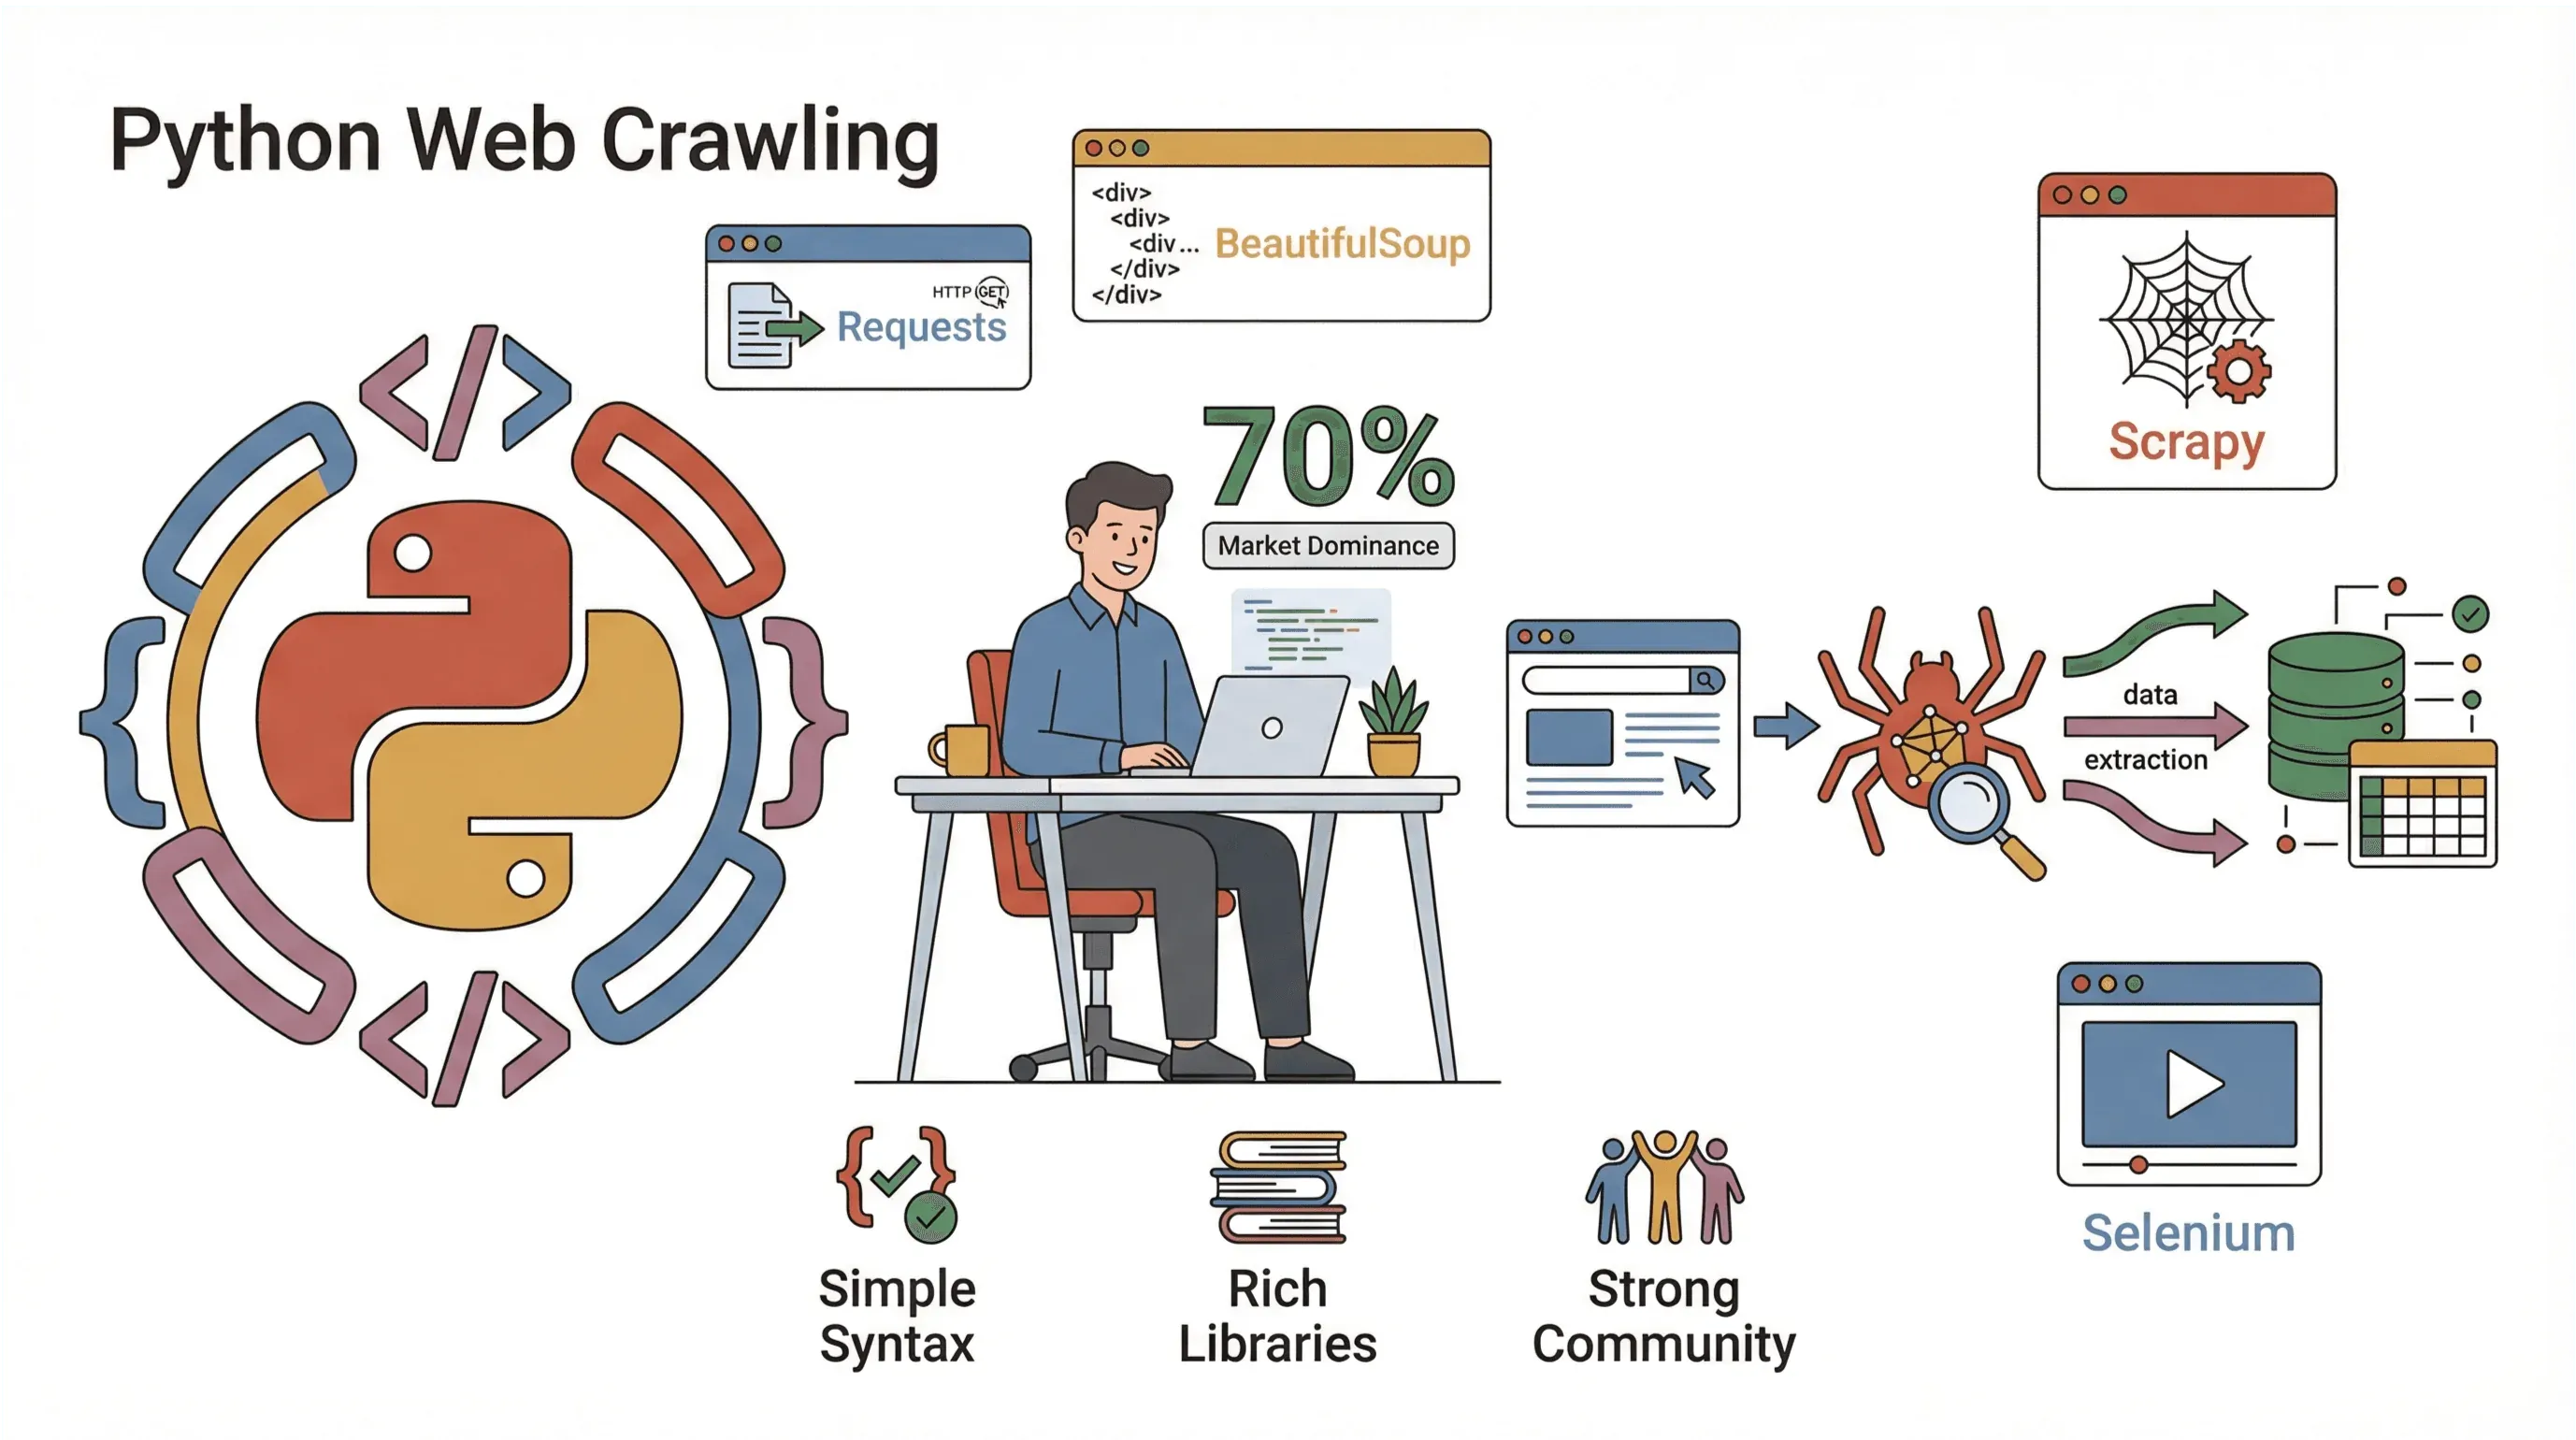 إذًا، لماذا تُعد Python ملكة الزحف على الويب؟ لثلاثة أسباب رئيسية:
- البساطة: صياغة Python سهلة القراءة ومناسبة للمبتدئين، وتتيح لك كتابة زواحف تعمل فعليًا بأسطر قليلة.
- منظومة المكتبات: تمتلك Python مجموعة غنية من المكتبات تغطي كل جزء من عملية الزحف: جلب الصفحات، وتحليل HTML، والتعامل مع JavaScript، وغير ذلك.
- المجتمع: مع اعتماد ما يقارب 70% من مشاريع تجريف الويب على Python، ستجد مجتمعًا ضخمًا، وكمًّا هائلًا من الشروحات، وإجابات لأي مشكلة تقريبًا قد تواجهها.
أبرز مكتبات Python للزحف على الويب:
- Requests: أسهل طريقة لجلب صفحات الويب (HTTP GET/POST).
- BeautifulSoup: الخيار الأشهر لتحليل HTML والعثور على العناصر.
- Scrapy: إطار عمل متكامل للزحف في المشاريع واسعة النطاق.
- Selenium: أتمتة المتصفحات لتجريف المواقع التي تعتمد بكثافة على JavaScript.
مقارنةً بلغات أخرى (مثل Java أو C#)، تتيح لك Python الانتقال من الفكرة إلى زاحف يعمل فعليًا في جزء بسيط من الوقت. وإذا كنت من أهل البيانات، يمكنك تمرير مخرجات الزاحف مباشرةً إلى Pandas للتحليل، دون فوضى التصدير والاستيراد.
مقارنة طرق التحليل: Regex مقابل BeautifulSoup مقابل Scrapy
عندما يتعلق الأمر بـاستخراج البيانات من صفحات الويب، لديك عدة خيارات. إليك كيف تتقارن الطرق الرئيسية:
| الطريقة | كيف تعمل | المزايا 🟢 | العيوب 🔴 | الأنسب لـ |
|---|---|---|---|---|
| Regex | مطابقة أنماط على HTML الخام | سريعة مع الأنماط البسيطة والمعروفة | هشّة، وتنكسر عند تغيّر HTML | الحلول السريعة، استخراج الروابط |
| BeautifulSoup | تحوّل HTML إلى شجرة وتبحث حسب الوسوم | سهلة ومرنة وتتعامل مع HTML الفوضوي | أبطأ مع الصفحات الضخمة، ومنطق الزحف يدوي | معظم سكربتات التجريف الصغيرة والمتوسطة |
| Scrapy | إطار زحف متكامل، تحليل بـ CSS/XPath | سريع وقابل للتوسّع ويتولى الزحف والتحليل معًا | منحنى تعلّم أصعب وإعداد أكثر | الزواحف واسعة النطاق والإنتاجية |
- Regex أشبه باستخدام جهاز كشف المعادن على الشاطئ: سريع، لكنك ستفوّت أشياء إذا تحرّكت الرمال.
- BeautifulSoup أشبه بامتلاك خريطة ومجرفة: يمكنك الحفر في أي مكان، لكن عليك أن تمشي الشاطئ بنفسك.
- Scrapy أشبه بإحضار فريق كامل مع شاحنات وأجهزة GPS: مبالغة لصندوق رمل صغير، لكن لا يُضاهى في المهام الكبيرة.
بالنسبة لمعظم المبتدئين، أنصح بالبدء بـ Requests + BeautifulSoup. ستتعلّم الأساسيات، ويمكنك دائمًا «التخرّج» إلى Scrapy عندما تصبح جاهزًا للتوسّع.
خطوة بخطوة: كيف تبني زاحف مواقع بسيطًا بلغة Python
مستعد لتوسيخ يديك؟ لنبنِ زاحفًا أساسيًا يزور الصفحات، ويتتبّع الروابط، ويلتقط بعض البيانات. سأشرح لك كل خطوة، مع أكواد يمكنك نسخها وتعديلها.
الخطوة 1: إعداد بيئة Python لديك
أولًا، تأكّد من تثبيت Python 3.10 أو أحدث. (تحقّق باستخدام python --version.) أنصح بإنشاء بيئة افتراضية لمشروعك:
python -m venv venv
source venv/bin/activate  # على Windows: venv\Scripts\activate
ثم ثبّت المكتبات التي ستحتاجها:
pip install requests beautifulsoup4
هذا كل شيء! افتح محرّر الأكواد المفضّل لديك واستعد لكتابة زاحفك.
الخطوة 2: كتابة أول سكربت زاحف مواقع
لنبدأ بجلب صفحة واحدة. إليك سكربتًا بسيطًا:
import requests

def crawl_page(url):
    response = requests.get(url)
    response.raise_for_status()  # يطلق خطأ إذا لم تكن الاستجابة 200 OK
    print(response.text[:500])   # طباعة أول 500 حرف للمعاينة

crawl_page("https://www.scrapingcourse.com/ecommerce/")
من المفترض أن ترى كتلة من HTML في الطرفية، وهذا دليل على أنك تتواصل مع الويب فعلًا.
الخطوة 3: تتبّع الروابط وجمع مزيد من البيانات
الآن، لنجعل زاحفنا يتتبّع الروابط ويزور صفحات متعددة. سنحتفظ بقائمة بالروابط المطلوب زيارتها، ومجموعة بالروابط التي زرناها بالفعل (لتجنّب الحلقات المفرغة):
from bs4 import BeautifulSoup

start_url = "https://www.scrapingcourse.com/ecommerce/"
urls_to_visit = [start_url]
visited_urls = set()
max_pages = 20  # حد أمان

while urls_to_visit and len(visited_urls) < max_pages:
    current_url = urls_to_visit.pop(0)
    try:
        resp = requests.get(current_url)
        resp.raise_for_status()
    except Exception as e:
        print(f"Failed to retrieve {current_url}: {e}")
        continue

    soup = BeautifulSoup(resp.text, "html.parser")
    print(f"Crawled: {current_url}")

    for link_tag in soup.find_all("a", href=True):
        url = link_tag['href']
        if not url.startswith("http"):
            url = requests.compat.urljoin(current_url, url)
        if url.startswith(start_url) and url not in visited_urls:
            urls_to_visit.append(url)
    visited_urls.add(current_url)
سيزحف هذا السكربت إلى 20 صفحة كحد أقصى، متتبعًا الروابط التي تبقى داخل النطاق نفسه. وسترى كل رابط أثناء الزحف إليه.
الخطوة 4: استخراج البيانات من الصفحات
لنفترض أنك تريد الحصول على أسماء المنتجات وأسعارها من كل صفحة. إليك كيف يمكنك فعل ذلك:
product_data = []

while urls_to_visit and len(visited_urls) < max_pages:
    # ... (كما في الأعلى)
    soup = BeautifulSoup(resp.text, "html.parser")
    if "/page/" in current_url or current_url == start_url:
        items = soup.find_all("li", class_="product")
        for item in items:
            name = item.find("h2", class_="product-name")
            price = item.find("span", class_="price")
            link = item.find("a", class_="woocommerce-LoopProduct-link")
            if name and price and link:
                product_data.append({
                    "name": name.get_text(),
                    "price": price.get_text(),
                    "url": link['href']
                })
    # ... (بقية منطق الزحف)

# الحفظ في ملف CSV
import csv
with open("products.csv", "w", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price", "url"])
    writer.writeheader()
    writer.writerows(product_data)
print(f"Scraped {len(product_data)} products.")
والآن أصبح لديك ملف CSV يحتوي على كل المنتجات التي جرّفتها، جاهز للتحليل أو الرفع أو التباهي به أمام أصدقائك.
الخطوة 5: تصحيح أخطاء الزاحف وتحسينه
بناء زاحف شيء، وجعله متينًا شيء آخر. إليك بعض النصائح من تجربتي الشخصية (وبعض الصداع الذي دفعت ثمنه غاليًا):
- اضبط ترويسة User-Agent: بعض المواقع تحجب «Python-requests» افتراضيًا. تظاهر بأنك متصفح:
headers = {"User-Agent": "Mozilla/5.0"} requests.get(url, headers=headers) - تعامل مع الأخطاء بسلاسة: استخدم try/except لتخطّي الصفحات المعطوبة أو المحجوبة.
- تجنّب الحلقات اللانهائية: تتبّع دائمًا الروابط التي تمت زيارتها، وحدّد سقفًا لعدد الصفحات.
- خفّف وتيرة طلباتك: أضف
time.sleep(1)بين الطلبات لتجنّب الحجب. - تحقّق من robots.txt: احترم دائمًا قواعد الزحف الخاصة بالموقع (المزيد عن ذلك أدناه).
- سجّل تقدّمك: اطبع أو سجّل كل رابط أثناء الزحف؛ فهذا منقذ حقيقي عند تصحيح الأخطاء.
إذا وجدت في أي وقت أن زاحفك يُحجب، أو يعيد محتوى غريبًا، أو يفوّت بيانات، فراجع الترويسات، وأبطئ الوتيرة، وتأكد من أنك لا تصطدم بإجراءات مكافحة الروبوتات.
Thunderbit: تبسيط الزحف على المواقع بالذكاء الاصطناعي
استخرج البيانات من أي موقع باستخدام الذكاء الاصطناعي Get Started Free
والآن، لنتحدث عن «الزر السهل» للزحف على الويب: Thunderbit. رغم حبي الشديد لـ Python، أحيانًا تريد البيانات فحسب، دون إعداد ولا تصحيح أخطاء ولا صيانة. Thunderbit هو إضافة Chrome لتجريف الويب مدعومة بالذكاء الاصطناعي، تتيح لك استخراج البيانات من أي موقع بنقرتين فقط.
ما الذي يميّز Thunderbit؟
- اقتراح الحقول بالذكاء الاصطناعي: يفحص ذكاء Thunderbit الاصطناعي الصفحة ويقترح البيانات التي يمكنك استخراجها، دون الحاجة إلى فحص HTML أو كتابة محددات.
- بلا أكواد ويعمل داخل المتصفح: يعمل داخل متصفحك، لذا يتعامل مع المواقع التي تتطلب تسجيل الدخول والصفحات المعتمدة على JavaScript.
- تجريف الصفحات الفرعية: تحتاج تفاصيل أكثر؟ يستطيع Thunderbit زيارة كل صفحة فرعية تلقائيًا (مثل تفاصيل المنتج) وإثراء جدولك.
- تصدير فوري: صدّر بياناتك إلى Excel أو Google Sheets أو Airtable أو Notion، دون عناء التعامل مع ملفات CSV.
- تجريف سحابي أو محلي: اختر بين التجريف السحابي السريع (للمواقع العامة) أو وضع المتصفح (للمواقع التي تتطلب تسجيل دخول أو الصعبة).
- الجدولة: اضبط عمليات التجريف لتعمل تلقائيًا، دون الحاجة إلى مهام cron أو خوادم.
بالنسبة لمستخدمي الأعمال، يُعد Thunderbit نقلة نوعية. يمكنك الانتقال من «أحتاج هذه البيانات» إلى «ها هو جدول البيانات» في دقائق، لا ساعات. وإذا كنت مطوّرًا، يمكن لـ Thunderbit أن يكمّل سكربتاتك: استخدمه في المهام السريعة، أو كخطة بديلة عندما يحتاج كودك إلى استراحة.
تريد أن ترى كيف يعمل؟ حمّل إضافة Chrome وجرّب تجريف موقعك المفضّل. الخطة المجانية تتيح لك تجريف عدد محدود من الصفحات، وتبدأ الخطط المدفوعة من 15 دولارًا شهريًا مقابل 500 رصيد.
جرّب Thunderbit AI Web Scraper مجانًا
اعتبارات مهمة عند بناء زاحف مواقع بلغة Python
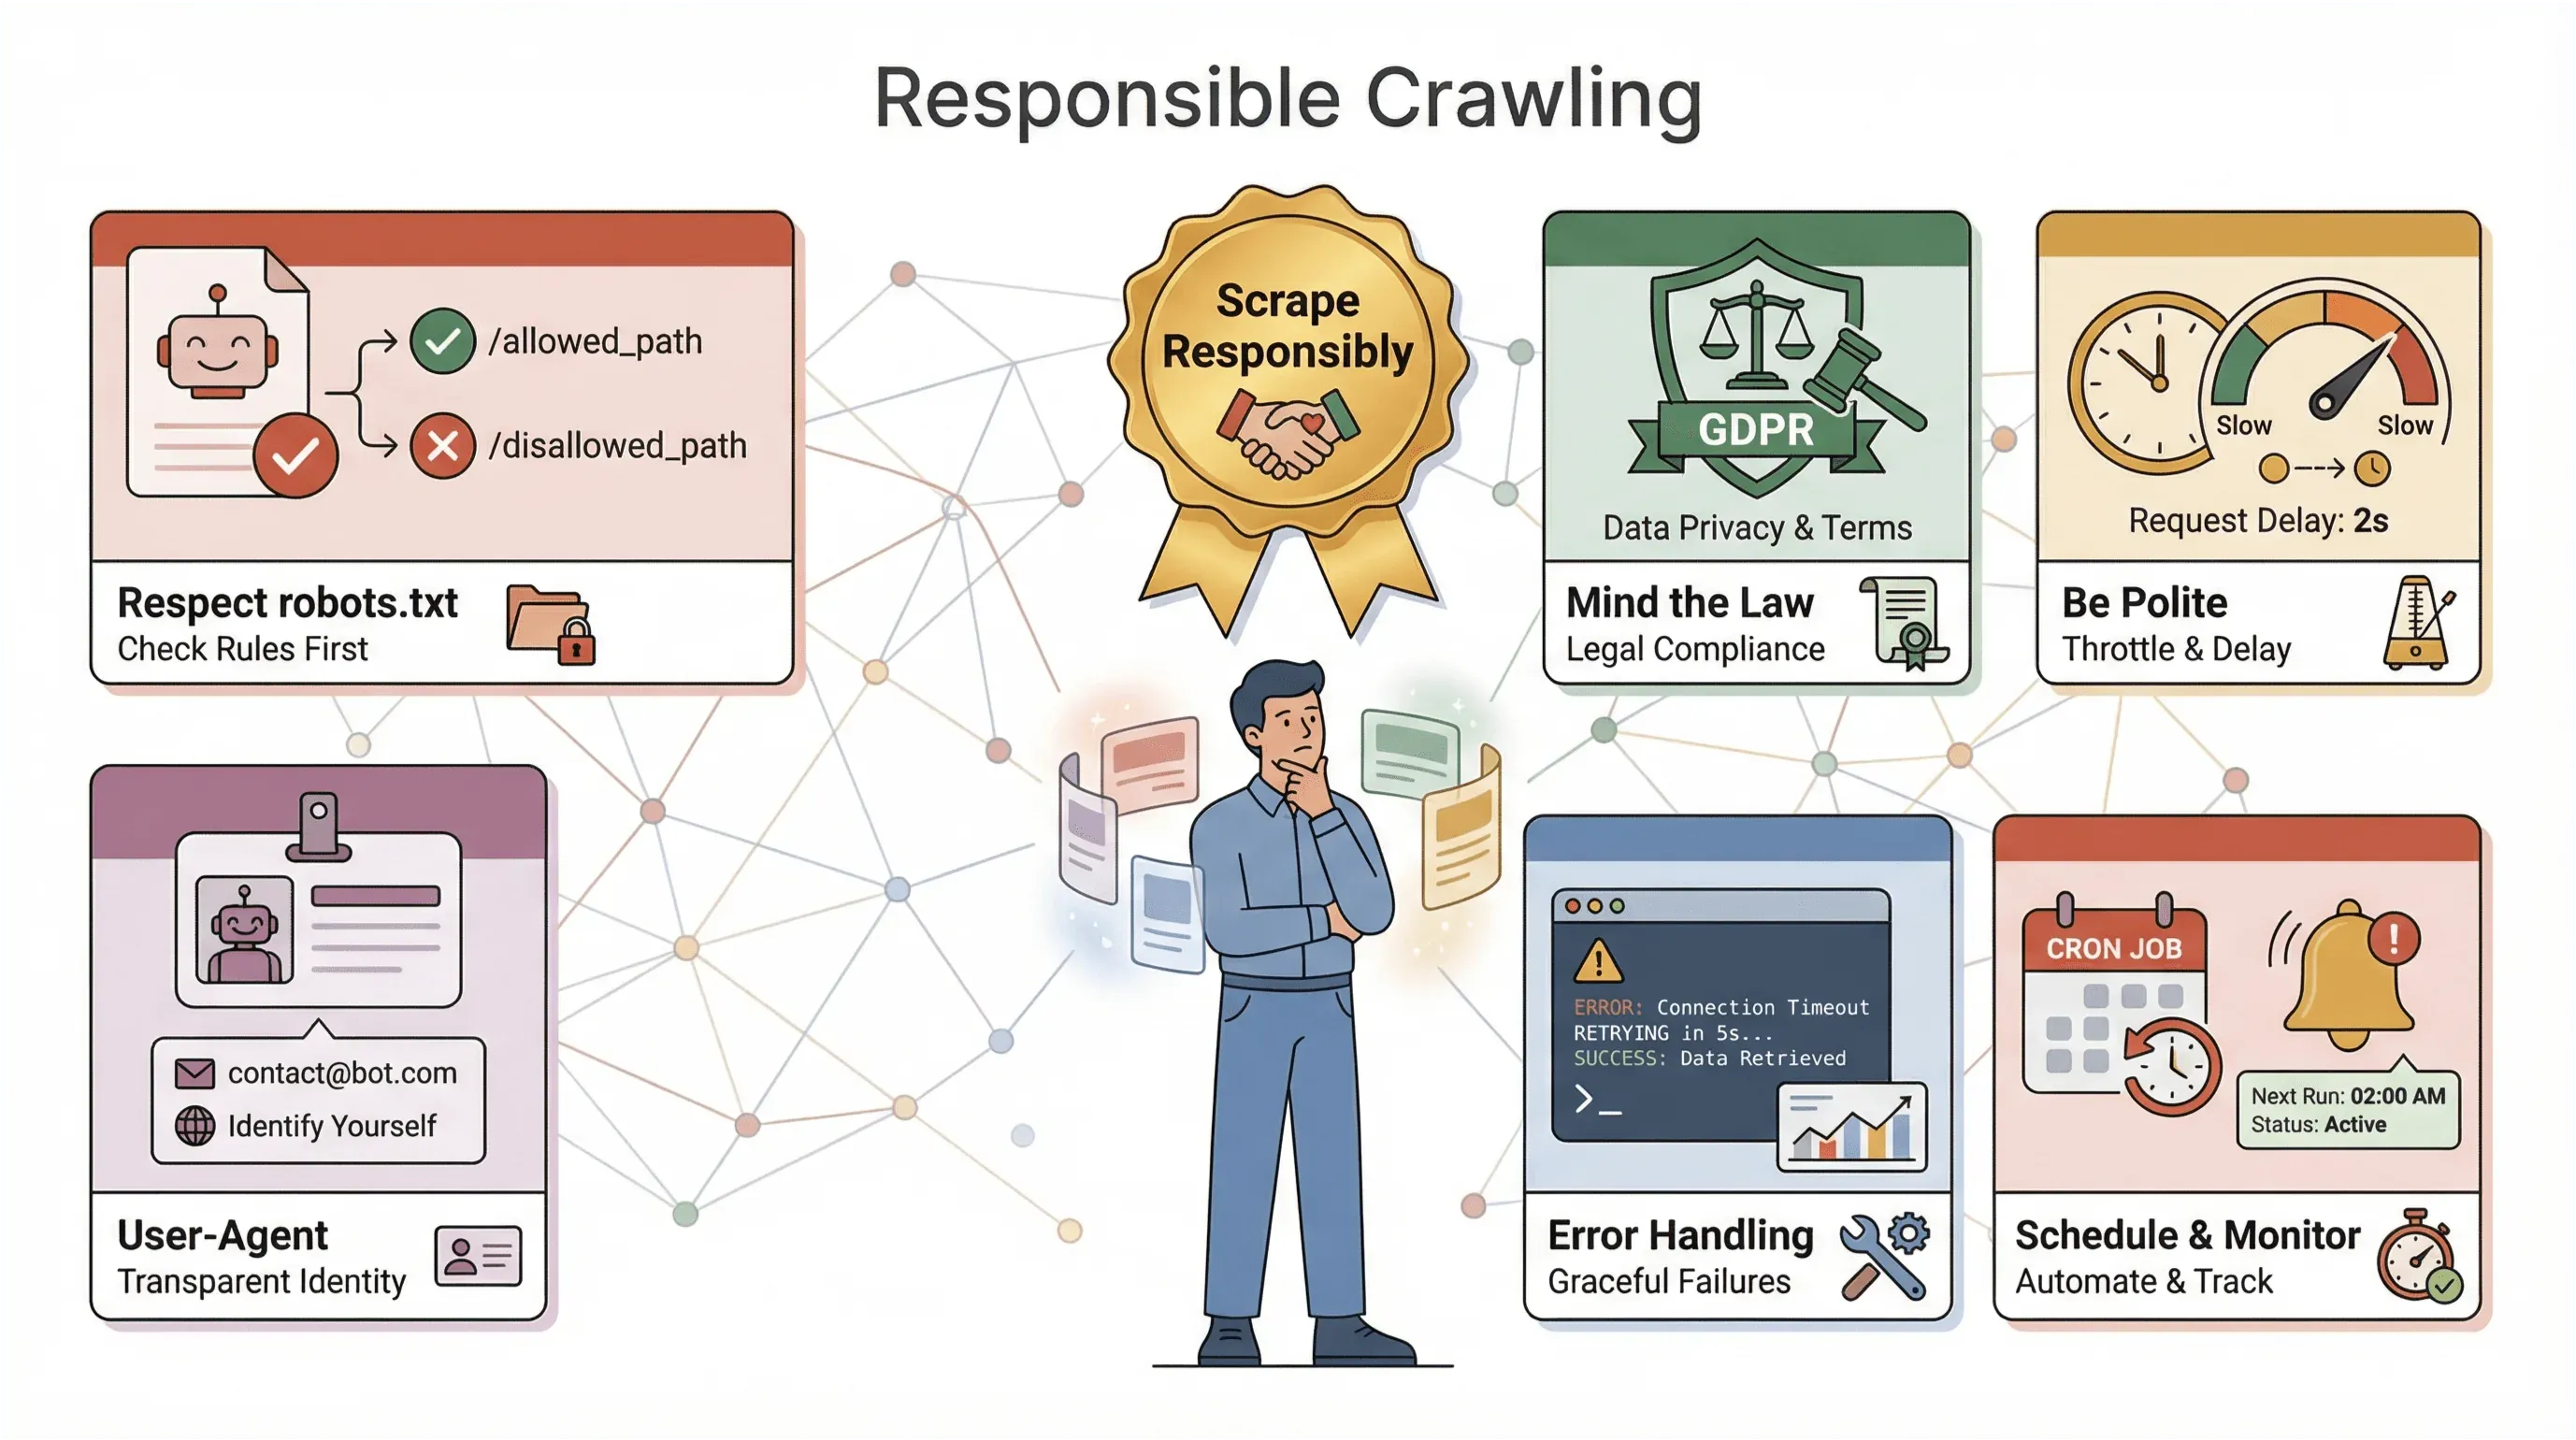 قبل أن تطلق زاحفك على العالم، إليك بعض كلمات التحذير (والحكمة):
- احترم robots.txt: تنشر معظم المواقع ملف
robots.txtيحدّد للزواحف ما هو مسموح. تجاهله قد يعرّضك للحجب، أو الأسوأ: للمساءلة القانونية. تحقّق دائمًا من هذه القواعد والتزم بها (المزيد هنا). - انتبه للقانون: تحظر شروط استخدام بعض المواقع عمليات التجريف. وإذا كنت تجمع بيانات شخصية، فقد تنطبق قوانين الخصوصية مثل GDPR وCCPA (dataprixa.com). وعند الشك، التزم بالبيانات العامة غير الحساسة.
- كن مهذبًا: لا تُغرق المواقع بالطلبات؛ خفّف وتيرة زاحفك، وعشوِ فترات الانتظار، وتجنّب التجريف في ساعات الذروة.
- عرّف عن نفسك: استخدم نص User-Agent مخصصًا، وفكّر في إدراج بيانات تواصل إذا كنت تجرّف على نطاق واسع.
- تعامل مع الأخطاء وسجّلها: توقّع أن تتغيّر المواقع، وأن تتعطّل الصفحات، وأن تصبح البيانات فوضوية. ابنِ آليات لمعالجة الأخطاء والتسجيل والمراقبة كي تصلح المشكلات بسرعة.
- جدوِل وراقب: للزحف الدوري، استخدم أدوات الجدولة (مثل cron أو المجدول المدمج في Thunderbit)، واضبط تنبيهات في حال بدأ زاحفك بالفشل أو بجمع بيانات صفرية.
القاعدة الذهبية: جرّف بمسؤولية. الويب مورد مشترك؛ فلا تكن «ذلك الروبوت» الذي يفسده على الجميع.
نصائح متقدمة: توسيع زاحف Python وتطويره
بمجرد أن تتقن الأساسيات، قد ترغب في الارتقاء بزاحفك. إليك بعض الخطوات المتقدمة:
- تعامل مع JavaScript: استخدم Selenium أو Playwright لتجريف المواقع التي تحمّل بياناتها ديناميكيًا.
- وسّع النطاق: في المشاريع الكبيرة، انتقل إلى Scrapy أو استخدم المكتبات غير المتزامنة (مثل
aiohttp) لإرسال طلبات متوازية. - استخدم البروكسيات: دوّر عناوين IP لتجنّب الحجب في عمليات الزحف عالية الحجم.
- أتمت خطوط أنابيب البيانات: اكتب مباشرة إلى قواعد البيانات، أو اربط الأمر بالتخزين السحابي لمجموعات البيانات الكبيرة.
- راقب ونبّه: فعّل التسجيل وفحوص السلامة والإشعارات للزواحف طويلة الأمد.
إذا أصبح زاحفك عنصرًا حيويًا في عملك، ففكّر في استخدام خدمات مُدارة أو واجهات API لتخفيف العبء الثقيل. وإذا كنت تجرّف مواقع متعددة بتخطيطات مختلفة، فقسّم كودك إلى وحدات كي تتمكن من تحديث المحللات بسهولة.
الخلاصة وأبرز النقاط
ما هي عملية استخراج البيانات وكيف تُنجز في 2026 Get Started Free
بناء زاحف مواقع بلغة Python هو من أكثر المهارات التي تمنحك قوة في عالم اليوم القائم على البيانات. إليك ما تناولناه:
- زواحف المواقع تُؤتمت عملية زيارة صفحات الويب واستخراج البيانات منها، وهي ضرورة لأتمتة الأعمال والبحث والاستخبارات التنافسية.
- Python هي الخيار الأول لبناء الزواحف، بفضل صياغتها البسيطة ومكتباتها القوية ومجتمعها الضخم.
- طرق التحليل مهمة: استخدم regex للحلول السريعة، وBeautifulSoup لمعظم السكربتات، وScrapy للمهام الكبيرة.
- خطوة بخطوة، يمكنك الانتقال من جلب صفحة واحدة إلى الزحف على موقع كامل وحفظ بيانات منظّمة، دون الحاجة إلى شهادة دكتوراه.
- Thunderbit يذهب أبعد من ذلك، إذ يتيح لك تجريف البيانات بالذكاء الاصطناعي، دون أكواد، مع تصدير فوري؛ وهو مثالي لمستخدمي الأعمال أو لأي شخص يريد نتائج سريعة.
- الزحف المسؤول هو الأساس: احترم قواعد المواقع، وتعامل مع الأخطاء، وضع الأخلاقيات أولًا دائمًا.
- التوسّع ممكن بالأدوات المناسبة، سواء كانت Selenium لـ JavaScript، أو Scrapy للتوازي، أو Thunderbit للأتمتة بلا أكواد.
أفضل طريقة للتعلّم هي البدء بخطوة صغيرة: اكتب سكربتًا، جرّب Thunderbit، وانظر ما البيانات التي يمكنك فتحها. الويب ملكك (أو بوفيه بياناتك، إن كنت جائعًا مثلي).
تريد التعمّق أكثر؟ اطّلع على هذه المصادر:
- What Is Data Scraping and How to Do It in 2025
- How to Scrape Website Data into Excel using AI
- Thunderbit Blog لمزيد من النصائح والأدلة والتقنيات المتقدمة.
زحفًا موفقًا، وعسى أن تكون أدوات تجريفك سريعة، وبياناتك نظيفة، وقهوتك لا تنفد أبدًا.
جرّب Thunderbit AI Web Scraper الآن
الأسئلة الشائعة
1. ما الفرق بين زاحف المواقع وأداة تجريف الويب؟
الزاحف يزور صفحات الويب ويكتشفها بشكل منهجي (مثل رسم خريطة لموقع)، بينما تستخرج أداة التجريف بيانات محددة من تلك الصفحات. معظم المشاريع الواقعية تستخدم الاثنين: الزحف للعثور على الصفحات، والتجريف للحصول على البيانات.
2. لماذا تحظى Python بهذه الشعبية في بناء زواحف المواقع؟
Python سهلة التعلّم، ولديها مكتبات قوية (مثل Requests وBeautifulSoup وScrapy وSelenium)، ومجتمع ضخم. نحو 70% من مشاريع تجريف الويب تستخدم Python، ما يجعلها المعيار في هذا المجال.
3. متى أستخدم regex أو BeautifulSoup أو Scrapy في التحليل؟
استخدم regex للأنماط البسيطة والمتوقعة. وBeautifulSoup هي الأفضل لمعظم السكربتات: سهلة ومرنة. أما Scrapy فمثالية للزواحف واسعة النطاق أو الإنتاجية التي تحتاج إلى السرعة والتوازي والميزات المتينة.
4. كيف يقارن Thunderbit ببرمجة زاحف بلغة Python؟
يتيح لك Thunderbit تجريف البيانات بالذكاء الاصطناعي ودون أكواد: انقر فقط، وحدّد الحقول، ثم صدّر. وهو مثالي لمستخدمي الأعمال أو للمهام السريعة. أما Python فتمنحك تحكمًا وتخصيصًا أكبر، لكنها تتطلب برمجة وصيانة.
5. ما القضايا القانونية أو الأخلاقية التي يجب الانتباه لها عند الزحف على المواقع؟
تحقّق دائمًا من robots.txt واحترمه، والتزم بشروط استخدام الموقع، وتجنّب جمع البيانات الحساسة أو الشخصية دون موافقة، وخفّف وتيرة طلباتك تجنبًا لإرهاق الخوادم. التجريف المسؤول يبقي الويب مفتوحًا للجميع.
مستعد للتجربة بنفسك؟ حمّل Thunderbit أو افتح محرّر Python المفضّل لديك وابدأ الزحف. البيانات موجودة هناك، فاذهب واحصل عليها!
جرّب AI Web Scraper Get Started Free
اقرأ المزيد



