適用於資訊框、引用與章節的 Wikipedia 爬蟲









整理 Wikipedia 文章,方便研究與分析
將文章重點、資訊框數值、引用與章節脈絡分開保存。
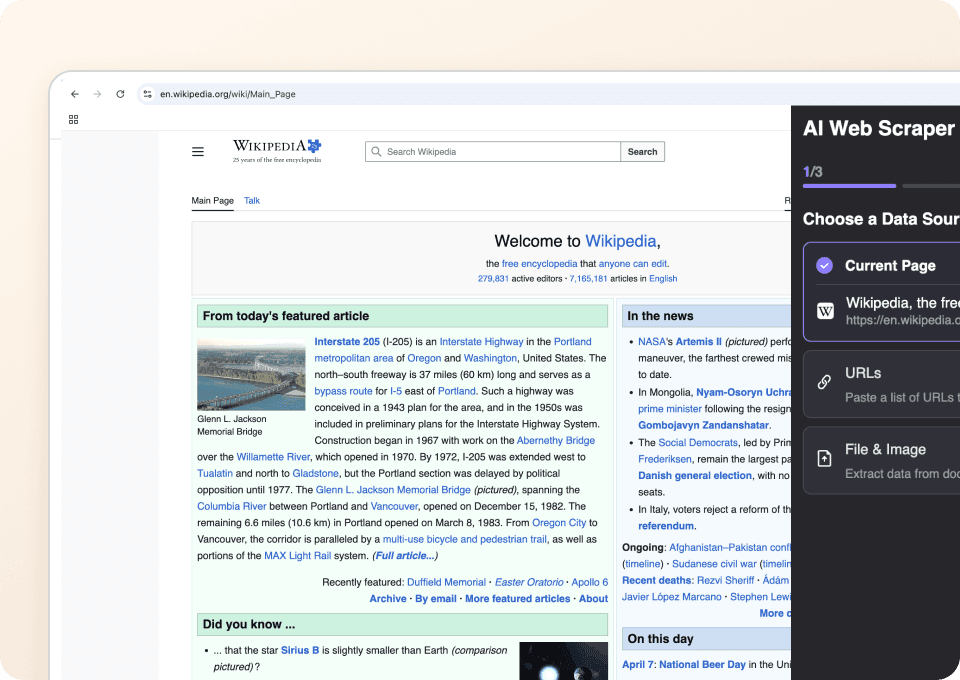
一鍵擷取 Wikipedia 資料
它會先為您正在開啟的頁面提出欄位建議,並在一次執行中完成擷取。如果您願意,也可以用自然語言調整或重新命名欄位,再重新執行。
適用於不同類型的 Wikipedia 頁面
Agent 會讀取可見的標籤、標題與章節名稱,將您可存取頁面上的資料對應好。如果某欄沒有出現,對應欄位就會保持空白。
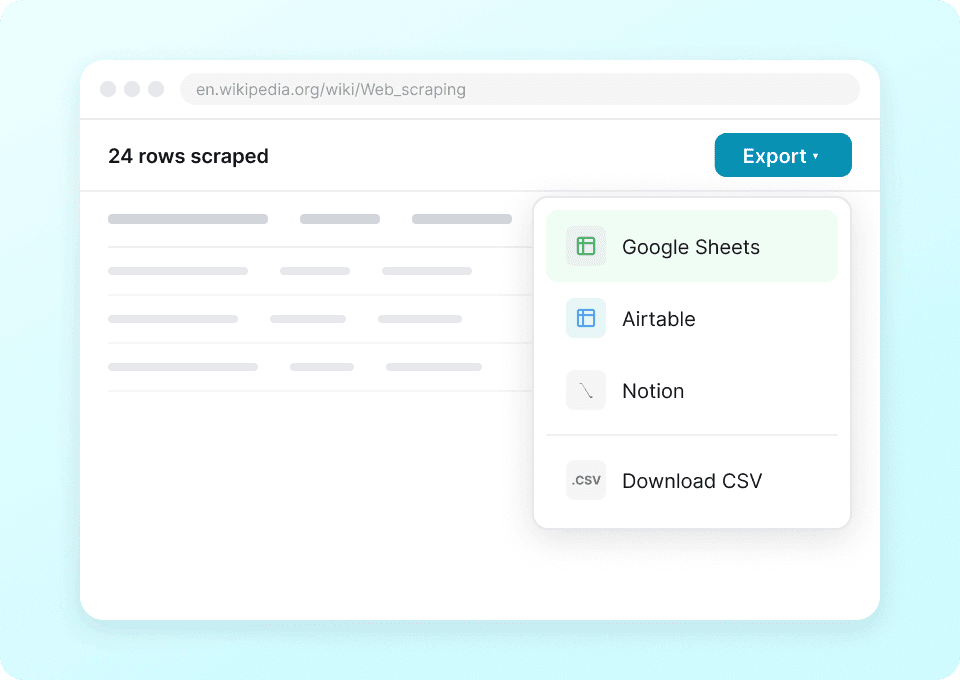
直接匯出 Wikipedia 資料
將研究成果繼續匯出到 Google Sheets、Excel、Airtable、Notion,或下載成 CSV。
不用自己打造爬蟲,也能收集 Wikipedia 研究資料
減少 Wikipedia 研究時維護選擇器的成本。
手動或選擇器式設定
花時間維護規則Thunderbit AI Agent
欄位建議與一次完成用於文章重點、資訊框、引用與章節的欄位
只有在您可存取的頁面上顯示的內容,才會出現對應欄位。
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.
關於 Wikipedia 研究任務的常見問題
Wikipedia 上的 Agent Mode 簡短解答。
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Flixster 爬蟲
Thunderbit Flixster 爬蟲可協助你從 Flixster 的熱門票房榜單及附近電影院中擷取數據。透過 AI 智慧欄位建議,快速收集電影名稱、票房收入、評分、上映日期、電影院名稱、地點及現正上映電影,方便分析或研究使用。
深入了解 ->
olympustaff.com 爬蟲
Thunderbit olympustaff.com 爬蟲可協助你從 olympustaff.com 抽取漫畫列表與評論資料。透過 AI 智慧欄位建議,快速收集漫畫標題、作者、發佈日期及讀者意見,方便分析與研究。非常適合行銷人員、研究者及內容創作者取得 olympustaff.com 的結構化數據。
深入了解 ->
Hatena 爬蟲
Thunderbit Hatena 爬蟲可協助你透過 AI 智慧欄位建議,快速擷取 Hatena 部落格與主題清單的資料。無論是部落格標題、作者名稱、發佈日期、內容摘要,還是熱門主題,都能輕鬆收集,適合用於市場研究、內容分析或行銷規劃。非常適合行銷人員、研究者與內容創作者,快速獲取結構化的 Hatena 資料。
深入了解 ->
namu.wiki 爬蟲
Thunderbit namu.wiki 爬蟲可協助你從 namu.wiki 擷取資料,包括所需頁面與近期討論。透過 AI 智慧欄位建議,快速收集頁面標題、網址、最後編輯日期、討論主題及參與者名稱,無論是用於研究、內容創作或社群分析都非常方便。
深入了解 ->
網易音樂爬蟲
Thunderbit 網易雲音樂爬蟲可協助你從網易雲音樂的搜尋結果與藝人作品頁面擷取資料。透過 AI 智慧欄位建議,快速收集歌曲名稱、藝人、專輯資訊、時長與歌曲連結,方便分析或研究。非常適合音樂分析師、市場行銷人員及音樂愛好者,輕鬆獲取結構化的網易雲音樂數據。
深入了解 ->
QQ 音樂爬蟲
Thunderbit QQ 音樂爬蟲可協助你從 QQ 音樂搜尋結果及歌手作品列表中擷取資料。透過 AI 智慧欄位建議,快速收集歌曲名稱、歌手、專輯資訊、發行日期等結構化數據,方便分析與研究。非常適合音樂分析師、市場行銷人員及音樂愛好者高效整理 QQ 音樂資料。
深入了解 ->準備好大幅提升你的資料擷取效率了嗎?
加入 200,000+ 位已使用 Thunderbit 自動化網頁爬取流程的專業人士。
免費試用可用於 8 個網頁,且提供無限額度。


