
網路上到處都是海量資料,但問題是:如果要人工一筆一筆蒐集,效率低得像在看油漆乾一樣無聊,產出也差不多。到了 2026 年,企業接觸到的網頁內容比以往任何時候都多;平均來看,公司的每日網頁資料攝取量已從 2020 年的 1.2 TB 增加到 2025 年的 8 TB(Actowiz Solutions)。不管你是在做銷售、行銷、電商還是營運,對快速、結構化又準確的網頁資料需求,早就不只是「加分」,而是實際的營運剛需。講白一點,沒有人有時間一直複製貼上到天荒地老。
使用 AI 從任何網站擷取資料 點一下,AI 就會讀取頁面、判斷結構,並回傳乾淨的表格。免費方案每月可處理 6 個頁面。 Get Started Free
這也是為什麼內容爬取工具這幾年會紅成這樣。這些工具——從 AI 驅動的 Chrome 擴充功能到企業級平台都有——可以幫你把整個流程自動化,將雜亂的網頁轉成乾淨的試算表、資料庫,或即時儀表板。我在 SaaS 與自動化領域待了多年,可以很肯定地說:選對工具,不只是省時間,還會直接改變團隊的工作方式。接下來,我們就來看看 2026 年最值得關注的 16 款內容爬取工具,重點放在每款工具的獨特之處、適合哪些商業需求,以及怎麼挑出最符合你工作流程的選擇。
為什麼企業需要頂尖的內容爬取工具
如果你曾經手動建立名單、追蹤競品價格,或整理市場聲量,你一定知道人工蒐集資料很快就會變成噩夢。速度慢、容易出錯,而且等你做完,資料可能早就過時了。也因為如此,到 2025 年,超過 70% 的企業已採用自動化網頁擷取,把人工工作量大幅減少了約 60%(Actowiz Solutions)。
內容爬取工具能自動從網站擷取結構化資料,讓你可以:
- 把最新潛在客戶資料送進 CRM(不用再從名錄手動複製貼上)
- 即時監控競品價格與庫存
- 彙整評論、新聞與社群提及,取得行銷洞察
- 建立研究或分析用的客製資料集
- 排程定期擷取資料,持續產出報表
而且投資報酬率相當明顯:使用網頁爬蟲的企業在 2020 到 2025 年間,合計節省了超過 5 億美元,營運效率提升約 20–40%(Actowiz Solutions)。簡單說,內容爬取工具能讓團隊把精力放在策略上,而不是重複苦工。
我們如何挑選最好的內容爬取工具
不是每一款網頁爬蟲都一樣。整理這份清單時,我是從真實商業使用者的角度出發——銷售、行銷、營運與研究團隊要的是結果,不是麻煩。以下是我最重視的幾個面向:
- 易用性: 非技術人員能不能快速上手?有沒有點選式介面或 AI 協助?
- 自動化與功能: 能不能處理分頁、子頁面、排程與動態內容?是否可雲端執行以提升速度與規模?
- 資料輸出與整合: 能不能匯出到 Excel、CSV、Google Sheets、Airtable、Notion,或透過 API 串接?
- 可擴充性: 適不適合一次性任務,還是能支援大量、持續性的專案?
- 客製化: 能不能調整擷取邏輯、加入自訂欄位,或處理比較棘手的網站?
- 法規與隱私: 工具是否能幫助你符合 GDPR、CCPA 與網站使用條款?
- 支援與社群: 有沒有文件、客服或使用者社群協助排除問題?
- 成本: 有沒有免費方案或試用?價格是否符合你的規模與預算?
當然,我也特別把 Thunderbit 放在醒目的位置——這是我和團隊打造的工具,因為我真心認為,它是商務使用者開始使用 AI 網頁爬蟲的最簡單方式。
2026 年最值得關注的 18 款內容爬取工具
接下來就來拆解各路高手,從 AI 的極簡操作到開發者級強大功能,一次看懂。
1. Thunderbit
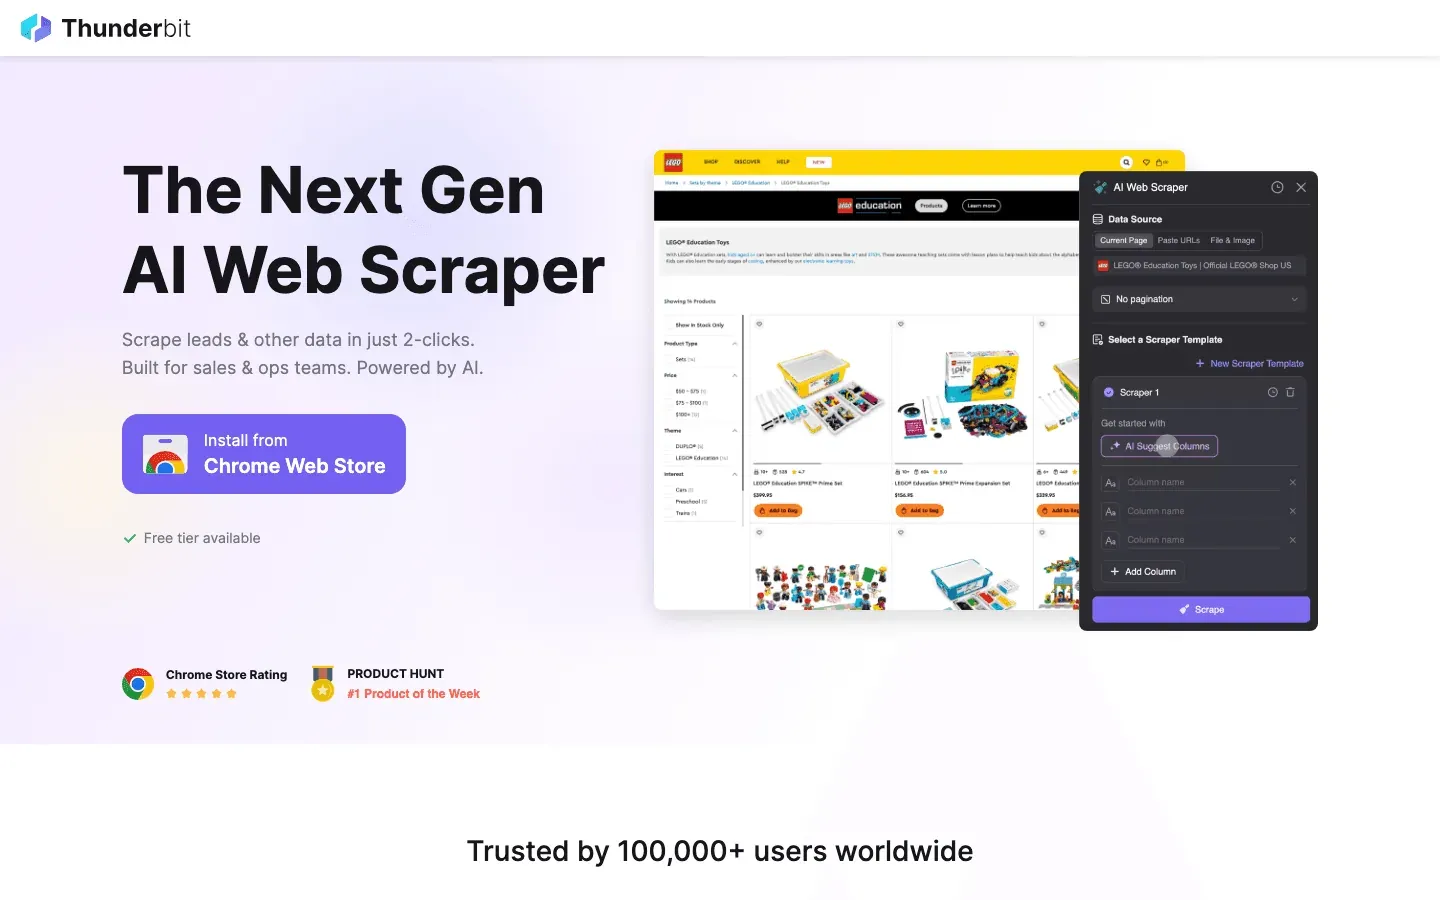 Thunderbit 是一款專為商務使用者設計的 AI 網頁爬蟲 Chrome 擴充功能,主打「快速拿到結果」。它最亮眼的功能是 一鍵擷取:只要打開網頁、點一下,Thunderbit 的 AI 就會讀懂頁面、判斷欄位,並替你完成爬蟲設定。不用寫程式,也不用調整 selector,直接點、抓、匯出。
- 子頁面爬取: Thunderbit 可自動前往每個子頁面(例如產品或個人資料頁)補充資料,非常適合名單開發或電商研究。
- 分頁與範本: 可處理多頁清單,並提供 Amazon、Zillow、Instagram 等網站的即用範本。
- 免費資料匯出: 可匯出到 Excel、Google Sheets、Airtable、Notion、CSV 或 JSON,沒有額外付費牆。
- AI 自動填表: 除了爬取,也能用 AI 自動填寫線上表單,把工作流程自動化延伸得更遠。
- 雲端與瀏覽器爬取: 公開網站可選擇快速雲端模式;登入狀態則可用瀏覽器模式。
- 價格: 免費可處理 6 個頁面(試用可到 10 個),付費方案每月 15 美元起。
Thunderbit 非常適合想要免技術門檻自動化資料蒐集的銷售、行銷與營運團隊。這是我當年最希望早點擁有的工具——現在,任何人都能在幾分鐘內建立名單或監控競品。
免費試用 Thunderbit AI 網頁爬蟲 不用設定爬蟲、也不用維護 selectors。可免費匯出到 Excel、Google Sheets、Airtable 或 Notion,無額外費用。 Get Started Free
2. Scrapy
 Scrapy 是開發者最愛的開源強力工具。它是以 Python 為基礎的框架,讓你用自訂 spider 大規模抓取與擷取資料。Scrapy 以速度與彈性見長,支援非同步爬取、自訂管線、代理輪換,以及與資料庫或 API 的整合。
- 適合對象: 開發者與資料工程師,適合打造大型、複雜或需要重複執行的爬取專案。
- 優勢: 完整控制權、可擴充性高、社群龐大、穩定性經過實戰驗證。
- 缺點: 對不會寫程式的人學習門檻高;沒有視覺化介面。
如果你熟悉 Python,又想建立穩健且可擴充的爬蟲,Scrapy 幾乎就是業界標準。
3. Octoparse
 Octoparse 是一款免程式碼、雲端式的網頁爬蟲,搭配視覺化拖放介面。你可以直接點選資料欄位、設定分頁,甚至用 AI 輔助辨識模式來加快建立流程。
- 內建範本: 幾分鐘內即可從 Amazon、Twitter、Google Maps 等熱門網站擷取資料。
- 雲端爬取與排程: 可在 Octoparse 的伺服器上執行任務、設定定期排程,並處理大規模專案。
- 匯出選項: CSV、Excel、JSON、API 整合。
- 價格: 有限制的免費方案;付費方案約從每月 75 美元起。
Octoparse 很適合商業分析師與不寫程式的人,想要強大爬取能力但不想碰程式碼。
4. ParseHub
 ParseHub 是一款視覺化網頁爬蟲,在處理動態內容與複雜網站結構方面表現出色。它的點選式介面可讓你建立包含條件邏輯、迴圈與多層導覽的工作流程。
- 動態內容: 可處理下拉選單、無限捲動與互動式元素。
- 雲端與本機執行: 可在雲端執行專案(付費),或在本機處理較小任務。
- 匯出: CSV、Excel、JSON、API。
- 價格: 免費方案很大方;付費方案從每月 49 美元起。
ParseHub 很適合需要彈性與強大功能、又不想寫程式的使用者來處理棘手網站。
5. Data Miner
 Data Miner 是一款 Chrome/Edge 擴充功能,主打快速、以範本為基礎的爬取。它有超過 50,000 個公開擷取配方,涵蓋 15,000 多個網站,很多情況下你只要點一下就能把整頁抓下來。
- Google Sheets 整合: 可直接把擷取資料上傳到 Sheets。
- 自訂配方: 可用點選式介面或 XPath 建立自己的擷取邏輯。
- 分頁與自動化: 支援多頁爬取與排程執行。
- 價格: 有免費方案;付費方案從每月 19 美元起。
很適合需要快速從瀏覽器取得中小量資料的分析師與行銷人員。
6. WebHarvy
 WebHarvy 是一款 Windows 桌面應用程式,結合點選式操作與自動模式辨識。只要點選一個元素,WebHarvy 就會把所有相似項目標示出來,方便你擷取。
- 支援圖片、文字、分頁: 可抓取產品圖片、電子郵件、網址等多種資料。
- 桌面排程: 可在電腦上排程執行爬取。
- 一次性授權: 每台電腦約 199 美元。
非常適合想要簡單、無訂閱制、又能定期爬取的小型企業使用者。
7. Import.io
 Import.io 是企業級的雲端平台,專為大規模資料擷取打造。它提供 AI 資料清理、即時監控與完善的合規功能。
- API 整合: 可將資料直接送到資料庫、BI 儀表板或應用程式。
- 合規性: 建構時就已把 GDPR 與 CCPA 納入考量。
- 價格: 企業合約,屬於高階方案。
最適合需要可靠、合規且可擴充的網頁資料管線的大型組織。
8. Apify
 Apify 是一個雲端自動化平台,也是網頁爬取「actor」(機器人)的市集。你可以使用現成 actor 抓取常見網站,也能用 JavaScript 或 Python 自己開發。
- 市集: 有數百個可直接使用的爬蟲,涵蓋 LinkedIn、Amazon 等網站。
- 排程與 API: 可透過 API 執行、排程與整合 actor。
- 價格: 有免費方案;付費從每月 49 美元起。
適合開發者與技術熟悉度較高的團隊,想要自動化、彈性與社群驅動的解決方案。
9. Dexi.io
 Dexi.io 是一個雲端平台,適合協作式網頁資料專案。它提供工作流程自動化、排程與團隊管理功能。
- 工作流程自動化: 可跨團隊建立與分享資料管線。
- API 與匯出: 可整合資料庫、雲端儲存或 BI 工具。
- 價格: 客製化報價,主要面向團隊與企業。
很適合需要長期、協作式資料專案的組織。
10. Helium Scraper
 Helium Scraper 是一款桌面工具,結合視覺化擷取與腳本彈性。你可以用點選式操作完成大部分工作,也可以直接加入自訂 JavaScript 處理更進階的邏輯。
- 處理動態內容: 可抓取大量 AJAX 的網站。
- 資料清理與轉換: 內建腳本功能,方便建立客製化流程。
- 一次性授權: 約 99 美元。
很適合想要高彈性、又不想綁訂閱的進階使用者。
11. Web Scraper
 Web Scraper 是許多人入門網頁爬取的免費 Chrome 擴充功能。你可以定義 sitemap、點選要抓取的元素,然後匯出成 CSV 或 JSON。
- 多層爬取: 可追蹤連結、處理分頁與擷取巢狀資料。
- 本機免費使用: 另有付費雲端版本,可用於排程與擴充規模。
非常適合新手、學生,或任何需要快速、免費、小型任務解決方案的人。
12. Mozenda
 Mozenda 是企業雲端平台,重點放在合規、可擴充性與託管服務。其點選式介面可讓你建立用於資料擷取的「agents」。
- 託管服務: Mozenda 團隊可以代你建立並維護爬蟲。
- 合規與支援: 特別重視 GDPR、CCPA 與企業需求。
- 價格: 約從每月 500 美元起。
最適合想要開箱即用、可擴充、且有強力支援的大型組織。
13. SimpleIndex
 SimpleIndex 是一款同時支援文件與網頁資料擷取的自動化工具,特別強調 OCR 與索引。
- 螢幕擷取 OCR: 可從掃描文件、PDF,甚至螢幕上的網頁表單擷取資料。
- 整合: 可輸出到資料庫、文件管理系統。
- 一次性授權: 每個工作站約數百美元。
很適合同時處理文件與網頁資料流程的組織。
14. Datastreamer(前身為 Spinn3r)
 Datastreamer(前身為 Spinn3r)是一個即時內容爬取平台,適合部落格、新聞與社群媒體。它的 Firehose API 能持續從數百萬個來源提供新的內容流。
- 垃圾內容過濾與語言處理: 輸出乾淨、結構化的資料流。
- API 存取: 可直接整合進你的系統。
- 訂閱制價格: 依使用量計費。
最適合媒體監控、新聞彙整或需要即時內容串流的研究團隊。
15. FMiner
 FMiner 是一款用於複雜網頁爬取的視覺化流程建構工具。透過拖放介面,你可以設計多層次、具條件判斷的爬取流程。
- Python 腳本: 可插入自訂程式碼處理進階邏輯。
- 跨平台: 支援 Windows 與 Mac。
- 一次性授權: 約從 168 美元起。
非常適合想用視覺化方式規劃複雜流程的分析師或資料科學家。
16. G2 Webscraper
 G2 Webscraper(這裡指的是 G2 上評價很高的相關工具)以簡單好用與實際成效受到好評。使用者特別喜歡免費、容易上手、又能省下大量時間的工具,例如 Web Scraper Chrome 擴充功能或 Data Miner。
- 使用者評價高: 在易用性與穩定性方面評分不錯。
- 快速設定: 基礎到中階任務的學習曲線很低。
如果你要的是「裝了就能用」的簡單爬取工具,G2 上的熱門選擇通常很安全。
比較表:一眼看懂頂尖內容爬取工具
| 工具 | 易用性 | 自動化與功能 | 匯出格式 | 合規與隱私 | 價格 | 最適合 |
|---|---|---|---|---|---|---|
| Thunderbit | ⭐⭐⭐⭐⭐ | AI 欄位、子頁面、雲端 | Excel、CSV、Sheets、Notion、Airtable、JSON | 使用者引導 | 免費,15 美元/月起 | 不寫程式者、銷售、營運 |
| Scrapy | ⭐ | 全程程式碼、非同步、外掛 | CSV、JSON、資料庫 | 由使用者自行管理 | 免費、開源 | 開發者、大型專案 |
| Octoparse | ⭐⭐⭐⭐ | 視覺化、範本、雲端 | CSV、Excel、JSON、API | 使用者引導 | 免費,75 美元/月起 | 分析師、電商、不寫程式者 |
| ParseHub | ⭐⭐⭐⭐ | 視覺化、動態內容、雲端 | CSV、Excel、JSON、API | 使用者引導 | 免費,49 美元/月起 | 不寫程式者、複雜網站 |
| Data Miner | ⭐⭐⭐⭐⭐ | 範本、瀏覽器、Sheets | CSV、Excel、Sheets | 使用者引導 | 免費,19 美元/月起 | 瀏覽器內快速任務 |
| WebHarvy | ⭐⭐⭐⭐⭐ | 視覺化、模式辨識 | Excel、CSV、XML、JSON | 使用者引導 | 一次性 199 美元 | Windows 使用者、小型企業 |
| Import.io | ⭐⭐⭐⭐ | AI、雲端、監控 | CSV、API、資料庫 | GDPR、CCPA | 企業級 | 大型組織、重視合規 |
| Apify | ⭐⭐⭐ | 雲端、市集、API | JSON、API、Sheets | 由使用者自行管理 | 免費,49 美元/月起 | 開發者、自動化、整合 |
| Dexi.io | ⭐⭐⭐ | 雲端、團隊、工作流程 | CSV、API、資料庫、儲存 | 使用者引導 | 客製化 | 團隊、長期專案 |
| Helium Scraper | ⭐⭐⭐ | 視覺化 + 腳本 | CSV、資料庫 | 使用者引導 | 一次性 99 美元 | 進階使用者、客製邏輯 |
| Web Scraper | ⭐⭐⭐⭐⭐ | Sitemap、瀏覽器 | CSV、JSON | 使用者引導 | 免費(本機) | 新手、小型任務 |
| Mozenda | ⭐⭐⭐ | 雲端、託管、合規 | CSV、API、資料庫 | GDPR、CCPA | 每月 500 美元以上 | 企業、託管服務 |
| SimpleIndex | ⭐⭐⭐ | OCR、網頁、文件 | 資料庫、DMS | 使用者引導 | 一次性 500 美元 | 文件 + 網頁資料 |
| Datastreamer | ⭐⭐ | 即時、API | JSON、API | 使用者引導 | 訂閱制 | 媒體、新聞、研究 |
| FMiner | ⭐⭐⭐ | 視覺化流程、Python | CSV、資料庫 | 使用者引導 | 一次性 168 美元 | 複雜、視覺化流程 |
| G2 Webscraper | ⭐⭐⭐⭐⭐ | 簡單、瀏覽器 | CSV、JSON | 使用者引導 | 免費/不一 | 簡單好用、快速見效 |
前面列出的其中兩款工具,現在已經不再納入清單。Visual Web Ripper 自 2018 年起就沒再由 Sequentum 維護,而 Content Grabber 的網站目前顯示 404,產品線也已被 Sequentum Cloud 取代。如果你打算把工作流程建立在這兩者之上,務必要先確認它們現在是否還能正常使用。
如何為你的企業選擇合適的內容爬取工具
選工具的關鍵,就是把你的需求和工具的強項對上。以下是我快速整理的檢查清單:
- 先定義使用情境: 一次性任務還是長期持續?規模小還是很大?資料是公開的還是需要登入?
- 對照團隊技能: 不會寫程式的人可以先從 Thunderbit、Octoparse、ParseHub 或 WebHarvy 開始。開發者則可以直接進入 Scrapy 或 Apify。
- 確認匯出需求: 需要 Excel、Sheets,還是 API 整合?務必確認工具有支援。
- 考量合規性: 如果你在受監管產業,或要爬取個資,請優先選擇有合規功能的工具(例如 Import.io、Mozenda)。
- 先從小規模測試: 先用免費方案或試用,在真實資料上測試後再決定。
- 提前想好未來: 你的需求是否會成長?選一款能隨你一起擴充的工具。
也別忘了:有時候最簡單的工具反而最適合。若你只是想快速做出一份試算表,不必把事情搞得太複雜。
資料隱私與合規:你需要注意什麼
網頁爬取能打開很多可能性,但也伴隨責任。想合法且符合最佳實務,可以這樣做:
- 尊重 robots.txt 與網站政策: 先確認網站是否允許爬取,並遵守其規範。
- 除非有正當理由與同意,否則避免擷取個資: GDPR 和 CCPA 不是開玩笑的。
- 不要過度轟炸伺服器: 使用內建限速、延遲與排程,避免被封鎖,也算是對網路負責。
- 若產業敏感,請使用具合規功能的工具: Import.io 與 Mozenda 都是以 GDPR/CCPA 為設計考量。
- 保留操作紀錄: 特別是商業或受監管用途,請記錄你擷取了什麼、為什麼擷取。
有倫理的爬取,才是可持續的爬取,也能讓你的業務遠離風險。
結論:用對內容爬取工具,讓團隊戰力全面升級
網路就是你企業最大的、也最混亂的資料庫——只要有對的內容爬取工具,你終於能把它真正用起來。不管你是要建立名單、追蹤競品,還是餵養即時儀表板,這 18 款工具幾乎涵蓋了所有情境、技能層級與預算範圍。
如果你想最快看到成果,Thunderbit 是我最推薦給商務使用者的選擇:AI 驅動、免程式碼,幾分鐘內就能把任何網站變成結構化資料集。不過,不論你的需求是什麼,先試用免費方案、實際測試,看看哪一款最適合你的工作流程。
下載 Thunderbit Chrome 擴充功能 安裝後打開你需要的頁面,點一下就好。Email、電話號碼與圖片提取器在所有方案中都免費。 Get Started Free
準備好告別複製貼上的苦工了嗎?下載 Thunderbit Chrome 擴充功能,親自感受網頁資料可以有多簡單。如果你想更深入了解網頁爬取,也可以到 Thunderbit Blog 看更多指南、技巧與教學。
試用 Thunderbit AI 網頁爬蟲 Get Started Free
常見問題
1. 什麼是內容爬取工具?它和一般網頁爬蟲有什麼不同?
內容爬取工具是一種專門用來自動從網站擷取結構化資料的網頁爬蟲。雖然所有網頁爬蟲都能抓資料,但內容爬取工具通常還具備排程、子頁面導覽、AI 欄位辨識,以及與商業流程整合等功能,因此對企業團隊來說更強大也更好上手。
2. 哪一款內容爬取工具最適合非技術使用者?
Thunderbit、Octoparse、ParseHub、Data Miner 和 WebHarvy 都很適合不寫程式的人。Thunderbit 的 AI 簡化流程與可直接匯出到 Excel、Sheets、Airtable 或 Notion 的能力,特別突出。
3. 我要如何確保網頁爬取合法且合規?
務必遵守網站條款、robots.txt,以及 GDPR 和 CCPA 這類隱私法規。除非你有正當理由與明確同意,否則避免擷取個資。若產業較敏感,請選擇內建合規功能的工具,例如 Import.io 或 Mozenda。
4. 這些工具能處理有 JavaScript 或無限捲動的動態網站嗎?
可以——像 Thunderbit、Octoparse、ParseHub、Apify 和 FMiner 都能處理動態內容、無限捲動與多層導覽。有些複雜網站可能需要額外設定或使用雲端執行。
5. 為企業挑選內容爬取工具時,我該考慮什麼?
請考慮團隊的技術能力、資料需求規模、匯出/整合需求、合規考量與預算。先從免費方案或試用開始,並在實際使用情境中測試,再做決定。
祝你爬取順利,願你的資料永遠新鮮、結構清楚,且隨時可用。
延伸閱讀




