看著一段腳本俐落地穿梭網站,在您喝咖啡的同時把資料一筆筆抓下來,總有種莫名療癒的感覺。若您跟我一樣,大概也曾想過:「怎麼才能讓網頁爬蟲更快、更聰明,而且沒那麼折騰?」
這正是我踏入 OpenClaw 網頁爬蟲世界的原因。在數位環境中, 超過 90% 的企業都依賴網頁資料擷取,用途從銷售名單到市場情報都有;掌握對的工具,不只是炫技,而是企業必需。
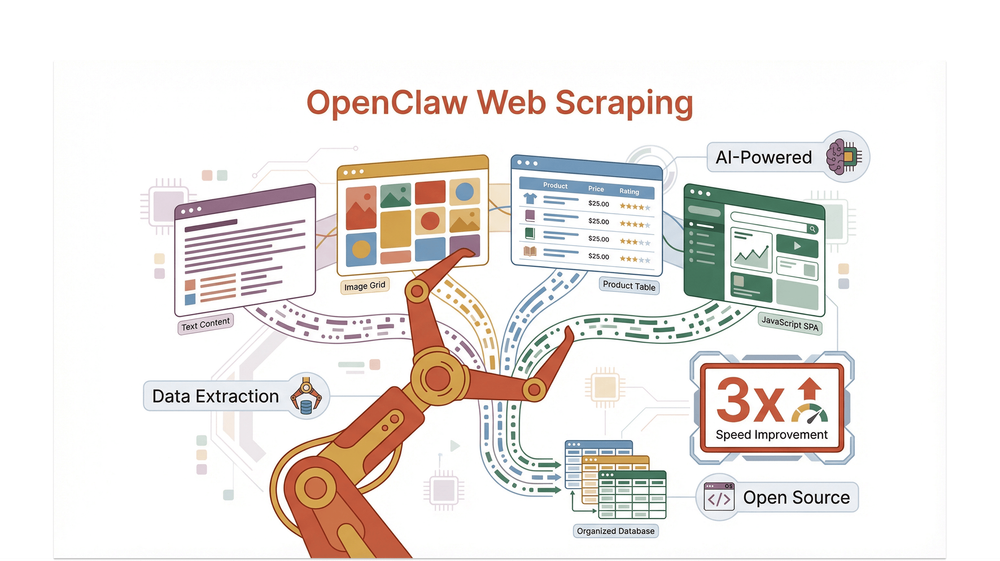
OpenClaw 近來已成為爬蟲社群的熱門選擇,特別適合處理動態、圖片密集或結構複雜的網站;這類網站常常讓傳統爬蟲吃不消。
在這篇指南裡,我會帶您從 OpenClaw 的安裝設定,一路走到進階自動化工作流程。更重要的是,身為時間管理控,我也會示範如何結合 Thunderbit 的 AI 功能,讓您的爬取流程不只強大,還真的用起來很有趣。
什麼是 OpenClaw 網頁爬蟲?
先從基礎說起。OpenClaw 網頁爬蟲,指的是使用 OpenClaw 平台——一個自架式、開源的 agent gateway——來自動擷取網站資料。OpenClaw 不只是另一個爬蟲;它是一套模組化系統,能把您常用的聊天管道(如 Discord 或 Telegram)連接到一組 agent 工具,包括網頁擷取器、搜尋工具,甚至還有託管瀏覽器,專門應付那些讓其他工具頭痛的 JavaScript 重度網站。
OpenClaw 為什麼在網頁資料擷取領域特別突出?因為它兼具彈性與穩定性。您可以用內建工具像 web_fetch 做簡單的 HTTP 擷取,也可以啟動由 agent 控制的 Chromium 瀏覽器處理動態內容,或是接上社群打造的技能(例如 openclaw-plugin-web-scraper)來執行更進階的流程。它是開源的(採用 MIT 授權)、持續維護,而且插件與技能生態相當活躍,對任何認真想大規模爬取資料的人來說,都是頂級選擇。
OpenClaw 能處理非常多樣的資料型態與網站格式,包括:
- 文字與結構化 HTML
- 圖片與媒體連結
- 由 JavaScript 渲染的動態內容
- 複雜、多層的 DOM 結構
而且因為它是 agent 驅動,您可以協調爬取任務、自動化報告,甚至即時與資料互動——全部都能在您最熟悉的聊天應用或終端機中完成。
為什麼 OpenClaw 是網頁資料擷取的強大工具
那麼,為什麼這麼多資料專業人士和自動化愛好者都湧向 OpenClaw?讓我們拆解一下它讓人驚豔的技術優勢:
速度與相容性
OpenClaw 的架構就是為速度而生。其核心 web_fetch 工具利用 HTTP GET 請求搭配智慧內容擷取、快取與重新導向處理。在內部與社群基準測試中,OpenClaw 在從靜態與半動態網站擷取大量資料時,表現持續優於 BeautifulSoup 或 Selenium 等舊工具(docs.openclaw.ai)。
但 OpenClaw 真正厲害的地方在於相容性。透過託管瀏覽器模式,它能處理依賴 JavaScript 進行渲染的網站——這正是許多傳統爬蟲常卡關的地方。不管您面對的是圖片豐富的電商目錄,還是帶有無限捲動的單頁應用,OpenClaw 透過 agent 控制的 Chromium 設定都能把事情完成。
對網站變動的韌性
網頁爬蟲最大的痛點之一,就是網站更新後腳本跟著失效。OpenClaw 的插件與技能系統在設計上就強調韌性。舉例來說,圍繞 Scrapling 函式庫的封裝支援自適應擷取,這代表即使網站版面改了,您的爬蟲仍可「重新定位」元素——對長期專案來說非常有價值。
真實世界表現
在並排測試中,基於 OpenClaw 的工作流程展現出:
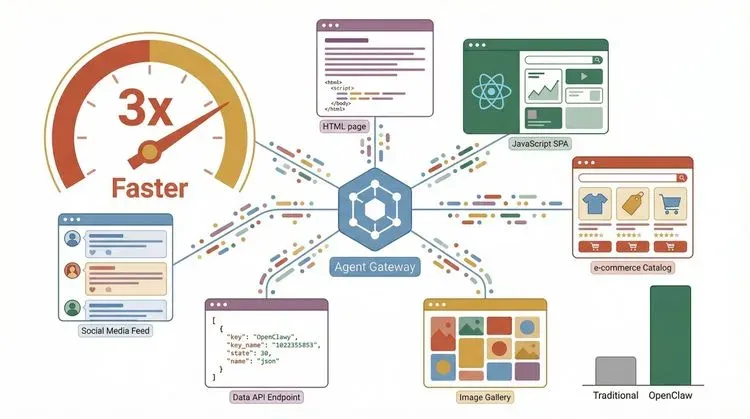
- 在複雜、多頁網站上,擷取速度比傳統 Python 爬蟲快 最高 3 倍(scrapling.readthedocs.io)
- 由於有託管瀏覽器,處理動態、JavaScript 重度頁面的成功率更高
- 對混合內容頁面(文字、圖片、HTML 片段)有更好的處理能力
使用者回饋經常提到 OpenClaw 能在其他工具失手的地方「直接可用」——特別是在面對版面刁鑽或有反機器人機制的網站時,更是明顯。
開始前:為網頁爬蟲設定 OpenClaw
準備好了嗎?以下是如何在您的系統上把 OpenClaw 建起來並開始運作。
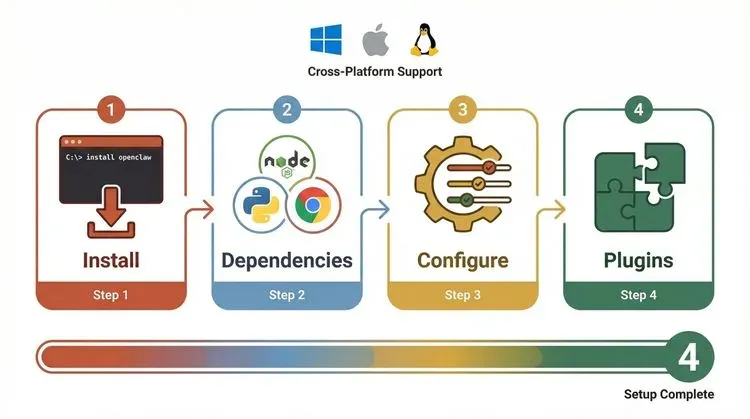
步驟 1:安裝 OpenClaw
OpenClaw 支援 Windows、macOS 與 Linux。官方文件建議先從引導式上手流程開始:
openclaw onboard
這個指令會帶您完成初始設定,包括環境檢查與基本配置。
步驟 2:安裝必要依賴
依您的工作流程不同,您可能需要:
- Node.js(核心 gateway 使用)
- Python 3.10+(給使用 Python 的插件/技能,例如 Scrapling 封裝)
- Chromium/Chrome(託管瀏覽器模式使用)
在 Linux 上,您可能還需要安裝額外套件來支援瀏覽器。文件中有一個專門的疑難排解章節處理常見問題。
步驟 3:設定網頁工具
先設定您的網頁搜尋供應商:
openclaw configure --section web
這樣您就可以從 Brave、DuckDuckGo 或 Firecrawl 等供應商中選擇。
步驟 4:安裝插件或技能(可選)
如果想解鎖進階爬取能力,可以安裝社群插件或技能。例如,要加入 openclaw-plugin-web-scraper:
git clone https://github.com/hvkeyn/openclaw-plugin-web-scraper.git
cd openclaw-plugin-web-scraper
openclaw plugins install .
openclaw gateway restart
新手小技巧
- 安裝新插件後先執行
openclaw security audit,檢查是否有安全漏洞(docs.openclaw.ai)。 - 如果您透過 nvm 使用 Node,記得檢查 CA 憑證;不一致可能會導致 HTTPS 請求失敗(docs.openclaw.ai)。
- 為了額外安全性,務必在 VM 或容器中隔離插件與瀏覽器元件。
新手指南:您的第一個 OpenClaw 爬取專案
讓我們做一個簡單的爬取專案——不需要電腦科學博士學位。
步驟 1:選擇目標網站
挑一個有結構化資料的網站,例如商品列表或目錄。這個例子裡,我們要從一個示範電商頁面爬取商品標題。
步驟 2:理解 DOM 結構
使用瀏覽器的「檢查元素」工具,找出包含您想要資料的 HTML 標籤(例如 <h2 class="product-title">)。
步驟 3:設定擷取條件
透過 OpenClaw 基於 Scrapling 的技能,您可以使用 CSS 選擇器指定元素。以下是一段使用 openclaw-ultra-scraping 技能的範例腳本:
PYTHON=/opt/scrapling-venv/bin/python3
$PYTHON scripts/scrape.py fetch "https://example.com/products" --css "h2.product-title::text"
這個指令會抓取頁面並擷取所有商品標題。
步驟 4:安全處理資料
將結果匯出為 CSV 或 JSON,方便後續分析:
$PYTHON scripts/scrape.py fetch "https://example.com/products" --css "h2.product-title::text" -f csv -o products.csv
重點概念說明
- 工具 schema: 定義每個工具或技能能做什麼(擷取、抽取、爬行)。
- 技能註冊: 透過 ClawHub 或手動安裝,將新的爬取能力加入 OpenClaw。
- 安全資料處理: 在投入正式環境前,務必驗證並清理輸出內容。
使用 OpenClaw 自動化複雜爬取工作流程
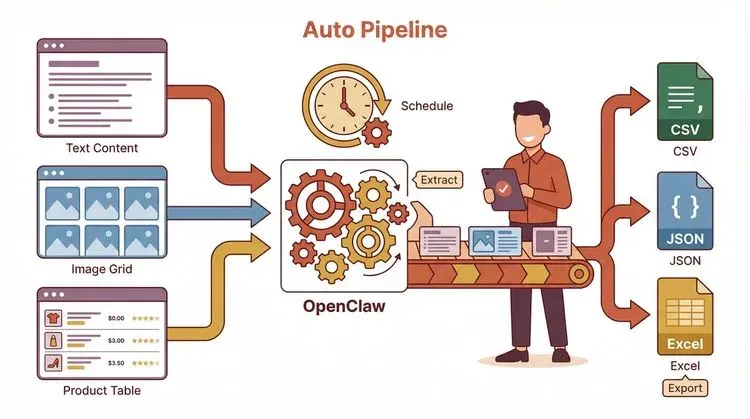
當您掌握基礎之後,就該開始自動化了。以下教您如何打造一個會自己跑的工作流程(而您可以專心做更重要的事——例如吃午餐)。
步驟 1:建立並註冊自訂技能
撰寫或安裝符合您特定擷取需求的技能。舉例來說,您可能想爬取商品資訊與圖片,接著每天自動寄出報告。
步驟 2:設定排程任務
在 Linux 或 macOS 上,可使用 cron 來排程您的爬取腳本:
0 6 * * * /usr/bin/python3 /path/to/scrape.py fetch "https://example.com/products" --css "h2.product-title::text" -f csv -o /data/products_$(date +\%F).csv
在 Windows 上,則可使用工作排程器搭配類似參數。
步驟 3:與其他工具整合
如果需要動態導覽(例如點擊按鈕或登入),可以將 OpenClaw 與 Selenium 或 Playwright 結合。許多 OpenClaw 技能都能呼叫這些工具,或接受瀏覽器自動化腳本。
手動與自動化工作流程比較
| 步驟 | 手動工作流程 | 自動化 OpenClaw 工作流程 |
|---|---|---|
| 資料擷取 | 手動執行腳本 | 透過 cron/工作排程器排程執行 |
| 動態導覽 | 手動點擊 | 透過 Selenium/技能自動化 |
| 資料匯出 | 複製貼上或下載 | 自動匯出為 CSV/JSON |
| 報告 | 手動摘要 | 自動產生並寄送報告 |
| 錯誤處理 | 邊做邊修 | 內建重試/記錄機制 |
結果呢?更多資料、更少苦工,以及能隨您的目標一起擴展的工作流程。
提升效率:將 Thunderbit 的 AI 爬取功能與 OpenClaw 整合
接下來就是最有意思的部分。身為 Thunderbit 的共同創辦人,我非常相信把兩者優勢結合起來:OpenClaw 靈活的爬取引擎,加上 Thunderbit 的 AI 欄位偵測與匯出能力。
Thunderbit 如何強化 OpenClaw
- AI 建議欄位: Thunderbit 能自動分析網頁,推薦最適合擷取的欄位,從此不必再猜 CSS 選擇器。
- 即時資料匯出: 一鍵即可將爬取的資料直接匯出到 Excel、Google Sheets、Airtable 或 Notion(Thunderbit 文件)。
- 混合式工作流程: 使用 OpenClaw 處理複雜導覽與爬取邏輯,再把結果串接到 Thunderbit 進行欄位對應、補強與匯出。
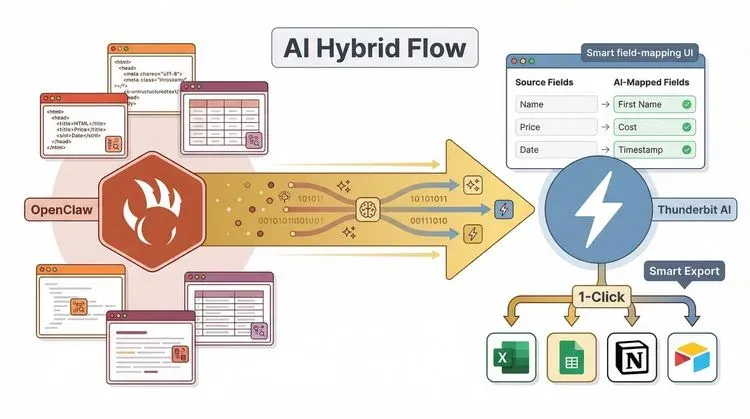
混合式工作流程範例
- 使用 OpenClaw 的託管瀏覽器或 Scrapling 技能,從動態網站擷取原始資料。
- 將結果匯入 Thunderbit。
- 點擊「AI 建議欄位」自動對應資料。
- 匯出到您偏好的格式或平台。
這種組合對需要兼顧強大功能與易用性的團隊來說是顛覆性的——像是銷售營運、電商分析師,以及任何受夠凌亂試算表的人。
即時疑難排解:常見 OpenClaw 錯誤與修復方式
再好的工具偶爾也會卡關。以下是快速診斷與修復常見 OpenClaw 爬取問題的指南:
常見錯誤
- 驗證問題: 有些網站會封鎖機器人或要求登入。可使用 OpenClaw 的託管瀏覽器,或與 Selenium 整合處理登入流程(docs.openclaw.ai)。
- 請求被阻擋: 可輪換 user agent、使用代理,或降低請求頻率以避免被封鎖。
- 解析失敗: 重新確認您的 CSS/XPath 選擇器;網站結構可能已變更。
- 插件/技能錯誤: 執行
openclaw plugins doctor,診斷已安裝擴充功能的問題(docs.openclaw.ai)。
診斷指令
openclaw status– 檢查 gateway 與工具狀態。openclaw security audit– 掃描安全漏洞。openclaw browser --browser-profile openclaw status– 檢查瀏覽器自動化健康狀況。
社群資源
可靠且可擴展的 OpenClaw 爬取最佳實踐
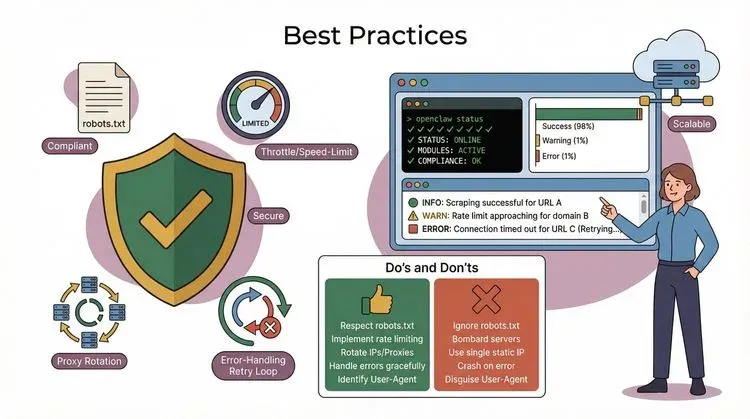
想讓您的爬取流程順暢又可持續?這是我的檢查清單:
- 尊重 robots.txt: 只爬取您被允許的內容。
- 控制請求頻率: 避免每秒送出過多請求而壓垮網站。
- 驗證輸出: 永遠檢查資料是否完整且正確。
- 監控使用情況: 記錄爬取執行過程,留意錯誤或封鎖訊號。
- 規模化時使用代理: 輪換 IP 以避免速率限制。
- 部署到雲端: 若是大型任務,建議在 VM 或容器化環境中執行 OpenClaw。
- 優雅處理錯誤: 在腳本中加入重試與備援邏輯。
| 該做的事 | 不該做的事 |
|---|---|
| 使用官方插件/技能 | 盲目安裝不受信任的程式碼 |
| 定期執行安全稽核 | 忽略漏洞警告 |
| 上線前先在測試環境驗證 | 爬取敏感或私人資料 |
| 文件化您的工作流程 | 依賴硬編碼選擇器 |
進階技巧:為獨特需求自訂與延伸 OpenClaw
如果您已經準備好進入進階玩家模式,OpenClaw 也允許您為特殊任務打造自訂技能與插件。
開發自訂技能
- 依照 OpenClaw 技能 SDK 文件 建立新的擷取工具。
- 可使用 Python 或 TypeScript,視您最熟悉的語言而定。
- 將您的技能註冊到 ClawHub,方便分享與重複使用。
進階功能
- 技能串接: 把多個擷取步驟組合起來(例如先爬列表頁,再逐一造訪詳情頁)。
- 無頭瀏覽器: 使用 OpenClaw 的託管 Chromium,或與 Playwright 整合處理 JavaScript 重度網站。
- AI agent 整合: 連接外部 AI 服務,讓資料解析或補強更聰明。
錯誤處理與上下文管理
- 在您的技能中加入穩健的錯誤處理(Python 的 try/except,或 TypeScript 的 error callback)。
- 使用 context 物件在爬取步驟之間傳遞狀態。
想找靈感,可看看社群投稿技能以及 Scrapling API 參考。
結論與重點整理
從安裝 OpenClaw、執行您的第一次爬取,到利用 Thunderbit 建立自動化混合工作流程,我們已經涵蓋了很多內容。希望您能記住以下幾點:
- OpenClaw 是一個靈活、開源的強大工具,特別適合在複雜或動態網站上進行網頁資料擷取。
- 其插件/技能生態系讓您能處理一切,從簡單擷取到進階多步驟爬取都沒問題。
- 把 OpenClaw 與 Thunderbit 的 AI 功能結合,能讓欄位對應、資料匯出與流程自動化變得輕鬆許多。
- 保持安全與合規: 稽核您的環境、尊重網站規則,並驗證您的資料。
- 別害怕實驗: OpenClaw 社群活躍又友善——勇敢加入、嘗試新技能,並分享您的成果。
如果您想把爬取效率再往上推,Thunderbit 隨時能幫上忙。若您想繼續學習,也可以到 Thunderbit Blog 看更多深度解析與實用指南。
祝您爬取順利——願您的選擇器總能精準命中。
常見問題
1. OpenClaw 和 BeautifulSoup 或 Scrapy 這類傳統網頁爬蟲有什麼不同?
OpenClaw 是以 agent gateway 形式打造,具備模組化工具、託管瀏覽器支援,以及插件/技能系統。這讓它在動態、JavaScript 重度或圖片豐富的網站上更有彈性,也比傳統那種高度依賴程式碼的框架更容易自動化端到端流程(docs.openclaw.ai)。
2. 如果我不是開發者,也能使用 OpenClaw 嗎?
可以!OpenClaw 的上手流程與插件生態都很適合新手。若是更複雜的任務,您可以使用社群建立的技能,或把 OpenClaw 與像 Thunderbit 這類免寫程式工具結合,輕鬆完成欄位對應與匯出。
3. 我該如何排解常見的 OpenClaw 錯誤?
先從 openclaw status 與 openclaw security audit 開始。若是插件問題,使用 openclaw plugins doctor。也可以查閱官方文件與 GitHub issues 尋找常見問題的解法。
4. 使用 OpenClaw 進行網頁爬蟲安全又合法嗎?
和任何爬蟲一樣,務必遵守網站服務條款與 robots.txt。OpenClaw 是開源且本機執行的,但您仍應稽核插件安全性,並避免在未經允許的情況下爬取敏感或私人資料(github.com)。
5. 要怎麼把 OpenClaw 與 Thunderbit 結合,取得更好的結果?
先用 OpenClaw 處理複雜的爬取邏輯,再把原始資料匯入 Thunderbit。Thunderbit 的 AI 建議欄位會自動對應資料,而您可以直接匯出到 Excel、Google Sheets、Notion 或 Airtable,讓整個工作流程更快也更穩定(Thunderbit 文件)。
想看看 Thunderbit 如何升級您的爬取流程嗎?下載 Chrome 擴充功能並立即開始打造更聰明的混合式工作流程。別忘了也去看看 Thunderbit YouTube 頻道,裡面有實作教學和技巧分享。
試用 Thunderbit,讓網頁爬蟲更聰明 Get Started Free
延伸閱讀