
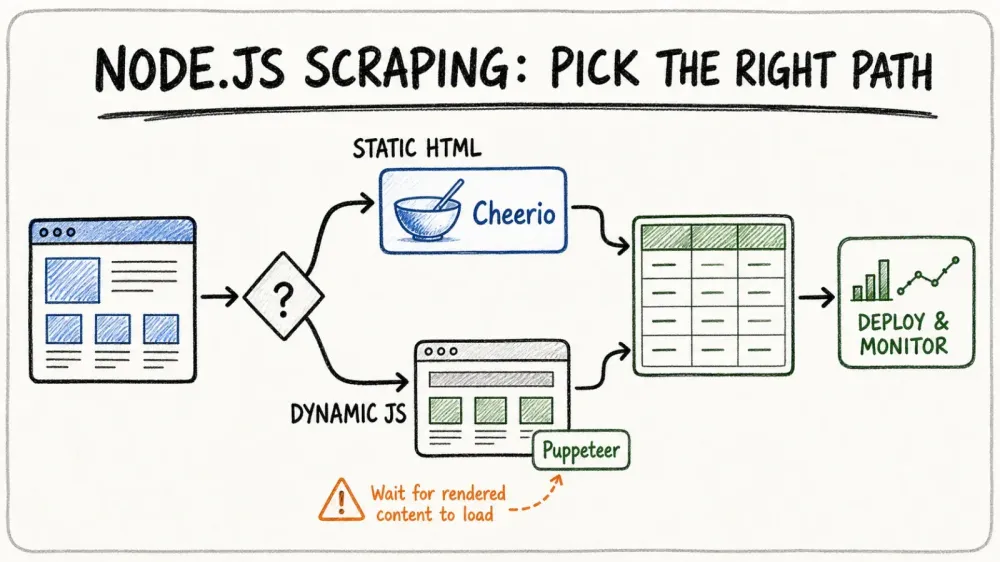
網路世界對資料的渴求比以往更高,而到了 2026 年,Node.js 正站在最前線,幫助團隊用更聰明的方式抓取資料,而不是一味硬拼。無論你是做業務、電商,還是像我一樣熱愛資料的技術控,大概都已經發現:爬蟲不再只是「把資料抓回來」而已——重點是要快、要能擴充,而且還不能讓你的 IP 被關進數位黑牢。這股需求也沒有放緩的跡象——公開網頁資料早已悄悄成為現代團隊建構各種應用的基礎,從價格情報到 LLM 訓練流程都少不了它,競爭與門檻也前所未有地高。
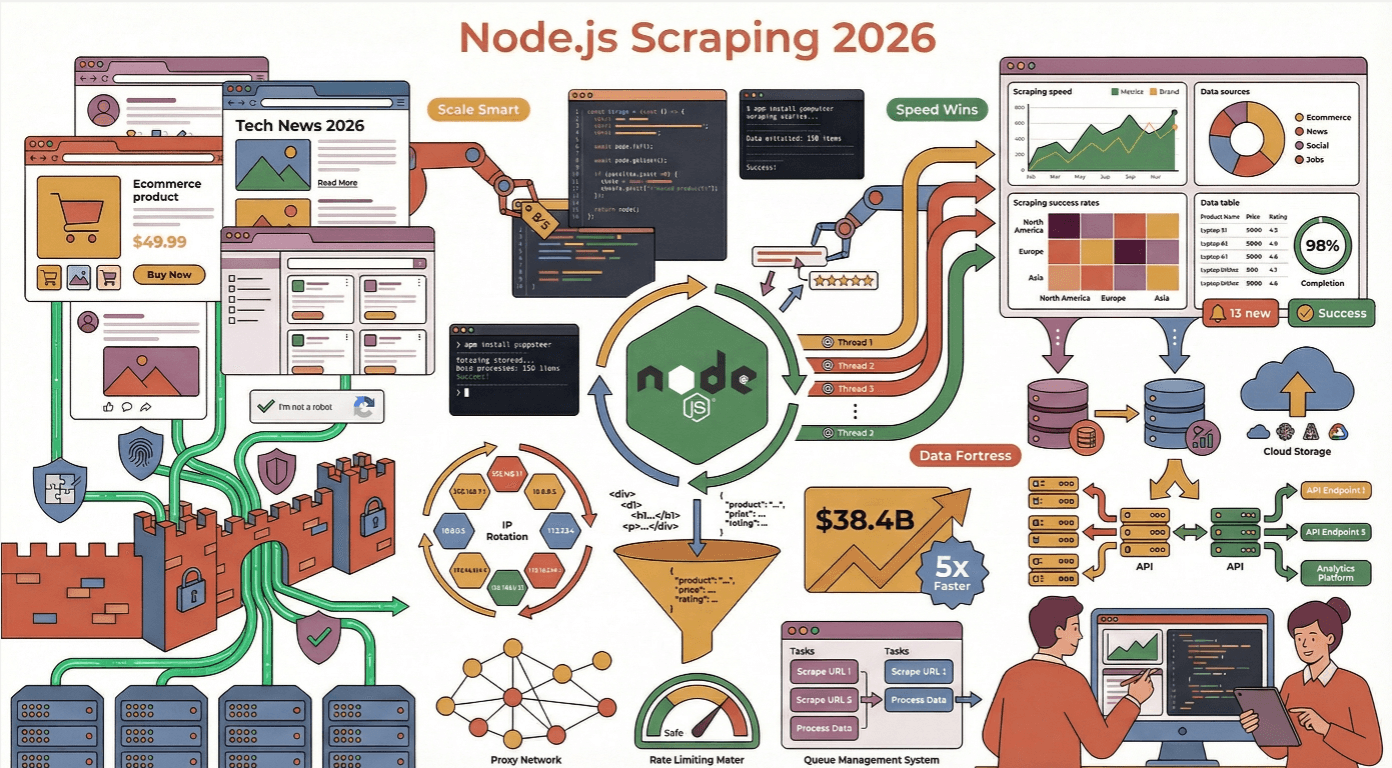
但問題是:現代網站就像一座堡壘,裡面充滿動態內容、防機器人陷阱,以及不停變動的版面。我看過太多爬蟲不是當場崩掉,就是跑沒多久就陣亡——通常都是因為忽略了最佳實務,或低估了反爬防線有多聰明。所以,接下來我們就來談談 Node.js 網頁爬蟲效率的實戰最佳做法,順便穿插一些真實經驗、幾個小笑話,以及大量可直接上手的建議。
為什麼選擇 Node.js 來提升網頁爬蟲效率?
如果你曾經嘗試一次抓幾百甚至幾千個頁面,就會知道速度與並行能力就是一切。這正是 Node.js 的強項。它的非同步、非阻塞 I/O 模型天生就適合處理大量同時發出的網路請求——你可以把它想成網路世界裡的終極多工高手(Node.js Docs)。其他語言可能還卡在等請求回應,Node.js 則會持續轉動事件迴圈,把各種請求像嗑了咖啡因的馬戲團表演者一樣一把接一把地接住。
我也看過 Node.js 在需要即時更新與大規模擷取的情境中,表現超越 Python 和 Java,尤其是在目標網站大量依賴 JavaScript 時。事實上,約 40% 的開發者 現在都把 Node.js 用在後端與自動化工作上,使它成為全球最受歡迎的網頁技術之一。
Node.js 與其他網頁爬蟲框架相比如何?
讓我們稍微 geek 一下。以下是 Node.js 與其他方案的比較:
| 框架 | 優勢 | 劣勢 | 最佳使用情境 |
|---|---|---|---|
| Node.js | 非同步、併發能力強、npm 生態龐大、原生 JS 適合動態網站 | 可能較吃記憶體、若不用 async/await 容易陷入 callback 地獄 | 即時爬取、JavaScript 密集型網站、可擴充的微服務 |
| Python | 爬蟲函式庫多(BeautifulSoup、Scrapy)、語法簡單 | 大量併發時較慢、處理 JS 渲染網站較吃力 | 靜態 HTML、研究、原型開發 |
| Java | 型別系統強、企業級穩定 | 語法冗長、不太適合快速腳本 | 大規模、企業級爬取 |
| Go | 速度快、併發效率高 | 生態較小、學習門檻較高 | 高效能、低延遲爬取 |
對多數商業使用者來說,Node.js 取得了很好的平衡:速度快、彈性高,而且非常適合現代、以 JavaScript 驅動的網站(Thunderbit Blog)。
建立穩健的 Node.js 網頁爬蟲環境
好的爬蟲,從穩固的基礎開始。以下是我最常用的配置:
- 專案結構: 模組化處理。可使用
/src、/libs、/config這類資料夾。敏感資訊(API key、代理伺服器)建議用dotenv放在環境變數中(Thunderbit Guide)。 - HTTP 用戶端: 請求可用 axios、got 或 node-fetch。
- HTML 解析: 靜態 HTML 用 Cheerio,動態內容則用 Puppeteer 或 Playwright。
- 工具函式: 用 Lodash 做資料整理,用 validator.js 或 Joi 做資料驗證。
- 測試與 Lint: 用 Mocha 寫測試,ESLint 維持程式碼品質(LogRocket)。
必備的 Node.js 網頁爬蟲函式庫
- HTTP 用戶端(axios / got / 內建
fetch): 負責發送請求。先提醒一下:自 Node.js v18 起,你就可以直接使用原生fetch,不需要另外安裝套件,而 Node.js v22 也已將它標記為穩定版。若你在較新的 Node 版本上開發新專案,其實大多不必再裝node-fetch——直接呼叫fetch就行。我自己仍然常用 axios,因為我想要攔截器、自動處理 JSON,以及在 Node 與瀏覽器之間一致的 promise API;而 got 則是我在需要重試、串流或原生 HTTP/2 時的首選。選最符合你技術棧的即可;若只是快速腳本,原生fetch就很夠用。 - Cheerio: 快速、類 jQuery 的 HTML 解析器。非常適合靜態頁面,解析速度約 0.5 秒(Oxylabs)。
- Playwright / Puppeteer: 用於自動化無頭瀏覽器,處理動態、JavaScript 密集型網站。速度較慢(每頁約 4 秒),但對於頁面載入後才出現內容的網站不可或缺(Bright Data)。如果你打算在 2026 年從零開始,Playwright 會是預設首選——開箱即支援跨瀏覽器(Chromium / Firefox / WebKit)、內建 trace 檢視器,而且最早打造 Puppeteer 的團隊現在也在 Microsoft 主導它。Puppeteer 仍適合只做 Chrome 的工作,但從近期 release note 來看,更新重心比較偏向 Chrome 相容性修正,而不是新增能力。
- dotenv: 管理環境變數。
- csv-writer/jsonfile: 匯出資料用。
避開常見的 Node.js 網頁爬蟲陷阱
我已經數不清看過多少次爬蟲被封鎖、當機,或是吐出一堆亂七八糟的資料。以下幾點特別要注意:
- 忽略 robots.txt 與服務條款: 在爬取前一定要先確認。違反規範可能讓你的 IP 被封,甚至惹上法律麻煩(ScraperAPI)。
- 對伺服器過度施壓: 不要狂刷請求。請用隨機延遲(1–3 秒)來節流,搭配併發控制,別像過動機器人一樣亂衝(ScrapeGraphAI)。
- 沒有處理錯誤: 請求一定要包在 try/catch 裡,處理 HTTP 錯誤,並記錄失敗原因。對暫時性錯誤可使用指數退避重試(ScrapeGraphAI)。
- 忘記設定請求標頭: 使用真實感較高的 User-Agent,並輪替它。再加上 Accept-Language、Referer 等標頭,模擬真實瀏覽器行為(ScrapeGraphAI)。
如何繞過反爬機制
現代網站幾乎都配備了各式各樣的防機器人技術。以下是我避開這些數位地雷的方法:
- 輪替代理與 IP: 使用代理池並輪換 IP,避免被封鎖(Medium)。
- 隨機化標頭: 每次請求都輪替 User-Agent、Accept-Language 和其他標頭。
- 無頭瀏覽器隱匿: 使用
puppeteer-extra-plugin-stealth這類外掛,降低自動化痕跡。 - 模擬真人行為: 加入隨機延遲、滑鼠移動、捲動,甚至打字錯誤(ZenRows)。
在 Node.js 爬蟲中模擬真人行為
這部分最有趣,也有點怪。不要一點進去就立刻點擊與捲動,而是讓爬蟲這樣做:
- 在每個動作之間等待隨機時間(
await page.waitForTimeout(randomDelay)) - 讓滑鼠以小幅、帶些抖動的方式移動(
page.mouse.move(x, y)) - 打字時加入隨機延遲,偶爾出錯再修正(
page.type(selector, text, {delay: random(100,200)})) - 捲動時不要一口氣到底,而是以不規則方式移動
這些技巧能顯著提升你在受保護網站上的成功率(ScraperAPI)。
用 Thunderbit 簡化複雜資料擷取
使用 AI 從任何網站抓取資料 跳過樣板程式:Thunderbit 的 agentic 網頁爬蟲可讀懂任何頁面,一鍵擷取資料,完全不需要維護 Node.js 程式碼。 Get Started Free
現在來談談大家心裡那隻大象:爬蟲很難。但其實不一定要那麼難。這也是我們打造 Thunderbit 的原因。
Thunderbit 是一款 agentic 網頁爬蟲 Chrome 擴充功能,讓你能用自然語言從任何網站擷取資料。只要點一下「One Click Extract」,讓 AI 自行判讀頁面內容,再按下「Scrape」即可。它就像一位不睡覺、也不會跟你加薪的初級工程師。
更棒的是,Thunderbit 還提供 API,可以直接接到你的 Node.js 工作流程中。你不用再寫成千上萬行爬蟲程式,而是讓 Thunderbit 處理最麻煩的部分——動態內容、子頁面、分頁,全都交給它。你只要把結構化資料匯出成 CSV、JSON,或直接送到 Google Sheets、Airtable、Notion,就能繼續你的工作(Thunderbit Blog)。
免費試用 Thunderbit Chrome 擴充功能 安裝免費 Chrome 擴充功能,一鍵擷取結構化資料,或從你的 Node.js 應用程式直接呼叫 Thunderbit 的 API。 Get Started Free
Thunderbit 與傳統 Node.js 爬蟲的比較
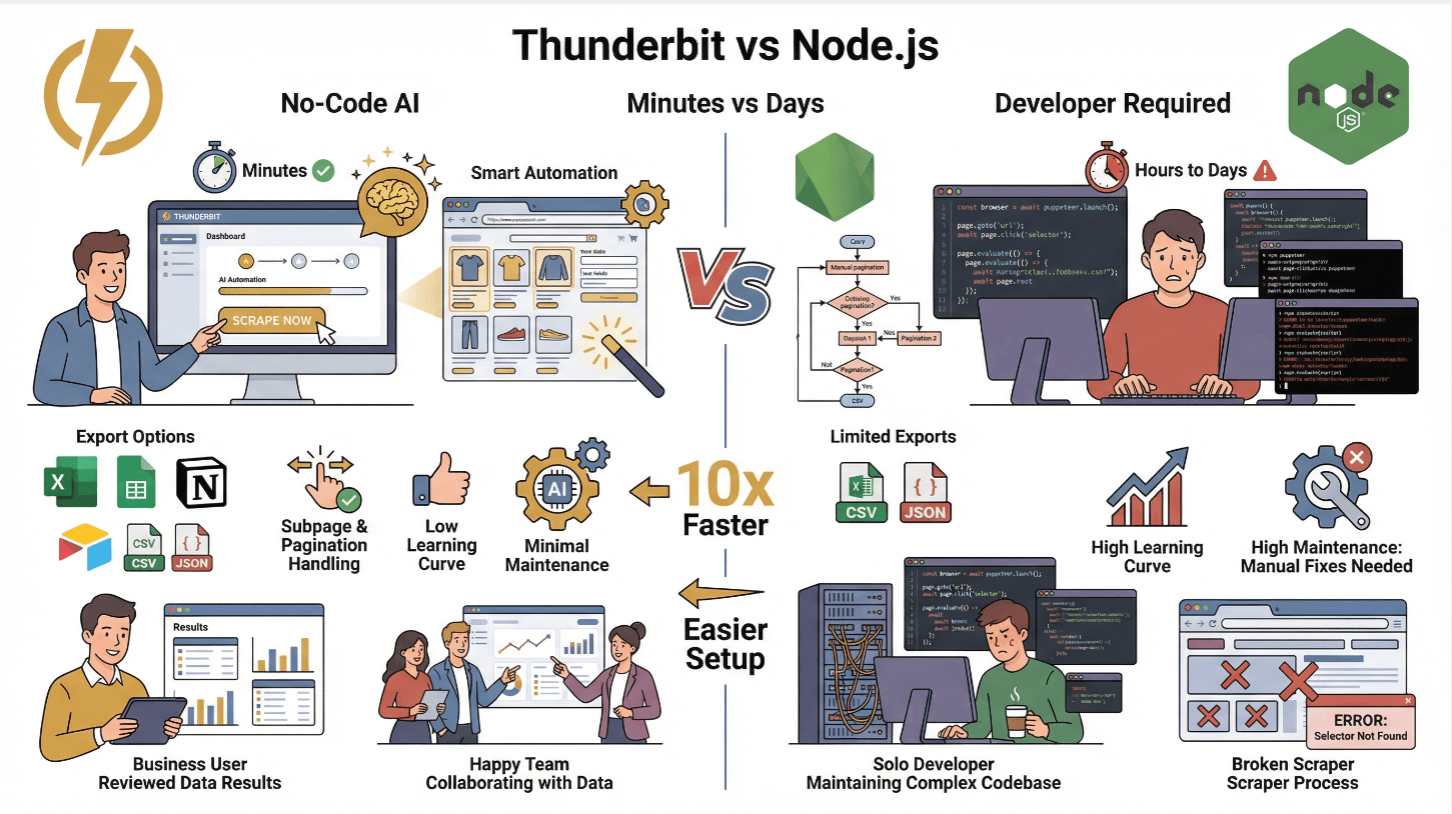
| 功能 | Thunderbit | 傳統 Node.js 爬蟲 |
|---|---|---|
| 設定時間 | 幾分鐘(免寫程式) | 幾小時到幾天(撰寫、測試) |
| 處理動態內容 | 可以(AI + 瀏覽器) | 可以(需使用 Puppeteer/Playwright) |
| 子頁面與分頁 | 一鍵完成 | 需要手動撰寫程式 |
| 資料匯出 | Excel、Sheets、Notion、Airtable、CSV、JSON | CSV/JSON(自訂程式) |
| 學習門檻 | 低(業務使用者可上手) | 高(開發者導向) |
| 維護成本 | 低(AI 可自我適應) | 高(網站一改版就得手動修) |
Thunderbit 非常適合非技術團隊,或任何想跳過苦工、直接聚焦洞察的人。對進階使用者來說,也能透過 Thunderbit 的 API 大規模自動化爬取(Thunderbit Docs)。
結合 Cheerio 與 Puppeteer 處理動態內容
這是我最喜歡的 Node.js 爬蟲黃金組合。做法如下:
- 先用 Puppeteer 載入頁面並執行 JavaScript(等待
networkidle,確保內容都載入完)。 - 擷取 HTML,用
await page.content()取得完整頁面內容。 - 交給 Cheerio 解析:把 HTML 餵給 Cheerio,快速進行類 jQuery 風格的解析與資料擷取。
這種混合式做法能同時享有兩邊優點:Puppeteer 負責動態內容,Cheerio 負責快速解析(Browserless)。
效能小提醒: 只選取你真正需要的元素。Cheerio 會把整個 DOM 載入記憶體,因此避免使用過於寬泛的選擇器;如果你會重複抓同一批頁面,也建議快取結果(Oxylabs)。
優化 HTML 解析與資料擷取
- 使用精準選擇器: 不要用
$('body *'),只選你需要的部分。 - 串流處理大型頁面: 若 HTML 非常大,可考慮串流或拆分工作。
- 快取已渲染 HTML: 若會重複訪問同一 URL,將 HTML 快取起來,避免重複請求。
- 驗證與清理資料: 使用驗證函式庫,避免把垃圾資料塞進資料庫(ScrapeGraphAI)。
在雲端部署可擴充的 Node.js 網頁爬蟲
要大規模爬取?現在是時候轉向雲原生了。
- 把爬蟲容器化: 撰寫
Dockerfile、複製程式碼、安裝依賴,並設定 entrypoint。 - 部署到雲端: 簡單任務可用 AWS EC2、Google Cloud Compute 或 Azure VM。若要追求真正的大規模,則可使用 Kubernetes,或 AWS ECS/EKS、Google Cloud Run、Azure Kubernetes Service 這類代管服務(DigitalOcean)。
- 透過 Kubernetes 排程: 執行多個 pod,依需求自動擴縮,並用負載平衡器分散 URL。
- 設定定時任務: 使用雲端排程器(CloudWatch Events、Cloud Scheduler)或 cron job,在固定間隔觸發爬取。
在一個實際案例中,把 Kubernetes pod 從 5 個擴到 10 個,讓 400 頁的爬取時間從幾分鐘縮短到不到一分鐘(DigitalOcean)。
監控與自動擴縮你的爬蟲基礎設施
- 記錄日誌: 將日誌串流到 CloudWatch、Stackdriver 或 Datadog,並針對錯誤或速度變慢設定警報。
- 健康檢查: 用 Prometheus 和 Grafana 監控每分鐘爬取頁數、錯誤率、pod 健康狀況等指標。
- 自動擴縮: 設定 Kubernetes HPA(Horizontal Pod Autoscaler),根據 CPU 或請求數量自動擴充 pod。
也別忘了加上指數退避重試,才能在網路抖動或暫時封鎖時快速恢復。
資料儲存與後處理最佳實務
資料抓回來之後,下一步就是儲存與清理:
- 小型任務: 匯出成 CSV、JSON,或直接送到 Google Sheets、Airtable、Notion(Thunderbit 開箱即用)。
- 大型任務: 結構化資料適合用 SQL(MySQL/PostgreSQL),半結構化或會演變的 schema 則可用 NoSQL(MongoDB、DynamoDB)(ScrapeHero)。
- 雲端儲存: 原始檔與備份可放在 S3 或 Google Cloud Storage。
- 資料清理: 一定要驗證欄位、統一格式(日期、數字),並去除重複資料。使用 schema 驗證器確保資料品質(ScrapeGraphAI)。
原始資料與清理後資料都保留著——你永遠不知道什麼時候會需要重跑或除錯。
結論:Node.js 網頁爬蟲效率的關鍵重點
跳過爬蟲程式碼 看看 Thunderbit 的 agentic 網頁爬蟲,和你自己撰寫並維護爬蟲腳本相比,有哪些差異。 Get Started Free
最後幫大家整理重點:
- 善用 Node.js 的非同步優勢 來處理大量並行爬取,尤其是 JavaScript 密集型網站。
- 組合合適工具: 請求用 axios/got,靜態 HTML 用 Cheerio,動態內容用 Puppeteer,必要時混合使用,兼顧速度與彈性。
- 避開反機器人陷阱: 輪替代理與標頭、模擬真人行為,並尊重 robots.txt。
- 用 Thunderbit 簡化流程: 對商業使用者或快速原型開發來說,Thunderbit 能透過 AI 擷取複雜資料,並經由 API 接入你的 Node.js 技術棧。
- 大規模部署: 容器化、用 Kubernetes 編排,並做好監控,確保穩定性。
- 儲存並清理資料: 依需求選對儲存方式,且在使用前務必驗證。
網路世界不會變簡單,但只要掌握這些最佳實務,你的 Node.js 爬蟲就能保持快速、可靠,並且始終領先反爬軍備競賽一步。若你哪天半夜 2 點還在修 selector 修到快崩潰,記得:Thunderbit 的 AI 永遠在線。
想繼續深入了解嗎?歡迎到 Thunderbit Blog 看更多深度內容,或試試 Thunderbit 的 Chrome 擴充功能,親自感受爬蟲可以多簡單。
使用 Thunderbit Agentic Web Scraper 抓取資料 Thunderbit 的 Web Scraper API 讓你可以從自己的 Node.js 程式碼觸發擷取,還提供免費方案可先開始使用。 Get Started Free
常見問題
1. 為什麼 Node.js 在 2025 年特別適合網頁爬蟲?
Node.js 的非同步、事件驅動模型可以同時處理成千上萬個請求,非常適合抓取大量資料或即時更新。再加上龐大的 npm 生態與原生 JavaScript 支援,對現代、JavaScript 密集型網站尤其合適(Node.js Docs)。
2. 用 Node.js 爬取時,如何避免被封鎖?
使用輪替代理、隨機化請求標頭、用隨機延遲節流請求,並透過 Puppeteer 等工具模擬真人行為(滑鼠移動、捲動、打字)。同時務必遵守 robots.txt 與網站條款(Medium)。
3. 我的 Node.js 爬蟲應該什麼時候用 Cheerio,什麼時候用 Puppeteer?
若資料已經在原始 HTML 中,請用 Cheerio 快速解析靜態 HTML。若網站內容是透過 JavaScript 動態載入,則用 Puppeteer。若想達到最佳效果,可以先用 Puppeteer 渲染頁面,再交給 Cheerio 解析 HTML(Bright Data)。
4. Thunderbit 如何簡化 Node.js 網頁爬蟲?
Thunderbit 讓你用 AI 和自然語言提示詞就能從任何網站擷取結構化資料,完全不需要寫程式。它可處理動態內容、子頁面與分頁,並提供可供 Node.js 整合的 API。資料也能直接匯出到 Excel、Google Sheets、Airtable 或 Notion(Thunderbit Blog)。
5. 在雲端擴充與監控 Node.js 爬蟲的最佳方式是什麼?
把爬蟲容器化,部署到 Kubernetes 或代管雲端服務,並使用自動擴縮來應對流量高峰。再搭配 CloudWatch 或 Prometheus 監控日誌與指標,並針對錯誤或速度變慢設定警報(DigitalOcean)。
準備好把你的網頁爬蟲能力升級了嗎?試試 Thunderbit,祝你的爬蟲又快、又隱蔽,永遠比反爬機制快一步。
試用 Agentic 網頁爬蟲 Get Started Free
延伸閱讀




