
網路成長的速度,快到連我早上的咖啡都顯得慢了——而相信我,我喝咖啡可是很快的。到了 2026 年,網頁資料擷取早已不只是技術人員眼中的「加分項」,而是驅動銷售開發、電商價格追蹤、市場研究,甚至房地產分析的關鍵利器。如今已有超過 49% 的企業每週都在使用網頁爬取工具,選對函式庫或工具,可能就意味著你能把原本耗上好幾個小時的苦工,變成一份在競爭對手還沒吃完午餐前就已送到手上的可行動洞察表。
有趣的是,2026 年的網頁爬蟲函式庫可說是百花齊放,從免寫程式的 AI Chrome 擴充功能,到專為開發者打造的高階框架,選擇非常多。無論你是只想把潛在客戶名單匯出到 Excel 的業務、要追蹤 500 個 SKU 的營運主管,還是正在打造客製化爬蟲的 Python 高手,這裡都有適合你的工具。我在 SaaS 與自動化領域打滾多年,也熬了不少不想承認的深夜,實際研究過這些工具——所以接下來,就讓我們一起拆解 2026 年你一定要知道的 10 大網頁爬蟲函式庫,以及如何挑到最能讓你事半功倍的那一款。
2026 年什麼樣的網頁爬蟲函式庫才算強大?
運用 AI 從任何網站抓取資料 Get Started Free
在看清單之前,我們先聊聊,挑選網頁爬蟲函式庫時,真正該在意的是什麼。依我的經驗,2026 年最好的工具通常都有幾個共通點:
- 容易上手: 非工程背景的人能不能幾分鐘內做出成果?還是得先修完一門 Python 博士班?
- 動態內容處理能力: 能不能抓現代那種 JavaScript 很重的網站?還是只要碰到比靜態 HTML 再複雜一點的頁面就卡住?
- 語言與平台支援: 它能不能在你最常用的語言上運作——Python、JavaScript、Java,甚至直接在瀏覽器裡就能用?
- 擴展性: 能不能穩穩處理數百甚至上千頁,不會動不動就翻車?
- 整合與匯出: 能不能和 Excel、Google Sheets、Notion 或你的資料流程順利接軌?
- AI 與自動化: 到了 2026 年,能用自然語言提示詞直接運作的 AI 工具會是巨大加分,特別是對不想碰程式碼的商務用戶來說。
現實情況是,企業團隊最重視的就是速度、準確性,以及盡可能少的前置設定。你花在修壞掉的爬蟲或和程式碼搏鬥上的時間越少,就越有時間拿資料去做決策。隨著 AI 與瀏覽器自動化普及,連非技術背景的人現在也能抓取以前得靠工程師幫忙才能取得的資料(PromptCloud)。
好,重點來了。
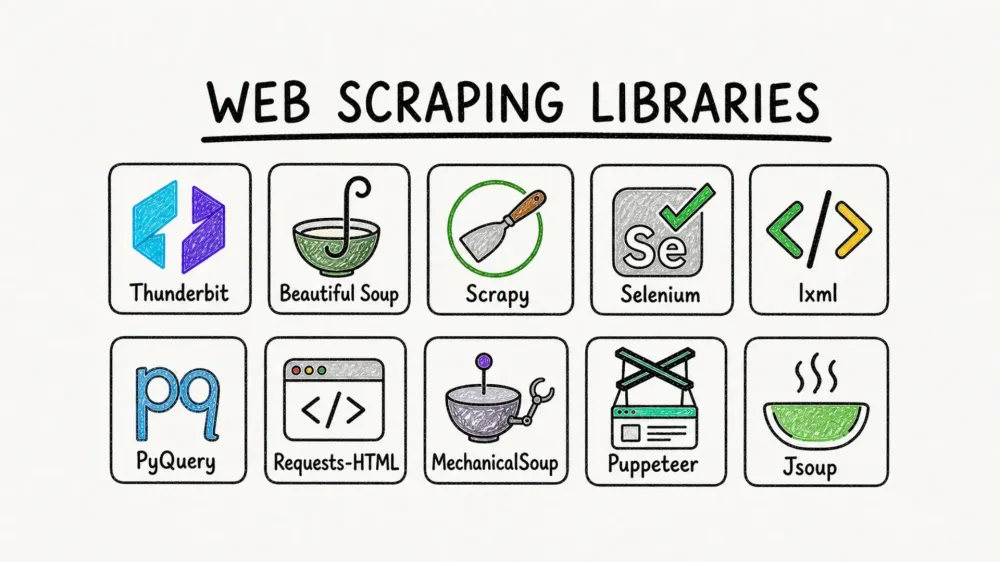
2026 年 10 大強大網頁爬蟲函式庫
- Thunderbit|瀏覽器內免寫程式、AI 驅動的網頁爬取
- Beautiful Soup|在 Python 中輕鬆解析 HTML 與清理資料
- Scrapy|適合大規模、高速爬取與資料流程處理
- Selenium|用於瀏覽器自動化與抓取 JavaScript 密集型網站
- lxml|Python 中極速 XML/HTML 解析
- PyQuery|Python 裡的 jQuery 風格 HTML 選取工具
- Requests-HTML|整合 HTTP、HTML 解析與 JavaScript 渲染的 Python 工具
- MechanicalSoup|Python 表單自動化與簡單瀏覽器任務
- Puppeteer|Node.js 的無頭 Chrome 自動化工具
- Jsoup|Java 中穩健的 HTML 解析工具
1. Thunderbit

Thunderbit 是我最推薦給想要不寫任何程式碼就能抓取網頁資料的人。這款AI 驅動的 Chrome 擴充功能 讓你只要用自然語言描述需求(例如「把這個頁面的所有商品名稱、價格和圖片抓出來」),AI 就會自動完成後續工作。不需要範本,也不用繁瑣設定——按一下就能開始;想調整欄位也可以,不想動它也照樣能跑。
Thunderbit 在 2026 年脫穎而出的原因:
- 免寫程式、自然語言介面: 任何人都能用——業務、營運、行銷、房地產都行,不需要 Python。
- 自動欄位辨識: AI 會直接根據頁面結構推斷出欄位。
- 子頁面爬取: 如果你需要更詳細的資料,Thunderbit 可以自動逐一造訪子頁面(像商品頁或個人檔案頁),把資訊補齊到你的表格裡(Thunderbit Blog)。
- 熱門網站即用範本: Amazon、Zillow、Shopify 等等,一鍵即可抓取。
- 可匯出到 Excel、Google Sheets、Notion、Airtable: 資料直接到團隊最需要的地方。
- 支援 34 種語言: 很適合跨國團隊。
- 雲端或瀏覽器爬取皆可: 依你的工作流程選擇;雲端模式處理公開網站超快,瀏覽器模式則適合需要登入的情境。
Thunderbit 深受全球超過 20 萬名使用者信賴,免費方案最多可爬取 6 頁(試用加成後可到 10 頁)。如果你想看看現代網頁爬取長什麼樣子,我會從這裡開始。
2. Beautiful Soup
Beautiful Soup 是 Python 的經典函式庫,因為能輕鬆解析混亂的 HTML,深受資料科學家與分析師喜愛。如果你曾經試著從標籤破損或格式怪異的頁面中擷取資料,你一定會懂 Beautiful Soup 的好。
Beautiful Soup 的優勢:
- 可處理不規則 HTML: 非常適合清理與擷取那些「長得不漂亮」的網頁資料(Beautiful Soup Docs)。
- 容易學: 就算是 Python 初學者也能很快上手。
- 彈性高: 可與 Requests 等 HTTP 客戶端搭配,也能結合 lxml 提升速度。
- 常見用途: 快速擷取資料、整理網頁資料、搭配小型腳本使用。
如果你面對的是靜態頁面,或需要整理亂七八糟的標記內容,Beautiful Soup 會是很穩的選擇。
3. Scrapy
Scrapy 可說是 Python 網頁爬取界的重量級選手。它是一個功能完整的框架,專門用來打造可擴展的爬蟲與資料流程。如果你需要抓上千頁、追蹤連結,並在大規模下處理資料,Scrapy 就是為這種需求而生。
Scrapy 為何是熱門首選:
- 高度模組化: 可建立複雜的 spider、pipeline 與 middleware(Scrapy Docs)。
- 適合大型專案: 很適合市場研究、競品分析,或任何需要從大量網站爬取與擷取資料的任務。
- 非同步且快速: 為速度與效率而設計。
- 社群資源豐富: 外掛、教學與支援都很多。
Scrapy 的學習曲線確實比較高,但一旦是大規模任務,它就是個超強工具。
4. Selenium
Selenium 是瀏覽器自動化的首選工具。它用途很廣,從測試網頁應用到抓取需要登入、點擊或處理彈窗的網站都能勝任。如果你要處理 JavaScript 很重或高度動態的網站,Selenium 可以像真人使用者一樣操作瀏覽器(ScrapingBee Selenium Guide)。
Selenium 的強項:
- 可操控真實瀏覽器: Chrome、Firefox、Safari、Edge 都可以。
- 可處理登入、彈窗與使用者操作: 對登入後抓資料,或需要多步驟流程的網站非常有幫助。
- 支援多種語言: Python、Java、C# 等等。
- 最適合: 會擋簡單爬蟲的網站,或需要模擬真實使用者行為的情境。
它比以 HTTP 為基礎的函式庫更重一些,但有時候,你真的就是需要一個真實瀏覽器。
5. lxml
lxml 是 Python 裡效能極高的 XML 與 HTML 解析器。如果速度是你的首要考量(例如:解析成千上萬份大型文件),lxml 幾乎很難被超越(Python HTML Parser Performance)。
lxml 的受歡迎原因:
- 速度飛快: 尤其在大型檔案上,效能常常優於多數 Python 解析器。
- 穩定可靠: 同時支援 XML 與 HTML,並且能和其他工具良好整合。
- 很適合: 處理大型資料集,或搭配 Beautiful Soup、Scrapy 增強能力。
如果你是在大規模爬取,或需要處理超大檔案,lxml 幾乎是工具箱裡必備的一把。
6. PyQuery
PyQuery 把 jQuery 的選擇器語法帶進了 Python。若你很喜歡在 jQuery 裡用 $('.class') 這種方式選取元素,PyQuery 能讓你在爬取腳本中用類似的體驗完成同樣的事(PyQuery Docs)。
PyQuery 的亮點:
- jQuery 風格選擇器: 對熟悉前端開發的人來說很直覺。
- 程式碼簡潔好讀: 能把複雜選取寫得很簡單。
- 可整合 lxml: 底層速度與效率都不錯。
- 最適合: 想在 Python 裡快速做出類 jQuery 的 HTML 操作專案。
對從網頁開發轉向資料擷取的人來說,它是一座很棒的橋樑。
7. Requests-HTML
Requests-HTML 是一個 Python 函式庫,把 Requests 的易用性、內建 HTML 解析,甚至 JavaScript 渲染都整合在一起。
Requests-HTML 的特色:
- 一站式整合: 抓頁面、解析 HTML,甚至渲染 JavaScript,一個套件搞定。
- 適合初學者: 很適合中小型爬取專案。
- 最適合: 快速腳本、帶有部分動態內容的網站,以及想要簡單工具的使用者。
如果你剛入門,或只是需要一個能應付小型任務的彈性工具,Requests-HTML 會是不錯的選擇。
8. MechanicalSoup
MechanicalSoup 是一個能自動操作網頁表單與簡單瀏覽器互動的 Python 函式庫。它建立在 Beautiful Soup 和 Requests 之上,因此很適合用來登入、填表,以及處理基本流程(ScrapingBee MechanicalSoup Guide)。
MechanicalSoup 的實用之處:
- 可自動處理表單與登入: 很適合抓取登入後才看得到的資料。
- API 簡單: 初學者也容易上手。
- 最適合: 重複性的瀏覽器任務、簡單工作流程,以及不需要完整瀏覽器自動化的網站。
雖然在複雜網站上不如 Selenium 強大,但它更輕巧,也更容易應付基本需求。
9. Puppeteer
Puppeteer 是一個用來控制無頭 Chrome 或 Chromium 的 Node.js 函式庫。它是許多開發者處理 JavaScript 很重、互動性很高網站時的愛用工具(Scrape.do Puppeteer Guide)。
Puppeteer 的超能力:
- 完整瀏覽器自動化: 可以像真人一樣點擊、捲動、填表與互動。
- 能處理動態內容: 對透過 JavaScript 載入資料的網站特別適合。
- 最適合: 電商、社群媒體,或任何傳統爬蟲常常失手的網站。
如果你是 JavaScript 開發者,或需要處理「現代網路」的資料抓取,Puppeteer 幾乎是必備工具。
10. Jsoup
Jsoup 是 Java 裡 HTML 解析的黃金標準。你可以把它想成 Java 開發者版本的 Beautiful Soup(Baeldung Jsoup Guide)。
Java 團隊喜歡 Jsoup 的原因:
- API 簡單又強大: 幾行程式碼就能擷取與操作資料。
- 可處理亂格式 HTML: 即使頁面標記品質不佳,也能有效清理與解析。
- 最適合: 把爬取功能整合進 Java 商業應用或後端流程。
如果你的技術棧是 Java,Jsoup 幾乎就是最直覺的選擇。
網頁爬蟲函式庫比較表
以下是這 10 個函式庫的快速對照:
| 函式庫 | 語言 | 易用性 | 動態內容 | AI/免寫程式 | 常見用途 | 最適合 |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome 擴充功能 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | 是 | 銷售、營運、研究、房地產 | 非工程背景人士、商務用戶 |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | 否 | HTML 解析、資料清理 | Python 初學者、分析師 |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | 否 | 大規模爬取、資料流程 | 開發者、大數據專案 |
| Selenium | 多語言 | ⭐⭐ | ⭐⭐⭐⭐⭐ | 否 | 瀏覽器自動化、登入 | QA、動態網站爬取 |
| lxml | Python | ⭐⭐⭐ | ⭐ | 否 | 高速解析、大型檔案 | 高階使用者、大型資料集 |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | 否 | jQuery 風格選取 | 網頁開發者、簡潔腳本 |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | 否 | 快速腳本、JS 渲染 | 初學者、小型專案 |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | 否 | 表單自動化、登入 | 簡單瀏覽器任務 |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 否 | JavaScript 很重的網站、自動化 | JS 開發者、動態網頁爬取 |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | 否 | Java 中的 HTML 解析 | Java 團隊、後端流程 |
如何為你的企業挑選正確的網頁爬蟲函式庫
什麼是資料擷取,以及 2025 年該如何操作 Get Started Free
那麼,到底該選哪一個?根據我多年來反覆試錯、也熬過不少除錯夜晚的經驗,我的建議是:
- 非工程背景或商務用戶: 先從 Thunderbit 開始。AI/免寫程式的方式能讓你在幾分鐘內拿到成果,而不是等上幾天。如果團隊只是想把資料匯進 Excel 或 Sheets,別把事情搞複雜。
- Python 開發者: Beautiful Soup 和 Requests-HTML 很適合小型任務;大專案則交給 Scrapy。再搭配 lxml 或 PyQuery,效果更強。
- 需要處理登入或動態內容? Selenium(多語言)或 Puppeteer(Node.js)會是最好的選擇。
- Java 團隊: Jsoup 是把爬取能力整合進 Java 應用的明顯首選。
- 需要自動填表或簡單工作流程? MechanicalSoup 輕量、好上手,非常方便。
挑選時的關鍵考量:
- 技術能力: Thunderbit 這類免寫程式工具很適合非技術團隊;開發者通常會偏好程式碼型函式庫的彈性。
- 資料複雜度: 如果是簡單的靜態頁面,Beautiful Soup 或 Jsoup 很合適;若是動態、JavaScript 密集型網站,則選 Selenium 或 Puppeteer。
- 規模: Scrapy 與 lxml 在大規模、高速任務上表現出色。
- 整合能力: Thunderbit 可直接匯出到 Sheets、Notion 和 Airtable,能替商務流程省下大量時間。
想進一步了解如何挑選工具,可以參考 PromptCloud 的指南。
結論:用對工具,釋放網頁資料的真正價值
到了 2026 年,網頁爬取早已不再只是程式設計師或資料科學家的專利。隨著 AI 驅動與免寫程式工具的大爆發,從銷售到研究的每一個團隊,都能從網路這座資料金礦中挖到寶。選對函式庫,一年就能替你省下數百個小時(Browsercat),提升準確度,還能幫你的企業真正拉開差距。
我的建議是:先從你的需求出發——速度、規模、技術熟悉度——再實際試幾個選項。你可以先用 Thunderbit 的免費方案 試水溫;如果你想動手寫點東西,像 Beautiful Soup 或 Scrapy 這類開源函式庫也一直都在。
想深入了解?可以到 Thunderbit Blog 看更多教學,或訂閱我們的 YouTube 頻道 觀看實作教學。
祝你抓取順利——願你的資料永遠乾淨、結構化,並且隨時能派上用場。
免費試用 Thunderbit AI 網頁爬蟲 Get Started Free
常見問題
1. 2026 年對非工程背景人士來說,最容易上手的網頁爬蟲函式庫是哪個?
Thunderbit 是非工程背景人士的首選。它的 AI Chrome 擴充功能可讓使用者透過自然語言提示詞抓取資料,不需要寫程式。
2. 哪個函式庫最適合抓取 JavaScript 很重或動態網站?
Puppeteer(Node.js)和 Selenium(多語言)最適合抓取動態、由 JavaScript 渲染的網站。它們能自動操作真實瀏覽器,處理複雜互動。
3. Beautiful Soup 和 Scrapy 有什麼差別?
Beautiful Soup 很適合單頁或小型專案的解析與資料擷取,尤其是 HTML 很亂的頁面。Scrapy 則是一個完整框架,適合建立可擴展的爬蟲與處理大量資料。
4. 我可以直接把抓下來的資料匯出到 Google Sheets 或 Notion 嗎?
可以——Thunderbit 支援直接匯出到 Google Sheets、Notion、Airtable 和 Excel。多數程式碼型函式庫則需要你自行撰寫匯出邏輯。
5. 我該怎麼為企業挑選合適的網頁爬蟲函式庫?
請考量你的技術能力、想抓取網站的複雜程度、資料量,以及整合需求。像 Thunderbit 這類免寫程式工具很適合商務團隊;若需要更高控制權,開發者通常會偏好 Scrapy、Beautiful Soup 或 Puppeteer 這類函式庫。
延伸閱讀



