
網路的發展速度比我對咖啡的依賴還要快——相信我,這可不是隨便說說。到了 2026 年,網頁資料擷取不再只是資料愛好者的利基技能;它已成為商業智慧、AI 訓練和自動化的核心支柱。無論你是追蹤市場趨勢、為下一代大型語言模型(LLM)提供資料,還是僅僅想跟上競爭對手的定價,對即時、結構化網頁資料的需求從未如此之高。而這場資料淘金熱的核心是什麼?答案是 Python。憑藉其龐大的生態系統和易於理解的語法,Python 仍然是網頁爬蟲的首選語言,從快速的一次性腳本到工業級的爬蟲,無所不能。
但關鍵在於:選擇正確的 Python 網頁爬蟲套件 可以決定你專案的成敗。我曾見過團隊因為選錯工具而花費數天與反爬蟲機制搏鬥,或者在一個更智慧的函式庫幾分鐘就能解決問題時,卻耗費數小時解析混亂的 HTML。因此,作為一個在 SaaS、自動化和 AI 領域深耕多年(並建立了 Thunderbit 以讓所有人都能更輕鬆地進行爬蟲)的人,我整理了 2026 年最棒的 12 個 Python 網頁爬蟲套件——每個套件都有其獨特的優勢、特點和理想使用場景。讓我們深入探討,為你的下一個資料探險找到最完美的工具。
為何選擇正確的 Python 網頁爬蟲套件至關重要
使用 AI 從任何網站抓取資料 Get Started Free
說實話:並非所有網頁爬蟲專案都是一樣的。有時候你可能只需要從靜態頁面抓取幾個產品價格。而有時候,你可能需要處理一個比洗澡時的貓咪還要固執的 JavaScript 密集型網站。正確的套件可以為你節省數小時(甚至數天)的時間,減少錯誤,並幫助你避免常見的陷阱,例如反爬蟲阻擋或損壞的 HTML。
Python 在網頁爬蟲領域的受歡迎程度不僅僅是炒作。像 requests 和 urllib3 這樣的函式庫每月下載量超過 10 億次,幾乎所有主要的爬蟲工具都以 Python 為主。但能力越大,責任越大:選擇錯誤的工具,你可能會發現自己陷入一個比撥號上網還要慢的專案。明智地選擇,你將在咖啡變冷之前,就能獲得乾淨、結構化的資料。
我們如何選擇最佳的 Python 網頁爬蟲套件
我可不是隨便亂選的。我是這樣評估每個套件的:
- 效能與並行性: 它能否快速抓取數百(或數千)個頁面?
- 易用性: 它對初學者友好嗎?還是需要電腦科學博士學位才能使用?
- HTML 解析能力: 它能否處理損壞的標記、支援 XPath/CSS 選擇器,並讓資料擷取變得輕鬆?
- 動態內容支援: 它能否處理 JavaScript 密集型網站?還是只適用於靜態頁面?
- 社群與文件: 它是否有活躍的用戶群和完善的文件?還是會讓你陷入 Stack Overflow 的煉獄?
- 最佳使用場景: 它是用於快速腳本、大規模爬蟲,還是介於兩者之間?
我還考慮了真實世界的開發者回饋、最新的基準測試,以及我在該領域中(有時是痛苦的)經驗。現在,讓我們來看看這些競爭者。
1. Thunderbit
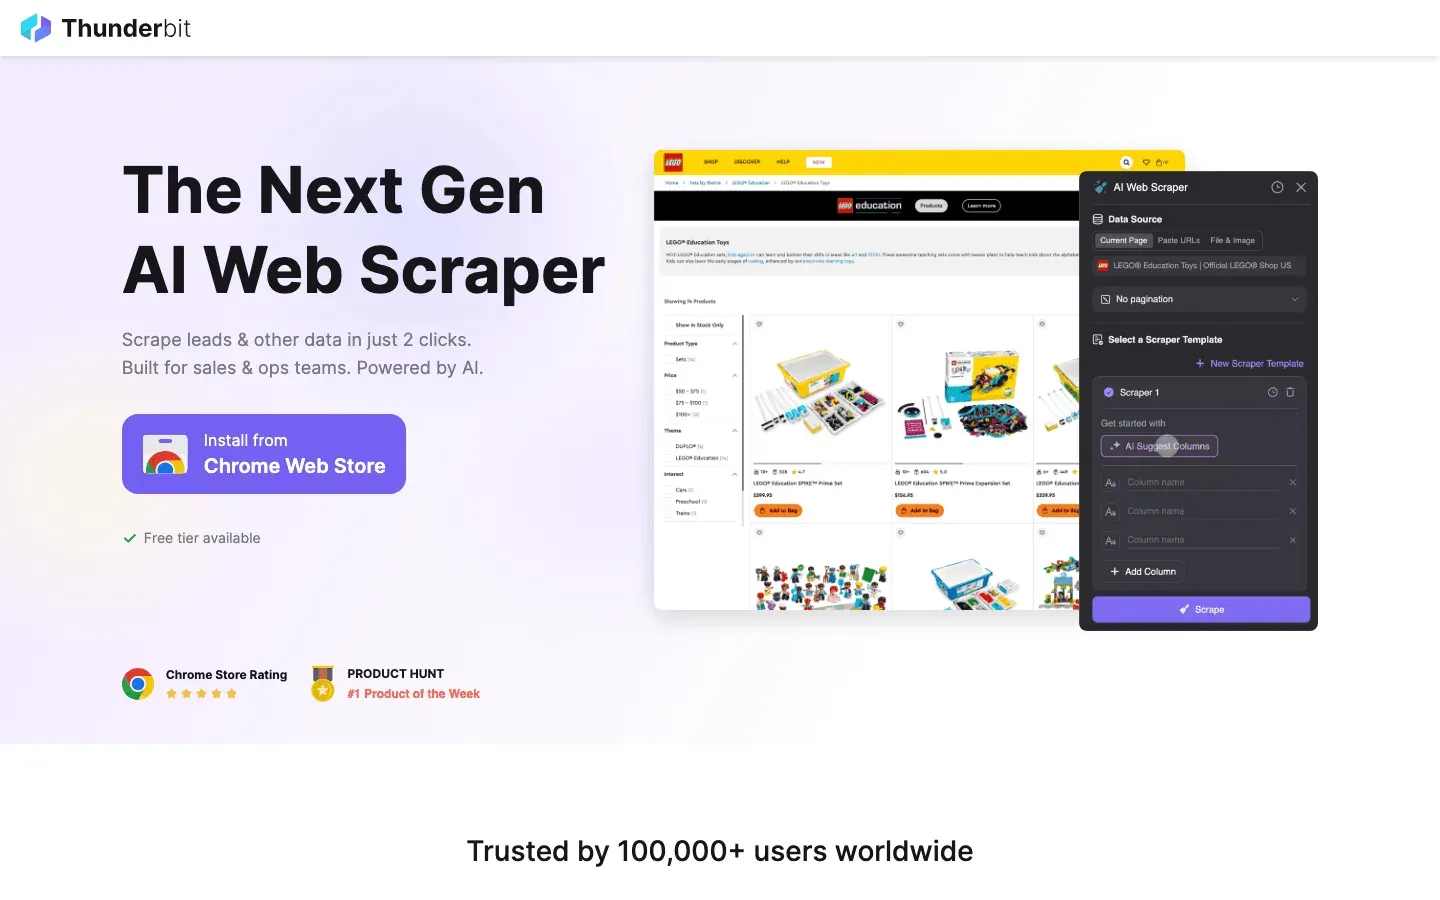 Thunderbit 並不是你典型的 Python 函式庫——它是一個由 AI 驅動的 Chrome 擴充功能,正在改變網頁爬蟲的遊戲規則,特別是對於那些追求速度、準確性和一點 AI 魔法的 Python 開發者而言。是什麼讓 Thunderbit 脫穎而出?它讓你使用自然語言指令來告訴 AI 你想要什麼資料,然後它會處理所有事情:欄位建議、子頁面導航、分頁,甚至匯出到 Excel、Google Sheets、Notion 或 Airtable。
Thunderbit 是抓取複雜、非結構化資料的救星——想像一下混亂的目錄、產品列表,或者 HTML 結構更像是「抽象藝術」而非「結構化文件」的網站。它的 AI 建議欄位 功能會讀取頁面並建議最佳欄位,而子頁面爬蟲 則讓你能夠透過自動訪問連結的詳細頁面來豐富你的資料集。如果你厭倦了反爬蟲的困擾,Thunderbit 的瀏覽器內建和雲端爬蟲選項都能滿足你的需求。
Python 開發者喜歡 Thunderbit 用於快速原型開發、潛在客戶生成和市場研究。你可以直接在 Python 資料管道中使用其輸出,甚至可以透過其 API 自動化爬蟲工作流程。它不是一個傳統的程式碼函式庫,但它正迅速成為那些希望減少編碼時間、將更多時間用於資料分析的人們的最愛。
主要功能:
- AI 驅動的欄位建議和資料擷取
- 處理子頁面、分頁,甚至 PDF/圖片
- 匯出為 CSV、Excel、Google Sheets、Notion、Airtable
- 無需編碼——非常適合非技術用戶和希望快速行動的 Python 專業人士
- 提供免費方案;付費方案可根據你的需求擴展
最適合: 潛在客戶生成、市場研究、快速原型開發,以及抓取複雜或混亂的網頁資料。
2. Beautiful Soup
 Beautiful Soup 是 Python 中 HTML 解析的元老級工具。如果你剛入門,或者需要從靜態網頁擷取資料,它就是你最好的朋友。Beautiful Soup 擅長導航和解析結構不良的 HTML(「標籤湯」),使其成為抓取不按規則出牌的網站的救星。
其 API 對初學者友好——想想 .find()、.select() 和 .text——它與 requests 完美搭配,用於抓取網頁。在底層,你可以選擇不同的解析器(例如 lxml 以提高速度或 html5lib 以實現最大相容性)。文件一流,社群龐大。
主要功能:
- 直觀、Python 風格的 HTML/XML 導航 API
- 優雅地處理損壞或不一致的標記
- 適用於多種解析器,以提高速度或相容性
- 龐大的社群和大量的教學資源
最適合: 快速腳本、靜態頁面爬蟲,以及希望輕鬆入門的初學者。
3. Scrapy
 Scrapy 是大規模自動化網頁爬蟲的重量級冠軍。如果你需要抓取數百或數千個頁面、管理管道或安排重複性任務,Scrapy 是大多數團隊最終會選擇的框架。它底層仍然運行在 Twisted reactor 上,但自 2.14 版本發布以來,其大部分非同步內部機制已重寫為原生的
asyncio 協程,現在還有 AsyncCrawlerProcess / AsyncCrawlerRunner 入口點,可以與現代 Python 非同步生態系統的其餘部分良好協作。它速度快,支援並行爬蟲、用於資料清理的項目管道,並可匯出為 JSON、CSV 或資料庫。
Scrapy 具有可擴展性,提供用於代理、快取甚至有限 JavaScript 渲染(透過 Splash 或 Selenium 整合)的外掛程式。學習曲線比 Beautiful Soup 更陡峭,但如果你認真對待大規模網頁資料,Scrapy 是你成長的選擇。
主要功能:
- 透過 Twisted reactor + 原生
asyncio協程進行非同步爬蟲(Scrapy 2.14+,Python 3.10+) - 內建用於資料清理和儲存的管道
- 匯出為多種格式(JSON、CSV、DB)
- 龐大、活躍的社群和外掛程式生態系統
最適合: 大規模、重複性爬蟲專案、資料管道,以及任何需要速度和可靠性的人。
4. Selenium
 Selenium 是抓取 JavaScript 密集型或互動式網站的首選工具。它自動化真實瀏覽器(Chrome、Firefox 等),讓你模擬使用者操作,例如點擊、滾動和表單提交。如果你需要的資料只有在 JavaScript 運行後才會出現,無論網站多麼固執,Selenium 都能獲取它。
權衡之下?Selenium 速度慢且資源密集。你為每次爬蟲運行一個完整的瀏覽器,因此不要期望每分鐘處理數千個頁面。但對於那些「沒有其他工具能做到」的場景,Selenium 是救星。
主要功能:
- 完整的瀏覽器自動化(支援 Chrome、Firefox、Edge 等)
- 處理 JavaScript 渲染的內容和互動元素
- 支援無頭模式,實現更快、無 UI 的爬蟲
- 龐大的社群和廣泛的文件
最適合: 抓取動態、JavaScript 密集型網站,自動化登入流程,以及處理 CAPTCHA 或複雜的使用者互動。
5. PyQuery
 PyQuery 將 jQuery 風格的語法引入 Python,讓 HTML 解析對於任何使用過 JavaScript 中 jQuery 的人來說都感到熟悉。它封裝了快速的
lxml 解析器,讓你使用 CSS 選擇器,例如 $('div.classname') 來查找元素。
PyQuery 非常適合快速原型開發,以及希望程式碼簡潔易讀的開發者。對於複雜的查詢,它比 Beautiful Soup 更快,並且可以輕鬆與非同步工具或 Selenium 整合,以實現更進階的工作流程。
主要功能:
- Python 中類似 jQuery 的選擇器和語法
- 透過 lxml 後端實現快速解析
- 非常適合從 JavaScript 轉型的開發者
- 支援鏈式呼叫和簡潔的查詢
最適合: 原型開發、jQuery 愛好者,以及任何希望減少 HTML 解析程式碼的人。
PyQuery 教學與比較
6. LXML
 LXML 是 Python 中 HTML 和 XML 解析的速度之王。它建立在 C 函式庫
libxml2 和 libxslt 之上,以其效能和對 XPath 和 CSS 選擇器的強大支援而聞名。如果你正在處理大型文件或需要運行複雜的查詢,lxml 是你的最佳選擇。
它可以直接使用,也可以作為 Beautiful Soup 或 PyQuery 的後端。其 API 稍微進階一些,但對於大型任務來說,其速度和靈活性是值得的。
主要功能:
- Python 中最快的解析速度
- 完全支援 XPath 和 CSS 選擇器
- 有效處理大型和複雜文件
- 可獨立使用或作為其他函式庫的解析器
最適合: 高效能解析、大規模爬蟲,以及需要進階查詢的專案。
7. Requests
 Requests 是 Python 中進行 HTTP 請求的事實標準。其簡潔、直觀的 API 讓抓取網頁變得像
requests.get(url) 一樣簡單。它開箱即用,處理 cookie、session,甚至 JSON 解碼。
雖然 Requests 是同步的(每個請求都等待完成),但它非常適合快速腳本和小規模爬蟲。將它與 Beautiful Soup 或 lxml 搭配使用,可以實現經典的爬蟲工作流程。
主要功能:
- 簡單、Python 風格的 HTTP 請求 API
- 處理 cookie、session 和重定向
- 與解析函式庫無縫整合
- 龐大的社群和文件
最適合: 簡單腳本、靜態頁面爬蟲,以及希望快速入門的初學者。
8. MechanicalSoup
 MechanicalSoup 是一個輕量級函式庫,可以自動化簡單的瀏覽器互動——例如填寫表單或導航多步驟登入流程——而無需啟動完整的瀏覽器。它封裝了
requests 和 Beautiful Soup,使其比 Selenium 更快、更輕量,適用於不嚴重依賴 JavaScript 的網站。
如果你需要登入、提交表單或點擊幾個頁面(且網站不太動態),MechanicalSoup 是一個很好的折衷方案。
主要功能:
- 自動化表單填寫和導航
- 建立在 Requests 和 Beautiful Soup 之上
- 輕量且快速(無瀏覽器開銷)
- 易於用於中等程度的互動
最適合: 需要登入或表單提交的網站、簡單的自動化任務,以及任何希望避免 Selenium 開銷的人。
MechanicalSoup 教學
9. Aiohttp
 Aiohttp 是用於高速、並行網頁請求的非同步強大工具。如果你需要快速抓取數百個頁面,aiohttp 允許你並行發送請求,大大減少總運行時間。在一項基準測試中,抓取 50 個頁面使用 aiohttp 只需 3 秒,而使用同步請求則需要 16 秒(查看效能差異)。
Aiohttp 需要編寫 async def 程式碼並使用 await,但對於大型任務來說,速度提升是值得的。
主要功能:
- 非同步 HTTP 客戶端/伺服器框架
- 支援 session、cookie 和 HTTP/2
- 大幅提升並行請求的速度
- 與非同步解析函式庫整合
最適合: 高速、大規模爬蟲、API 擷取,以及任何熟悉非同步程式設計的人。
10. Twisted
 Twisted 是驅動 Scrapy 的事件驅動網路引擎。雖然它本身不是一個爬蟲函式庫,但進階用戶可以直接使用 Twisted 來建立自訂爬蟲、處理非 HTTP 協定,或實作超並行爬蟲。
Twisted 功能強大,但學習曲線陡峭。它最適合高度客製化的場景或從頭開始建立框架時使用。
主要功能:
- 用於 HTTP、WebSockets、SSH 等的事件驅動網路
- 支援 SSL、並行和自訂協定
- 支撐 Scrapy 的非同步引擎
- 適用於進階用例的高度靈活
最適合: 自訂協定、建立爬蟲框架,以及需要最大控制權的進階用戶。
11. Grab
 Grab 是一個一體化的爬蟲工具包,結合了 HTTP 請求、解析、自動化、代理輪換和 CAPTCHA 處理。它在精神上與 Scrapy 相似,但旨在更容易學習和使用,內建支援代理、快取和非同步爬蟲。
Grab 的突出功能是其 Grab:Spider 系統,它可以使用 multicurl 並行運行數千個請求。如果你需要一個一體化解決方案,且設定比 Scrapy 更簡單,Grab 值得一試。
主要功能:
- 內建支援代理、使用者代理輪換和快取
- 用於高並行性的非同步爬蟲系統
- XPath 解析和模組化架構
- 用於大規模爬蟲的生產環境
最適合: 一體化爬蟲專案、大量使用代理的任務,以及希望獲得強大功能而無需 Scrapy 複雜性的用戶。
12. Urllib3
 Urllib3 是驅動許多 Python 客戶端(包括 Requests)的底層 HTTP 引擎。它提供連接池、執行緒安全、重試以及對 HTTP 連接的精細控制。雖然大多數開發者間接使用它,但當你需要最大效能或正在建立更高級別的函式庫時,urllib3 是你的首選。
它不像 Requests 那樣對初學者友好,但它經過實戰考驗且高度可靠。
主要功能:
- 連接池和執行緒安全
- 對 HTTP 連接的精細控制
- 作為許多其他函式庫的基礎
- 對重複請求的高效能
最適合: 自訂 HTTP 客戶端、多執行緒爬蟲,以及在 Python HTTP 堆疊之上建立的開發者。
比較表:Python 網頁爬蟲套件一覽
| 套件 | 易用性 | 效能 | 動態內容 | 解析能力 | 社群/文件 | 最適合 |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | 快速 (雲端/本地) | 是 (透過 AI) | 自動欄位、子頁面 | 成長中 (AI 趨勢) | 潛在客戶生成、市場研究、無程式碼使用者 |
| Beautiful Soup | ★★★★★ (容易) | 中等 | 否 | HTML/XML、容錯性 | 龐大 | 靜態頁面、初學者 |
| Scrapy | ★★☆☆☆ (陡峭) | ★★★★★ (非常高) | 僅限外掛程式 | CSS/XPath、管道 | 龐大、活躍 | 大規模、重複性爬蟲 |
| Selenium | ★★☆☆☆ (中等) | ★☆☆☆☆ (慢) | 是 (完整) | 完整 DOM、JS | 成熟 | JS 密集型、互動式網站 |
| PyQuery | ★★★★☆ (jQuery) | 快速 (lxml) | 否* | jQuery 選擇器 | 中等 | 原型開發、jQuery 開發者 |
| LXML | ★★★☆☆ (進階) | ★★★★★ (最快) | 否 | XPath/CSS、XML | 中等 | 大型文件、進階查詢 |
| Requests | ★★★★★ (非常容易) | ★★☆☆☆ (同步) | 否 | HTTP、JSON | 龐大 | 簡單腳本、靜態頁面 |
| MechanicalSoup | ★★★★☆ (容易) | ★★☆☆☆ (同步) | 否 | 表單、導航 | 小型 | 登入流程、表單自動化 |
| Aiohttp | ★★☆☆☆ (非同步) | ★★★★★ (並行) | 否 | 非同步 HTTP | 龐大 (非同步) | 高速、並行爬蟲 |
| Twisted | ★☆☆☆☆ (複雜) | ★★★★★ (自訂) | 否 | 網路、協定 | 利基 | 自訂框架、進階使用者 |
| Grab | ★★★☆☆ (模組化) | ★★★★☆ (非同步) | 否 | 代理、XPath | 小型 | 一體化、大量代理/驗證碼 |
| Urllib3 | ★★★★☆ (底層) | ★★★★☆ (池化) | 否 | HTTP、池化 | 龐大 | 自訂客戶端、多執行緒爬蟲 |
*PyQuery 可以與 Selenium 結合用於動態網站。
如何為你的需求選擇合適的 Python 網頁爬蟲套件
2026 年什麼是資料爬蟲以及如何進行 Get Started Free
那麼,你應該選擇哪個套件呢?這是我的速查表:
- 靜態頁面、小型任務,或你剛接觸爬蟲: 從 Requests + Beautiful Soup 開始。
- 大規模、重複性或生產級爬蟲: Scrapy 或 Grab(用於一體化需求)。
- JavaScript 密集型或互動式網站: Selenium(如果你想要 AI 驅動、無程式碼的爬蟲,則選擇 Thunderbit)。
- 高速、並行爬蟲: Aiohttp(如果你熟悉非同步程式設計)。
- 表單自動化或登入流程: MechanicalSoup(適用於簡單網站),Selenium(適用於複雜 JS)。
- 進階解析或大型文件: LXML 或 PyQuery。
- 自訂網路或協定工作: Twisted。
- 快速原型開發、潛在客戶生成或混亂/非結構化資料: Thunderbit。
而且不要害怕混搭——許多工作流程會結合這些工具以實現最大效率。例如,你可以使用 Selenium 渲染頁面,然後將 HTML 傳遞給 Beautiful Soup 或 PyQuery 進行解析。
結論:使用正確的 Python 工具為你的網頁爬蟲增添動力
2026 年的網頁爬蟲比以往任何時候都更強大——也更必要。有了正確的 Python 網頁爬蟲套件,你可以將混亂的網路轉化為乾淨、可操作的資料,用於你的業務、研究或下一個大創意。無論你是經驗豐富的開發者,還是剛踏入資料領域,此列表中總有一款工具適合你的需求。
如果你想了解 AI 驅動、無程式碼的爬蟲是什麼樣子,請試用 Thunderbit。如果你渴望獲得更多技巧、深入分析和教學,請查看 Thunderbit 部落格,了解網頁爬蟲、自動化和資料驅動工作流程的最新資訊。
祝你爬蟲愉快——願你的選擇器永遠匹配,代理永不失效,資料像你的程式碼一樣乾淨。
常見問題
1. 對於初學者來說,最好的 Python 網頁爬蟲套件是什麼? 對於大多數初學者來說,Requests 和 Beautiful Soup 的組合是入門最簡單的方式。兩者都具有直觀的 API、大量的教學資源,並能處理大多數靜態頁面爬蟲任務。
2. 如何使用 Python 抓取 JavaScript 密集型網站? 使用 Selenium 自動化真實瀏覽器,或者試用 Thunderbit 進行 AI 驅動、無程式碼的爬蟲,它可以處理動態內容。對於大規模需求,Scrapy 可以與 Splash 或 Selenium 結合使用。
3. 哪個套件最適合大規模、高速爬蟲? Scrapy 專為大規模、非同步爬蟲而設計。如果你需要更高的速度並熟悉非同步程式碼,aiohttp 是並行請求的首選。
4. 我可以在我的工作流程中結合這些套件嗎? 當然可以!許多開發者使用 Requests 或 Selenium 抓取頁面,然後使用 Beautiful Soup、lxml 或 PyQuery 進行解析。Thunderbit 的輸出(CSV、Excel、Sheets、Notion、Airtable)可以無縫整合到 Python 數據管道中,使其成為 Python 開發者的強大伴侶。
5. Thunderbit 是一個 Python 函式庫還是獨立工具? Thunderbit 是一個 AI 驅動的 Chrome 擴充功能和平台,而不是傳統的 Python 函式庫。然而,它的輸出(CSV、Excel、Sheets、Notion、Airtable)可以無縫整合到 Python 數據管道中,使其成為 Python 開發者的強大伴侶。
6. 2026 年 AI 編碼代理是否會取代 Python 爬蟲函式庫? 目前還沒有,但它們值得了解。像 Claude Code 和 OpenAI Codex 這樣的工具可以在幾秒鐘內從簡單的英文提示生成一個可運行的 Requests + Beautiful Soup 或 Scrapy 腳本,這對於一次性任務和原型開發來說確實很有用。對於自然語言瀏覽器流程(登入、動態 JS、多步驟導航),Browser Use 是人們正在使用的開源選項,而 Firecrawl 在目標是將乾淨的 Markdown 饋送給 LLM 時很受歡迎。這些都不能消除困難的部分——反爬蟲防禦、速率限制和服務條款仍然適用——對於大規模的生產爬蟲,Scrapy + aiohttp 在成本和控制方面仍然佔優。將 AI 代理視為一種更快地編寫爬蟲的方式,而不是此列表中函式庫的直接替代品。
想在網頁爬蟲領域保持領先嗎?訂閱 Thunderbit YouTube 頻道 並關注 Thunderbit 部落格,獲取更多指南、比較和自動化技巧。
免費試用 Thunderbit AI 網頁爬蟲 Get Started Free
了解更多



